
MindSpore Lite 端侧推理的 Tensor、动态 Shape 与异构执行链【鸿蒙心迹】
同一个模型,为什么开发机跑 20ms,放到手机上就变成 100ms?
做端侧 AI 的时候,最开始的思路很简单:模型文件拿过来,加载了,Predict 一下不就行了?
结果真放到手机上跑,发现不对:开发机上 20ms 的模型,手机上跑了 100ms。甚至有的模型直接跑不起来。
这时候才意识到:端侧推理不是"把模型文件加载了就完事"。模型文件只是个静态文件,真正跑起来的时候,有一大堆东西要处理:内存、Shape、算子调度、异构执行。
一、先想清楚:Predict() 到底做了什么
先看一段最普通的推理代码:
OH_AI_Model *model;
OH_AI_Tensor *input;
OH_AI_Tensor *output;

OH_AI_ModelPredict(model, &input, 1, &output, 1);
这一行调用,看起来就是跑一次推理。但实际上,这一行背后做了多少事?
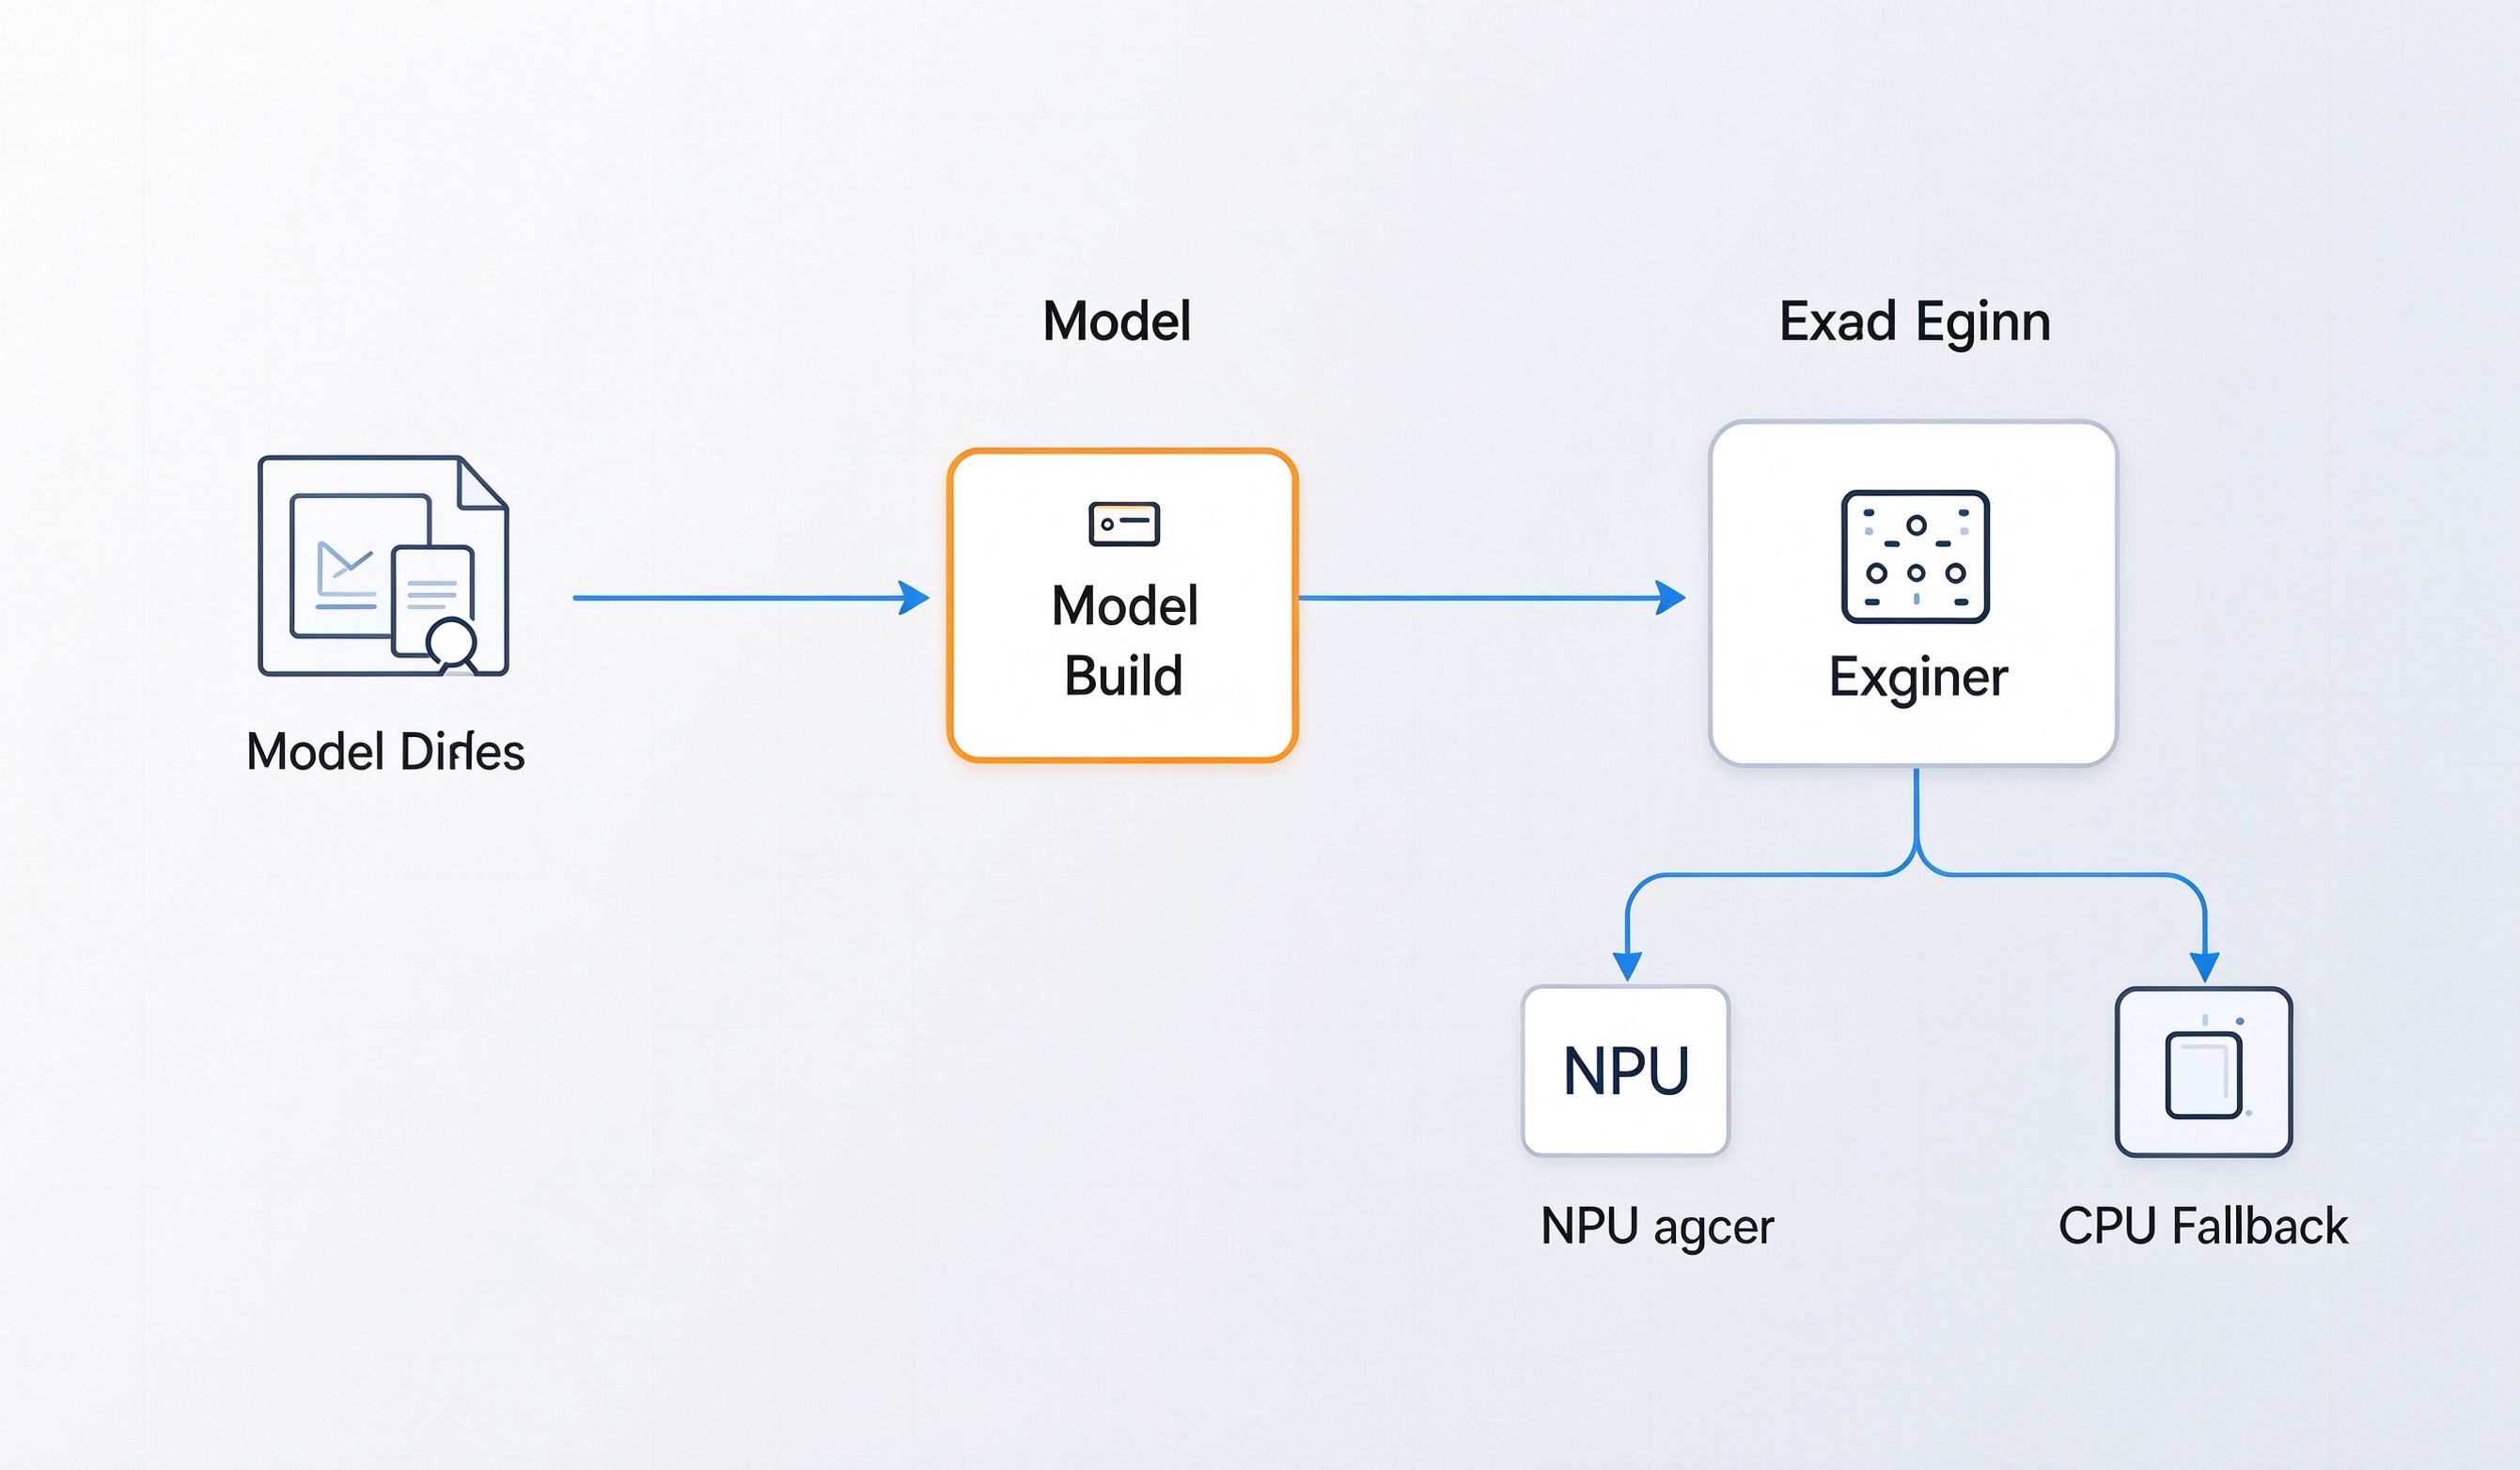
| 阶段 | 做什么 |
|---|---|
| 模型加载 | 从文件读模型,解析结构 |
| Model Build | 把模型编译成可执行图 |
| Tensor 准备 | 分配输入输出内存 |
| Shape 检查 | 确认输入 Shape 对不对 |
| 算子执行 | 每个算子在 CPU/NPU 上跑 |
| 结果输出 | 从 Tensor 拿结果 |
这一行 Predict(),背后是一整套执行引擎在跑。
二、模型文件和可执行模型有什么区别
很多人以为:模型文件加载了,就能直接跑。不对。
模型文件是静态的,存着算子结构、权重这些信息。但它还不能直接在 CPU/NPU 上跑。
要先 Build:把模型文件编译成当前硬件可执行的格式。
| 概念 | 是什么 |
|---|---|
| 模型文件 | 静态文件,存算子和权重 |
| Build 后的模型 | 可执行的,跑在当前硬件上 |
Build 不是瞬间完成的,它要做很多优化:算子融合、内存规划、异构调度。Build 一次,之后每次推理就快了。
这段代码解决什么问题: 加载并 Build 模型。
文件: ai/InferenceEngine.cpp
用途: 端侧模型推理
接入位置: AI 推理模块初始化
// 创建 Context
OH_AI_Context *context = OH_AI_ContextCreate();

// 设置线程数和绑核
OH_AI_ContextSetThreadNum(context, 4);
OH_AI_ContextSetThreadAffinity(context, true);

// 创建 Model
OH_AI_Model *model = OH_AI_ModelCreate();

// Build:从文件加载并编译
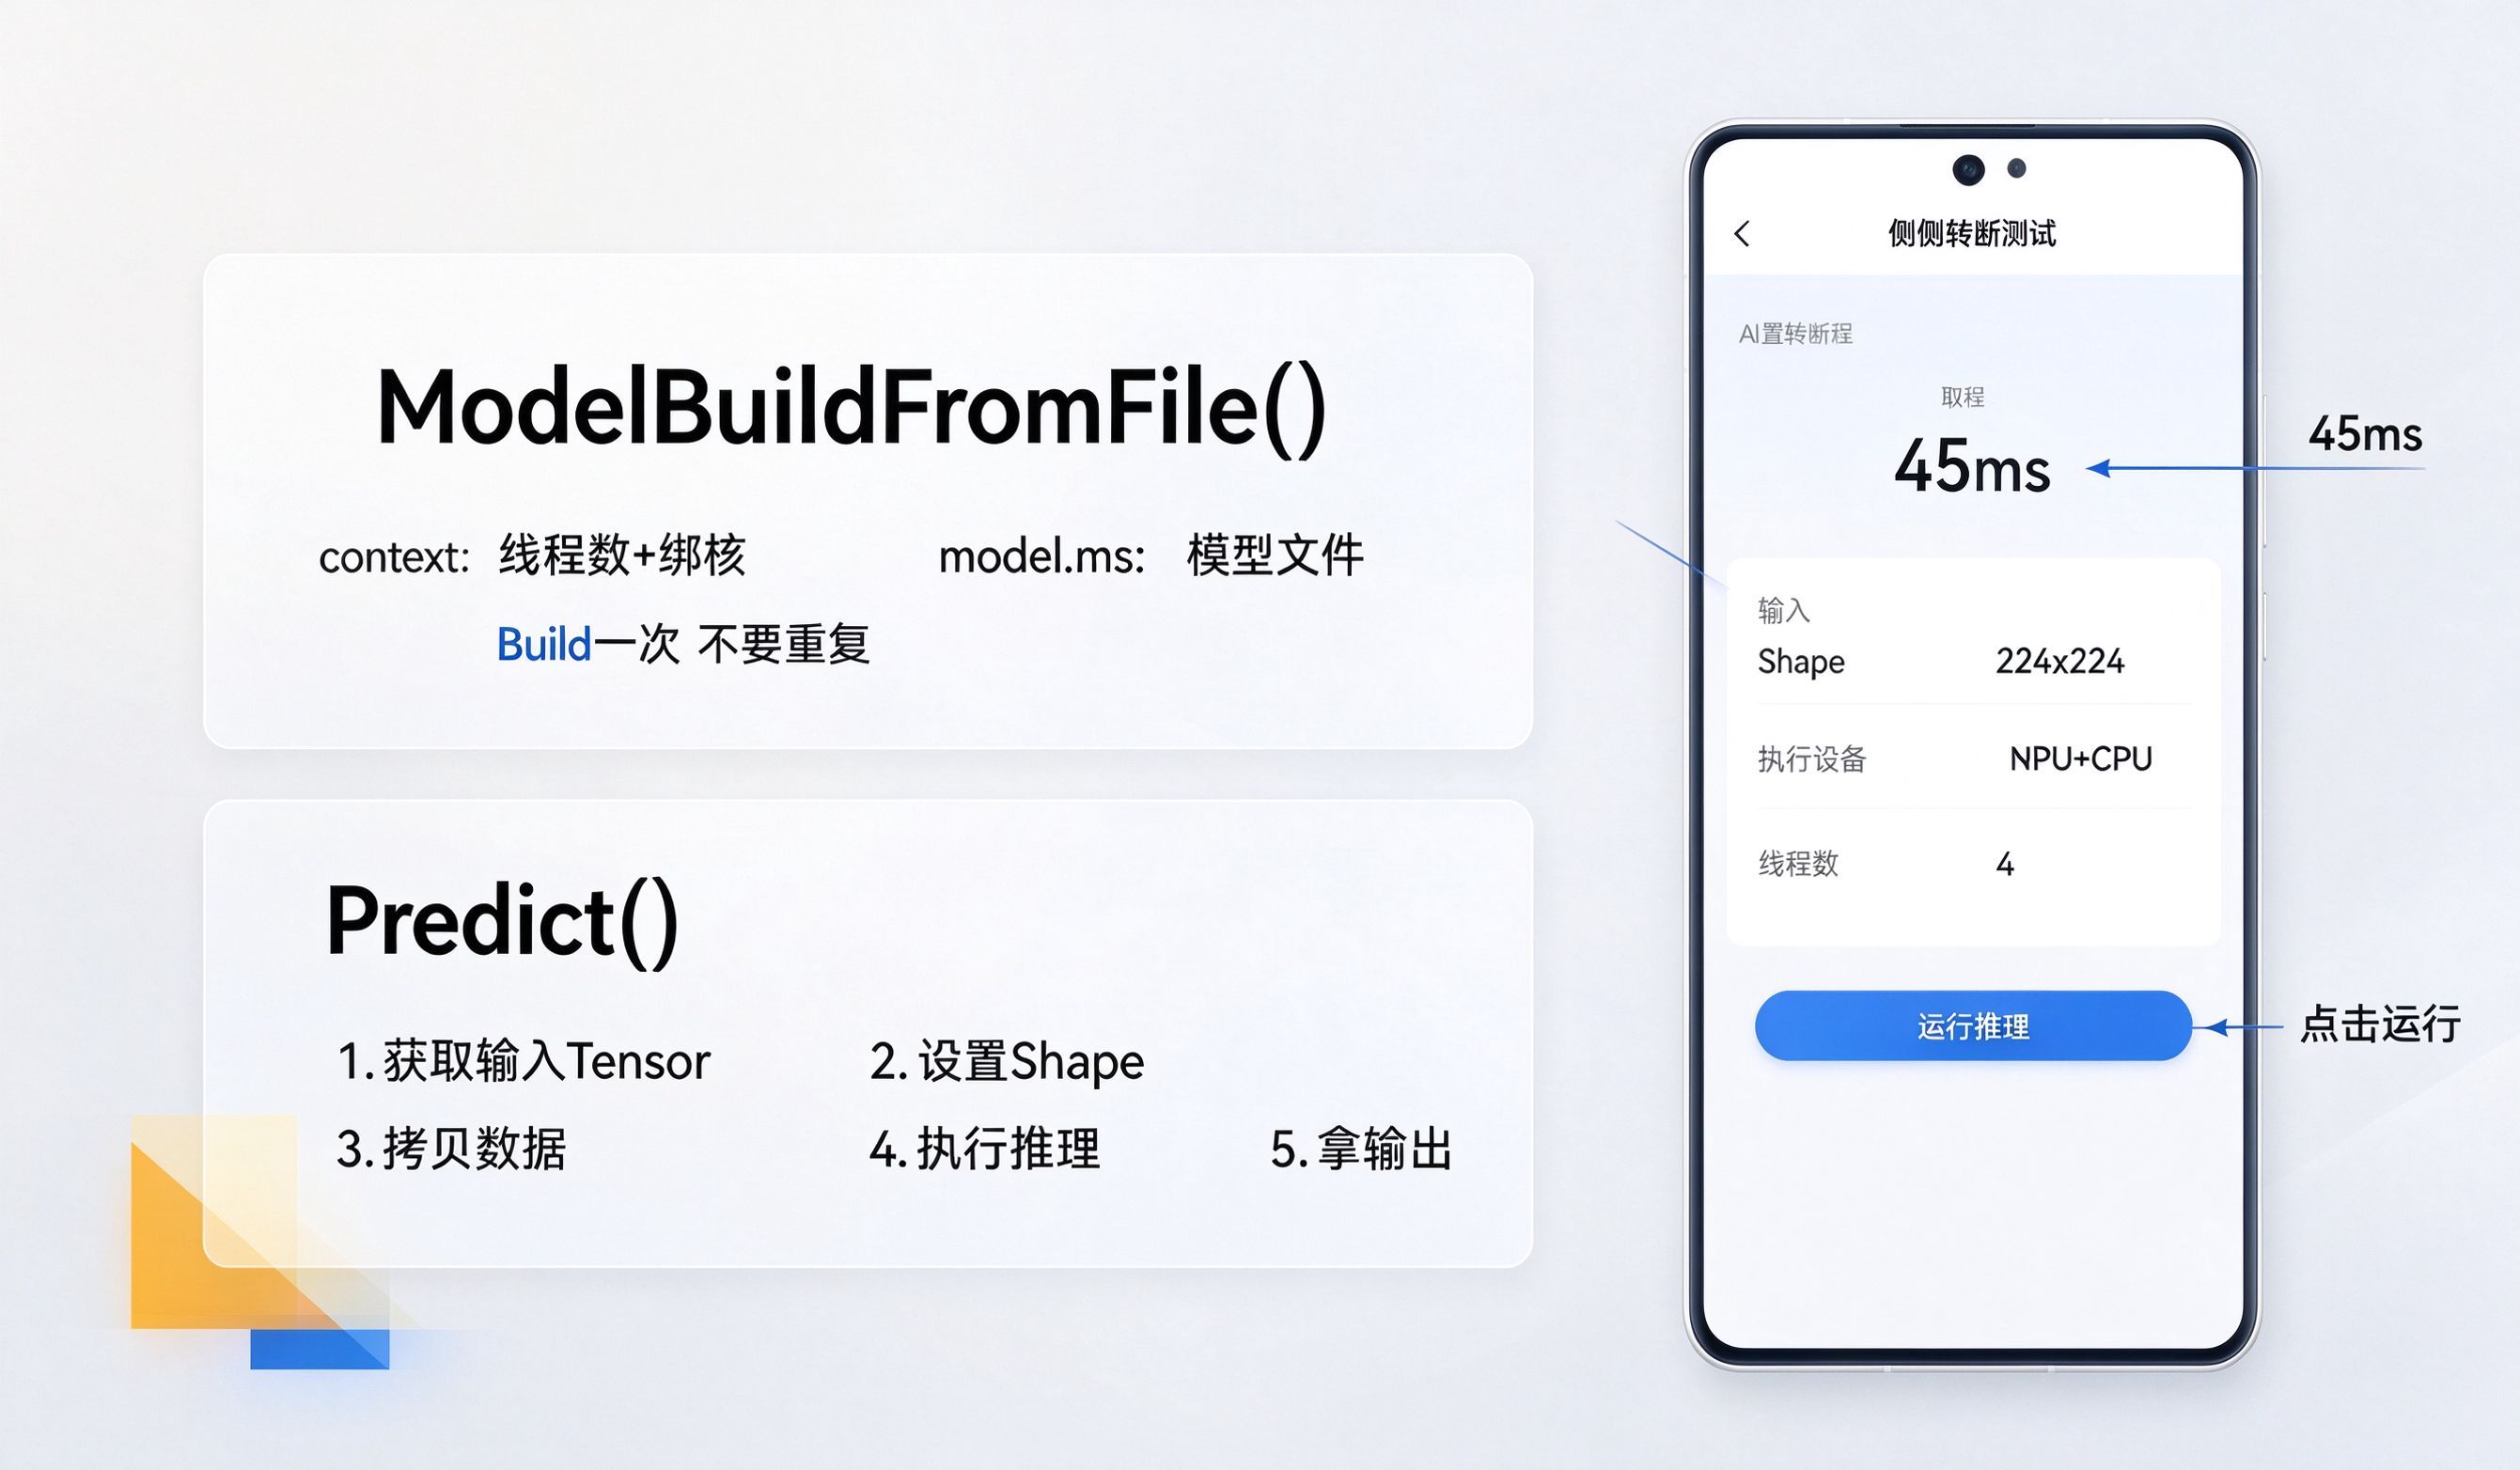
OH_AI_Status status = OH_AI_ModelBuildFromFile(
  model,
  "model.ms",
  OH_AI_MODEL_TYPE_MINDIR,
  context
);
这里最关键的是 Build。Build 是重操作,不能每次推理都重新 Build。
三、Tensor 和 Shape 为什么这么重要
模型跑起来,数据怎么传进去?通过 Tensor。
Tensor 有 Shape,也就是它的维度。比如一个图片 Tensor,Shape 是 [1, 3, 224, 224]:1 张图,3 通道,224×224。
输入 Shape 变了,比如从 224×224 变成 640×640,会发生什么?
| 情况 | 要不要重新处理 |
|---|---|
| Shape 不变 | 直接推理 |
| Shape 变了 | 要 Resize |
Resize 是什么?就是重新规划内存,重新做执行图优化。因为 Shape 变了,内存需求变了,算子调度也可能变。
四、动态 Shape 是什么
静态 Shape:模型的输入大小是固定的,比如必须是 224×224。
动态 Shape:模型的输入大小是可变的,比如可以在 [1, 3, 224, 224] 到 [1, 3, 640, 640] 之间变。
动态 Shape 很灵活,但也有代价:
| 类型 | 内存占用 | 灵活性 |
|---|---|---|
| 静态 Shape | 小,只按固定大小分配 | 不灵活 |
| 动态 Shape | 大,按最大可能分配 | 灵活 |
动态 Shape 的范围不能设计太大。范围太大了,内存按最大的分配,浪费很多。
五、CPU 和 NPU 异构执行是什么意思
很多人以为:配置了 NPU,所有算子都在 NPU 上跑。不对。
NPU 不是万能的。有些算子 NPU 不支持,就会回退到 CPU 跑。这叫 CPU Fallback。
| 算子类型 | 在哪里跑 |
|---|---|
| NPU 支持的 | NPU 跑,快 |
| NPU 不支持的 | CPU 跑,慢 |
所以即使配置了 NPU,模型里有算子 NPU 不支持,那部分还是在 CPU 上跑,整体速度就上不去。
这段代码解决什么问题: 执行推理。
文件: ai/InferenceEngine.cpp
用途: 一次模型推理
接入位置: 每次预测调用
// 获取输入 Tensor
OH_AI_Tensor *input = OH_AI_ModelGetInputTensorByTensorName(model, "input");

// 设置输入 Shape
OH_AI_TensorSetDataType(input, OH_AI_DATATYPE_FLOAT32);
OH_AI_TensorSetShape(input, {1, 3, 224, 224});

// 把数据拷贝到 Tensor
OH_AI_TensorCopyFromBuffer(input, inputData, inputSize);

// 执行推理
OH_AI_ModelPredict(model, &input, 1, &output, 1);

// 从输出 Tensor 拿结果
OH_AI_TensorCopyToBuffer(output, outputData, outputSize);
六、几个容易踩的坑
第一个坑:模型 Build 每次推理都重新执行。Build 是重操作,一次就够了。
第二个坑:Context 重复复用到多个 Model Build。Context 是一次性的,每个模型单独建。
第三个坑:输入 Shape 改变却不 Resize。Shape 变了内存就不对了。
第四个坑:以为配置 NPU 后所有算子都会跑 NPU。不支持的算子回退 CPU。
第五个坑:Tensor Buffer 生命周期比 Predict 短。Tensor 还在用,Buffer 已经释放了。
第六个坑:盲目增加推理线程数。线程太多反而慢,还有上下文切换开销。
第七个坑:动态 Shape 范围设计过大。内存浪费很多。
第八个坑:只看模型文件大小判断运行时内存。模型文件小,运行时内存可能很大。
七、为什么开发机和手机差这么多
开发机跑 20ms,手机跑 100ms,差在哪里?
| 因素 | 开发机 | 手机 |
|---|---|---|
| CPU 性能 | 强 | 弱 |
| NPU 加速 | 有 | 有,但算子支持不全 |
| 内存带宽 | 大 | 小 |
| 散热 | 好 | 差,容易降频 |
手机上跑 AI,不是简单的"把模型搬过来"。要考虑 CPU 性能、NPU 支持哪些算子、内存带宽够不够、会不会因为发热降频。
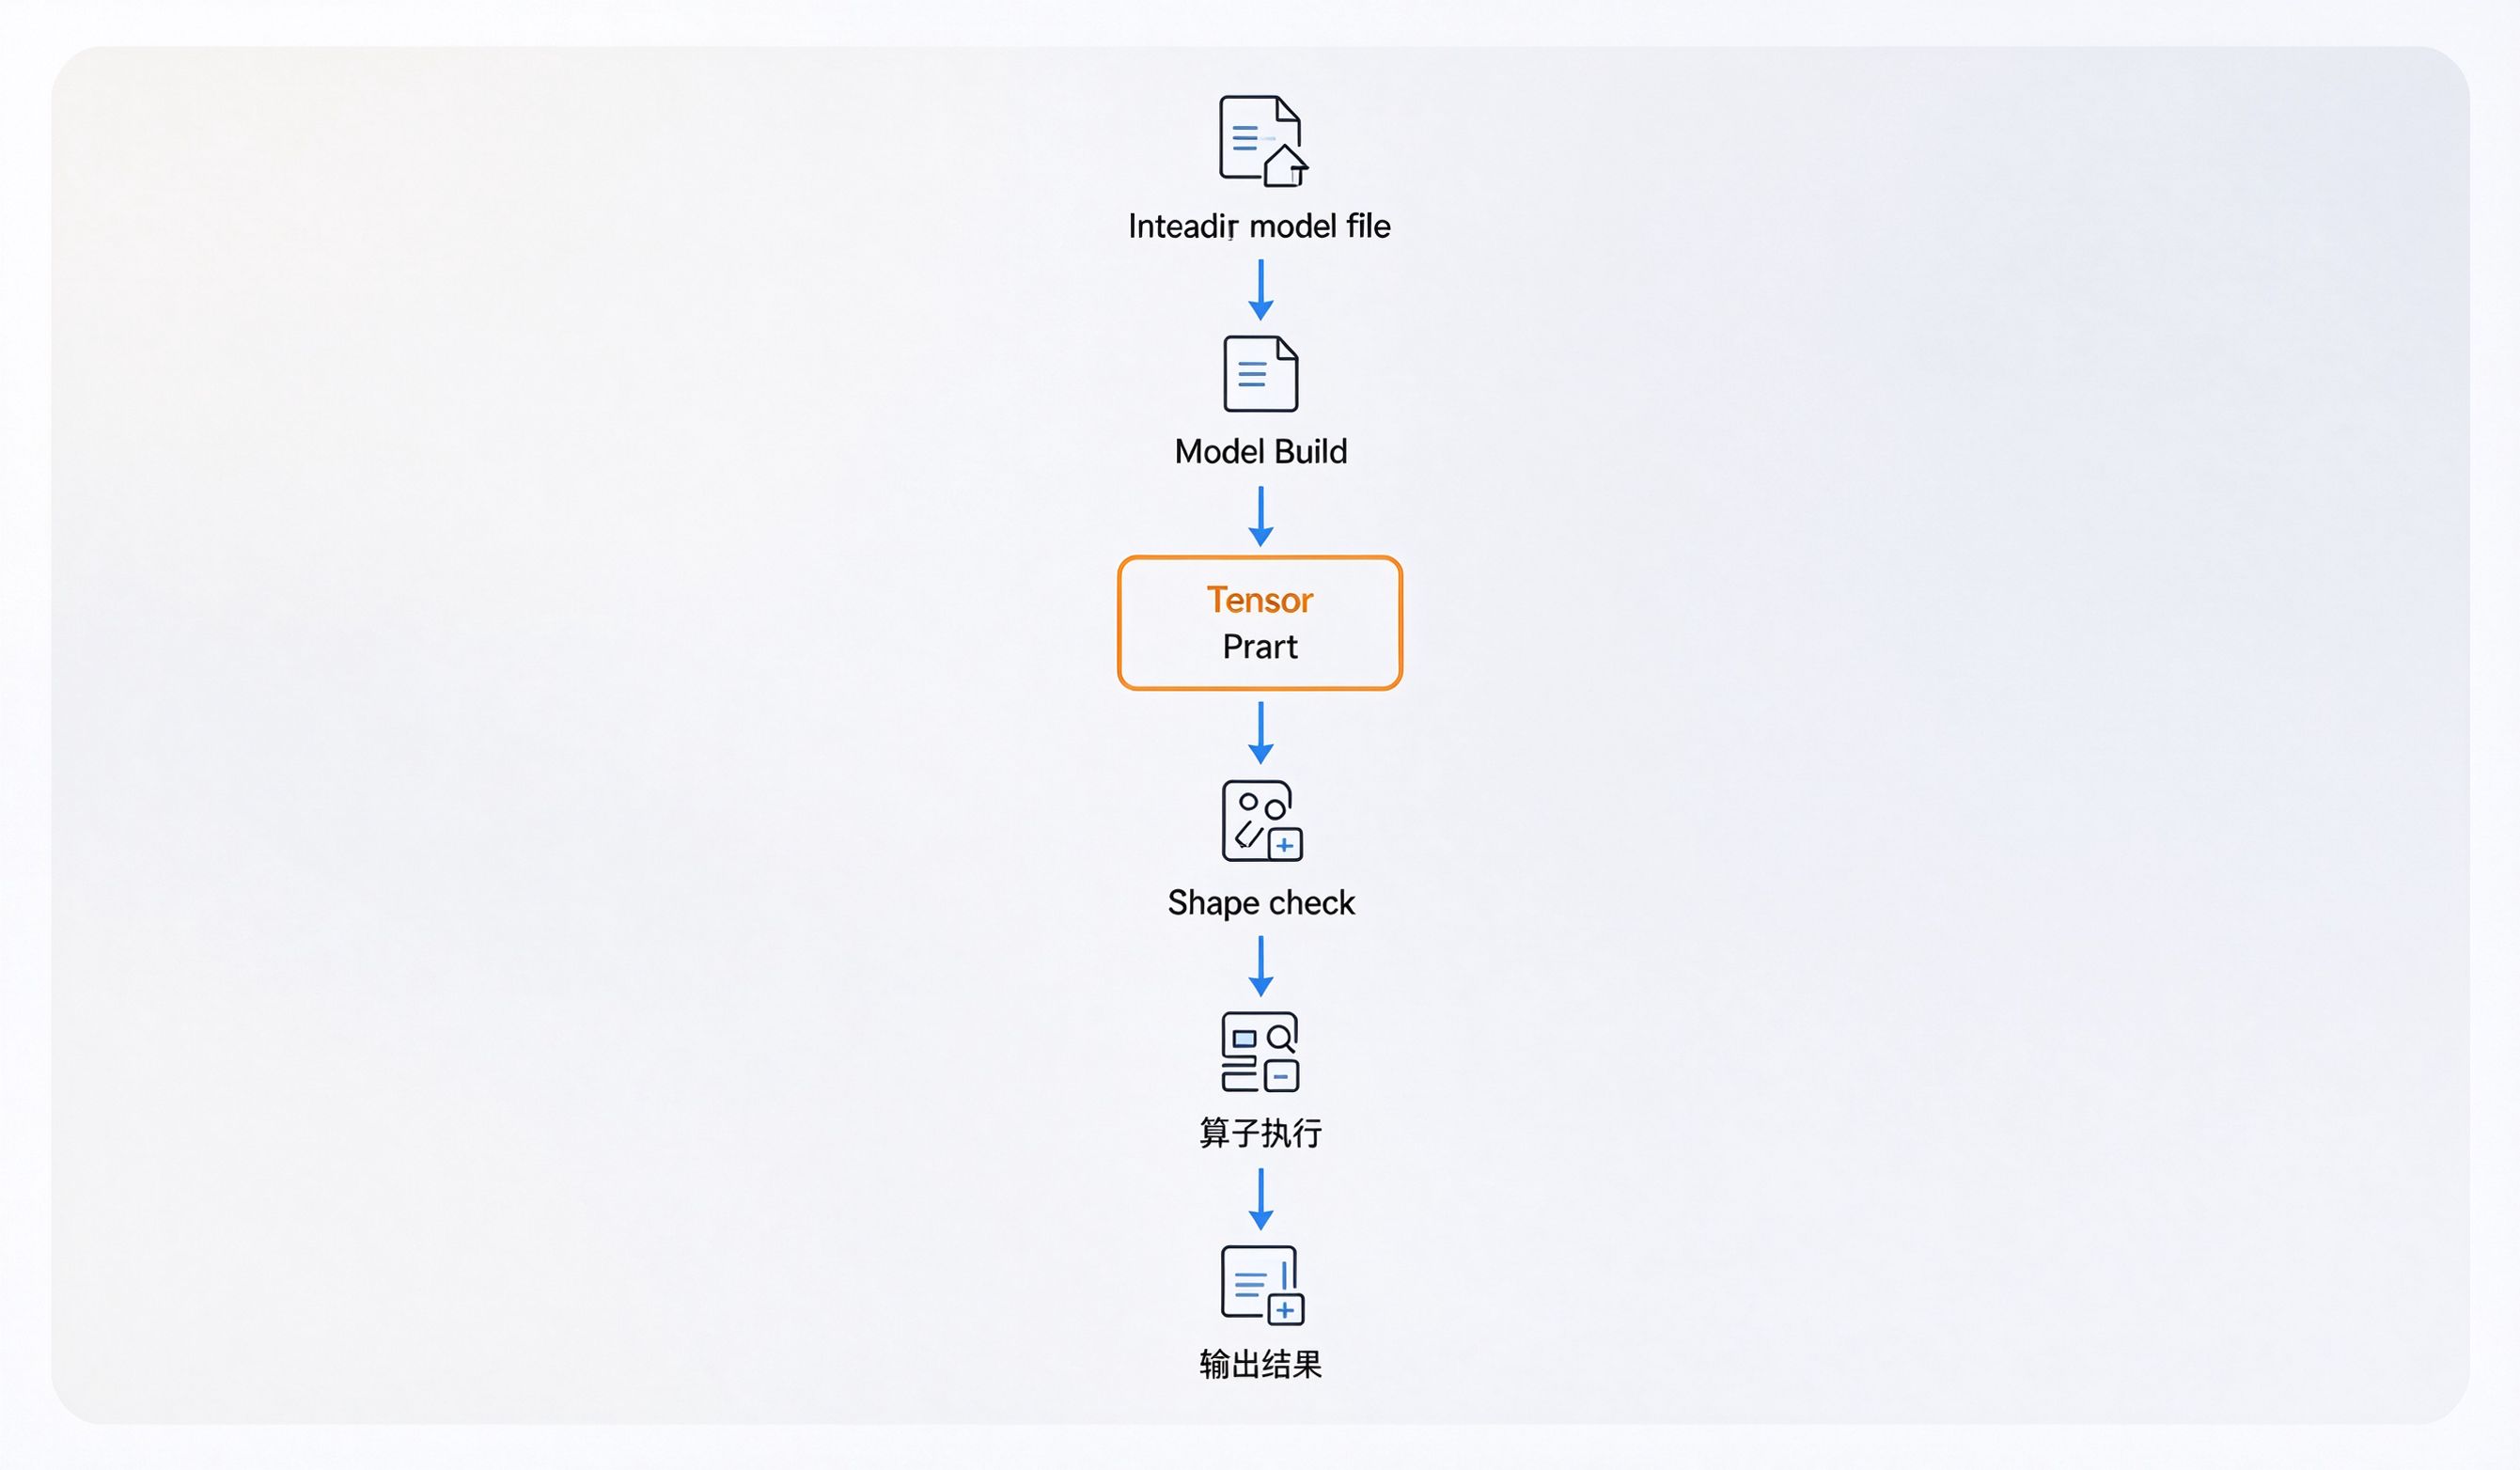
这次做端侧推理最大的体会是:端侧推理不是"加载模型跑 Predict"这么简单。背后是一整套执行引擎:模型加载、Build 优化、Tensor 内存规划、Shape 管理、算子异构调度。
每一个环节都有它存在的理由:Build 做优化、Tensor 管数据、Shape 管内存、异构调度发挥硬件能力。
真正做的时候,最容易忽略的不是算法本身,而是周边的工程问题:Build 不要重复做、Shape 变了要 Resize、NPU 不是万能的、线程数不是越多越好。这些才是端侧推理性能的关键。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)