
HiTraceChain:TraceId、Span 与跨线程调用链的上下文传播【鸿蒙心迹】
用户点了一次"提交订单",日志里却出现了几十条记录,怎么证明它们属于同一次操作?
做线上问题排查的时候,最头疼的就是这个:用户说点了一次提交,然后报错了。你去翻日志,翻出来几十条记录,有 UI 线程的、有异步任务的、有 Native 层的、有系统服务的。
哪几条是这次操作产生的?哪几条是别的操作的?根本分不清。
这时候才意识到:光有时间戳和日志内容不够,你需要一个东西把同一次操作的所有日志串起来。这个东西就是 TraceId。
一、先想清楚:为什么日志串不起来
先把最基础的问题想明白。
普通日志长这样:
10:00:01.234 UI 点击提交按钮
10:00:01.456 异步任务开始执行
10:00:01.789 Native 层调用系统服务
10:00:02.123 系统服务返回结果
看起来是按时间排的。但问题是:用户可能点了两次提交,或者别的操作也在跑。你怎么知道这四条日志是同一次操作的?
| 问题 | 说明 |
|---|---|
| 多线程并发 | 多个操作同时在跑 |
| 跨进程 | UI 进程和系统服务进程 |
| 跨设备 | 手机和平板都在跑 |
没有一个统一的 ID,你根本分不清哪些日志属于同一次操作。
二、ChainId、SpanId、ParentSpanId 是什么
HiTraceChain 的核心就是三个 ID:
| ID | 作用 |
|---|---|
| ChainId | 整条调用链的 ID,一次操作一个 |
| SpanId | 每一步操作的 ID |
| ParentSpanId | 上一步操作的 ID |
ChainId 把整条链串起来。SpanId 标记每一步。ParentSpanId 告诉你这一步是从哪一步来的。
这样你就能还原出完整的调用树:第一步是什么,第二步是什么,第三步是从哪一步分支出来的。
三、调用链是怎么创建和传播的
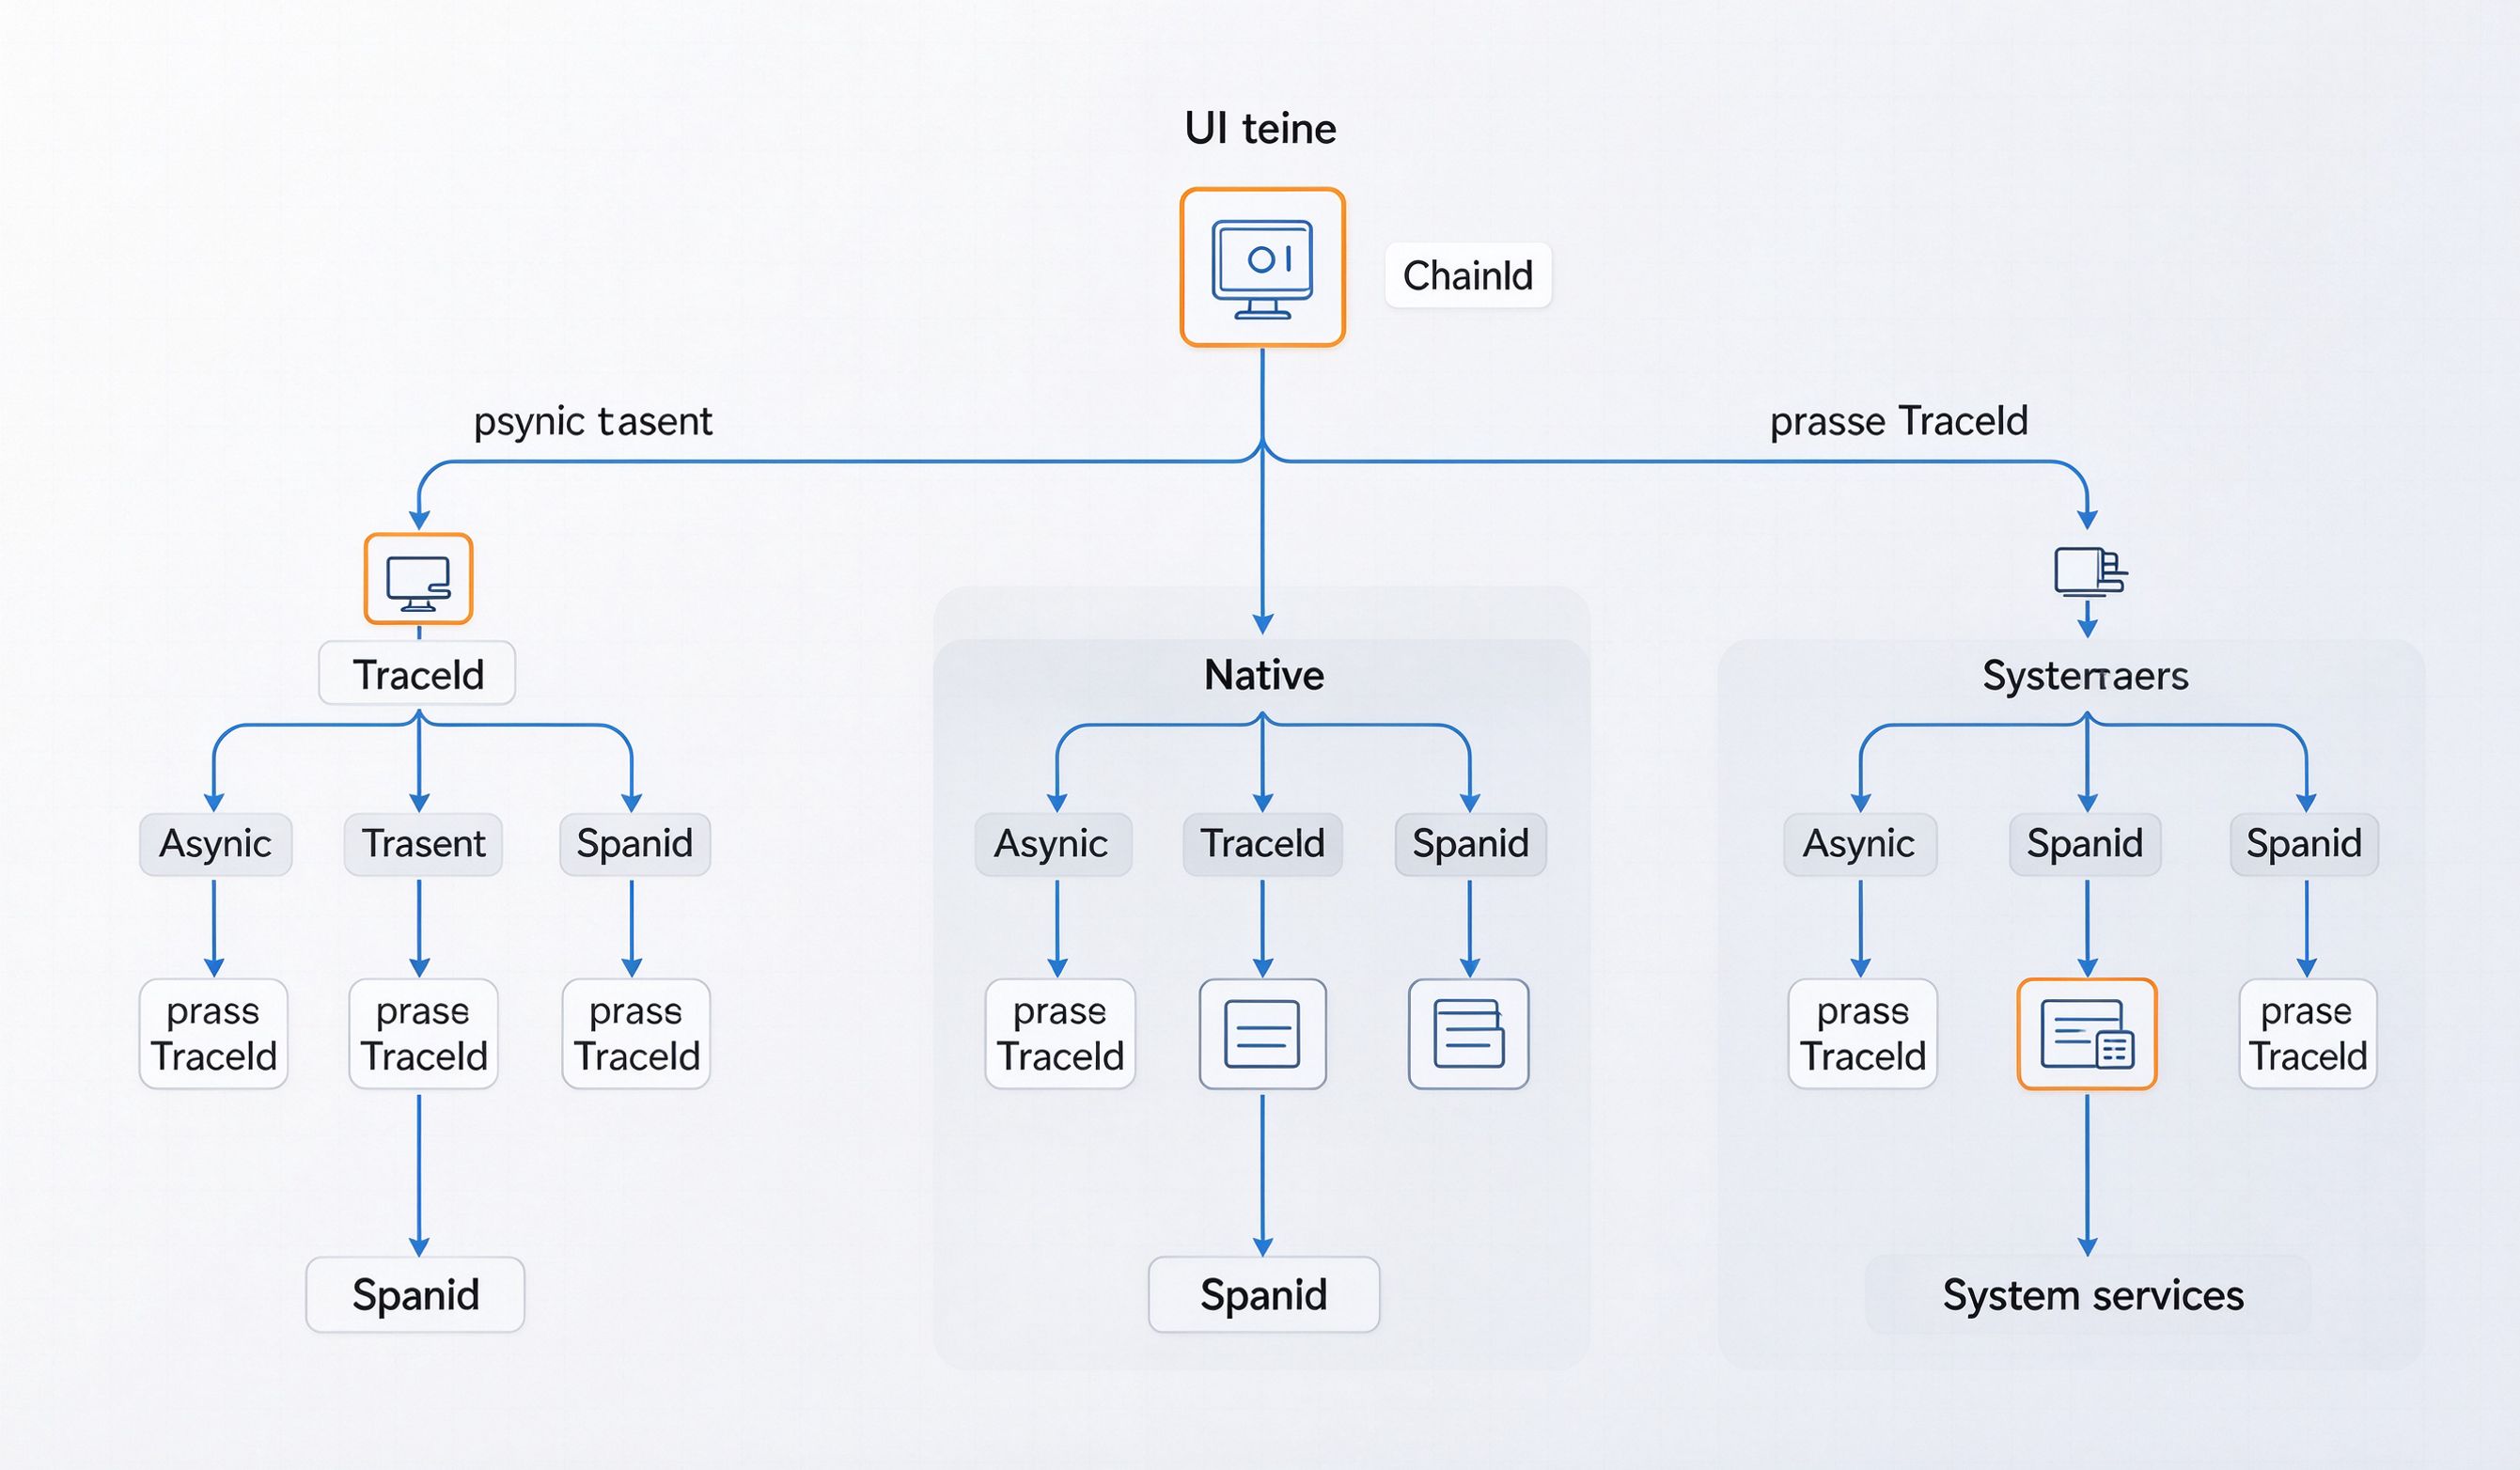
完整的调用链是这样的:
- UI 线程处理用户点击,创建第一个 Span,生成 ChainId;
- 调用异步任务,把 ChainId 和 SpanId 传过去;
- 异步任务创建新的 Span,ParentSpanId 指向上一步;
- 调用 Native 层,把 ChainId 传过去;
- Native 层再创建新的 Span;
- 调用系统服务,把 ChainId 传过去;
- 系统服务再创建新的 Span。
每一步都带着同一个 ChainId。这样所有日志都能串起来。
这段代码解决什么问题: 创建调用链 Span。
文件: trace/TraceHelper.ets
用途: 跨线程调用链追踪
接入位置: 关键业务节点
import { hiTraceChain } from '@kit.PerformanceAnalysisKit';

// 开始一个新的调用链
let traceId = hiTraceChain.begin('submitOrder', hiTraceChain.HiTraceFlag.DEFAULT);

// 业务逻辑...

// 异步任务,传递 TraceId
setTimeout(() => {
  // 把 TraceId 设置到当前线程
  hiTraceChain.setId(traceId);

  // 异步任务的业务逻辑...

  // 结束
  hiTraceChain.end(traceId);
}, 100);
这里最关键的是:异步线程里要把 TraceId 传过去,不然异步任务的日志就跟主线程断开了。
四、为什么异步线程容易丢 TraceId
很多人写调用链,主线程都好好的,一到异步就断了。
为什么?因为 TraceId 是存在当前线程上下文里的。主线程有,新开的异步线程没有。
| 线程 | 有没有 TraceId |
|---|---|
| UI 主线程 | 有,begin 创建的 |
| 异步任务线程 | 没有,新线程是空的 |
| Native 层 | 没有,要手动传 |
你不手动传,异步线程就不知道现在在调用链里,它打出来的日志就没有 TraceId,就串不起来。
五、HiTraceChain 和 HiTraceMeter 有什么区别
很多人搞混了这两个。不对。
| 组件 | 作用 |
|---|---|
| HiTraceChain | 管调用链上下文,生成和传播 TraceId |
| HiTraceMeter | 管性能打点,记录某一步花了多久 |
HiTraceChain 是"把日志串起来"。HiTraceMeter 是"记录每一步的耗时"。两个配合用:Chain 负责串,Meter 负责量。
六、几个容易踩的坑
第一个坑:每个函数都重新 begin 导致调用链断裂。每一层都开始新链,就串不起来了。
第二个坑:异步线程没有传递 TraceId。异步任务的日志全断了。
第三个坑:Span 创建后父子关系错误。ParentSpanId 不对,调用树就错了。
第四个坑:任务结束没有 clearId。线程池里的线程复用,TraceId 串到下一个任务去了。
第五个坑:拿时间戳硬拼日志。自己拼时间线,不如用现成的 TraceId。
第六个坑:只追踪正常路径不标记异常分支。出错的时候,反而找不到调用链。
七、调用链怎么帮你排障
调用链最大的价值不是开发的时候用,是排障的时候用。
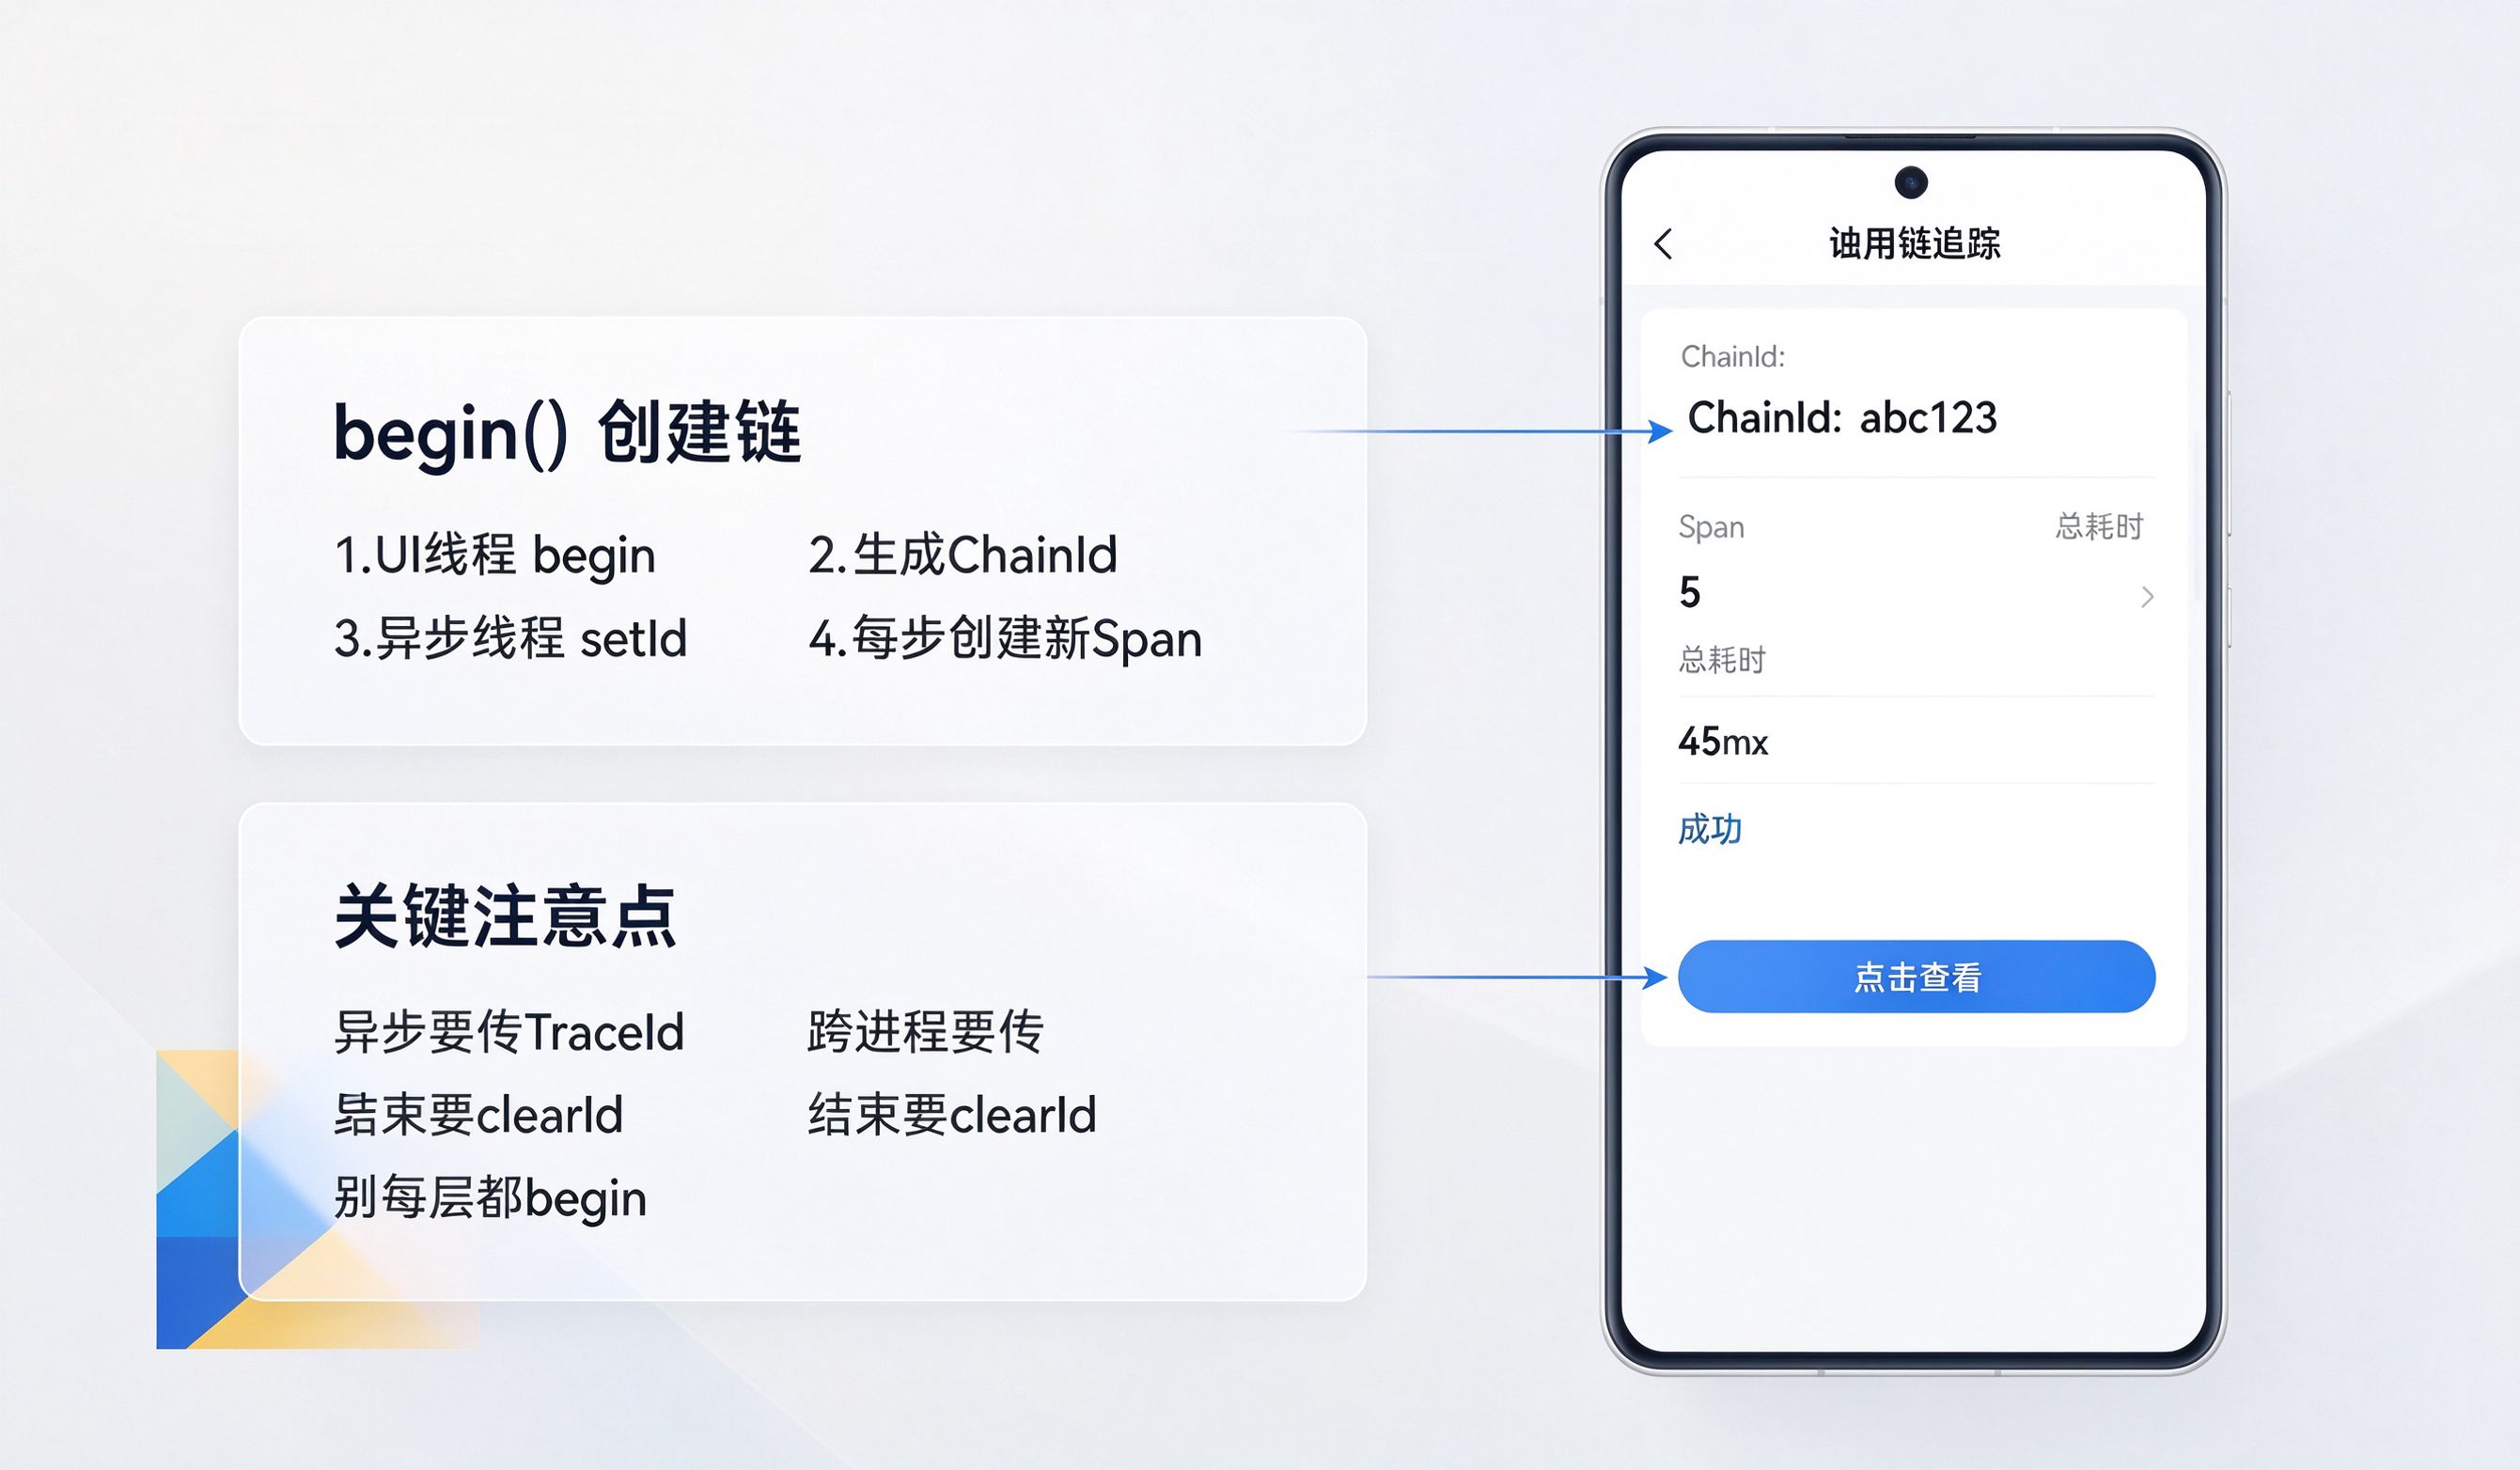
用户报了个错,你拿到 ChainId,把所有带这个 ChainId 的日志都捞出来,按 SpanId 和 ParentSpanId 排好,完整的调用过程就出来了。
哪一步慢了,哪一步报错了,一目了然。不用自己猜哪里出问题了。
这次做调用链追踪最大的体会是:TraceId 不是什么高深的东西,就是一个 ID,把同一次操作的所有日志串起来。但它难在传播:主线程到异步线程、UI 到 Native、应用到系统服务,每一层都要记得传。
真正做的时候,最容易忽略的不是怎么打 Trace,而是怎么保证 TraceId 不丢。异步线程、跨进程、跨设备,每一个边界都要手动传。丢了一个,整条链就断了。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)