
华为昇腾960超节点:“系统级胜利”宏观叙事下,也应该重视的短板
作者:雍忠玮
这几天,华为在全联接大会2026上发布Atlas 960E SuperPoD(中文名:昇腾960超节点),一直是业界关注的热点。
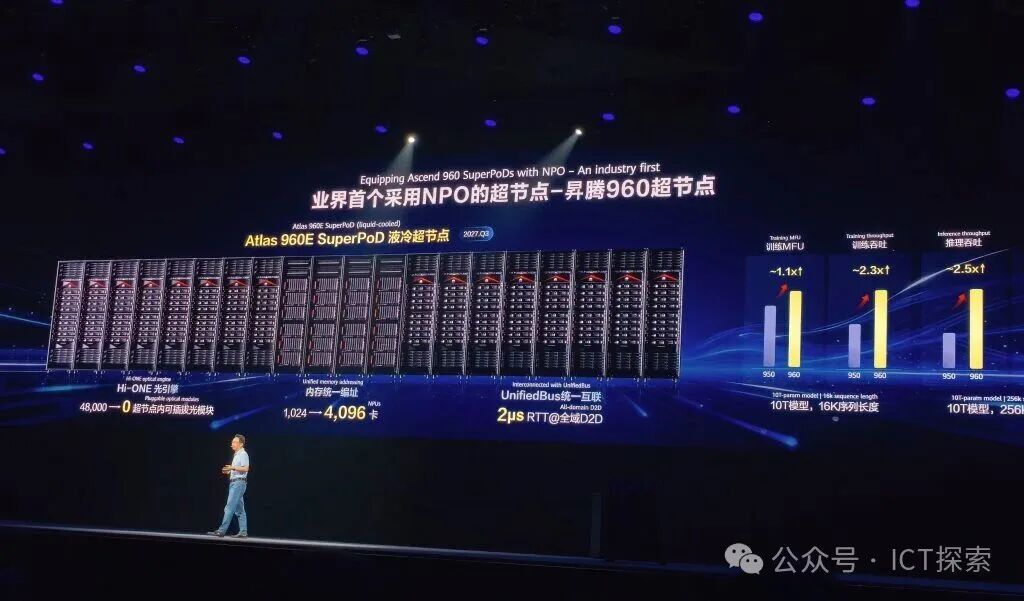
作为全球首个采用NPO(近封装光学)技术的超节点产品,这款可扩展至4096卡的算力系统以8 EFLOPS FP8算力[注1]、1PB HBM容量[注2]和99.8%系统可用度[注3],将“系统架构创新弥补单点芯片差距”的叙事推向新的高度。
从弯道超车,到“换道超车”
如果说,中国科技行业在相当长的时间里,都致力于弯道超车,那么华为此次发布的“昇腾960超节点”,就属于“换道超车”。
昇腾960超节点最核心的突破,总体看有三个:
第一个就是华为提出的Peerium顶层计算架构,以及具体在昇腾960超节点上的实现,也就是“灵衢(UnifiedBus)”,一种基于开放协议的高速总线。
抛开复杂的技术概念,可以这样简单来定位:“灵衢”是一种技术(或者说技术方法),是华为Peerium计算架构这个战略思路中的“统一内存寻址”和“平等互联”,在具体产品上的首次实现,或者说第一代产品。
关于“灵衢”,也可以简单来表述,就相当于电视剧《功勋》里,于敏在晶体管计算机线性计算速度太慢的时候,让所有的研发人员分成多个小队,大家各自平行计算,最后将平行计算结果再汇总的思路,大体就是这样。
第二个,就是NPO光互联技术的工程化落地,就是名称为Hi-ONE的NPO光引擎。
第三个,是韬定律下的昇腾960DT芯片本身。
当然,这三个要素可以视为促成昇腾960超节点硬件整体优势的并行要素,并不是那个比哪个更为重要,而是都重要。
更细节的参数,华为官方新闻稿里都有,这里就不重复罗列了。
至于说昇腾960超节点最大集群规模可达51.2万卡、最大支持100万卡昇腾超节点集群等等,听听就得了。
这么说吧,昇腾960DT单卡价格不会低于30万,而有券商研报给出的测算价格,一套4096卡的Atlas 960 SuperPod售价就是3.1亿美元,也就是单卡对应的系统成本约7.6万美元(约合55万人民币)。
按此保守算,100万卡就是5500亿元人民币,第一华为是否能直接交付,第二就算能,估计也没有哪一家公司能买得起。毕竟,三大运营去年的总利润加起来也就2400多亿,都不够买50万卡的。因此,这种表述纯粹就是听着玩的,没有任何实际意义,听听就得了。
当然,如果有需要,华为造还是能造出来的,毕竟,按照行业预测,华为2026年全年的预期交货量就超过130万卡,国内算力卡出货断层第一,也是唯一能稳定交付千卡级超节点集群的厂商。
但华为确实在因为先进制程受限、往年间擅长的“弯道超车”已经没有任何可见机会的情况下,改“换道超车”策略,并取得了巨大的战果。也就是说,这个“系统级胜利”的宏观叙事,是完全成立的。
未曾提及的短板
在总体上系统级胜利的基础上,也应该客观看到,一些当前仍然面临的不足。
首先就是“算子生态”上,华为还需要时间,尤其是需要真正对开发者们做投入和引导。
“算子”是什么就不多做介绍了,有兴趣的人自己可以去查一下。
华为的CANN(异构计算架构)开原生态目前大概有420个高性能算子,和英伟达的CUDA生态的2000个相比,还有距离。不过,CUDA生态搞了20年了,CANN生态是和昇腾战略发布一起发布的,到目前满打满算也就是8年时间,所以在数量上的差距对比,也属正常。
算子生态的差距,容易导致的最现实的问题,就是大模型项目如果要迁移到昇腾平台,付出的时间成本和资金成本,都比较明显。尤其是封闭模型,或者只是公开权重、非完全开源的模型,迁移难度就更高。具体细节不展开了,CSDN社区里就有很多讨论。
在这次全联接大会2026上,徐直军也对此有所回应说,“DeepSeek开源后,我们的客户对华为的昇腾发展指出了很多问题,也充满了期待。”只是他没有做任何展开说明,尤其是期待什么,没有说。
目前的情况是,尽管华为表示,已经在开发者生态建设上投入了大量资源,但开发者群体的感受输出,却不够理想。对比一下:
华为昇腾计算产品部部长周斌在2026年5月表示,CANN已实现全面开源开放,“为开发者提供完整、高效、开放的算子开发体系”。其实,CANN宣布全面开源开放是2025年8月的事情了。华为给出的数据是:CANN社区外部开发者占比达61%,月活开发者5200名。
而开发者社区(是放在CSDN下的)的反馈是,“相较于GPGPU的可独立开发优势,昇腾后续开发严重依赖于华为技术人员支持”等,更为细节的就不展开了,有兴趣的人可以去CSDN社区的CANN开发者社区自己看。
昇腾芯片一年一代的迭代速度,也对软件适配构成了持续压力,因为该节奏就意味着CANN、算子库、通信库和迁移工具链这四层软件栈,每一层都需要跟着新硬件重做一遍。这种“滚动作业”式的适配负担,是开发者体验难以在短期内追平CUDA的结构性原因。
第二个就是前面提到的HBM供应链问题。
就在最近的9月10日,路某社就报道称,由于全球HBM短缺及美国自2024年底收紧对华先进HBM出口管制,中国AI芯片厂商已愈发依赖灰色市场获取先进HBM,采购价格通常是境外买家的数倍。
上游HBM涨价,那么以其为核心部件之一的AI芯片,涨价也就在情理之中了。比如,华为的昇腾950DT加速芯片在过去两个月,涨价幅度已经超过50%,单片价格报价都达到或者超过25万人民币了(后面估计还得继续涨),连旧款的昇腾950PR芯片报价也从年初的6万上升到了8万元,涨幅也超过了30%。当然,其他家,例如寒武纪、沐曦及天数智芯等,也都在涨价。
对华为而言,难处不在于HBM的涨价,而在于高性能HBM供应或者说来源的困境。虽然说长鑫存储的已进入HBM3E风险试产阶段,据说2027年就能向华为供货,但全球其他竞争者已经都使用上HBM4了,而华为基本上是没办法获得HBM4的。
虽然昇腾960超节点在发布会上,声称能够支持“1PB HBM容量”和“288GB HBM”,但核心问题是,“支持”不等于“有货”。在出口管制持续收紧的背景下,HBM的获取难度和成本,是比算子生态更底层的制约因素。
第三个就是NPO事实上先行,和现有标准如何兼容,以及由此产生的“超节点架构的未验证风险”。
标准兼容涉及到华为的NPO光引擎技术是否能被第三方硬件厂商和系统集成商广泛接受。从短期来说,鉴于华为的NPO光引擎技术主要目标,是绑定在昇腾芯片上使用,问题不大,但从长远看,如果不能实现跨加速器互连协议兼容,或者不能获得更多硬件厂商的支持,那么生态开放性就会有问题。尽管此前ICT探索在文章中也说过,这个问题也不用太着急,“待我成事,自有大儒为我辩经”。
但现实里已经有人提出疑问:兼容性问题将导致跨厂商混合部署“几乎不可能”,那么在明年就必须要在现实中验证一个结果:华为将大量竞争压力放在了加速器之间的通信上,随着卡数上升,集群可能积累可观的峰值算力,却在设备交换数据时损失时间和功耗,在大型训练任务所需的通信过程中,系统理论性能究竟能“存活”多少。
徐直军在接受媒体专访的时候说,“大家都关注芯片去了,没人关注灵衢。”其实当他这样对媒体说的时候,就意味着灵衢(UnifiedBus)已经获得业界的关注了。
从受众角度看,全联接大会主舞台面向的是产业决策者、政府客户和资本市场,他们关心的是华为能否提供一套可部署、可扩展的国产算力底座。但ICT探索认为,即然华为是抛开弯道超车,要搞“换道超车”,就不能只重视车(比如芯片、总线、传输这些硬件),还要重视道(比如算子生态、上游供应链、协议兼容性等软性问题)。
正如徐直军接受媒体专访的时候也承认的:“数据没有到位,计算就无法继续,一个短板会制约整个系统。”
因此,在涉及昇腾960超节点宏观“系统级胜利”叙事之外,重视和提一提那些未曾提及的短板,可能也是必要的。
ICT探索注1:8 EFLOPS FP8算力:是满配系统(也就是4096满卡)、理想条件下、能够达到的理论峰值性能(Peak Performance)。
ICT探索注2:1PB HBM容量:是960DT单芯片最高支持 288GB HBM(高带宽内存),当 4096张昇腾960
NPU通过超节点架构互联后,其HBM总容量便线性累加至4096×288GB≈1.15PB。按照华为公布的消息,用于训练(Train)的昇腾960DT,将在2027年Q1就绪、Q2上市,用于推理(Inference)的昇腾960PR将在2027年Q3上市。这里需要明确一点:因为美国管制,当前市场上几乎所有用于高性能计算的HBM产品都对华实行管制销售(不只是原产美国,几乎是所有),名义上是管制,其实基本上就是不卖。因此,华为能做的就是自研HBM。据公开报道,昇腾950PR起,华为芯片已开始采用自研HBM(代号HiBL、HiZQ),降低了对海外存储供应的依赖。昇腾960DT所标注的288GB的HBM容量、9.6TB/s带宽,其规格被描述为8颗12层HBM3E的水平。而国内唯一从事HBM裸片制造的长鑫存储,其HBM3样品已交付华为,计划2026年冲刺量产,12层HBM3E则计划2027年推进。这与昇腾960DT2027年Q1就绪的时间表极为接近。即便如此,长鑫存储的产能不足,仍属于核心瓶颈。根据研究机构Epoch
AI估算,华为2026年约150万颗AI芯片中,仅约24万颗能搭配自研HBM,另有约75万颗不得不采用性能较低的非HBM内存。华为轮值董事长徐直军也坦言:“我们连中国内部的需求都无法完全满足”。还有一点需要说明一下:昇腾960DT单芯片最高支持288GB的HBM(高带宽内存),已经相当厉害,对比来看,英伟达H200的HBM容量为141GB,B200为192GB。ICT探索注3:“系统可用度”是一个衡量系统在规定时间内处于可工作状态的概率指标。99.8%的可用度,意味着在一年(365天)的连续运行中,系统允许的计划外停机时间总计约为约17小时31分钟。华为在发布会上强调,这一可用度是建立在系统无故障运行时间(MTBF,平均无故障时间)相比上一代提升一倍的基础之上的。其背后的关键工程支撑,正是NPO(近封装光学)技术的引入:用
5500个 Hi-ONE 光引擎,替代了原本需要的约
4.8万颗传统800G可插拔光模块。光模块数量的大幅减少约88.5%,直接降低了因单个光模块故障导致系统中断的概率,从而将系统可用度提升至99.8%的水平。关于华为在NPO方面的领先,可参见ICT探索此前发布的文章《华为的7.2T光引擎,与中美光互连的权力反转》。
关于作者:雍忠玮,前财经和科技媒体人,重点关注ICT领域的创新技术发展。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)