
slime 源码走读:SGLang-Native 推理架构解析(下)
作者:昇腾实战派
知识地图:https://blog.csdn.net/Lumos_Lovegood/article/details/161601003
前言
昇腾平台当前已支持slime框架
本文是 slime 源码走读系列的推理架构部分的下篇。上篇介绍了 slime 的推理整体架构——服务化推理、四级层级、三条通信路径、SGLangEngine 遥控器、sgl-router 等。如果还没读过、强烈建议先读上篇,本文会反复引用其中的设定。
如果不想跳回去翻,简单复述一下走读配置和架构骨架。
走读配置(来自 OpenClaw-RL/toolcall-rl/retool_qwen3_4b_rl.sh):
ray job submit ... -- python3 train_async.py \
   --actor-num-nodes 1 \
   --actor-num-gpus-per-node 4 \      # 训练占 4 GPU
   --rollout-num-gpus 4 \             # 推理占 4 GPU
   --rollout-num-gpus-per-engine 2 \  # 每个引擎 TP=2
   --n-samples-per-prompt 8 \         # GRPO:每个 prompt 采样 8 条
   --rollout-batch-size 32 \
   --custom-generate-function-path generate_with_retool.generate \
   --custom-rm-path generate_with_retool.reward_func
单节点 8 GPU,训练和推理各占 4 GPU 的解耦部署;推理侧起 2 个 SGLang 引擎,每个 TP=2;工具调用逻辑通过 --custom-generate-function-path 注入。
架构骨架(上篇结论):
- RolloutManager(Ray Actor,0 GPU)是 rollout 调度入口
- 它管理着 2 个 SGLangEngine Ray Actor,每个 Actor 又 spawn 一个独立的 SGLang HTTP Server 子进程(持有实卡 GPU)
- 所有推理请求通过一个 sgl-router 子进程分发到引擎
- 推理调用通过两个扩展点暴露给用户:–rollout-function-path(外层 rollout 调度)和 --custom-generate-function-path(内层单条 sample 生成)
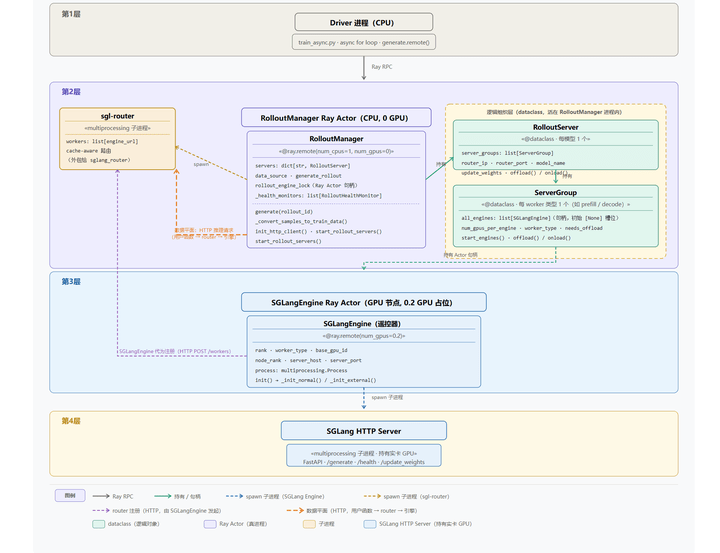
【图示】推理架构
上篇讲的是”搭起来之后是什么形状”。本文回答另一个问题:一次 rollout_manager.generate() 调用进来之后,slime 如何驱动这套架构——在 DAPO 式过采样、GRPO 分组、partial rollout 续生成、工具调用多轮交互这些约束下,高效地产出一个干净的训练 batch。
本文的调用链比上篇那张全局图更聚焦:
generate_rollout                       # 同步入口,train/eval 分流
  └── generate_rollout_async           # 双层 while + dynamic sampling
        └── generate_and_rm_group      # group 级并发(asyncio.gather)
              └── generate_and_rm      # 三层并发嵌套 + partial rollout mask
                    ├── custom_generate(retool)→ await post(router)
                    └── async_rm → reward_func
本文分两章展开:
第 4 章 推理控制流——从框架内部视角,拆解 rollout 调度、并发结构、partial rollout 正确性三条线:
- 4.1 generate_rollout:同步入口与 partial rollout 回收
- 4.2 双层 while:dynamic sampling 的自动补偿
- 4.3 GenerateState:单例与三套并发机制
- 4.4 group 并发与三层嵌套
- 4.5 generate_and_rm:partial rollout 的正确性
第 5 章 自定义 generate 函数——从框架外部视角,通过对比默认 generate 和 retool 两个实现,划清用户函数的责任边界:
- 5.1 扩展点与默认实现
- 5.2 责任 1-3:partial rollout 边界、prompt 构造、HTTP 调用
- 5.3 责任 4-6:多轮循环、字段对齐、状态翻译
4 推理控制流:dynamic sampling 双层 while、partial rollout
4.1 generate_rollout:同步入口与 partial rollout 回收
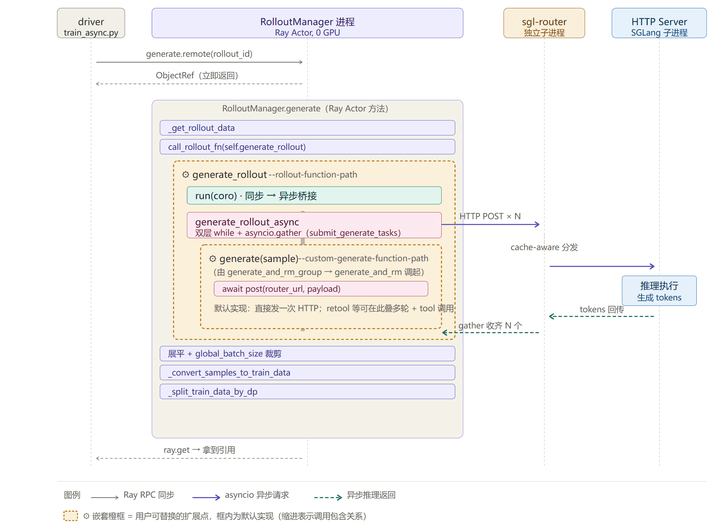
【图示】调用栈
generate_rollout 是 RolloutManager.generate 通过 call_rollout_fn 调到的默认 rollout 函数——也就是上篇 1.2 节调用栈里那个外层橙色虚框扩展点(可通过 –rollout-function-path 替换)。它本身只有十几行,浓缩三件事:
def generate_rollout(args, rollout_id, data_source, evaluation=False):
    assert args.rollout_global_dataset
    if evaluation:
        output, _ = run(eval_rollout(args, rollout_id))
        return output
    output, aborted_samples = run(generate_rollout_async(args, rollout_id, data_source.get_samples))
    if aborted_samples:
        data_source.add_samples(aborted_samples)
    return output
第一件事:桥接同步与异步。 函数签名是普通的 def,run() 把 async 协程提交给后台 asyncio 线程跑到完成。这一行就是 RolloutManager 同步代码与 asyncio 世界的接口。
注意传给 generate_rollout_async 的是 data_source.get_samples 这个方法、不是 data_source 对象本身——generate_rollout_async 内部只把它当作”给数字返样本”的 Callable,不知道也不关心 data_source 是什么类。add_samples 的回收逻辑放在外层 generate_rollout 里,因为那里才能拿到完整的 data_source 对象。这是个解耦设计。
第二件事:train 与 eval 分流。 两条路径对第二个返回值的处理恰好相反——train 用 aborted_samples 接住并回收,eval 用 _ 直接丢弃。评估只关心完整跑完的轨迹,半截的留着没有意义。
第三件事:partial rollout 的回收。 这是本节的核心,但要先把两件事说清楚。
data_source 是什么? --data-source-path 的默认值是 slime.rollout.data_source.RolloutDataSourceWithBuffer。
用户可以通过 --data-source-path 替换为自定义类,但自定义类若继承自只读基类 RolloutDataSource 却不覆盖 add_samples,开了 --partial-rollout 后调用 add_samples 会立刻 raise RuntimeError——这是框架防止”静默丢弃半成品”的一道硬保护。
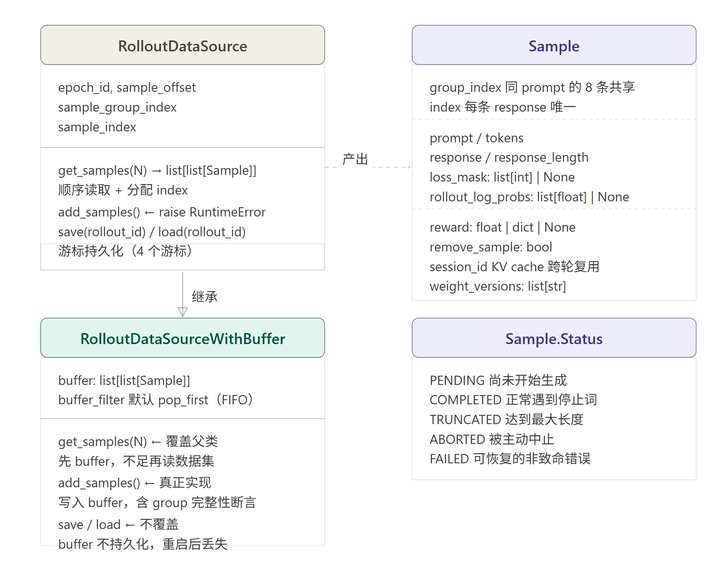
【图示】数据层类图
RolloutDataSourceWithBuffer 在只读基类之上加了一个 buffer。
- get_samples(N) 的策略是先从 buffer 取、不够再从基础数据集取;
- add_samples 把半成品追加到 buffer 末尾,下一轮 get_samples 时优先取出。
关于索引分配:get_samples 里 group_index 在外层循环(每个 prompt)递增,index 在内层循环(每个 response)递增——同一个 prompt 的 8 条 sample 共享同一个 group_index**,但各有独立的** index**。**半成品被回收时带着上一轮的 index,这就是 generate_rollout_async 末尾用 sorted(data, key=lambda g: g[0].index) 排序的原因:半成品的 index 来自上一轮、本轮新生成的 index 来自本轮,排序后半成品自然排在新 sample 之前,保证确定性顺序。
还有一个取舍值得一提:RolloutDataSourceWithBuffer 没有覆盖 save / load 方法,buffer 的内容不参与断点续训。训练中断重启后 buffer 是空的,飞行中的半成品丢失,下一轮从基础数据集重新取 prompt 生成。
abort 什么时候才会发生?
partial rollout 这里是 dynamic sampling 的配套机制,不开dynamic sampling,开partial rollout默认场景没有意义。
dynamic sampling 要求同时配置 --over-sampling-batch-size(必须大于 rollout_batch_size)和 --dynamic-sampling-filter-path:前者让飞行请求数超过 target,后者在 group 完成时实时 filter、否决不符合条件的 group 并触发补采。在这个过程中,当 data 已经凑够 32 个有效 group、state.pendings 里还有大量飞行中的请求——这些请求被 abort,产生半成品。–partial-rollout 的作用就是把这些半成品回收到 buffer、而不是直接丢弃。
标准 GRPO 不开 dynamic sampling:over_sampling_batch_size 默认等于 rollout_batch_size,所有 group 都通过 filter(fn is None 时 call_dynamic_filter 直接返回 keep=True),pendings 退出时恰好为空,abort() 是空操作,aborted_samples 是空列表,if aborted_samples: 不成立,add_samples 根本不会被调用,buffer 始终为空。
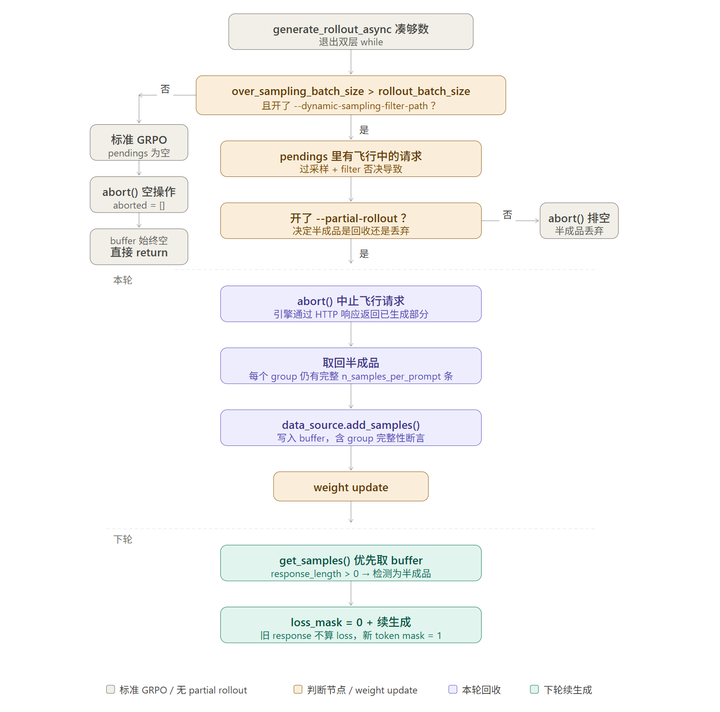
【图示:partial rollout 控制流图】
dynamic sampling + partial rollout 开启时的触发流程:
本轮: generate_rollout_async 凑够 32 个有效 group
       → state.pendings 里仍有飞行中的请求(过采样导致)
       → abort() 中止飞行请求
       → 引擎把已生成部分通过 HTTP 响应自然返回,形成半成品
       → aborted_samples(list[list[Sample]],每个 group 仍有完整 8 条)
       → data_source.add_samples() 写入 buffer

       weight update(新权重同步到引擎)

下一轮: data_source.get_samples() 优先从 buffer 取出半成品
       → generate_and_rm 检测 response_length > 0
       → loss_mask = [0] × response_length(旧策略产出,不算 loss)
       → 续生成,新 token 追加 loss_mask = [1, 1, ...]
add_samples 里有一道断言:每个 group 必须恰好有 n_samples_per_prompt 条 sample。这意味着 abort 的粒度是 group——generate_and_rm_group 用 asyncio.gather 等齐整组再返回,保证不存在”半个 group”的情况,两个设计互相配套。
–partial-rollout 是个总开关,它同时控制三处行为:abort() 是否收集半成品(不开就排空 pending 不收集);generate_and_rm 是否检测 response_length > 0 并置 loss_mask=0;默认 generate 函数是否对新生成的 token 增量追加 loss_mask。任何一处缺失,整条链路都不对。这个闭环的下半截(续生成侧的 loss_mask 处理)在 4.5 节展开。
**以上关于 abort 和 partial rollout 的描述,均针对默认的 generate_rollout 实现。**替换 --rollout-function-path 后,这套机制整体失效,由用户函数自行决定如何处理未完成的请求——fully_async_rollout 就是一个完全不同的例子:它不 abort 飞行请求,而是把含 ABORTED sample 的 group 整体塞回 buffer 重试。
4.2 双层 while:dynamic sampling 的自动补偿
上一节讲了 partial rollout 闭环的”触发条件”——dynamic sampling 凑够 32 个有效 group 之后,pendings 里残留的飞行请求被 abort。但**“凑够 32 个有效 group”这件事本身怎么发生**?答案就是 generate_rollout_async 的双层 while——dynamic sampling 的核心实现。
target_data_size = args.rollout_batch_size      # 本文 = 32
state.reset()                                    # remaining_batch_size 初始化为 0

while len(data) < target_data_size:                          # 外层(消费者)
    while state.remaining_batch_size < target_data_size:     # 内层(生产者)
        samples = data_source(args.over_sampling_batch_size)
        state.submit_generate_tasks(samples)
        # ↑ submit_generate_tasks 内部:每 group create_task 并入 pendings
        #    同时 remaining_batch_size += len(samples)

    done, state.pendings = await asyncio.wait(state.pendings, return_when=asyncio.FIRST_COMPLETED)
    for task in done:
        group = task.result()
        all_data.append(group)
        dynamic_filter_output = call_dynamic_filter(dynamic_filter, args, group)
        if not dynamic_filter_output.keep:
            state.remaining_batch_size -= 1                  # 触发内层补充
            continue
        if len(data) < target_data_size:
            data.append(group)
⭐ 这是个生产者-消费者模型:
- 生产者(内层 while)从 data_source 拉数据、submit_generate_tasks 把生成任务塞进 state.pendings
- 消费者(外层 while)从 state.pendings 取完成的 group 处理
- state.pendings 是队列,承载飞行中的 task
三个变量都以 group 为单位(本文一个 group = 同一 prompt 的 8 条 sample):
| 变量 | 含义 |
|---|---|
| target_data_size | 目标——要凑够多少个通过 filter 的有效 group(本文 32) |
| data | 已收集的、通过 dynamic filter 的有效 group |
| state.remaining_batch_size | 当前已提交、预计将通过 filter 的 group 数 |
⭐ remaining_batch_size 的含义是 “当前已提交、预计将通过 filter 的 group 数” ——也就是按当前提交量预期能产出多少个可用于训练的有效 group。它的三种变化:
- submit_generate_tasks 里 += len(samples):每提交 N 个新任务、先记入这 N 个预期产出
- dynamic filter 否决一个 group 时 -= 1:这个 group 不会通过、修正预期产出、生产者需要补一个
- 通过 filter 进 data 时不变:它本来就在预期产出里、实际产出兑现预期、不需要修正
⭐ 这个定义让两种场景共用同一份代码:
- 标准 GRPO(不开 dynamic sampling):dynamic_sampling_filter_path 为 None,call_dynamic_filter 在 fn is None 时直接返回 keep=True——所有 group 都通过、-= 1 路径从未触发,remaining_batch_size 就是”已提交 group 数”,内层 while 退出后 = target、外层 while 等齐所有 task 进 data、循环结束。
- DAPO 式过采样(开 dynamic_sampling_filter):被否决的 group 让 remaining_batch_size 下降、生产者补充,直到所有”预期产出”都落实。
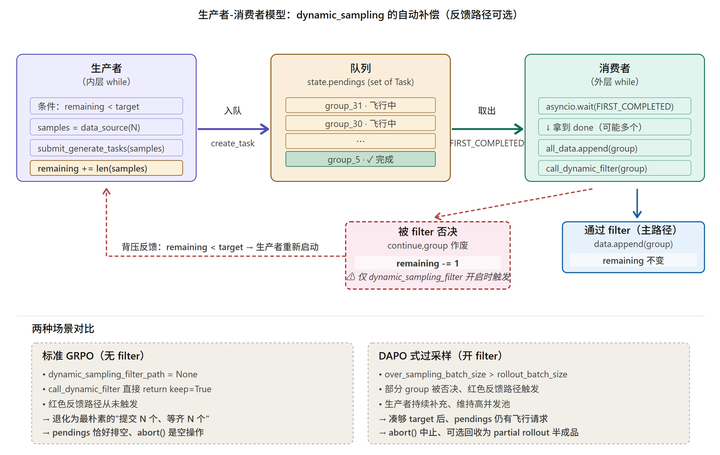
【图示】数据处理循环
⭐ 这里有一个 slime的取舍:判断条件与并发完成的冲突。
外层循环用 asyncio.wait(…, return_when=FIRST_COMPLETED) 等待任务完成。但“第一个完成”不等于“只有一个完成”——网络延迟波动、asyncio 调度、引擎批量返回都可能导致 done 集合里同时有多个 task。
问题场景:假设当前 len(data) = 31,target = 32,还差 1 个 group 就满了。此时一批 3 个 group 同时完成,且都通过了 dynamic filter:
| 顺序 | 操作 | len(data) 变化 | 结果 |
|---|---|---|---|
| 第 1 个 group | len(data) < 32 为真,data.append() | 31 → 32 | ✅ 进入训练集 |
| 第 2 个 group | len(data) = 32,len(data) < 32 为假 | 32(不变) | ❌ 被护栏拦下 |
| 第 3 个 group | 同上 | 32(不变) | ❌ 被护栏拦下 |
3 个 group 都已从 pendings 中取出(asyncio.wait 返回的 done 已从集合中移除),但只有 1 个进了 data。外层 while 检查 32 < 32 不成立,循环退出。
后 2 个 group 的命运:
- 不在 data 里 → 不参与训练
- 不会被 abort() 回收 → 已完成,不是半成品
- 在 all_data 里有记录 → 可通过钩子访问
代码中的all_data 记录的是所有完成的 group,无论它们后续是否被 filter 否决、是否被护栏拦下。
all_data.append(group) # 在 filter 判断和护栏判断之前执行
可以通过–rollout-all-samples-process-path Hook——用户可以在所有生成完成后对 all_data 做统计分析(如过滤率、质量分布),而 data 只包含最终进入训练集的样本。
代码注释点明了这个取舍:
# NOTE: here we have not stored all the unused samples back to the data buffer.
slime 回收的只有 abort() 出来的半成品。已经完整跑完、但不会进入本轮训练集的 group 有两类——被 dynamic filter 否决的、以及 FIRST_COMPLETED 一次返回多个、凑够 target 后超出的——它们都留在 all_data 里被丢弃,除非用户通过 rollout_all_samples_process_path 钩子主动处理。
两类损耗的性质不同:
- filter 否决是 dynamic sampling 的算法成本(主动剔除不符合标准的 group);
- 超出 target 才是异步并发下的固有损耗(FIRST_COMPLETED 的批量返回特性)。
后者在不开 dynamic sampling、over_sampling_batch_size = rollout_batch_size 时降为 0,前者只要开了 filter 就总会发生。
while 循环结束后的收尾——四步:
aborted_samples = await abort(args, rollout_id)         # 1. 中止并(可选)收集半成品
assert len(data) == args.rollout_batch_size              # 2. 验收
data = sorted(data, key=lambda g: g[0].index)            # 3. 按 index 排序保证确定性
all_samples = sorted(all_data, key=lambda g: g[0].index) #    (为钩子准备)
state.reset()                                            # 4. 清状态
⭐ state.reset() 必须在 abort() 之后——如果先 reset,state.pendings 被清空,abort() 就找不到要中止的飞行请求了。
4.3 GenerateState:单例与三套并发机制
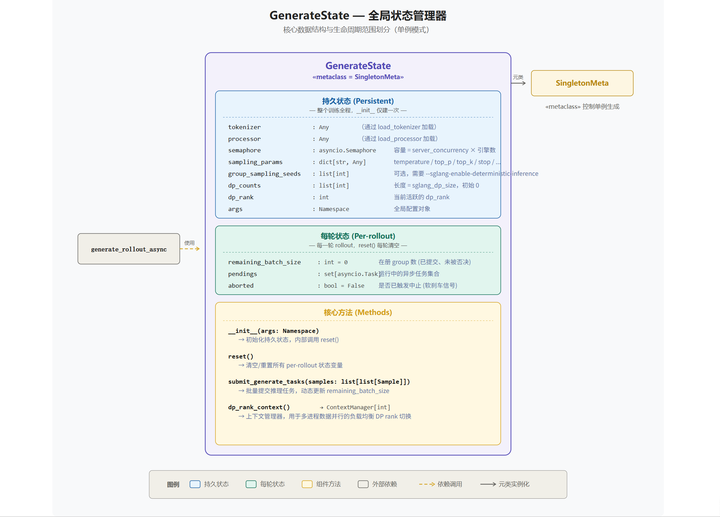
【图示】GenerateState类图
GenerateState 是整个生成流程的状态容器,双层 while 里的 state.xxx 全部来自它。它用单例模式实现,但目的不是"保证全局唯一"本身——而是借此把状态自然切成两层:persistent 状态只在第一次构造时初始化,per-rollout 状态每轮由 reset() **清零。**单例保证"第一次构造"真的只发生一次,后续轮次拿同一个实例,persistent 状态才能真正跨轮复用。
class GenerateState(metaclass=SingletonMeta):
    def __init__(self, args):
        self.tokenizer = load_tokenizer(...)
        self.processor = load_processor(...)
        self.semaphore = asyncio.Semaphore(
            args.sglang_server_concurrency * args.rollout_num_gpus // args.rollout_num_gpus_per_engine
        )
        self.sampling_params = dict(temperature=..., top_p=..., ...)
        if getattr(args, "sglang_enable_deterministic_inference", False):
            self.group_sampling_seeds = [args.rollout_seed + i for i in range(args.n_samples_per_prompt)]
        self.dp_counts = [0] * (args.sglang_dp_size or 1)
        self.reset()

    def reset(self):
        self.remaining_batch_size = 0
        self.pendings = set()
        self.aborted = False
⭐ init 和 reset() 的分工,就是 persistent 状态和 per-rollout 状态的分界线:
| 类别 | 内容 | 生命周期 |
|---|---|---|
| Persistent | tokenizer / processor / semaphore / sampling_params / dp_counts / group_sampling_seeds | 整个训练全程,init 建一次 |
| Per-rollout | remaining_batch_size / pendings / aborted | 一轮 rollout,reset() 每轮清 |
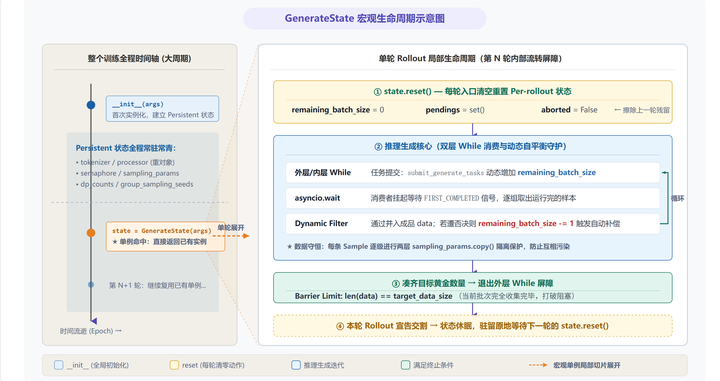
【图示】GenerateState声明周期图
单例的意义在于:**tokenizer 是重对象,加载一次要读模型配置。**SingletonMeta 保证第二轮以后 GenerateState(args) **直接返回已有实例。**所以 generate_rollout_async 开头那句 state = GenerateState(args) 看起来像新建,实际上第一轮真建,后续轮次拿同一个。
sampling_params 是个 dict,跨 rollout 复用——但有两层独立的 copy 保护:
- 第一层在 submit_generate_tasks 提交 group 级任务时(sampling_params=self.sampling_params.copy()),防止不同 group 间互相覆盖;
- 第二层在 generate_and_rm_group 的 for 循环里,为 group 内每条 sample 各自再 copy 一次(current_sampling_params = sampling_params.copy()),防止同 group 内 sample 间互相污染。
两层 copy 各管各的粒度,每条 sample 最终拿到的都是完全独立的副本。
GenerateState 上挂着三套并发相关的机制。第一套是双层 while 的生产者-消费者模型(4.2 节讲过)。
第二套:semaphore
self.semaphore = asyncio.Semaphore(
    args.sglang_server_concurrency * args.rollout_num_gpus // args.rollout_num_gpus_per_engine
)
⭐ 这是个 asyncio.Semaphore(不是 threading.Semaphore)——用 async with 获取,获取不到时协程挂起、让 event loop 调度别的协程,不阻塞线程。这呼应上篇 3.4 节的“绝不阻塞 event loop”主线。
拆开来看三个参数:
| 参数 | 本文值 | 含义 |
|---|---|---|
| sglang_server_concurrency | 32 | 每个 SGLang 引擎同时能处理的请求数上限(SGLang 的 --max-running-requests) |
| rollout_num_gpus | 4 | 分配给推理的总 GPU 数 |
| rollout_num_gpus_per_engine | 2 | 每个引擎占用的 GPU 数(TP 大小) |
引擎数 = rollout_num_gpus // rollout_num_gpus_per_engine = 4 // 2 = 2
semaphore 容量 = 每引擎并发上限 × 引擎数 = 32 × 2 = 64
⭐ 公式的本质是:把所有推理引擎的并发能力加起来,作为客户端侧的总并发上限。
理论上,一次 rollout 可能产生的并发请求数远大于 64:
32 个 group × 8 条 sample/group ×(多轮工具调用,如 3 轮)= 768 个请求
semaphore 的作用是:只允许 64 个请求同时“在飞”,剩余的请求在 semaphore 的等待队列里排队。每完成一个请求,就从队列里放一个进去。
async with state.semaphore:      # ← 获取不到时,协程在这里挂起排队
    sample = await custom_generate(...)   # ← 只有拿到槽位的才能执行
两层并发控制的分工:
| 闸门 | 控制粒度 | 单位 | 本文容量 | 作用 |
|---|---|---|---|---|
| 双层 while / remaining_batch_size | 在册 group 数 | group | ≈ 32 | 保证训练集凑够数,不控制请求洪峰 |
| semaphore | 同时在飞的请求数 | request | 64 | 限制引擎的并发数 |
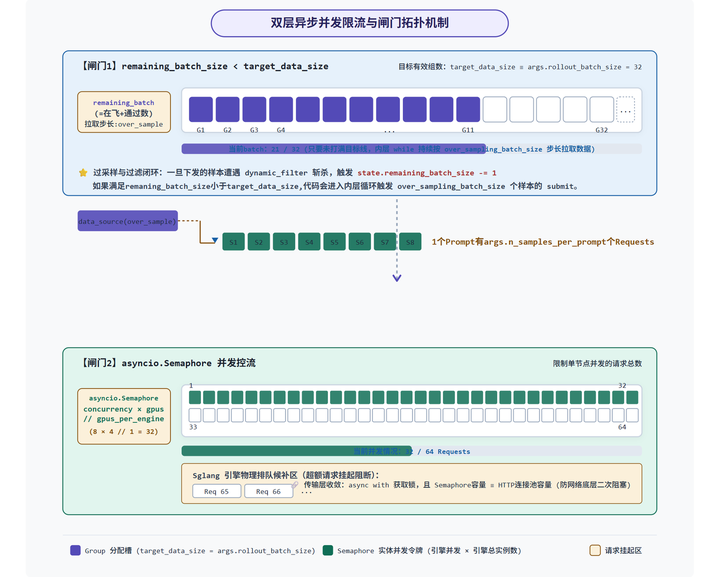
【图示】两层阀门
⭐ 上篇 3.4 节讲过 HTTP 连接池容量用的是完全一样的公式:sglang_server_concurrency * rollout_num_gpus // rollout_num_gpus_per_engine。semaphore 是逻辑层并发闸门,连接池是传输层上限。两者相等保证 semaphore 是唯一的并发闸门。
第三套:dp_rank_context——多 DP rank 场景的负载均衡
先区分两个概念:
- 本文的多实例:rollout_num_gpus=4, rollout_num_gpus_per_engine=2 → 2 个完整的 SGLang 引擎(每个是 TP=2 的完整模型副本)。负载均衡由 sgl-router 负责
- 多 DP rank:通过 --sglang-dp-size 开启,同样是起多个完整模型副本,但负载均衡策略由框架控制——需要保证同一个 prompt 的多条 sample 路由到同一个副本(共享 KV cache),或者按各 rank 的实时负载动态分配
本文配置未开 --sglang-dp-size,走的是 sgl-router 负载均衡,dp_rank_context 退化成空操作(dp_counts 长度为 1,理论上永远返回 rank 0)。下面只是展示它的设计:
@contextmanager
def dp_rank_context(self):
    candidates = [i for i, count in enumerate(self.dp_counts) if count == min(self.dp_counts)]
    dp_rank = int(np.random.choice(candidates))
    self.dp_counts[dp_rank] += 1
    try:
        yield dp_rank
    finally:
        self.dp_counts[dp_rank] -= 1
dp_counts 记录每个 DP rank 当前正在处理的请求数。dp_rank_context 是一个引用计数式的负载均衡器:
- 找出 dp_counts 中并发数最小的所有 rank(最空闲的)
- 随机选一个(避免 argmin 永远选同一个)
- += 1 占用 → yield → 退出时 -= 1 释放
调用方拿到 dp_rank 后,可以据此路由请求(比如保证同 prompt 的多条 sample 发往同一副本)。
三层并发机制总结:
| 机制 | 控制粒度 | 本文是否生效 | 作用 |
|---|---|---|---|
| 双层 while / remaining_batch_size | group | ✅ | 凑够训练集数量,自动补偿 filter 否决 |
| semaphore | request | ✅ | 限制同时飞的请求数,保护下游引擎 |
| dp_rank_context | DP rank | ❌(走 sgl-router 负载均衡) | 多 DP rank 场景下框架侧负载均衡 |
4.4 group 并发与三层嵌套:从机制到运行时
4.3 节交代了 GenerateState 上挂的三套并发机制有什么。本节看 generate_and_rm_group 和 generate_and_rm 怎么把它们用起来——一次 rollout 同时存在 rollout 级、group 级、sample 级三种并发粒度,每一层做出的并发决策都不同,本节看这些决策的依据。
4.4.1 group 入口的两件事:状态短路与亲和性
generate_and_rm_group 在创建任何 task 之前,先做两件事:
state = GenerateState(args)

# 第一件:状态短路
if state.aborted:
    return group

# 第二件:session_id 分配(已有的不覆盖)
for sample in group:
    if sample.session_id is None:
        sample.session_id = str(uuid.uuid4())
第一件——状态短路。
4.1 节讲过 abort() 做的事:设 state.aborted = True,等已在 pendings 的 task 结束。但 abort 触发的瞬间还有一类 group 不在 pendings 里——刚从生产者侧出来、正进入 generate_and_rm_group 的 group。它们既不在飞、也没被 abort() 主动处理,完全依赖自己检查 state.aborted 标志主动退出。
⭐ 如果不检查,这个 group 会照常创建 8 个 task、占 8 个 semaphore 槽位、发 8 个 HTTP 请求、跑完后产出没人要的结果(generate_rollout_async 外层 while 已经退出)。
第二件——session_id 的”按需分配”。
要理解这条机制,先看一个事实:一条 sample 可能跨越多轮 rollout 才走完整个生成过程。上一轮 partial rollout 生成了一半被 abort、回收到 buffer,这一轮取出来接着生成。从客户端代码看是”continue from where it left off”,但从 SGLang 引擎看是两次独立的 HTTP 请求——引擎不知道这两次请求其实是同一条 sample 的前后两段。
session_id 就是给同一条 sample 的多次请求一个统一标识。两种 sample 进入 generate_and_rm_group 时的状态:
| sample 来源 | 进入时 session_id | 这里的行为 |
|---|---|---|
| 首次出现的全新 sample | None | 分配一个新的 uuid |
| 半成品(需要续生成) | 上一轮分配的 uuid | 不覆盖,继续用 |
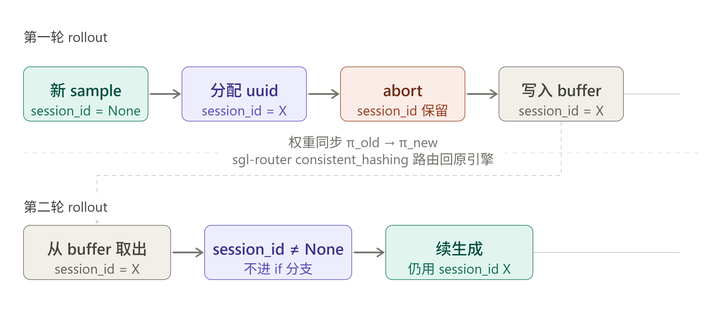
【图示】session_id 在跨轮次流程中的传递
session_id 保留下来用来做什么?
跨轮次的同一标识,被默认 generate 用来做路由决策:
if sample.session_id:
    if getattr(args, "router_policy", None) == "consistent_hashing":
        headers = {"X-SMG-Routing-Key": sample.session_id}
session_id 作为路由键塞进 HTTP header,sgl-router 把同一个 session_id 的所有请求路由到同一个 worker——半成品续生成时会去找上一轮生成它的那个引擎。这就是路由亲和性。
我理解**亲和性兑现的实际价值是 prompt prefix 的 radix cache:SGLang 基于 token 序列前缀做缓存,只要请求的 prompt 在缓存树里能匹配前缀,就跳过这段 prefill 计算。**半成品续生成的输入是 prompt + 上一轮已生成的部分,这段 token 序列和上一轮原引擎处理过的请求有重叠——路由回原引擎能提高命中概率。(这部分暂时没有走读SGlang源码确认,如有出入,还望指正)。
4.4.2 group 内并发:为什么用 gather 而不是 wait
session_id 分配完后,group 内 8 条 sample 创建 task 并发执行:
tasks = []
for idx, sample in enumerate(group):
    current_sampling_params = sampling_params.copy()
    if getattr(args, "sglang_enable_deterministic_inference", False):
        current_sampling_params["sampling_seed"] = state.group_sampling_seeds[idx]
    tasks.append(asyncio.create_task(generate_and_rm(args, sample, current_sampling_params, evaluation=evaluation)))

group = await asyncio.gather(*tasks)
current_sampling_params = sampling_params.copy() 就是 4.3 节提到的内层 copy——seed 注入恰好需要 sample 级粒度,所以它出现在内层 copy 之后是必然的。
但真正值得展开的是 gather 这个选择。上一层(generate_rollout_async 的双层 while)等待方式是 asyncio.wait(…, return_when=FIRST_COMPLETED)。同样是”等多个 task”,为什么选了完全相反的两种语义?
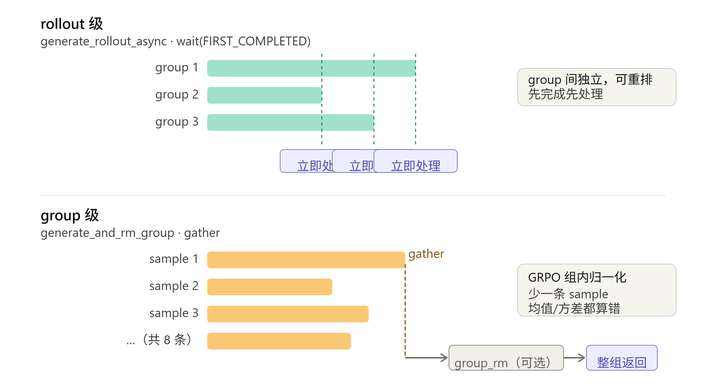
【图示】: 两种等待语义的对照
答案在算法层面:GRPO 的 advantage 计算需要看到 group 内所有 sample 的 reward 才能做组内归一化。
反过来,group 之间是独立的,所以 rollout 级用 FIRST_COMPLETED 最大化吞吐,group 级用 gather 保证完整性。等待语义由算法语义决定。这也是 4.1 节说”abort 粒度是 group”的代码层证据:gather 保证 group 要么完整返回、要么(被 abort 时)整组返回原样,永远没有”半个 group”。
4.4.3 sample 级:进入三层嵌套之前的预处理与早返回
generate_and_rm 是真正发起请求的地方,但函数体前半段有一个预处理步骤和一个早返回,都发生在进入任何并发结构之前:
# 预处理:partial rollout 场景下,把"已有 response"的 loss_mask 全置 0
if args.partial_rollout and args.mask_offpolicy_in_partial_rollout and sample.response_length > 0:
    sample.loss_mask = [0] * sample.response_length

# 早返回:已完成/已截断的 sample 直接复用已有 response,不重新生成
if sample.status == Sample.Status.COMPLETED or sample.status == Sample.Status.TRUNCATED:
    assert sample.response is not None
    if not args.group_rm:
        assert sample.reward is not None
    return sample

# 才进入三层嵌套
state = GenerateState(args)
async with state.semaphore:
    ...
预处理:将旧段 loss_mask 全置 0,不 return,继续往下走。这是 partial rollout mask 构造的前半步,详见 4.5 节。
早返回:处理一种微妙的情况——上一轮 abort 时,某条 sample 恰好已经跑完(COMPLETED/TRUNCATED),随 group 一起进了 buffer。这一轮取出来时根本不需要再生成,直接复用已有 response。
4.4.4 两层嵌套:semaphore、aborted 检查与 dp_rank_context
进入并发结构后,代码是两层嵌套加一次中间检查:
async with state.semaphore:           # 第 1 层
    if state.aborted:                  # semaphore 内的 aborted 检查
        sample.status = Sample.Status.ABORTED
        return sample
    with state.dp_rank_context() as _: # 第 2 层
        ...
4.3 节已经分别介绍过 semaphore 和 dp_rank_context 的机制,本节只看运行时执行时序——为什么是这个顺序,为什么 aborted 检查刻意放在 semaphore acquire 之后。
第 1 层:semaphore acquire——三者中最稀缺的资源(全局 64 个槽位),必须最先 acquire。容量公式和排队机制详见 4.3 节。
aborted 检查为什么放在 acquire 之后——这是本节真正值得展开的点。
一条 sample 可能在 semaphore 队列里排很久(过采样池里 768 个请求等 64 个槽位,平均排队时间不短)。abort 大概率发生在排队期间——本轮凑够数后立刻 abort,但这条 sample 当时还在队列里。把检查放在 acquire 之后,就是把它放在"abort 信号最可能已经到达"的时刻:拿到槽位的瞬间发现 aborted、立刻 return 让出槽位,避免完整跑完一次产出没人要的请求。
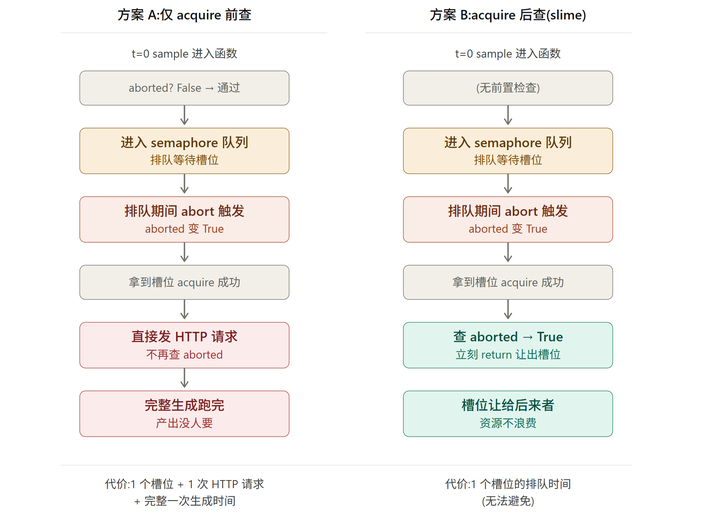
【图示】aborted 检查位置对比
第 2 层:dp_rank_context。 确定要执行之后才选路由——多 DP rank 时挑当前最闲的 rank,引用计数式负载均衡(详见 4.3 节)。本文配置未开 --sglang-dp-size,退化为空操作。
三者的顺序由”资源稀缺程度”决定:semaphore 槽位全局共享、最稀缺,最先抢;aborted 是对已拿到槽位的二次验证,紧跟其后;dp_rank 是执行前的路由选择,确认要跑了才做。
4.4.5 generate 的选择与默认实现
dp_rank_context 内层做的事是选择并调用 generate 函数:
custom_func_path = getattr(sample, "generate_function_path", None) or args.custom_generate_function_path

if custom_func_path is not None:
    custom_generate_func = load_function(custom_func_path)
    if "evaluation" in inspect.signature(custom_generate_func).parameters:
        sample = await custom_generate_func(args, sample, sampling_params, evaluation=evaluation)
    else:
        sample = await custom_generate_func(args, sample, sampling_params)
else:
    sample = await generate(args, sample, sampling_params)
两个细节:
- getattr 加默认值 None 而非直接访问属性,是防御性写法——generate_function_path 是 Sample 上的可选字段,不存在时退回 None,走全局的 args.custom_generate_function_path。
- per-sample 路径优先于 per-rollout 配置,多数据集混合时可以在同一个 rollout 里混用不同生成逻辑;
第5章详细介绍默认generate和custom_generate_function_path的实现和差异。
4.5 partial rollout 的正确性:loss_mask 是怎么保证训练信号纯净的
4.1 节给出了 partial rollout 的触发流程(dynamic sampling 凑够数 → abort → 半成品流回 → 下一轮续生成),并指出 --partial-rollout 总开关同时控制三处行为:abort 是否收集半成品、generate_and_rm 是否检测 response_length > 0 并置 loss_mask=0、默认 generate 是否对新 token 追加 loss_mask。本节回到这个闭环的下半截——后两处行为如何让 partial rollout 在算法上成立、又是如何把这件事的影响传递到训练侧的。
4.5.1 partial rollout 解决什么问题
partial rollout 是 RL 训练里的经典特性,verl、slime 等主流框架都有实现。它是一个通用机制——把被中止的请求的”已生成部分”保留下来,下一轮接着生成,避免已经付出的生成成本被浪费。
不同场景引入这个机制的出发点不同。本文聚焦 slime 默认配置走的路径:配合 DAPO 的 dynamic sampling 使用。文末会简要对比另一种用法(Full Async + 新鲜度策略)。
slime 的场景:DAPO 过采样的副作用回收
DAPO 这类算法常配合 dynamic sampling 使用——给定 rollout_batch_size = 32(每轮训练要 32 个有效 group),推理侧实际提交的样本数会更多,比如 over_sampling_batch_size = 48。这是因为不是每个 group 都会通过 dynamic filter,所以会根据情况多生成一些以保证”有效产出”达到 32(4.2节详细介绍过)。
⭐ 这个机制的物理后果:当训练 batch 凑够 32 个有效 group 时,推理侧还有飞行中的请求。它们在算法上已经没用了——下一步训练只消费 32 个,多出来的即使跑完也不会被用上。slime 调用 abort() 立刻中止这些飞行中的请求(4.1 节讲过)。
但 abort 之后还有一个问题:这些被 abort 的请求,已经生成了一部分 token,要不要保留?
最简单的处理是整条丢掉、下一轮重新抽 prompt 生成,但这意味着已经付出的生成成本被浪费——被 abort 的请求可能已经跑了大半,这部分 GPU 时间一笔勾销。过采样比例越高、被 abort 的请求越多,浪费的总成本就越显著。
partial rollout 的处理是把 abort 的样本”已生成的部分”塞回 buffer,下一轮取出来续生成——半成品作为 context 复用,下一轮只需生成剩下的部分。
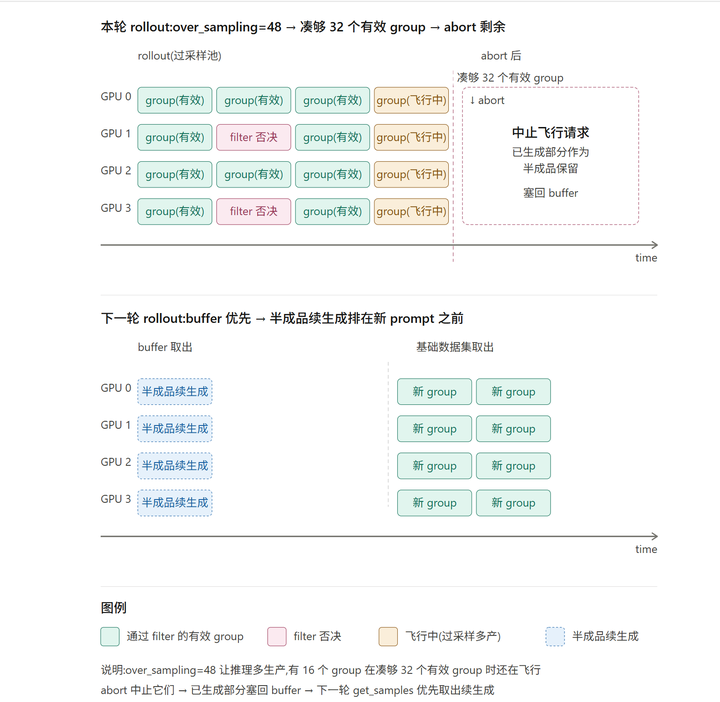
【图示】DAPO 过采样的副作用回收
⭐ 关键细节:这些半成品在下一轮是”优先处理”的。RolloutDataSourceWithBuffer.get_samples(N) 先从 buffer 取、不够再从基础数据集取——半成品总是排在新 prompt 之前。
另一种用法:Full Async + 新鲜度策略
partial rollout 作为通用机制,在另一种场景下出发点完全不同——典型是 verl 的 Full Async 架构。
那里的主要问题是长尾 sample 拖累训练节奏:batch 内不同 sample 生成时间差异极大,等齐才训练意味着推理 GPU 大量空转、训练 GPU 长时间空闲。Full Async 引入”新鲜度策略”(staleness > 0)让训练不必等齐推理,但仍然需要解决一个工程问题——参数同步必须把飞行中的请求停下,这时还在跑的长尾样本怎么处理?如果直接丢,长尾的生成成本浪费;partial rollout 让长尾续到下一轮跑完。
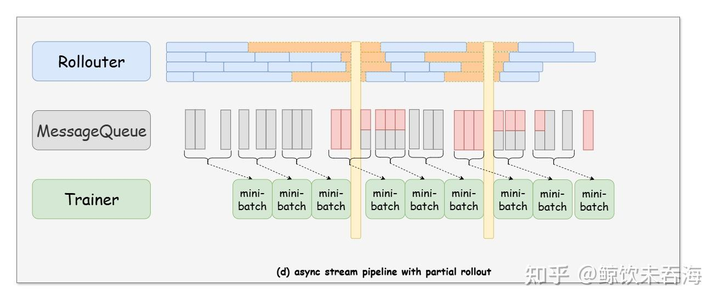
【图示】full async partial rollout
⭐ 同样是 partial rollout,两种场景的出发点完全不同:slime 默认场景从”过采样副作用”出发,Full Async 场景从”长尾问题”出发。共同点是底层的”半成品回收 + 续生成”机制。
还有一个独立的问题:已生成段的训练价值
无论 partial rollout 用于哪种场景,把半成品续生成完之后,这条 sample 里都会有两段 token:旧段(上一轮 π_old 生成)和新段(这一轮 π_new 生成)。这两段在训练时如何使用?
直接对旧段算 loss、回传梯度理论上是不行的——这等于用新策略的梯度去训练旧策略产出的 token,违反 on-policy 假设。所以必须做点什么。”做什么”有几种方案:
- 直接丢弃训练价值:把旧段的 loss_mask 全置 0,旧段只作 context 不贡献梯度。实现一行代码,数值稳定,代价是这段 token 不参与训练
- IS 校正:给旧 token 算 π_train / π_rollout 的比值乘到 advantage 上,旧段也贡献训练信号;同时用拒绝采样和 token veto 兜底极端权重
⭐ slime 框架在这件事上不做强制规定——它提供两个开关(partial_rollout 总开关、mask_offpolicy_in_partial_rollout 子开关)、Sample 数据结构里的 loss_mask 字段、generate_and_rm 里的 mask 置 0 钩子,但不强制 generate 函数怎么用这些钩子。
**默认 generate 函数(**sglang_rollout.py **里)给了一个最简基线——”直接丢弃训练价值。**但用户函数可以走完全不同的路径,甚至完全禁用 partial rollout(retool 就这么做,4.6 详谈)。
接下来 4.5.2-4.5.4 要讲的就是默认 generate 这条”直接丢弃”路径是怎么实现的——这是 slime 提供的参考实现,也是理解 loss_mask 机制最简单的入口。
4.5.2 半成品的路由与默认 generate 的 mask 两步构造
默认 generate 的”直接丢弃”路径由两步配合完成。
步骤 1 在 generate_and_rm 开头(这是框架代码,所有 generate 函数都会经过):
# 第一步:把"已有 response"的 loss_mask 全置 0
if args.partial_rollout and args.mask_offpolicy_in_partial_rollout and sample.response_length > 0:
    sample.loss_mask = [0] * sample.response_length

# 第二步:已完成的 sample 直接返回,不重复生成
if sample.status == Sample.Status.COMPLETED or sample.status == Sample.Status.TRUNCATED:
    assert sample.response is not None
    if not args.group_rm:
        assert sample.reward is not None
    return sample
判据是 sample.response_length > 0:全新 sample 经过 data_source.get_samples 出来时 response_length = 0,只有从 buffer 取出的半成品才大于 0。⭐ 一个整数比较完成路由,不需要额外标记字段。四种情况:
| sample 来源 | response_length | status | 第一步 | 第二步 | 最终行为 |
|---|---|---|---|---|---|
| 全新 sample | 0 | PENDING | ❌ | ❌ | 进入生成流程 |
| 半成品(abort 时仍在生成) | > 0 | ABORTED | ✅ mask=[0]×N | ❌ | 续生成 |
| 半成品(abort 时刚好跑完) | > 0 | COMPLETED | ✅ mask=[0]×N | ✅ | 直接 return |
| 半成品(已截断) | > 0 | TRUNCATED | ✅ mask=[0]×N | ✅ | 直接 return |
需要注意的是,步骤 1 是框架代码,所有 generate 函数都会经过——但用户函数可以无视这个 mask(自己重新构造、或者完全不用 loss_mask)。
⭐ 第一步把旧段 mask 置 0 后,这段 token 仍然作为 context 参与续生成(模型必须看到前文才能续写),但不参与梯度回传。
步骤 2 在默认 generate 内部(这只是默认实现的选择,用户函数完全可以不这么做):
# 默认 generate 内,每次续生成都执行
if sample.loss_mask is not None:
    assert args.partial_rollout and args.mask_offpolicy_in_partial_rollout
    sample.loss_mask += [1] * len(new_response_tokens)
两步配合的最终效果:
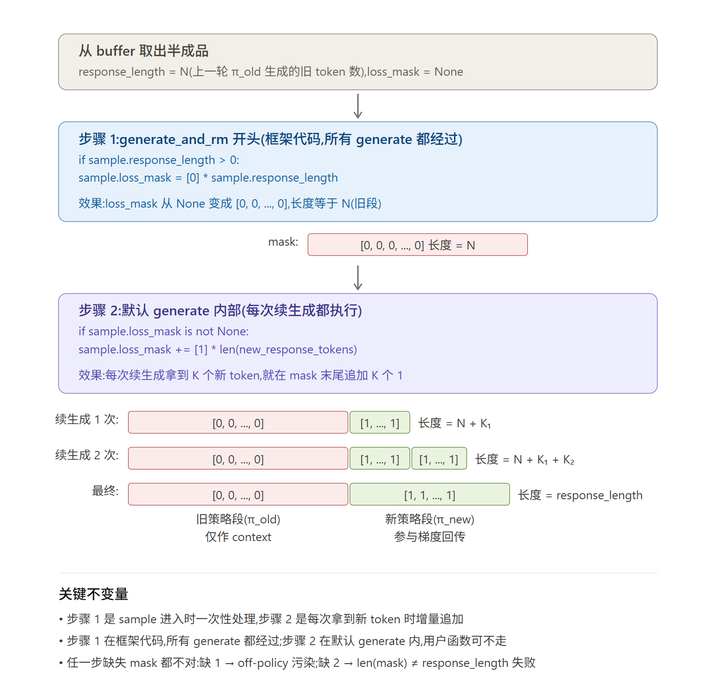
【图示】mask的构造
⭐ 默认 generate 一次调用只追加一次 [1]****(一次性返回全部新 token),图中“多次续生成”在默认路径下不会发生;多轮工具调用(如 retool)才可能多次追加,但本文所参考的 retool 禁用了 partial rollout
步骤 2 的代码里有个 assert 值得单独拎出来:
if sample.loss_mask is not None:
    assert args.partial_rollout and args.mask_offpolicy_in_partial_rollout
    sample.loss_mask += [1] * len(new_response_tokens)
⭐ 它在守护一个不变量:在默认 generate 里,loss_mask 被赋值的唯一合法路径就是 partial rollout 的两步构造。逻辑展开:
loss_mask is not None  ⟹  开了 partial_rollout 的两步构造
                        ⟹  旧段 mask=0 已置好(步骤 1)
                        ⟹  新段 mask=1 增量追加(步骤 2,正在做)
4.5.3 rollout 侧交付给 trainer 的契约
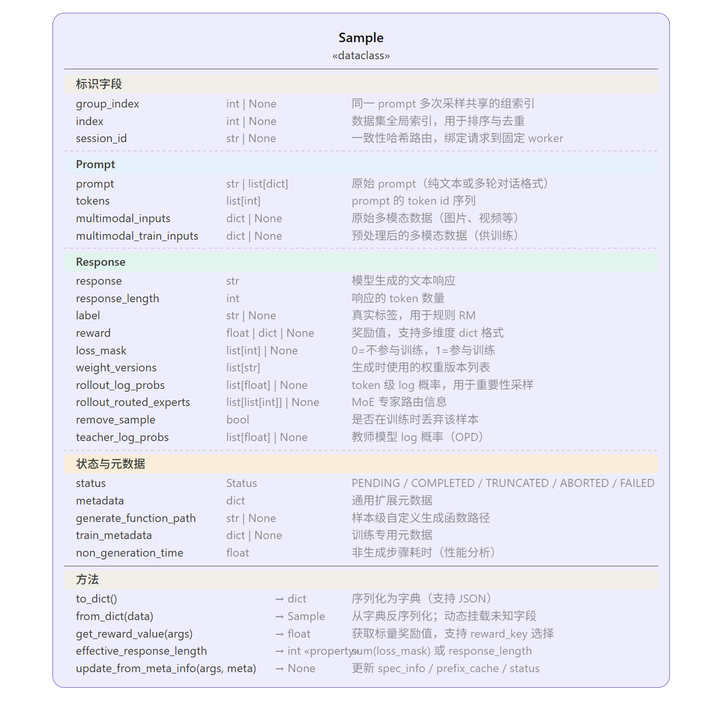
【图示】Sample类图
rollout 侧把 sample 完整生成完后,交付给 trainer 的就是一个 Sample 实例。和 loss_mask 直接相关的字段:
loss_mask: list[int] | None = None    # 0 = 忽略,1 = 计算
response_length: int = 0              # 响应的 token 数

@property
def effective_response_length(self):
    """有效响应长度:若有 loss_mask 则返回参与训练的 token 数,否则返回总响应长度。"""
    return sum(self.loss_mask) if self.loss_mask is not None else self.response_length
⭐ effective_response_length 这个 property 就是 loss_mask 对训练实际生效的第一个可见证据——参与训练的 token 数 = mask=1 的位置数。
这和前文默认 generate 那个 assert 的逆否命题完全对上:
没开 partial rollout 时 loss_mask 是 None,trainer 看到 None 就用全长 response_length 当作有效长度(等价于全 1 mask);开了 partial rollout(或用户函数主动构造了 mask),trainer 看到具体的 0/1 列表就只统计 mask=1 部分。
partial rollout 对周边字段的隐式约束。partial rollout 不只影响 loss_mask,还约束了所有”统计类”字段必须支持跨多次生成累加。看 Sample.update_from_meta_info:
def update_from_meta_info(self, args, meta_info):
    if args.sglang_speculative_algorithm:
        # partial rollout 场景下不能直接使用 sglang 返回的累计投机解码统计,
        # 需通过 add 方法逐步累加以保证多段生成的统计正确性
        self.spec_info.add(meta_info=meta_info)

    self.prefix_cache_info.add(meta_info=meta_info)

    if "weight_version" in meta_info:
        self.weight_versions.append(meta_info["weight_version"])
⭐ weight_versions 是个 list 而不是单个字符串——直接表达了”一条 sample 的不同 token 段可能由不同权重版本生成”这个 partial rollout 的本质事实。
小结
本章拆解了 slime 推理控制流的运行时形态,从 generate_rollout 同步入口一路深入到 generate_and_rm 内部的并发结构。核心观察有四点:
一是双层 while 的设计统一了两种场景——remaining_batch_size 的含义是”当前已提交、预计将通过 filter 的 group 数”,标准 GRPO 下 filter 退化为恒真、-= 1 路径从未触发,循环行为坍缩为最朴素的”提交 N 个、等齐 N 个”;DAPO 过采样下被否决的 group 触发生产者补充。
二是三套并发机制各管各的粒度:双层 while 的 remaining_batch_size 控制 group 级生产消费、semaphore 控制 request 级在飞数量、dp_rank_context 控制多 DP rank 场景下的路由选择。semaphore 容量公式与上篇 3.4 节 HTTP 连接池容量完全一致,保证逻辑闸门与传输层上限对齐。
三是等待语义由算法需求决定:rollout 级用 FIRST_COMPLETED 最大化吞吐、group 级用 gather 保证 group 完整性——后者既是 dynamic_filter 在 group 粒度判断的前提,也是 abort 粒度是 group、add_samples 断言每组恰好 N 条的代码层根据。
四是partial rollout 的正确性靠 loss_mask 两步构造:generate_and_rm 把旧段 mask 全置 0,默认 generate 对新 token 增量追加 mask=1,两步配合让续生成的样本里旧段只作 context、新段贡献训练信号。slime 框架本身不强制如何处理 off-policy 段,只提供 loss_mask 字段、mask_offpolicy_in_partial_rollout 开关、update_from_meta_info 累加接口这些钩子——具体策略由 generate 函数自己决定。
至此 rollout 内部的调度、并发、正确性三条线都已走读完毕,第 5 章把视角切到框架外,看用户函数怎么在这些钩子上写自己的实现。
5 自定义 generate 函数:从默认实现到 retool
第 4 章讲的都是框架内部——rollout 入口、双层 while、并发结构、partial rollout 正确性。本章视角切换到框架外:如果你要写一个自定义 generate 函数,框架退场后你要承担什么。
⭐ 本章定位:默认 generate 是 demo,retool 是扩展实例;两者中间的差异就是”自定义”这件事的全部内容。
需要事先说明:retool 实际代码包含 PRM(process reward model)子系统——独立的 router、独立的 tokenizer、多轮投票打分等。本章为了聚焦”自定义 generate 的核心责任”,所有 PRM 相关内容一律省略。retool 在本章里只展示工具调用和多轮循环这条主线。
相关代码链接:OpenClaw-RL/toolcall-rl/generate_with_retool.py
5.1 扩展点与默认实现
写 generate 函数前先看框架给你什么。
框架通过 load_function 按路径字符串动态加载用户函数,并直接调用。这意味着函数签名是强约束:参数和返回值必须与框架期望一致,否则运行时崩溃。
retool 和默认 generate 的签名完全相同:
# 默认 generate (sglang_rollout.py)
async def generate(args, sample: Sample, sampling_params) -> Sample:
    ...

# retool generate (generate_with_retool.py)
async def generate(args, sample: Sample, sampling_params) -> Sample:
    assert not args.partial_rollout, "..."
    ...
- args:全局配置
- sample:输入样本,也是输出容器
- sampling_params:采样参数
框架和用户函数之间只有两个信息通道:
- args 传配置:router 地址、采样参数、各种开关
- sample 作为数据契约:既是输入也是输出
默认 generate:最简参考实现
sglang_rollout.py 里的默认 generate 完整实现约 60 行,核心代码——去掉可选分支后,不到 20 行:
async def generate(args, sample, sampling_params):
    state = GenerateState(args)
    url = f"http://{args.sglang_router_ip}:{args.sglang_router_port}/generate"
    prompt_ids = _prepare_prompt_ids(sample, state.tokenizer, state.processor)

    payload = {
        "input_ids": prompt_ids,
        "sampling_params": sampling_params,
        "return_logprob": True,
    }
    output = await post(url, payload)

    new_response_tokens = [item[1] for item in output["meta_info"]["output_token_logprobs"]]
    new_response_log_probs = [item[0] for item in output["meta_info"]["output_token_logprobs"]]

    sample.tokens += new_response_tokens
    sample.response_length += len(new_response_tokens)
    sample.response += output["text"]
    if sample.loss_mask is not None:
        sample.loss_mask += [1] * len(new_response_tokens)
    sample.rollout_log_probs += new_response_log_probs

    sample.update_from_meta_info(args, output["meta_info"])
    return sample
⭐ 这就是 generate 函数的核心形态——单次 HTTP 请求,所有字段增量追加,框架方法做状态翻译。
完整实现的那 40 多行额外代码处理的是”特定场景下的扩展”(多模态、MoE、监控等),不是 generate 的核心责任。任何复杂场景下的 generate 函数,本质上都是从这 18 行核心代码开始扩展的。retool 就是个具体的扩展案例。
责任清单总览
按 retool 实际做了什么,可以列出一份自定义 generate 函数的责任清单——同时给出默认 generate 和 retool 在每条责任上的对比:
| # | 责任 | 默认 generate(参考实现) | retool(扩展实现) |
|---|---|---|---|
| 1 | partial rollout 边界 | 支持——通过 loss_mask is not None assert 配合,实现 4.5.2 的两步构造 | 禁用——assert not args.partial_rollout, |
| 2 | prompt 构造 | 直接用 sample.prompt / sample.tokens,不做 chat template | 自己写 Jinja2 模板,处理 Qwen3 / Qwen3.5 工具调用格式差异 |
| 3 | HTTP 调用 | 单次调用 /generate 端点,解析 meta_info | 多轮调用,每轮一次,带 abort 检测 |
| 4 | 多轮循环 | 没有循环——单次请求就返回 | 5 个 break 点 + 3 种终止状态 |
| 5 | 字段对齐 | 增量追加 tokens / response / loss_mask / rollout_log_probs,简单场景对齐天然成立 | 多轮 + 工具返回 + dummy log_prob,要严格成对追加保证对齐 |
| 6 | 状态翻译 | 调框架的 sample.update_from_meta_info() 统一接口 | 替换了默认 generate,失去统一接口,自己用 match 写 |
⭐ 从表里能看到三种对比模式:责任 1 是”做与不做”(默认支持的功能,用户函数可以选择关掉);责任 2、3、5、6 是”简单 vs 复杂”(默认实现的最简版本,retool 扩展成多轮版本);责任 4 是”无 vs 有”(多轮循环是 retool 独有的、默认 generate 不示范)。
5.2 / 5.3 按代码出现顺序逐条对比。
5.2 责任 1-3:partial rollout 边界、prompt 构造、HTTP 调用
责任 1:决定 partial rollout 边界
默认 generate 支持 partial rollout——通过 4.5.2 那段两步构造的下半步处理 off-policy 段:
if sample.loss_mask is not None:
    assert args.partial_rollout and args.mask_offpolicy_in_partial_rollout
    sample.loss_mask += [1] * len(new_response_tokens)
loss_mask 进来非 None 说明 generate_and_rm 已经把旧段置 0 了,这里追加新段 mask=1,完成两步构造。
retool 禁用 partial rollout:
assert not args.partial_rollout, "Partial rollout is not supported for this function at the moment."
retool 的所有跨轮状态(turn、tool_call_count、response_token_ids、loss_masks、step_action_spans)都在局部变量里——这些状态无法跨 abort/续生成持久化。如果在 turn 3 被 abort、下一轮从 buffer 取出来续生成时,turn 计数从 0 开始、tool_call_count 从 0 开始,状态错乱。要支持 partial rollout,就得把所有中间状态序列化到 sample.metadata,并按 4.5.3 讲的累加语义维护——retool 选择简单的路。
责任 2:prompt 构造
默认 generate 不做 chat template 化——直接信任 sample.prompt 或 sample.tokens 已经是可用的格式:
prompt_ids = _prepare_prompt_ids(sample, state.tokenizer, state.processor)
...
payload["input_ids"] = prompt_ids
sample.prompt 是 dataset 那边走 tokenizer.apply_chat_template 生成的、已经带了系统提示和对话格式,默认 generate 直接拿来用。
retool 自己写 Jinja2 模板——因为工具调用场景下,prompt 里必须包含工具描述(模型怎么知道有哪些工具可用?),而 dataset 那边的 chat template 不包含工具:
tool_specs = tool_registry.get_tool_specs()
tc_format = _detect_tool_call_format(state.tokenizer)
prompt = format_conversation_with_tools(prompt=sample.prompt, tools=tool_specs, tool_call_format=tc_format)
prompt += _get_generation_prompt_suffix(sample.prompt)
retool 自己写了两套 Jinja2 模板(Qwen3 的 JSON 工具格式 + Qwen3.5 的 XML 工具格式),自己读模型 chat_template 的特征字符串(<function= 是否存在)判断走哪套,自己 render。
责任 3:HTTP 调用
默认 generate 单次调用 /generate 端点:
url = f"http://{args.sglang_router_ip}:{args.sglang_router_port}/generate"
output = await post(url, payload)
args.sglang_router_ip / args.sglang_router_port 是上篇 2.2 节那两行写回——埋的线在这里收。框架不提供”调用推理”的 API,只是把 router 地址塞进 args 这个全局上下文,你自己拼 URL、构造 payload、发请求、解析 output[“meta_info”]。
retool 多轮调用——本质上和默认 generate 用的是同一个端点(同样的 url、同样的 post),但每一轮都调一次,中间穿插工具执行:
for turn in range(TOOL_CONFIGS["max_turns"]):
    # ... 准备 payload ...
    output = await post(url, payload)

    # 中途 abort 检测
    if output["meta_info"]["finish_reason"]["type"] == "abort":
        sample.status = Sample.Status.ABORTED
        return sample

    # ... 解析、执行工具、追加 ...
5.3 责任 4-6:多轮循环、字段对齐、状态翻译
责任 4:多轮循环
默认 generate 没有循环——单次 HTTP 请求拿到响应、回填 sample、直接返回。这就是 5.1 节贴的全部核心代码。
retool 完整的多轮循环——工具调用本质上是多轮交互,模型说”调用工具” → 工具执行 → 返回结果 → 模型继续说,直到模型给出最终答案或触发退出条件:
for turn in range(TOOL_CONFIGS["max_turns"]):
    # 1. 超 context 长度 → TRUNCATED 退出
    if total_length >= max_context_length:
        sample.status = Sample.Status.TRUNCATED
        break

    # 2. 调用 SGLang
    output = await post(url, payload)

    # 3. abort → ABORTED 提前 return
    if output["meta_info"]["finish_reason"]["type"] == "abort":
        sample.status = Sample.Status.ABORTED
        return sample

    # 处理生成 token + 追加到数组
    ...

    # 4. length finish(模型自然停止)→ break
    if output["meta_info"]["finish_reason"]["type"] == "length":
        break

    # 5. 执行工具
    next_obs, done = await execute_predictions(cur_response)

    # 6. done(模型给出 answer)→ break
    if done:
        break

    # 7. tool_call_count 上限 → break
    if tool_call_count >= TOOL_CONFIGS["max_tool_calls"]:
        break
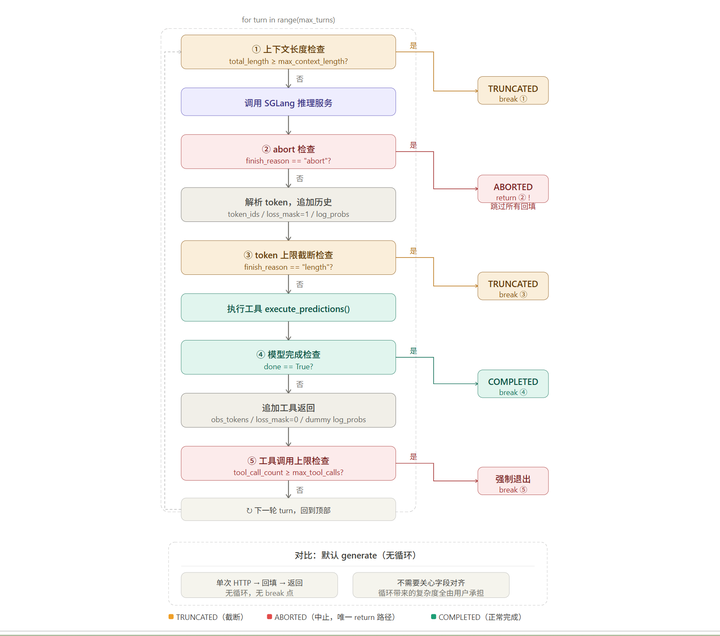
【图示】 retool 多轮循环的 5 个 break 点和终止状态全景
责任 5:字段长度对齐
RolloutManager._convert_samples_to_train_data 里有道断言 assert len(sample.loss_mask) == sample.response_length——这是框架对用户函数的最终验收(4.5 节讲过)。除了 loss_mask,rollout_log_probs 也要和 response_length 等长。
默认 generate 简单场景对齐天然成立——单次请求拿到 N 个 token,追加 N 个 token + N 个 mask + N 个 log_prob,长度自然等于 response_length。三个字段(token / mask / log_prob)都基于同一个 new_response_tokens 的长度追加,不可能错位。
retool 多轮 + 工具返回让对齐变成真实挑战。每一轮有两段需要追加——模型生成的部分(mask=1)和工具返回的部分(mask=0):
# 模型生成的内容 → 参与训练
response += cur_response
response_token_ids += cur_response_token_ids
loss_masks += [1] * len(cur_response_token_ids)         # 紧贴在一起

# 工具返回的 observation → 不参与训练
response += next_obs
response_token_ids += obs_tokens_ids
loss_masks += [0] * len(obs_tokens_ids)                 # 紧贴在一起
⭐ retool 的做法是**“严格成对追加”**:每追加一段 token 就追加等长的 mask,永远不在两次追加之间插入复杂逻辑。
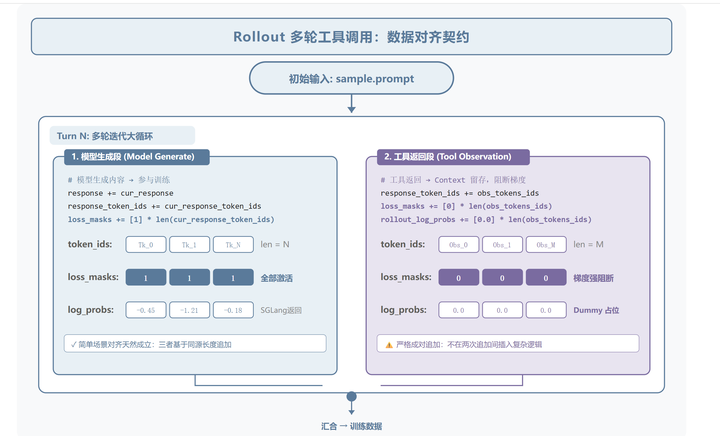
【图示】数据对齐契约
工具返回(代码执行结果、报错)不是模型生成的,对它算 loss 等于训练模型去”预测工具的输出”——毫无意义且污染策略梯度。所以工具返回的 token 作为 context 留在序列里,但 loss_mask = 0。
rollout_log_probs 同理——工具返回的 token 没有真实 log_prob(不是采样出来的),retool 填 dummy 0.0 占位:
if sample.rollout_log_probs is not None:
    sample.rollout_log_probs += [0.0] * len(obs_tokens_ids)
    assert len(response_token_ids) == len(sample.rollout_log_probs), \
        f"Token/logp length mismatch at turn {turn}: ..."
dummy 值不会被训练真正使用——它们对应的 loss_mask=0、训练侧算 importance ratio 时被 mask 掉。loss_mask=0 和 rollout_log_probs=0.0 在工具 token 上配套出现——一个说”别算 loss”,一个说”这里没有有效 log prob、但占个位保证对齐”。每轮的 assert 是用户函数对框架对齐契约的自我验收。
责任 6:状态翻译
默认 generate 调框架的统一接口——
sample.update_from_meta_info(args, output["meta_info"])
这是 4.4 节末尾点过的”状态翻译的统一接口”——把 SGLang 的 finish_reason(length / abort / stop)映射成 Sample.Status(TRUNCATED / ABORTED / COMPLETED),同时还顺手累加 prefix_cache_info、weight_versions 等统计字段(4.5 节讲过)。
retool 自己用 match 写——
match output["meta_info"]["finish_reason"]["type"]:
    case "length": sample.status = Sample.Status.TRUNCATED
    case "abort":  sample.status = Sample.Status.ABORTED
    case "stop":   sample.status = Sample.Status.COMPLETED
retool 替换了默认 generate,失去了 update_from_meta_info 这套自动翻译,所以它自己写 match。这条 match 只翻译 status——其他字段(prefix_cache_info 等)retool 没维护(它本来也不需要,因为禁用了 partial rollout)。
小结
本章通过对比默认 generate(约 18 行核心代码)和 retool(700+ 行)两个实现,划清了 slime 框架与用户函数之间的责任边界。六条责任清单是本章的骨架:
- partial rollout 边界:默认实现通过 loss_mask is not None 自动适配两步构造;retool 因多轮状态无法跨 abort 持久化而 assert not args.partial_rollout——这是工程取舍而非理论限制,把中间状态序列化到 sample.metadata 即可支持。
- prompt 构造:默认实现直接信任 dataset 侧生成的 prompt;retool 因工具调用需要在 prompt 里注入工具描述,自己写了两套 Jinja2 模板覆盖 Qwen3 / Qwen3.5 的格式差异。
- HTTP 调用:两者用同一个 /generate 端点、同一个 post 函数,区别只在调用次数——默认单次、retool 多轮。框架不提供”调用推理”的 API,只把 router 地址塞进 args 这个全局上下文(上篇 2.2 节埋的线在这里收)。
- 多轮循环:retool 独有的部分——5 个 break 点 + 3 种终止状态把多轮工具调用的所有退出路径都明确编码。
- 字段对齐:response_token_ids、loss_mask、rollout_log_probs 严格成对追加,工具返回的 token 用 mask=0 + dummy log_prob=0.0 占位——保证训练侧消费时不需要区分”模型生成”和”工具返回”。
- 状态翻译:默认实现调框架统一接口 update_from_meta_info;retool 因替换了默认 generate、失去了这个接口,自己用 match 手写 finish_reason 到 Sample.Status 的映射。
从对比里能读出 slime 对扩展点的态度:框架只提供数据契约(Sample 结构、字段对齐要求)和上下文(args、router 地址),不提供”用户函数应该长什么样”的脚手架。 默认 generate 是参考实现而非基类,用户函数从签名到内部逻辑都是从零开始写,自由度极高、但所有责任也都落在用户函数自己身上。
全文小结
下篇深入了 slime 推理控制流的内部机制,回答了上篇遗留的问题——一次 rollout_manager.generate() 调用进来之后,slime 如何驱动那套服务化推理架构产出训练 batch。
第 4 章从框架内部视角拆解了调度、并发、正确性三条线:dynamic sampling 的双层 while 用生产者-消费者模型统一了标准 GRPO 和 DAPO 过采样两种场景,是 slime “通用代码 + 空操作退化”设计哲学的典型样本;GenerateState 上挂的三套并发机制(remaining_batch_size / semaphore / dp_rank_context)各管不同粒度,semaphore 容量与 HTTP 连接池容量刻意对齐保证逻辑闸门是唯一瓶颈;rollout 级 FIRST_COMPLETED 与 group 级 gather 的对照展示了等待语义如何由算法需求倒推决定;partial rollout 的 loss_mask 两步构造既保证了 off-policy 数据不污染训练信号,又通过钩子化设计把”如何处理旧段”的决策权交给用户函数。
第 5 章从框架外部视角划清了用户函数的责任边界——通过默认 generate 和 retool 两个实现的对比,把”自定义 generate”这件事拆成 6 条可清单化的责任。可以看到 slime 对扩展点的取舍:只约束数据契约、不提供脚手架,用户函数从签名到内部逻辑全部自己写,自由度与责任完全对称。
合上下两篇看,slime 的”SGLang-Native”哲学贯穿始终:上篇展示了它在架构层面的兑现——一个 placement group 切片统一部署模式、SGLangEngine 只做遥控器、sgl-router 完全外包、三条通信路径各行其道;下篇展示了它在控制流层面的兑现——每一处通用机制都通过”空操作向简单场景退化”覆盖多种用法,每一个钩子都把策略决定权下放给用户函数。
generate返回的 Sample 经过 RolloutManager 的数据后处理(_convert_samples_to_train_data+_split_train_data_by_dp,具体实现留待训练或者数据引擎部分文章展开),最终返回list[Box(ref)],接回上篇的actor_model.async_train——整条调用链首尾闭合。"

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)