
端侧大模型听起来很美,鸿蒙应用到底怎么几行代码接进去?
"接个大模型吧"——这句话在项目会上很容易说出口,落到代码里往往变成三件事:调云端接口、按调用量付费、把用户数据发出去。对工具类产品来说,第一件和第二件还能忍,第三件过不了合规;对高频小功能来说,第三个也许无所谓,但前两件的账算不过来。
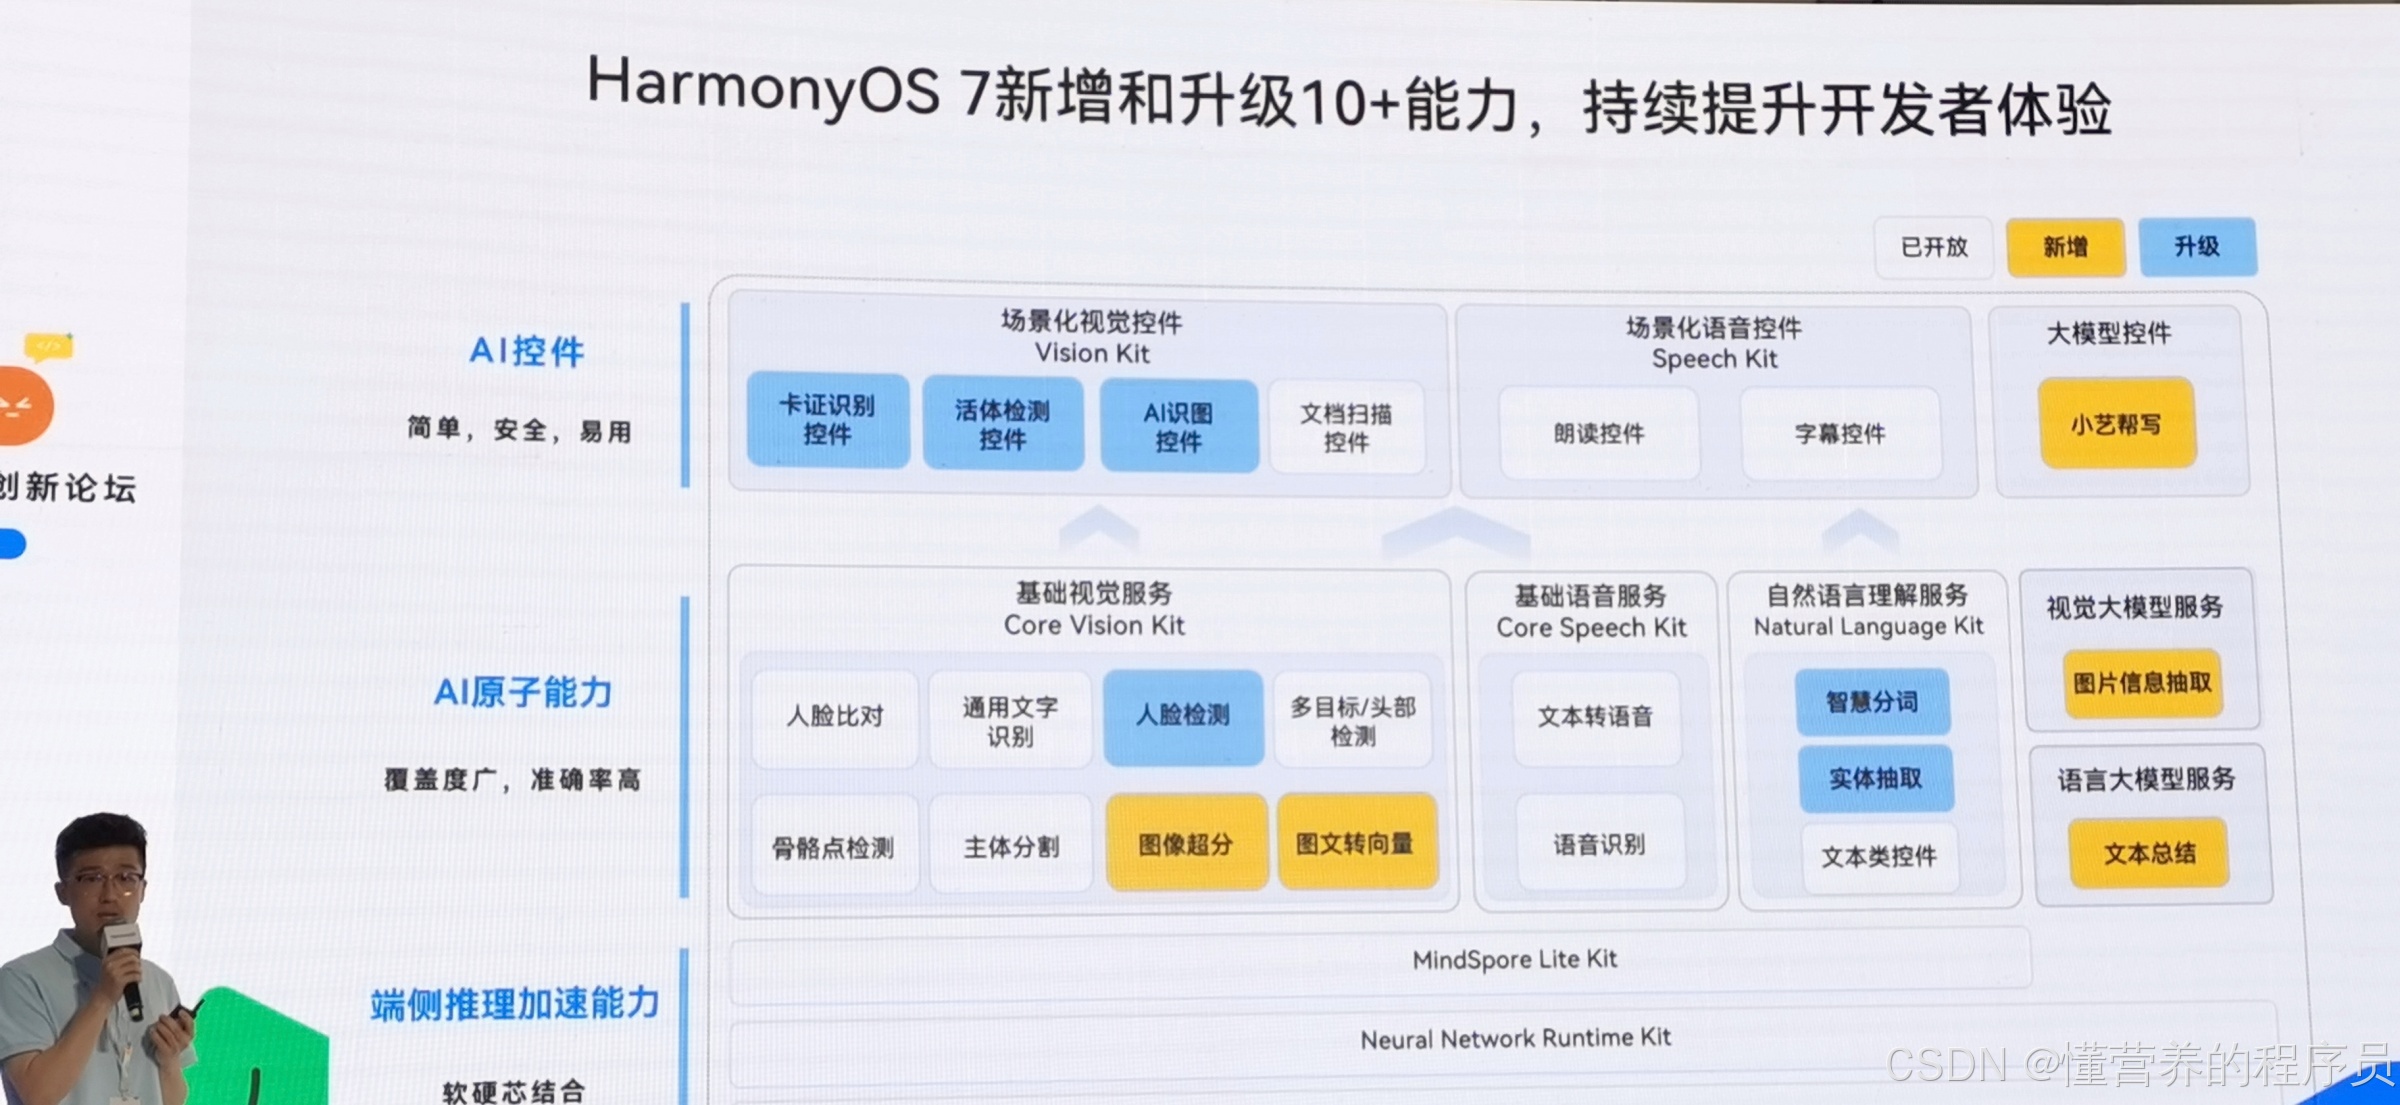
为了解决这个问题,HarmonyOS 7 把端侧 AI 能力做成了三层可直接调用的形态:AI 控件、AI 原子能力、AI 生态底座能力,最省事的一层只需要配置参数就能用。2026 年 9 月 18 日 HDD·HarmonyOS 创新论坛上海站上,华为终端小艺产品经理把这一整套能力的开放情况、新增特性和接入方式讲了一遍。
本文基于该场分享的现场录音与课件照片整理,按"开放现状 → 三层能力 → 今年新增了什么 → 怎么接入"的顺序梳理,数据与案例均出自现场分享。
一、开放现状:20+ 能力,日调用 36.8 亿次
先看两组数字:
| 指标 | 数值 |
|---|---|
| 已开放端侧 AI 能力 | 20+ 个,覆盖语音类、视觉类、语言类 |
| 接入应用 | 10000+ 个 |
| 应用日调用量 | 36.8 亿次 |
现场也顺手算了一笔成本账,很有说服力。通用文字识别这个最基础的能力,目前月调用量超过 6 亿次。按业界云端约 0.03 元/次的价格折算,这个功能本身就够让一个应用每月省下十万到百万级的调用成本。现场提到的使用方包括钉钉(分享面板提取图片文字)、京东金融(屏幕感知推荐)以及搜题、二手车、企业通讯等各类应用。
性能账:酷狗音乐的无损音源
现场用酷狗音乐举例,说明端侧优化的空间有多大:通过 CANN 自定义算子定向优化,在相同的流量消耗下可以听到无损音质,现场给出的口径是音质提升约 75%、流量节省约 98%,同时时延与功耗也有明显下降(约 80% 的时延、约 50% 的耗电)。
这不是"效果更好一点",是把成本结构改了。
二、三层开放形态:从"一行代码"到"自己训练"
现场把能力按使用难度分成三层,这个分层本身就是选型指南。
第一层:AI 控件——界面和数据 API 打包给你
控件把 UI 和背后数据打包在一起,主打简单、安全、易用。属于这一层的:
- Vision Kit 场景化视觉控件:卡证识别、活体检测、AI 识图、文档扫描;
- Speech Kit 场景化语音控件:朗读控件、字幕控件;
- 大模型控件:今年新增的小艺帮写。
第二层:AI 原子能力——更细粒度的数据处理
面向需要自己控制流程的开发者,按垂类划分:
| 垂类 | 套件 | 典型能力 |
|---|---|---|
| 视觉 | CoreVisionKit、Vision Kit | 通用文字识别、人脸检测、人脸比对、主体分割、多目标/头部检测、骨骼点检测、图像超分 |
| 语音 | CoreSpeechKit、Speech Kit | 文本转语音、语音识别 |
| 语言 | Natural Language Kit | 实体抽取、智慧分词、图片信息抽取、图文转向量、文本总结 |
第三层:AI 生态底座能力——给大厂优化极端性能用
面向调用量极大、要在功耗与性能上继续压的场景,提供从自定义模型部署、硬件计算路由调度到高性能算子增强的一整套方案(涉及 CANNKit、MindSporeLiteKit 等)。日常应用基本用不到,但当天花板需要再抬一格时,这一层是出口。
三、今年新增了什么:三个值得关注的能力
1. 大模型控件:小艺帮写
手机屏幕底部悬浮的彩色帮写控件。一键优化文字表达,覆盖内容摘要、纠错、润色、语句改写。场景上现场举的例子很接地气:发朋友圈拟文案、逢年过节写祝福、饭馆让写评价换小礼品。
今年在这个能力上还会业界首发"一键生成思维导图",把大模型的文本处理从生活场景扩到移动办公、轻办公。
2. 大模型多模态信息抽取:文字识别的 ProMax 版
现场说的是"业界首发开放基于大模型的多模态信息抽取",相比业界开源模型准召率更优,功耗更低、时延更低,靠的是软硬芯协同。
典型用法:浏览博客或旅行攻略时,不用复制文字,截图丢给应用,由端侧把图片里的文字抽出来,应用再专注处理用户 query。现场专门点了一句:这种标准化又非常耗 token 的操作,最适合下沉到端侧。
3. 视觉大模型的屏幕识别:把无障碍读得更像人话
原来的小模型只能解析数字:屏幕上"点赞 1.8 万",读出来就是"1.8 万"。现在大模型能结合图标、文字与上下文做理解,播报出来的是"点赞 1.8 万按钮"。这一条直接改善视障用户的可访问性。
四、端侧大模型的性能底牌
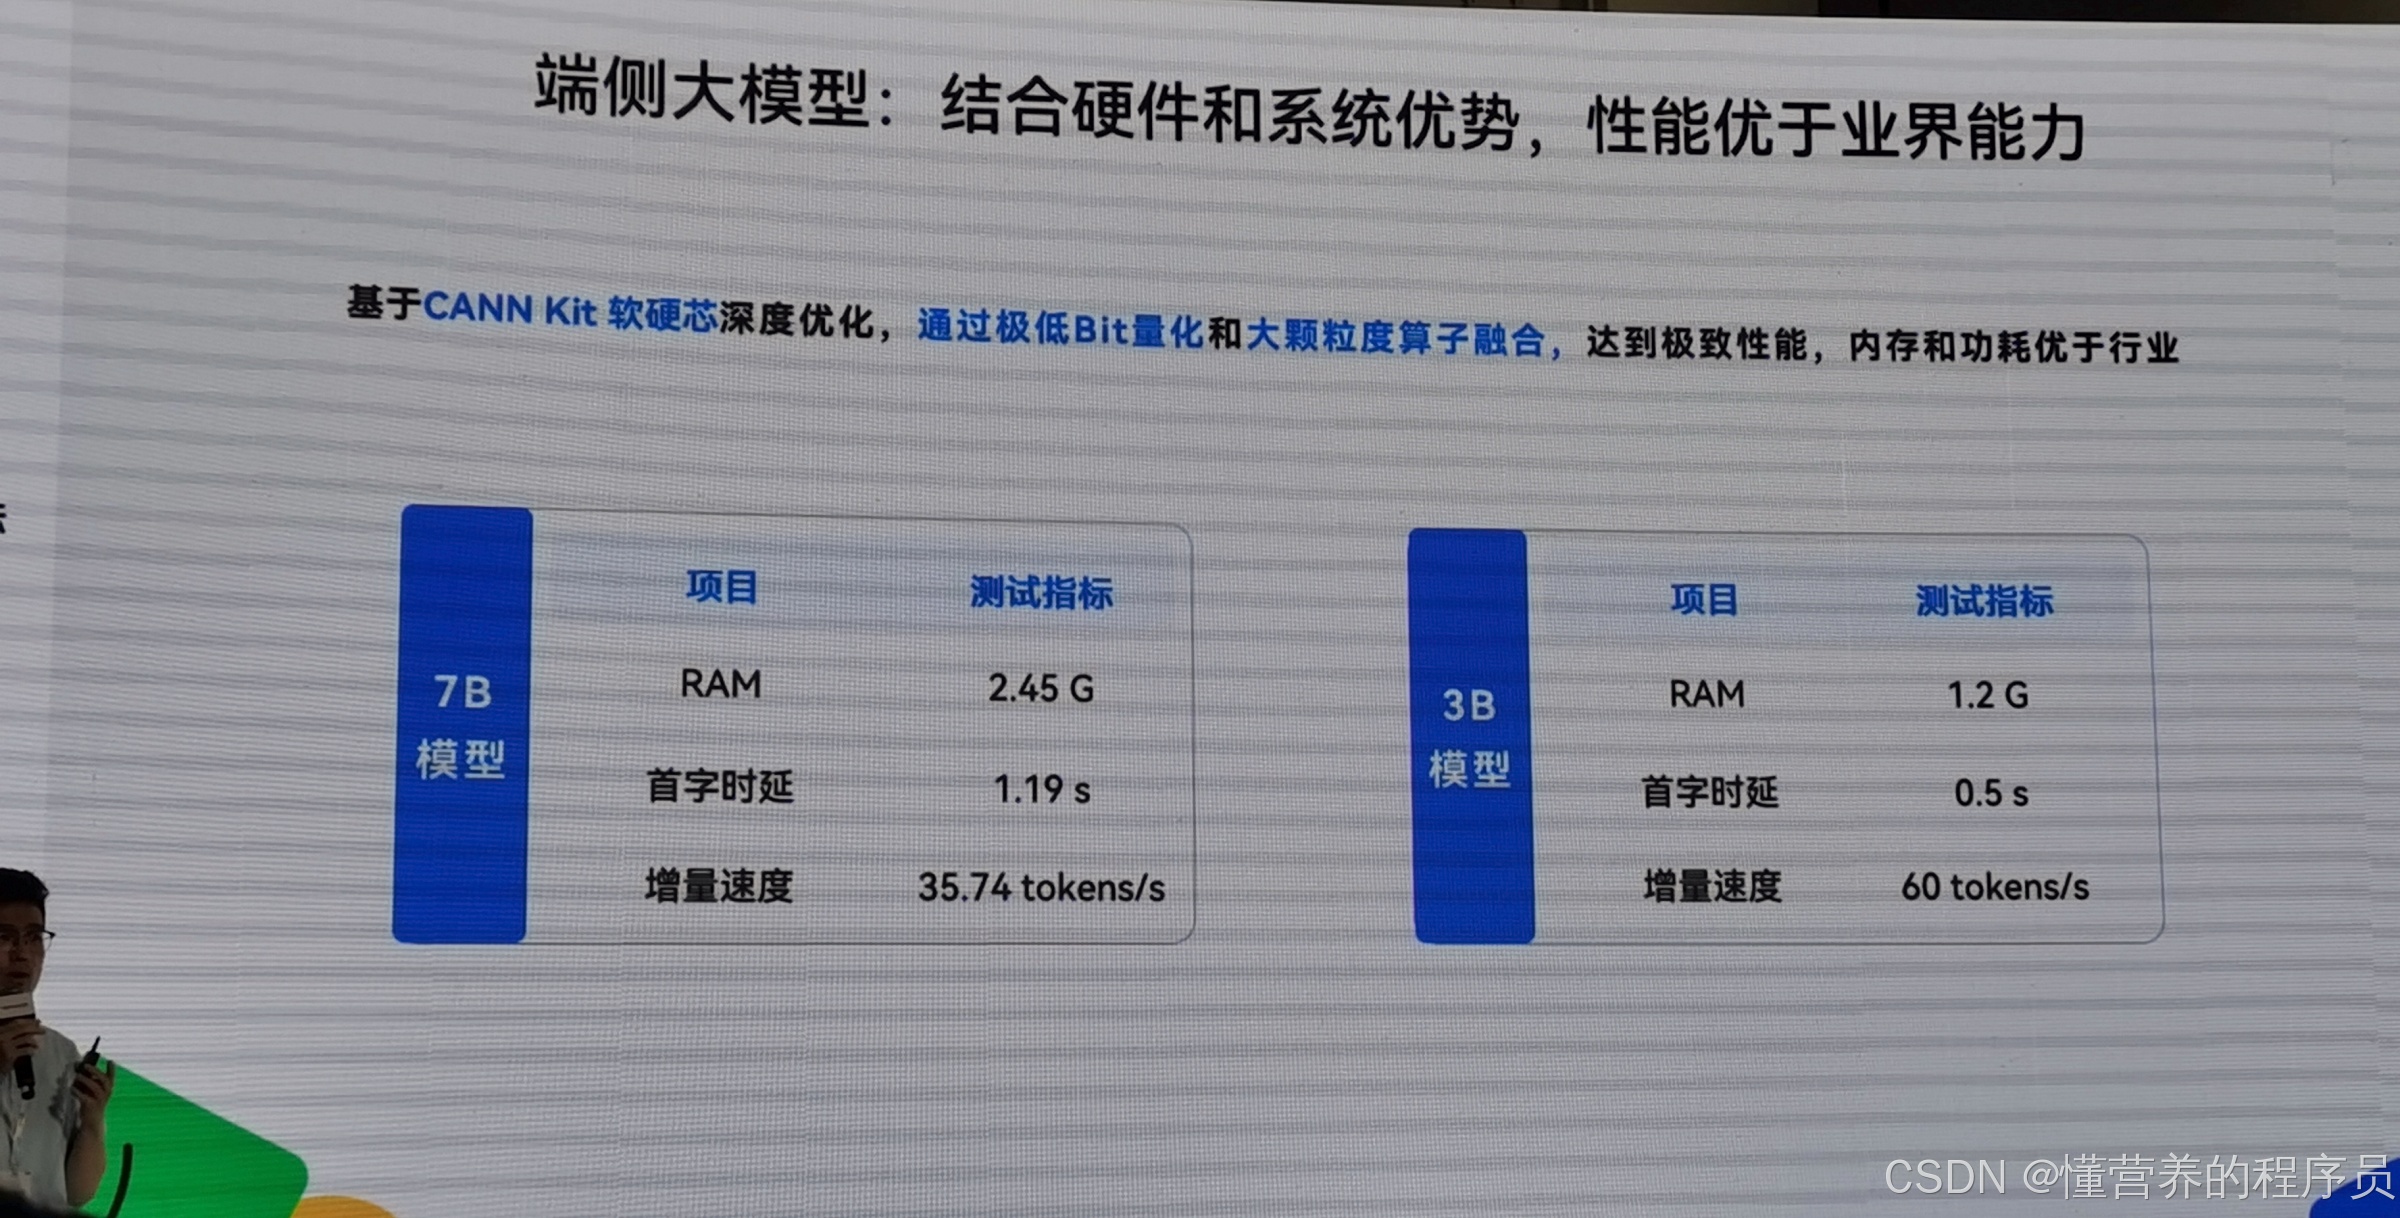
会按机型、内存条件与芯片算力部署 1B / 3B / 7B 的 Transformer 模型,以及 30B 的 MoE 模型。现场给出的两处实测:
- 3B 模型:首字时延 0.5 秒,增量生成速度 60+ tokens/s,属于业界第一梯队;
- 7B 模型的内存占用:鸿蒙平台上约 2.4G;部署在其它平台上一般要 4G 甚至 5G 以上。
第二条的现实意义比看起来大:内存涨价的时候,很多用户会选 8G 内存的手机。平台侧把 7B 压到 2.4G,意味着中端机及以下机型也能跑大尺寸模型,开发者做出来的功能效果有保障,机型适配的工作量也小了。
小模型侧:三个已经在跑的能力
- 图像超分:低分辨率图重建为高清,知乎首页预览图放大即用。相比开发者自己部署开源算法,时延降低 50%;老照片修复、素材放大、视频封面都是适用场景。
- 文搜图:基于文本语义检索图片,南航 e 家的实践中,乘务员描述"充电口没电了"就能从海量图库里找到对应的投诉照片,相比业界开源 CN-CLIP 模型准确率提升 10%。
- 人脸检测:返回高精度人脸框坐标、五官位置、朝向与置信度。端侧离线计算,隐私合规性强,避开了隐私授权、协议签署等漏斗环节;钉钉登录、支付宝验证、华为图库人像精修都在用。还可选配人脸比对、主体分割、多目标识别、骨骼点检测等能力组合使用。
五、怎么接:控件两步,原子 API 三步
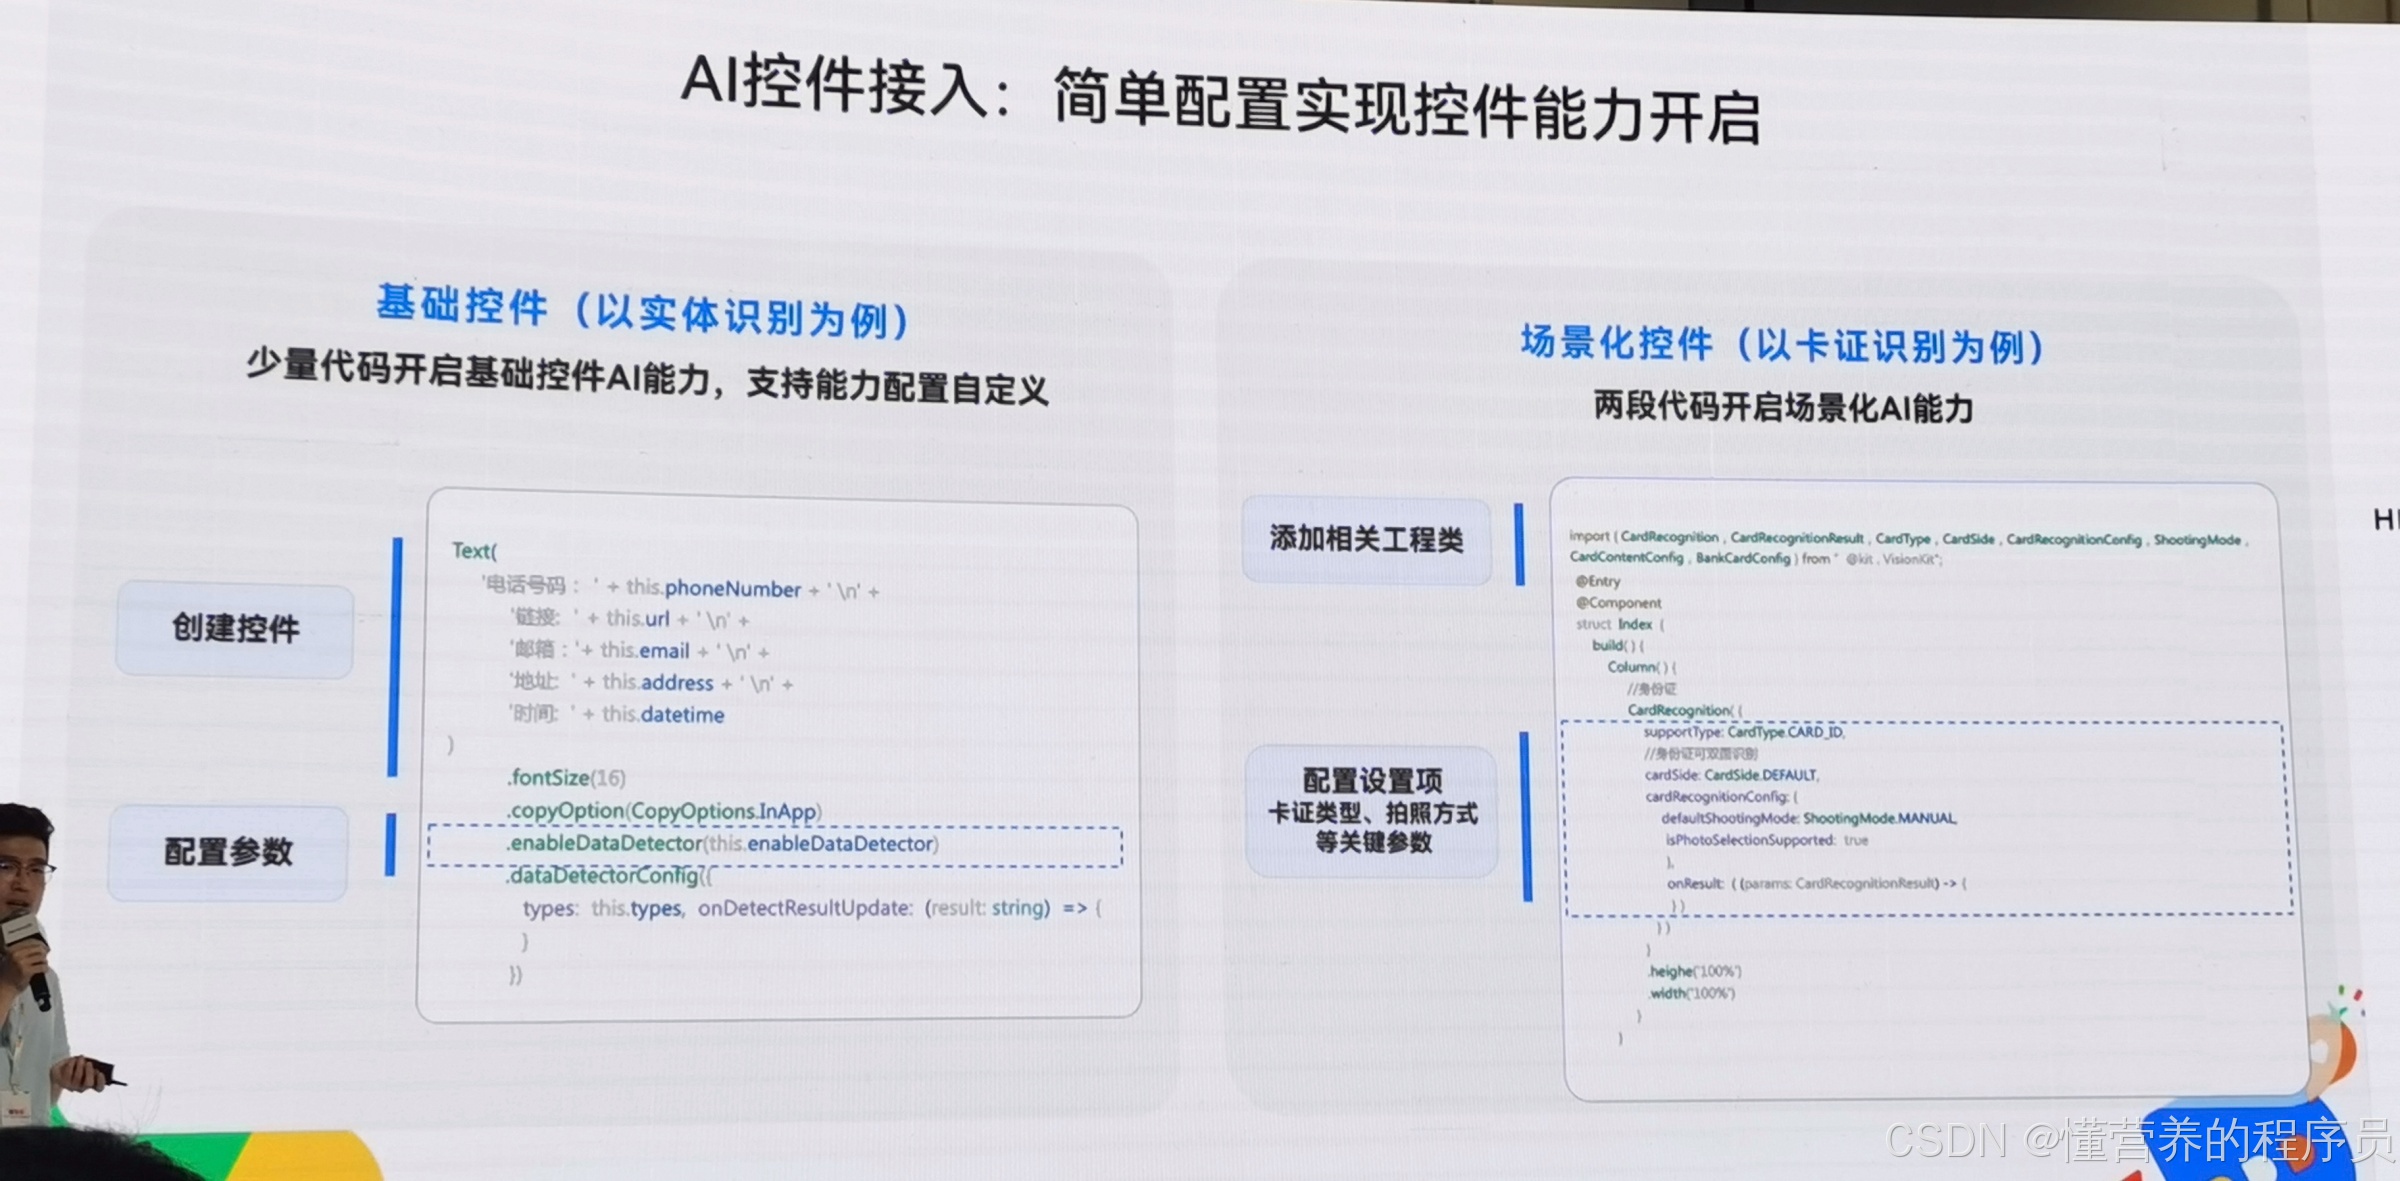
现场把接入方式压成了两个模板。
场景化控件(以卡证识别为例)——两步:
- 添加相关工程类,创建控件;
- 配置设置项。以卡证识别为例,需要配置卡证类型、拍照方式、是否支持从相册选择等关键参数,再挂上结果回调。
基础控件(以实体识别为例):少量代码即可开启,支持能力自定义。
原子化 API(以大模型 API、文字识别为例)——三步:
- 导入代码模块(如
@kit.CoreVisionKit、@hms.ai.largeLanguageModel)与相关工程类; - 配置参数。文字识别配
TextRecognitionConfiguration;大模型要配的东西多一些,包括模型模式、预设提示模板 ID、核采样值、temperature、topP、repetitionPenalty、maxLength 等; - 初始化 API 并调用。
这些参数的名字对做过大模型调用的开发者应该很熟。真正的变化是:这一次它们跑在端侧。
六、卡证识别:七类证件 + 双语身份证
顺手记一个细节,这类小能力往往最能体现工程成熟度:卡证识别控件支持七类卡证——身份证(含双语)、行驶证、驾驶证、护照、银行卡、港澳来往内地通行证、台湾通行证。现场提到身份证支持双语显示,对使用藏文、维文身份证的用户同样可以正常识别。今年还会用大模型技术进一步提升识别准确率。
总结
这场分享可以浓缩成四句话:
- 能下沉到端侧的就下沉——"标准化又耗 token"的操作(OCR、超分、检索、抽取)在端侧做,成本结构与合规风险都更好;
- 控件优先,API 兜底——能用控件就别自己拼流程,控件的接入成本是"配置参数"级别;
- 性能看内存而不是看参数量——7B 压到约 2.4G 内存,决定了你的功能能不能覆盖中端机型;
- 先翻一遍能力清单再动手——很多你以为要自己训练的能力(人脸、超分、文搜图、分词、抽取),系统已经开放了。
接入前最该做的一件事,其实不是写代码,而是把你功能里"耗 token 且标准化"的那一段圈出来——那里大概率就是端侧能力的落点。
关于我
13 年 IT 全栈,.NET、Python、Office 自动化(VSTO/VBA/Python)都做,也做 AI 应用实操(智能体开发),主业是帮企业和团队把重复劳动自动化——报表一键生成、数据对接、文档批量处理、工具定制。
本科物理化学、硕士计算机化学,在一线实验室待过 13 年(9 年制药 + 4 年第三方检测),现在主要服务药企、检测机构和实验室:SOP、合规、样本流、仪器数据接口这些词不用你解释。
这几年做得比较多的是这几类:Office 自动化(VSTO/VBA/Python)工具定制、数据对接与 LIMS 咨询、技术陪跑。
不是外包码农,是听得懂业务的自己人。有同类场景的朋友欢迎评论区聊聊,先聊清楚再动手不迟。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献8条内容

所有评论(0)