
[人工智能]2026人工智能与大语言模型芯片家族参考V02:华为、Nvidia、AMD、Intel、Qualcomm
2026 人工智能与大语言模型芯片家族参考:Nvidia、AMD、Intel、Qualcomm 与华为
多厂商数据中心、边缘与终端 AI 加速器概览
免责声明:本文档为高层次、示意性的多厂商概览。产品规格因 SKU 与配置而异,权威数值请以各厂商官方数据手册为准。
1. 执行摘要
人工智能处理器市场已成为半导体行业最具战略意义的细分领域之一。大语言模型(LLM)、计算机视觉、推荐系统以及科学计算均依赖能够高效执行矩阵运算的专用硬件。本文档梳理了五家有影响力的厂商——Nvidia、AMD、Intel、Qualcomm 与华为——所提供的 AI 芯片家族,涵盖数据中心训练与推理加速器、边缘与汽车平台,以及终端侧神经网络处理单元(NPU)。
Nvidia 凭借 Hopper 与 Blackwell 架构及 CUDA 软件生态,仍是数据中心 AI 训练与推理 GPU 的主要供应商。AMD 通过 Instinct MI300 系列与开放的 ROCm 平台获得显著进展。Intel 提供 Gaudi 加速器、Data Center GPU Max 产品,并在 Core Ultra 处理器中集成 NPU。Qualcomm 依托其移动领域经验,推出高能效的 Cloud AI 推理加速器及集成 Hexagon NPU 的 Snapdragon 平台。华为持续构建以昇腾(Ascend)为核心的本土 AI 生态,包括 Ascend 910、Ascend 310 处理器及 Atlas 硬件。
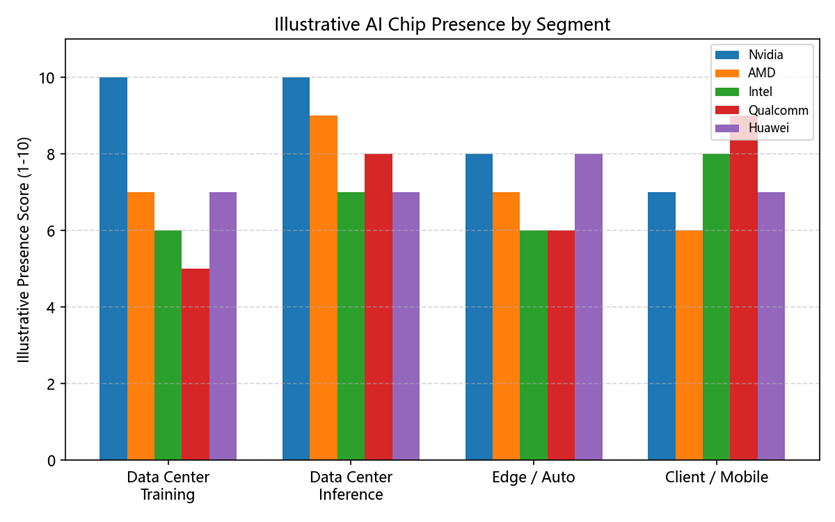
图 1:各细分市场 AI 芯片示意性布局(分数为概念性,不代表市场份额)。
2. AI 芯片分类
AI 芯片可按工作负载、部署位置与架构进行分类。训练加速器需要支持大模型、大容量内存与高速互联;推理加速器则强调吞吐、延迟与能效。架构上包括通用 GPU、固定功能 NPU/ASIC、可编程 FPGA 以及异构 SoC。
数值精度同样关键:FP32、TF32、BF16、FP16、INT8、FP8 以及新兴的 FP4/FP6 格式在精度与速度/密度之间进行权衡。硬件、内存、互联与软件的正确组合决定了 AI 基础设施的总体拥有成本。
3. Vendor AI Chip Families
3.1 Nvidia
Nvidia 数据中心 GPU 产品围绕 Hopper 与 Blackwell 架构构建。基于 Hopper 的 H100 与 H200 SXM 模块广泛应用于大语言模型训练与推理,配备高带宽内存(HBM3/HBM3E)、第四代 Tensor Core 以及 Transformer Engine。基于 Blackwell 的 B200 与 GB200 超级芯片引入第二代 Transformer Engine、NVLink 72 交换机互联,并支持更低精度格式,面向万亿参数模型。
在边缘与汽车领域,Nvidia 提供 Jetson Orin 与 Thor SoC 世代,以及面向自动驾驶的 DRIVE 平台。在终端侧,GeForce RTX GPU 配备 Tensor Core,支持游戏、内容创作与开发者工作流的本地 AI 加速。
|
产品家族 |
细分市场 |
关键特性 / 说明 |
典型用途 |
|
Hopper (H100 / H200) |
数据中心 |
Hopper 架构、HBM3 / HBM3E、Transformer Engine、NVLink |
大语言模型训练/推理、HPC |
|
Blackwell (B200 / GB200) |
数据中心 |
第二代 Transformer Engine、NVLink 72、FP4 / FP6 支持 |
下一代大模型、超级计算 |
|
Grace CPU |
数据中心 / HPC |
Arm 架构、高带宽内存、NVLink-C2C |
CPU+GPU 超级芯片、数据处理 |
|
Jetson Orin / Thor |
边缘 / 汽车 |
Ampere / Blackwell 级 GPU、Arm CPU、安全岛 |
机器人、边缘 AI、自动驾驶 |
|
GeForce RTX (Ada) |
终端 / 工作站 |
Ada Lovelace、Tensor Core、DLSS 3 |
游戏、创作者 AI、本地推理 |
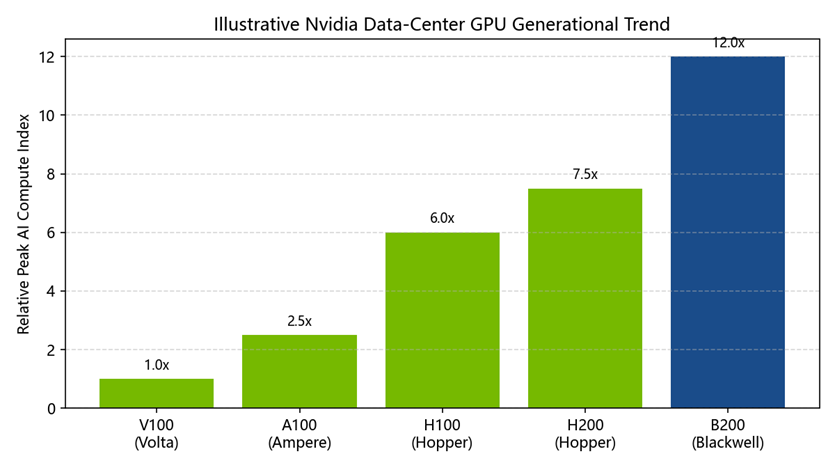
图 2:Nvidia 数据中心 GPU 示意性代际趋势(相对峰值 AI 算力指数)。
3.2 AMD
AMD 的 AI 战略覆盖数据中心 GPU、自适应 SoC 与终端 NPU。Instinct MI300X 加速器采用基于 Chiplet 的 CDNA 3 GPU 架构,可封装大容量 HBM3 显存,面向生成式 AI 推理。MI300A 将 CPU 与 GPU Chiplet 融合,适用于高性能计算(HPC)与 AI。AMD 的 ROCm 开放平台提供库、编译器与框架支持。
AMD Versal 自适应 SoC 将可编程逻辑、标量处理器与 AI 引擎集成,用于边缘推理与信号处理。在 PC 端,Ryzen AI 处理器集成基于 XDNA 的 NPU,支持 Windows 工作室效果等本地 AI 负载。Radeon GPU 也通过 ROCm 支持 AI 加速。
|
产品家族 |
细分市场 |
关键特性 / 说明 |
典型用途 |
|
Instinct MI300X |
数据中心 |
CDNA3 GPU Chiplet、大容量 HBM3、ROCm |
大模型推理、生成式 AI |
|
Instinct MI300A |
HPC / AI |
Zen 4 CPU + CDNA3 GPU APU、统一内存 |
HPC、AI 训练 |
|
Versal AI Edge / VEK |
边缘 / 嵌入式 |
AI 引擎、可编程逻辑、Arm 核心 |
5G、医疗、工业视觉 |
|
Ryzen AI (XDNA) |
终端 |
专用 NPU、低功耗推理 |
视频效果、生产力 AI |
|
Radeon Instinct / PRO |
工作站 / 服务器 |
RDNA / CDNA、ROCm 支持 |
渲染、AI 开发 |
3.3 Intel
Intel 的 AI 产品组合包括独立加速器、数据中心 GPU 与终端 NPU。来自 Intel Habana Labs 团队的 Gaudi3 与 Gaudi2 加速器面向深度学习训练与推理,强调性价比与基于以太网的扩展能力。Data Center GPU Max 系列(Ponte Vecchio)为 AI 与 HPC 工作负载提供强大吞吐。
在边缘与终端侧,Intel Movidius VPU 家族支持低功耗计算机视觉。Core Ultra(Meteor Lake 与 Lunar Lake)处理器集成 NPU 瓦片,与 CPU、GPU 瓦片协同实现混合 AI。Intel 的 oneAPI 与 OpenVINO 工具包帮助开发者在异构目标上部署模型。
|
产品家族 |
细分市场 |
关键特性 / 说明 |
典型用途 |
|
Gaudi3 / Gaudi2 |
数据中心 |
Habana 血统 ASIC、张量/流水线/矩阵核心、以太网扩展 |
深度学习训练/推理 |
|
Data Center GPU Max |
数据中心 / HPC |
Ponte Vecchio、大量 Xe 核心、HBM2e |
AI、HPC、渲染 |
|
Core Ultra NPU |
终端 |
Meteor Lake / Lunar Lake 集成 NPU 瓦片 |
端侧 AI、视频会议 |
|
Movidius VPU |
边缘 |
低功耗视觉加速器 |
摄像头、物联网视觉 |
|
oneAPI / OpenVINO |
软件 |
跨架构工具、模型优化 |
Intel 硬件跨平台部署 |
3.4 Qualcomm
Qualcomm 的 AI 战略强调能效与端侧智能。Cloud AI 100 与 Cloud AI 100 Ultra 加速器面向数据中心推理,在推荐系统、Transformer 等模型上提供高能效吞吐。Snapdragon 移动平台集成 Hexagon NPU,并在 Snapdragon 8 Gen 3 与 8 Elite 世代中扩展了 AI 能力。
在 PC 领域,Snapdragon X Elite 与 X Plus 平台将 Hexagon NPU 性能引入 Windows 笔记本,支持端侧生成式 AI。Qualcomm 还面向汽车推出 Snapdragon Ride Flex SoC,用于数字座舱与自动驾驶。
|
产品家族 |
细分市场 |
关键特性 / 说明 |
典型用途 |
|
Cloud AI 100 / Ultra |
数据中心推理 |
低功耗推理 ASIC、PCIe / HHHL |
云端推理、大模型服务 |
|
Snapdragon 8 Elite / Gen 3 |
移动 |
Hexagon NPU、INT8 / FP16、端侧生成式 AI |
智能手机、影像、助手 |
|
Snapdragon X Elite / X Plus |
终端 PC |
Oryon CPU + Adreno GPU + Hexagon NPU |
Windows on Snapdragon、本地 AI |
|
Snapdragon Ride Flex |
汽车 |
集成 ADAS 与座舱处理 |
自动驾驶、智能座舱 |
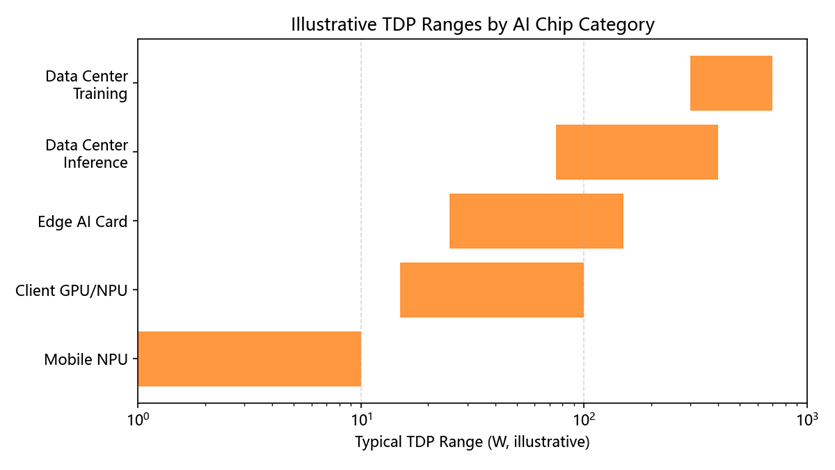
图 3:各类别 AI 芯片典型 TDP 范围示意。
3.5 华为
华为昇腾(Ascend)AI 处理器家族是其本土 AI 基础设施的核心。Ascend 910 面向训练,Ascend 310 面向边缘推理。这些处理器驱动 Atlas 800 训练服务器、Atlas 300 推理卡与 Atlas 200 边缘模块。华为将昇腾硬件与 CANN(Compute Architecture for Neural Networks)软件栈及 MindSpore 框架配套使用。
华为还将其 NPU 能力集成到麒麟(Kirin)移动 SoC 中,为智能手机与平板提供端侧 AI 功能。昇腾生态在中国本土云与企业部署中具有重要地位。
|
产品家族 |
细分市场 |
关键特性 / 说明 |
典型用途 |
|
Ascend 910 / 910B |
数据中心训练 |
达芬奇架构、HBM、CANN |
大模型训练、超级计算 |
|
Ascend 310 / 310P |
边缘 / 推理 |
低功耗达芬奇核心、INT8 / FP16 |
边缘推理、智慧城市 |
|
Atlas 800 / 300 / 200 |
服务器 / 卡 / 边缘 |
基于昇腾的集成系统 |
训练集群、推理卡 |
|
Kirin NPU |
移动 |
达芬奇微架构 NPU |
智能手机、端侧 AI |
|
CANN / MindSpore |
软件 |
算子库、图编译器、框架 |
模型训练/部署 |
4. 对比分析
下表从多个维度总结五家厂商的特点。由于各厂商 SKU 众多且路线图更新迅速,以下条目为定性描述。
|
厂商 |
旗舰数据中心家族 |
关键边缘/终端家族 |
主要软件栈 |
显著优势 |
代表性应用场景 |
|
Nvidia |
Blackwell / Hopper |
Jetson / GeForce RTX |
CUDA / TensorRT / Triton |
生态成熟、训练规模 |
大模型训练、HPC、自动驾驶 |
|
AMD |
Instinct MI300 系列 |
Versal / Ryzen AI |
ROCm / OpenVX / Ryzen AI SDK |
HBM 容量、开源推进 |
推理集群、自适应边缘、PC |
|
Intel |
Gaudi3 / Data Center GPU Max |
Core Ultra NPU / Movidius |
oneAPI / OpenVINO / 框架插件 |
XPU 广度、以太网扩展 |
训练、推理、终端 AI |
|
Qualcomm |
Cloud AI 100 Ultra |
Snapdragon X Elite / 8 Elite |
Qualcomm AI Stack / QNN |
能效、端侧 AI |
云端推理、移动、PC AI |
|
Huawei |
Ascend 910 / 910B |
Ascend 310 / Kirin |
CANN / MindSpore |
本土垂直整合 |
中国云、边缘、移动 AI |
5. 趋势与展望
- 先进封装与 Chiplet 正在重塑 AI 芯片。2.5D 中介层、3D 堆叠、TSMC CoWoS、Intel EMIB 以及 UCIe 标准使厂商能够将计算、内存与 I/O 芯片合封,提升良率与内存带宽。
- 内存容量与带宽仍是关键瓶颈。高带宽内存(HBM)持续演进,HBM3E 已量产,HBM4 在路线图中。内存池化与 CXL 等缓存一致性互联可能改变加速器跨服务器共享内存的方式。
- 扩展网络决定了多少加速器能作为单一逻辑单元运行。Nvidia NVLink / NVSwitch、AMD Infinity Fabric 以及基于以太网的方案分别针对 AI 集群的不同成本与性能需求。
- 更低数值精度与结构化稀疏性被用来提升吞吐。FP8 训练与推理正成为主流,FP4/FP6 与模型压缩技术旨在降低显存占用与每 token 能耗。
- 功耗与散热限制推动液冷与供电创新。现代数据中心 GPU 与加速器单卡功耗可达数百瓦,促使设施采用液冷、更高压配电与机架级热设计。
- 软件生态仍是关键差异点。框架支持(PyTorch、TensorFlow、JAX)、编译器、运行时服务系统(TensorRT-LLM、vLLM、Triton)及厂商 SDK 影响模型移植与优化难度。
- 主权 AI、区域供应链与出口管制正在重塑采购。部分市场优先采用本土加速器与本地制造,为全球厂商带来机遇,也带来碎片化风险。
6. 插图与数据说明
本文档中的所有图表均为示意性说明,用于突出厂商与产品类别之间的结构性差异,并非来自审计后的市场研究数据。性能、功耗与 presence 分数应视为概念性参考,而非精确排名。
路线图与产品名称变化频繁。读者在采购或工程决策前,应直接向各厂商核实当前规格、供货情况与软件支持。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)