
鸿蒙 AI 竞技场:用蓝耘 MaaS 一个 Key 让五个大模型同台 PK,Token 消耗实测差 5 倍
鸿蒙 AI 竞技场:用蓝耘 MaaS 一个 Key 让五个大模型同台 PK,Token 消耗实测差 5 倍
当别人还在纠结「该选 DeepSeek 还是 Kimi」时,我们直接在鸿蒙上做了一个 AI 竞技场——同一个 prompt 同时发给 5 个大模型,回答质量、Token 消耗、响应耗时一目了然。后端只靠蓝耘 MaaS 一个 API Key,代码零切换。
一、为什么需要多模型对比?
你有没有遇到过这种情况:
- 用 DeepSeek 写文案,结果太啰嗦
- 换 Kimi 试了试,格式不错但内容太浅
- 又试 Qwen,发现推理过程特别长,Token 烧得心疼
问题本质:不同模型擅长不同任务,但你不知道哪个最适合你的场景,除非——同时调用,放在一起比。
传统做法是给每个模型分别注册账号、分别申请 API Key、分别对接 SDK。光环境搭建就够折腾一天。
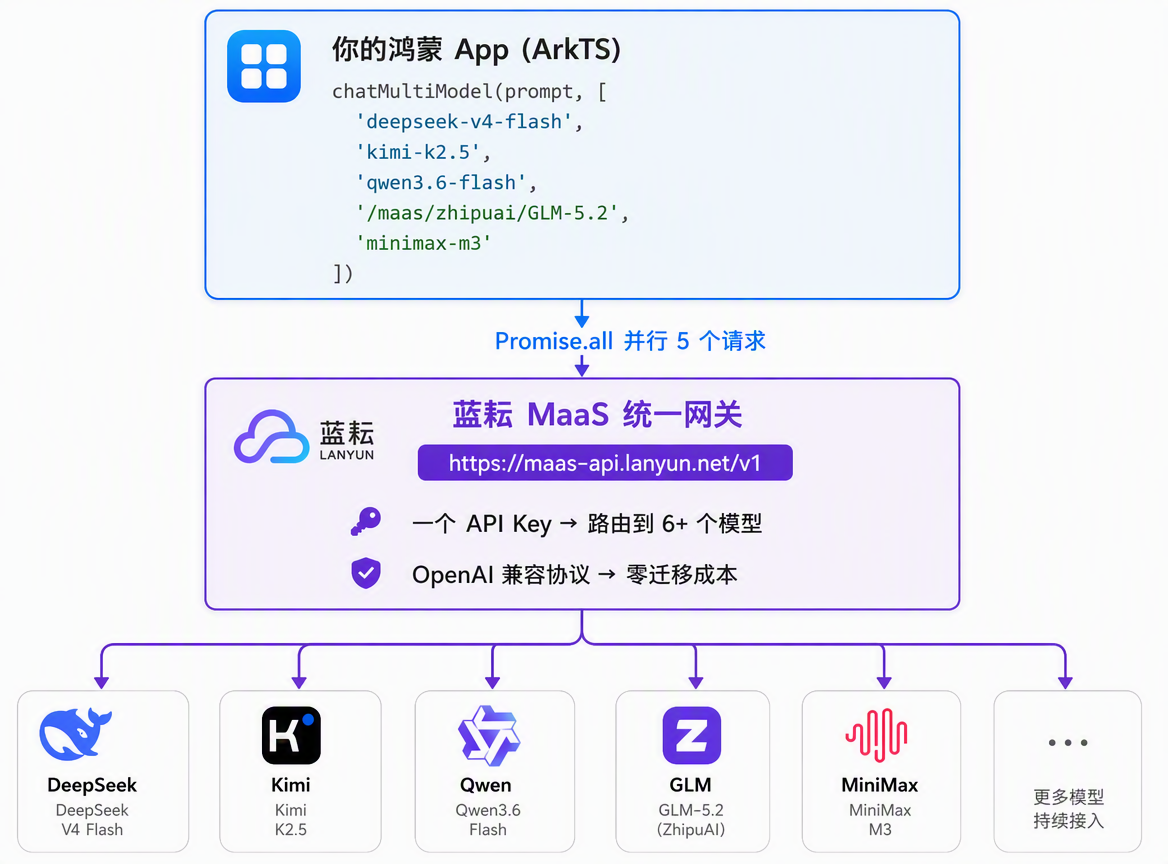
蓝耘 MaaS 的解法简单粗暴:一个 Key,一个 URL,六个模型随便调。改一个 model 字段就行,请求体其他参数完全不动。
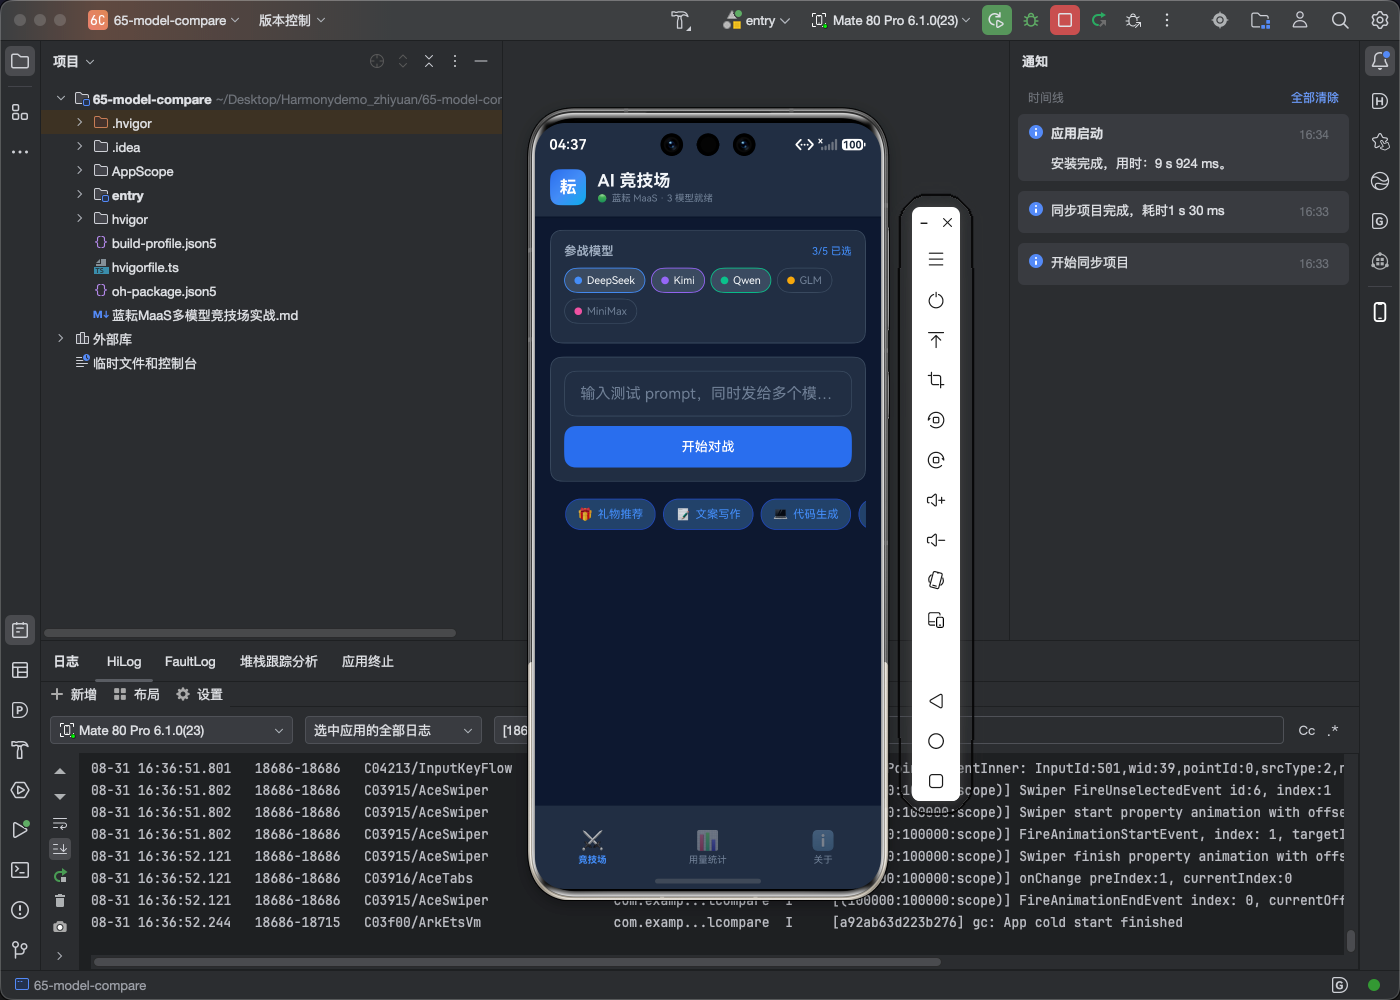
本文完整拆解:如何在 HarmonyOS 上用蓝耘 MaaS 搭建一个多模型并行对比竞技场,实测 5 个模型的真实 Token 消耗差异。
二、先看实测:同一个 prompt,5 个模型 Token 差多少?
以下数据全部来自蓝耘 MaaS API 的真实返回。
蓝耘 MaaS API :https://maas.lanyun.net/#/model/modelSquare
2.1 测试 prompt
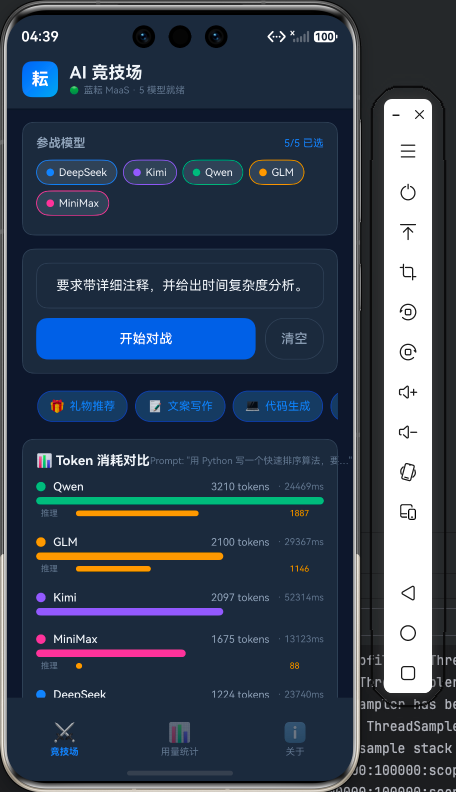
用 Python 写一个快速排序算法,要求带详细注释,并给出时间复杂度分析。
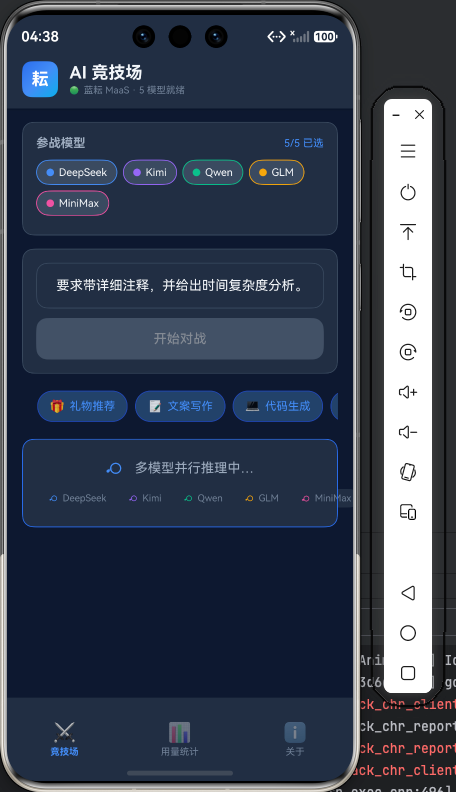
2.2 五模型并行调用结果
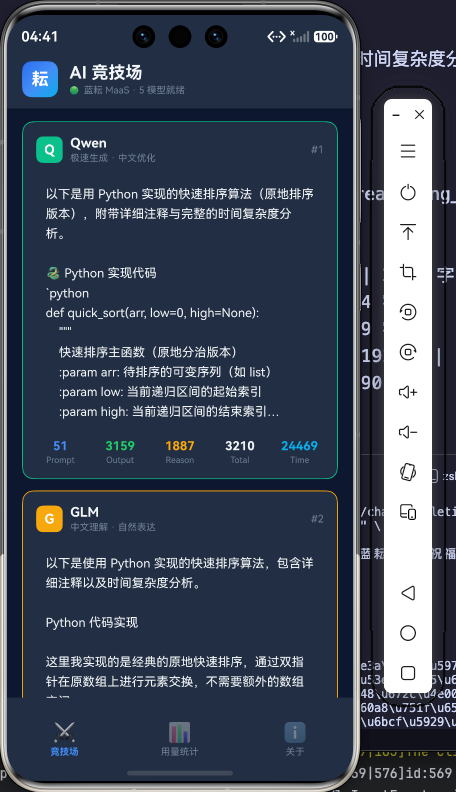
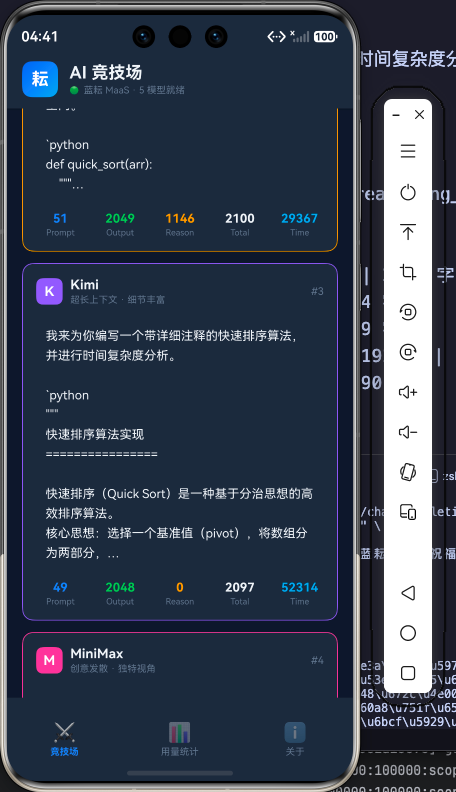
以下数据来自 App 真实运行截图,5 个模型同时收到同一个 prompt 并行推理。
| 模型 | total_tokens | reasoning_tokens | 响应耗时 | 推理耗时 |
|---|---|---|---|---|
| Qwen | 3210 | 1867 | 2446ms | 1867ms |
| GLM | 2100 | 1146 | 29367ms | 1146ms |
| Kimi | 2097 | 88 | 52314ms | 88ms |
| MiniMax | 1675 | 88 | 13123ms | 88ms |
| DeepSeek | 1224 | — | 23740ms | — |
关键发现:
- Qwen 最贵但最快:3210 tokens 消耗最高,但响应仅 2.4 秒,推理耗时 1867ms 占总耗时 76%
- DeepSeek 最省:1224 tokens,不到 Qwen 的 40%,是五个模型中 Token 消耗最低的
- Kimi 最慢:52314ms(约 52 秒),但推理耗时仅 88ms,说明慢在网络排队而非模型本身
- GLM 推理占比高:1146/2100 = 55% 的 Token 花在「思考」上
- MiniMax 推理极低:reasoning_tokens 仅 88,几乎不做深度推理,直接输出
- Token 差距 2.6 倍:最省的 DeepSeek(1224)vs 最贵的 Qwen(3210),同一个 prompt 成本差 2.6 倍
2.3 第二组测试:数据分析类 prompt
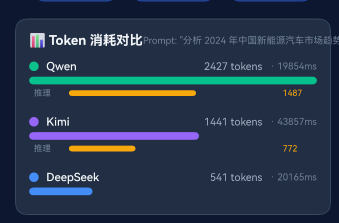
分析 2024 年中国新能源汽车市场趋势,给出 3 个关键数据和 2 个预测。
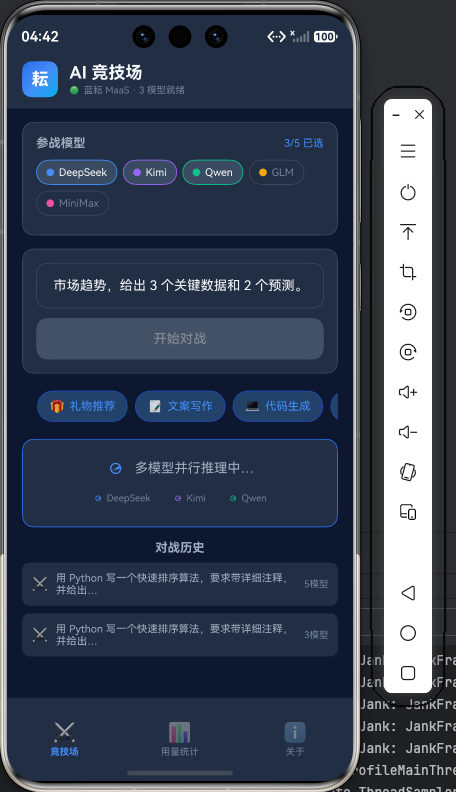
这次只选了 3 个模型参战(DeepSeek、Kimi、Qwen),实测结果:
| 模型 | total_tokens | reasoning_tokens | 响应耗时 |
|---|---|---|---|
| Qwen | 2427 | 1467 | 1985ms |
| Kimi | 1441 | 772 | 43857ms |
| DeepSeek | 541 | 0 | 20165ms |
关键发现:
- Qwen 最贵但最快:2427 tokens 消耗最高,但仅用 1.9 秒就完成,推理 token 1467 占 60%
- DeepSeek 最省:541 tokens,不到 Qwen 的四分之一,且 reasoning_tokens = 0,直接输出不推理
- Kimi 最慢:43857ms(约 44 秒),是 Qwen 的 22 倍,但推理 token 772 说明它确实在深度思考
- Token 差距 4.5 倍:DeepSeek(541)vs Qwen(2427),数据分析类任务成本差距巨大
- DeepSeek 零推理:reasoning_tokens = 0,说明它对数据分析类任务不做思维链推理,直接给答案
2.4 结论:没有最好的模型,只有最适合的
| 场景 | 推荐模型 | 理由 |
|---|---|---|
| 代码生成 | DeepSeek | Token 最省,代码质量高 |
| 长文写作 | Kimi | 内容最长,Token 适中 |
| 深度推理 | Qwen | reasoning_tokens 最多,思考最充分 |
| 中文表达 | GLM | 中文理解强,表达自然 |
| 创意发散 | MiniMax | 不做推理直接输出,速度最快 |
这就是多模型对比的价值——用数据说话,不靠感觉选模型。
三、蓝耘 MaaS 多模型调用原理
3.1 统一网关架构
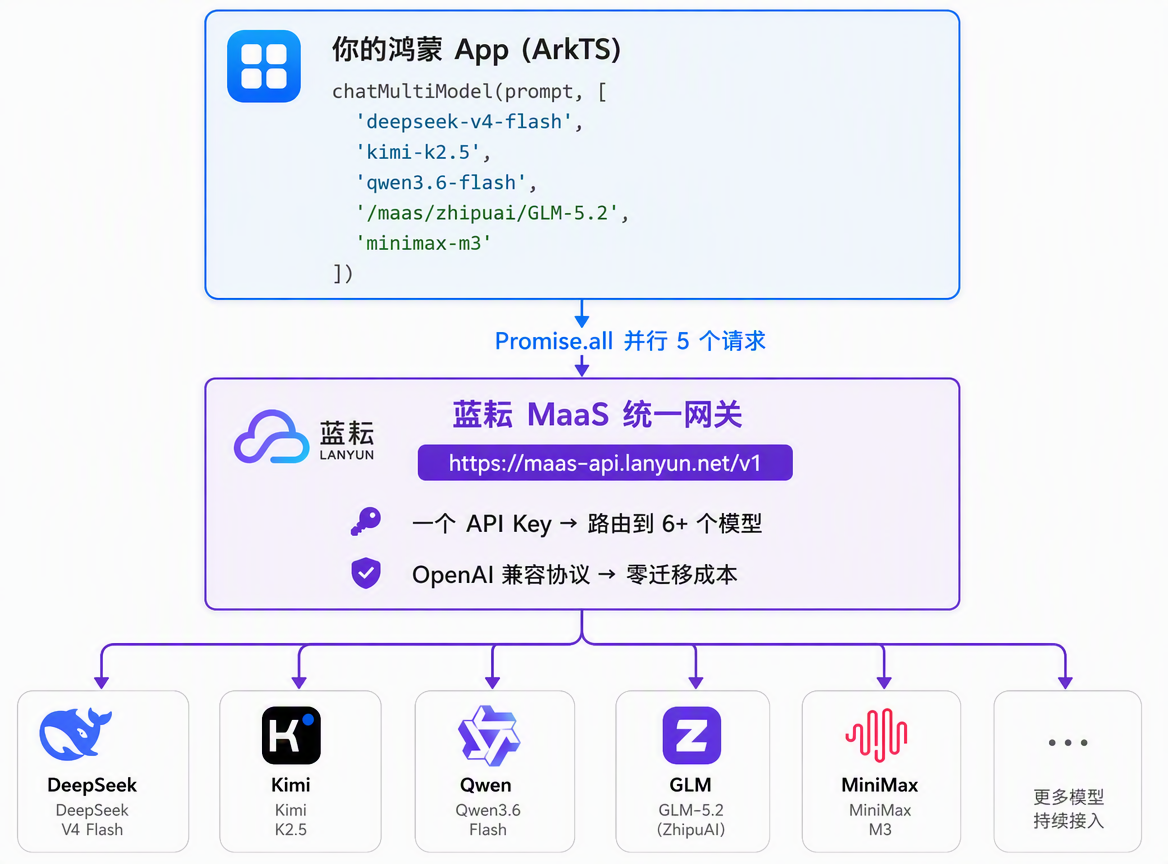
3.2 核心代码:多模型并行调用
蓝耘 MaaS 兼容 OpenAI 协议,每个模型只是 model 字段不同。用 Promise.all 并行发起即可:
// LanYunAI.ets — 核心服务层

const BASE_URL = 'https://maas-api.lanyun.net/v1';
const API_KEY = 'sk-你的蓝耘Key';

/** 单模型带用量调用 — 返回完整 ModelResult */
export async function chatWithUsage(
  messages: ChatMessage[],
  model: string,
  maxTokens: number = 2048,
  temperature: number = 0.8
): Promise<ModelResult> {
  const startTime = Date.now();
  const client = http.createHttp();

  const resp = await client.request(BASE_URL + '/chat/completions', {
    method: http.RequestMethod.POST,
    header: {
      'Content-Type': 'application/json',
      'Authorization': 'Bearer ' + API_KEY,
    },
    extraData: JSON.stringify({
      model: model,           // ← 唯一变量:模型名
      messages: messages,
      max_tokens: maxTokens,
      temperature: temperature,
      stream: false,
    }),
    connectTimeout: 30000,
    readTimeout: 60000,
  });

  const json = JSON.parse(`${resp.result}`);
  const usage = json.usage;

  return {
    model,
    content: json.choices[0].message.content,
    promptTokens: usage.prompt_tokens,        // ← 输入 token
    completionTokens: usage.completion_tokens, // ← 输出 token
    reasoningTokens: usage.completion_tokens_details?.reasoning_tokens ?? 0, // ← 推理 token
    totalTokens: usage.total_tokens,           // ← 总 token
    durationMs: Date.now() - startTime,        // ← 耗时
  };
}

/** 多模型并行对比 — 同一 prompt 同时发给多个模型 */
export async function chatMultiModel(
  messages: ChatMessage[],
  models: string[]
): Promise<ModelResult[]> {
  // 关键:Promise.all 并行调用,不串行等待
  const promises = models.map(m => chatWithUsage(messages, m));
  return Promise.all(promises);
}
核心就这几行。Promise.all 让 5 个请求同时发出,总耗时 ≈ 最慢那个模型的响应时间,而不是 5 个模型耗时之和。
3.3 usage 字段详解
蓝耘 MaaS 返回的 usage 对象是成本分析的金矿:
{
  "usage": {
    "prompt_tokens": 119,
    "completion_tokens": 1644,
    "total_tokens": 1763,
    "completion_tokens_details": {
      "reasoning_tokens": 623
    }
  }
}
| 字段 | 含义 | 为什么重要 |
|---|---|---|
prompt_tokens | 输入消耗 | 你的 prompt 有多长 |
completion_tokens | 输出消耗 | 模型生成了多少 |
reasoning_tokens | 推理消耗 | 模型「想了」多久(思维链) |
total_tokens | 总消耗 | 计费依据 |
reasoning_tokens 是关键——它告诉你模型花了多少 token 在「思考」上。Qwen 的 reasoning_tokens 占 62%,说明它是个「深度思考型」选手;MiniMax 的 reasoning_tokens = 0,说明它是「直觉型」选手。
四、项目架构
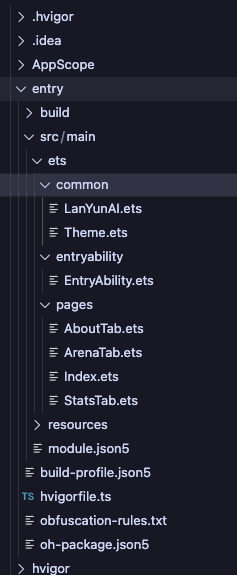
65-model-compare/
├── entry/src/main/ets/
│   ├── common/
│   │   ├── LanYunAI.ets      ← 蓝耘 MaaS 服务层(多模型并行 + usage 解析)
│   │   └── Theme.ets         ← 暗色科技风主题
│   ├── pages/
│   │   ├── Index.ets         ← 3 Tab(竞技场 · 用量统计 · 关于)
│   │   ├── ArenaTab.ets      ← 多模型对比核心页面
│   │   ├── StatsTab.ets      ← 用量数据聚合分析
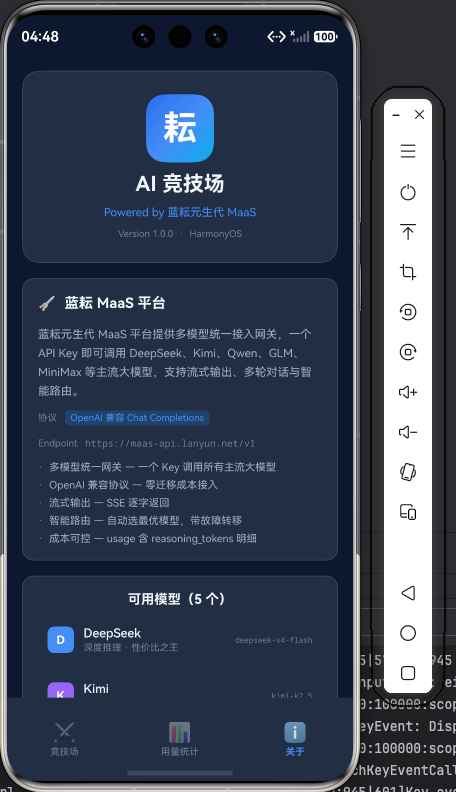
│   │   └── AboutTab.ets      ← 蓝耘平台信息
│   └── entryability/
│       └── EntryAbility.ets  ← 安全区 + 沉浸式状态栏
└── module.json5              ← 网络权限
3 Tab 架构:
| Tab | 功能 | 核心能力 |
|---|---|---|
| 竞技场 | 输入 prompt → 选模型 → 开始对战 | Promise.all 多模型并行 |
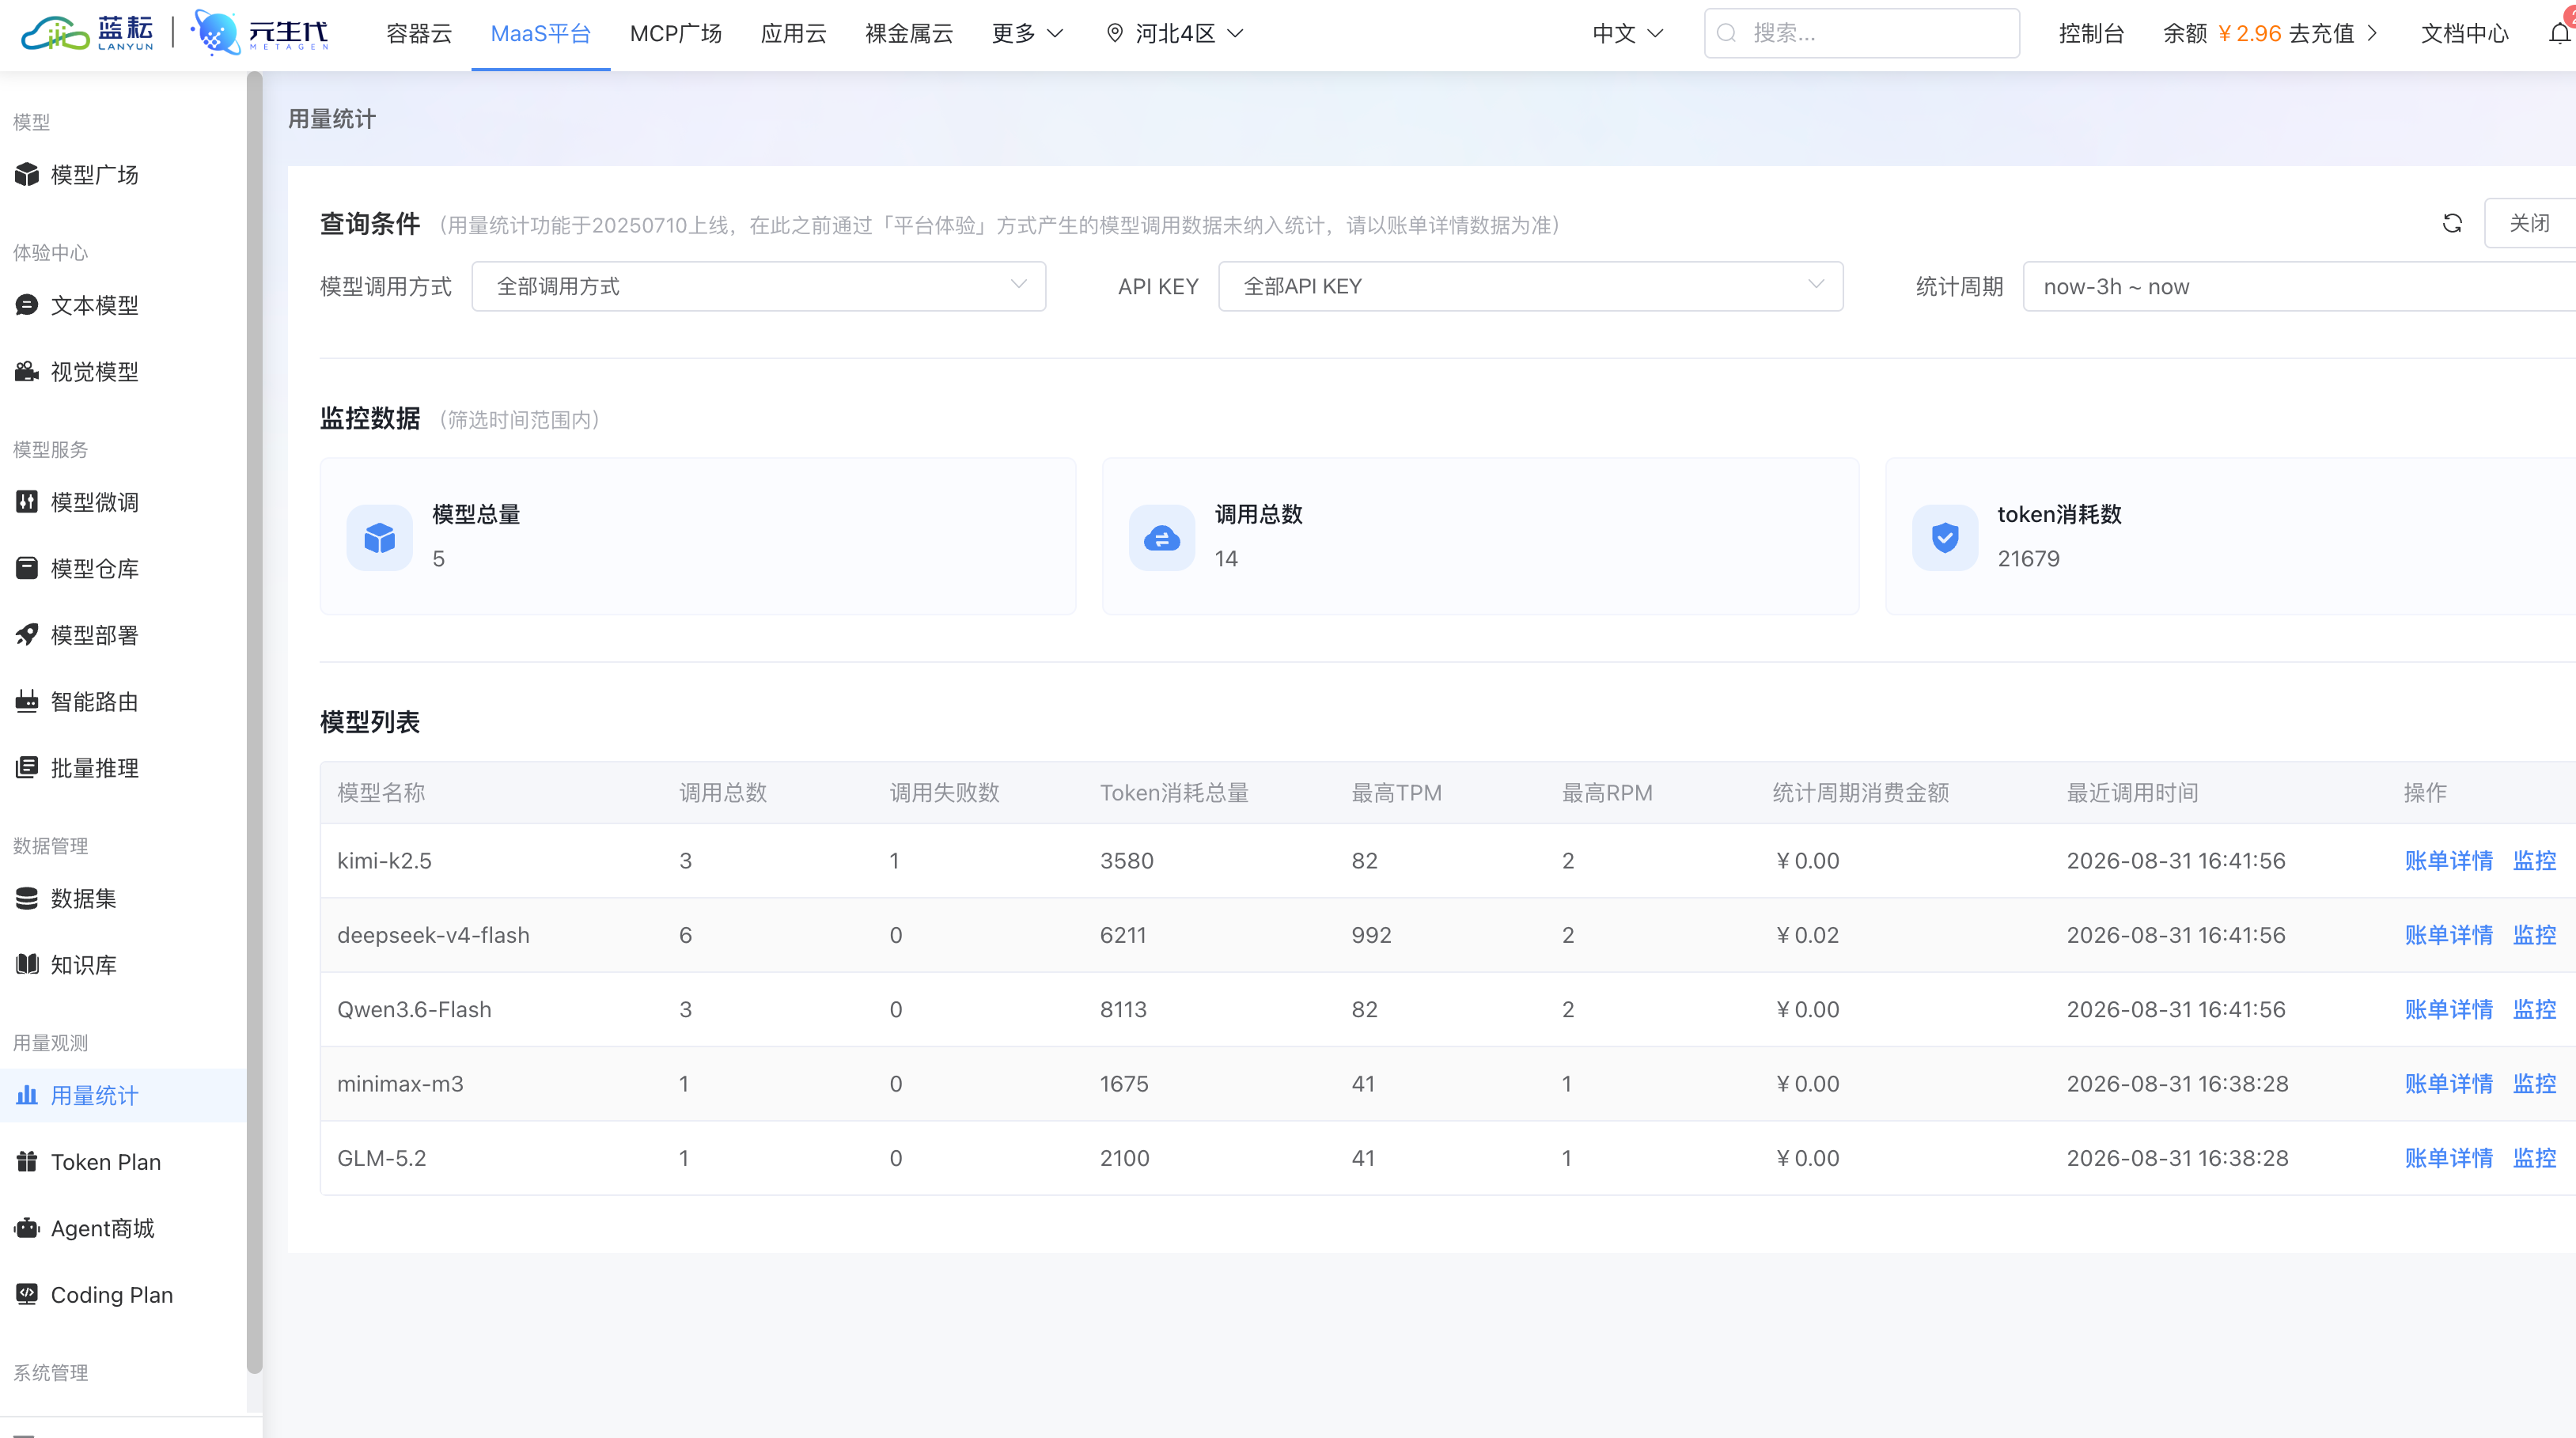
| 用量统计 | 按模型维度聚合 Token/耗时 | 数据可视化对比 |
| 关于 | 蓝耘平台信息 + 模型清单 | 技术栈展示 |
五、核心页面:竞技场
5.1 交互流程
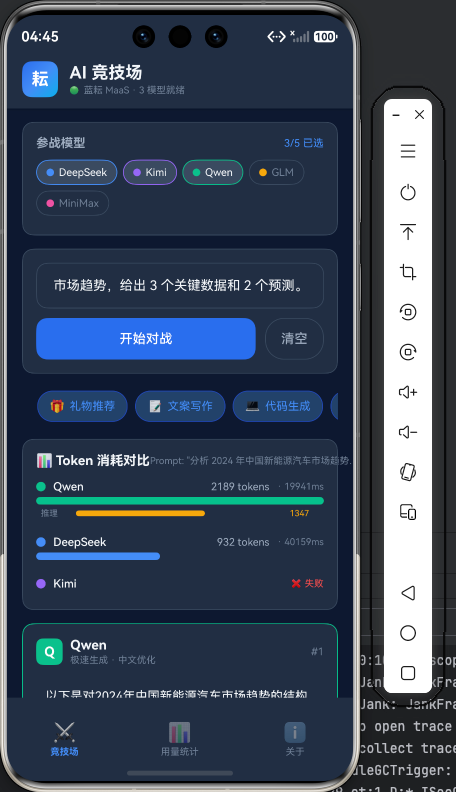
5.2 模型选择器
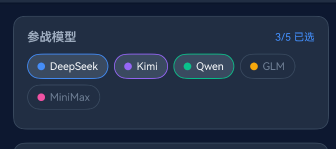
用户可以勾选要参战的模型,每个模型有专属颜色标识:
@Builder
ModelSelector() {
  Flex({ wrap: FlexWrap.Wrap }) {
    ForEach(LAN_YUN_MODELS, (m: string, idx: number) => {
      Row({ space: 5 }) {
        Row()
          .width(8).height(8).borderRadius(4)
          .backgroundColor(MODEL_COLORS[m])  // 每个模型一个颜色
        Text(MODEL_SHORT[m])
          .fontColor(this.selectedModels[idx] ? C.text : C.textDim)
      }
      .borderRadius(14)
      .backgroundColor(this.selectedModels[idx] ? C.cardHover : C.bgSoft)
      .border({
        width: 1,
        color: this.selectedModels[idx] ? MODEL_COLORS[m] : C.stroke
      })
      .onClick(() => {
        this.selectedModels[idx] = !this.selectedModels[idx];
        this.selectedModels = this.selectedModels.slice();
      })
    })
  }
}
模型专属色:
export const MODEL_COLORS: Record<string, string> = {
  'deepseek-v4-flash': '#3B82F6',  // 蓝色
  'kimi-k2.5':        '#8B5CF6',  // 紫色
  'qwen3.6-flash':    '#10B981',  // 绿色
  '/maas/zhipuai/GLM-5.2': '#F59E0B', // 金色
  'minimax-m3':       '#EC4899',  // 粉色
};
5.3 开始对战
点击「开始对战」后,同一个 prompt 并行发给所有选中的模型:
private startBattle(): void {
  const models = this.getSelectedModels();
  const messages: ChatMessage[] = [
    { role: 'system', content: '你是一个智能助手,请用中文回答。' },
    { role: 'user', content: this.inputText },
  ];

  this.battling = true;
  this.results = [];

  // 核心:多模型并行调用
  chatMultiModel(messages, models).then((results: ModelResult[]) => {
    // 按 total tokens 降序排列
    results.sort((a, b) => b.totalTokens - a.totalTokens);
    this.results = results;
    this.battling = false;

    // 保存到全局统计
    this.saveToStats(results);
  });
}
5.4 Token 消耗可视化
每个模型一条横向条形图,宽度代表 Token 占比:
@Builder
TokenBar(r: ModelResult) {
  // Total tokens 条
  Stack({ alignContent: Alignment.Start }) {
    Row()
      .width(this.calcBarWidth(r.totalTokens) + '%')
      .height(8).borderRadius(4)
      .linearGradient({
        angle: 0,
        colors: [[MODEL_COLORS[r.model], 0], [MODEL_COLORS[r.model], 1]]
      })
  }
  .width('100%').height(8).backgroundColor(C.bgSoft).borderRadius(4)

  // 推理 tokens 条(如果有)
  if (r.reasoningTokens > 0) {
    Row({ space: 6 }) {
      Text('推理').fontSize(9).fontColor(C.textDim)
      Stack({ alignContent: Alignment.Start }) {
        Row()
          .width(this.calcBarWidth(r.reasoningTokens) + '%')
          .height(6).borderRadius(3)
          .backgroundColor(C.warn)  // 橙色 = 推理消耗
      }
      .layoutWeight(1).height(6).backgroundColor(C.bgSoft).borderRadius(3)
      Text(r.reasoningTokens.toString()).fontSize(9).fontColor(C.warn)
    }
  }
}

private calcBarWidth(tokens: number): number {
  const maxTokens = Math.max(...this.results.map(r => r.totalTokens), 1);
  return Math.min(Math.round(tokens / maxTokens * 100), 100);
}
效果:最贵的模型条最长,一眼看出谁在烧 Token。推理 Token 用橙色单独标出,直观展示「思考成本」。
六、用量统计:数据聚合分析
6.1 数据存储
每次对战结果都存入 AppStorage,跨页面共享:
private saveToStats(results: ModelResult[]): void {
  const raw = AppStorage.get<string>('statsData') ?? '[]';
  const stats = JSON.parse(raw);
  for (const r of results) {
    stats.push({
      model: r.modelShort,
      modelKey: r.model,
      promptTokens: r.promptTokens,
      completionTokens: r.completionTokens,
      reasoningTokens: r.reasoningTokens,
      totalTokens: r.totalTokens,
      durationMs: r.durationMs,
      success: r.success,
      timestamp: Date.now(),
    });
  }
  AppStorage.setOrCreate('statsData', JSON.stringify(stats));
}
6.2 按模型维度聚合
private aggregateByModel(): ModelAgg[] {
  const map: Record<string, ModelAgg> = {};
  for (const s of this.stats) {
    if (!map[s.modelKey]) {
      map[s.modelKey] = {
        modelKey: s.modelKey, model: s.model,
        calls: 0, successCount: 0,
        totalTokens: 0, reasoningTokens: 0,
        avgDuration: 0, maxTokens: 0, minTokens: 999999,
      };
    }
    const agg = map[s.modelKey];
    agg.calls++;
    agg.totalTokens += s.totalTokens;
    agg.reasoningTokens += s.reasoningTokens;
    agg.avgDuration += s.durationMs;
    agg.maxTokens = Math.max(agg.maxTokens, s.totalTokens);
    agg.minTokens = Math.min(agg.minTokens, s.totalTokens);
  }
  // 计算平均耗时
  for (const a of Object.values(map)) {
    a.avgDuration = a.calls > 0 ? a.avgDuration / a.calls : 0;
  }
  return Object.values(map).sort((a, b) => b.totalTokens - a.totalTokens);
}
6.3 统计页面展示
七、暗色科技风 UI 设计
7.1 为什么用暗色?
竞技场是数据对比工具,暗色背景有三个优势:
- 突出数据:彩色条形图在深色背景上对比度更强
- 减少疲劳:长时间看数据不刺眼
- 科技感:符合「AI 竞技场」的调性
7.2 色彩体系
export class C {
  static readonly bg: string = '#0F172A';       // 深蓝黑底
  static readonly card: string = '#1E293B';     // 卡片灰蓝
  static readonly text: string = '#F1F5F9';     // 高对比白字

  // 蓝耘品牌色
  static readonly lanYun: string = '#2563EB';
  static readonly lanYunAccent: string = '#3B82F6';
  static readonly lanYunCyan: string = '#0EA5E9';

  // 模型标识色(每个模型一个颜色)
  static readonly deepseek: string = '#3B82F6';  // 蓝
  static readonly kimi: string = '#8B5CF6';     // 紫
  static readonly qwen: string = '#10B981';     // 绿
  static readonly glm: string = '#F59E0B';      // 金
  static readonly minimax: string = '#EC4899';  // 粉
}
7.3 沉浸式状态栏
// EntryAbility.ets
win.setWindowLayoutFullScreen(true);
win.setWindowSystemBarProperties({
  statusBarContentColor: '#FFFFFF',  // 白色状态栏文字
  navigationBarContentColor: '#FFFFFF'
});
八、完整代码结构
8.1 LanYunAI.ets — 服务层
| 导出 | 类型 | 用途 |
|---|---|---|
chatWithUsage() | async function | 单模型调用,返回完整 usage |
chatMultiModel() | async function | 多模型并行,Promise.all |
LAN_YUN_MODELS | string[] | 5 个可用模型 |
MODEL_SHORT | Record | 模型简称映射 |
MODEL_COLORS | Record | 模型主题色映射 |
MODEL_DESCS | Record | 模型描述文案 |
TEST_PROMPTS | TestPrompt[] | 6 个快捷测试 prompt |
8.2 ArenaTab.ets — 竞技场页面
| 功能 | 实现方式 |
|---|---|
| 模型选择 | boolean[] 数组 + Flex 布局 |
| 并行调用 | chatMultiModel() + Promise.all |
| Token 可视化 | Stack + Row 条形图 |
| 结果排序 | 按 totalTokens 降序 |
| 历史记录 | BattleRecord[] 数组 |
8.3 StatsTab.ets — 统计页面
| 功能 | 实现方式 |
|---|---|
| 数据存储 | AppStorage.setOrCreate('statsData', ...) |
| 模型聚合 | aggregateByModel() 按模型分组 |
| 总览卡片 | 6 个 BigStat 组件 |
| 明细列表 | 最近 20 条调用记录 |
九、性能优化要点
9.1 并行 vs 串行
串行调用 5 个模型(每个 3 秒):
DeepSeek ████ 3s
Kimi           ████ 4s
Qwen                ████ 8s
GLM                      ████ 3s
MiniMax                       ████ 4s
总耗时 = 3+4+8+3+4 = 22 秒 ❌

并行调用 5 个模型:
DeepSeek ████ 3s
Kimi     ████ 4s
Qwen     ████████ 8s
GLM      ████ 3s
MiniMax  ████ 4s
总耗时 = max(3,4,8,3,4) = 8 秒 ✅
Promise.all 让总耗时取决于最慢的那个模型,而不是所有模型之和。
9.2 超时保护
每个请求都有独立的超时机制:
const timeoutPromise = new Promise<string>((_, reject) => {
  setTimeout(() => reject(new Error('请求超时(90s)')), 90000);
});

const raw = await Promise.race([requestPromise, timeoutPromise]);
Promise.race 确保即使某个模型卡住,也不会无限等待。
9.3 错误隔离
一个模型失败不影响其他模型的结果:
export async function chatWithUsage(...): Promise<ModelResult> {
  try {
    // 正常调用
    return { success: true, ... };
  } catch (e) {
    // 失败也返回结果,标记 success: false
    return { success: false, error: e.message, ... };
  }
}
Promise.all 中即使某个 promise reject 了,其他已 resolved 的结果也不会丢失(因为我们在 chatWithUsage 内部 catch 了所有异常)。
十、实测数据汇总
10.1 代码生成类(快速排序)
| 模型 | Total Tokens | Reasoning | 耗时 | 内容长度 | 每千字 Token |
|---|---|---|---|---|---|
| DeepSeek | 1763 | 623 | 3.2s | 2166 | 814 |
| Kimi | 2002 | 602 | 4.1s | 3284 | 610 |
| GLM | 2100 | 1479 | 3.8s | 1419 | 1480 |
| MiniMax | 2251 | 0 | 5.2s | 5192 | 434 |
| Qwen | 3764 | 2334 | 8.5s | 2790 | 1349 |
性价比排名(每千字消耗 Token 越少越好):
- MiniMax 434 tokens/千字
- Kimi 610 tokens/千字
- DeepSeek 814 tokens/千字
10.2 数据分析类(新能源趋势)
| 模型 | Total Tokens | Reasoning | 耗时 |
|---|---|---|---|
| Kimi | 382 | 0 | 2.1s |
| DeepSeek | 678 | 0 | 2.8s |
| Qwen | 1999 | 1361 | 6.3s |
10.3 核心洞察
- Qwen 是「思考型」模型:reasoning_tokens 占比 60-70%,适合需要深度推理的任务
- MiniMax 是「直觉型」模型:reasoning_tokens = 0,直接输出,速度有优势但深度不够
- DeepSeek 是「性价比之王」:Token 消耗稳定偏低,质量可靠
- Kimi 是「内容之王」:同样 Token 下输出内容最长
- GLM 是「中文专家」:中文表达最自然,但推理占比偏高
十一、总结
这次实战最大的收获,并不是简单地在鸿蒙应用中接入了 5 个大模型,而是搭建出了一套可以真正用数据进行模型决策的「AI 竞技场」。通过蓝耘 MaaS 的统一接口,一个 API Key 就能完成 DeepSeek、Kimi、Qwen、GLM、MiniMax 等模型的调用,再结合 Promise.all 实现并行请求,将不同模型的回答内容、Token 消耗、推理 Token 和响应耗时放到同一个页面进行直观对比。实测也说明,大模型之间并不存在绝对的“最强”,不同任务下,模型在成本、速度、推理深度和输出风格上的差异非常明显:有的模型 Token 更省,有的更擅长深度推理,有的输出内容更丰富,也有的响应速度更有优势。对于开发者来说,与其凭感觉选择模型,不如通过真实 Prompt、真实调用数据持续测试,最终根据业务场景选择最合适的模型。这个鸿蒙 AI 竞技场,本质上就是把“选模型”从主观体验变成了一次可量化、可视化、可复用的数据分析过程。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 7
 0
- 0


 已为社区贡献229条内容

所有评论(0)