
从一句话到一个公开仓库:华为云码道 CodeArts 实战生成鸿蒙大会签到页
一键开通华为云码道 CodeArts 代码智能体:https://developer.huaweicloud.com/codeartsco.html?source=dmzntgwatomgit1&sourcead=dmzntgwatomgithd
一、"小东西"的另一副面孔
一次对话,一句需求,一个文件,一个仓库。
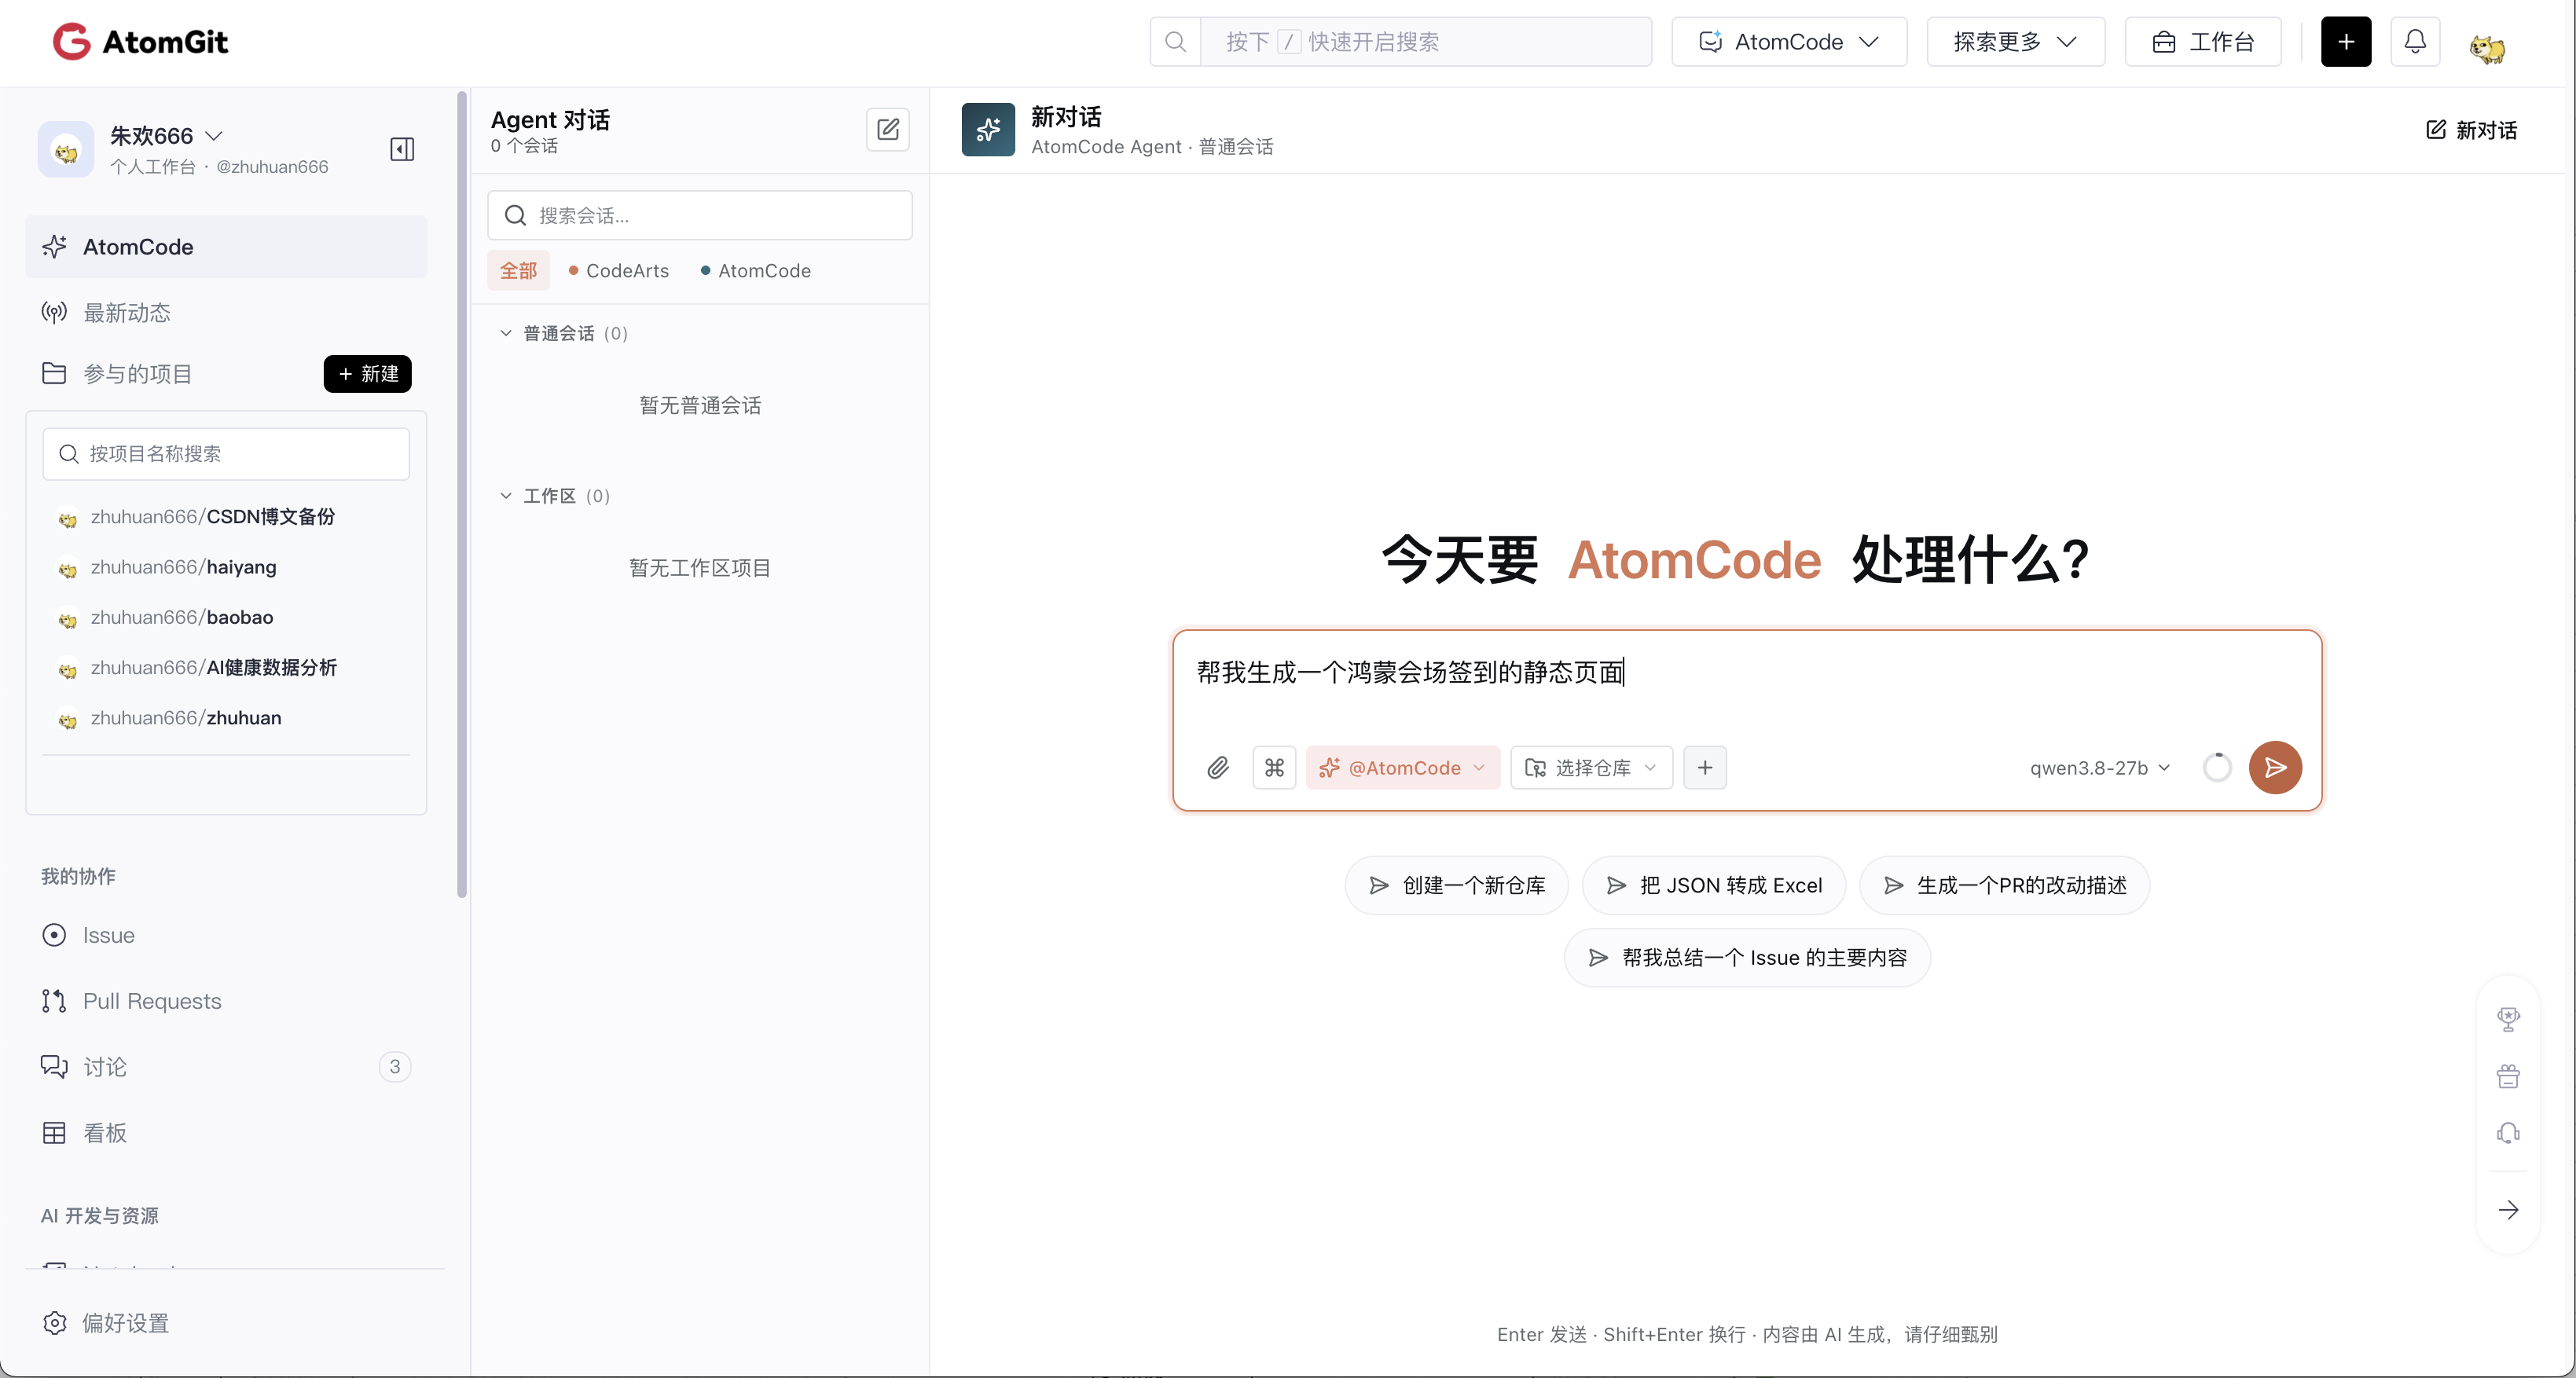
这次的样本小得有点不起眼:一个鸿蒙开发者大会的会场签到页。左侧会话列表的最上面躺着那句话——“帮我生成一个鸿蒙会场签到的静态页面”。没有技术栈要求,没有页数要求,没有设计稿,连"移动端还是 PC 端"都没说。和前两次一样,起点只有一行字。
前两篇我拆的是鸿蒙仿京东商城和 Vue3 手办馆,选那两个样本有个很实在的理由。前者把"没有工具链的鸿蒙工程"长成了 43 个文件 2481 行 ArkTS,后者把"有 Node 的真实前端工程"从装依赖一路做到 Playwright 无头复验。它们的看点是工程厚度——文件多、配置多、链路长,随便截一张图都是满屏的结构,天然适合"逐帧拆解"。
这次不一样。这次总共就一个 HTML 文件,260 行,6886 字节,没有任何外部依赖,浏览器双击就能打开。按"信息密度"算,它可能是三个样本里最没有可讲之处的那个。
但它恰好暴露了另一件事。
越是"轻"的任务,越没有外力可借。前两次里,很多环节其实是有"客观裁判"的:鸿蒙工程能不能打开,看 module.json5 的引用对不对得上;Vue3 项目能不能跑,看 npm run build 过不过、Playwright 的断言绿不绿。这些环节不需要模型做判断,只要跑一遍就知道对错。而这一次,从第一个 token 到最后一个字节,几乎没有任何构建系统、依赖清单或测试脚本能替它做决定——页面长什么样、二维码怎么来、状态存哪、怎么证明文件是好的、仓库该公开还是私有,全部是选择题,没有标准答案摆在那儿。
所以我决定换一种拆法。前两篇是沿着时间线走的:第 1 张图干了什么、第 2 张图干了什么,像看一段回放。这一篇改成按决策点走——跳过那些"把想法敲成代码"的过程性镜头,只停在七个真正需要判断的路口上,看看它在每个路口面前摆出了哪些选项、为什么选了这一个、以及这个选择后来付出了什么代价、换回了什么收益。
把"写代码"当成体力活,把"做决策"当成脑力活,这大概是看 AI 编程最容易被忽略的一个视角。这篇文章就是想把这个视角撑开一点。
二、先看全貌:一次对话里的七个岔路口
在逐点展开之前,先把整条链路摆出来。整段对话只发生在一个会话窗口里,从头到尾没有开第二个对话,也没有中途换模型——输入框右下角那个 qwen3.8-27b 的标识始终没变过。
这条链路上有两次明显的"折返"——图里没画出来,但在实际执行中确实发生了:一次是 write_file 的参数名写错导致第一次写入失败,一次是内联的 Python 校验脚本自己出了语法错误。这两次折返恰好是这个样本最有意思的地方,我会在第七、八节单独展开。
先把七个决策点的基本信息摊在表格里,方便回头看:
| 决策点 | 岔路口的关键问题 | 实际选择 | 大致代价 |
|---|---|---|---|
| 一、路线选择 | 技能库没有匹配项,是硬套工作流还是直走通用路径 | 直走通用前端路径,并显式声明"无匹配技能" | 放弃了技能库可能带来的流程约束 |
| 二、信息架构 | 一句"签到页"要落地成哪些区块 | 五区块结构:头部横幅 / 我的签到 / 今日日程 / 今日嘉宾 / 签到须知 | 区块一旦定死,后续追加只能在这套骨架里补 |
| 三、写入策略 | 单文件 400–500 行,可能触发输出上限 | 拆成 write_file + 两次 edit_file 三段写 | 多两次工具往返,且依赖锚点标记 |
| 四、二维码方案 | 无库、无网络、无素材 | Canvas 手绘伪二维码,固定种子保证显示稳定 | 图案是假的,不具备真实可扫性 |
| 五、状态设计 | 静态页怎么"记住"已签到 | localStorage 持久化 + 徽章弹出 + 二次点击幂等 | 换设备即失效,是纯本地演示态 |
| 六、验证手段 | 环境里没有 JS 运行时 | Python html.parser 解析 + 括号配对检查 | 只验证结构完整性,验证不了运行正确性 |
| 七、交付方式 | 工作区文件怎么变成可访问的仓库 | git init → ag repo create 公开 → push → ag repo view 复核 | 多走了一遍远程验证 |
七行看完,能大概感觉到这次任务的形状:它的难点不在"写",而在"选"。下面逐个展开。
三、决策一:技能库匹配不到的时候,是硬套还是直做
第一张截图里,模型在第一轮推理中就抛出了一句话,值得原样引来:
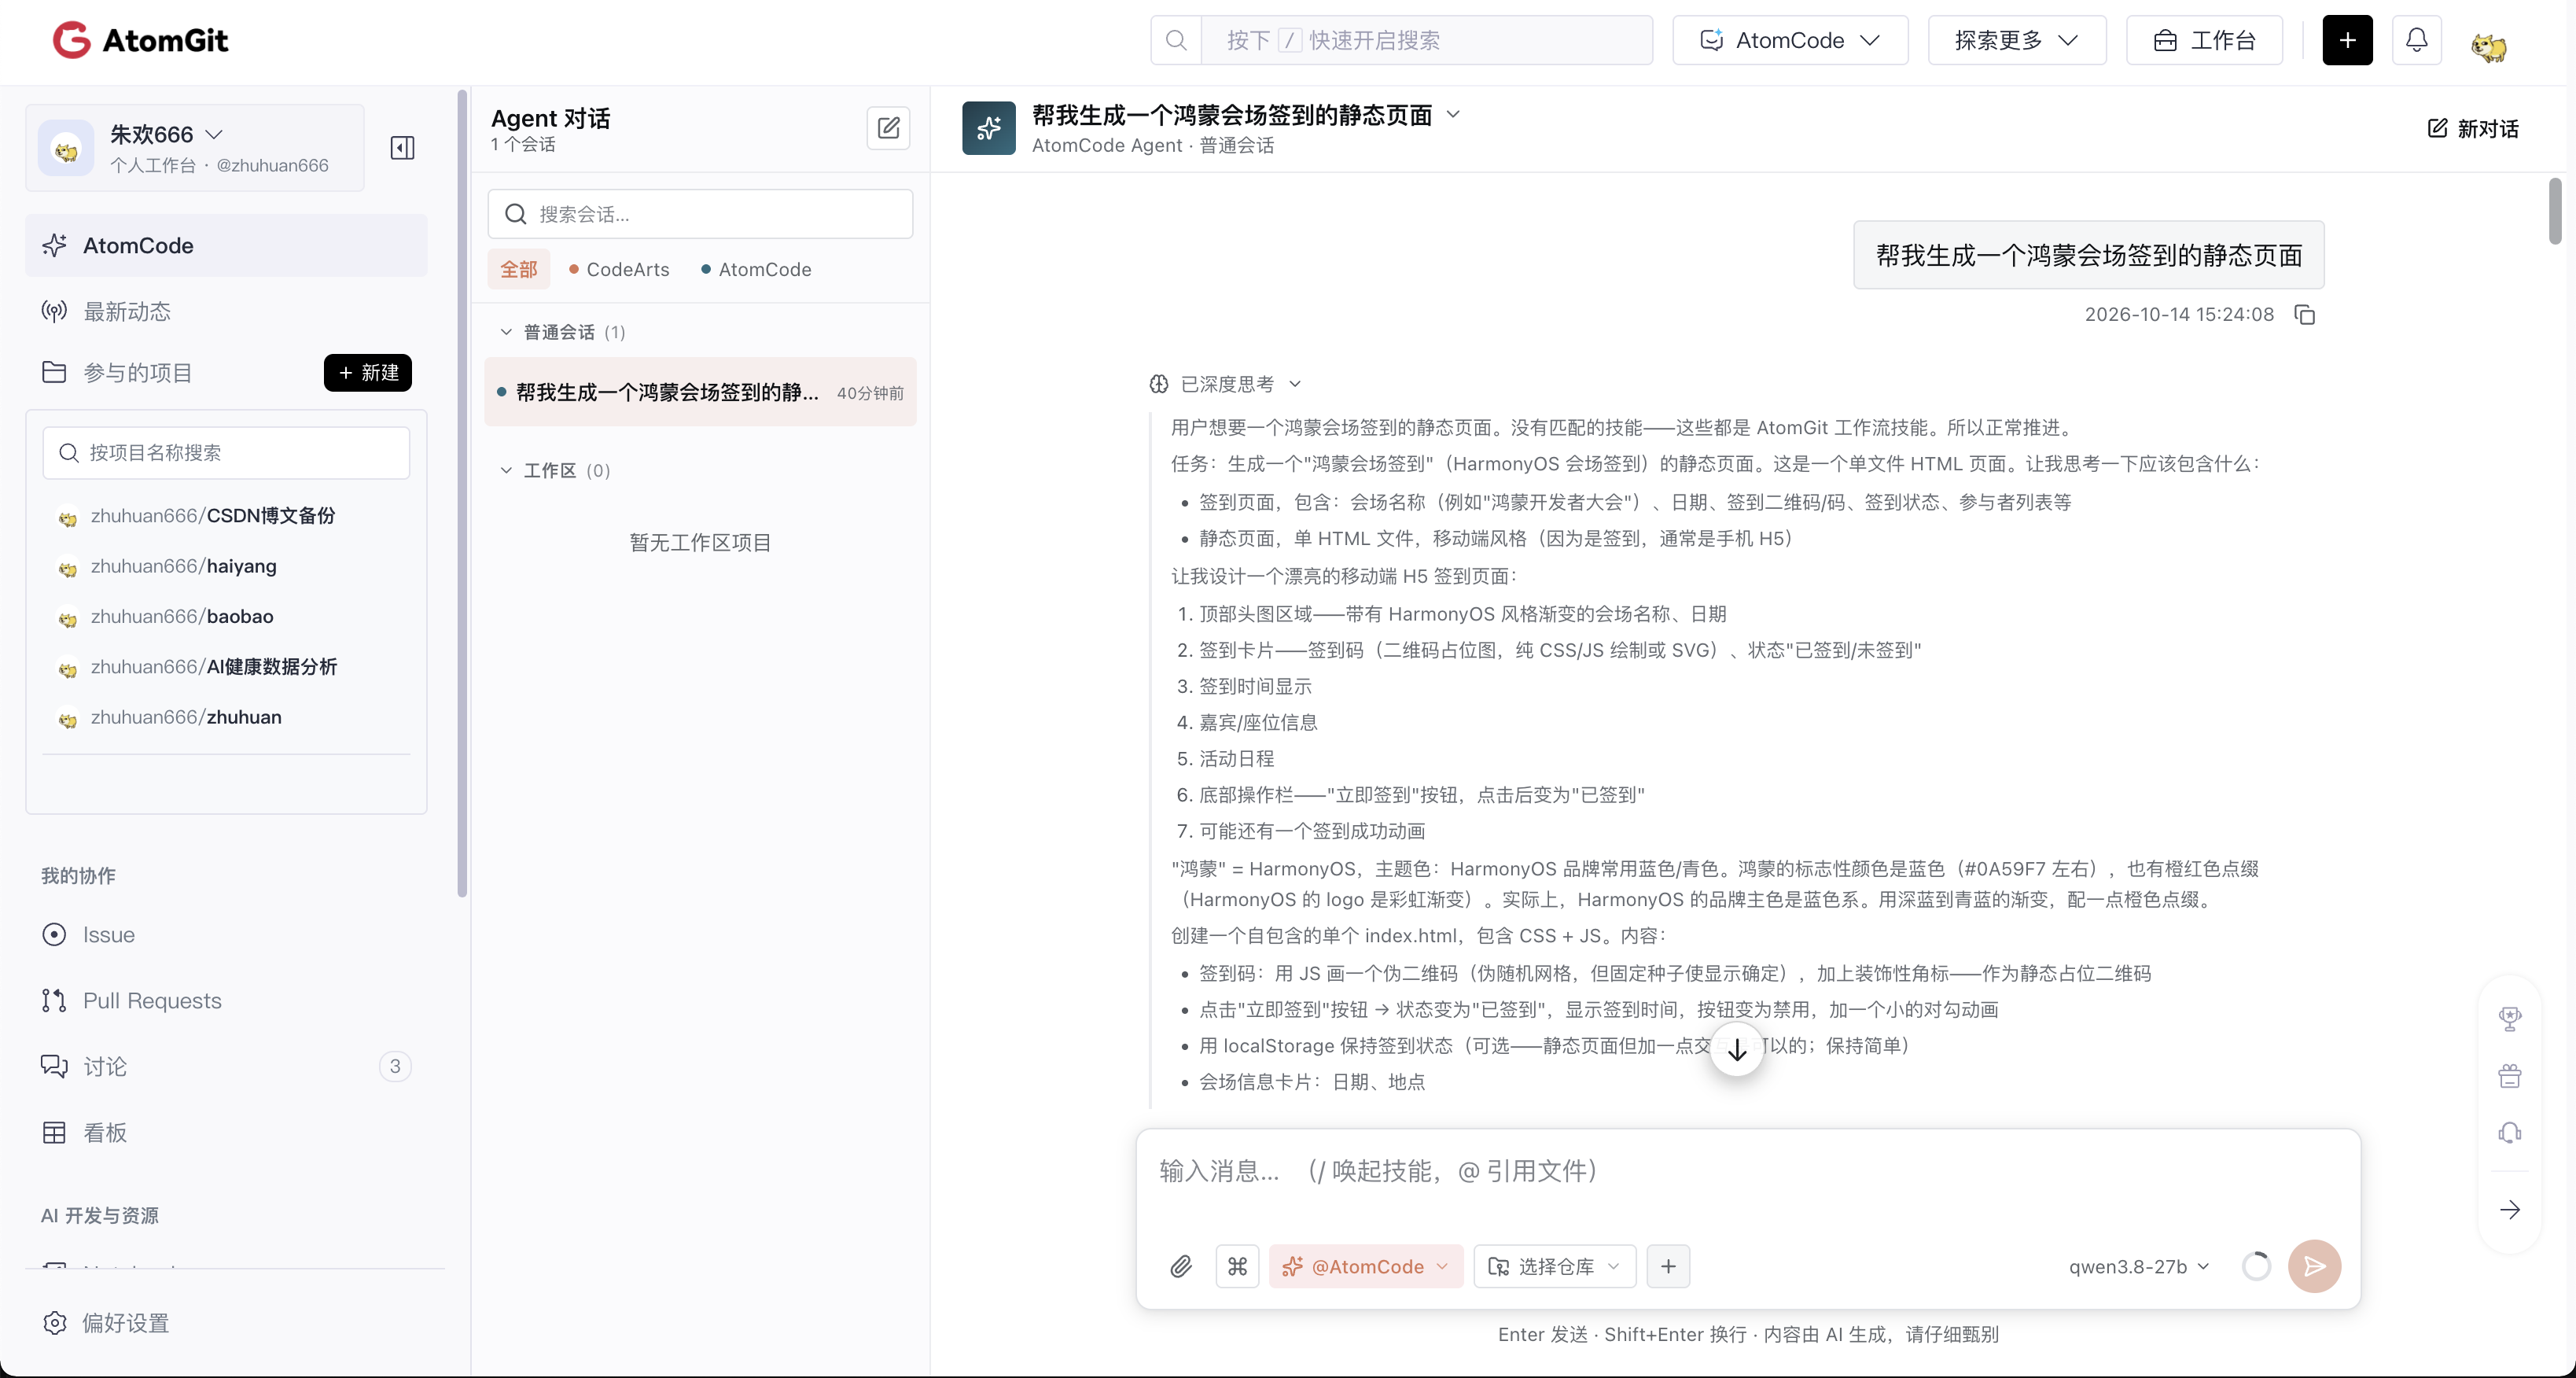
用户想要一个鸿蒙会场签到的静态页面。没有匹配的技能——这些都是 AtomCode 工作流技能。所以正常推进。
这句话背后其实是一个很容易被忽略的岔路口。现在的编程智能体几乎都挂了技能库(Skill),技能库的好处是把某些高频任务固化成流程,坏处是当需求不完全落在任何一条既定流程里时,模型容易产生一种"必须塞进某个框"的冲动——挑一个沾边的技能,然后硬把需求往里套,结果是流程跑完了,产物却和需求错位。
这里模型的判断是"不套"。它先确认了技能库里的条目都属于 AtomCode 工作流(创建仓库、生成 PR 描述、总结 Issue 那一类平台操作技能),确认没有一条覆盖"生成一个前端页面",然后干净利落地切回通用前端路径。这个判断的价值在于:它把"能力边界"和"任务边界"分开了——技能库覆盖不到,不代表任务做不了,只代表没有捷径可走。
对照一下新手的常见反应就很清楚。新手遇到"没有现成模板/组件库/脚手架"时,通常有两种走向:要么原地卡住,反复找一个"更合适的"工具;要么随便抓一个近似的模板硬改,最后交付的东西和需求差了一截,还得回头返工。老手和 AI 在这个路口的表现反而接近——先判断有没有可复用的路径,没有就承认没有,然后用自己的基本功把活干了。
| 维度 | 新手手写 | AI(本次) |
|---|---|---|
| 面对"无匹配技能" | 容易卡住找工具,或抓近似模板硬套 | 显式声明无匹配,切回通用路径 |
| 决策的可见性 | 决策停留在脑子里,不可追溯 | 推理中说出"没有匹配的技能",决策可审计 |
| 对能力边界的处理 | 常把"没有工具"误判成"做不了" | 把"没有捷径"和"任务不可做"分开 |
| 沉没成本 | 硬套模板后返工的时间白白蒸发 | 直接跳进主流程,无额外沉没成本 |
这里还有个细节:它不仅说了"没有匹配的技能",还顺手给这个结论加了限定——“这些都是 AtomCode 工作流技能”。这句话是它在做归因:技能库的定位本来就不是"前端生成器",所以匹配落空是正常的,不是失败。一个模型能不能在推理里把"这不是我的场景"说清楚,直接决定了它会不会走进一条错误的路。
四、决策二:一句"签到页",该被翻译成什么样的信息架构
"帮我生成一个鸿蒙会场签到的静态页面"这句话,信息量约等于零。真正的工作量在翻译这一步:把一句人话拆成一个页面该有的骨架。
模型在推理里给出的第一版拆解是这样的(原话,未改动):
- 顶部头图区域——带有 HarmonyOS 风格渐变的会场名称、日期
- 签到卡片——签到码(二维码占位图,纯 CSS/JS 绘制或 SVG)、状态"已签到/未签到"
- 签到时间显示
- 嘉宾/座位信息
- 活动日程
- 底部操作栏——“立即签到"按钮,点击后变为"已签到”
- 可能还有一个签到成功动画
注意这个列表的颗粒度。它不是"做一个好看的签到页"这种空话,而是把页面切成了有明确职责的区块:哪块放身份、哪块放凭证、哪块放状态、哪块放内容、哪块放操作。一个新手拿到同样的需求,脑子里浮现的往往是"签到页大概就是上面一个标题、中间一个二维码、下面一个按钮",等到真正写起来才发现漏了日程、漏了嘉宾、漏了须知,于是边写边补,最后区块布局七零八落。
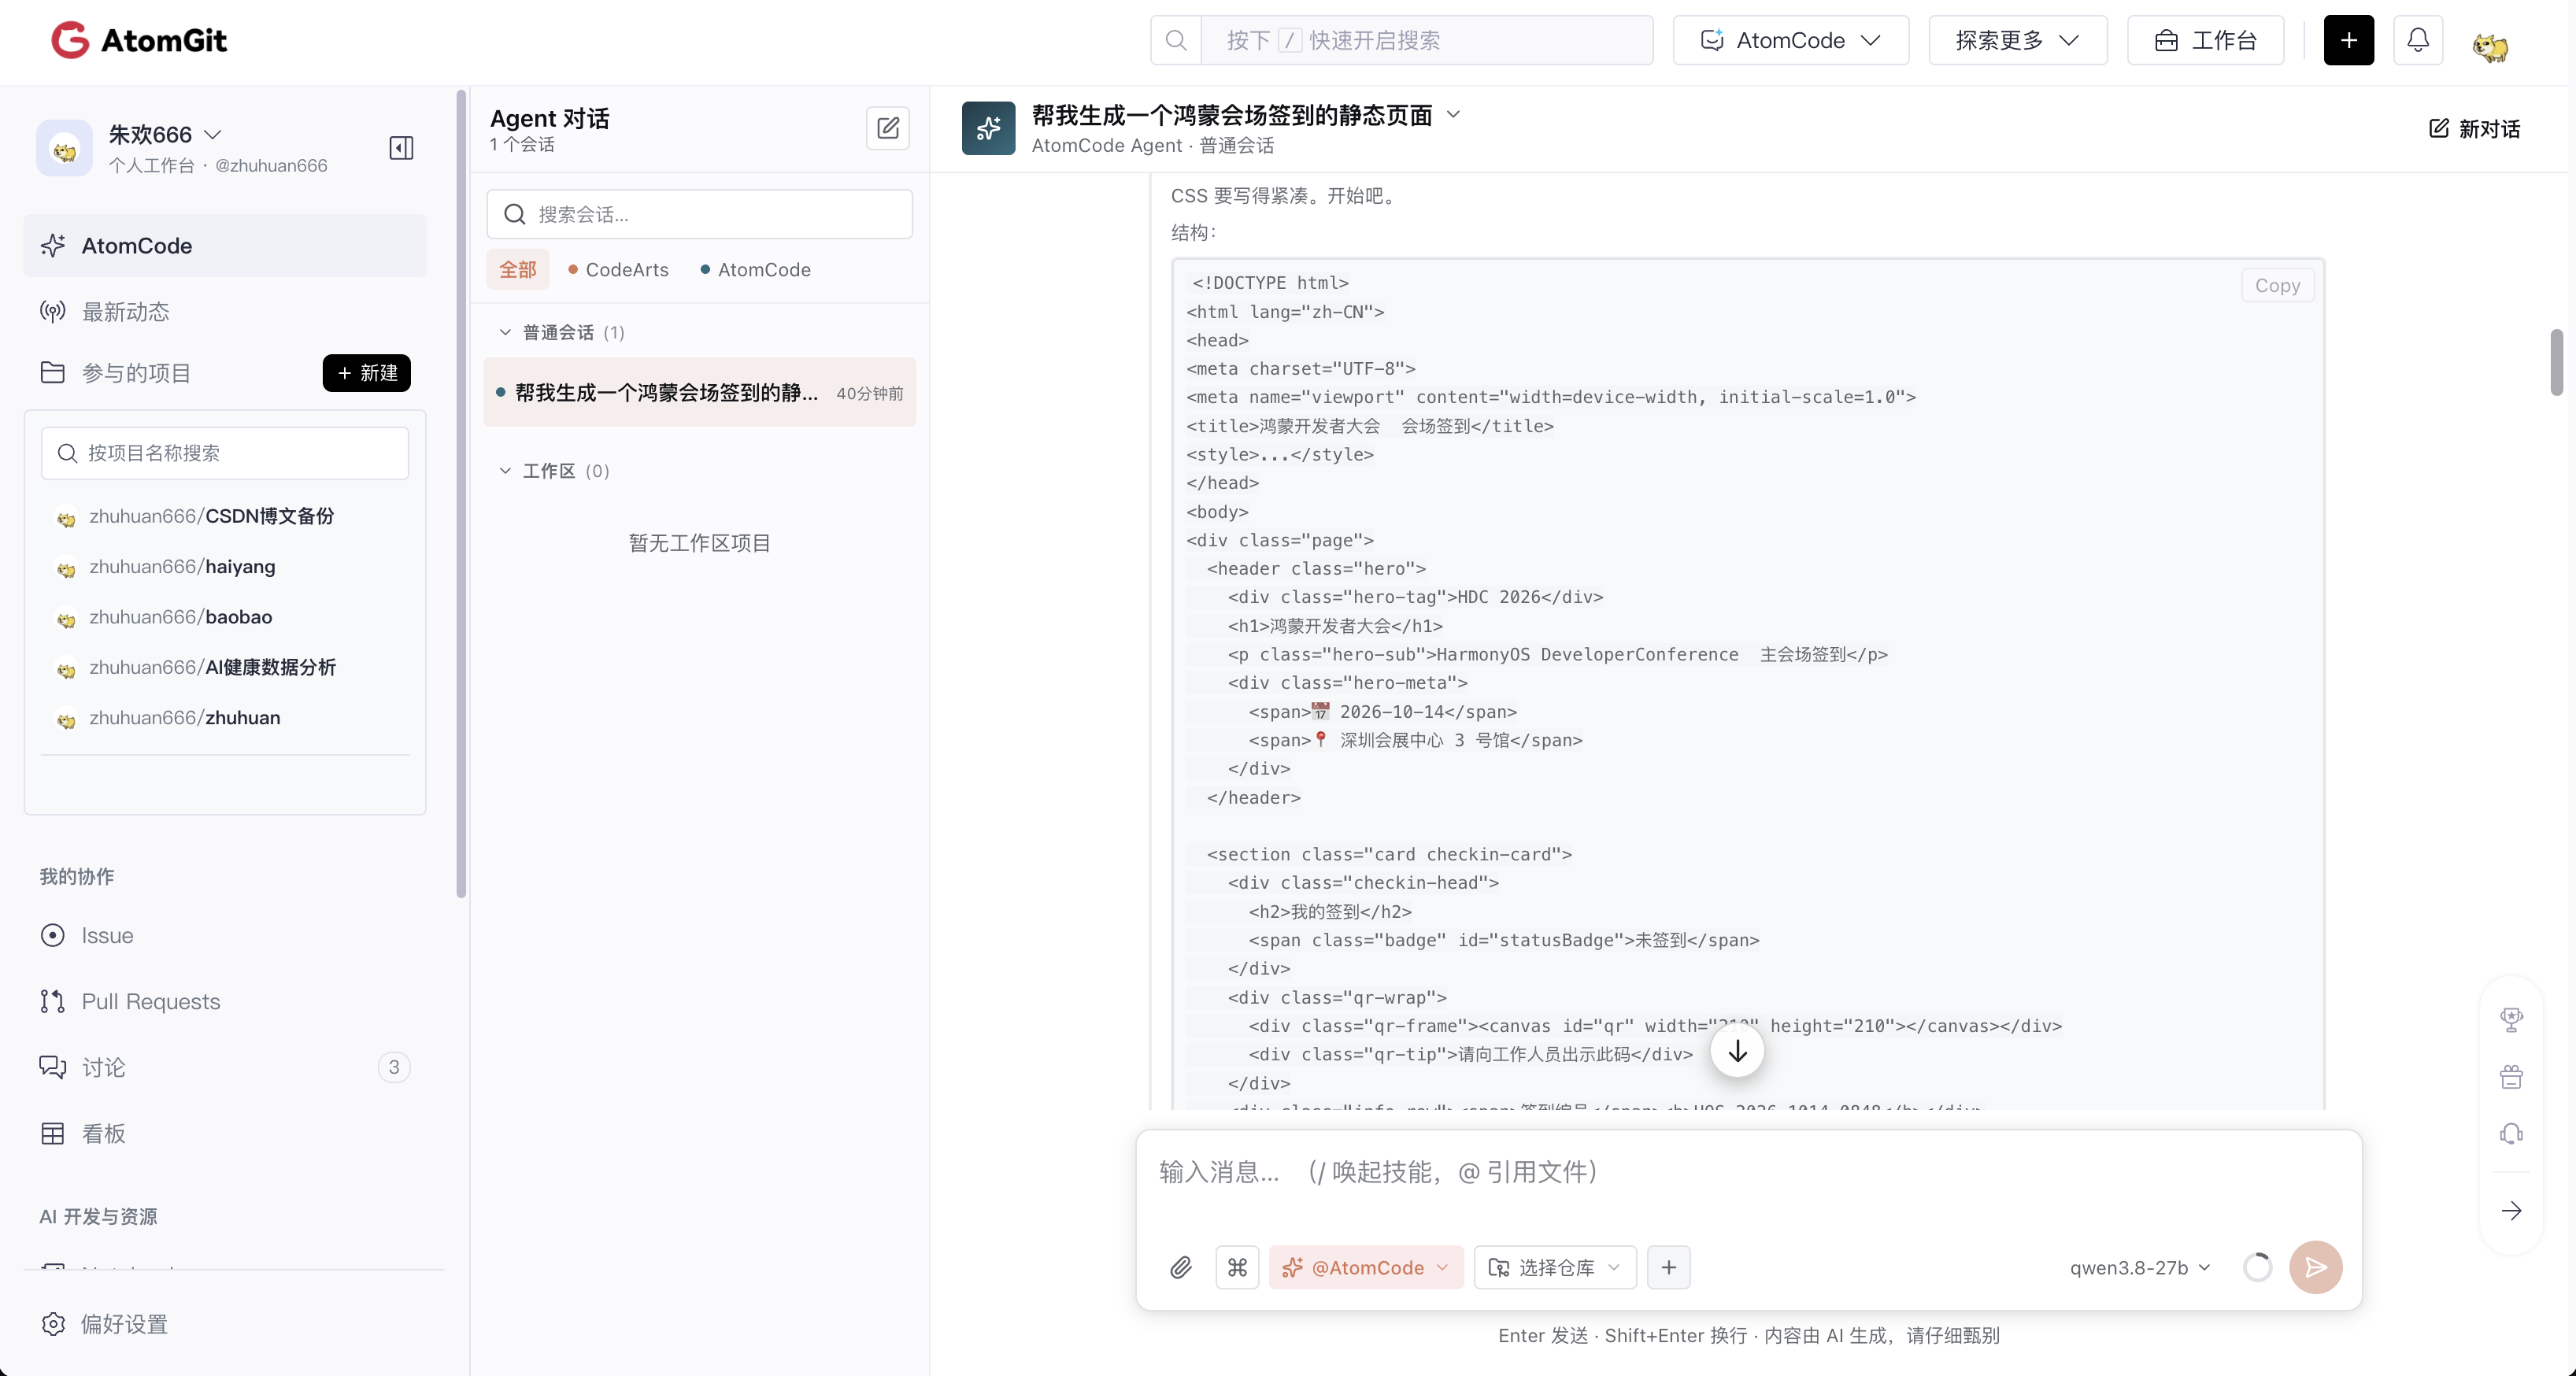
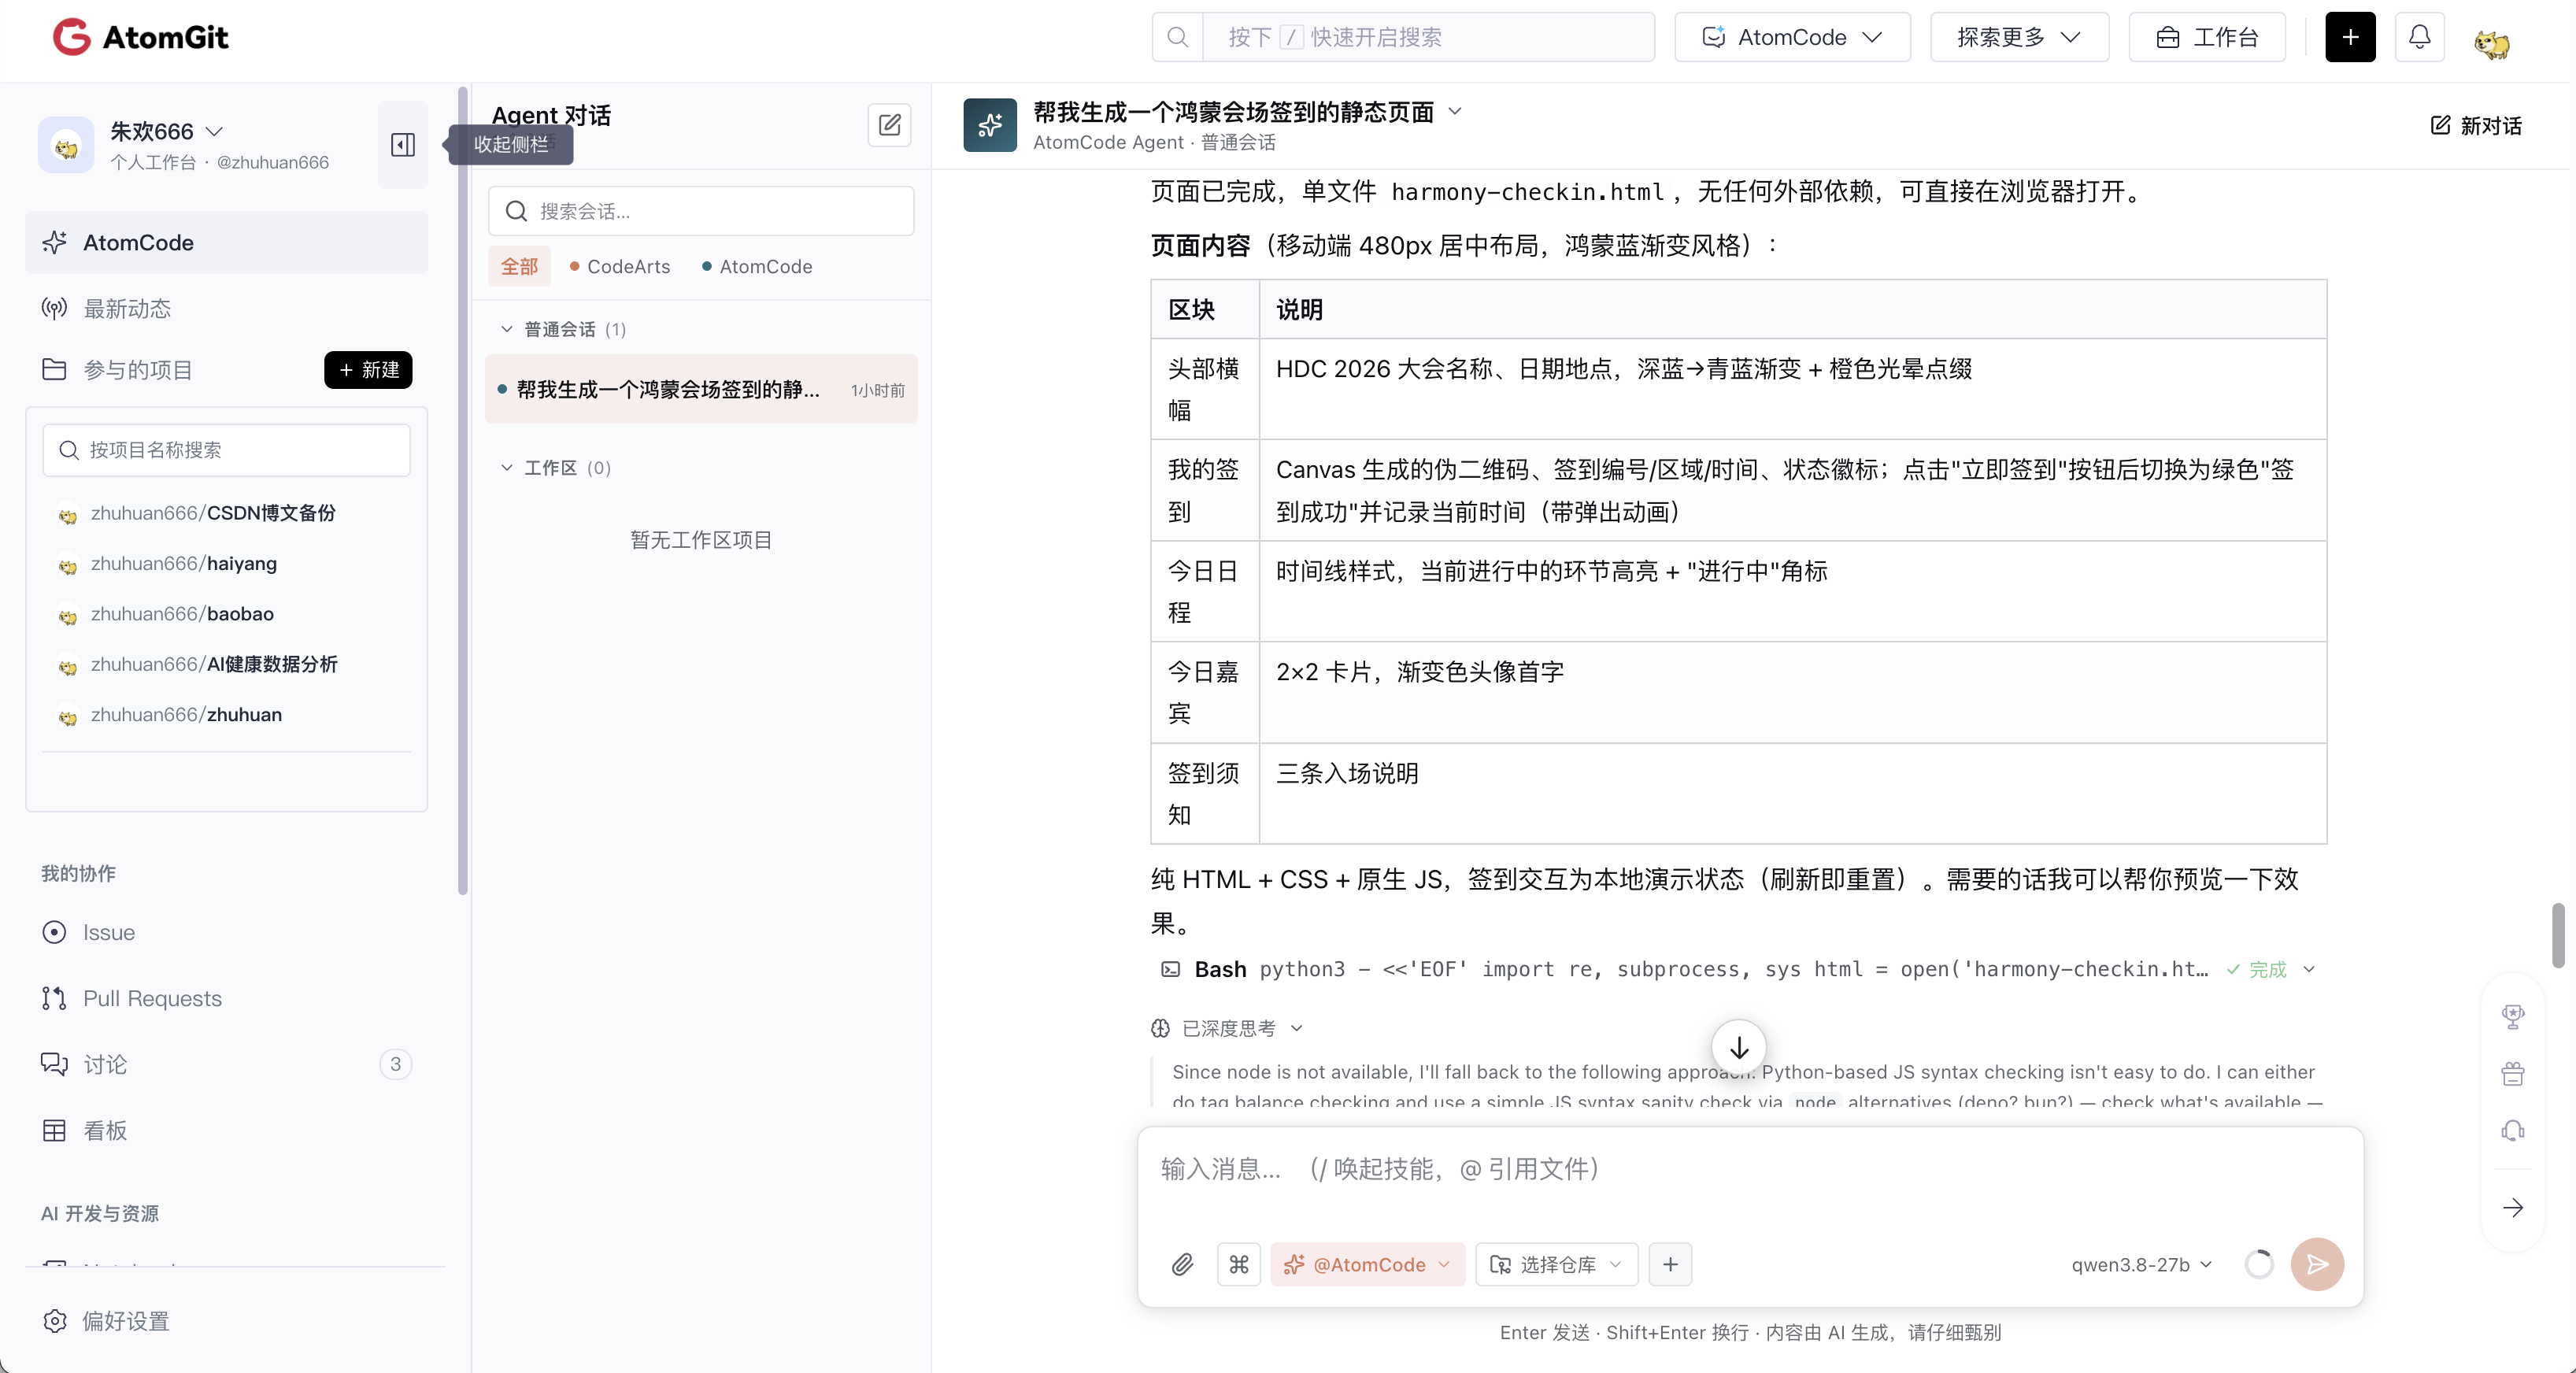
更值得看的是,它在草稿之后又做了一次"收敛"——把 7 条草稿压成了 5 个实际落地的区块。截图里最终交付的页面结构表长这样:
| 区块 | 说明 |
|---|---|
| 头部横幅 | HDC 2026 大会名称、日期地点,深蓝 → 青蓝渐变 + 橙色光晕点缀 |
| 我的签到 | Canvas 生成的伪二维码、签到编号 / 区域 / 时间、状态徽标;点击"立即签到"按钮后切换为绿色"签到成功"并记录当前时间(带弹出动画) |
| 今日日程 | 时间线样式,当前进行中的环节高亮 + "进行中"角标 |
| 今日嘉宾 | 2×2 卡片,渐变色头像首字 |
| 签到须知 | 三条入场说明 |
草稿里的 7 条去哪了?“签到时间显示"被并进了"我的签到”(时间是状态的一部分,不该单独成块),"底部操作栏"的按钮被并进了签到卡片(操作和状态放一起才不会割裂),"签到成功动画"降级成了一个 CSS 细节而不占独立区块。从 7 条砍到 5 条,砍掉的都是"看起来独立、实际属于别的区块"的东西——这是信息架构能力,不是写代码的能力。
再看它的移动端判断。需求里没提端,但它自己补了一条推理:“静态页面,单 HTML 文件,移动端风格(因为是签到,通常是手机 HS)”。然后给出了具体的布局参数——max-width: 480px 居中。这个数字选得挺有讲究:480px 是常见的移动端内容容器宽度,比 375/414 这类真实机型宽度略宽,是为了在桌面浏览器里预览时也能有个像样的版心,同时又不会宽到失去"手机页"的比例感。
| 判断项 | 新手常见做法 | AI(本次)做法 |
|---|---|---|
| 区块划分 | 边写边补,结构随写随变 | 先列 7 条草稿,再收敛成 5 个区块 |
| 端适配 | 需求没说就按 PC 做,或压根不设断点 | 主动推断"签到=手机场景",max-width: 480px 居中 |
| 视觉基调 | 随机配色,或直接上默认蓝 | 参照品牌色(HarmonyOS 蓝系 + 橙色点缀)定调 |
| 内容填充 | 留占位符 TODO、xxx | 直接给确定值(具体日期、地点、嘉宾名) |
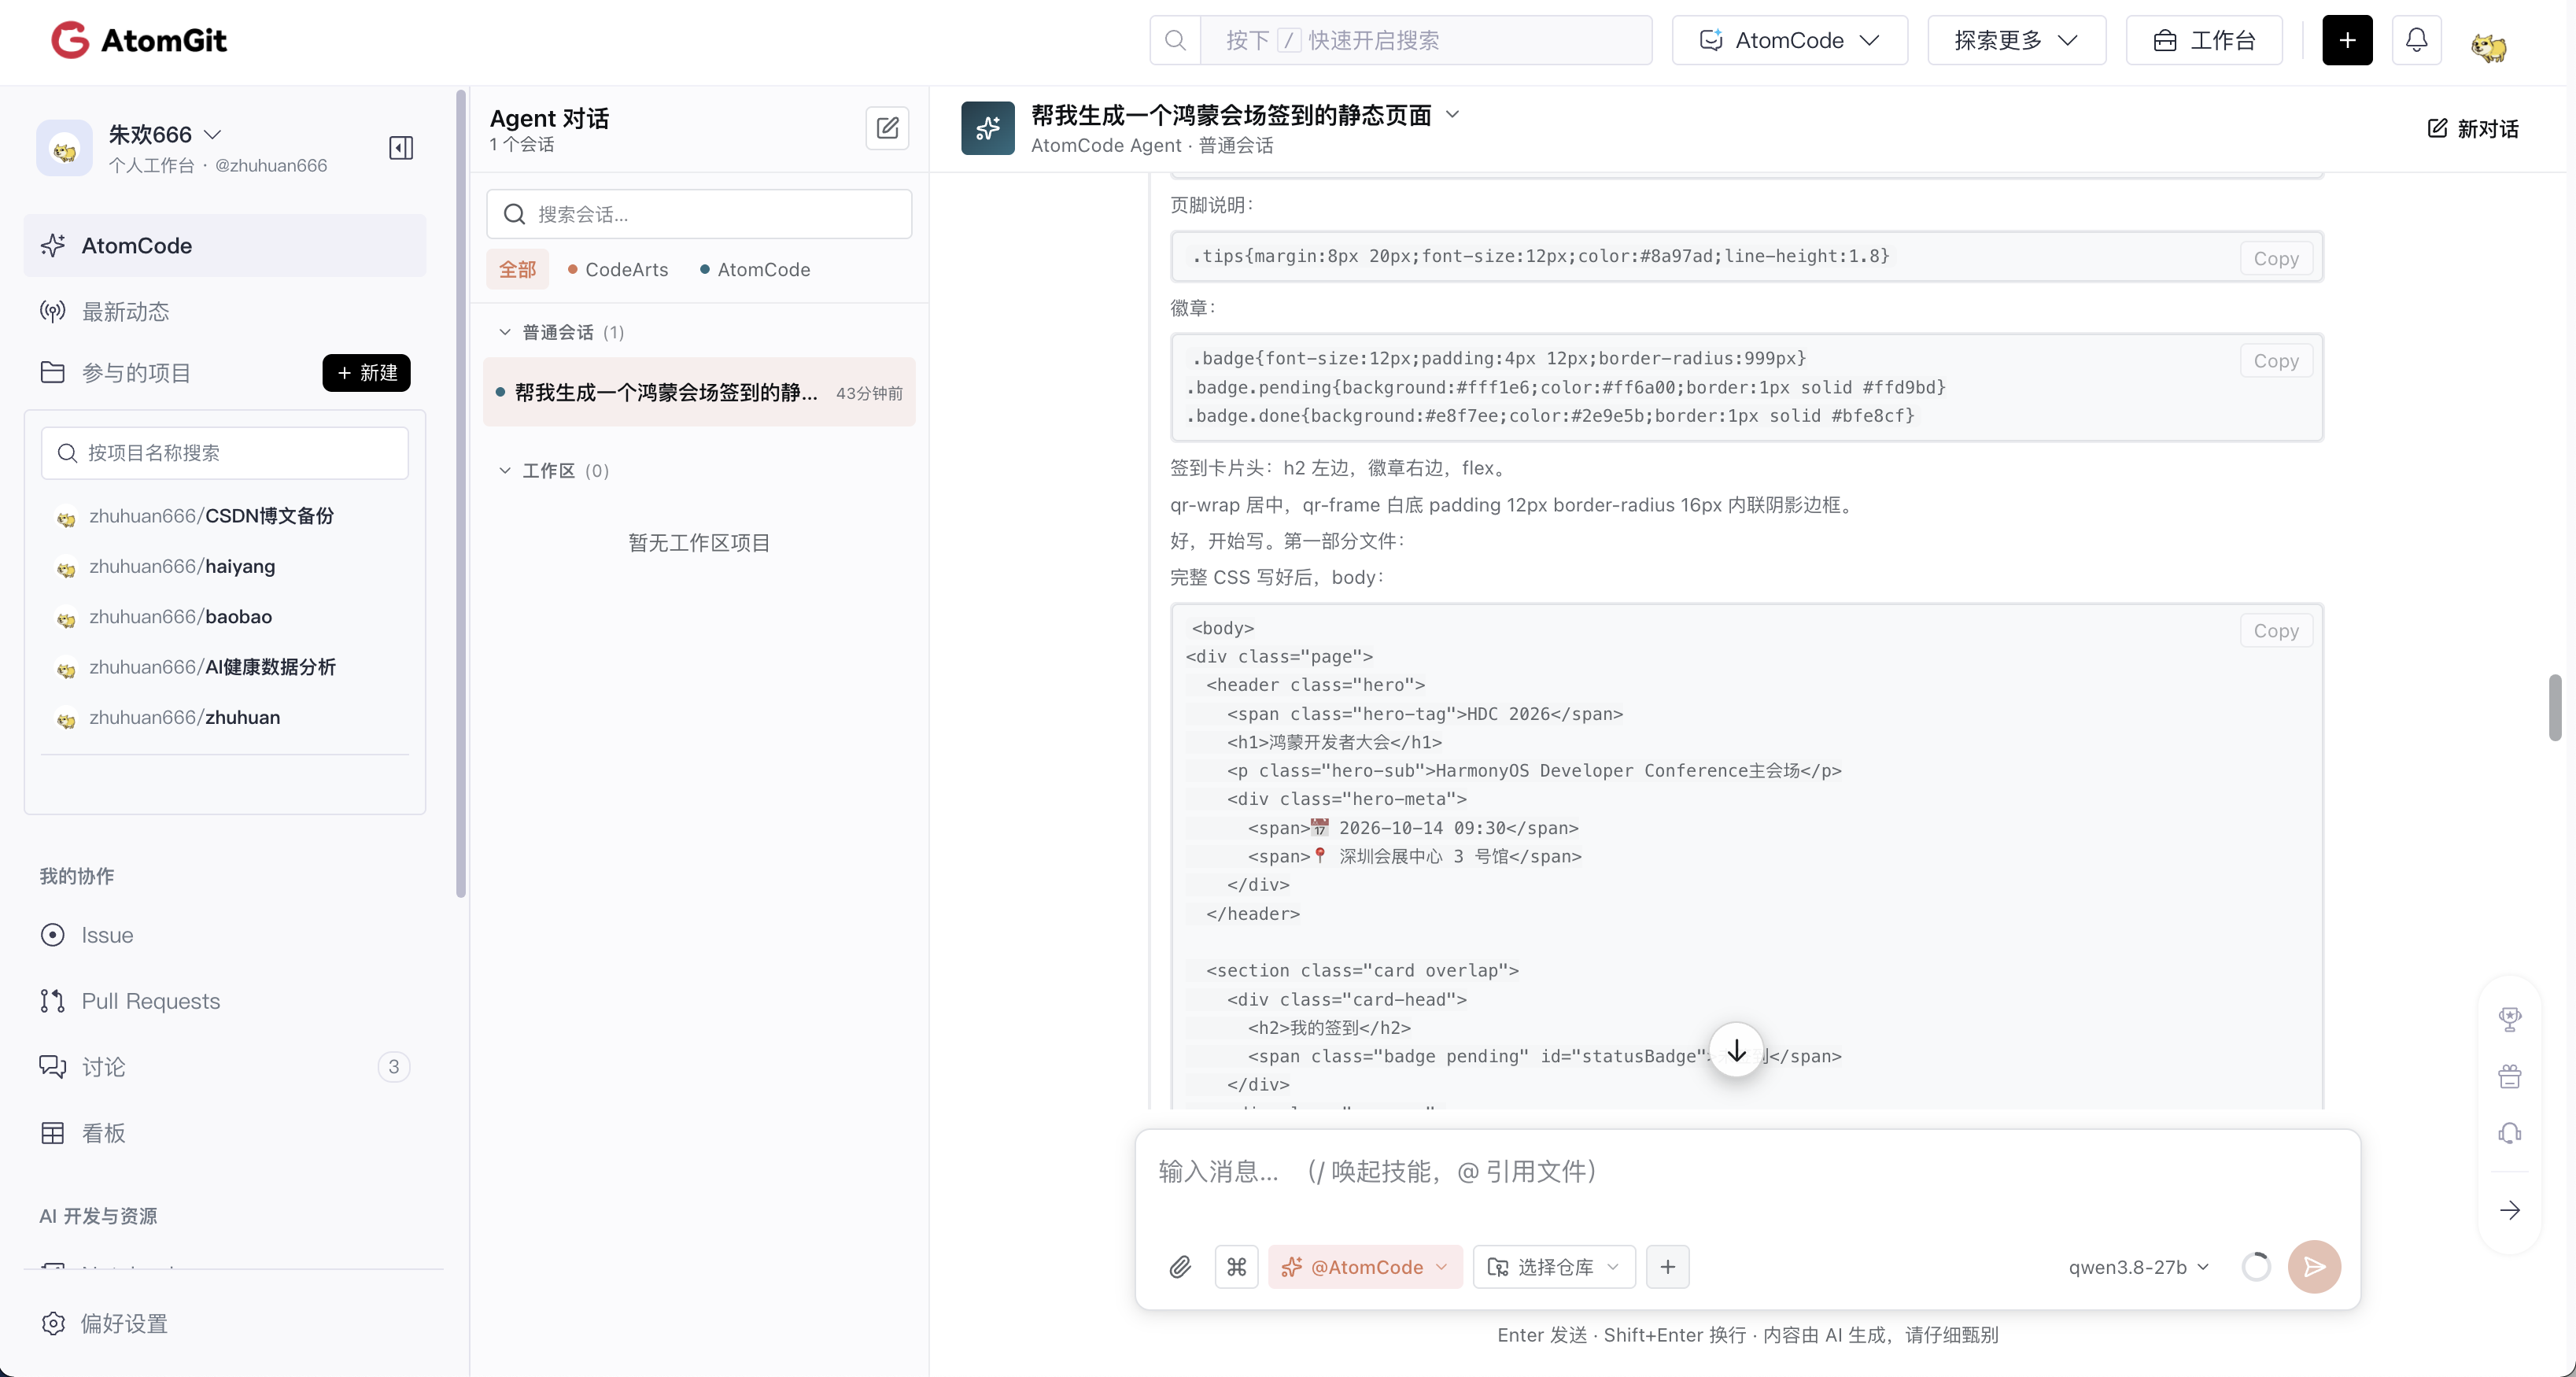
最后一行那个"直接给确定值"很关键。页面里的日期写着"2026 年 10 月 14 日 09:30",地点写着"深圳会展中心 3 号馆",嘉宾用四个虚构但成体系的名字(林远航、苏曦晚、陈子昂、顾晴),日程排成五档(09:30 签到入场 / 10:00 开幕主题演讲 / 11:00 HarmonyOS 6 技术解读 / 14:00 分会场研讨 / 16:00 开发者圆桌对话)。新手交付 demo 时常留一堆 xxx 占位符,AI 则会主动"编"出合理的内容把页面填满——这个差异在演示环节的观感上差得很远。
五、决策三:被 token 预算逼出来的三段式写入
这是整篇里最有工程味的一个决策,也是它和新手差异最大的一点。
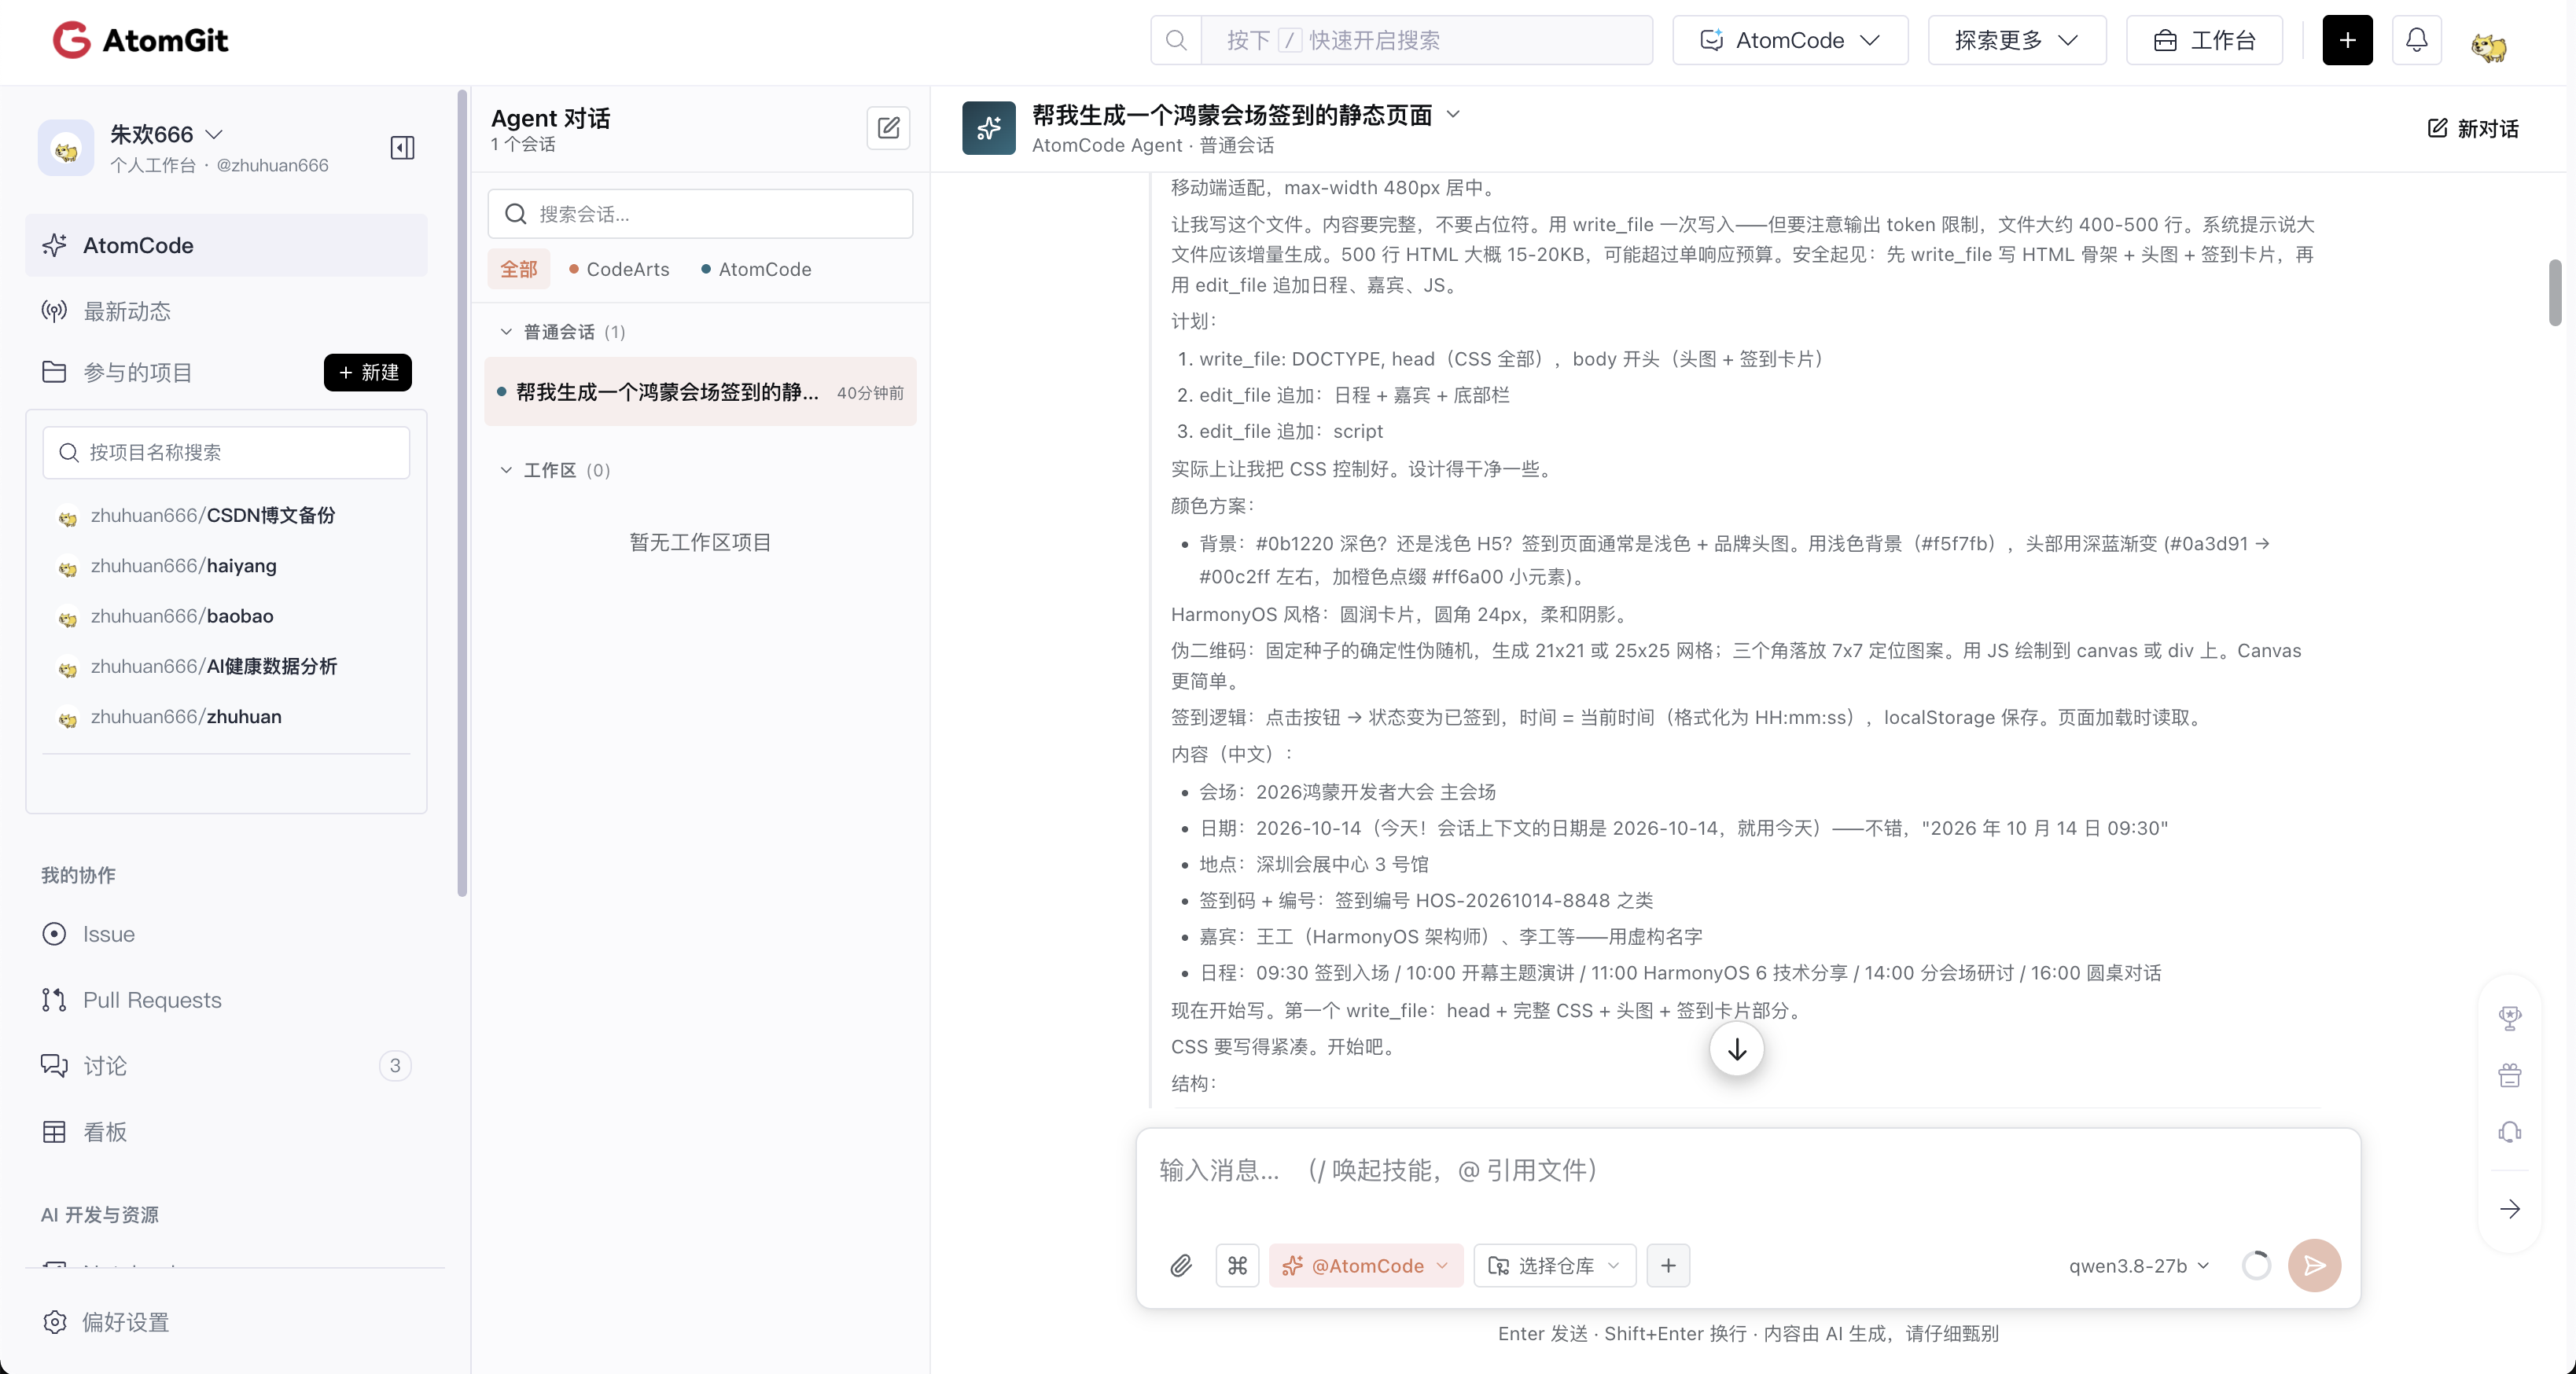
先看它自己怎么说的(推理原文):
让我写这个文件。内容要完整,不要留苦头。用 write_file 一次写完——但要注意输出 token 限制。文件大约 400-500 行……可能超过单次响应限制。安全起见:先 write_file 写 HTML 骨架 + 头图 + 签到卡片,再用 edit_file 追加日程、嘉宾、JS 等。
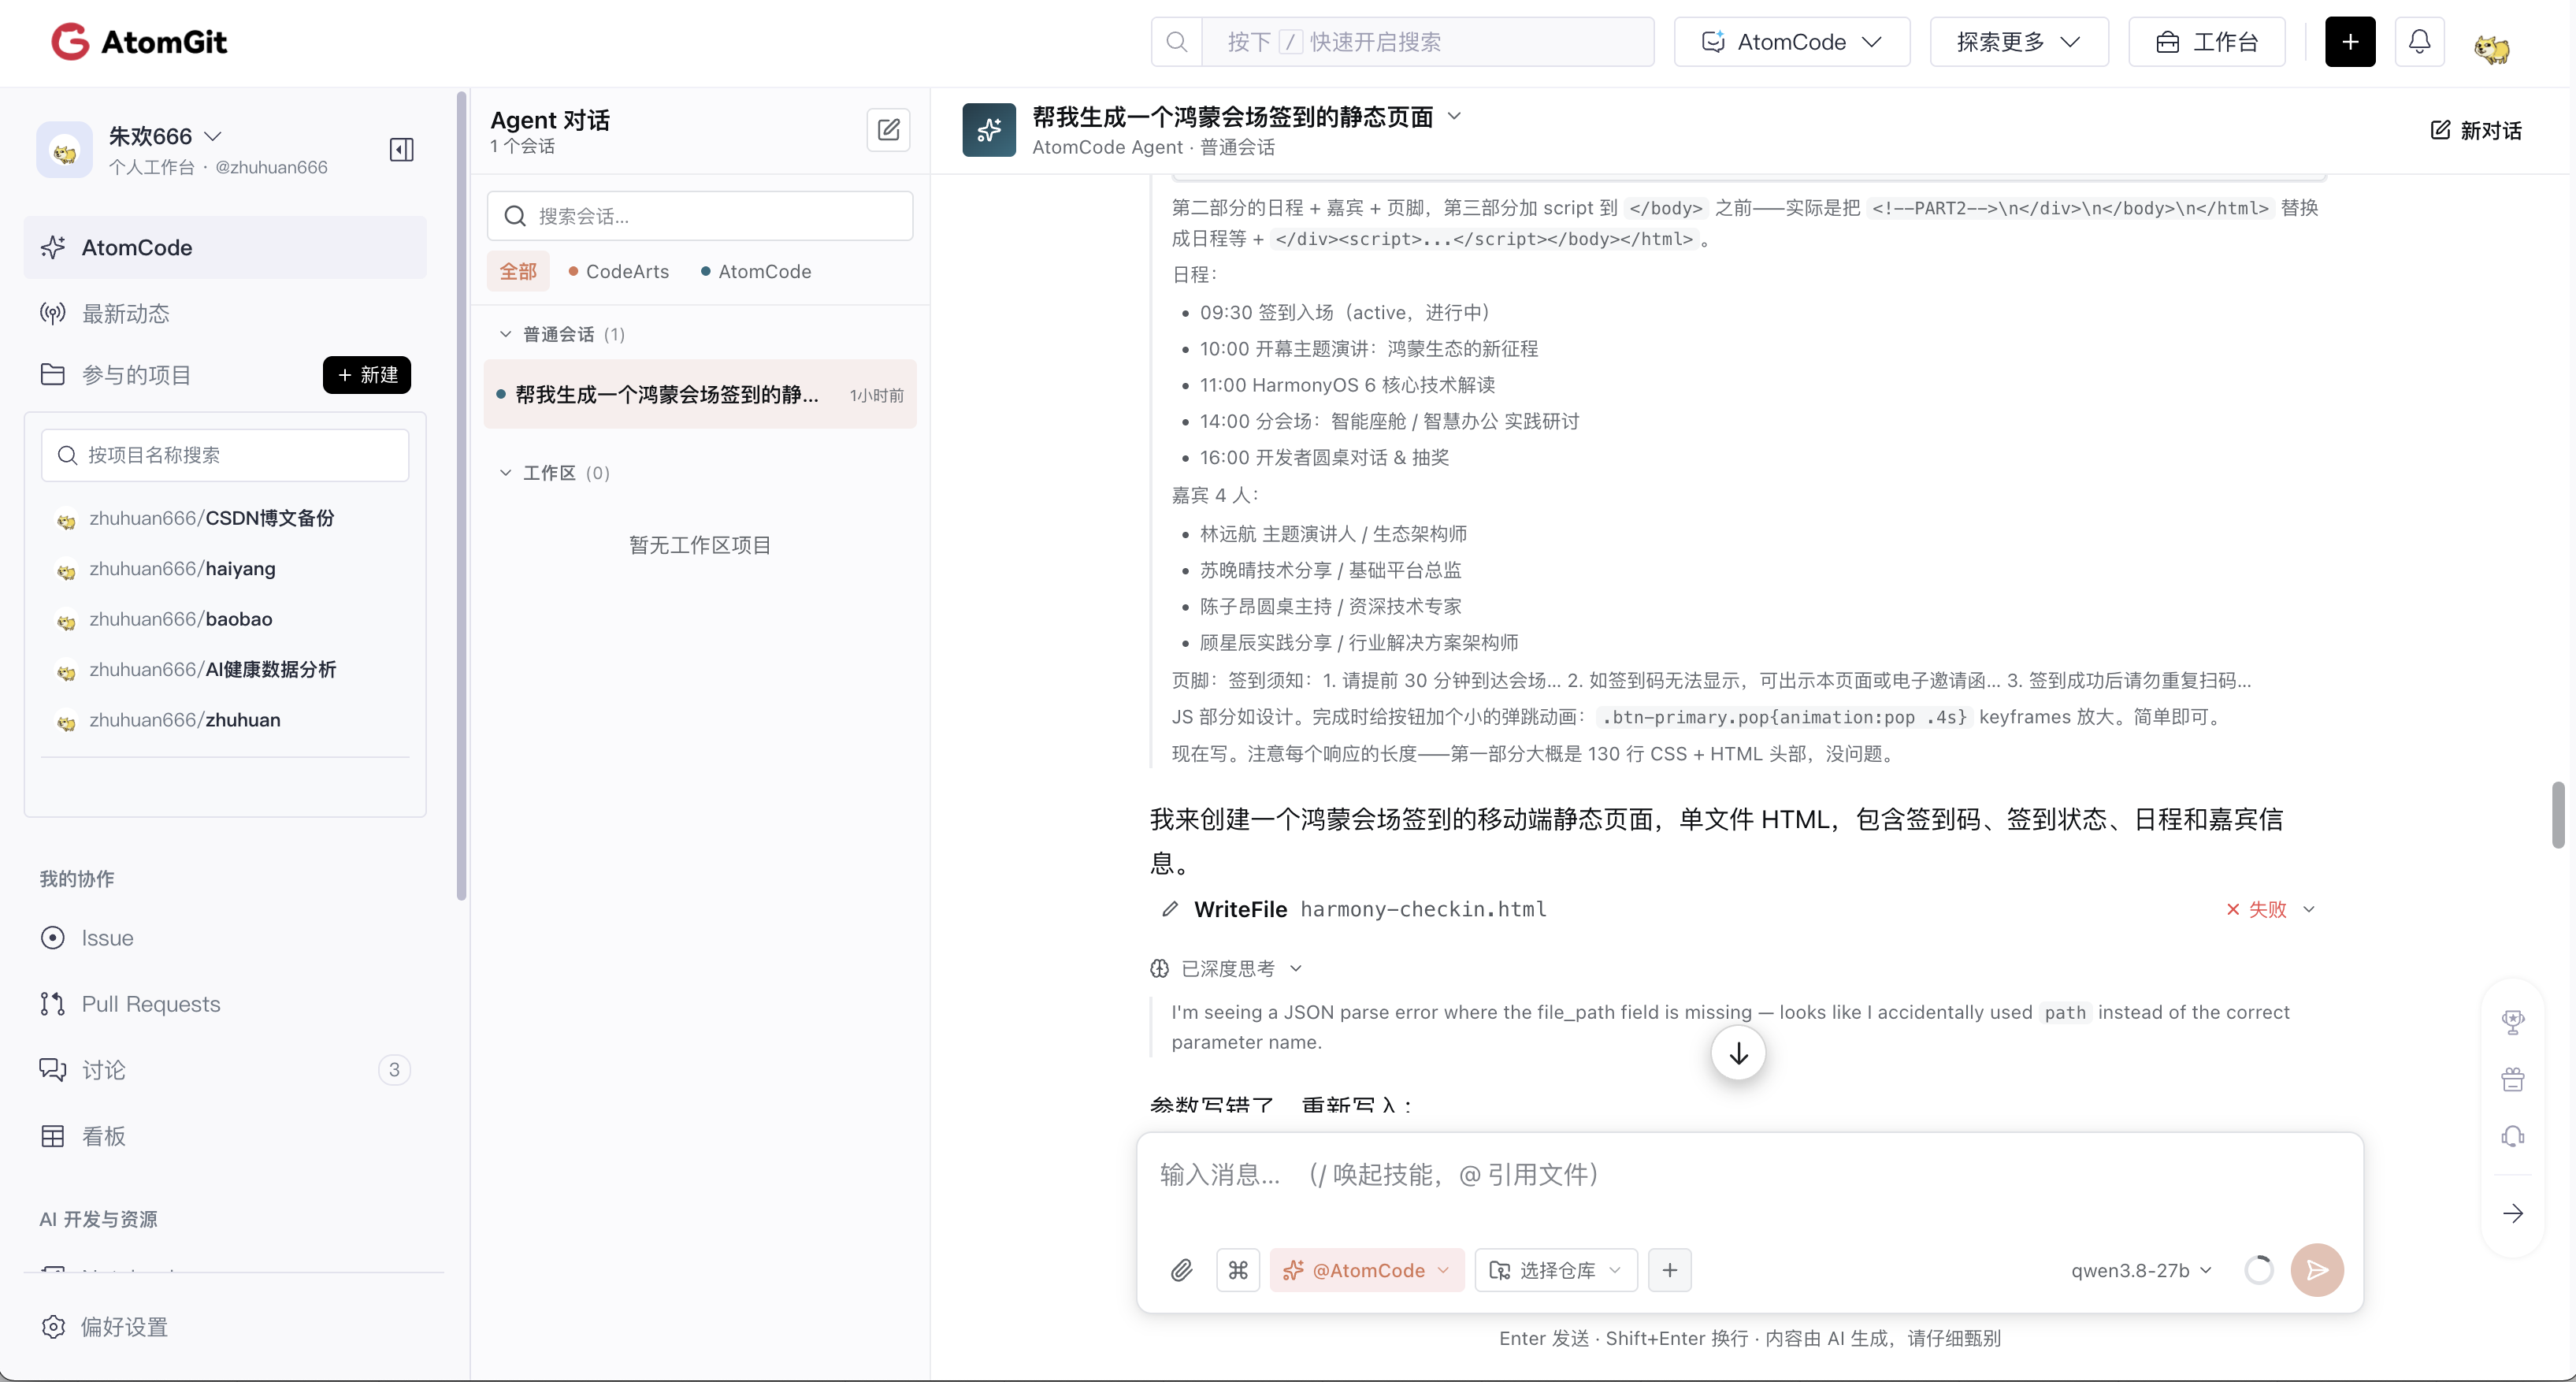
然后它给出了明确的三步计划:
- write_file: DOCTYPE, head(CSS 全部),body 开头(头图 + 签到卡片)
- edit_file: 追加"日程 + 嘉宾 + 底部栏"
- edit_file: 追加 script
新手写代码的时候不存在这个问题。人在编辑器里打字,想写多长写多长,写累了存个盘继续。但 LLM 的输出是有硬上限的——单次响应的 token 预算摆在那儿,一个 400–500 行、15–20KB 的 HTML,如果硬要一口气吐完,风险是很实在的:要么中途截断留下半个文件,要么为了塞进去而压缩质量,该写的 CSS 细节被砍掉。
所以它做了一次预算分配:把整个文件当成一个总预算,切给三次输出。第一次给"骨架 + 全部 CSS + 首页上半部分",第二次给"日程 + 嘉宾 + 页脚",第三次给"script"。这么切的依据是什么?看它的原话——“CSS 大概 150 行,然后 body 上半部分”。它先估算了每一段的体量,再按体量分配写入轮次,而不是随便找个位置切开。
然后是最体现经验的一点:三段之间怎么衔接。它没有用"分三次写三个文件"这种笨办法,而是用了一个锚点标记——第一次写 write_file 时,在 body 上半部分的末尾留下一个占位注释(形如 <!--...-->),第二次 edit_file 就把这个标记替换成后续内容。这样三次写入拼起来,在天衣无缝的同时,每条指令的目标都是明确的"替换某段",而不是"在文件末尾追加某段"——后者很容易因为上下文对齐问题把代码插错位置。
| 维度 | 新手手写 | AI(本次) |
|---|---|---|
| 输出长度限制 | 不存在(人能无限续写) | 硬约束,单次响应有 token 上限 |
| 应对策略 | 无(自然就是分段写) | 主动估算体量,切分写入轮次 |
| 拆分依据 | 无 | 按内容体量(CSS ~150 行等)而非随意位置 |
| 拼接方式 | 编辑器里直接续写 | 锚点标记 + edit_file 精确替换 |
| 失败模式 | 无(最多是写累了) | 若一次硬写,可能截断 / 降质 |
这张表想说的其实是一个反直觉的结论:"一次写完"在人这边是默认操作,在 AI 这边是需要刻意设计的工程决策。而且这个决策是"没有构建系统兜底"逼出来的——如果是一次鸿蒙工程或 Vue3 工程,文件再多也可以靠脚手架和构建去校验,但单文件 HTML 一旦被截断,产物直接就是坏的,没有任何东西会告诉你坏了。为了不让文件坏掉,它选择了主动牺牲"一次性"这个便利。
代价也有:多两次工具往返,多一次对锚点标记的依赖。如果第二次 edit_file 替换失败(比如锚点没匹配上),整条链就得回头。这个风险它自己也清楚,所以把三次拆分做得尽量干净——每次只做一件事。
六、决策四:没有依赖、没有素材,二维码从哪来
签到页最核心的元素是那个二维码。问题是:没有二维码库(不引 CDN,因为外部依赖本身就是风险),没有网络,没有真实的码图可以贴。
摆在面前的路大致有三条:
| 方案 | 做法 | 优点 | 致命问题 |
|---|---|---|---|
| A. 引第三方库 | 从 CDN 引入 qrcode.js 之类 | 生成的是真码,可扫 | 引入外部依赖,离线失效,违背"零依赖单文件" |
| B. 贴占位图 | 放一张静态图片或 base64 图 | 一行搞定,最快 | 丑,且和"签到码"的语义完全脱节 |
| C. 自己画 | 用 Canvas 手绘一个二维码样式的图案 | 零依赖、可控、视觉达标 | 图案是假的,不可扫 |
它选了 C,而且选得毫不犹豫——在推理里就直接定下了细节:
二维码:固定种子的随机性,生成 21x21 或 25x25 网格;三个角落 7x7 定位图案,用 JS 绘制到 canvas 或 div 上。Canvas 更简单。
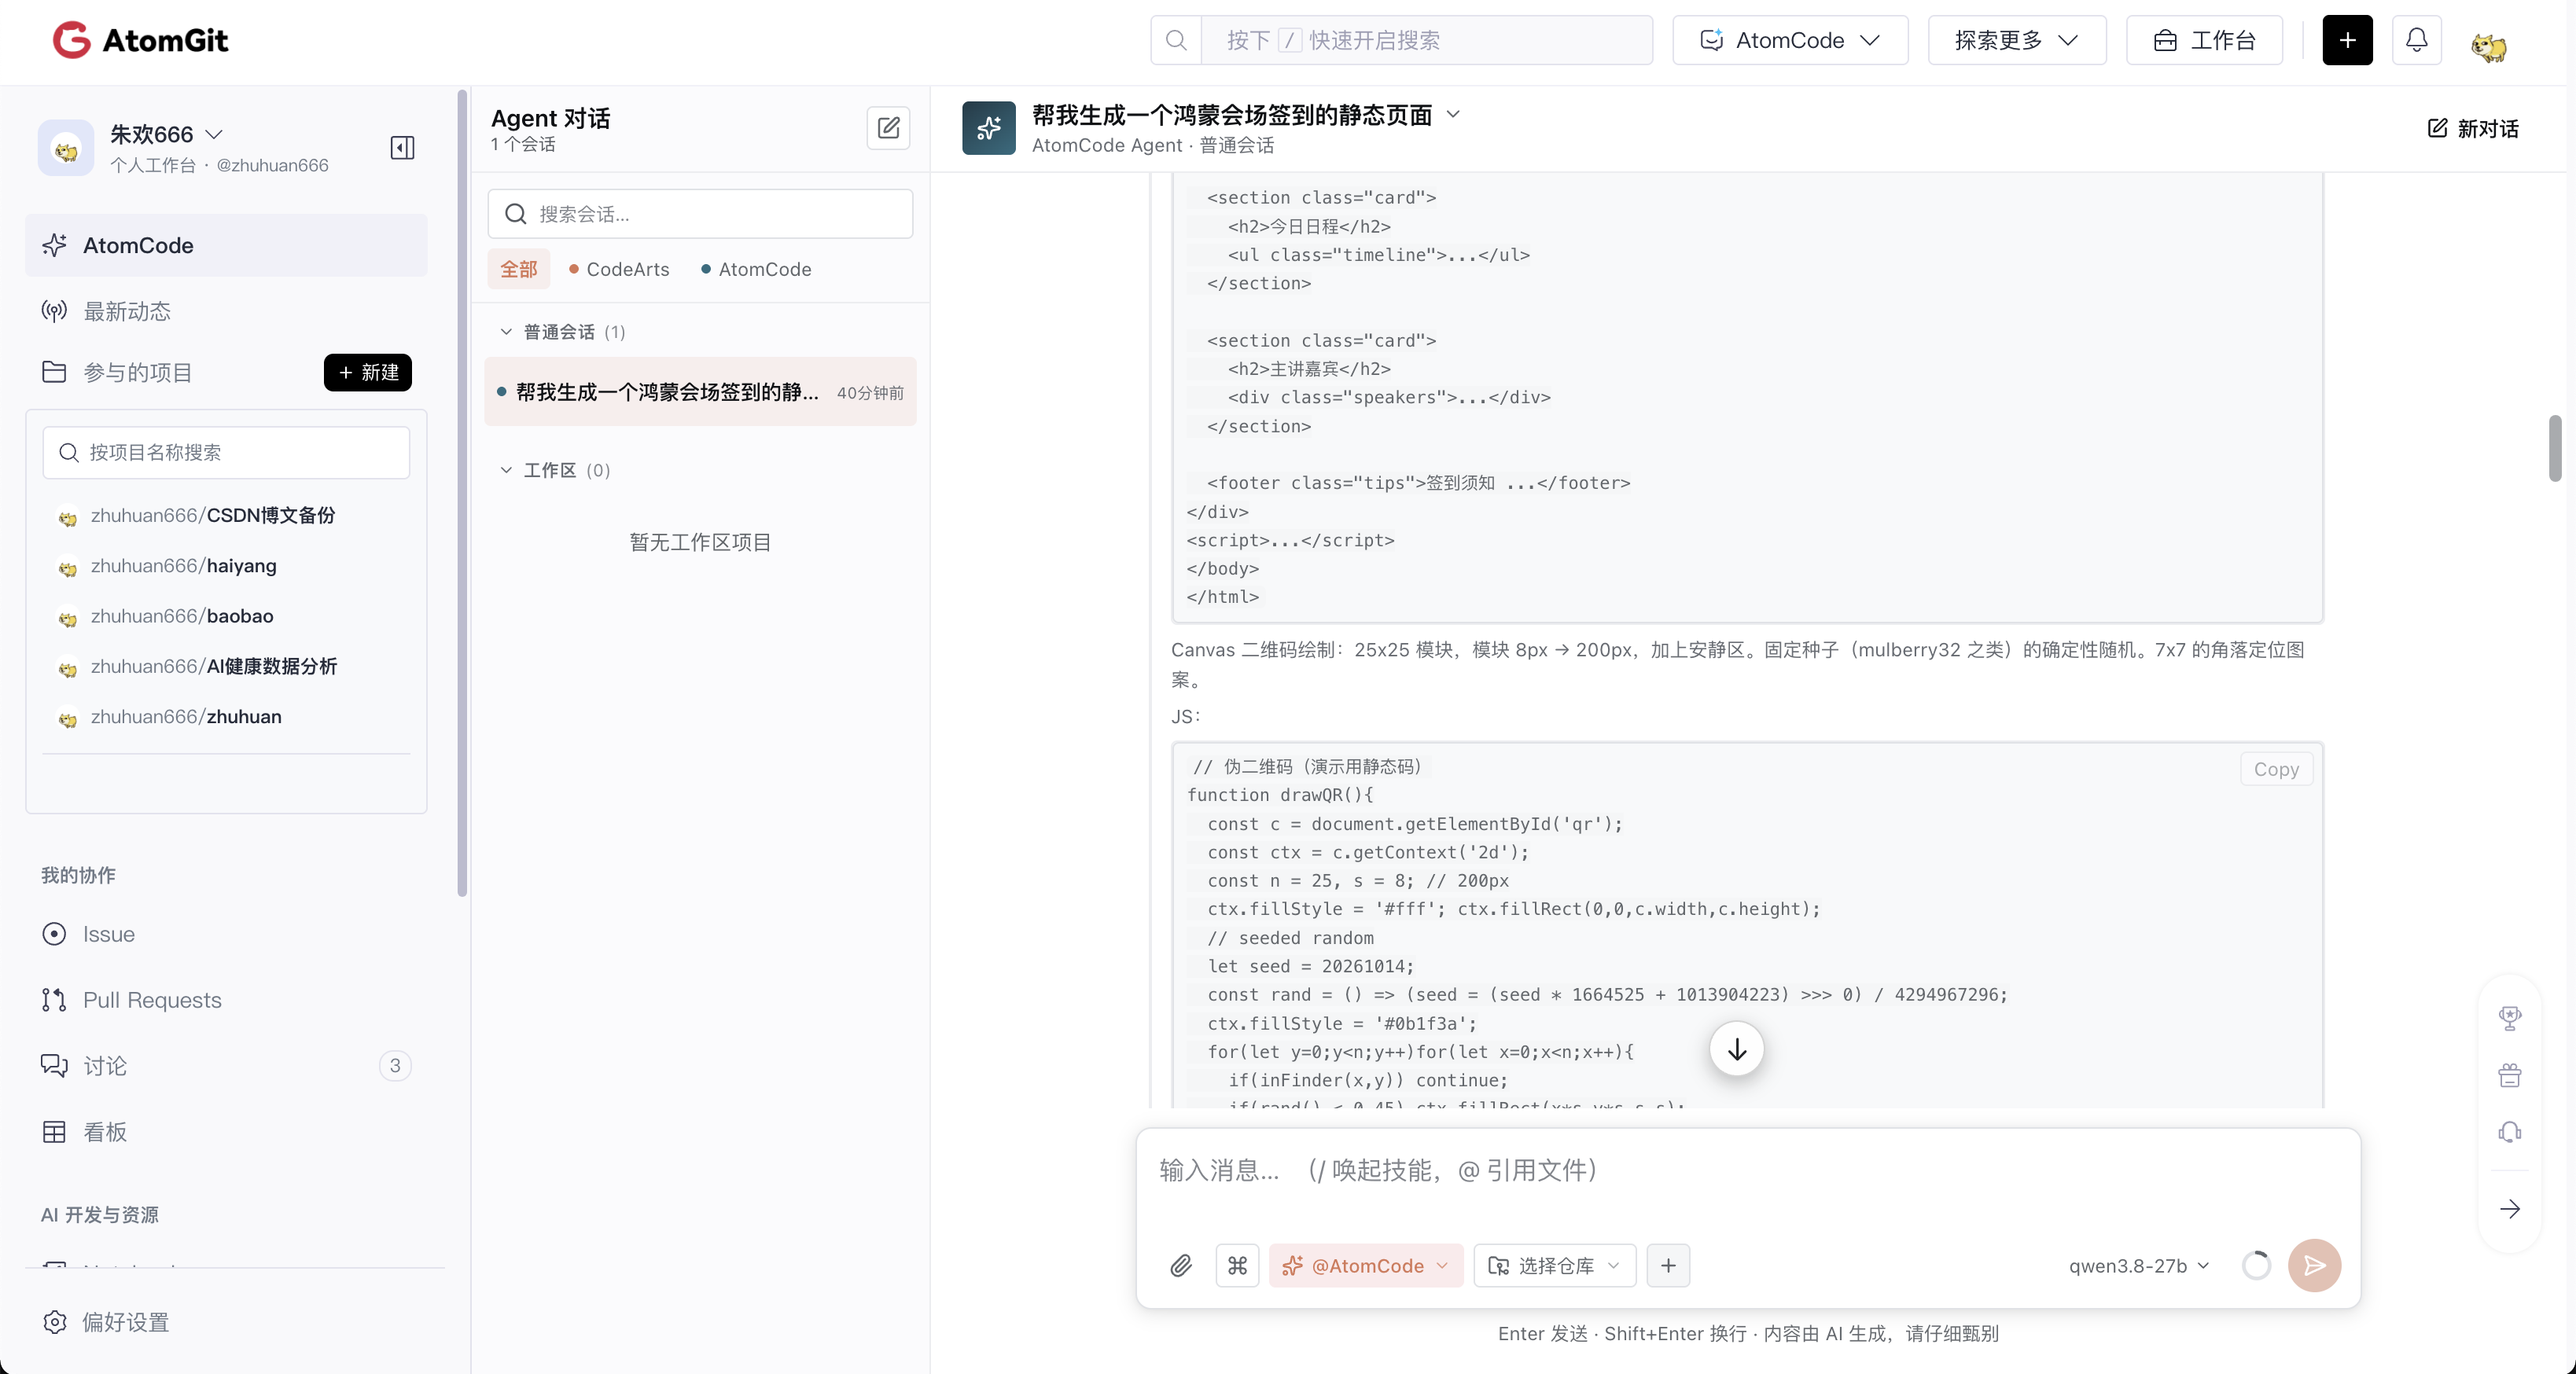
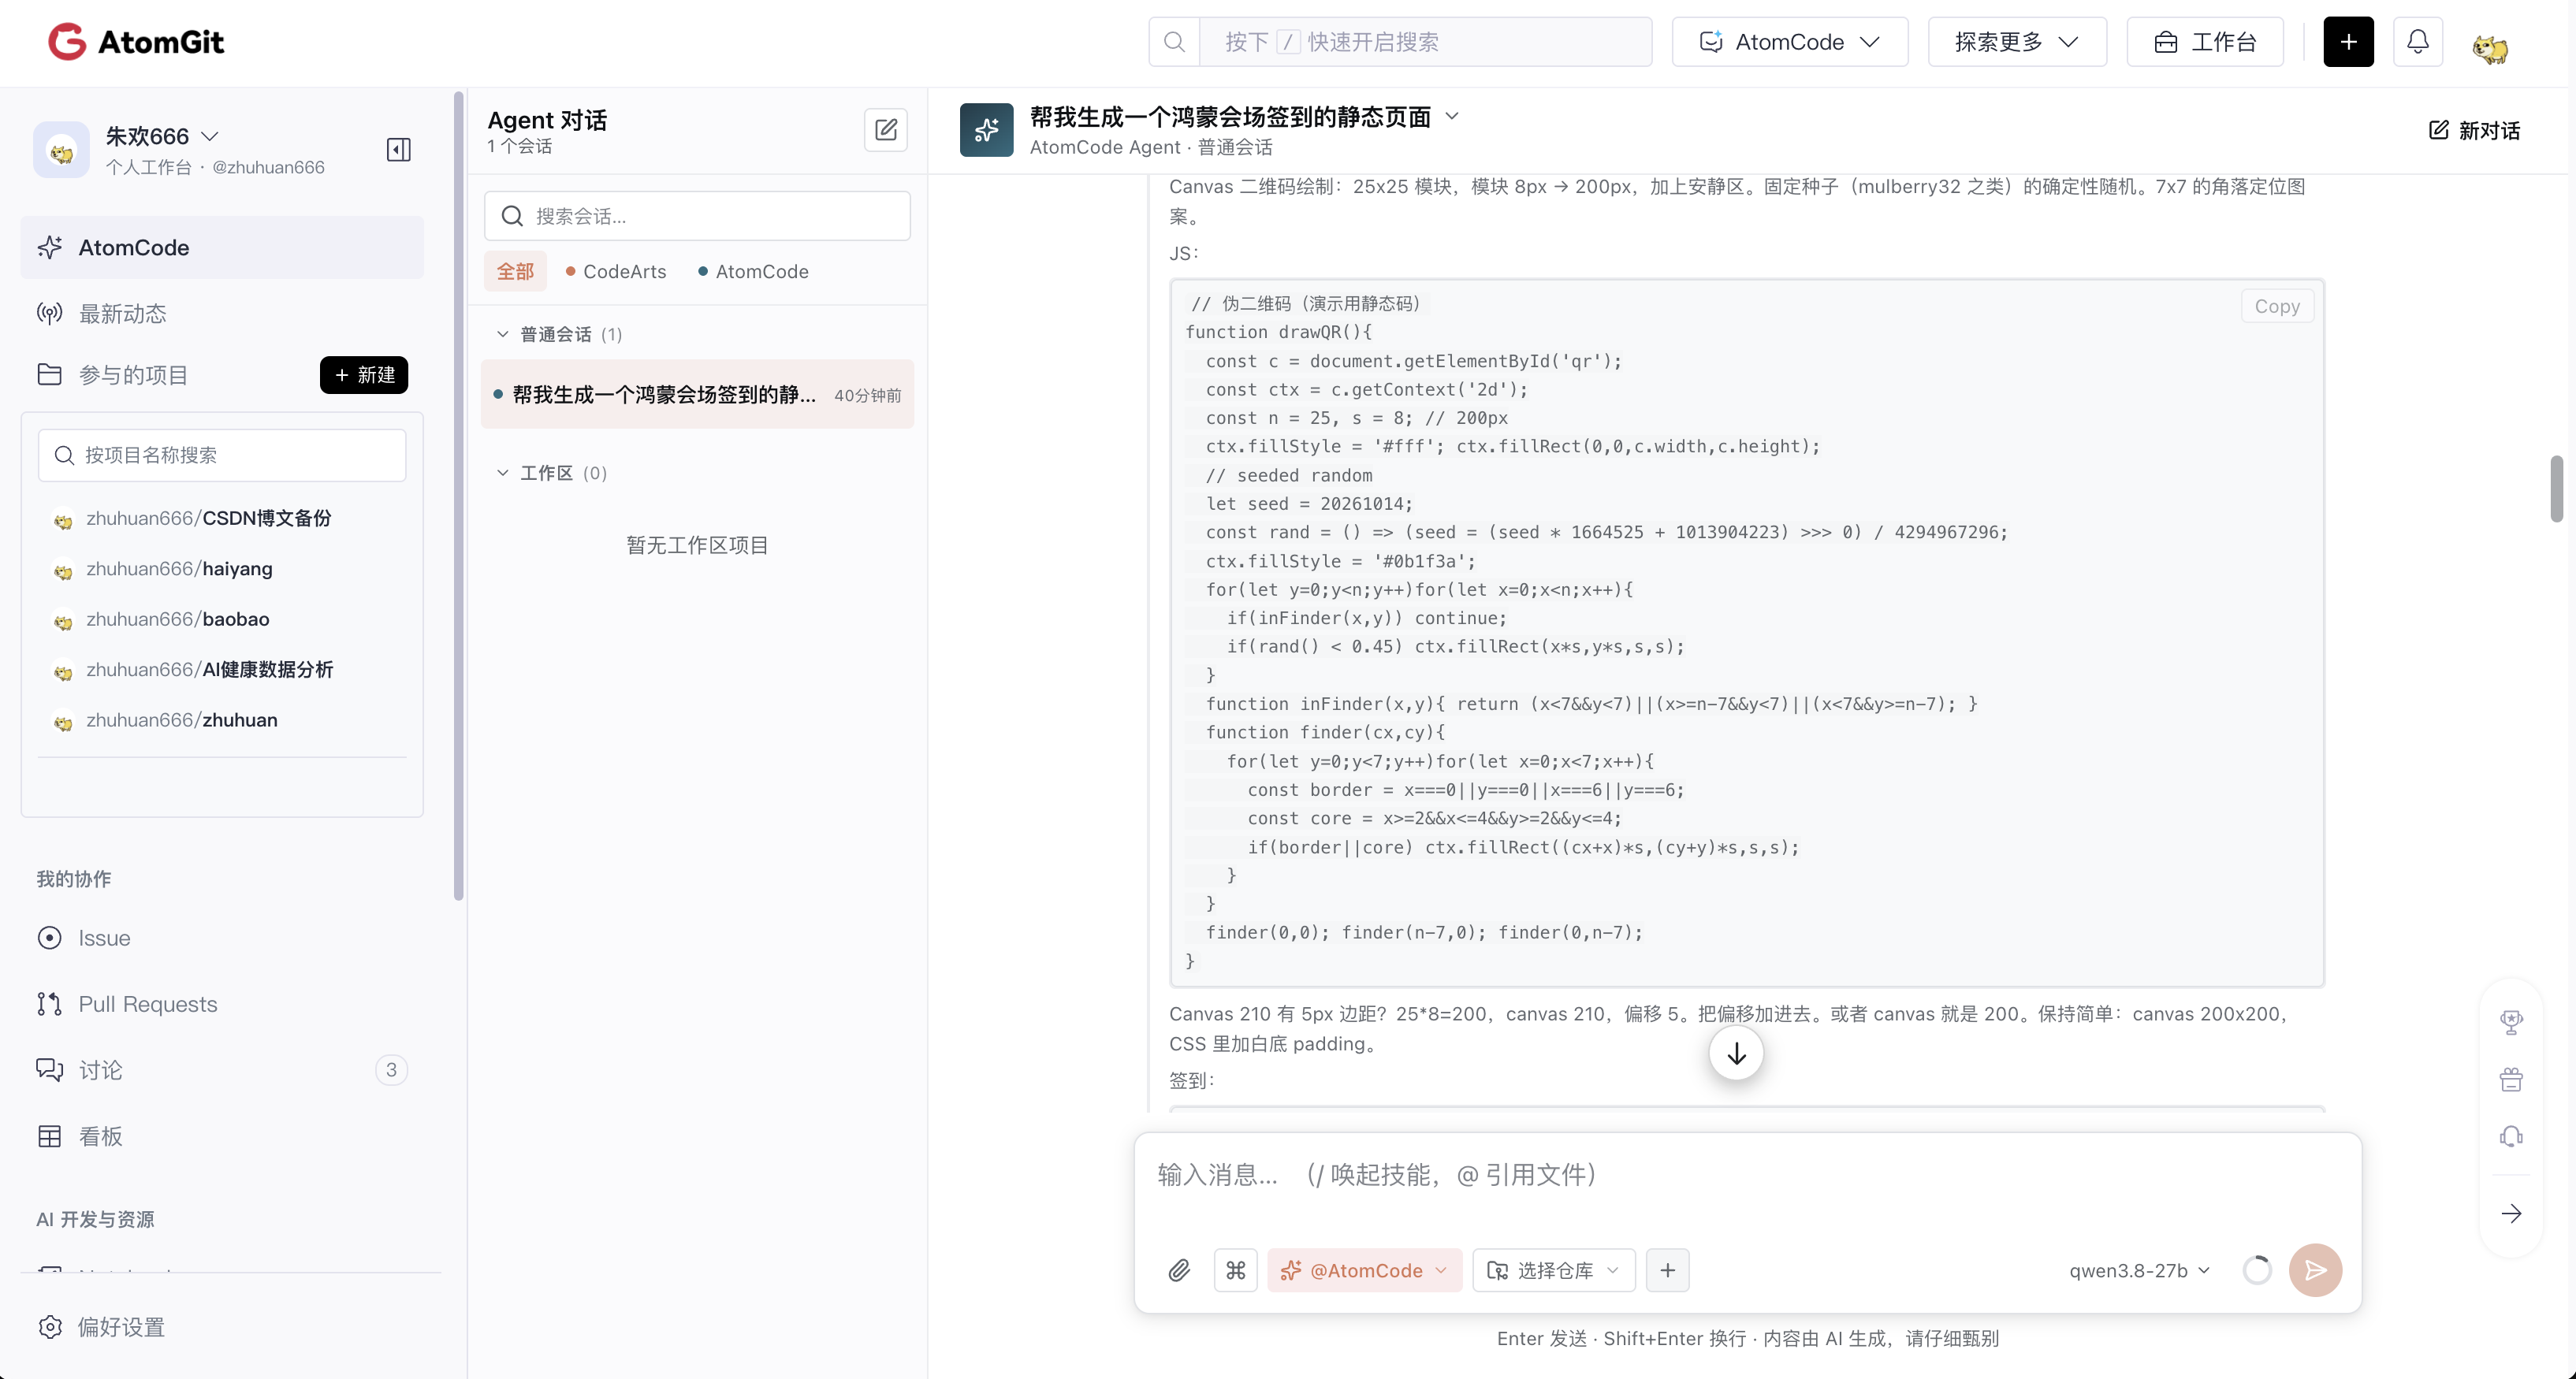
最终落地的参数是 25×25 网格、单模块 8px、画布 200×200。关键在于**"固定种子"这四个字。二维码的图案本质上是随机的点阵,如果每一帧用真随机去画,刷新页面图案就变了,观感上会露馅——真正的码是稳定的,同一个身份每次扫出来都一样。所以它用了确定性伪随机**:给一个固定种子,让图案每次重绘都完全一致。实际代码里用的是一段线性同余(LCG)式的写法:
// 伪二维码(演示用静态码)
function drawQR(){
  const c = document.getElementById('qr');
  const ctx = c.getContext('2d');
  const n = 25, s = 8;              // 25×25 网格,单模块 8px → 200px
  ctx.fillStyle = '#fff'; ctx.fillRect(0, 0, c.width, c.height);
  let seed = 20261014;              // 固定种子
  const rand = () => (seed = (seed * 1664525 + 1013904223) >>> 0) / 4294967296;
  ctx.fillStyle = '#0b1f3a';
  for (let y = 0; y < n; y++) {
    for (let x = 0; x < n; x++) {
      if (inFinder(x, y)) continue;               // 定位图案区域跳过
      if (rand() < 0.45) ctx.fillRect(x * s, y * s, s, s);
    }
  }
}
种子 20261014 显然取自大会日期,这个细节挺有意思——它挑了一个和业务语义相关的数字做种子,既保证了确定性,又让这个数字本身有意义。
再看三个定位图案(二维码四角里那三个"回"字形方块)。它用了一个取巧的写法:
function inFinder(x, y){
  return (x < 7 && y < 7) || (x >= n - 7 && y < 7) || (x < 7 && y >= n - 7);
}
function finder(cx, cy){
  for (let y = 0; y < 7; y++) {
    for (let x = 0; x < 7; x++) {
      const d = Math.max(Math.abs(x - 3), Math.abs(y - 3));
      if (d === 3 || d <= 1) ctx.fillRect((cx + x) * s, (cy + y) * s, s, s);
    }
  }
}
finder(0, 0); finder(n - 7, 0); finder(0, n - 7);
d === 3 || d <= 1 这一句是"回"字形的数学表达:d === 3 是最外圈边框,d <= 1 是中心实心块,中间 d === 2 是留白。三个角一画,加上围在中间的随机点阵,远看就是一张像模像样的二维码。这就是"用最少代码拿到最大视觉合理性"的典型操作——新手要么贴图了事,要么真去实现一个二维码编码算法(那是几百行起步的活);它选了第三条路,用 30 行伪码骗过眼睛。
有一处细节更能说明它的"工程直觉":它注意到画布和边框的关系——“Canvas 210 有 5px 边框?25*8=200,canvas 210,偏移 5,把偏移加进去。或者 canvas 就是 200,保持简单:canvas 200×200。” 也就是说,它在纠结"要不要给画布留安静区(quiet zone)"。二维码标准里码周围要留白边才容易被扫,但这是个假码,扫不扫得动无所谓,留白只会增加复杂度。最后它选了后者——保持简单,画布就是 200×200,白边交给外层的 CSS 容器去给。这个取舍很成熟:功能上不需要的东西,就不要为了"像"而妥协实现成本。
顺带说一句,这跟前两篇里的一个经典操作形成了呼应。第一批的鸿蒙商城遇到"缺少图标素材"时,用的是 base64 编码的 1×1 PNG 兜底——同样是"在没有素材的环境里,用代码造出一个能骗过编译/渲染的最小合法物"。一个是造资源,一个是造图案,思路是一路的。
七、决策五:签到状态存在哪,又该怎么给反馈
签到页的本质是一个状态机:从"未签到"到"已签到"。问题在于,这是一个纯静态的单文件页面,没有后端,没有数据库。状态存哪?
推理里的处理很直接:
签到逻辑:点击按钮 → 状态变为已签到,时间 = 当前时间(格式化为 HH:mm:ss),localStorage 保存,页面加载时读取。
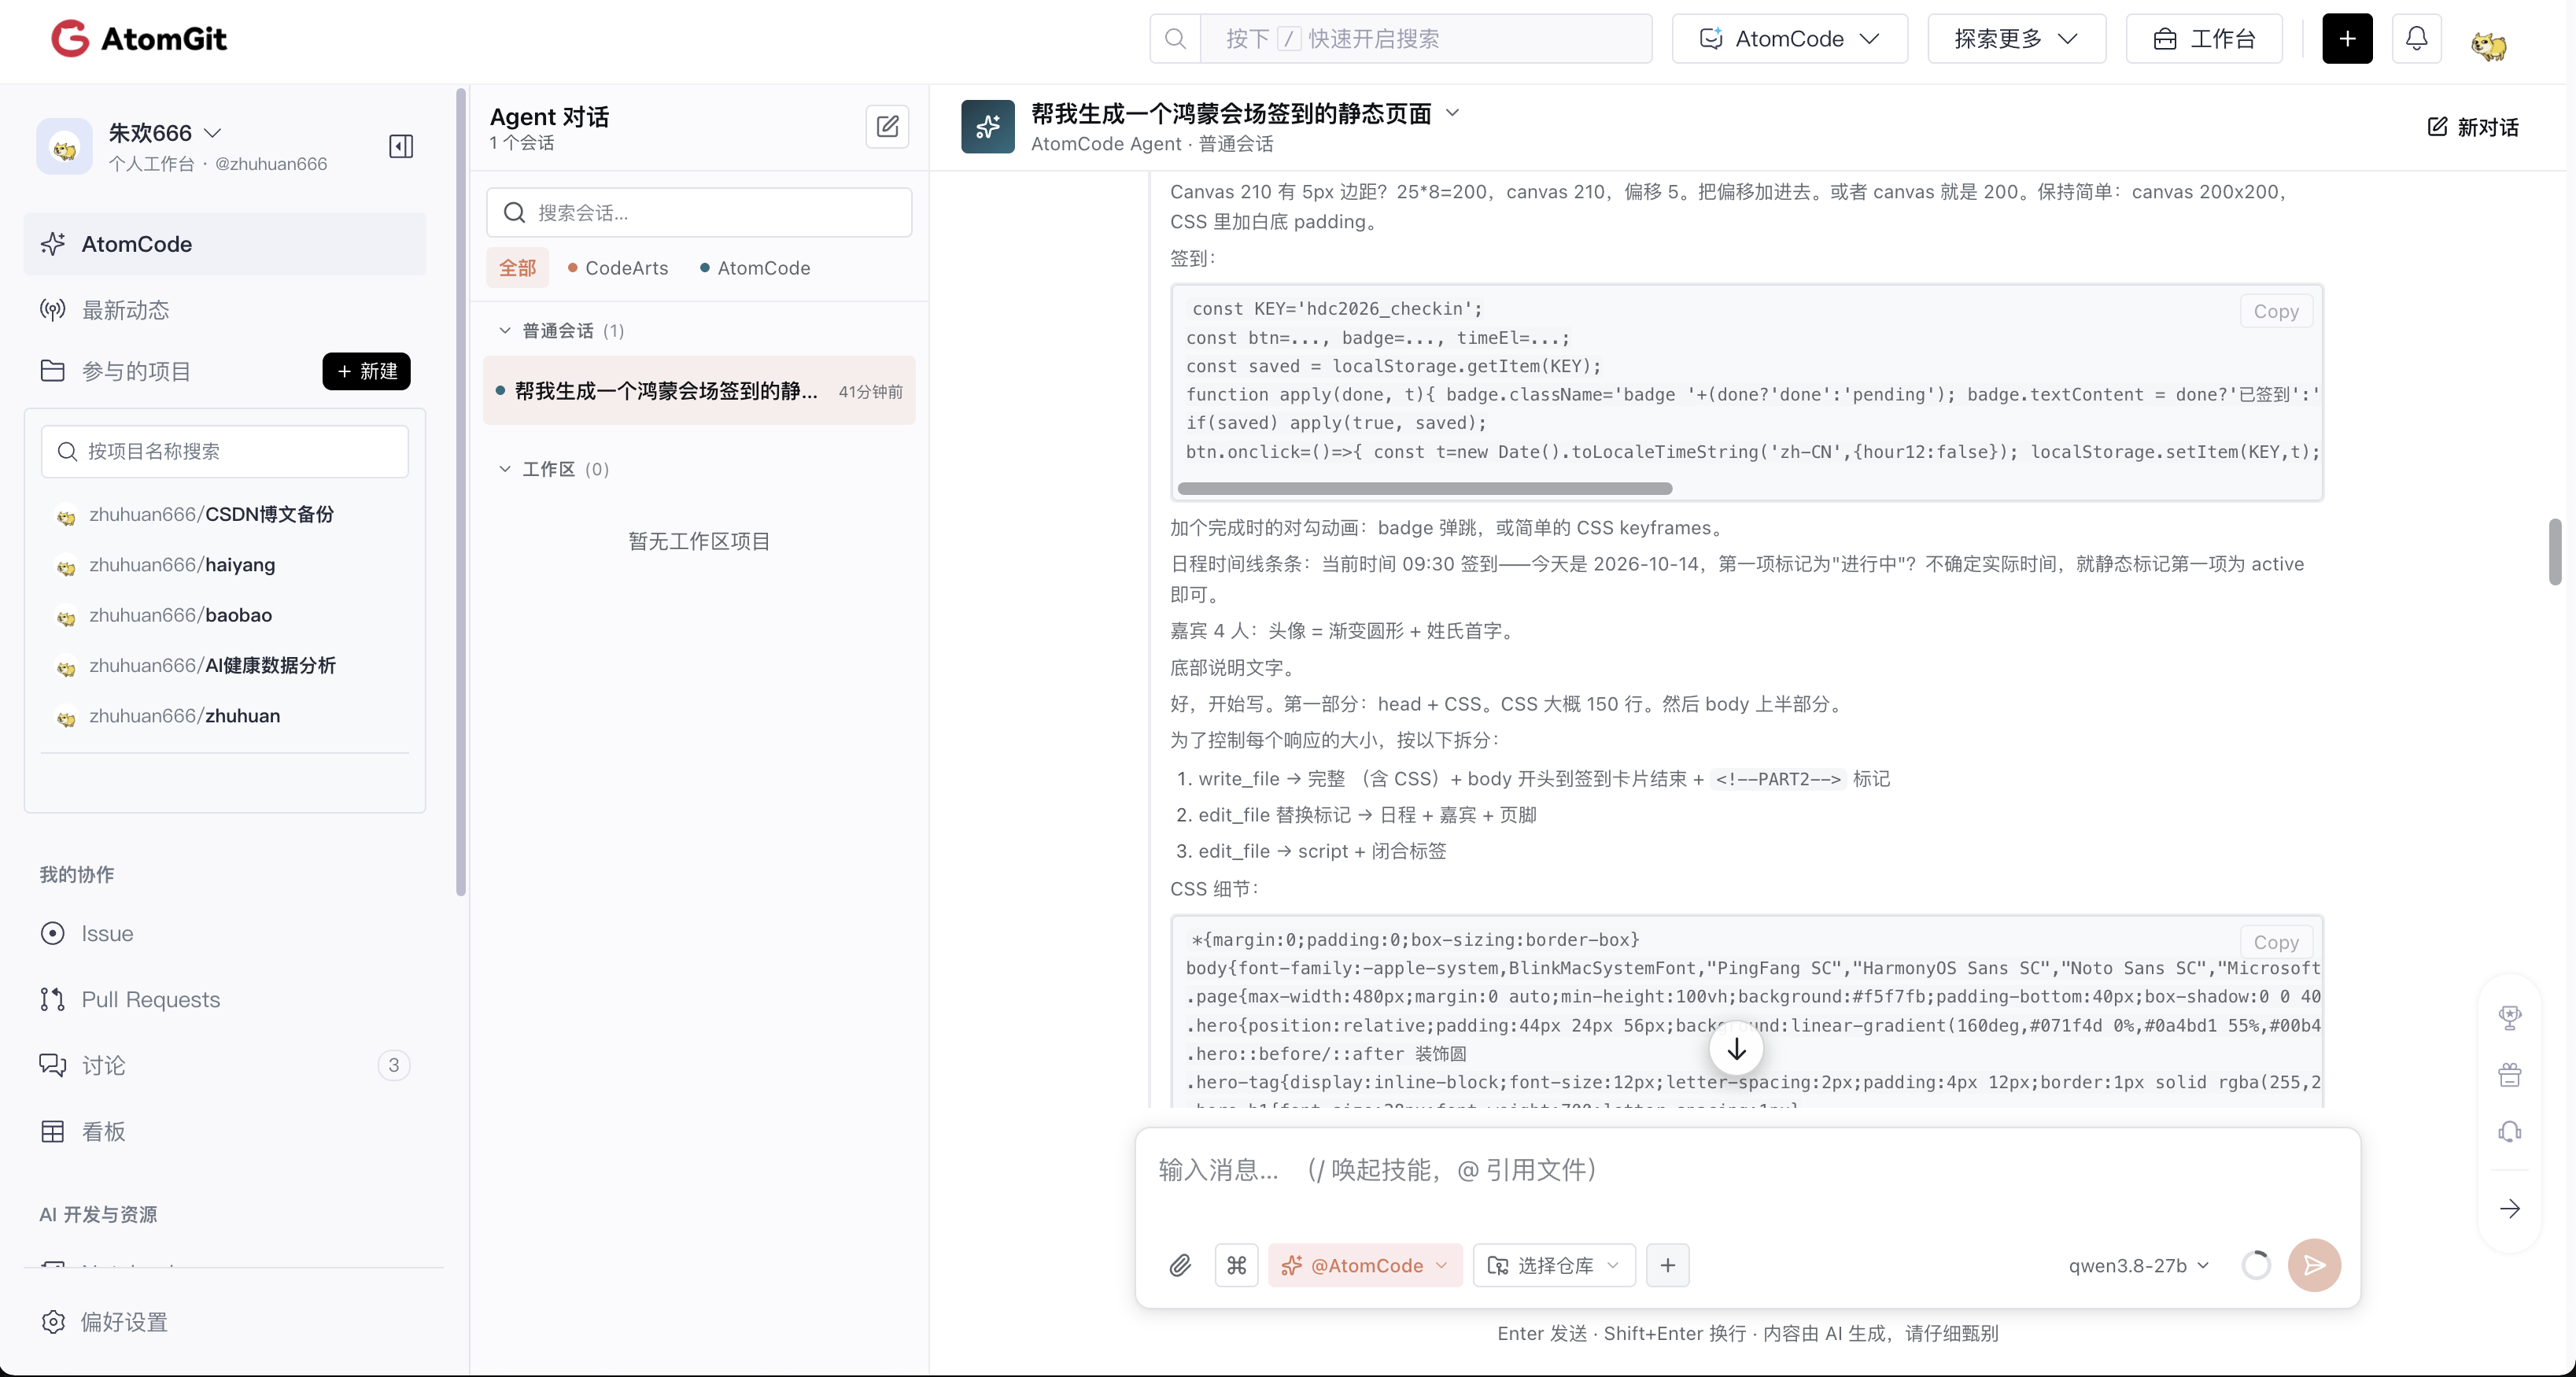
存储介质选 localStorage 是合理的——它是单文件静态页里唯一能做"跨刷新持久化"的本地存储,而且不依赖任何外部服务。落地的代码大致是:
const KEY = 'hdc2026_checkin';
const btn = document.getElementById('signBtn');
const badge = document.getElementById('statusBadge');
const tipEl = document.getElementById('qrTip');
const saved = localStorage.getItem(KEY);

function applyDone(t){
  badge.textContent = '已签到';
  badge.classList.remove('pending');
  badge.classList.add('done');
  btn.disabled = true;
  btn.textContent = '签到成功';
  tipEl.textContent = '签到时间 ' + t;
}
if (saved) applyDone(saved);

btn.onclick = () => {
  const now = new Date().toLocaleTimeString('zh-CN', { hour12: false });
  localStorage.setItem(KEY, now);
  applyDone(now);
};
这段代码虽短,但有几个点值得单拎出来。
第一,状态的键名带业务前缀。 hdc2026_checkin 而不是笼统的 checked。在真实项目里,localStorage 是全站共享的命名空间,一个含糊的键名迟早会和别的功能撞车。用"大会缩写 + 年份 + 语义"三段式命名,是工程习惯而不是随手写的。
第二,加载时先读取。 if (saved) applyDone(saved) 这一行保证了刷新页面后状态不丢——这才是"持久化"三个字的完整含义。很多新手只写了"点击后改状态",忘了"加载时读状态",结果一刷新就打回原形。
第三,天然幂等。 按钮点过一次后 disabled = true,再点也无效。这避免了"签到时间被反复覆盖"的问题——用户第二次点的时候,时间戳不应该变。新手写这类交互时经常漏掉这一步,导致重复点击把首次签到时间改掉了。
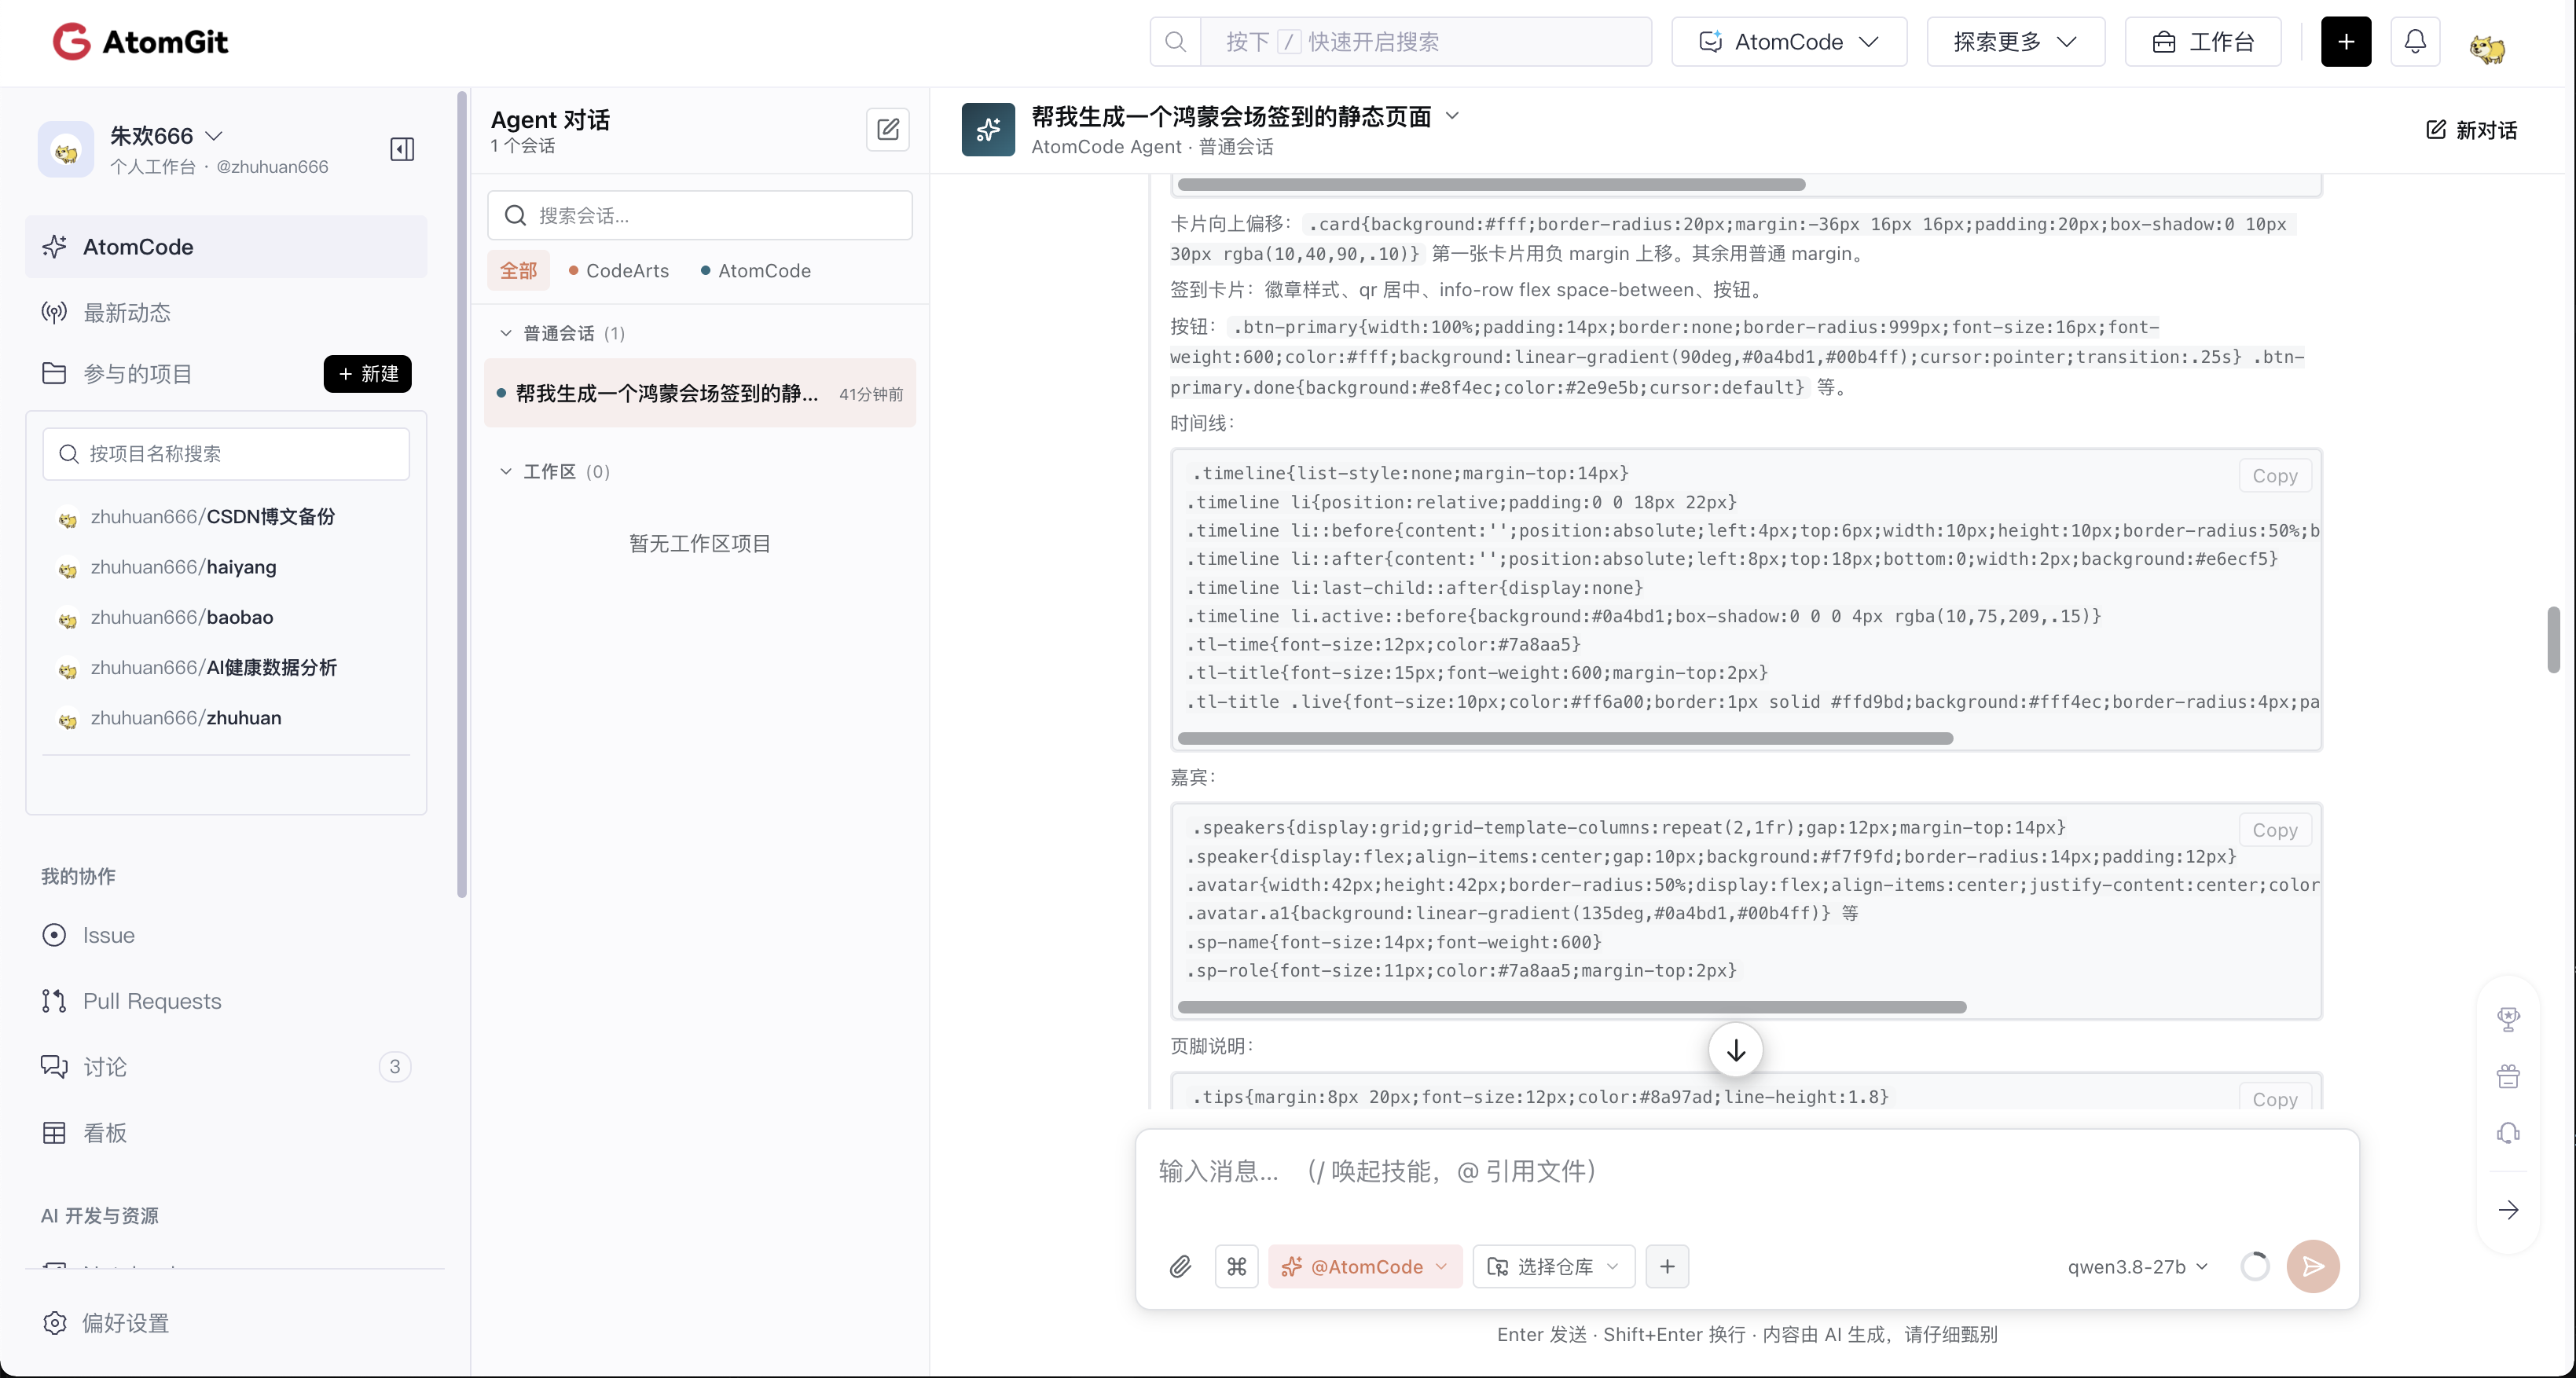
、徽章配色(pending 橙 → done 绿)、按钮文案(立即签到 → 签到成功)。截图里能看到这两套样式:
.badge { font-size: 12px; padding: 4px 12px; border-radius: 999px; }
.badge.pending { background: #fff1e6; color: #ff6a00; border: 1px solid #ffd0bd; }
.badge.done    { background: #e8f7ee; color: #2e8b57; border: 1px solid #bfe8cf; }
橙色代表"待办",绿色代表"完成"——这是视觉语义的通用约定,它没有自作主张用蓝色或紫色。而且徽章的样式不是写死在元素上的,而是通过 class 切换(pending / done 两个修饰类),这本身就是一套小型的设计令牌(design token)实践:颜色和语义解耦,改一处样式就改全局。
第五,动画是"加"(细节)而不是"块"(结构)。 草稿里第七条写着"可能还有一个签到成功动画",最终没有做成一个独立区块,而是降级成了一个 CSS 细节——“加个完成时的勾动效:徽章弹跳,或简单的 CSS keyframes”。这是个克制的选择:动画服务于反馈,不该喧宾夺主,更不该为了炫技占用结构位置。
| 状态维度 | 未签到 | 已签到 |
|---|---|---|
| 徽章文案 | 未签到 | 已签到 |
| 徽章配色 | 橙(pending) | 绿(done) |
| 按钮文案 | 立即签到 | 签到成功 |
| 按钮可点 | 可点 | disabled |
| 二维码提示 | 请向工作人员出示 | 签到时间 HH:mm:ss |
| 持久化 | localStorage 无值 | localStorage['hdc2026_checkin'] = 时间戳 |
这张表其实就是一个最小状态机的完整描述。新手容易只实现"状态变化",而忽略"状态的所有表达面"——徽章变了但按钮没变、按钮变了但提示文案没变,用户会觉得这个交互"没做完"。AI 这次是把所有和状态沾边的元素一次性对齐了。
代价也要说清楚:localStorage 是浏览器本地的,换设备、清缓存、开无痕窗口都会丢。所以推理里它自己也标注了——“纯 HTML + CSS + 原生 JS,签到交互为本地演示状态(刷新即重置)”。它没有假装这是一个能真正入库的签到系统,而是诚实地把能力边界写在了交付说明里。这种"不吹"的态度,在很多新手交付 demo 时反而是最缺的。
八、决策六:环境里连 node 都没有,拿什么验证
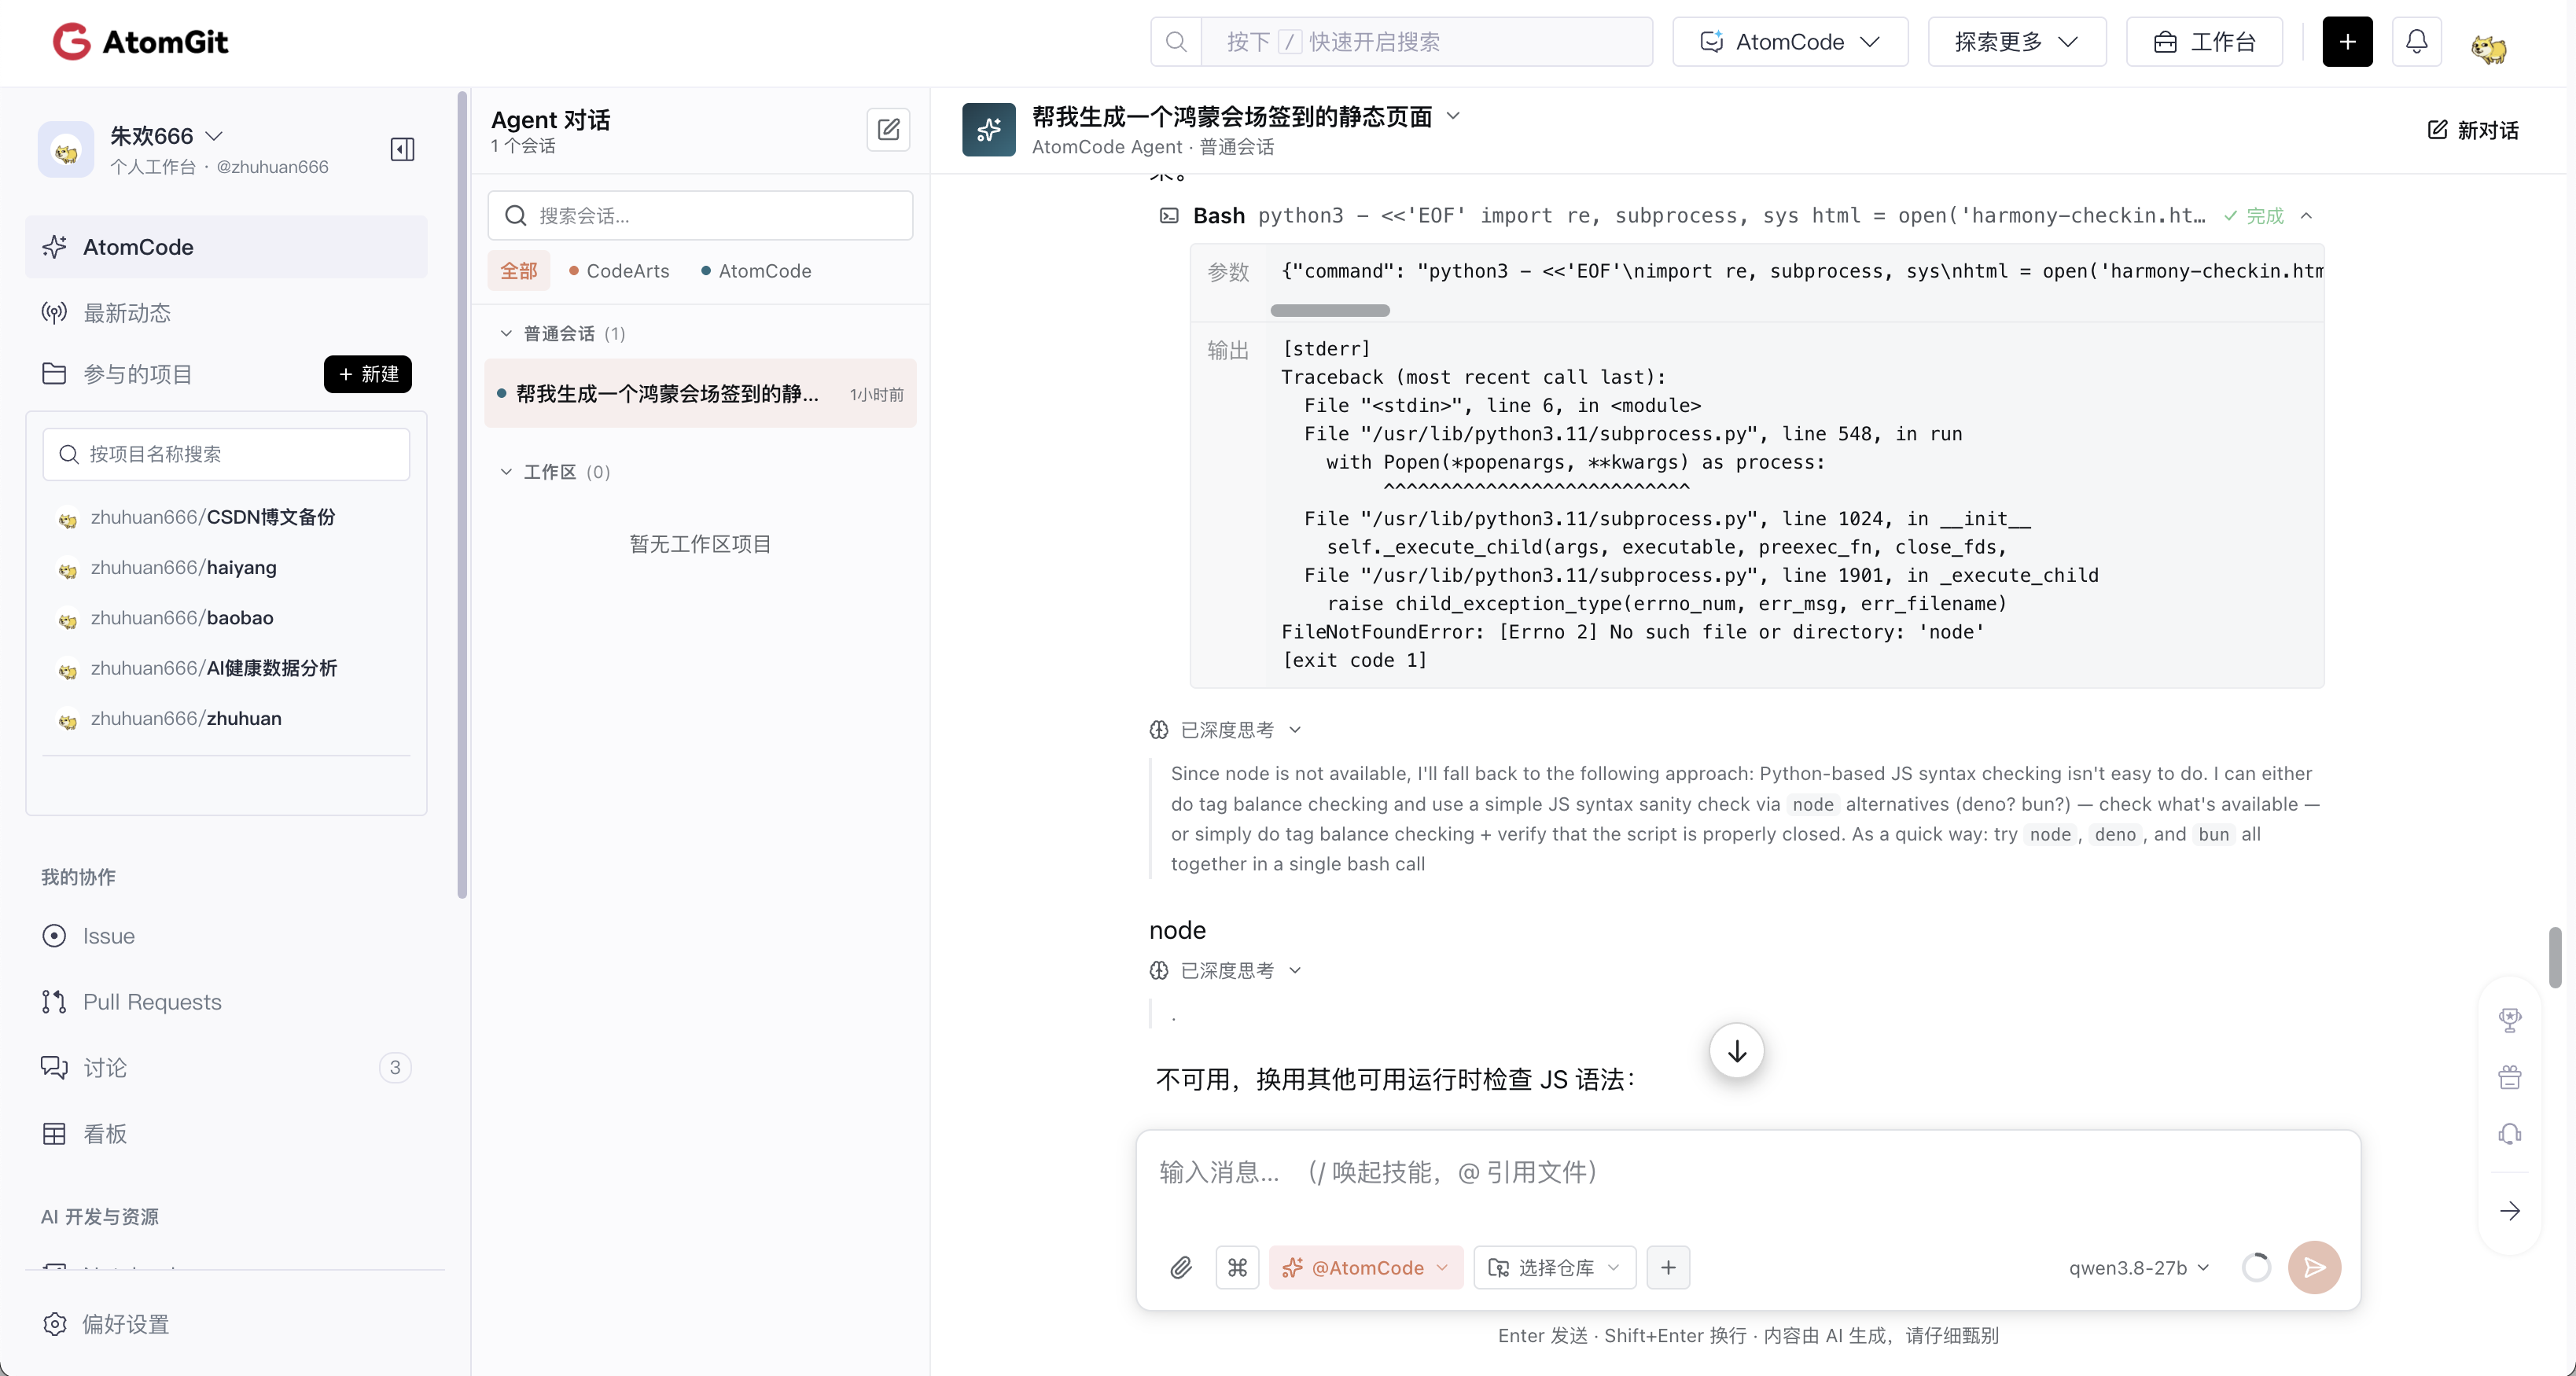
写完代码,下一个路口是"怎么证明它是好的"。前一篇 Vue3 项目里,这一步是 npm run build 加 Playwright 无头复验,有现成的工具链兜底。而这次的环境里,第一次尝试就撞了墙。
它先试了最自然的方案——调 node 去检查 JS 语法。截图里那次 Bash 调用的输出很有意思:
Traceback (most recent call last):
  ...
  File "/usr/lib/python3.11/subprocess.py", line 1901, in _execute_child
    raise child_exception_type(errno_num, err_msg, err_filename)
FileNotFoundError: [Errno 2] No such file or directory: 'node'
[exit code 1]
node 不存在,命令直接抛 FileNotFoundError。这时候新手常见的反应是:算了,不验证了,肉眼看看就行。但它的反应是立刻开始找替代路径(推理原文):
Since node is not available, I’ll fall back to the following approach: Python-based JS syntax checking isn’t easy to do… I can either do tag balance checking and use a simple JS syntax sanity check via node alternatives (deno? bun?) — check what’s available — or simply do tag balance checking + verify that the script is properly closed. As a quick way: try node, deno, and bun all together in a single bash call.
注意这个推理的层次:先承认"用 Python 检查 JS 语法不容易",然后列出两条备选路线(找 deno/bun 替代 / 只做标签平衡 + 脚本闭合检查),最后决定用一次 bash 调用把 node、deno、bun 全试一遍看有没有能用的。这是典型的"先探测可用资源,再决定方案"——而不是一头扎进某条路。
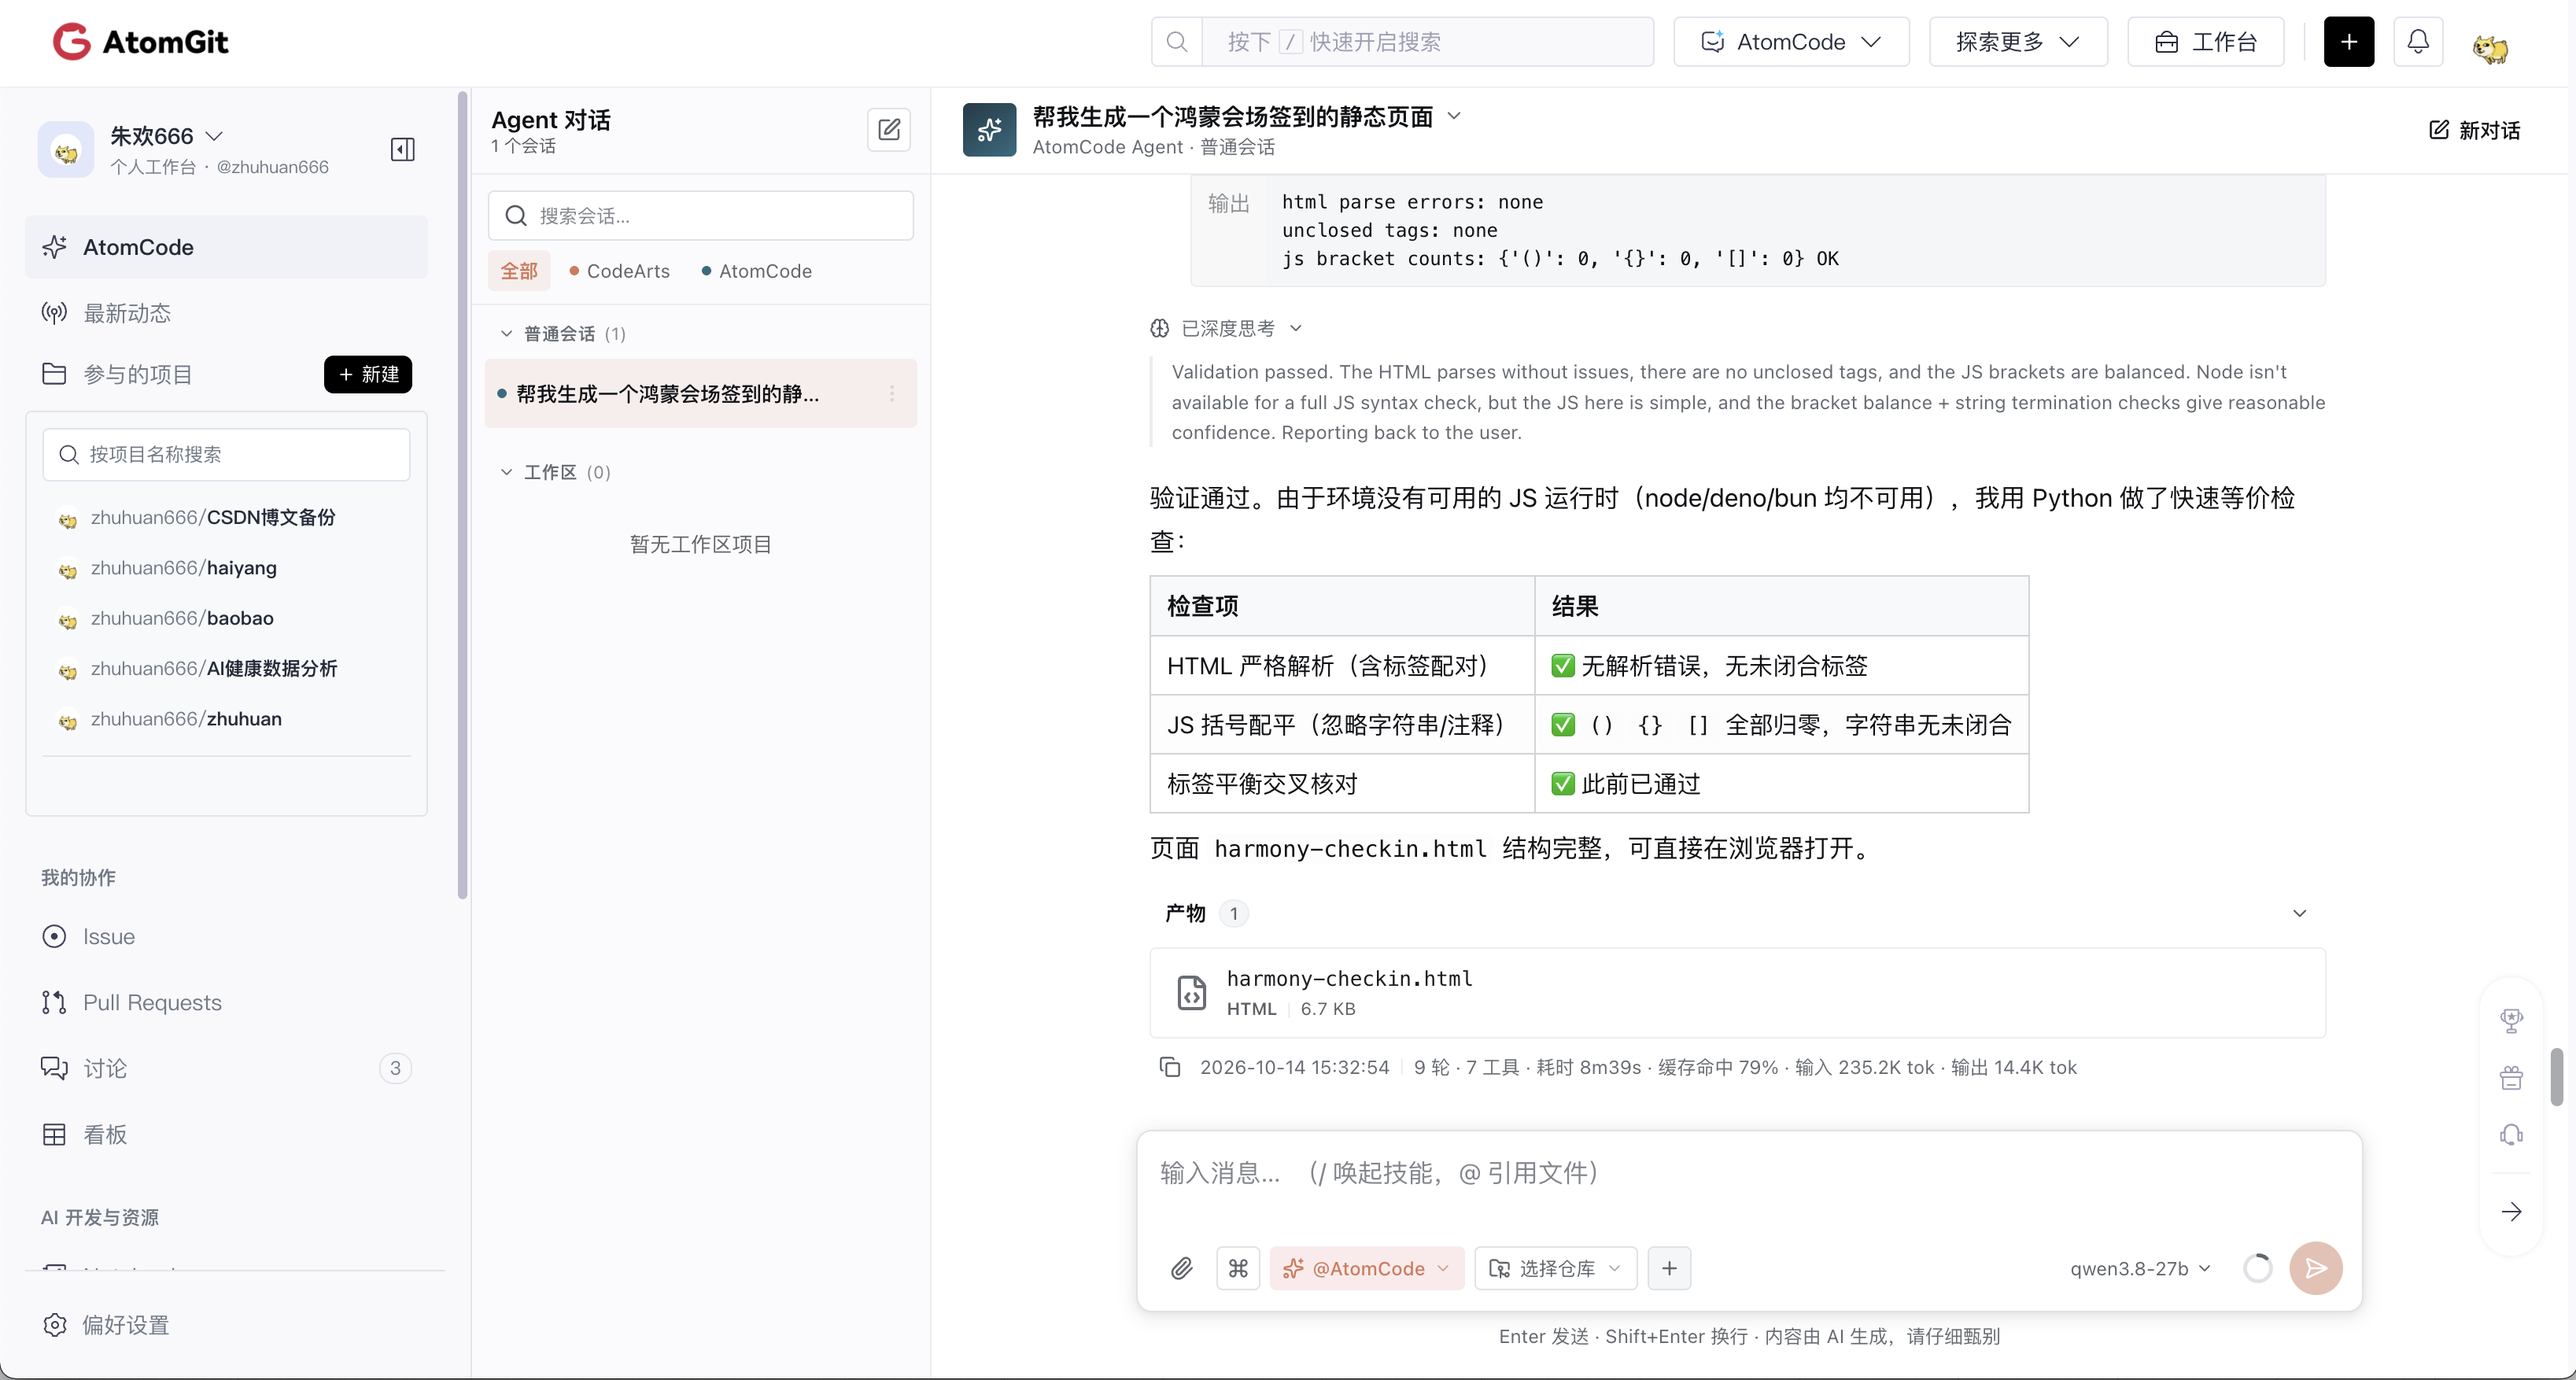
探测结果是三个都没有。于是它退到了最终的降级方案——用 Python 的 html.parser 做 HTML 结构解析,用正则做 JS 括号配对检查:
# python3 - <<'EOF'
import re
from html.parser import HTMLParser
html = open('harmony-checkin.html', encoding='utf-8').read()
# ... 解析标签、检查未闭合标签、统计 JS 括号
最终输出的验证结论是:
html parse errors: none
unclosed tags: none
JS bracket counts: {'(': 0, '{': 0, '[': 0} OK
三点全绿:HTML 解析无错、无未闭合标签、JS 三类括号计数平衡。然后它自己给这次验证做了定性——“Validation passed. The HTML parses without issues, there are no unclosed tags, and the JS brackets are balanced.”
这里最值钱的不是那三行绿字,而是它对自己验证能力的定位。 它在推理里明说了 “Python-based JS syntax checking isn’t easy to do”——它知道括号平衡不等于语法正确,({)} 这种也能配平但语法是错的。所以它把这次验证定义为"结构性验证"而不是"运行性验证",并在此基础上给了用户一个明确的交代:这是本地演示态,需要的话可以帮忙预览效果。
| 验证维度 | 有 Node + Playwright(上一篇) | 无任何 JS 运行时(本次) |
|---|---|---|
| HTML 结构 | 浏览器实际渲染即验证 | Python html.parser 解析,查未闭合标签 |
| JS 语法 | Node 真实解析 / 运行时抛错 | 三类括号计数平衡(弱校验) |
| 页面渲染 | Playwright 无头截图 + getComputedStyle | 无(依赖人工浏览器确认) |
| 交互逻辑 | 断言点击后 DOM 状态变化 | 无(依赖代码审查) |
| 结论强度 | 强(可证明"跑得对") | 弱(只能证明"结构完整") |
| 是否如实说明 | 是 | 是(明确标注为结构验证 + 本地演示态) |
这张表对照下来,能看到一个成熟的做法:验证手段可以降级,但"降级之后结论的强度也要跟着降级并说清楚",这一步不能省。 新手最容易犯的错不是"没验证",而是"用弱手段验了一遍,却按强结论来汇报"——比如只看了标签闭合就说"页面完全没问题"。这次它的处理是:能验的验、验不了的说明白,不把"结构完整"包装成"功能正确"。
九、决策七:从工作区文件到公开仓库
页面写完、验证做完,最后一步是"交付"。这看起来只是敲几条 git 命令,但里面藏着一个容易被忽略的选择:仓库的可见性。
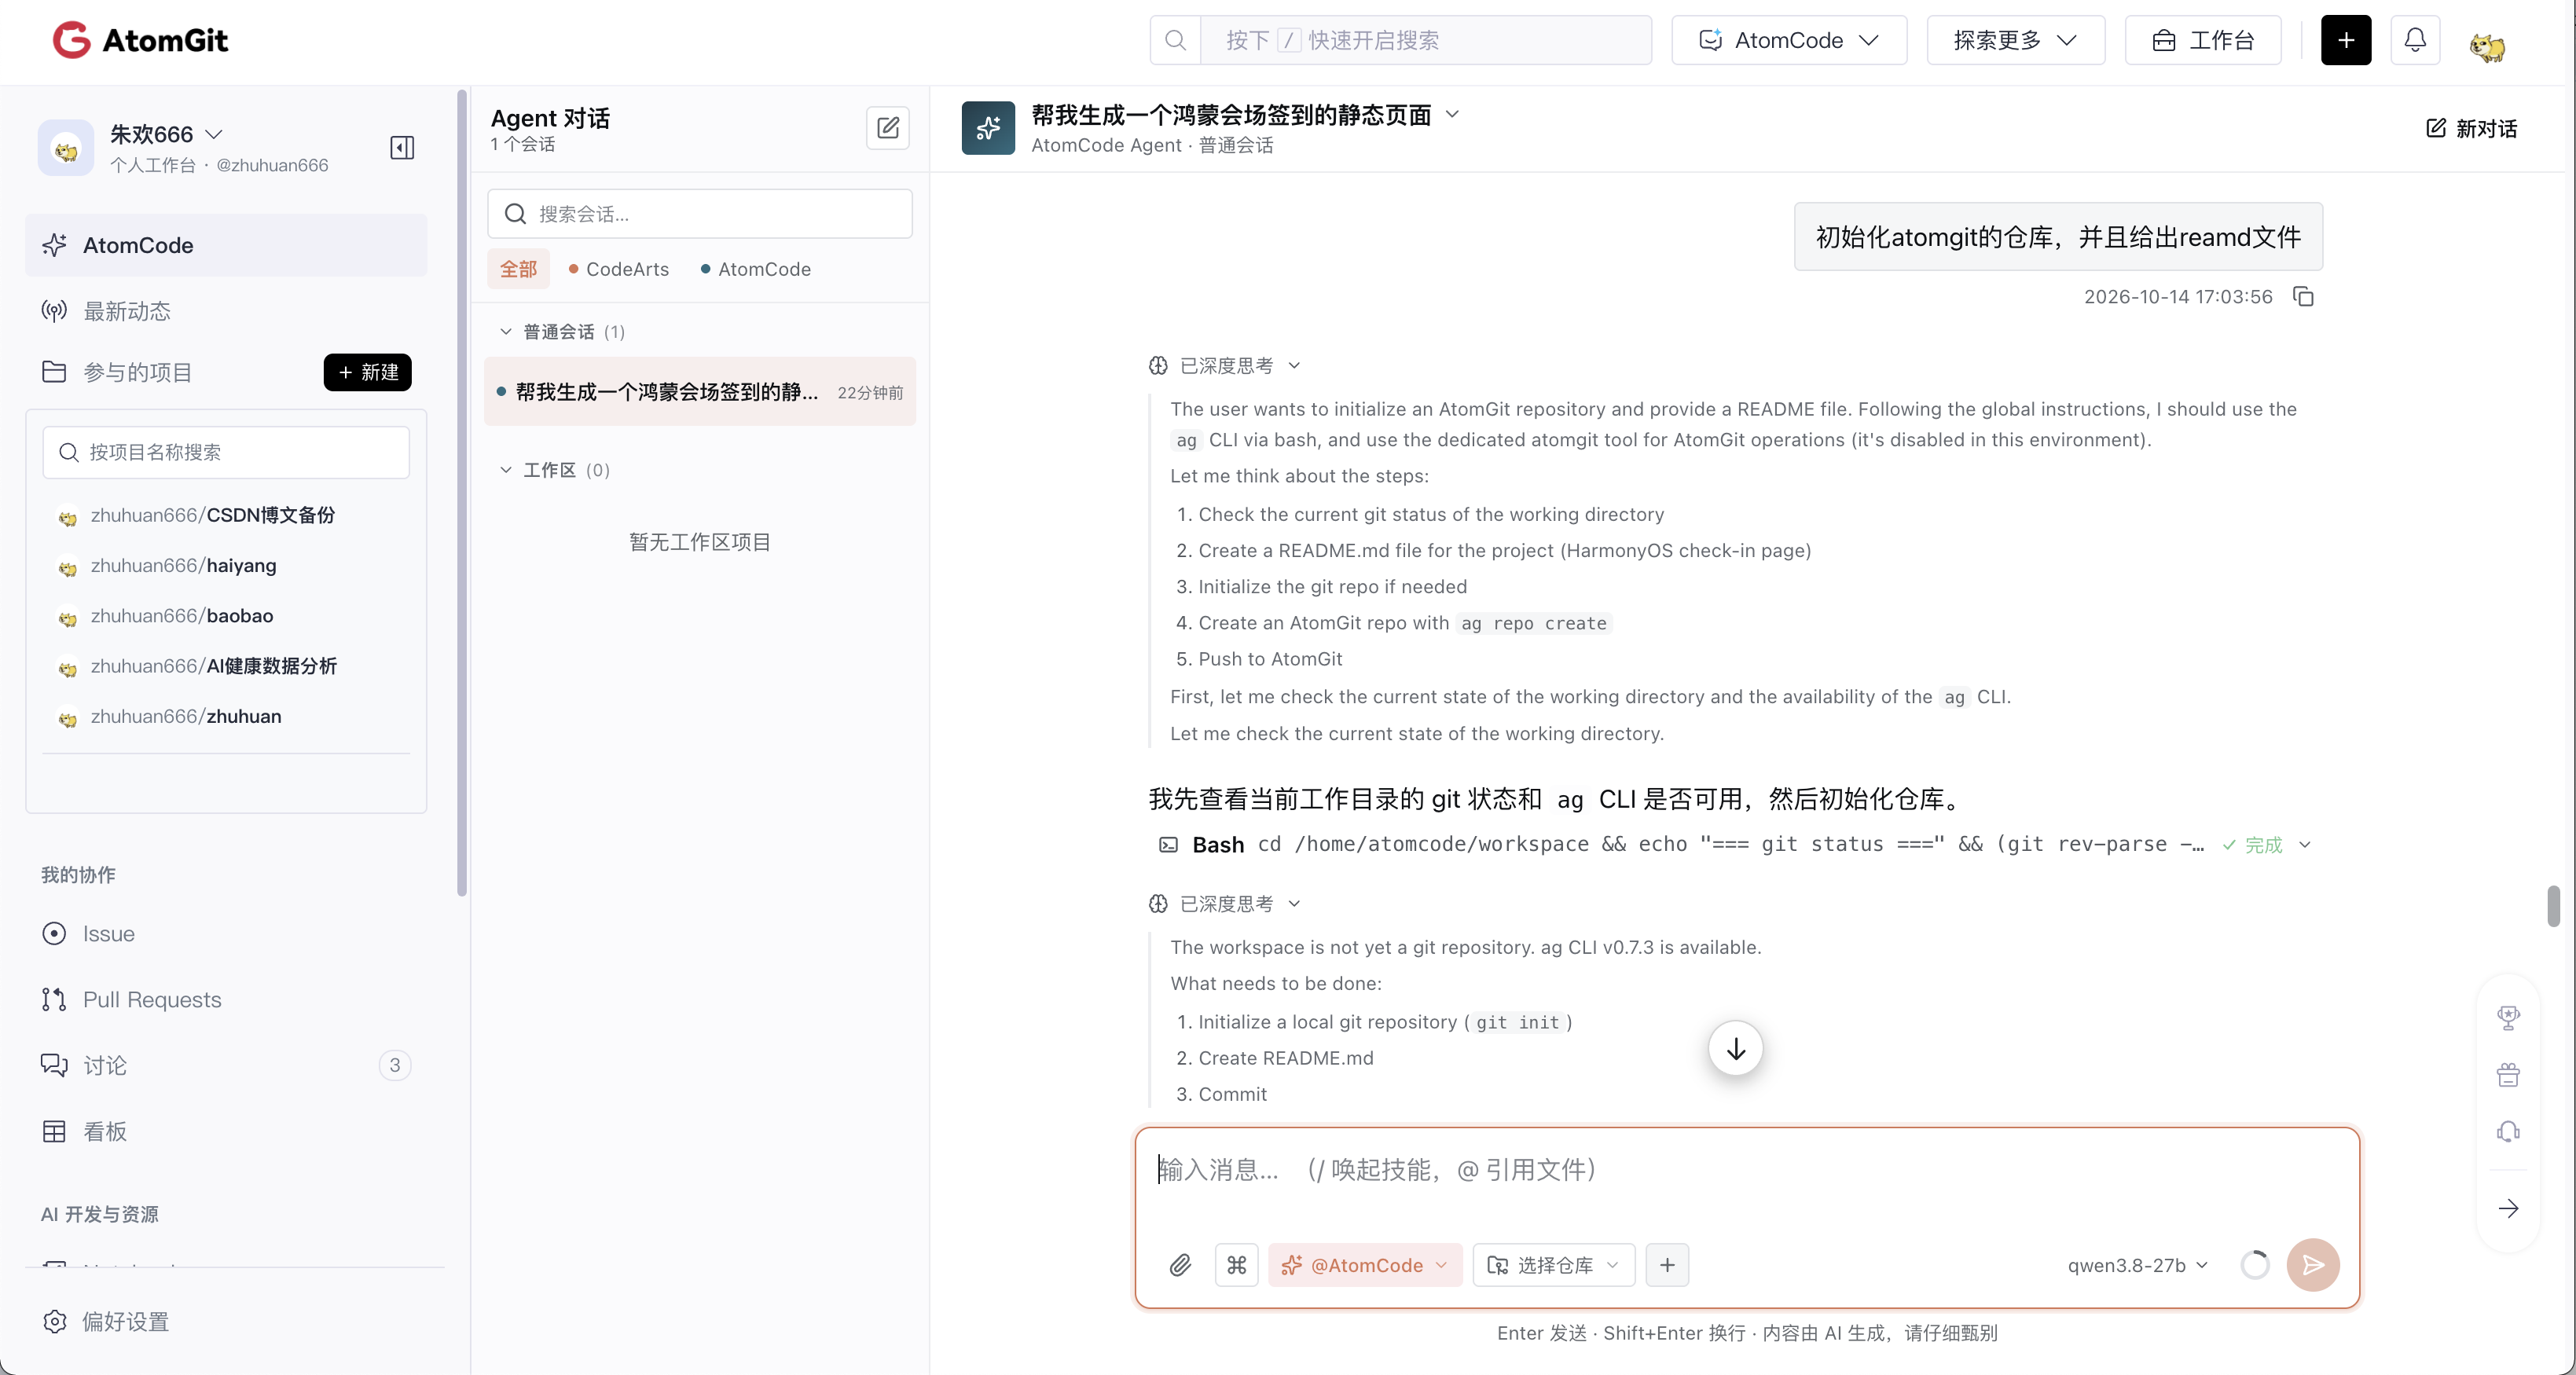
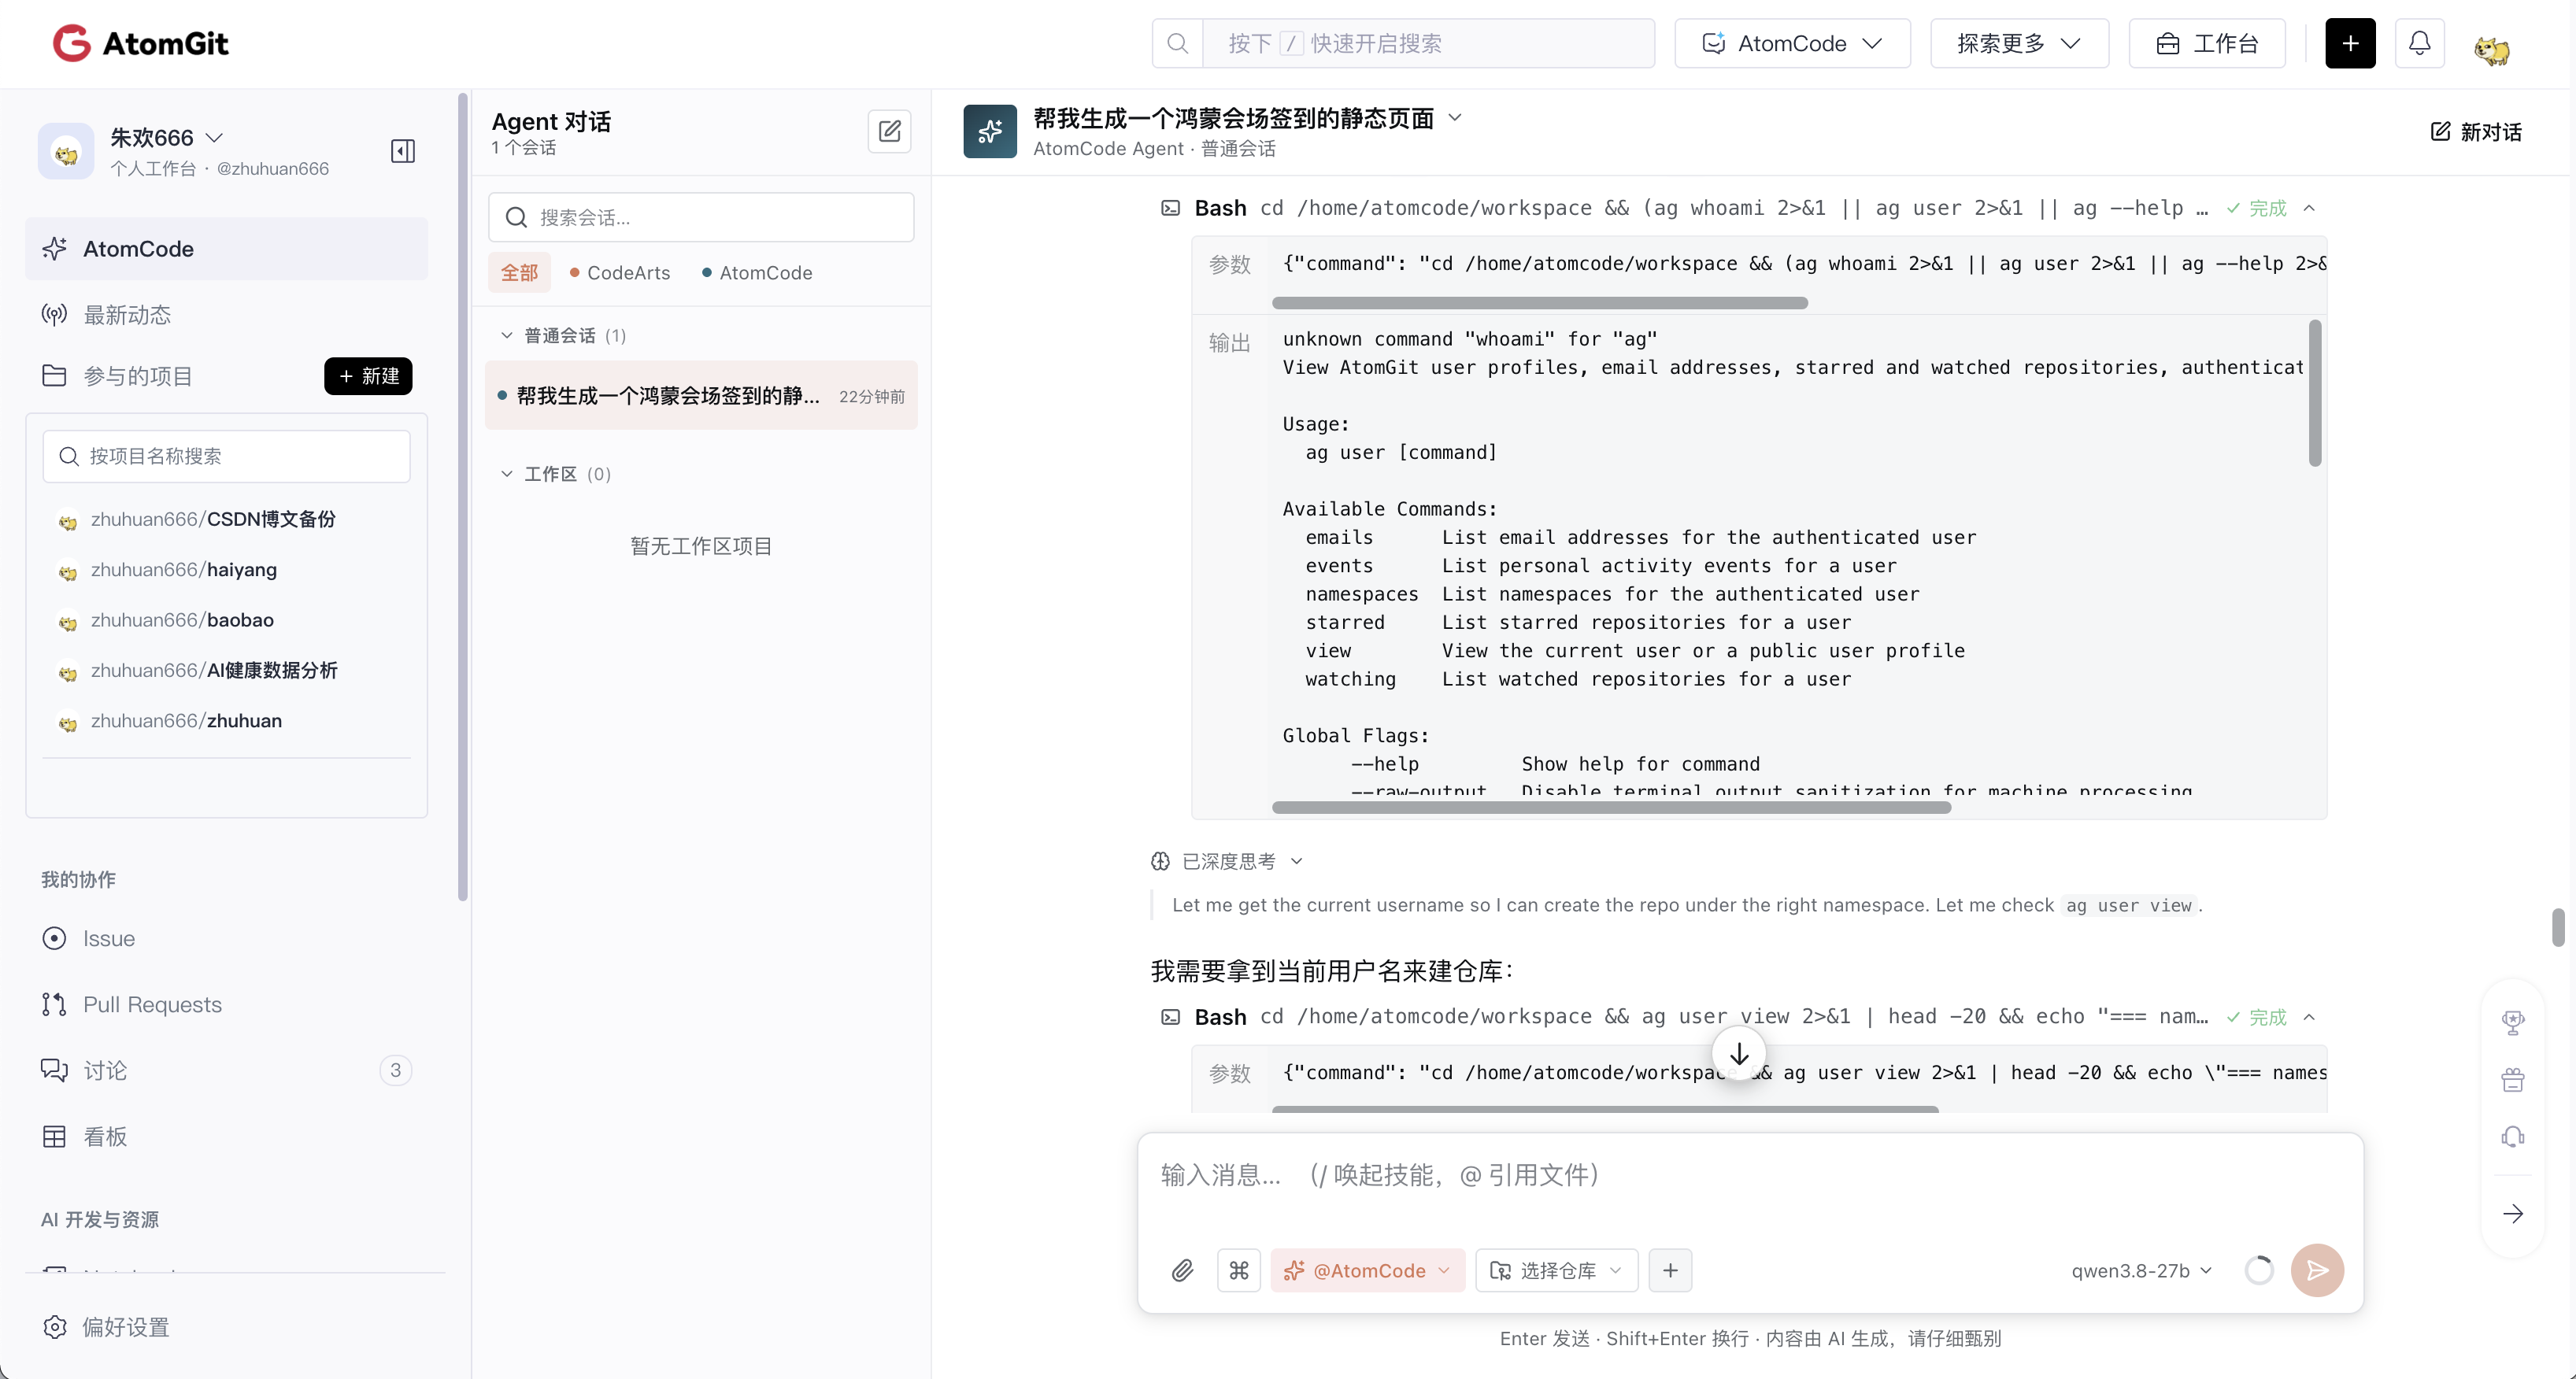
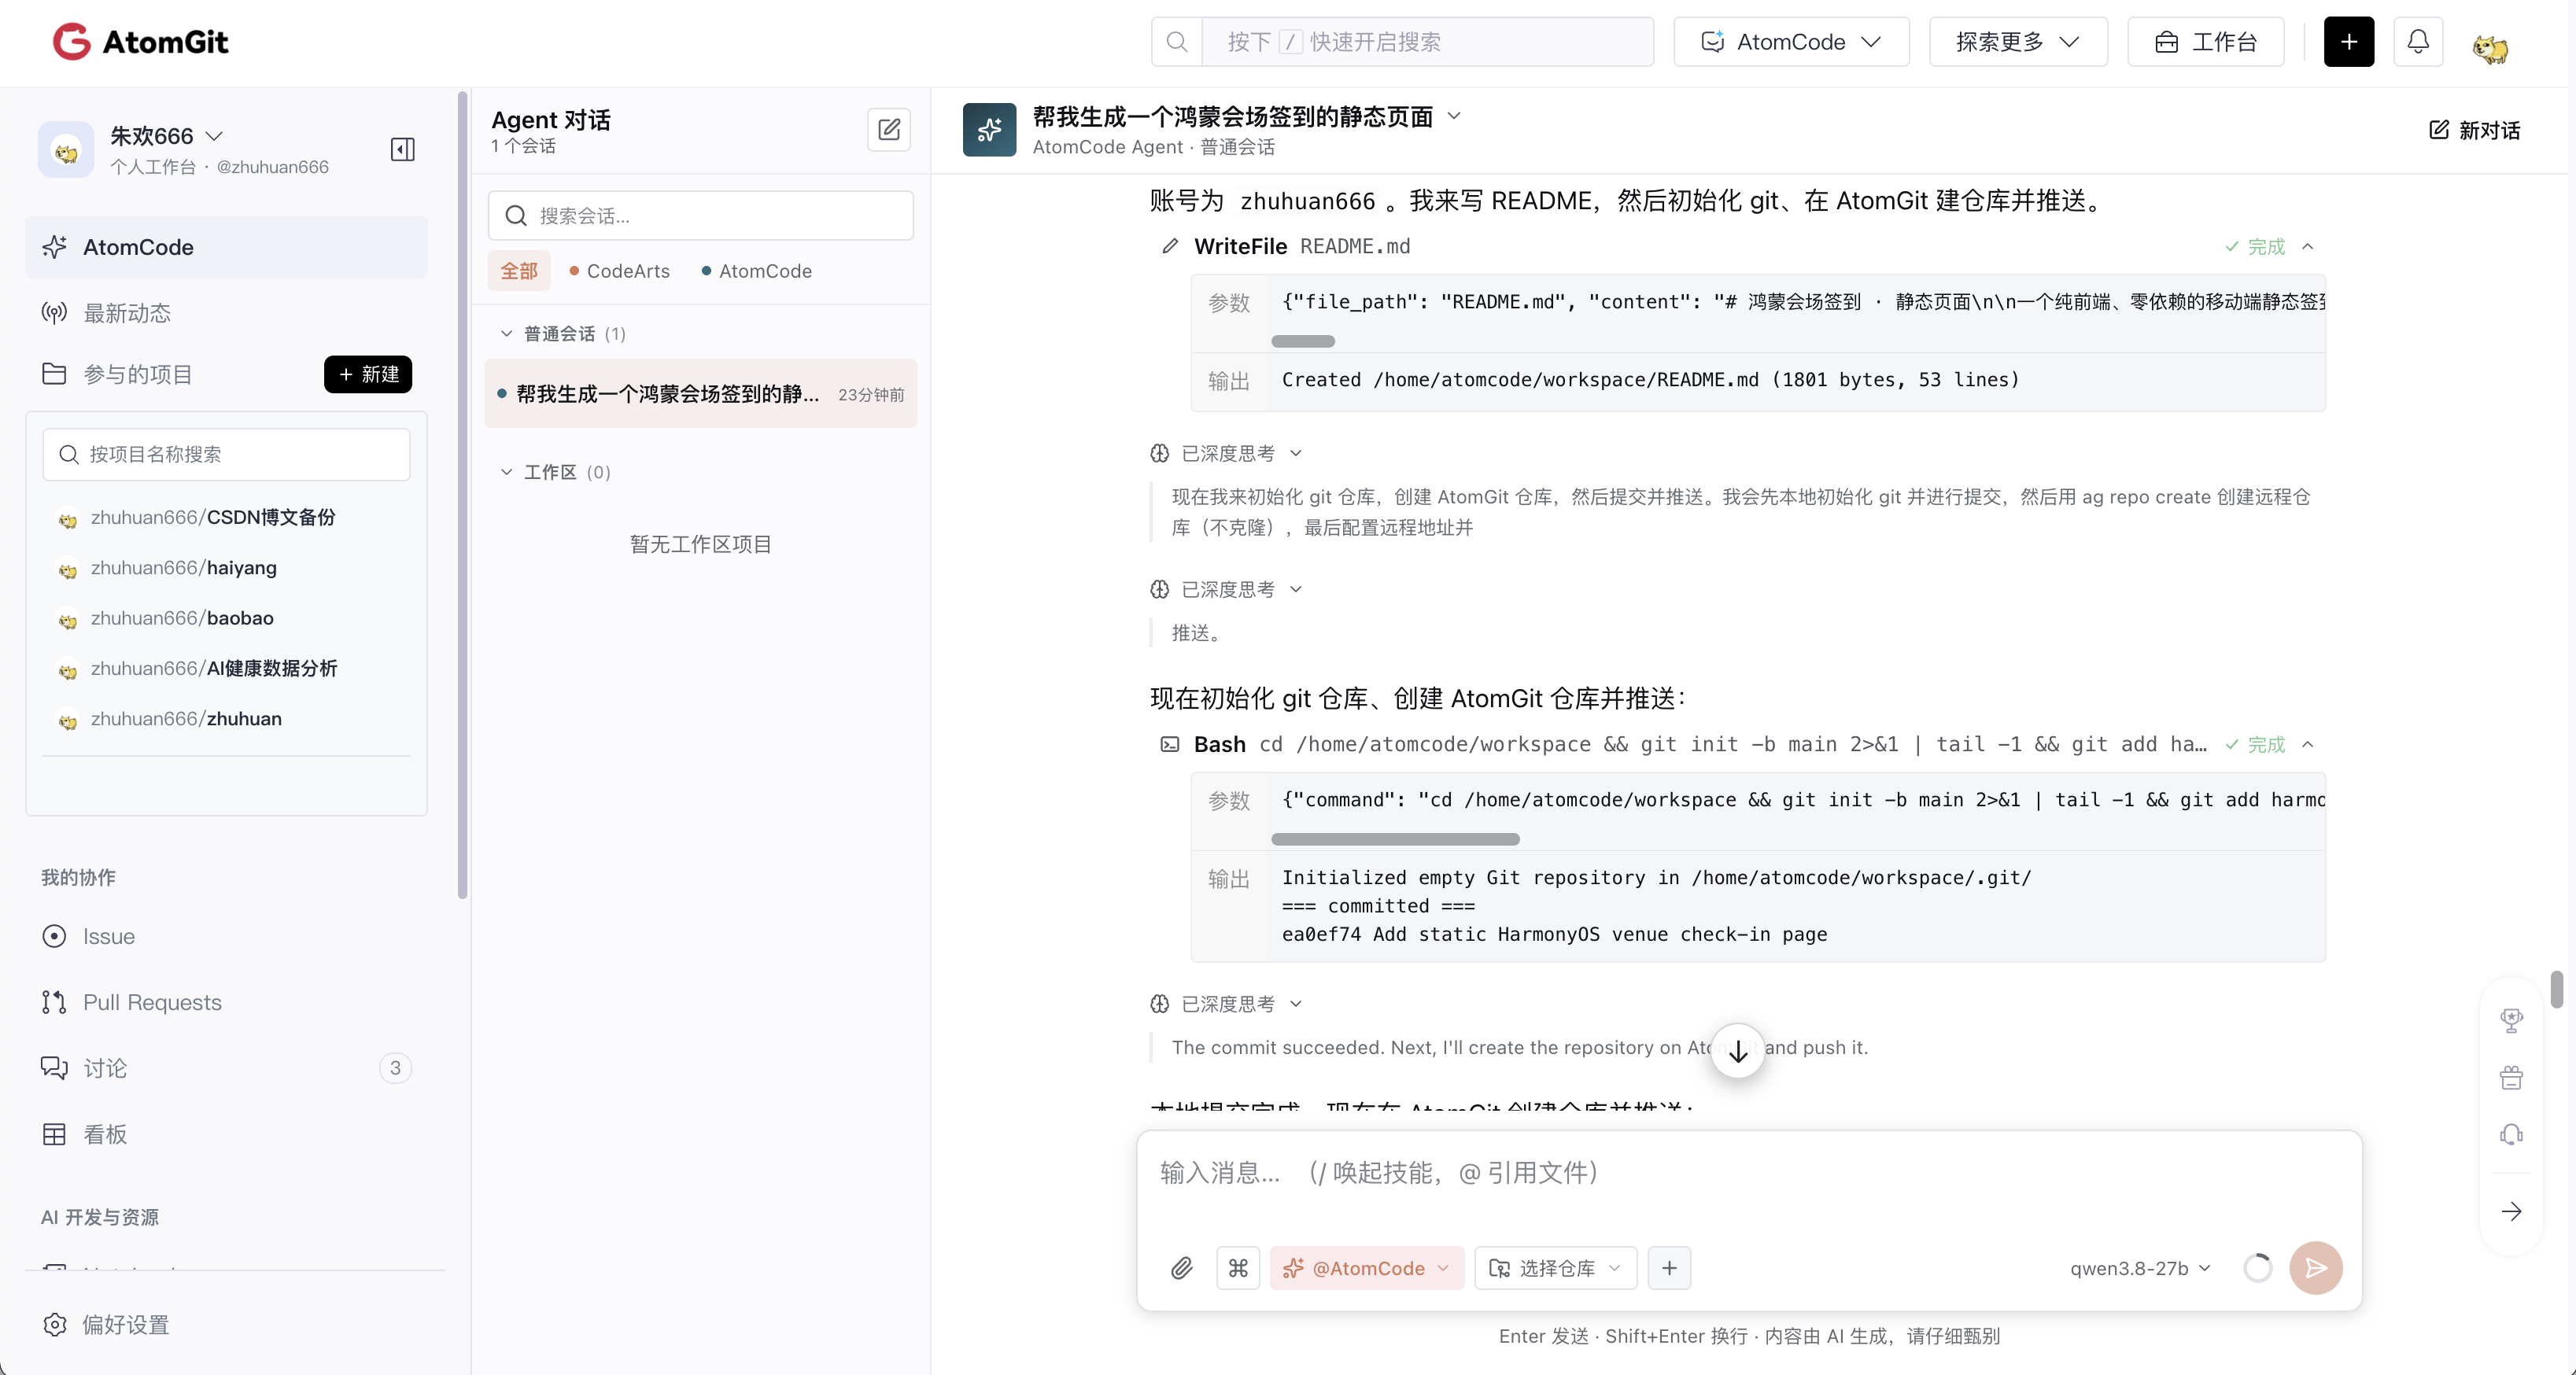
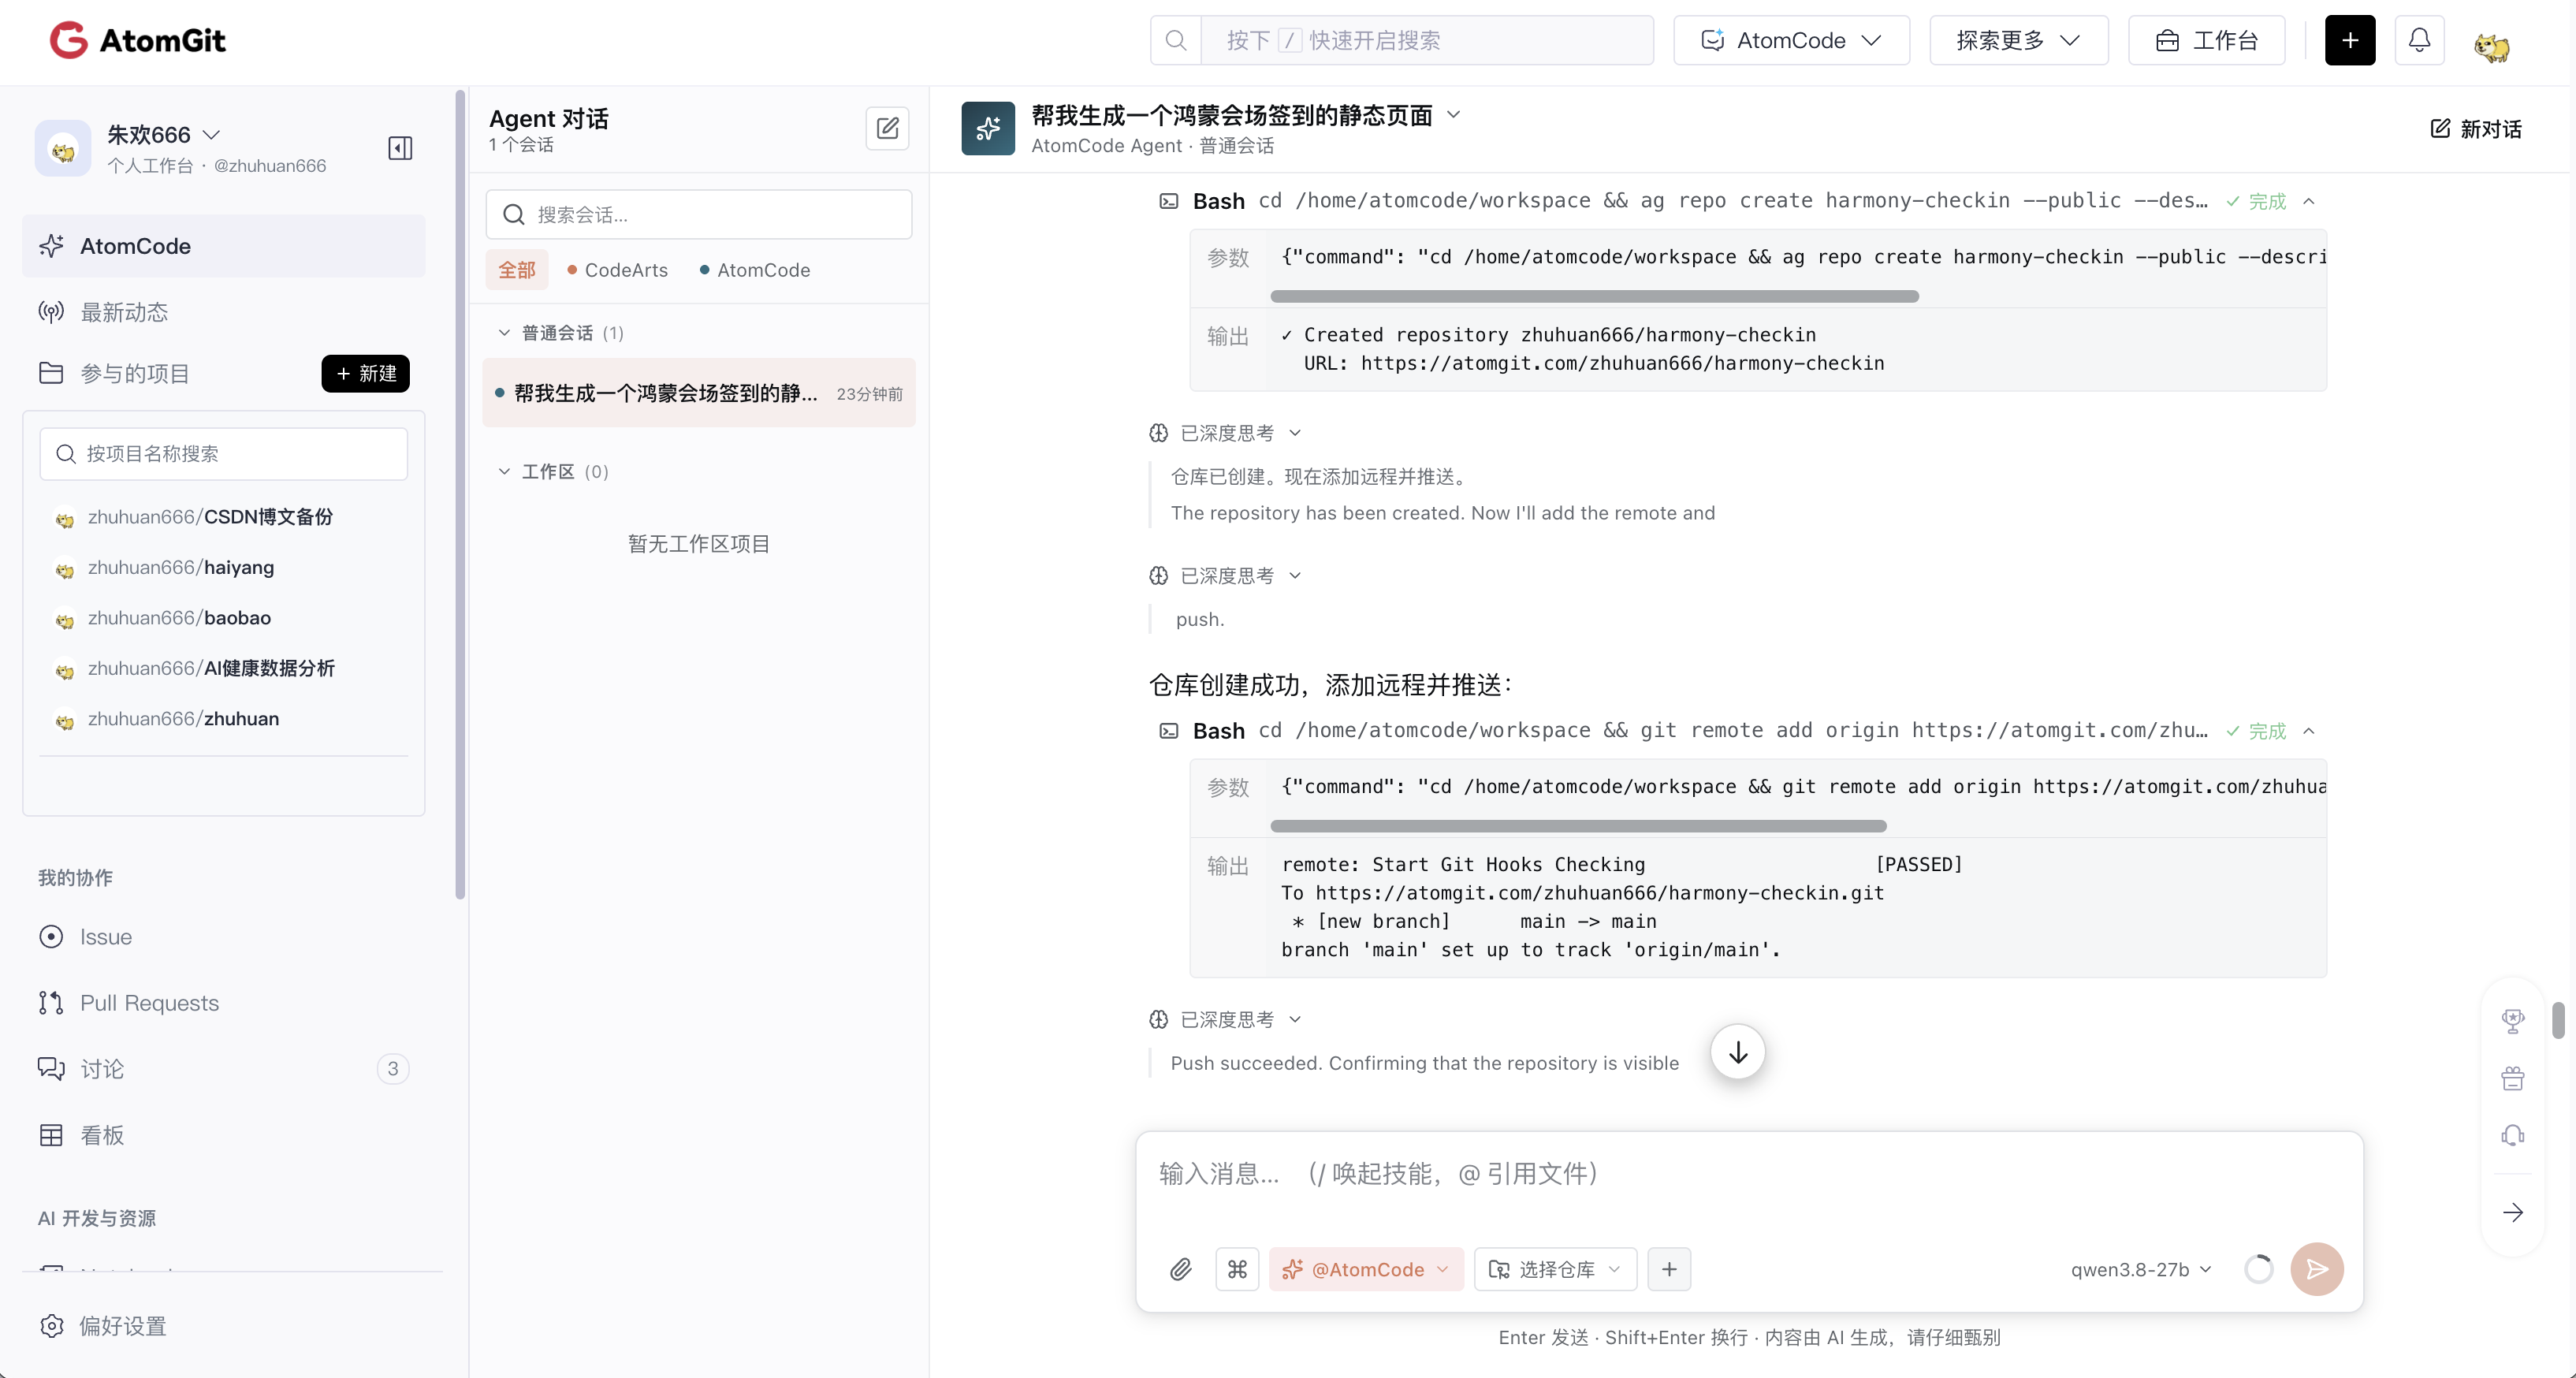
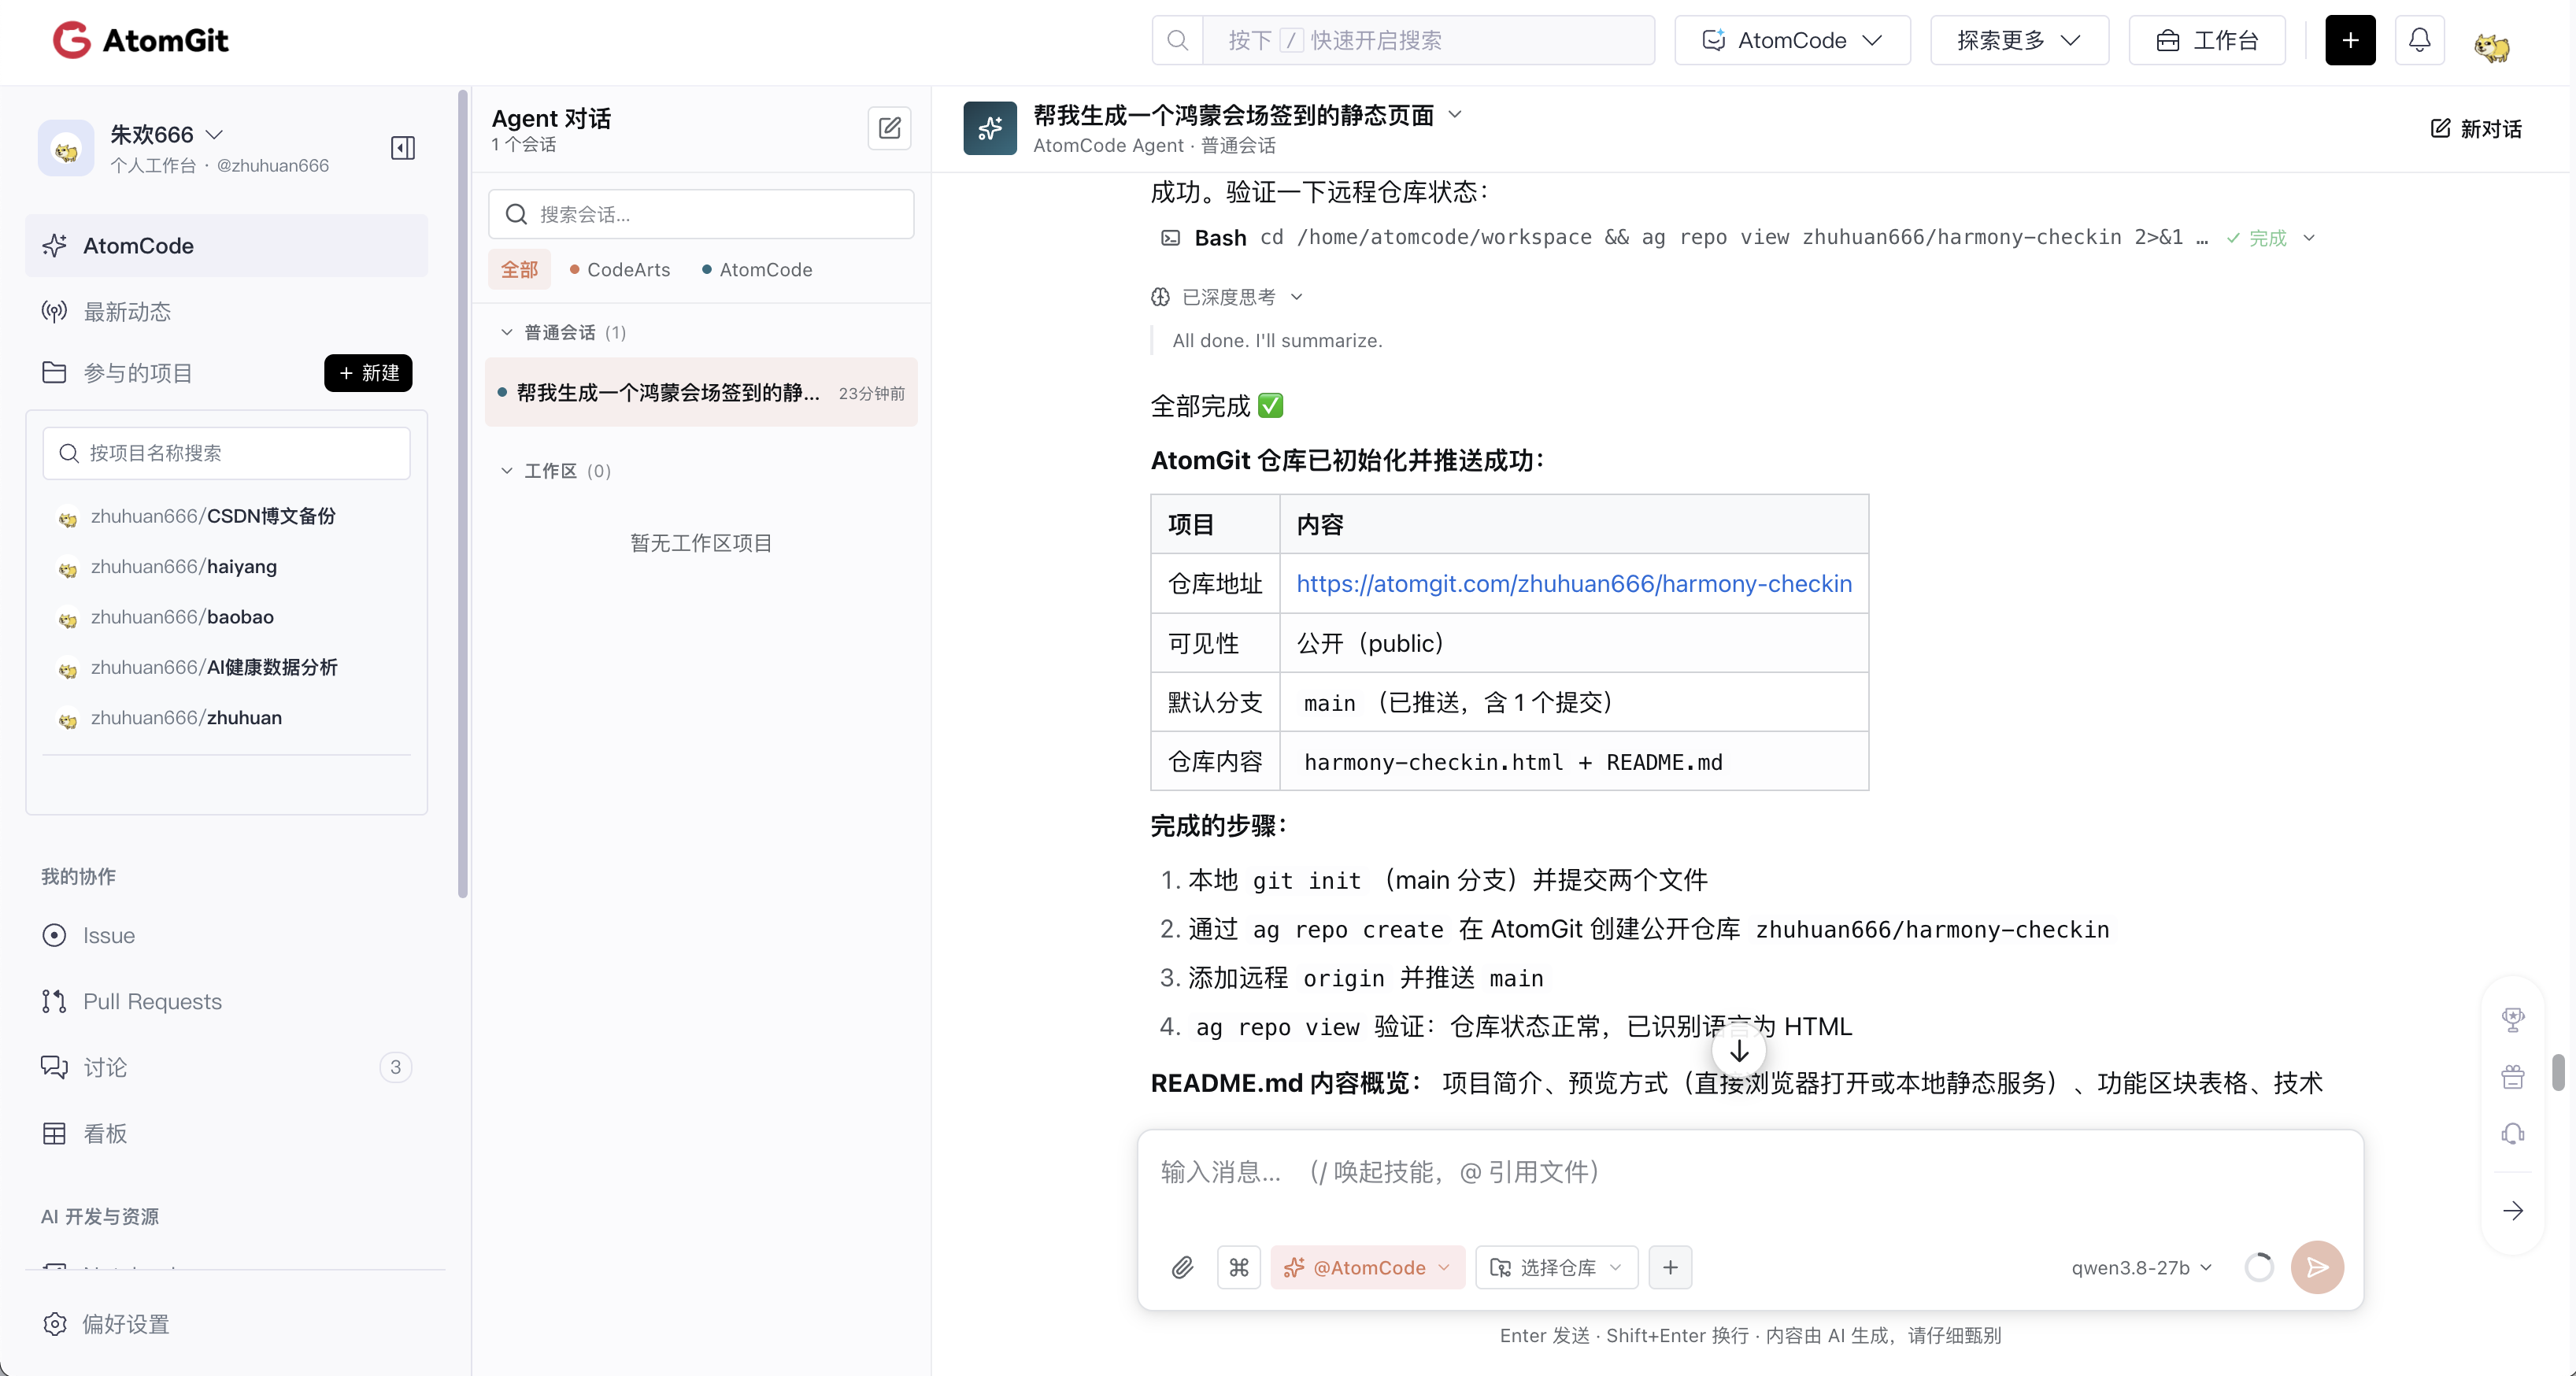
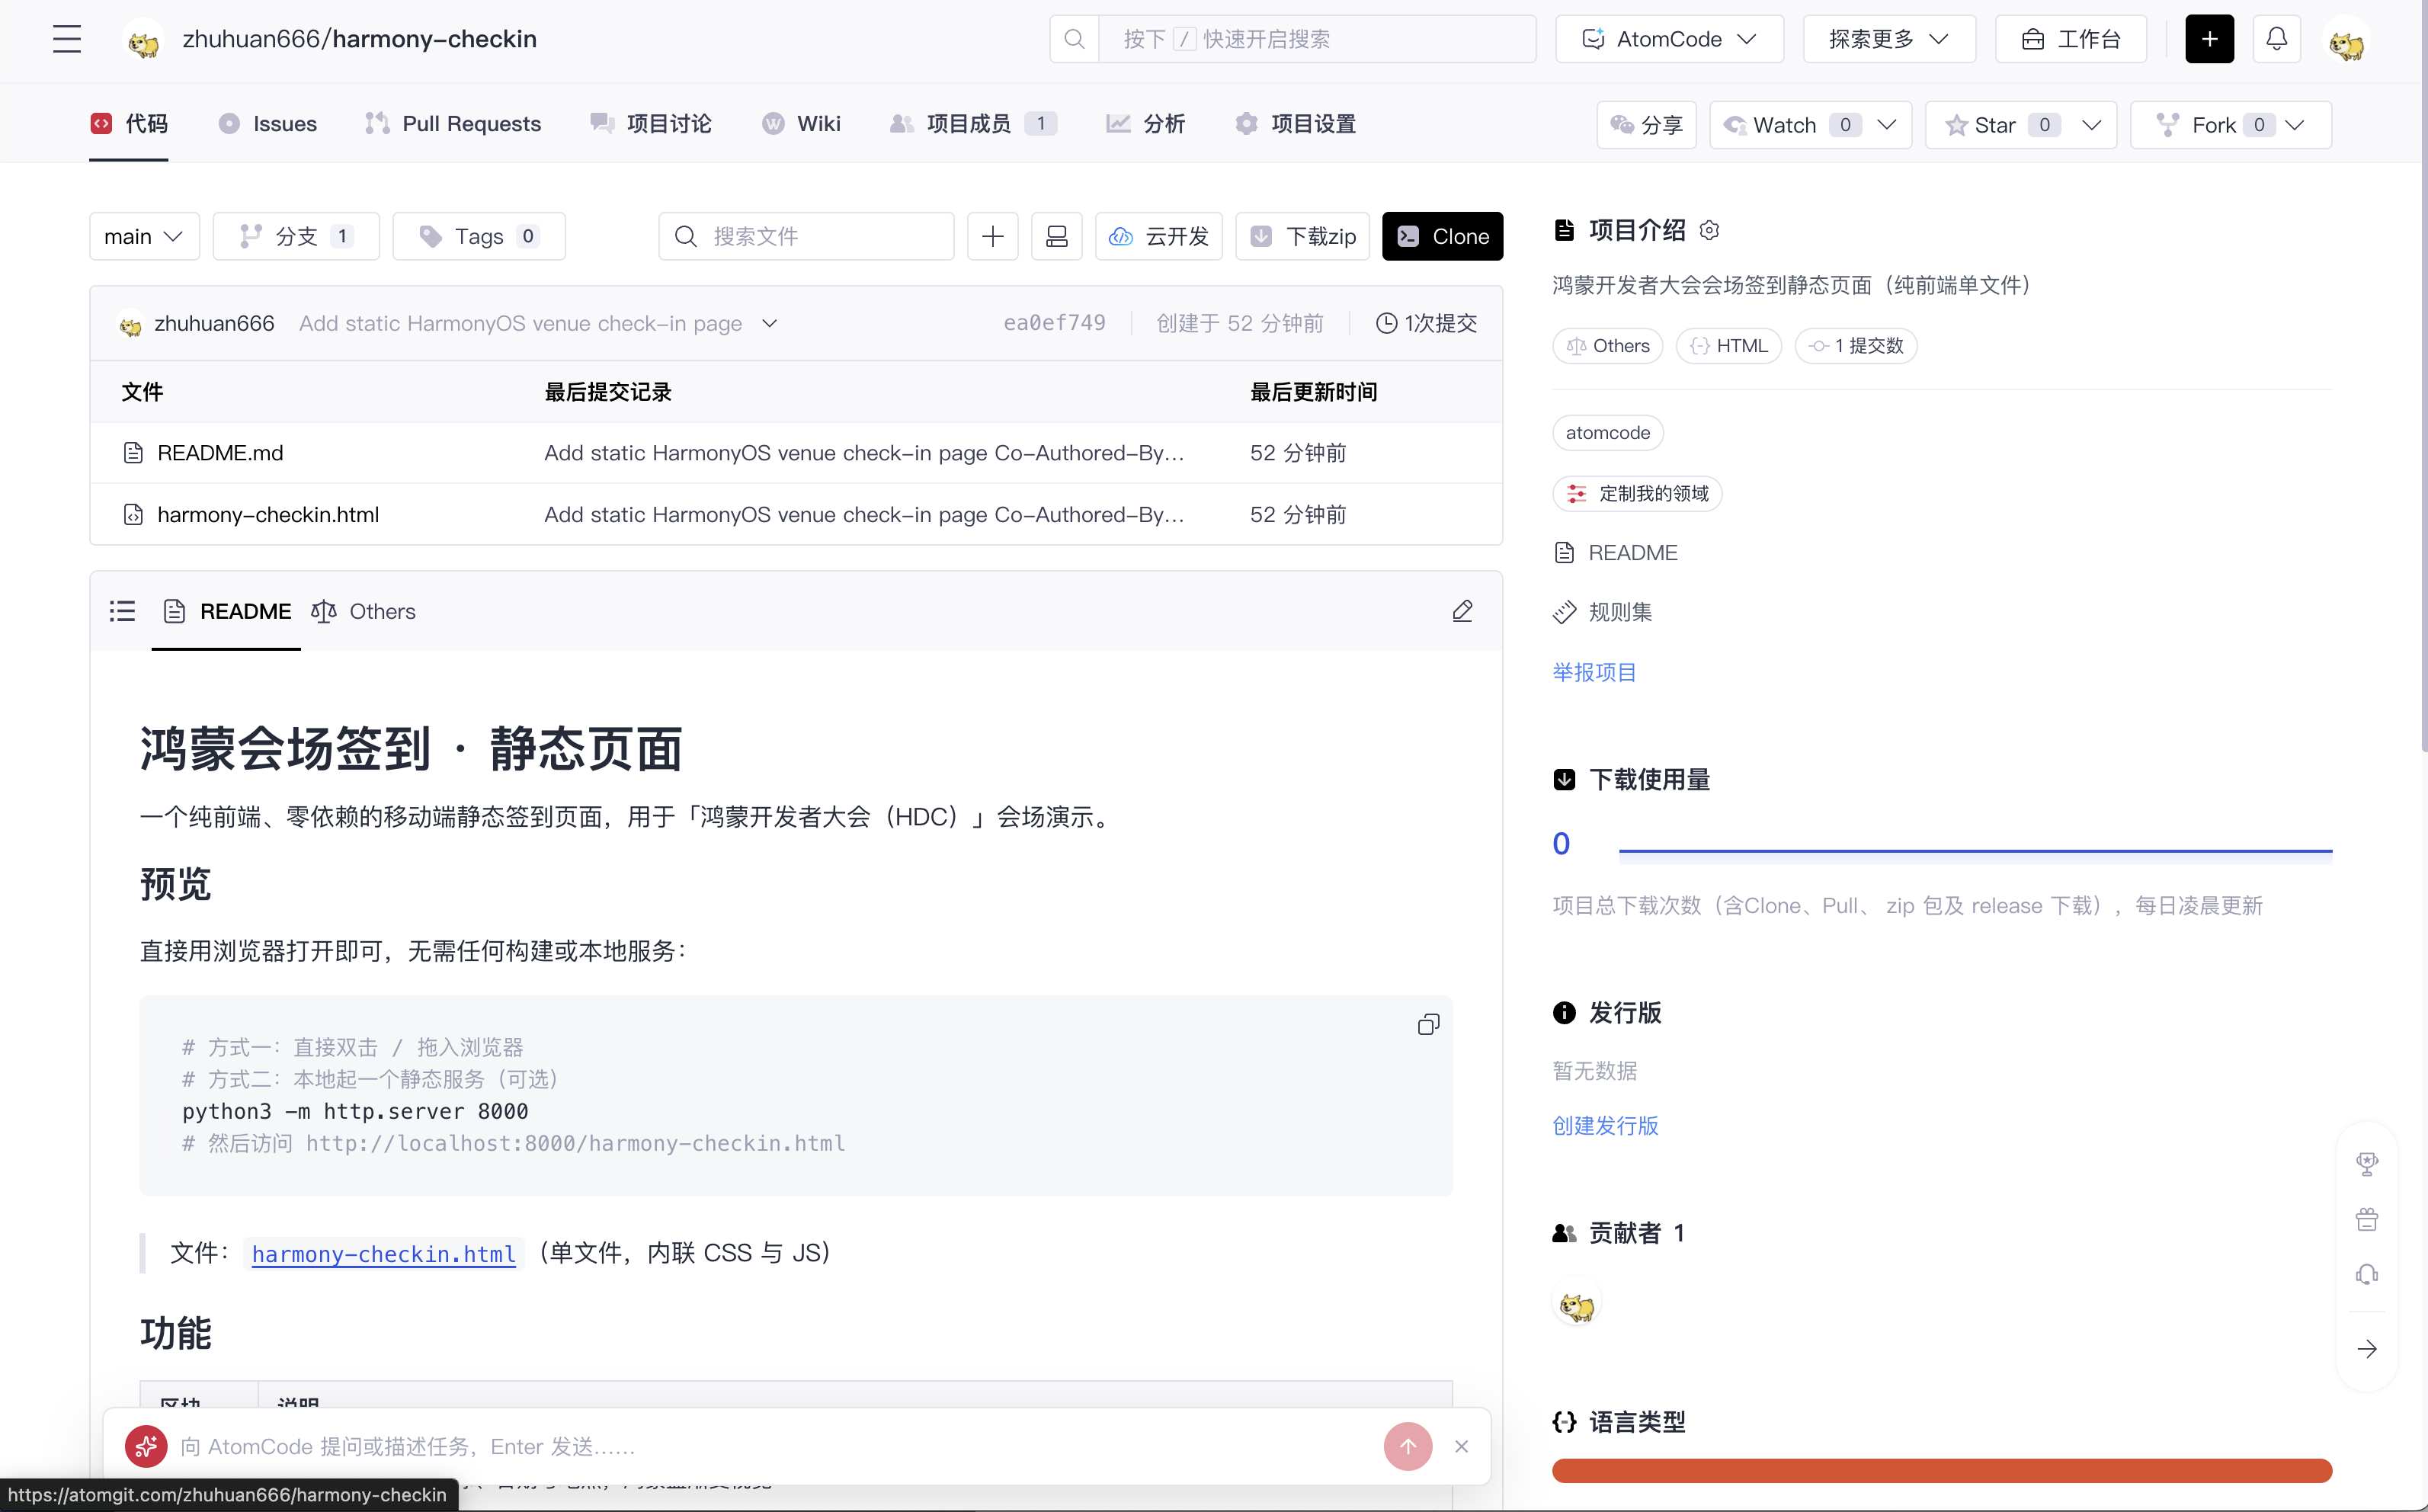
需要说明的是,这一段的中间几张截图在留档时出现了显示异常(页面渲染不稳定),所以我没有逐条还原每一次 push 的输出。但从最终那张验收截图能倒推出完整的动作序列——Agent 自己在总结里把它列清楚了:
- 本地 git init(main 分支)并提交两个文件
- 通过 ag repo create 在 AtomGit 上创建公开仓库 zhuhuan666/harmony-checkin
- 添加远程 origin 并推送 main
- ag repo view 验证:仓库状态正常,已识别语言 = HTML
最终验收表长这样:
| 项目 | 内容 |
|---|---|
| 仓库地址 | https://atomgit.com/zhuhuan666/harmony-checkin |
| 可见性 | 公开(public) |
| 默认分支 | main(已推送,含 1 个提交) |
| 仓库内容 | harmony-checkin.html + README.md |
几个细节值得停一下。
其一,默认分支直接用了 main。 它没有走"先 git init 生成 master 再改名"的弯路,而是一开始就指定 main。这是 2020 年之后的主流约定,说明它的脚手架知识比较新。
其二,交付物是两个文件而不是一个。 除了 harmony-checkin.html,它还生成了 README.md,内容涵盖"项目简介、预览方式(直接浏览器打开或本地静态服务)、功能区块表格、技术栈"。这一步很容易被跳过——毕竟代码才是主角。但对一个要推上公开仓库的项目来说,README 决定了别人点进来第一眼能不能看懂这是个什么。它甚至写了"预览方式"这种面向使用者的说明,这是产品思维的痕迹。
其三,用 ag repo view 做了远程复核。 这是最关键的一点。push 成功只代表命令返回了 0,不代表远程仓库真的建好、内容真的到位、语言真的被识别。它多跑了一条 ag repo view 去远端确认状态,看到"已识别语言 = HTML"才算完。"推送成功"和"仓库真的可访问"是两件事——这个差别,正是新手和老手在交付环节最大的分野。
| 交付环节 | 新手常见做法 | AI(本次)做法 |
|---|---|---|
| 初始化 | git init(默认 master)后不处理分支名 | 直接以 main 初始化 |
| 远程创建 | 手动开浏览器建仓,容易忘设可见性 | ag repo create 显式指定公开 |
| 附带文档 | 通常只推代码 | 同时生成 README.md(含预览方式) |
| 交付验证 | git push 返回成功就当完成 | 追加 ag repo view 远端复核 |
| 可见性认知 | 常忽略,或在"私有/公开"间反复 | 一次选定,并在总结里写清楚 |
关于可见性,这里还有一层呼应。上一篇 Vue3 项目的仓库是先建成私有、后来被要求改成公开的,属于"补位操作";而这一次,ag repo create 那一步就直接把可见性定成了公开。同一类岔路口,这次没有走弯路——变量在于这一次需求里隐含了"要给别人看"的意图(一个可访问的 demo),所以它没有犹豫。这种"从需求反推交付形态"的判断,比记住某条命令更重要。
十、两次自我纠错的深度对照
前面提到链路上有两次折返。这两次纠错特别值得单独拿出来,因为它们犯的错性质完全不同,而纠错的表现却能看出同一套底层能力。
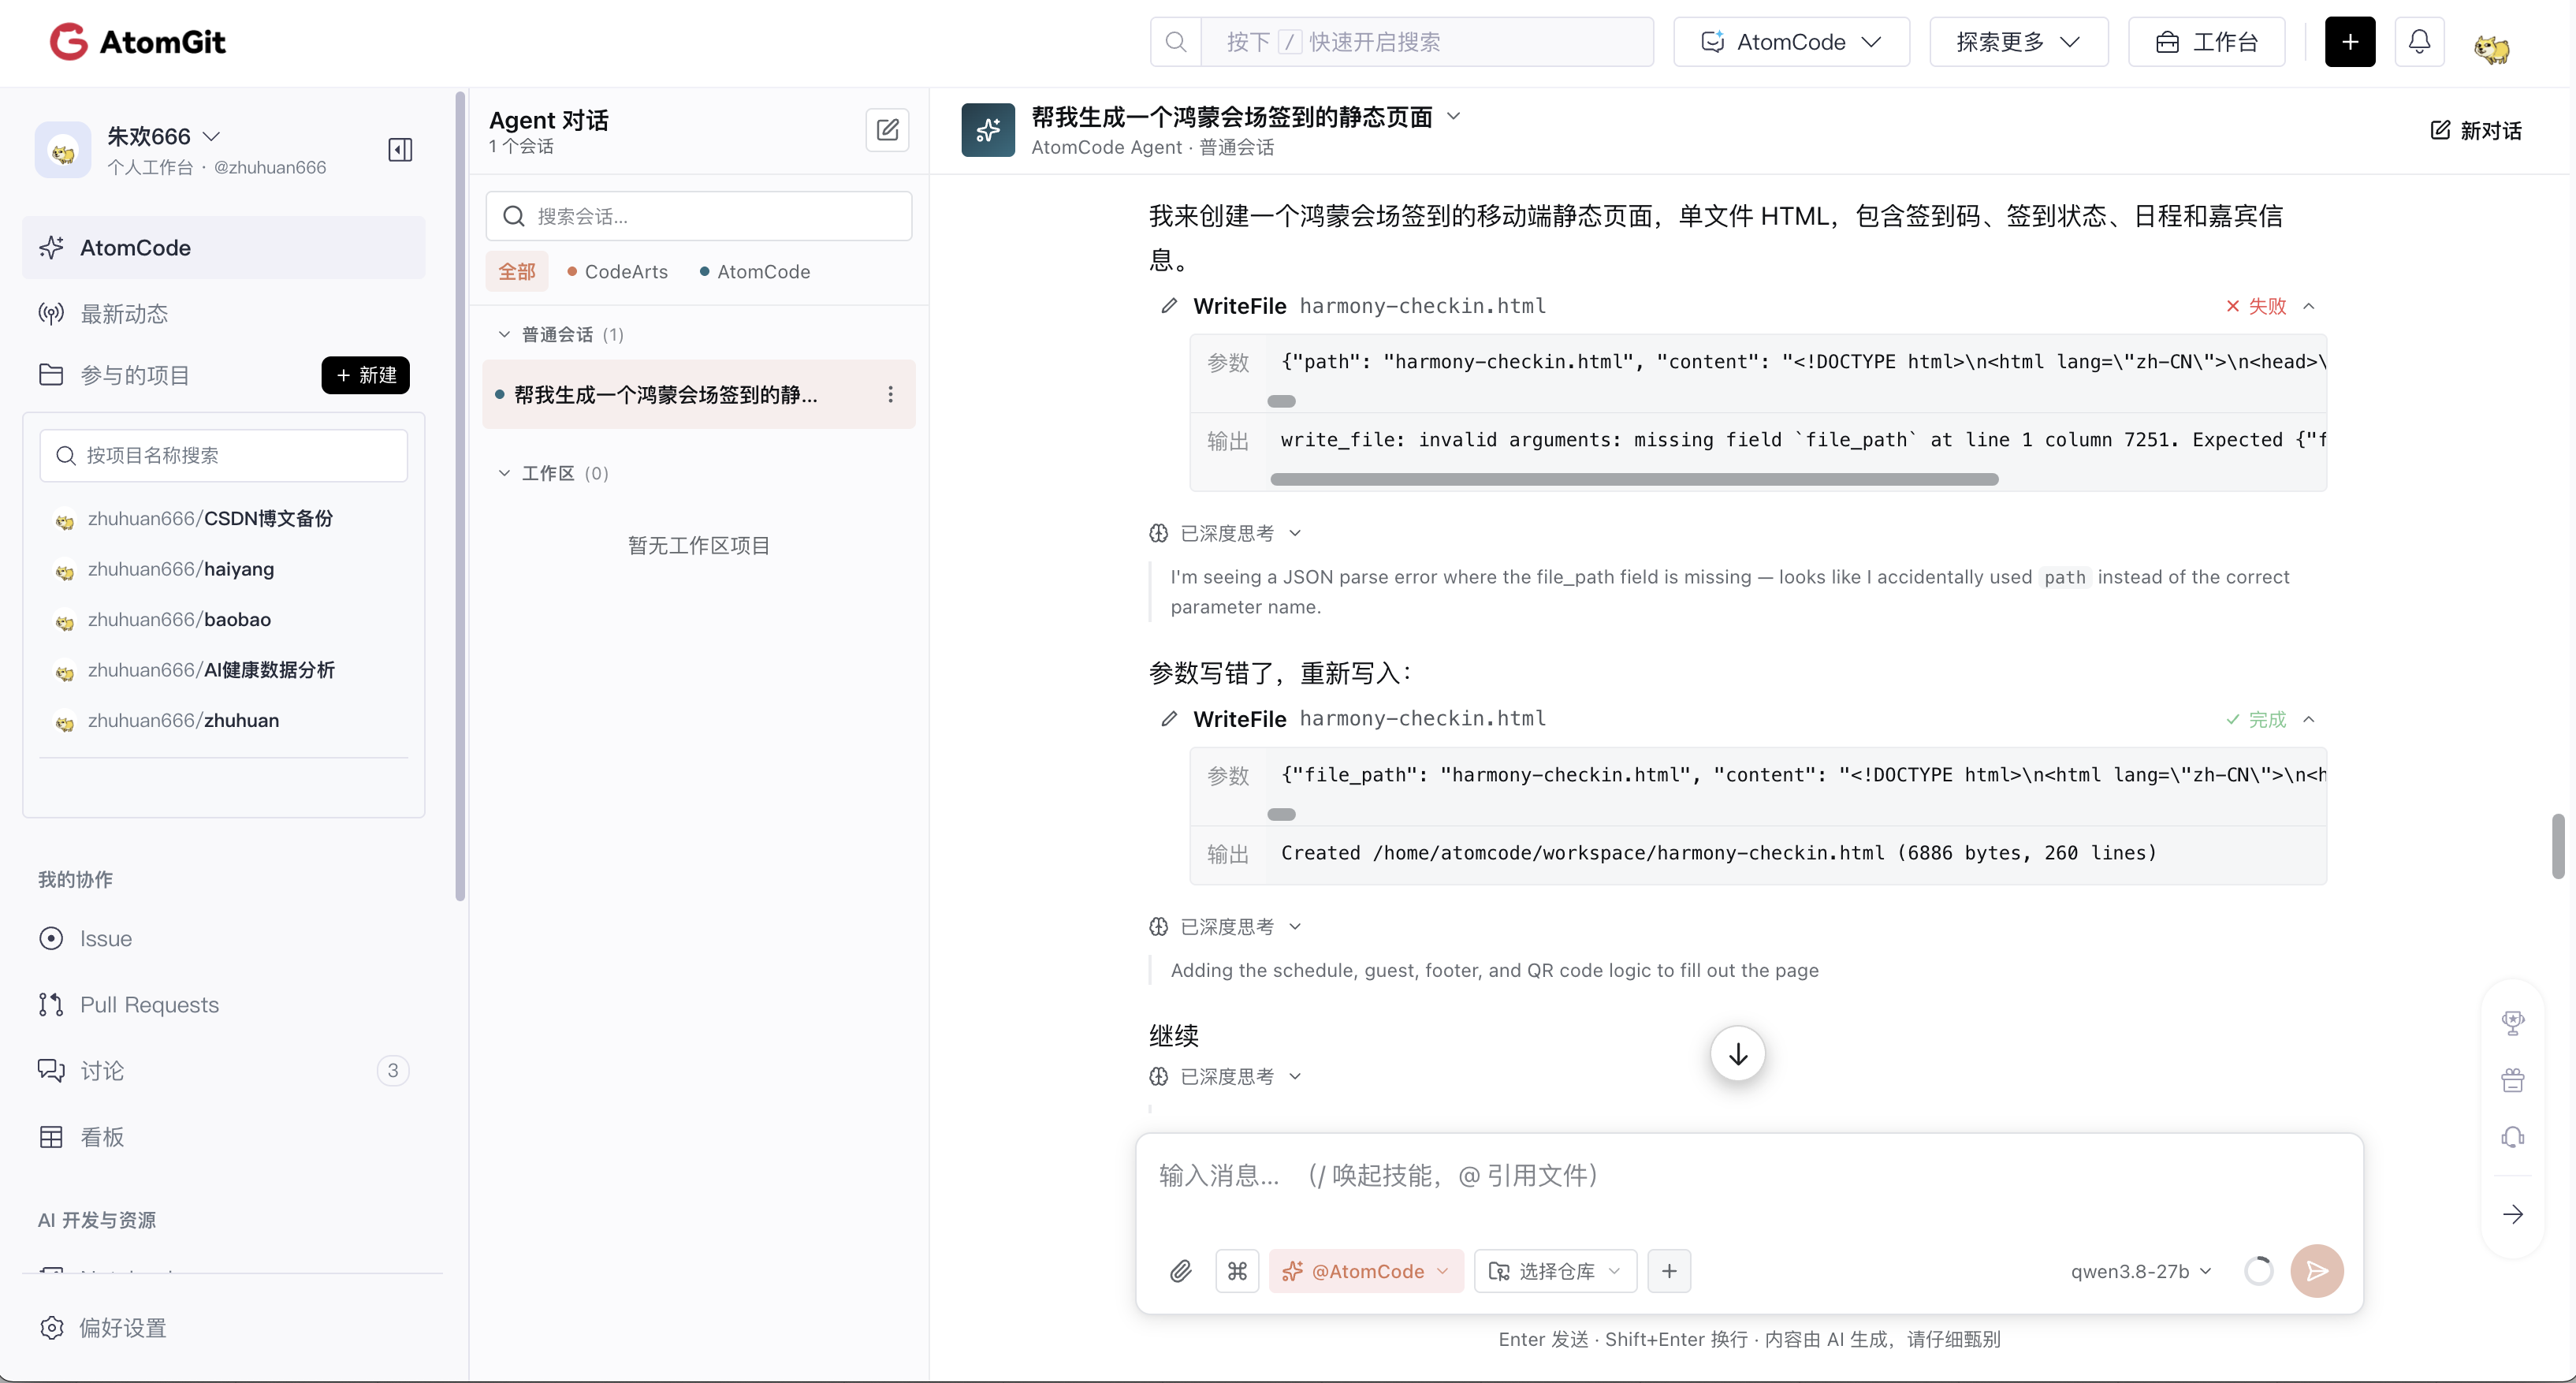
纠错一:工具契约错误(参数名写错)
第一次 write_file 调用时,它传的参数是:
{ "path": "harmony-checkin.html", "content": "<!DOCTYPE html>...</html>" }
工具返回报错:
write_file: invalid arguments: missing field 'file_path' at line 1 column 7251.
Expected {"file_...
它自己随即判断(推理原文):
I’m seeing a JSON parse error where the file_path field is missing - looks like I accidentally used path instead of the correct parameter name.
然后立刻重写:
{ "file_path": "harmony-checkin.html", "content": "<!DOCTYPE html>...</html>" }
输出变成:Created /home/atomcode/workspace/harmony-checkin.html (6886 bytes, 260 lines)。
这个错误的性质是工具契约不熟——知道要写文件,但记混了参数名(path vs file_path)。它的处理干净利落:读报错、定位字段、改参数名、重试,一次成功。没有反复试探,也没有把上一次的失败归咎于环境。
纠错二:思维链产物错误(校验脚本自己写错)
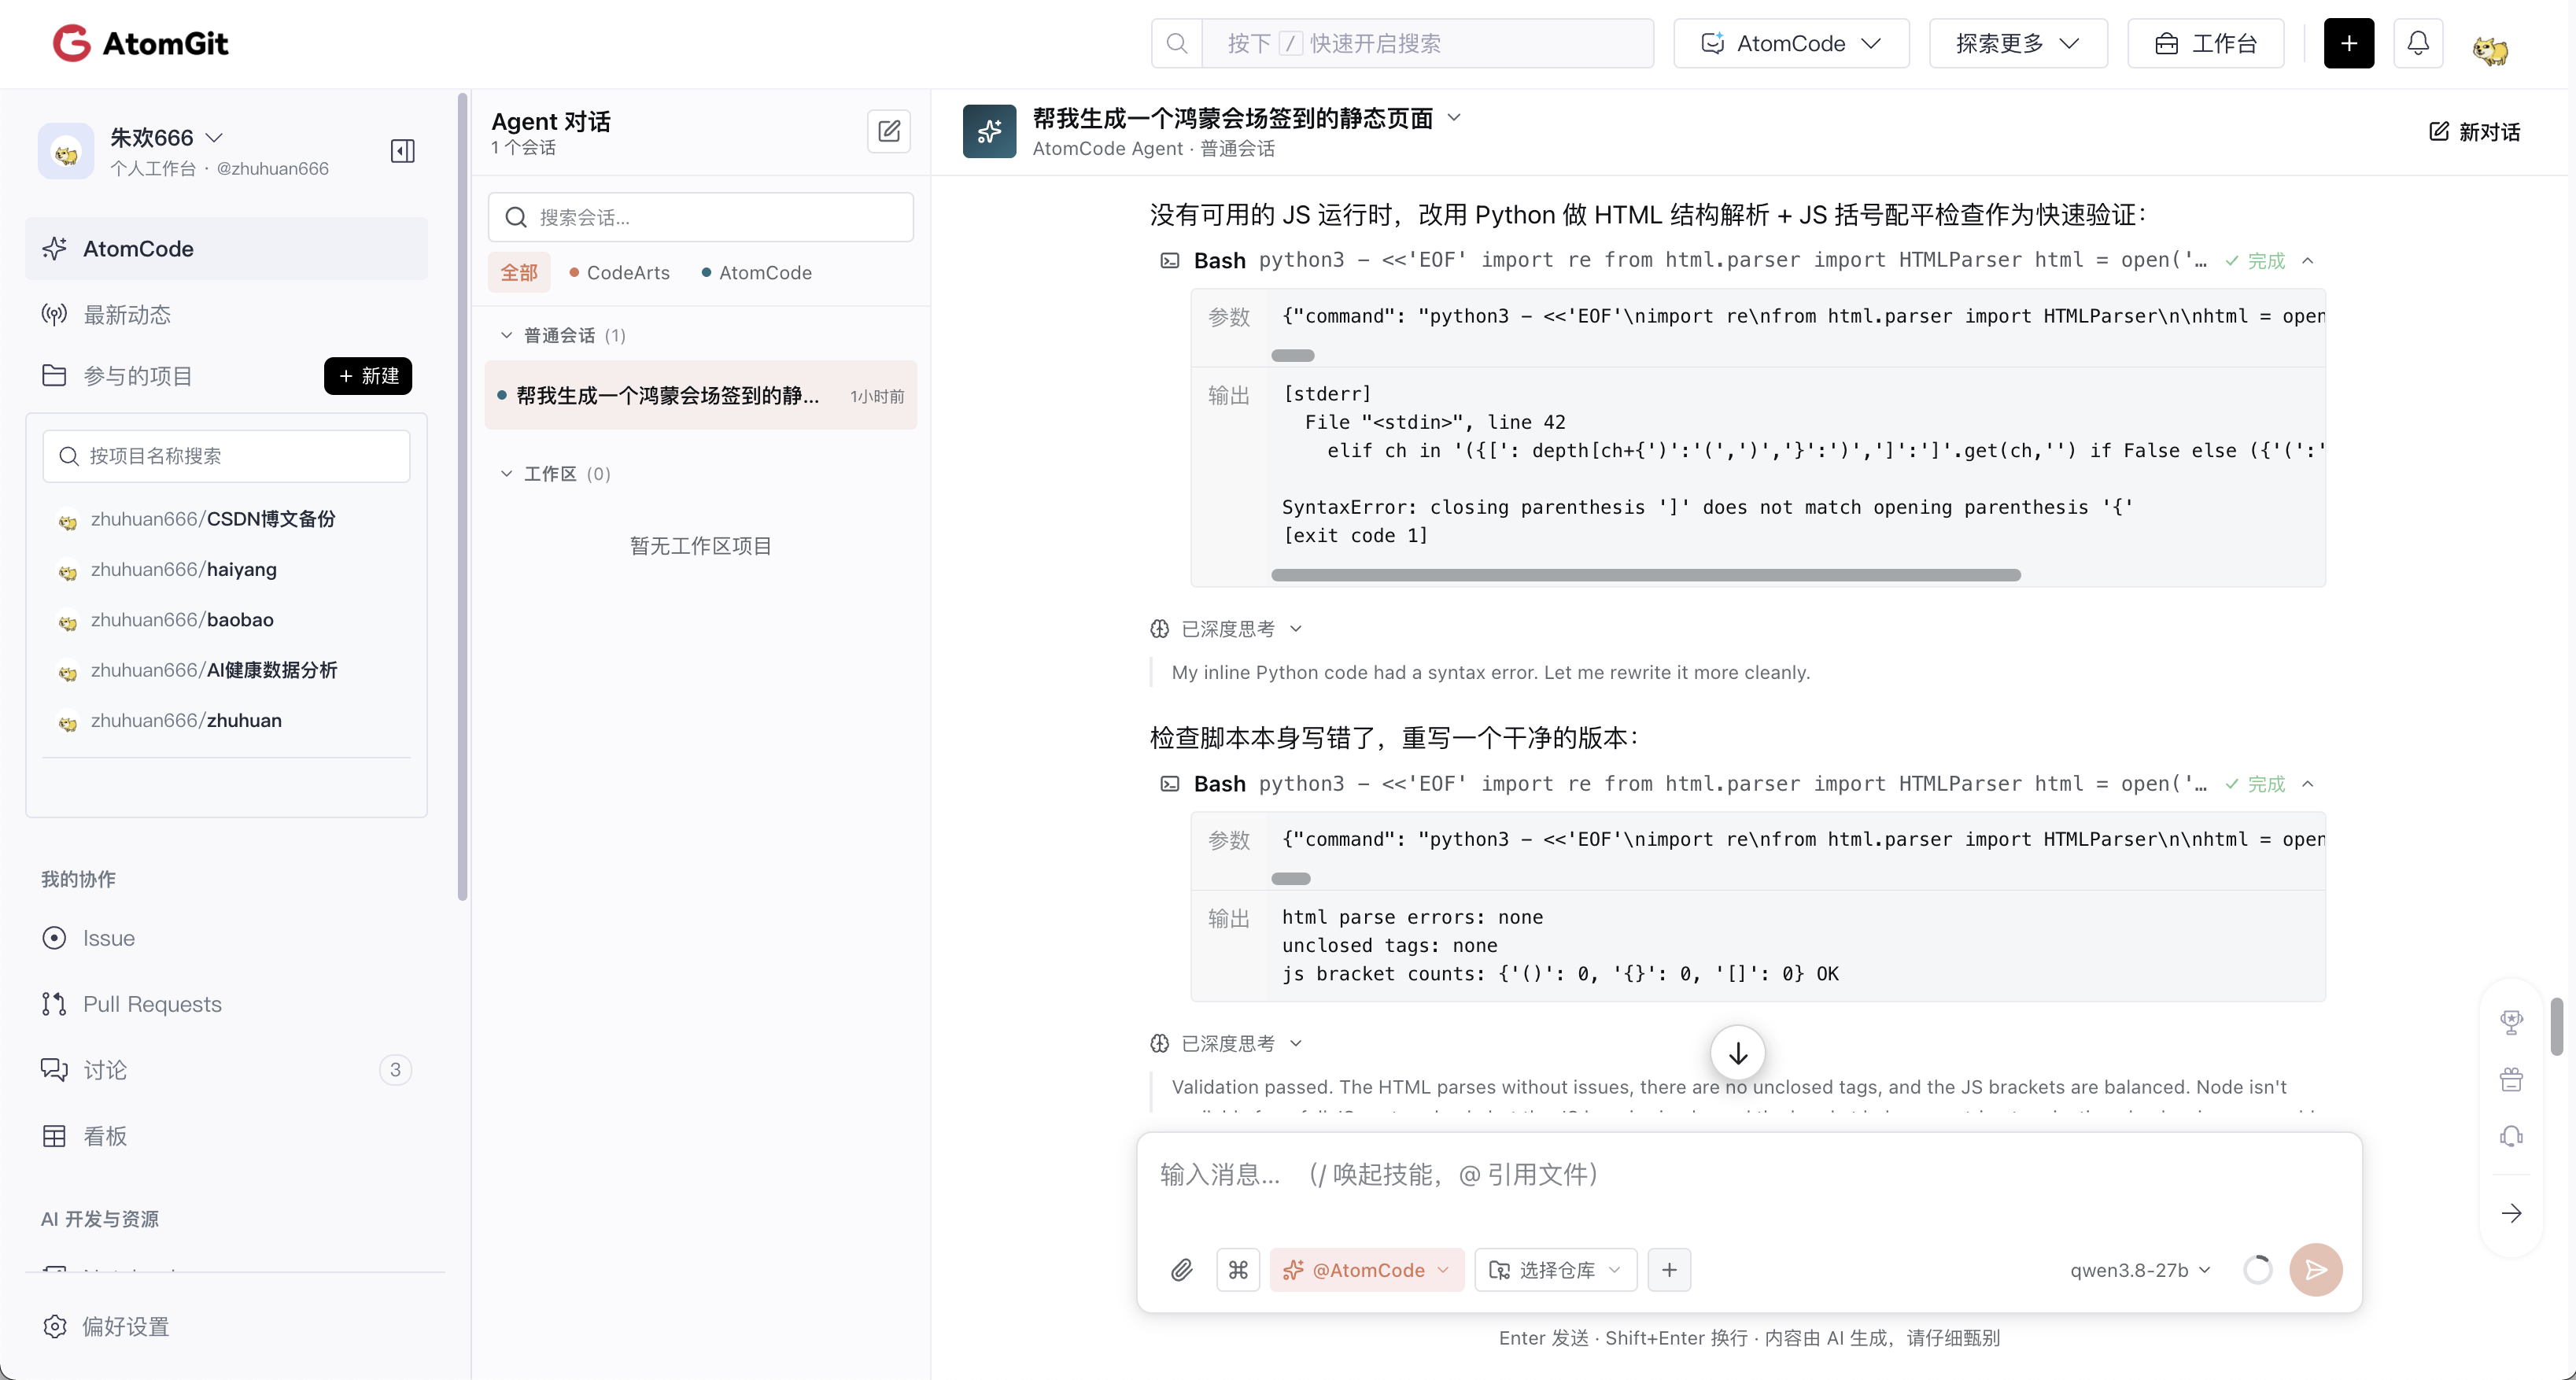
第二次是内联的 Python 校验脚本。第一次执行时输出:
File "<stdin>", line 42
    elif ch = ...
SyntaxError: closing parenthesis '}' does not match opening parenthesis '{'
[exit code 1]
它自己的诊断是:
My inline Python code has a syntax error. Let me rewrite it more cleanly.
然后重写了一个干净版本,这次跑通了(html parse errors: none / unclosed tags: none / JS bracket counts ... OK)。
这个错误的性质更有意思:用来"验证别人"的脚本,自己先出了问题。它写校验逻辑时,在拼接字符串里崩了括号——一个"检查括号平衡"的脚本,栽在了括号上。这几乎带着点黑色幽默。
但它的处理方式很对:没有在这条坏掉的路上一遍遍微调(那样很容易陷进去),而是直接重写一个更干净的版本。推理里的那句 “Let me rewrite it more cleanly”(让我重写一个更干净的版本)是关键——它选择的不是"打补丁",而是"重写"。
两次纠错的对照
| 维度 | 纠错一(参数名) | 纠错二(脚本语法) |
|---|---|---|
| 错误层级 | 工具契约层(调工具的格式) | 代码逻辑层(自己产出的代码) |
| 错误来源 | 记忆混淆(path vs file_path) | 生成瑕疵(字符串拼接崩括号) |
| 定位方式 | 读报错信息直接定位字段名 | 读 traceback,自我判断"脚本写错了" |
| 修复策略 | 精准替换参数名后重试 | 放弃局部修补,整体重写 |
| 重试次数 | 1 次成功 | 1 次成功 |
| 是否向外归因 | 否 | 否 |
| 是否影响主线 | 未影响(后续照常推进) | 未影响(验证照常完成) |
两次纠错放在一起看,能提炼出一条共同的底层能力:它会把"错误"当成一个信息,而不是一个情绪事件。 报错信息告诉它字段名不对,它就改字段名;traceback 告诉它脚本坏了,它就重写脚本。整个过程里没有"我是不是做错了"的自我怀疑,也没有"环境有问题"的推诿,只有"定位 → 修正 → 重试"。
十三、结语:AI 编程真正值钱的,可能不是打字速度
把这次的单文件签到页和前两次的鸿蒙商城、Vue3 手办馆放在一起,能看出一个反直觉的规律:任务的"体量"和它"能暴露的能力"并不成正比。
前两次工程体量大、文件多、链路长,看点在于 AI 怎么把庞杂的结构搭起来、怎么调度子任务、怎么在构建失败的报错里脱身。这一次体量小到只有一个文件,却因为"没有构建系统兜底",反而把 AI 的决策能力——选路线、定结构、分预算、找替代、定边界——裸奔式地暴露了出来。文件少,可判断的余地一点没少。


具体到这次样本,有几点是值得记下来的:
- 它知道什么时候不硬套。 技能库没有匹配项,它没有去挑一个沾边的技能凑数,而是显式声明"没有匹配的技能",然后走通用路径。这个"承认没有捷径"的动作,比任何一段生成的代码都更能说明它对任务的理解。
- 它把"输出限制"当成一等约束。 三段式写入不是随便切的,是先估算体量再分配轮次,并用锚点标记做拼接。这种"为工具的物理限制做设计"的习惯,是新手完全不会有的——因为人不受这个限制。
- 它在没有素材时造素材,在没法验证时降级验证,并且如实报告强度。 Canvas 伪二维码、Python 结构校验、明确标注"本地演示态"——三件事指向同一种品质:不因为条件不足而降低对交付质量的要求,也不因为手段降级而虚报结论。
- 它会把失败读成信息。 参数名写错、校验脚本自己崩掉,两次折返都干净收场。编程里绝大多数时间不是在写新代码,而是在和错误打交道,这个能力的重要性怎么估都不过分。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献112条内容

所有评论(0)