
Localization Kit Collator:设备编号自然排序等价键与稳定原序【鸿蒙心迹】
所有设备名称、截图、HiLog 和排序统计都是演示数据,未声称已在真实 HarmonyOS 设备、DevEco Studio 或设备资产系统完成编译及测试。
一、编号十排在编号二前面,排序没有坏,规则坏了
资产盘点界面有一个很普通的需求:把设备清单按名称排序。运营看着“设备1、设备2、设备3、设备10”的顺序觉得理所当然;程序如果直接按普通字符串比较,可能把“设备10”放到“设备2”前面。这种错位还算容易发现,真正难的是另一种情况:库里同时有“设备2”和“设备02”,两个名字既要按数字含义靠在一起,又不能把它们误认为同一台设备。
我把问题塞进 RackSort 小项目,页面叫 RackOrderPage,任务编号 RS-2807。演示只用五条导入记录,输入顺序是:R-10 设备10、R-02 设备2、R-02B 设备02、R-01 设备1、R-03 设备3。期望输出依次为 R-01、R-02、R-02B、R-03、R-10。其中“设备2”和“设备02”构成一对数字含义等价的名称,排序靠导入原序保持稳定,但业务 ID 仍然彼此独立。
在多语言设备管理里,单靠字符串的大小关系很难解释排序。汉字、拉丁字母、数字、标点混在一起,字符编码顺序并不等于用户习惯。这个案例从一次肉眼可见的错位入手,不做复杂搜索引擎,而是把“文本比较”“数字段比较”和“相等后的稳定回退”拆成三条独立规则。
二、先划清官方 Collator 与自定义自然排序的责任
华为官方本地习惯排序指南给出了 @kit.LocalizationKit 中 intl.Collator 的用法:用指定语言地区创建比较器,然后调用 compare 判断两个字符串的先后。官方示例覆盖排序用途、比较灵敏度以及中文本地化排序。这里能够直接引用的系统能力是文本片段的本地习惯比较,不是把任何数字样式、设备编码和前导零都自动按产品规则处理。
为了不依赖未经核验的数字选项,当前版本特意不声称 Collator 有某个自动识别设备编号的开关。它只负责比较非数字片段;连续阿拉伯数字则由应用层自己分词、去除用于数值比较的前导零,随后按有效数字长度与逐字符字典序比较。这样即便设备编号长到无法安全转换成 JavaScript 数值,也不需要 parseInt 和浮点运算。
还有一条容易混淆的概念:compare 返回零,只说明在当前排序规则下两段文本不分先后,不代表两条记录可以合并。真正唯一标识是一条数据附带的 id。这正是本文与“结果去重”类工程问题的区别;我们不删记录,也不更改身份,只控制屏幕显示先后。
三、把混合名称拆成数字片段与普通文字片段
先写一个独立比较器。传入“设备02”和“设备2”时,两个文本前缀由 Collator 比较为相同,数字部分都规整成“2”,最终返回零。遇到“设备10”则有效数字长度更长,排在“设备2”后面。如果数字太长,比较器仍然只处理字符串;这不是从硬件寄存器读出的数字,也不是设备通信协议。
import { intl } from '@kit.LocalizationKit';

interface RackRow {
  id: string;
  name: string;
  importOrder: number;
}

const chineseCollator: intl.Collator = new intl.Collator('zh-CN', {
  usage: 'sort', sensitivity: 'base'
});

function wordsOf(name: string): string[] {
  const tokens = name.match(/[0-9]+|[^0-9]+/g);
  return tokens === null ? [name] : tokens;
}

function decimalCompare(left: string, right: string): number {
  const a = left.replace(/^0+(?=\d)/, '');
  const b = right.replace(/^0+(?=\d)/, '');
  if (a.length !== b.length) { return a.length < b.length ? -1 : 1; }
  return a === b ? 0 : (a < b ? -1 : 1);
}

function naturalCompare(left: string, right: string): number {
  const aa = wordsOf(left);
  const bb = wordsOf(right);
  const length = Math.min(aa.length, bb.length);
  for (let i = 0; i < length; i++) {
    const aNumber = /^[0-9]+$/.test(aa[i]);
    const bNumber = /^[0-9]+$/.test(bb[i]);
    let diff = 0;
    if (aNumber && bNumber) {
      diff = decimalCompare(aa[i], bb[i]);
    } else {
      diff = chineseCollator.compare(aa[i], bb[i]);
    }
    if (diff !== 0) { return diff; }
  }
  return aa.length === bb.length ? 0 : (aa.length < bb.length ? -1 : 1);
}
这段实现刻意控制了边界:只认 ASCII 数字 0-9,暂不支持中文数字、全角数字、负号和小数。因为设备资产里的连字符往往是型号的一部分,贸然把它当负数号可能比原来的字符串顺序更糟。以后需要覆盖其他数字文字系统,可以引入明确的规范化步骤和测试数据,但不要悄悄扩大当前解析器含义。
函数内部没有文件句柄、网络连接或者订阅,因此不存在额外的释放问题。成本主要是反复分词;大量数据排序时可以把词元预先缓存,同时确保名称修改时缓存失效。若传入空名称,分词会返回空串结果,仍需要上层制定空名称置前还是置后的业务策略。
四、比较相等以后,用导入顺序保护记录身份
本地习惯比较并不是最终排序规则。我们希望同一批导入数据重复打开、刷新视图,设备排列仍然一致。给每条记录保存一个稳定的 importOrder,主比较器返回零时才用这个序号兜底;极端情况下序号重复,再回到唯一 id 做确定性比较。由此“设备2”和“设备02”的相对位置会固定,而不会随着排序引擎的内部策略变化跳来跳去。
const INPUT_ROWS: RackRow[] = [
  { id: 'R-10', name: '设备10', importOrder: 0 },
  { id: 'R-02', name: '设备2', importOrder: 1 },
  { id: 'R-02B', name: '设备02', importOrder: 2 },
  { id: 'R-01', name: '设备1', importOrder: 3 },
  { id: 'R-03', name: '设备3', importOrder: 4 }
];

function sortRackRows(input: RackRow[]): RackRow[] {
  const rows = input.slice();
  rows.sort((a: RackRow, b: RackRow): number => {
    const primary = naturalCompare(a.name, b.name);
    if (primary !== 0) { return primary; }
    if (a.importOrder !== b.importOrder) {
      return a.importOrder - b.importOrder;
    }
    return a.id < b.id ? -1 : (a.id > b.id ? 1 : 0);
  });
  return rows;
}

const ORDERED_ROWS: RackRow[] = sortRackRows(INPUT_ROWS);
// R-01, R-02, R-02B, R-03, R-10(本地逻辑期望,非真机实测)
slice 是刻意的防护:原始导入数组保留采集顺序,派生数组负责展示,两个集合不能互相污染。导入序号表示这批数据最初的稳定位置,不应在每次界面渲染时重新写成屏幕行号。否则一次刷新就可能反过来改变下次排序结果,造成无法解释的循环依赖。
如果后续合并来自不同设备的两批清单,importOrder 需要扩成稳定的批次编号加批内序号,或者先由数据层发放全局连续序号。本例明确只覆盖一个固定导入批次,不能声称已经解决跨端并发排序一致性。
五、界面只消费派生结果,不在构建阶段修改数据
接下来用 ArkUI 的 ForEach 展示结果。这里 UI 的职责非常克制:展示项目名、任务号、排序策略、五条设备以及状态 SORTED。排序在初始化阶段生成快照,build 只读它;不要为了少写一个方法,把原数组 sort 塞在 ForEach 表达式里,更不要让每次状态刷新都触发原地排序。
@Entry
@Component
struct RackOrderPage {
  @State sortedRows: RackRow[] = sortRackRows(INPUT_ROWS);
  @State status: string = 'SORTED';
  private taskId: string = 'RS-2807';

  build() {
    Column({ space: 12 }) {
      Text('RackSort · 设备自然序').fontSize(23).fontWeight(FontWeight.Bold)
      Text(`任务 ${this.taskId} · 演示`).fontSize(13).fontColor('#6B7280')
      Text('zh-CN · 数字段自然序 · 原序兜底')
      Text('条目 5 · 数字等价组 1').fontColor('#7353CF')
      ForEach(this.sortedRows, (row: RackRow) => {
        Row({ space: 16 }) {
          Text(row.id).width(92).fontColor('#7353CF')
          Text(row.name).fontSize(18)
        }.width('100%').padding(12).backgroundColor('#F5F3FB')
      }, (row: RackRow) => row.id)
      Text(`状态:${this.status}`).fontColor('#7353CF')
      Text('演示界面 · 非真实资产系统结果').fontSize(12)
    }.width('100%').padding(20)
  }
}
这里唯一的 ForEach 键是设备 id,绝不能用显示序号或名称。R-02 与 R-02B 的数字含义可以被排序比较器看作相等,但它们对应两个独立组件和两条真实业务记录。若未来给每条设备绑定“查看详情”按钮,也要用 id 导航,而不是传屏幕位置索引。
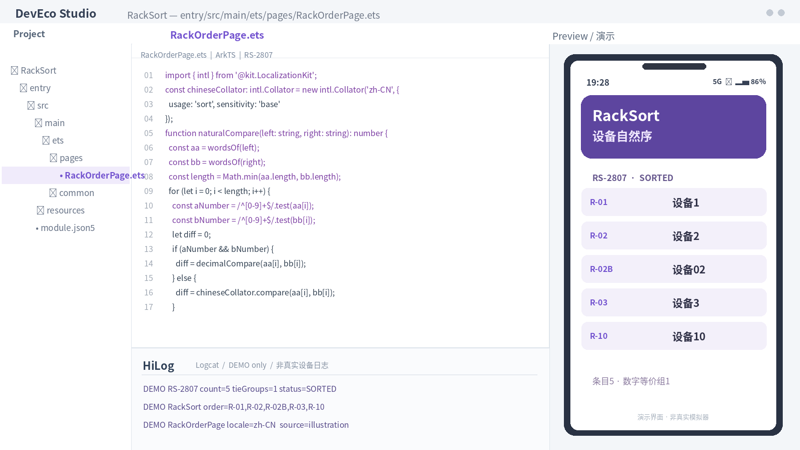
开发界面示意图把 RackOrderPage.ets 关键代码放在中部、模拟器固定在右边、底部显示一行演示 HiLog。这里不冒充实际 DevEco Studio 执行结果。排序动作并无需要退场释放的系统句柄;页面销毁时派生数组随组件退出,若产品采用外部共享缓存,应另外定义缓存的持有者与失效时机。
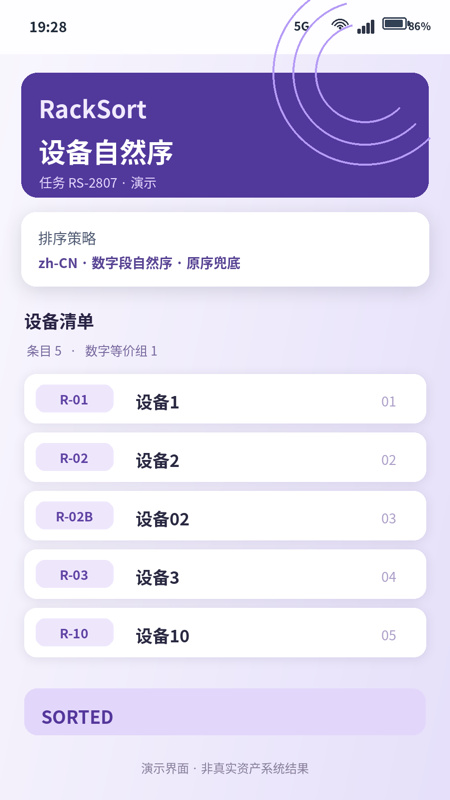
纯手机屏幕图中的五行顺序、任务号、状态、等价组个数都对应上面的确定性输入。顶部状态栏绘有完整时间、5G、Wi-Fi、信号和电量数字,它们只是图片元素。尤其要留意“数字等价组 1”并不表示数据库里存在一条重复资产,也不是系统 API 提供的去重统计。
六、用反例验证排序,不要只看五条顺眼数据
做完后最应该补的测试,是用一组数字边界去攻击比较器:设备0002 与 设备2 必须按数字值视为同级,由稳定导入序号决定先后;设备0000 和 设备0 不应因为位数多就跑到末尾。再把非常长的三十位设备号放进去,确认结果仍通过字符串长度比较,不会走浮点型数值转换。
接着测文字部分:A机2、a机2 在 sensitivity='base' 的配置下可能被视为不区分大小写的相邻名称,但不是相同业务 ID。不同语言地区的排序行为可能变化,尤其是拼音、多音字和标点的边界;把当前演示的 zh-CN 写死只为了回归可重复,实际产品应明确跟随系统语言还是跟随资产目录的固定排序约定。
第三类反例是混入非 ASCII 数字和带负号的名称。当前解析器不会把全角数字识别为数字段;这种情况应在导入规范化流程显式提示,而不是宣称 Collator 已自动修复。第四类反例是重名、空名和重复 ID:名称重复允许,ID 重复必须由数据层拒绝。第五类是改名时的二次排序,要保证导入序号不因当前显示顺序改变。
最后需要记录性能口径。对于几十条设备,这种现场解析足够展示思想;对数十万条资产,应该预先缓存词元,采用分页、虚拟列表以及异步工作线程评估,而不是凭五条演示数据宣布排序性能达到生产标准。本例未进行任何真实性能采样。
七、把“看上去正确”变成可复核的交付条目
交付时保留三份证据最有用:原始导入数组、明确写在代码里的排序规则、排序后 ID 序列。用户说“列表跳了”时,先确认输入批次和语言区域是否变化,再检查自然数值比较、等价组回退和组件 key,最后才看渲染问题。这样的调试顺序,比直接在 UI 上不断修改 sort 回调更容易定位故障。
本文的演示结论非常有限:在指定五条输入和 zh-CN 配置下,应用层算法的预期序列是 R-01、R-02、R-02B、R-03、R-10,数字等价组数量为一;不代表所有不同文字脚本都天然得到同一个顺序。官方 intl.Collator 为文字部分提供本地化比较基础,设备数字规则、等价键回退、导入身份管理都是产品代码自己的责任。
我没有把这个场景写成“一个排序 API 解决所有多语言问题”,因为实际产品往往恰好栽在省略的那个二级规则上。能把同值保留、业务身份、导入顺序和本地化比较分开,已经能让后续资产清单的错误更容易解释,也更方便写出真正有证据的测试。
八、资料与边界
- 华为官方《本地习惯排序》,核验
import { intl } from '@kit.LocalizationKit'、new intl.Collator()及compare()的使用方式:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-v5/i18n-sorting-local-V5 - 华为官方 ArkTS 简介:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/arkts-overview
- 连续 ASCII 数字段的自然序、前导零等价、
importOrder和id回退均是本文自定义业务算法,不是intl.Collator的自动数字排序或资产去重功能。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献293条内容

所有评论(0)