
ArkUI AlphabetIndexer+List:OCR校对批次空组回退与筛选定位【鸿蒙心迹】
本文的 IndexPilot、IP-1420、OCR记录、HiLog和界面数值全部是为了讲清工程边界而构造的演示样例;图片为独立绘制的技术示意图,并非 DevEco Studio 运行证据或真机测试结果。代码按照公开接口设计,仍需在目标 SDK 下编译和验证。
校对任务积压后,做一条右侧字母索引并不难。难的是用户先把列表切成“待复核”,再点击原本有内容的索引项,页面应该落在哪里。索引条显示四个分组,实际可见列表却只剩三个;此时索引值和列表行号已经不是同一回事。如果开发者把字母索引的 index 直接交给 scrollToIndex,跳到错误记录几乎是必然的。
这次用一个小项目 IndexPilot 拆开这个问题。它不是 OCR 识别引擎,而是 OCR 之后的人工复核工作台。任务 IP-1420 使用七条固定样例,界面为 ReviewIndexPage,过滤条件“待复核”;分组为 A/B/C/D,数量分别是 2/0/3/2。用户点击空的 B 组,业务层按“向后寻找,末尾回绕”规则转到 C 组第一项,对应真实列表索引 2,也就是第 3 条。
一、先明确索引条不保存行号
1. 同样是 index,其实指向两套不同坐标
AlphabetIndexer 的 onSelect 回调给出的是索引条条目下标,并非 List 的可视元素下标。例如 A、B、C、D 是索引条的第 0~3 项;筛选后的列表则是 A-011、A-014、C-021、C-026、C-031、D-008、D-013。索引条的 B=1,不能解释成列表第 2 条,因为 B 的候选集合当前为空。即使两个数字碰巧相同,意义也完全不同。
工程里还会有第三种身份:记录的稳定 ID。删除、修改筛选规则或重新加载后,行号可能变化,C-026 这样的 ID 仍然指向同一条复核记录。本文因此把“请求分组”“实际落点”和“记录身份”分成三个字段处理,不把它们塞进同一个 selectedIndex。
索引侧的规则也要提前写清:当命中空组,优先搜索其后最近的非空组;如果后面都为空,再从头回绕;所有组都没有结果时返回空状态,不能把 0 当成有效的默认行。这个业务规则不是 ArkUI 组件自行提供的能力,而是我们为工作台定义的导航策略。
二、把落点决策写成可验证的纯函数
我们首先解决“B 无内容时究竟跳到哪里”。以下代码放在 IndexPlan.ets,输入是一份已经筛选完毕的记录数组。组件回调只消费计划,不在渲染循环里猜测记录位置。
interface ReviewItem {
  id: string;
  group: string;
  title: string;
}
interface JumpPlan {
  requested: string;
  actual: string;
  rowIndex: number;
  redirected: boolean;
}

export function planJump(rows: ReviewItem[], keys: string[], selected: number): JumpPlan | null {
  if (selected < 0 || selected >= keys.length || rows.length === 0) return null;
  for (let offset = 0; offset < keys.length; offset++) {
    const target = keys[(selected + offset) % keys.length];
    const rowIndex = rows.findIndex((item: ReviewItem) => item.group === target);
    if (rowIndex >= 0) {
      return { requested: keys[selected], actual: target,
        rowIndex, redirected: offset !== 0 };
    }
  }
  return null;
}
findIndex 在这里取得的是当前筛选视图中的首条记录位置;它不能被缓存成永久行号。当前示例调用 planJump(rows, ['A','B','C','D'], 1),结果是 requested=B、actual=C、rowIndex=2。当 B 恢复有数据时,路径自然变成 B 的首条,不必再给 B 写特殊分支。
这个函数不承担数据库查询,不关心 OCR 精度,也不负责滚动动画;因此可以在不启动页面的条件下,对空列表、全空组、仅 D 非空、首尾回绕等边界编写单元测试。尤其要注意 null 与索引 0 的区别,前者表示无目标,后者可能是合法的第一条记录。
三、让 AlphabetIndexer 只发起导航意图
页面中同时渲染索引条和 List,但只使用一个 Scroller 控制列表。ForEach 的 key 使用稳定记录 ID;这不是为了好看,而是为了筛选后不把旧单元格的局部状态错误地复用到另一条记录上。下面是 ReviewIndexPage.ets 的核心视图片段,数组在示例里固定为七条演示记录。
@Entry
@Component
struct ReviewIndexPage {
  private readonly keys: string[] = ['A', 'B', 'C', 'D'];
  private readonly listScroller: Scroller = new Scroller();
  @State private rows: ReviewItem[] = [
    { id: 'A-011', group: 'A', title: '发票抬头' },
    { id: 'A-014', group: 'A', title: '收款编号' },
    { id: 'C-021', group: 'C', title: '合同页码' },
    { id: 'C-026', group: 'C', title: '合同日期' },
    { id: 'C-031', group: 'C', title: '合同附件' },
    { id: 'D-008', group: 'D', title: '对账签章' },
    { id: 'D-013', group: 'D', title: '对账总额' }
  ];
  @State private selectedGroup: number = 2;
  @State private tip: string = '待复核 7 条 · 当前 C';

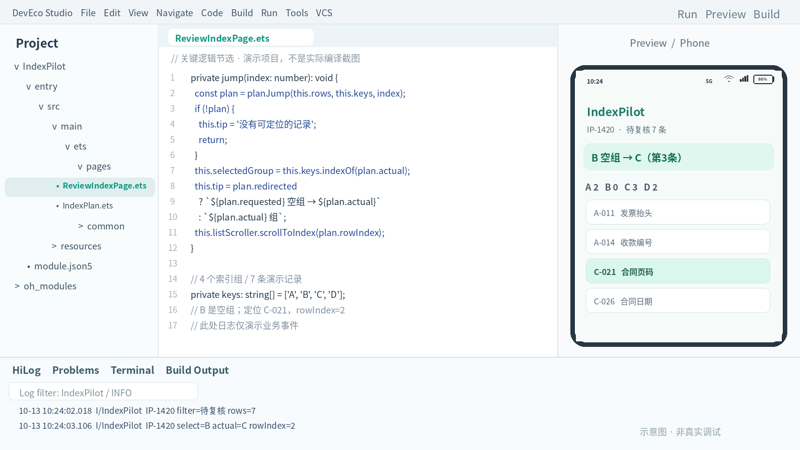
  private jump(index: number): void {
    const plan = planJump(this.rows, this.keys, index);
    if (!plan) { this.tip = '没有可定位的记录'; return; }
    this.selectedGroup = this.keys.indexOf(plan.actual);
    this.tip = plan.redirected ? `${plan.requested} 空组 → ${plan.actual}(第${plan.rowIndex + 1}条)`
      : `${plan.actual} 组 · 第${plan.rowIndex + 1}条`;
    this.listScroller.scrollToIndex(plan.rowIndex);
  }
  build() {
    Column({ space: 12 }) {
      Text('IndexPilot · IP-1420').fontSize(20).fontWeight(FontWeight.Bold)
      Text(this.tip).fontSize(14)
      Row() {
        List({ scroller: this.listScroller, space: 8 }) {
          ForEach(this.rows, (item: ReviewItem) => {
            ListItem() { Text(`${item.id}  ${item.title}`).padding(14) }
          }, (item: ReviewItem) => item.id)
        }.layoutWeight(1)
        AlphabetIndexer({ arrayValue: this.keys, selected: this.selectedGroup })
          .onSelect((index: number) => this.jump(index))
          .usingPopup(false)
      }.layoutWeight(1)
    }.padding(16)
  }
}
onSelect 是索引选择事件,Scroller.scrollToIndex 是列表定位控制;二者的连接是业务函数 planJump,而不是任何内建的“按字母排序”。代码假设 rows 已按 A、C、D 排好序;如果底层结果乱序,首项仍能找到,但“跳到分组开头”的视觉效果会不稳定。正式项目应让分组顺序与排序规则由同一份映射产生。
四、筛选切换之后,旧下标必须作废
同一页还要处理另一条时间线:用户从“全部”切换到“待复核”,组件树会重建可视项目。如果恰好有一个旧的定时定位回调,不能在数据更新后拿着旧的行号继续滚动。这里不需要假装 scrollToIndex 可以自动感知业务版本,而要用一个单调递增的代际令牌保护延后执行的动作。
对于在状态更新后需要重新定位的情形,以下方法可放到页面结构体中。timerId 是业务延迟调度句柄,viewEpoch 标记本次列表快照;定时器只作为演示安排布局后动作的方法,正式工程要结合目标版本的布局回调核验时机,不能把 0 毫秒等同于“已完成布局”。
private viewEpoch: number = 0;
private timerId: number = -1;
private alive: boolean = true;

private scheduleAfterFilter(nextRows: ReviewItem[], requested: number): void {
  this.rows = nextRows;
  const epoch = ++this.viewEpoch;
  const plan = planJump(nextRows, this.keys, requested);
  if (this.timerId >= 0) clearTimeout(this.timerId);
  if (!plan) { this.tip = '筛选后无记录'; return; }
  this.selectedGroup = this.keys.indexOf(plan.actual);
  this.timerId = setTimeout(() => {
    if (!this.alive || epoch !== this.viewEpoch) return;
    this.listScroller.scrollToIndex(plan.rowIndex);
  }, 0);
}

aboutToAppear(): void { this.alive = true; }
aboutToDisappear(): void {
  this.alive = false;
  this.viewEpoch++;
  if (this.timerId >= 0) clearTimeout(this.timerId);
  this.timerId = -1;
}
这段只展示筛选后的定位防护,不替应用引入真实 OCR 服务。需要集成时,筛选和排序要先完成,再把不可变的新数组传给 scheduleAfterFilter。页面退出时令牌作废并清理定时器;页面恢复后只恢复可解释的分组身份,不恢复上一版的裸行号。setTimeout 并非新的 ArkUI 定位 API,可能受事件循环与渲染调度影响,这是示例必须保留的边界。
五、让屏幕上能解释每一次跳转
示意界面设定为 10:24,状态栏含 5G、Wi-Fi、信号和电量 86%。任务始终写 IP-1420;顶部展示“待复核 7 条”,分组统计是 A 2 / B 0 / C 3 / D 2。点击 B 后,提示区显示 “B 空组 → C(第3条)”,列表向 C-021 定位。HiLog 示意文本统一为 IP-1420 select=B actual=C rowIndex=2,它只是配图的解释性日志,不是机器实际输出。
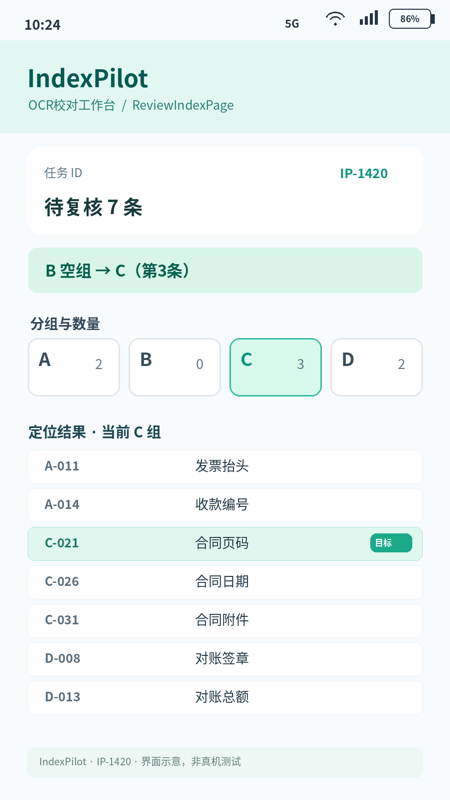
我更在意这个提示的可解释性。直接把高亮从 B 跳到 C,用户可能以为手势误触;明确告诉他 B 当前没有待复核记录,页面才不会显得“偶尔失灵”。不过提示不应永久悬浮,下一次索引选择、筛选条件变化或任务退出时,都需要把它替换成最新的导航结果。
六、验收边界别只检查“能滚动”
可以先构造五组输入做桌面级业务逻辑验证:B 为空但 C 有记录;B、C 都为空而 D 有记录;只有 A 有记录;全部为空;筛选后列表从七条缩减到两条。前四项验证回退规则,第五项验证旧 rowIndex=2 不能在新列表里误用。这里的测试计划是建议的验收用例,本文没有宣称它们已在 DevEco 或真机上跑过。
还需要考虑辅助功能。索引条条目和实际定位的分组可能不一致,若产品面向屏幕朗读用户,应提供状态提示的可访问语义;这是额外验收任务,而不是 onSelect 自动保证的效果。对于大列表,ForEach 的完整创建成本也值得单独评估,可在稳定 ID 的前提下进一步讨论懒加载数据源,不能把当前七条演示的表现直接推到上千条。
最终这个工程问题的关键不是找一个更复杂的滚动参数,而是给不同的“索引”取不同名字:字母条下标决定用户意图,列表行号决定滚动位置,记录 ID 保证条目身份。三者分开,空组、筛选、刷新、页面退出才各有明确的处理位置。
官方接口参考: AlphabetIndexer、List 与 Scroller。本文示例为业务设计稿,代码未经过目标 SDK 编译。
七、把分组映射留在领域层,而不是页面里
上线后最容易出现的退化,是另一个页面也需要跳转 A/B/C/D,于是直接复制一段 onSelect。复制时往往顺手复制了行号约定,却没有复制过滤规则,最后两个页面的同一个字母落在不同位置。更合理的扩展是让数据层输出排序后的可见记录和分组起点表,页面只调用导航计划;后续即使从 OCR 批次扩展到合同、发票或质检异常组,也无需改变容器组件。
日志建议同时记录 requested、actual、rowIndex、筛选版本和记录 ID,但不要把原始 OCR 文本、证件号码写进 HiLog。问题发生时,开发者需要知道“为何回退”,不需要复制用户的扫描内容。长列表滚动前还应再次检查目标行是否仍然属于当前快照;如果数据源可以在一帧内再次更新,单纯的计时器令牌还不够,必须由数据层给出同一版本的定位结果。
这个拆分看似多出一个 JumpPlan,却让异常处理的位置非常明确。它允许界面设计调整、列表虚拟化或新的筛选入口逐步引入,而不用改写一套难以复核的下标补丁。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献288条内容

所有评论(0)