
TaskPool:文搜图离线标签批次背压与过期结果丢弃【鸿蒙心迹】
做文搜图时,我最担心的并不是某一张照片处理慢,而是用户已经切换了搜索范围,上一批图片的标签结果却在几秒后回来,悄悄覆盖了新页面。尤其在折叠屏图库里,搜索条件、相册筛选、页面可见性都可能连续变化;只盯着一个“处理中”的布尔值,很容易把业务版本与线程任务混在一起。
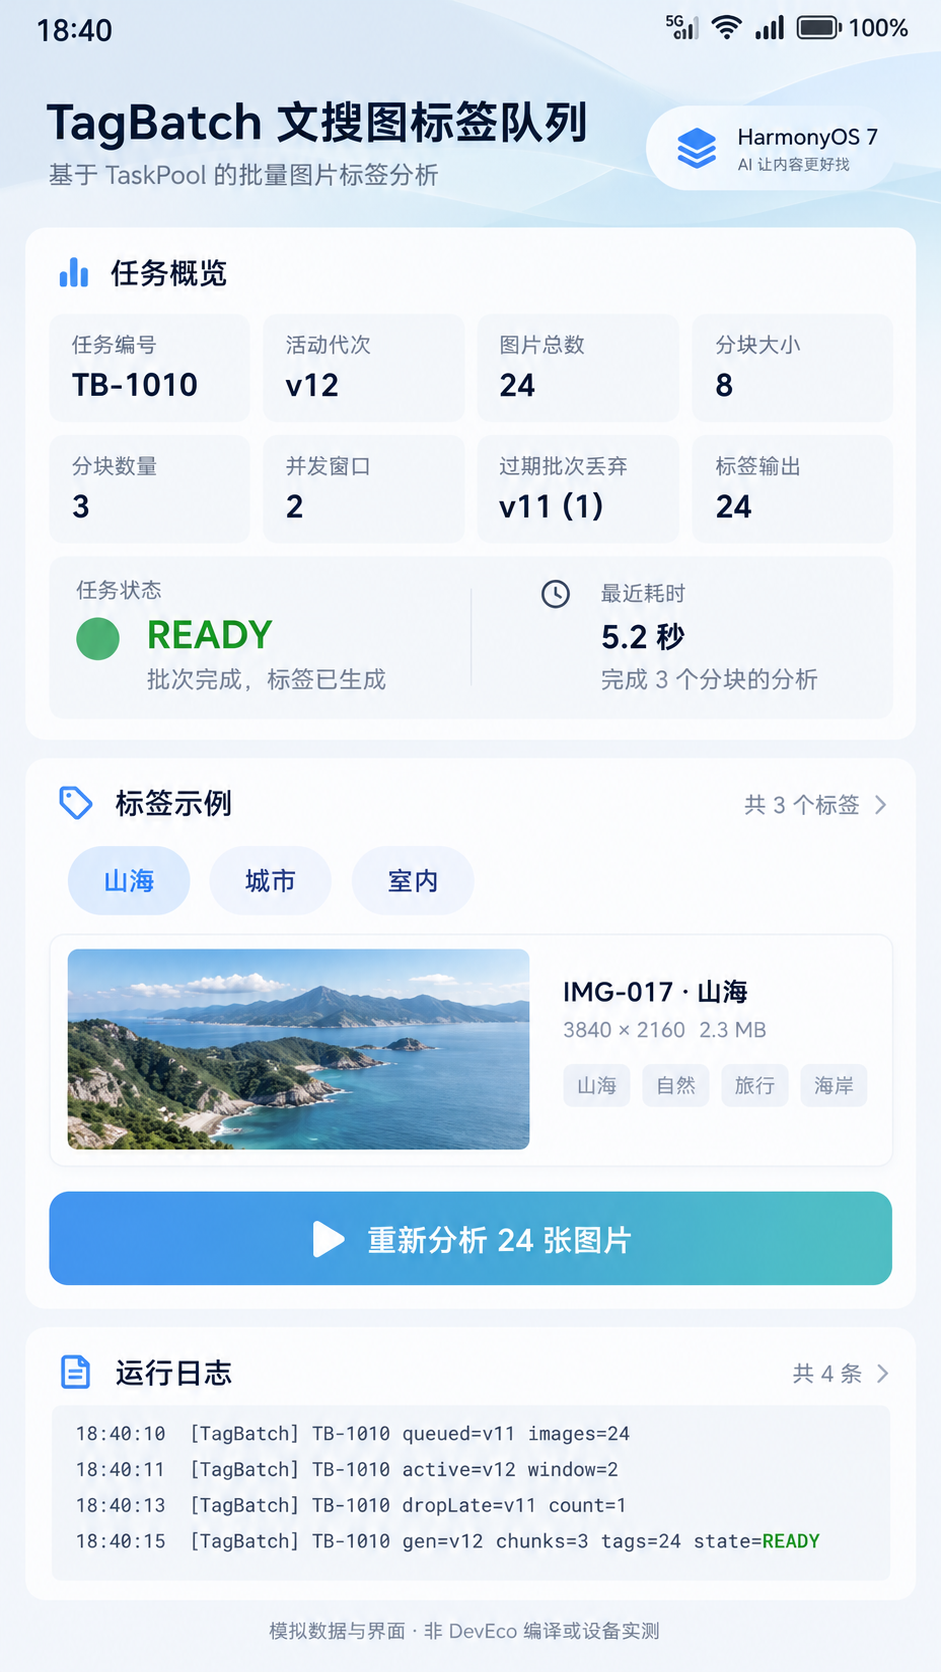
这次用一个小型的 TagBatch 演示,把问题缩到能够说明白的程度:任务编号 TB-1010,输入24张图片的文件名元数据,每8条作为一个分块,应用侧最多同时派出2个分块。用户从旧代次 v11 切换到 v12 后,旧代次迟到的1份结果应丢弃;新代次3个分块全部返回,才允许展示24条标签,界面状态为 READY。这些是预先设计的演示输入与状态,不是设备测得的吞吐量,也不是系统提供的文搜图识别模型。
一、先分开三件事:算标签、排队、决定结果是否生效
第一件事是纯计算。这里故意不用所谓“AI识图接口”冒充真实识别,只根据文件名中的 coast、city、room 标记形成“山海、城市、室内”三类标签。真实项目中,这一层才可能换成本地推理的文本或图像特征提取,但必须重新评估模型线程安全性、输入序列化成本及设备负载。
第二件事是派发策略。24份输入可以切成3块,却不代表应该一口气派发3个Task。TaskPool维护自己的线程池,应用的限流窗口则控制我方同时提交并等待的工作数;把窗口设为2属于当前Demo的业务选择,不能写成HarmonyOS规定的固定并发上限。
第三件事是结果提交。TaskPool返回Promise,只说明某次计算返回了值,不能说明用户还希望看它。结果归属于哪一轮搜索,要由主线程保存的业务代次决定。把这三层隔开,才谈得上取消按钮、筛选切换和页面销毁。
二、工作函数只处理可序列化快照
下面这段代码解决的是“让子线程拿到最小必要数据”。输入只有字符串数组,不传ArkUI组件、PixelMap、数据库连接对象,也不让并发函数直接修改@State。函数中没有网络请求或文件读写,因此不存在需要替它维护的监听器和句柄。
import { taskpool } from '@kit.ArkTS';

@Concurrent
function deriveTags(names: string[]): string[] {
  let result: string[] = [];
  for (let name of names) {
    if (name.includes('coast')) {
      result.push('山海');
    } else if (name.includes('city')) {
      result.push('城市');
    } else if (name.includes('room')) {
      result.push('室内');
    } else {
      result.push('待补充');
    }
  }
  return result;
}
@Concurrent函数保持顶层定义,避免捕获页面实例;TaskPool任务使用值快照,并不共享当前页面随时变化的筛选条件。函数体依赖的内容越少,排查序列化失败越直接。实际标签模型可能需要字节缓冲、词典或专门的推理会话,那时不能机械地把整个ViewModel传入子线程。华为TaskPool使用规范特别提醒了UI装饰器间接依赖、参数序列化和过度派发的风险。
三、两个消费槽位组成业务背压
下一段把“并发窗口2”和“批次代次”写到同一处。cursor只在调用这段函数的主线程推进,每个消费槽位拿到一个序号再等待TaskPool完成;结果放回原序号,避免先完成的第3块排到第1块前面。这里没有调用任何未经核对的TaskPool取消API,而是采用迟到结果无效化。
class TagBatchQueue {
  private epoch: number = 11;
  private readonly chunkSize: number = 8;

  invalidate(): void { this.epoch++; }

  async analyze(names: string[]): Promise<string[]> {
    const mine: number = ++this.epoch;
    let chunks: string[][] = [];
    for (let i = 0; i < names.length; i += this.chunkSize) {
      chunks.push(names.slice(i, i + this.chunkSize));
    }
    let cursor: number = 0;
    let slots: string[][] = new Array<string[]>(chunks.length);

    const consume = async (): Promise<void> => {
      while (cursor < chunks.length && mine === this.epoch) {
        const index: number = cursor++;
        const task: taskpool.Task = new taskpool.Task(deriveTags, chunks[index]);
        const value = await taskpool.execute(task) as string[];
        if (mine !== this.epoch) return; // 旧代次结果禁止回写
        slots[index] = value;
      }
    };
    await Promise.all([consume(), consume()]); // Demo并发窗口=2
    if (mine !== this.epoch) return [];
    let output: string[] = [];
    for (let part of slots) output.push(...part);
    return output;
  }
}
这不是系统底层的“硬取消”。一个Task已经开始执行时,即便页面立刻切了代次,它仍可能占着工作线程直到结束;mine !== epoch只保证返回后的UI或业务缓存不接收旧值。因此不要在文案里写“旧任务已经物理停止”,更不要把忽略结果等同于节电成功。对于持续运行的推理,应另外设计真正可响应的任务取消协议和资源释放点。
还有一个不能忽略的失败路径:两个消费槽位任一抛异常,Promise.all会拒绝,但另一个槽位可能仍在执行。调用方应将本代次标为失败并推进代次,防止另一个迟到成功结果引起半成品提交。只有全部分块完整返回、数量与输入一致,才把结果一次性赋给可观察状态。若标签还有图片ID映射,提交前应按imageId再做一轮校验,而不是只靠位置下标。
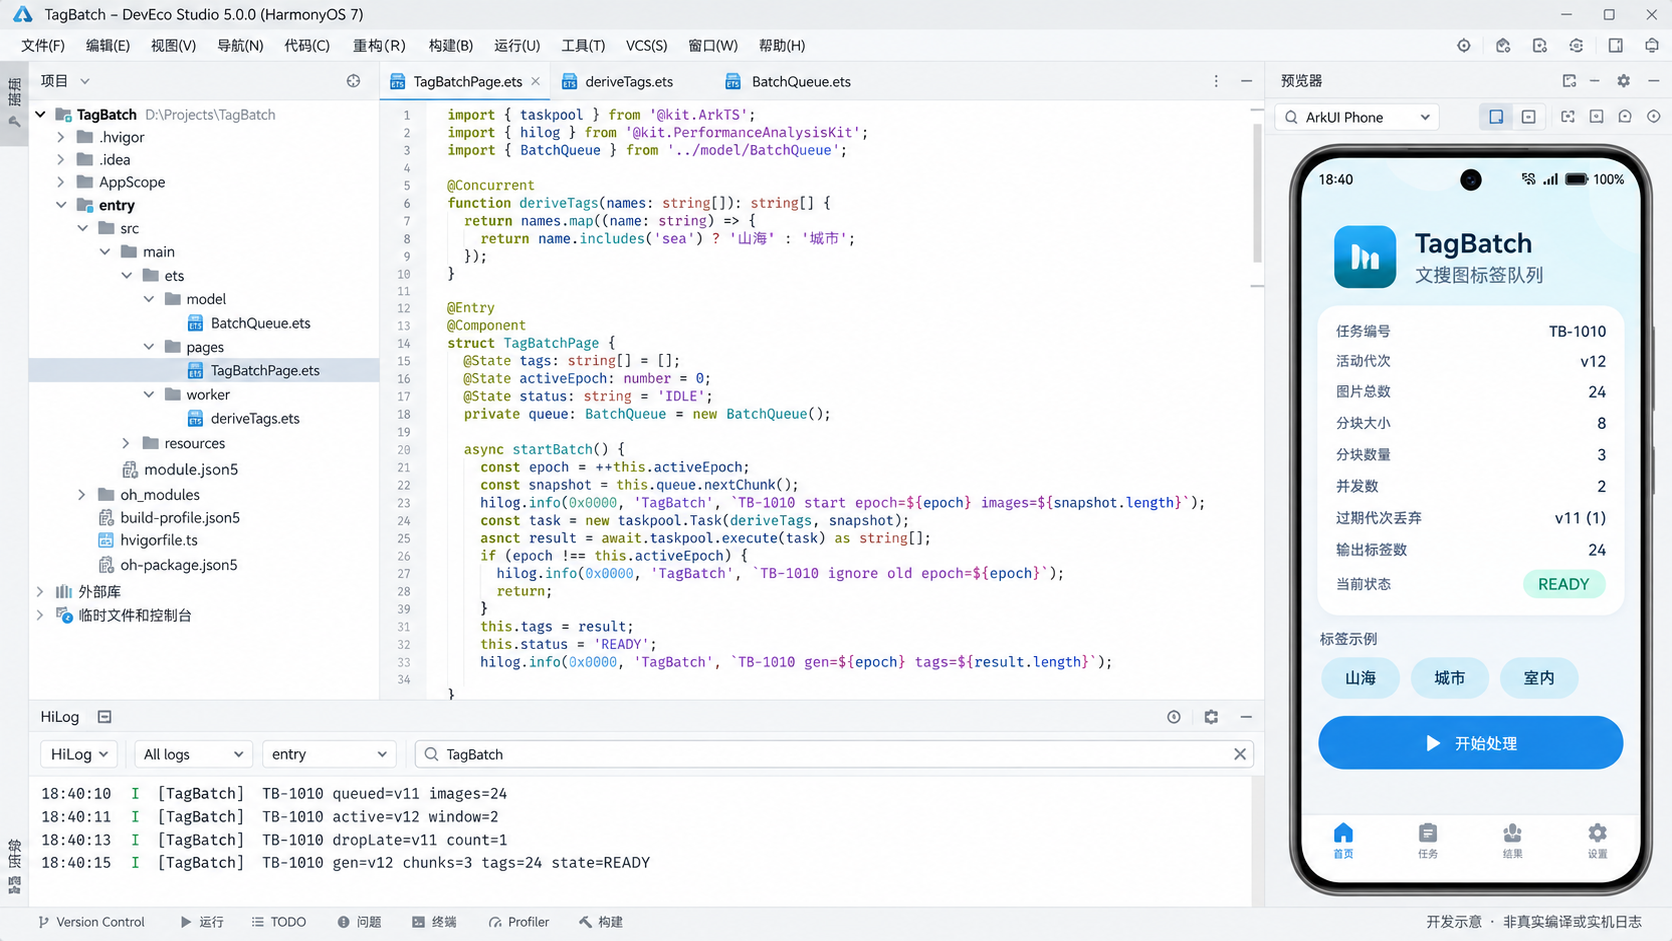
四、页面生命周期决定谁还能写状态
实际页面里我会把状态提交权再锁一层。哪怕协调器已经做了代次检查,页面也可能被销毁或复用。下段只展示页面边界代码,列表渲染和文件名获取由调用层提供;这里用 uiRevision 避免退出后的Promise继续修改旧页面。
@Entry
@Component
struct TagBatchPage {
  @State status: string = 'IDLE';
  @State tagCount: number = 0;
  private queue: TagBatchQueue = new TagBatchQueue();
  private uiRevision: number = 0;

  async submit(names: string[]): Promise<void> {
    const revision: number = ++this.uiRevision;
    this.status = 'RUNNING';
    try {
      const tags: string[] = await this.queue.analyze(names);
      if (revision !== this.uiRevision) return;
      this.tagCount = tags.length;
      this.status = tags.length === names.length ? 'READY' : 'FAILED';
    } catch (e) {
      if (revision !== this.uiRevision) return;
      this.queue.invalidate();
      this.status = 'FAILED';
    }
  }
  aboutToDisappear(): void {
    ++this.uiRevision;
    this.queue.invalidate();
  }
  build() {
    Column({ space: 12 }) {
      Text(`TagBatch · ${this.status}`)
      Text(`标签输出:${this.tagCount}`)
    }
  }
}
这里aboutToDisappear不是全局任务管理器:应用转后台、Ability重建、异步回调顺序等情况各有边界,不能想当然全部交给页面钩子处理。如果业务要求后台继续批处理,应把结果存入独立仓库,使用完整的任务ID与代次协商,再由新页面订阅最终快照;不要把一个被销毁页面当作后台调度中心。
五、按演示账本验收,而不是拿一张完成图当证据
本轮设计账本刻意固定为四条事件:18:40:10旧代次v11开始排队,24张图;18:40:11切换到v12,窗口为2;18:40:13丢弃1份v11迟到回包;18:40:15当前v12的3个分块汇齐,共24条标签,状态READY。IMG-017展示为“山海”,只是文件名元数据规则在样例数据上的效果。界面上的时间和数字用于对齐故事,不代表实测耗时或真实识图准确率。
还有一个复盘点是缓存提交的原子性。假设第一个分块返回8条、第二个返回8条、最后一个仍在运行,页面不要先把16条推入全局文搜图索引;否则用户在等待期间再次搜索,可能读到新旧标签混合的半成品。更稳的方案是先在本代次的临时数组中收齐,并对24个输入ID逐一核对,再以一次业务提交替换展示快照。若这时用户删除了某张照片,缺失ID应形成可诊断的冲突记录,不能硬凑24条。这个规则属于业务一致性协议,不能指望TaskPool替我们解决。
验收至少安排四组反例。连续切换两次筛选时,较旧的结果不能覆盖最新结果;处理到一半切走页面时,旧页面不再收到状态;一个分块抛异常时,全批次不能伪装成READY;输入中存在重名照片时,结果归属仍应使用稳定ID而不是数组位置。还有一种容易忽略的情况:一次只处理3张小图,派线程成本可能高于直接在主线程做轻量字符串分类,不能把TaskPool当作无条件的性能优化。
发布前还应该看一眼结果的可追踪性。每个分块最好附上TB-1010、代次、起止图片ID和原始输入数量,日志不能只写“worker success”。否则线上遇到重复结果时,很难区分是输入列表变了、序列化后的顺序变了,还是旧Promise后来居上。日志里不建议打印用户原图路径、完整搜索记录等隐私数据,保留经过脱敏的业务ID和状态即可。
背压还需要对两种极端保持敏感:用户快速连续触发时,旧任务占着线程,新任务未必马上得到执行机会;相册只有少量文件时,多线程派发本身又可能不划算。因此应用可设置一个很小的直算阈值,并在真正设备上记录队列等待、子任务耗时、UI回调耗时三段指标,分别对比,而不是只看一个“总共几毫秒”的数字。当前示意没有这些测量,不能做任何快慢排名。
文搜图真正难的地方,经常不是“如何开三个线程”,而是“哪一份结果有资格成为当前结果”。这个Demo留下的是一个可检查的契约:业务代次管有效性、双消费槽位管峰值、TaskPool只管纯计算,失败时不提交半批数据。等真实识别模型接入,再单独补序列化、内存峰值、离屏恢复与设备性能数据,工程结论才站得稳。
技术资料:华为开发者文档《TaskPool使用规范》(2026-09-14)https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/task-pool-usage-guidelines ;《同步任务开发指导(TaskPool和Worker)》(2026-08-03)https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/sync-task-development 。本文实现为设计样例,未执行DevEco编译或HarmonyOS实机测试。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)