
Localization Kit:隐私文案占位符漂移与上架门禁【鸿蒙心迹】
一次应用版本提测前,最容易被忽略的常常不是主页面的视觉问题,而是用户只在特定语言环境下才会碰到的隐私说明。中文写着“导出%s个文件到本地”,英文保留了%s,阿拉伯语译文却少了参数。页面默认展示未必立刻报错,但运行时格式化文案可能与产品预期不同,甚至让关键操作的对象数量不再明确。
我把这个问题缩成一个不依赖真实应用市场账号的工具:LocaleGuard。任务LG-1010检查zh_CN、en_US、ar_SA三套资源,每套16个业务键,共48个值。唯一差异出现在阿拉伯语的privacy_export_notice,译文漏了%s;内部发布门禁给出HOLD。这里的HOLD完全是开发者定义的预检状态,不是AppGallery Connect审核结论,更不是官方自动拒审规则。
一、版本和翻译都可能正确,变量签名仍可能错
做多语言文案,很多团队会要求“翻译一字不漏”,却忘了资源中还带着可替换参数。日期、文件数、商品名这些内容不该在各语言里拼字符串,应该把句子交给资源系统按语言取值。华为Localization Kit的本地化指南明确建议将文案与业务逻辑分离,并使用资源占位符代替简单拼接。
但这里有个容易混淆的边界:语言资源自动匹配负责根据设备偏好找到合适的文本;占位符等价性则是发布团队自己要额外核对的质量要求。前者是框架能力,后者是我们的静态工具,不要把二者写成同一个系统API。
Demo只检查同名键的%s、%d数量与类型。比如中文句子需要1个字符串型变量,英文仍要1个,而阿拉伯语不能变成0个。翻译顺序允许改变,但参数个数与类型不应凭空消失;如果产品确实决定删除某个参数,应同步修改调用处并升级资源基准,而不是在发布脚本中单独放过一种语言。
二、先把资源样本和业务口径固定
演示工程的目录采用HarmonyOS常见资源形式:entry/src/main/resources/base/element/string.json,再提供en_US/element/string.json和ar_SA/element/string.json。以下片段是三份文件中同一个键的缩写表示;整个演示检查集为每套16键,其他15键在本地造数中保持一致。
// 三份独立string.json中的同名项,以下仅为阅读时并排展示
// zh_CN(base): {"name":"privacy_export_notice","value":"导出%s个文件到本地?"}
// en_US:       {"name":"privacy_export_notice","value":"Export %s files locally?"}
// ar_SA:       {"name":"privacy_export_notice","value":"هل تريد تصدير الملفات محليًا؟"}
这段带注释的片段不是可以直接保存的JSON文件,而是为了看清差异:真实string.json的顶层应是{"string":[{"name":"...","value":"..."}]}这样的结构,JSON正文不能包含注释。检查工具读实际文件时必须按照真实结构解析,不能使用正则直接扫描整份JSON文本,否则注释、键名和转义都会影响统计。
另外,ar_SA展示的是一种演示性译文,并未经过母语校对。静态检查能指出变量缺失,却判断不了阿拉伯语语义、从右到左排版或隐私告知是否充分;这些验收仍需要本地化与法务/产品团队参与。
三、把扫描规则限定清楚,才谈得上低误报
下面是核心的Node.js辅助脚本函数,使用标准fs/promises,并非调用虚构的Localization Kit扫描SDK。读取时要求每项同时具备字符串name与value,遇到重复键直接抛错。默认资源一旦本身不完整,不应继续给其他语言打出“无问题”的报告。
import { readFile } from 'node:fs/promises';

async function readTable(file) {
  const data = JSON.parse(await readFile(file, 'utf8'));
  if (!Array.isArray(data.string)) throw new Error('bad string.json');
  const table = new Map();
  for (const row of data.string) {
    if (typeof row.name !== 'string' || typeof row.value !== 'string') {
      throw new Error('invalid row');
    }
    if (table.has(row.name)) throw new Error(`duplicate key: ${row.name}`);
    table.set(row.name, row.value);
  }
  return table;
}

function signature(value) {
  // 此Demo仅处理 %s、%d,先去掉转义字面量 %%
  const tokens = value.replaceAll('%%', '').match(/%[sd]/g) ?? [];
  return tokens.sort().join('|');
}
我不建议把这个简化的signature函数包装成“支持任意国际化格式”。位置参数、复数、复杂转义或带精度的格式标记在真实项目里需要更完备的解析器,不能用/%[sd]/g草率消化。正确做法是先声明当前规则接受哪些格式,发现未覆盖的模式就标记为待人工检查;这样比把不认识的占位符悄悄当作普通文字更安全。
对某些文案,译文即使保留了同样数量的%s,含义也可能错。例如将“取消”译成“确定”,这项静态门禁仍会放过。所以LocaleGuard是发布质量的一道局部防线,不能替代多语言真机走查,更不能替代合规判断。
四、用同一份基准产出可追溯的报告
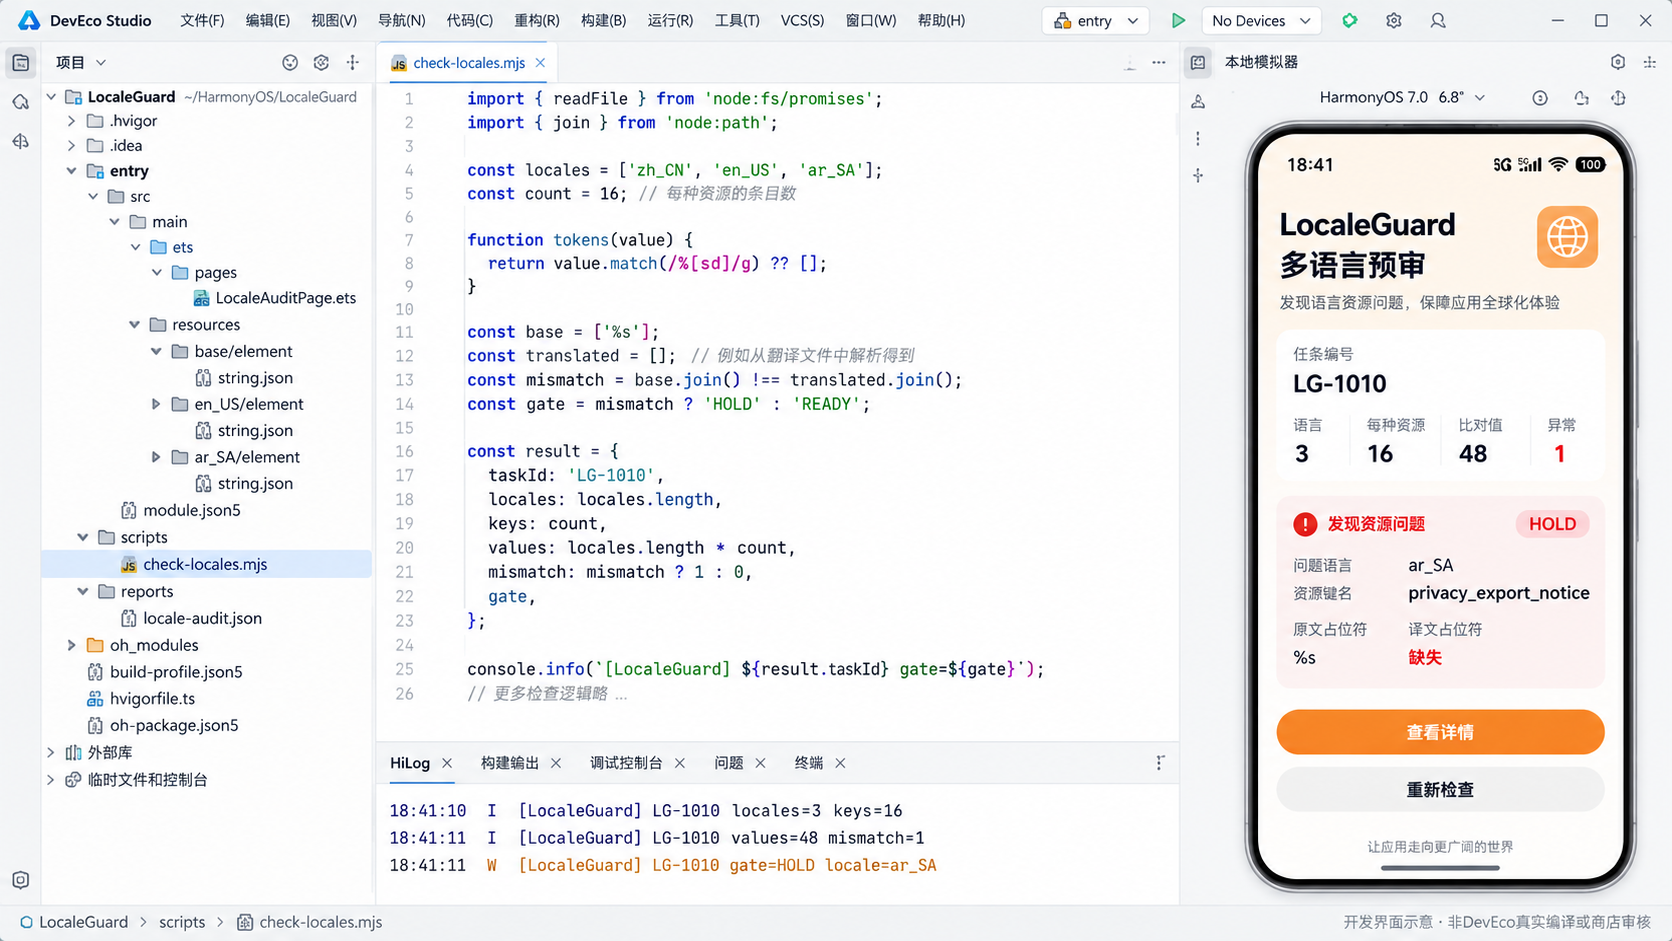
扫描顺序固定为先读默认资源,再枚举指定的三套语言。这里把中文默认目录映射到业务名称zh_CN;统计口径是“3套语言各16个键”,所以总核对值是48,而不是把16个键误写成48个独立资源名。对每个键检查缺失和格式签名不一致,任一异常就置HOLD。
import { mkdir, rename, writeFile } from 'node:fs/promises';
const root = 'entry/src/main/resources';
const locations = {
  zh_CN: `${root}/base/element/string.json`,
  en_US: `${root}/en_US/element/string.json`,
  ar_SA: `${root}/ar_SA/element/string.json`
};
const baseline = await readTable(locations.zh_CN);
const issues = [];
for (const [locale, file] of Object.entries(locations)) {
  const actual = await readTable(file);
  for (const [key, expected] of baseline.entries()) {
    if (!actual.has(key) || signature(actual.get(key)) !== signature(expected)) {
      issues.push({ locale, key, kind: 'placeholder_mismatch' });
    }
  }
  for (const key of actual.keys()) {
    if (!baseline.has(key)) issues.push({ locale, key, kind: 'extra_key' });
  }
}
const report = {
  taskId: 'LG-1010', locales: 3, keys: baseline.size,
  checkedValues: baseline.size * 3, issues,
  gate: issues.length ? 'HOLD' : 'READY'
};
await mkdir('reports', { recursive: true });
await writeFile('reports/locale-audit.json.tmp', JSON.stringify(report, null, 2));
await rename('reports/locale-audit.json.tmp', 'reports/locale-audit.json');
输出采用“先写临时文件再改名”的方式,避免直接覆盖上一份完整报告时留下一半JSON。但这里同样要守住说法:同目录重命名在常见文件系统上可以降低半文件风险,不等于突然掉电后一定具备持久化保证。正式流水线应保留构建号、代码提交号、资源哈希与报告生成时间,方便还原扫描输入。若资源读取失败、JSON解析异常或报告写出失败,CI应阻止继续发布,而不能自动回退成READY。
五、让错误对开发者可操作,不把“扫描失败”包装成“审核失败”
本轮样例账本固定三行:18:41:10读取三套语言、每套16项;18:41:11累计48个核对值,发现1处差异;同一时刻发布内部门禁改为HOLD,问题语言为ar_SA,问题键为privacy_export_notice。界面给出中文基准%s、英文%s、阿拉伯语“缺失”的并排对照,而不是一句没有上下文的“国际化错误”。
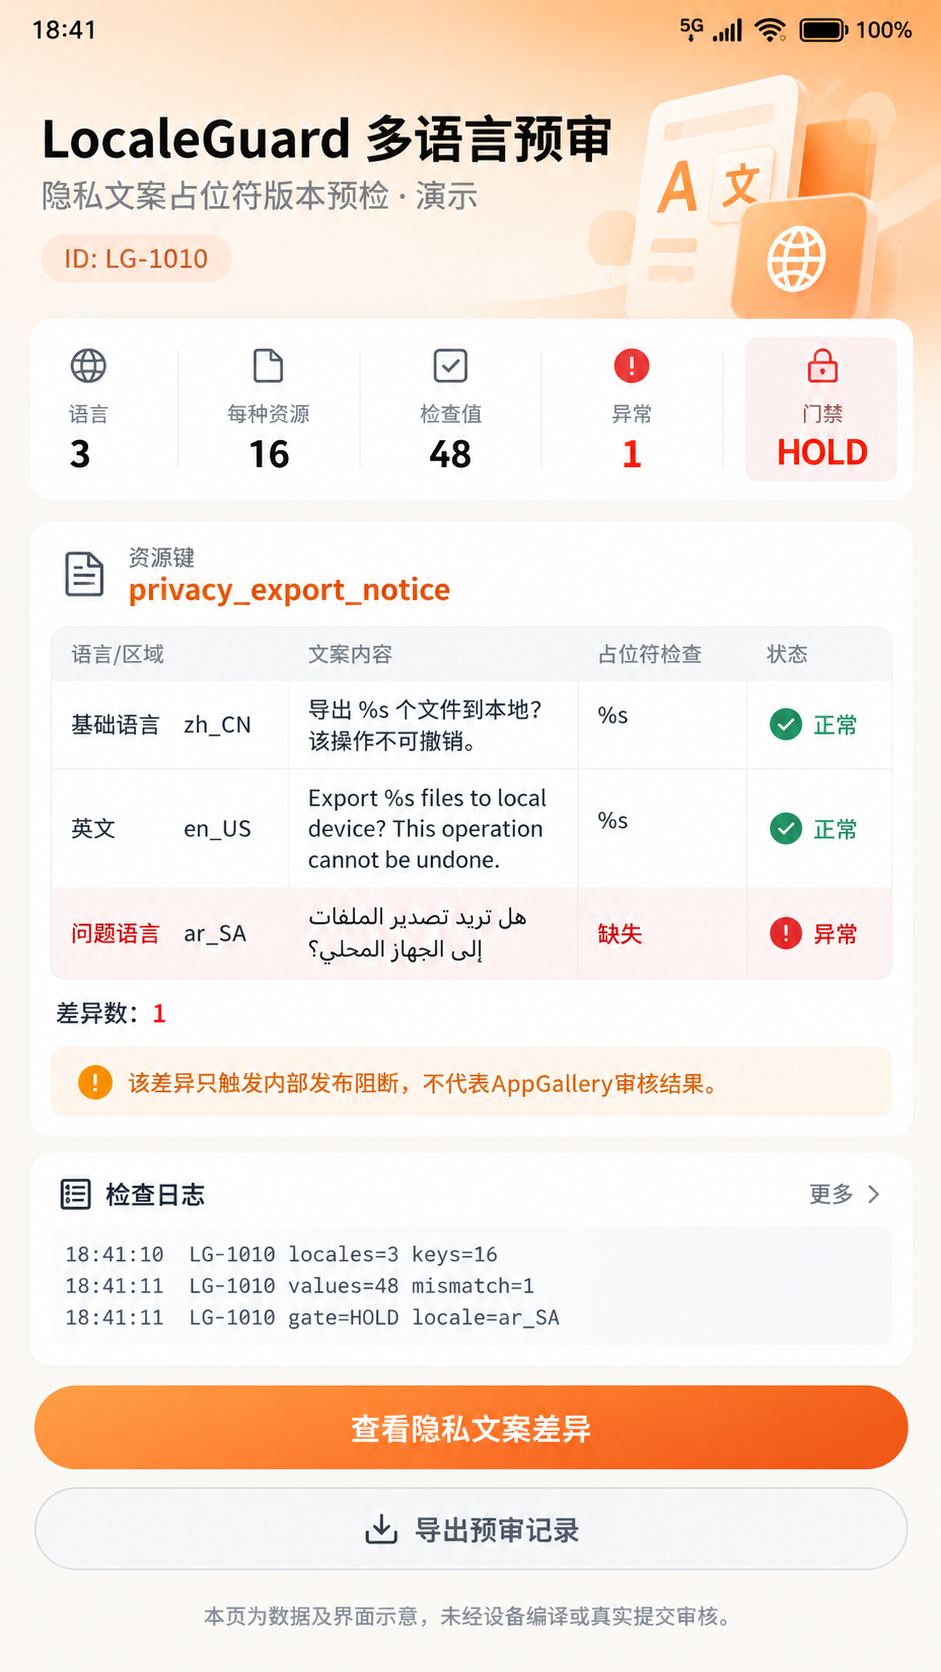
在团队协作层面,我会让报告多保留两种视角:一份供机器消费的结构化JSON,另一份供翻译和测试人员阅读的差异摘要。机器报告必须包含资源文件相对路径、语言、键名、预期签名和实际签名,便于CI稳定定位;人工摘要则直接展示缺哪个参数、可能影响哪种用户操作,不要求非研发同事看正则表达式。扫描器也应把“规则不支持”“文件读取失败”“占位符不一致”分成不同类别,否则团队会反复误判问题来源。当前演示界面只呈现最重要的一条差异,不等于完整发布报告只需记录这一行。
恢复动作也应该具体:译者先补全占位符,开发同学确认业务调用时传入的数据类型,测试切到ar_SA验证文案能否容纳参数,再重新运行扫描。只有重新核对48个值并得到没有异常的报告,才允许内部流水线从HOLD改为READY。不能在工具里直接把某条有问题的键改成“已知例外”就省掉校验,除非例外有审批人、到期时间及变更记录。
我还会补三种故障用例:某套资源缺整个键、出现重复name、基准中一个%s被改成%d。它们都应该得到明确的异常归因,不能混同为“翻译文案有错”。此外,涉及隐私授权或支付确认的文案还应进行人工审校,保证译文不改变用户对操作后果的理解。文字变长造成按钮溢出、阿拉伯语阅读方向和字号缩放,也不属于这个脚本能证明的内容。
另一个值得补进工程清单的细节,是资源语言码和目录本身。脚本应将预期语言集合写在仓库配置里;若业务准备支持四种语言,资源目录却只存在三套,不能仅因“现存三套都没问题”就放行。对新加语言要核对默认回退策略,避免缺失的说明文案悄悄落回不适用的默认语言。当前样例只覆盖已声明的三种语言,不能推导整个应用没有本地化缺口。
最后需要把门禁摆正:LocaleGuard的价值是让语言资源的一处具体漂移在上线前可见、可复核、可阻断,而不是宣称“做过静态检查就符合全部上架要求”。系统负责本地化资源匹配,Node.js脚本负责固定格式的小范围静态检测,审核规则和用户体验仍由真正的发布流程验证。这样工具更小,但每一次HOLD都有可解释的工程证据。
技术资料:华为HarmonyOS《提供多语言资源》https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-v5/l10n-multilingual-resources-V5 ;《避免硬编码与拼接》https://developer.huawei.com/consumer/cn/doc/harmonyos-guides-v5/l10n-hard-coding-concatenate-V5 ;Node.js fs API https://nodejs.org/api/fs.html 。本篇为离线静态检测设计样例,不代表真实设备测试或应用市场审核。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)