
ArkData RDB:文搜图标签索引切换事务回滚与读侧隔离【鸿蒙心迹】
一、相册没有坏,检索结果却在更新时短暂消失
文搜图项目做到后期,用户真正关心的已经不是“输入一句话能不能找到照片”,而是收藏过的结果能否稳定留下。设想一个本地相册:旧版标签索引能够返回十八条“海边落日”相关记录,后台准备替换新版标签时,其中一条照片标识重复。如果实现先清空旧表再逐条插入,新索引还没完整形成,前台就可能读到空列表。这样的闪烁不需要算法失效,只要把写入的中间态暴露给查询,就足以让用户怀疑照片被删除。
本文把问题缩到本地关系型数据库的业务切换。Demo叫PhotoIndex,任务编号PI-205;演示用旧代际IDX-006、新候选IDX-007,双方预设各十八条,候选存在一条重复主键,预期结果是候选回滚、活动索引仍为IDX-006、查询结果仍有十八条。这是一组为了讲清事务边界而设计的数据,并非真机压测,也不是实际相册识别输出。
二、为什么不直接替换整张表
在代码层面,最容易写的方案是先删除所有标签、重新写入,然后刷新界面。但“删除”和“插入”属于不同操作,任意一步失败都会让数据库处于不完整状态。更隐蔽的问题是,后台标签生成完成的时间不可预测,若用户同时滚动相册、切换搜索词,前端会在多个异步时点读取数据库。即使算法输出正确,读写交叉也可能产生同一批次中前后不一致的页面。
这里采用“双代际+活动指针”的模型。TAG_INDEX表为每条标签增加GEN_ID,组合主键为代际和照片ID;INDEX_META只有一个ACTIVE_GEN,指向允许前台读取的版本。新批次只写IDX-007,不碰IDX-006。等全部写入并完成业务校验,再在同一事务中更新活动指针;如果任意写入失败,事务回滚,活动指针保持原值。所谓读侧隔离不是夸大某个全新SDK能力,而是应用约定“查询总先取活动代际”,避免直接读取准备中的候选数据。
数据指针只记录一个版本号,并不能单独保证跨多条SQL的原子性。因此核心仍是关系数据库事务,而非用普通Preferences写一个完成标记。活动指针和候选写入应位于同一事务里;若分开写,就可能出现指针已经切换而候选数据尚未落齐的情况。界面上也不应该把“写入过多少条”误标为“用户已经能看到多少条”。
三、库的初始化与表结构先固定
要解决的第一个问题,是给每一条检索记录明确归属,避免只靠照片路径判断新旧。这里的ArkTS代码示例以Stage模型为前提,使用@kit.ArkData中的relationalStore。数据库名称和安全级别是本项目的配置,不代表鸿蒙系统自动生成了任何检索标签。正式工程还需要迁移脚本、库文件备份和用户数据处理策略。
import { relationalStore } from '@kit.ArkData';
import { common } from '@kit.AbilityKit';

export async function openPhotoIndex(
  context: common.UIAbilityContext
): Promise<relationalStore.RdbStore> {
  const store = await relationalStore.getRdbStore(context, {
    name: 'photo_index.db',
    securityLevel: relationalStore.SecurityLevel.S1
  });
  await store.executeSql(
    'CREATE TABLE IF NOT EXISTS TAG_INDEX (' +
    'GEN_ID TEXT NOT NULL, PHOTO_ID TEXT NOT NULL, TAG TEXT NOT NULL,' +
    'PRIMARY KEY (GEN_ID, PHOTO_ID))'
  );
  await store.executeSql(
    'CREATE TABLE IF NOT EXISTS INDEX_META (' +
    'ID INTEGER PRIMARY KEY, ACTIVE_GEN TEXT NOT NULL)'
  );
  return store;
}
初始化完成只说明能获得数据库句柄,不能推导出表中已经包含十八条记录。旧版IDX-006与活动指针属于事先准备的示例数据;首次安装应由应用明确初始化。getRdbStore和executeSql可能失败,初始化异常时不进入索引切换状态,UI保留“数据库暂不可用”的提示,不在异常分支偷偷创建一个空列表覆盖历史结果。
四、让十八条候选与指针改动共进退
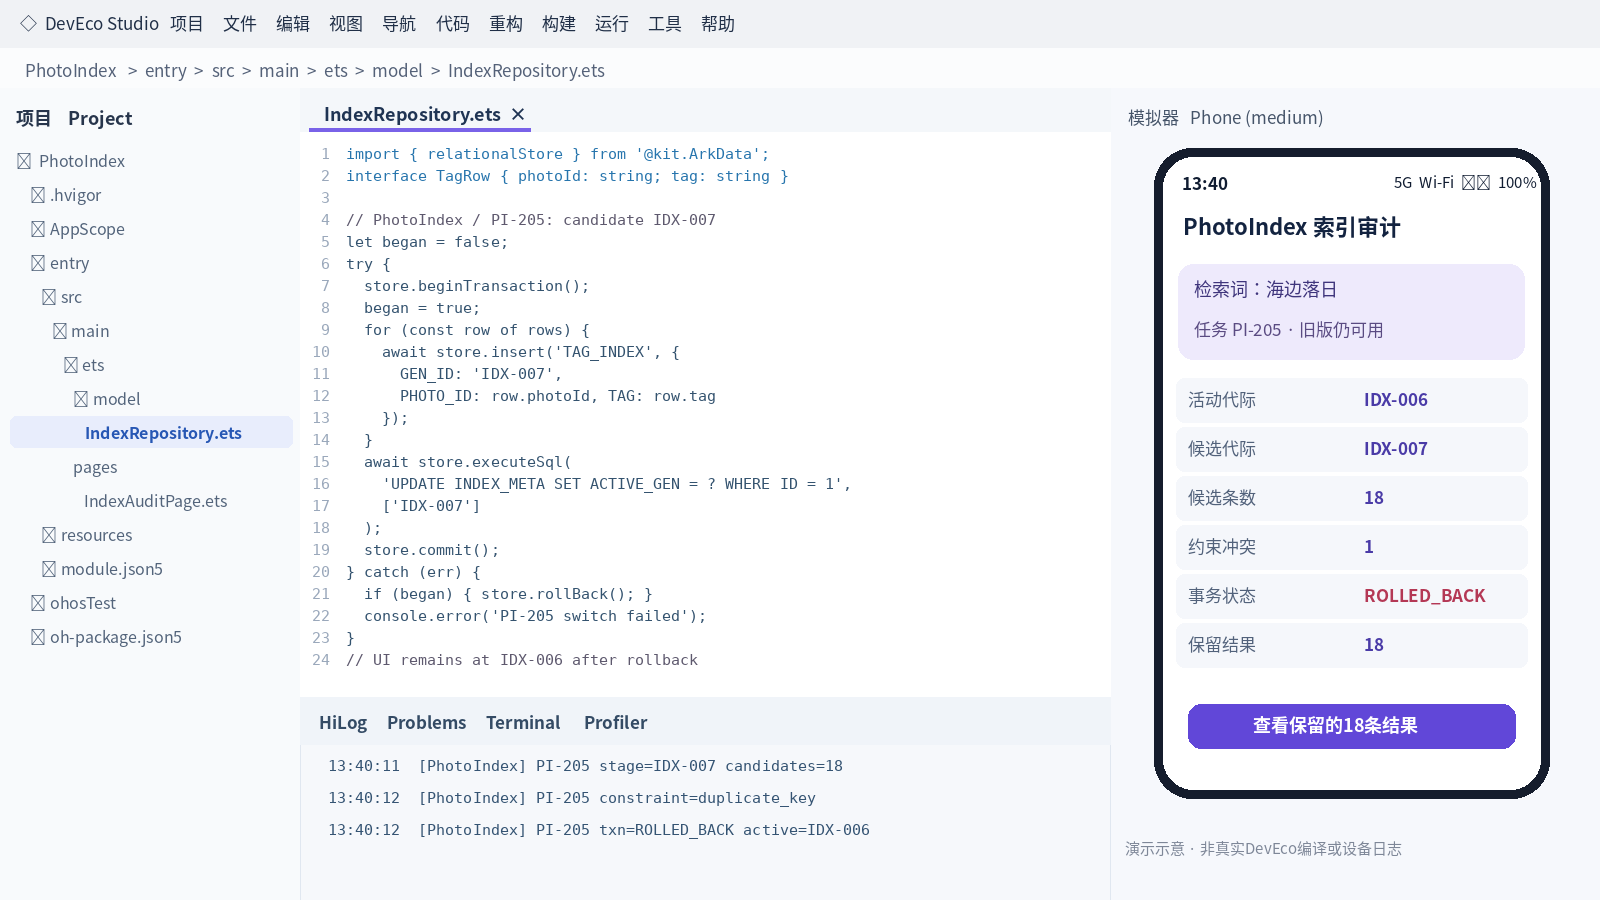
第二个问题是“半成功”如何处理。候选数组在交给数据库之前可以做长度、空值和照片ID重复校验;数据库仍须保留组合主键约束作为最后防线。下面刻意展示事务内的写入与活动指针更新。rollBack使用关系型数据库的事务接口,不是把UI数组重新赋旧值的伪回滚。该片段只说明关键路径,调用前应保证INDEX_META已有ID为1的记录,而且同一数据库连接上不能被其它写入流程插入事务。
interface TagRow { photoId: string; tag: string }

async function switchGeneration(
  store: relationalStore.RdbStore, rows: TagRow[]
): Promise<boolean> {
  let began = false;
  try {
    store.beginTransaction();
    began = true;
    for (const row of rows) {
      await store.insert('TAG_INDEX', {
        GEN_ID: 'IDX-007', PHOTO_ID: row.photoId, TAG: row.tag
      });
    }
    await store.executeSql(
      'UPDATE INDEX_META SET ACTIVE_GEN = ? WHERE ID = 1',
      ['IDX-007']
    );
    store.commit();
    return true;
  } catch (err) {
    if (began) { store.rollBack(); }
    console.error(`[PhotoIndex] PI-205 switch failed: ${JSON.stringify(err)}`);
    return false;
  }
}
这段流程最重要的是更新顺序:事务开始后写候选、最后改活动指针,提交后才允许前端广播“索引已经切换”。假设演示的第十八条与之前某条具有相同PHOTO_ID,唯一约束会拒绝第二次插入;演示状态因而标为ROLLED_BACK。真正执行时错误码和失败位置以实际SDK返回为准,不能把演示里的duplicate_key当成固定的系统错误码。
还要注意异常分支本身也可能失败。生产实现应在回滚失败时将数据库标记为待修复,不继续写下一批;如果活动指针更新影响零行,也不能直接提交,应显式检查元数据初始化情况。这里为突出事务思路,没有展开数据库连接的串行写队列、备份和迁移代码,不能将示例直接当成完整存储层。
五、前台只认活动代际,不认后台进度
读取侧的关键不是把搜索页永久锁住。用户应该仍能查询已验证的旧版,即使后台正在计算下一代标签。每次开始一次新的查询时,先读取INDEX_META的ACTIVE_GEN,再把该代际作为整个查询的过滤条件。需要翻页的场景,建议把本次查询读到的版本留在查询会话里,避免第一页来自IDX-006、第二页突然来自IDX-007。
async function readActiveGeneration(
  store: relationalStore.RdbStore
): Promise<string> {
  const result = await store.querySql(
    'SELECT ACTIVE_GEN FROM INDEX_META WHERE ID = 1'
  );
  try {
    if (!result.goToFirstRow()) { throw new Error('missing active generation'); }
    return result.getString(result.getColumnIndex('ACTIVE_GEN'));
  } finally {
    result.close();
  }
}
这里强调关闭ResultSet,是因为结果集的生命周期独立于页面上那十八张缩略图;查询完成后仍长期持有数据库游标,会给后续写入和资源回收增添不必要的负担。读取失败时也不要自动把候选代际当作备用值。索引切换的权限来自已经提交的活动指针,不来自“后台进度达到了百分之百”。必要时可以展示旧数据仍可搜索,同时提醒标签暂未更新。
六、用可观察的状态把异常讲清楚
预设日志为:13:40:11 [PhotoIndex] PI-205 stage=IDX-007 candidates=18,随后13:40:12 [PhotoIndex] PI-205 constraint=duplicate_key,最后13:40:12 [PhotoIndex] PI-205 txn=ROLLED_BACK active=IDX-006。这些字符串用于核对设计中的事务状态,不是当前环境捕获的HiLog。首个状态只表示候选已进入待写入过程;第二个表示构造数据触发约束;第三个才描述事务回滚后的期望活动指针。
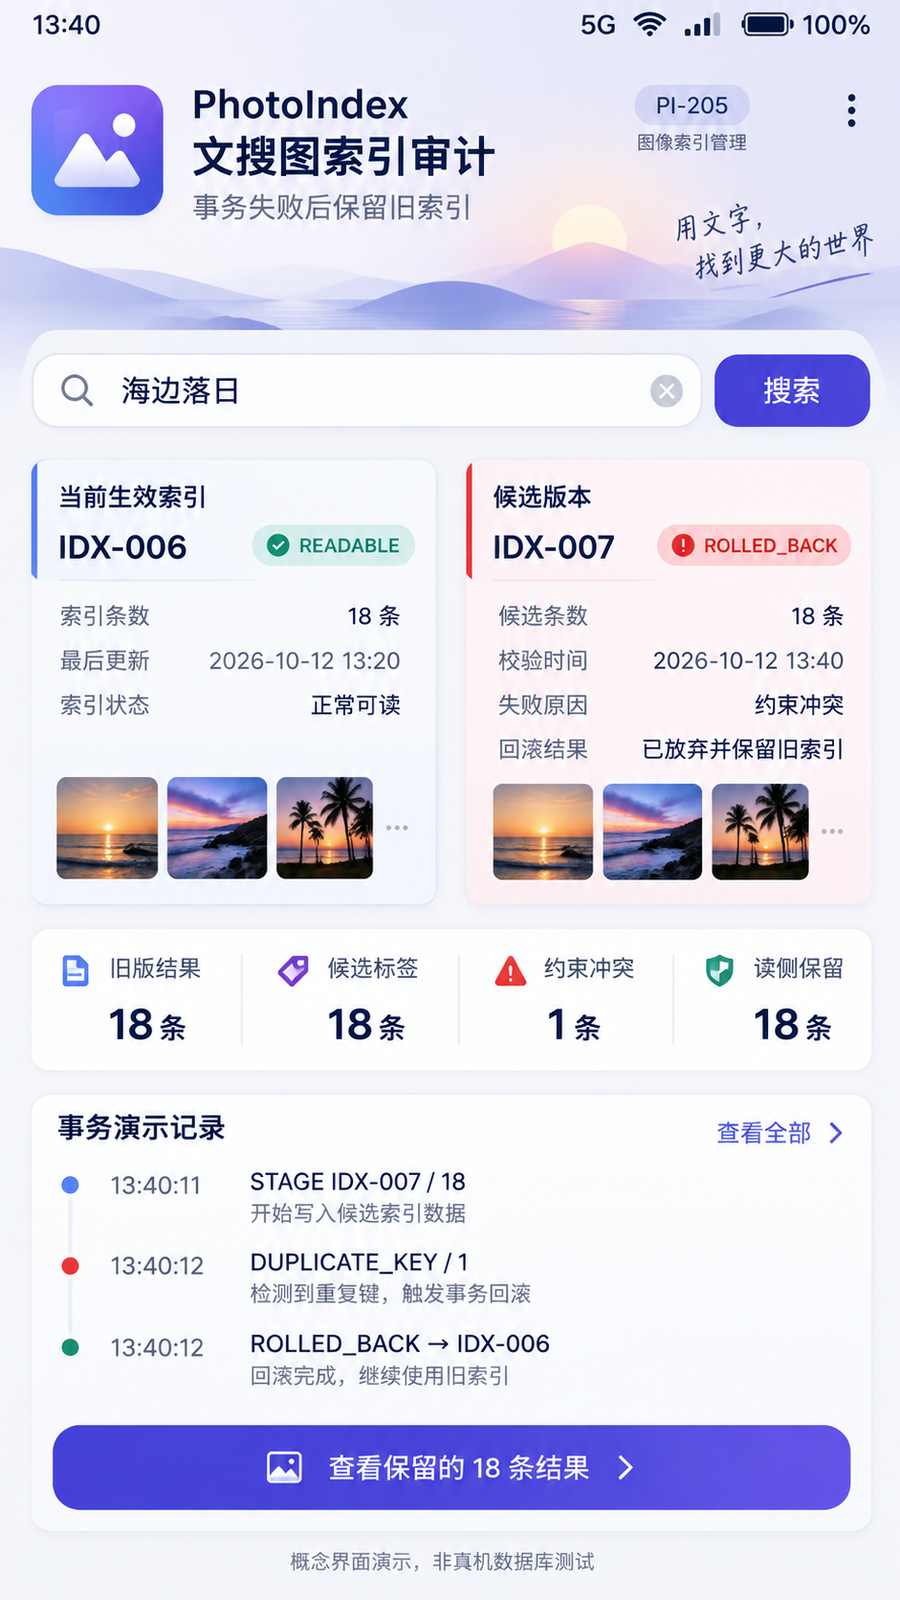
对用户可见的页面则保留搜索词“海边落日”,显示旧版IDX-006、候选IDX-007、候选十八条、异常一条、保留结果十八条。失败原因必须写“本轮索引更新失败,旧结果仍可使用”,不能写成“本轮照片删除失败”,更不能默认用户的媒体文件丢失。这里完全没有移动或删除原照片;失败只发生在业务标签数据库的候选代际。
七、页面退出、重复任务与下一轮切换
事务保护的是数据库写入,但它不能自动取消页面上的过期回调。搜索页退出后,后台索引任务可能仍在继续;如果结果回来时直接赋给已销毁组件的@State,会出现状态错位。建议由应用级服务持有数据库句柄和串行任务队列,页面只订阅事件;aboutToDisappear时注销页面订阅,别随手关闭仍有写事务占用的共享数据库连接。
重复按下“更新索引”按钮同样需要门禁。只允许同一个数据库实例有一个活动写事务;如果用户确实想取消,业务上应设置取消标记,在下一安全边界执行回滚或停止发起下一批,而不是任意时刻直接销毁数据库句柄。新批次不能永久沿用IDX-007,代际号必须由业务生成并保证唯一,避免旧的失败候选与新候选混在一起。
八、工程结论与可验证范围
这个设计解决的不是文搜图模型的准确率,而是标签替换期间的数据一致性:失败时保留可用旧结果,成功时一次性发布新版本。它适合本地离线标签库、OCR辅助索引、文档搜索缓存等场景;如果需要跨进程、多设备同步或者极大规模索引,则要重新评估事务锁、同步冲突和迁移方案,不能直接照搬页面级的状态判断。
本文只依据华为关系型数据库指南、ArkData接口资料描述可用接口与设计边界,代码未在DevEco中实际编译,图为概念演示而非实机截图。正式验收应以重复主键注入、断电恢复、读写并发、应用重启后活动指针以及ResultSet资源释放为检查项,分别记录真实设备日志,再决定是否推广到正式相册。
资料:华为开发者文档《ArkData API参考》 https://developer.huawei.com/consumer/cn/doc/doccenter-references/api/arkts-apis-data-relationalstore-literesultset ;《ArkData发布差异》 https://developer.huawei.com/consumer/cn/doc/doccenter-release-notes/js-apidiff-arkdata-b123sp18 。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)