
ArkData RDB:文搜图索引批次替换事务回滚与可见性门禁【鸿蒙心迹】
做本地文搜图时,索引不一定要先碰模型。只保存照片标识、搜索描述、批次编号这三个字段,就足以遇到一个值得提前处理的工程问题:用户刷新索引清单,旧数据先被清空,新批次写到一半却失败。若界面已经根据“清空成功”刷新,它会短暂显示空列表,甚至把未完成的六行当作最终结果。错误不在检索模型,而在业务把几次数据库操作误认成一次发布。
本文用 IndexLedger 演示这道边界。任务号 IDX-843,数据库 photo_index.db,索引表 photo_index。示例设定旧批次可见 12 条,准备替换为新批次 10 条,在成功写入第 6 条后主动注入失败。预期状态是 ROLLED_BACK,用户仍可见旧的 12 条;真正 Core Vision Kit 的向量建索引、相册文件读取和实际搜索质量都不属于这份 Demo。
封面是批次替换的概念图,不是数据库实测。下文仅围绕 HarmonyOS ArkData RDB 的事务语义和前端可见性协议展开。
一、先把“完成一次刷新”的含义定清楚
1. 可见列表必须跟随已提交版本
在内存里拼好十条候选就算刷新完成,是一种很诱人的写法。真正的问题在于:用户当前看到的十二条,属于已经确认的数据版本;新十条在业务层只是草稿。若直接把 UI 的 items 指向十条草稿,即使最终事务回滚了,界面仍可能把不完整的新数据留在屏幕上。反过来,如果每插入一条都触发查询,旧版本与新版本会被混着展示。
因此我们约定三个独立事实:incomingCount=10 只表示输入计划,stagedCount=6 表示本次故意失败之前已尝试写入的条数,visibleCount=12 始终表示事务结束后可查询的已提交行数。只有 commit() 确认成功,页面才准许重新读取 RDB 并更新可见列表。这里的“可见性门禁”是应用 UI 层的发布决策,不是 RDB 自带的某个叫“门禁”的接口。
2. 把数据库的创建与业务事务分开
建表属于应用初始化,不应每次点击“刷新索引”都执行一遍。示例表只存元信息,用主键锁住 photo_id。索引里不保存原照片内容,也不认为数据表的标签已经代表可检索的多模态向量。
import { common } from '@kit.AbilityKit';
import { relationalStore } from '@kit.ArkData';

export async function openIndexStore(ctx: common.UIAbilityContext): Promise<relationalStore.RdbStore> {
  const config: relationalStore.StoreConfig = {
    name: 'photo_index.db',
    securityLevel: relationalStore.SecurityLevel.S1
  };
  const store = await relationalStore.getRdbStore(ctx, config);
  await store.executeSql(
    'CREATE TABLE IF NOT EXISTS photo_index (' +
    'photo_id TEXT PRIMARY KEY, label TEXT NOT NULL, batch_id TEXT NOT NULL)'
  );
  return store;
}
创建失败时应停在“数据库不可用”,不应退化成静默覆盖旧列表;初始化获得的 RdbStore 要按应用的数据库管理策略复用,避免在短时多次点击时重复抢占连接。示例假定 Stage 模型和可用的 UIAbilityContext,真实项目的安全级别、数据库位置和升级策略要由产品数据等级决定。
二、一次写入失败应由谁负责兜底
1. 数据合同先于事务入口
事务能保护写入的原子性,但不会替开发者识别同一清单内重复照片、空标题、重复批次等业务错误。如果等到写到第六条才发现第七条标识为空,虽然可以回滚,却徒增数据库锁占用。最便宜的校验应在创建写事务之前完成。
下面是仅依赖 ArkTS 基础语法的预检示例,三种条件会直接阻断本轮替换。它不会访问数据库,也不会修改内存列表。
export interface PhotoIndexRow {
  photoId: string;
  label: string;
}

export function checkIndexRows(rows: PhotoIndexRow[]): string {
  if (rows.length === 0 || rows.length > 500) return 'INVALID_BATCH_SIZE';
  const ids = new Set<string>();
  for (const row of rows) {
    if (!row.photoId.trim() || !row.label.trim()) return 'EMPTY_FIELD';
    if (ids.has(row.photoId)) return 'DUPLICATE_ID';
    ids.add(row.photoId);
  }
  return 'READY';
}
500 只是 Demo 自定的单次上限,不是 ArkData 官方规模限制。真实应用应由平均文本长度、目标设备、实际事务持有时间和分页策略来决定批量粒度。输入预检失败属于业务拒绝,和 SQLite 写锁冲突、磁盘空间不足这类数据库异常必须分开记录。
2. 删除旧批次与写入新批次必须处在同一事务
最需要守住的不是“插入了六条”,而是“用户何时可以看到这六条”。createTransaction、Transaction.insert、commit、rollback 都属于官方关系数据库事务模型;下面故意使用 IMMEDIATE 写事务,让同一批次从删除旧行到插入新行都受事务控制。它与直接调用 store.insert 的自动提交路径不同。
import { relationalStore } from '@kit.ArkData';

export async function replaceVisibleBatch(
  store: relationalStore.RdbStore,
  rows: PhotoIndexRow[],
  injectFailure: boolean
): Promise<string> {
  if (checkIndexRows(rows) !== 'READY') return 'VALIDATION_REJECTED';
  const tx = await store.createTransaction({
    type: relationalStore.TransactionType.IMMEDIATE
  });
  try {
    const allRows = new relationalStore.RdbPredicates('photo_index');
    await tx.delete(allRows);
    for (let i = 0; i < rows.length; i++) {
      if (injectFailure && i === 6) throw new Error('INJECT_AT_6');
      await tx.insert('photo_index', {
        photo_id: rows[i].photoId,
        label: rows[i].label,
        batch_id: 'IDX-843'
      });
    }
    await tx.commit();
    return 'COMMITTED';
  } catch (error) {
    await tx.rollback();
    return 'ROLLED_BACK';
  }
}
在这份约定里,异常发生在准备写第七条之前,所以“写了六条”并不表示六条最终可见。rollback() 是明确的失败收口操作;若回滚本身又失败,正式项目必须上报为需要重新检查数据库状态的严重错误,而不是一律显示安全回滚。代码为了讲清主流程,保留了最小返回值;上线时应区分事务创建失败、运行中失败、回滚失败和提交完成后的 UI 读取失败。
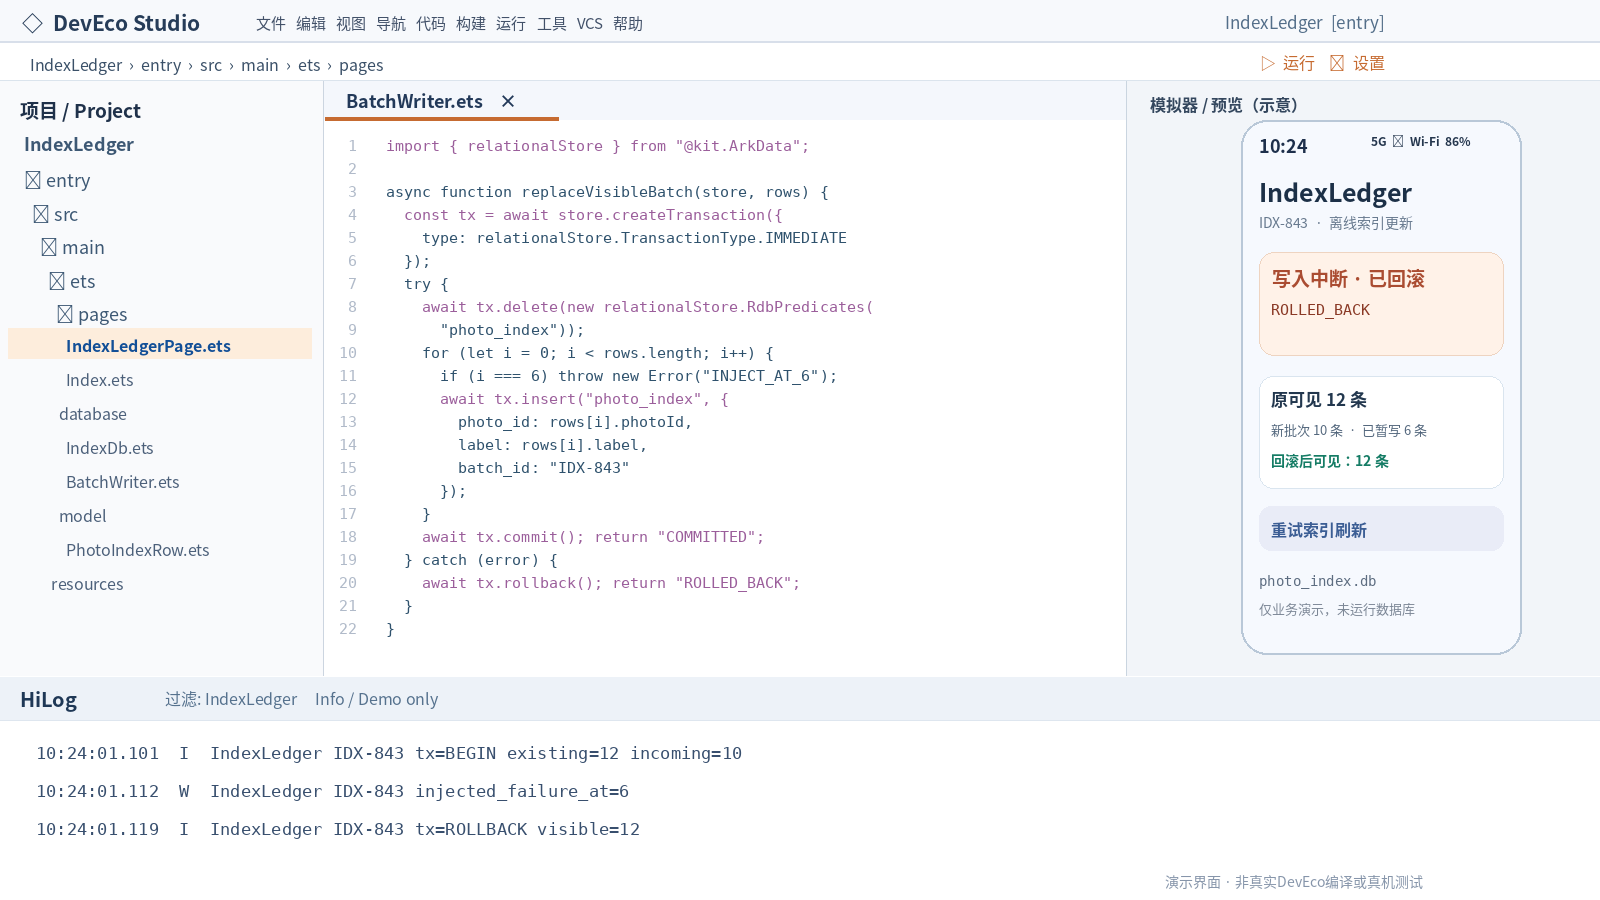
这张 DevEco 风格图是完整的合成演示界面:左边是 IndexLedger 工程树,中间为事务核心代码,右边显示 IDX-843 的已回滚页面,底部日志是预设验证文字。没有真实 RDB、DevEco 编译或设备操作过程被截图。
三、比回滚更容易漏掉的是 UI 发布时机
1. 提交成功才触发一次已提交数据重读
页面按钮应该把状态从 IDLE 变到 APPLYING,禁用重复提交;调用事务函数后,只有结果为 COMMITTED 才查询新的已提交结果集。若结果为 ROLLED_BACK,可以保留当前十二条快照,同时提供“重试”入口。这样既不会闪空,也不会把尚未提交的草稿当成真实索引。
很多 Demo 只关注 try/catch,却没注意到数据库操作和页面生命周期可能不同步。一个编辑页在事务等待期间离开了前台,Promise 仍可能返回。如果回调直接改页面状态,旧页面就会覆盖用户刚打开的新批次。可在组件层使用请求序号,只让当前页面仍关心的返回值更新 UI;数据库事务本身仍必须走完 commit 或 rollback,不因为页面销毁就让操作悬空。
2. 锁冲突不等于数据损坏
官方事务文档提醒关系数据库写事务存在并发限制,写锁相关错误与持锁时间有关。高频刷新业务不要在事务中做向量检索、网络下载或图片解码;这些步骤先完成、先预检,再以尽量短的区间写入数据库。若事务创建失败,应记录错误码和重试策略,而不是无上限自旋。
这份最简代码一次删除全部 photo_index 再写入新行,适合说明完整替换语义,并不适合数十万条、需要无感切换的生产索引。实际规模扩大时,可以用带批次号的独立表、双版本指针与后台清理设计,但那又是另一套协议;不要把“事务原子性”误解为“没有性能成本”。
四、把演示结果写成可核对的事实
这里刻意不说“已跑通真机”。本轮只定义一组预期校验数据:原来十二条,计划十条,注入点六条,状态 ROLLED_BACK,页面最终仍显示 12。日志契约是:IndexLedger IDX-843 tx=BEGIN existing=12 incoming=10,随后 IndexLedger IDX-843 injected_failure_at=6,最后 IndexLedger IDX-843 tx=ROLLBACK visible=12。这些并非运行采样,而是检查 UI、文字、图像一致性的示例值。
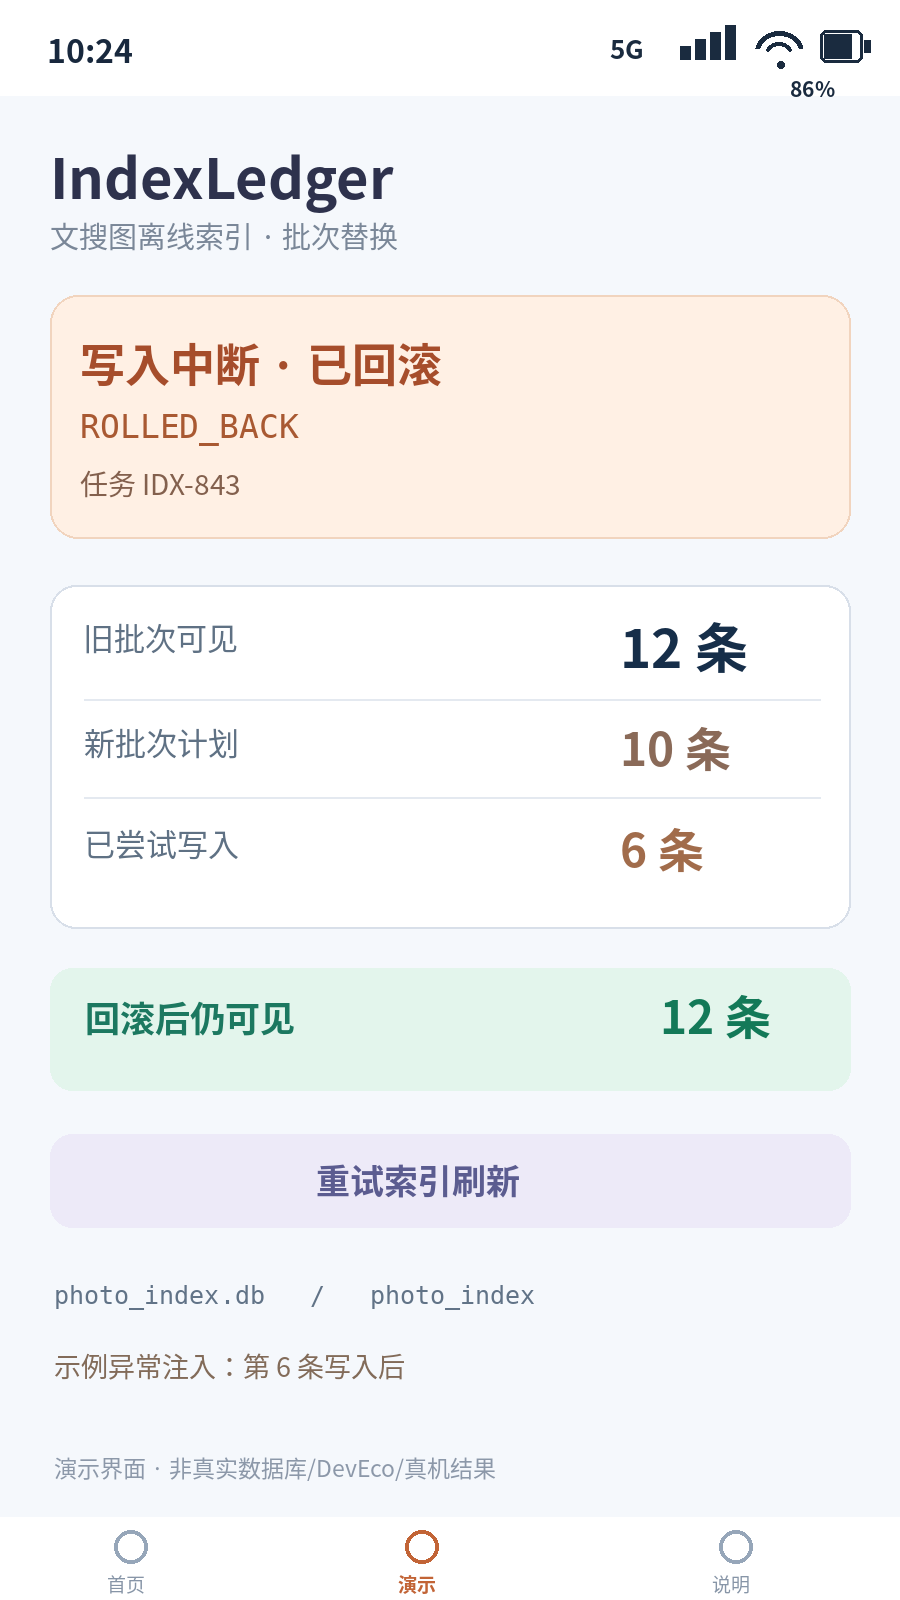
9:16 手机屏幕图显示“写入中断 · 已回滚”。在右下方的说明处已经标识“演示界面,非真实测试”;状态栏的时间、5G、Wi-Fi、信号与电量百分比同样是排版模拟。图里不出现新十条已经发布的字样,以免与事务回滚逻辑相冲突。
验收时至少补三组真正由项目环境执行的测试:一是正常十条全部提交并重新查询,二是注入异常后验证旧十二条原样存在,三是并发刷新两次时验证只有一个受支持的写入路径得到提交。需要检查每种路径下结果集是否关闭、事务错误是否可诊断、页面是否在销毁后停止更新。文中没有对这些步骤作出已通过声明。
五、适用边界与资料
这套思路适用于应用自有的小规模索引元数据、草稿集合或轻量缓存批次。它并不能替代 Core Vision Kit 内部向量索引的生命周期管理,也无法保证系统相册的照片不会被用户移动或删除。正式文搜图产品还要处理媒体权限、资源标识稳定性、搜索模型版本与检索结果失效问题。
值得留下的工程判断很简单:事务保证数据库写入是整体,业务门禁保证界面只发布已确认版本。两个条件任一缺失,用户都可能看到自相矛盾的列表状态。把注入失败的位置、回滚结果和可见计数写成一份数据契约,之后再进入目标 DevEco 版本、真机和真实数据验证,远比把一张绿色“成功”截图当成验收更稳妥。
官方依据:华为 ArkData API 变更说明(Transaction、commit、rollback、insert):https://developer.huawei.com/consumer/cn/doc/doccenter-release-notes/js-apidiff-arkdata-b123sp18;ArkData 关系数据库原生参考与事务边界:https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/api/capi-relational-store-h。本例仅使用应用层关系表与已确认的事务接口,checkIndexRows、replaceVisibleBatch 属于本文自定义业务代码。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献260条内容

所有评论(0)