
ArkData relationalStore:文搜图标签索引分页去重【鸿蒙心迹】
图片搜索不总是需要在输入框后面立刻接入向量模型。用户输入“海边”,在一批已经整理过主题标签的照片中寻找内容,这个需求首先是一项可靠的本地索引工程:记录是否一致、翻页有没有重复、快速换词是否污染结果、没有命中时页面如何解释。模型检索可以放在下一步,而基础检索如果连这些边界都没有处理好,接入模型也很难补救。
本文用 TagLens 做一个规模很小、数据固定的示例:数据集6张图,关键词“海边”命中3条,第一页取2条;演示任务编号 TL-062。这里的“文搜图”特指人工标签匹配,不是自然语言语义理解,也没有调用端侧视觉模型。文章讨论的是数据索引、查询时序和页面反馈,不虚构检索准确率或设备耗时。
一、先给检索定义一个可核对的协议
为避免写着写着把数据库字段、UI列表和预览图片混成一回事,我先把示例记录固定下来。P-021“海边灯塔”、P-034“海边栈道”、P-058“海边礁石”都包含标签“海边”;P-008“山谷晨雾”、P-016“城市夜景”、P-045“森林步道”不包含。每条记录持有稳定ID、标题、标签字符串和资源URI四个字段。用于排序的是ID,而不是图片加载完成的顺序。
一个容易忽略的细节是,命中数3与当前列表显示2不是矛盾。当前页面的偏移量为0,pageSize=2,显示P-021、P-034;下一页才会出现P-058。演示UI可以写“命中3 · 当前2”,但代码不能通过当前页面长度推断总命中数。完整工程应单独执行COUNT查询或维护可靠的结果总数;本次图示的3是固定测试数据对应的预期值,不冒充实时数据库统计。
图片URI也要与索引行分开管理。删掉了原图却没有同步清理索引,搜索仍会返回ID,但是打开预览失败。数据库只负责找到候选,真正展示之前还要验证URI是否能被本应用访问,并为无效资源准备占位图。直接把“图片存在”写成“查询命中”会让排障方向偏离事实。
二、表结构要让重复导入可控
先解决一个工程问题:应用打开多次,不应把相同六张示例图片重复追加。relationalStore.getRdbStore 取得数据库实例;建表使用稳定ID作为主键,初始化数据用 INSERT OR IGNORE 做幂等演示。实际项目应从索引生成器读取真实媒体URI,并建立删除同步策略。
import { relationalStore } from '@kit.ArkData';
import { common } from '@kit.AbilityKit';

export async function openTagIndex(context: common.UIAbilityContext): Promise<relationalStore.RdbStore> {
  const cfg: relationalStore.StoreConfig = {
    name: 'TagLens.db', securityLevel: relationalStore.SecurityLevel.S1
  };
  const db = await relationalStore.getRdbStore(context, cfg);
  await db.executeSql(`CREATE TABLE IF NOT EXISTS PHOTO_TAGS (
    ID TEXT PRIMARY KEY NOT NULL,
    TITLE TEXT NOT NULL,
    TAGS TEXT NOT NULL,
    URI TEXT NOT NULL
  )`);
  await db.executeSql(
    'INSERT OR IGNORE INTO PHOTO_TAGS (ID,TITLE,TAGS,URI) VALUES (?,?,?,?)',
    ['P-021', '海边灯塔', '海边,灯塔,蓝天', 'demo://P-021']
  );
  // 其余5条使用相同协议导入;demo://仅表示示例资源键
  return db;
}
SecurityLevel.S1 是这份教学数据的配置示例,不意味着所有真实图片元数据都能使用同一安全等级。getRdbStore 和 executeSql 都可能失败,所以调用方需要捕获异常,并把“索引不可用”与“没有匹配图片”区分开。demo:// 不是可直接交给Image显示的系统图片地址,这里只用于声明资源标识;迁移到媒体资源时应换成受权限和生命周期约束的真实URI。
还有一个扩展点:标签用逗号串接便于演示,却不适合长期维护复杂关系。若出现“海”误命中“海港”的需求冲突、标签别名和多语言同义词,应改成 PHOTO 与 PHOTO_TAG 两张表,并为标签建立索引。不能靠给字符串两端不断补百分号解决所有语义问题。
三、翻页先稳定排序,再谈去重
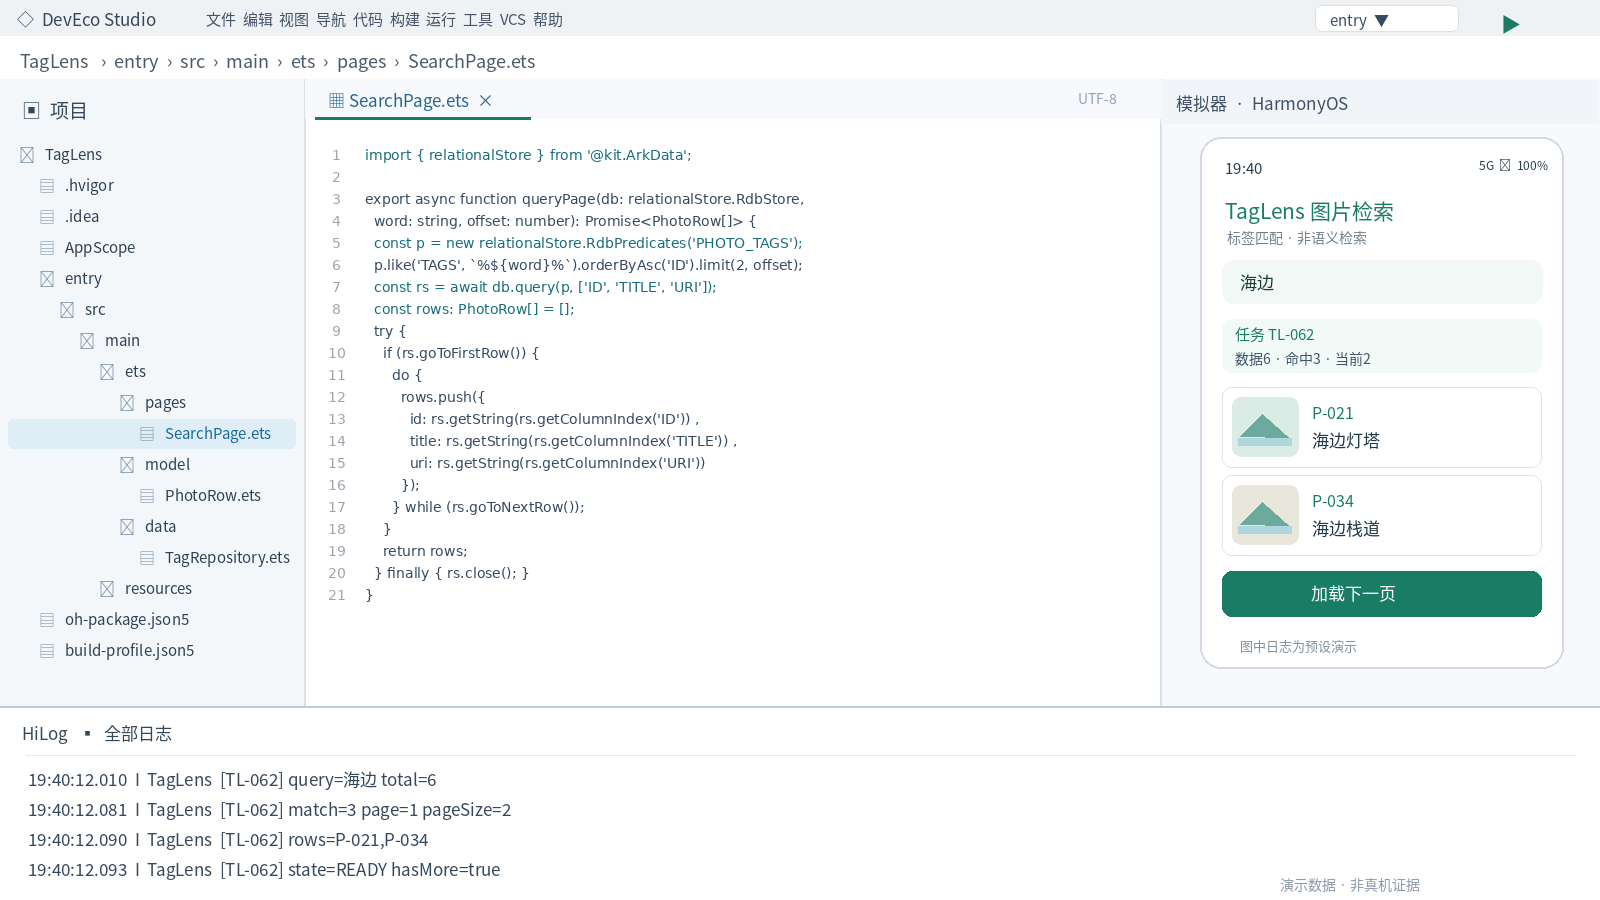
下面的代码处理数据库查询的关键路径:按标签模糊匹配、按ID升序、限制每页两条,并确保 ResultSet 在正常或异常路径都关闭。RdbPredicates 会生成查询条件,ResultSet 负责逐行读取。它们不是图片解码API,也不会自动解析自然语言。
import { relationalStore } from '@kit.ArkData';

export interface PhotoRow { id: string; title: string; uri: string; }

export async function queryPage(db: relationalStore.RdbStore,
  word: string, offset: number): Promise<PhotoRow[]> {
  const p = new relationalStore.RdbPredicates('PHOTO_TAGS');
  p.like('TAGS', `%${word}%`).orderByAsc('ID').limit(2, offset);
  const rs = await db.query(p, ['ID', 'TITLE', 'URI']);
  const rows: PhotoRow[] = [];
  try {
    if (rs.goToFirstRow()) {
      do {
        rows.push({
          id: rs.getString(rs.getColumnIndex('ID')),
          title: rs.getString(rs.getColumnIndex('TITLE')),
          uri: rs.getString(rs.getColumnIndex('URI'))
        });
      } while (rs.goToNextRow());
    }
    return rows;
  } finally { rs.close(); }
}
先排序、后分页是基本前提。如果第一页以创建时间排序、第二页又按文件大小排序,重复数据并不是框架的锅,而是查询协议不稳定。即使排序正确,在索引数据持续插入或删除时,OFFSET 方案仍可能漏项或重复;本篇用六条固定数据说明流程。生产环境可使用(sortKey, ID)游标翻页,或让一次搜索绑定数据快照。页面侧再按ID去重是防线,不是索引设计的替代品。
关键词还需要做长度限制、空白处理及转义检查。SQL LIKE 中的 %、_ 有特殊含义,直接把任意输入拼进模式可能产生意外的全量匹配。本例以普通词“海边”演示,真实输入必须制定转义协议;不能把 LIKE 的行为宣传成精确分词。数量增大后要评估全文索引和数据迁移,不要默认普通字段模糊匹配永远足够快。
四、慢查询返回时,页面可能早已换词
在真实界面里,用户输入“海边”后,可能还没翻完第一页就改成“森林”。如果上一个异步结果回来得更晚,只靠清空数组会出现旧图重新混入。这里借用简单的自增代号,并把它与查询词、偏移量一起作为一次请求的上下文。它解决的是页面状态污染,不保证数据库工作本身被取消。
// TagLensPage 的成员方法片段;db与rows由页面注入或维护
private requestId: number = 0;
private alive: boolean = true;
@State rows: PhotoRow[] = [];
@State stateText: string = 'IDLE';

async search(word: string, db: relationalStore.RdbStore): Promise<void> {
  const request = ++this.requestId;
  const normalized = word.trim();
  this.rows = [];
  if (normalized.length === 0) { this.stateText = 'EMPTY_QUERY'; return; }
  this.stateText = 'LOADING';
  try {
    const first = await queryPage(db, normalized, 0);
    if (!this.alive || request !== this.requestId) { return; }
    for (const item of first) {
      if (!this.rows.some((row: PhotoRow) => row.id === item.id)) {
        this.rows.push(item);
      }
    }
    this.stateText = this.rows.length === 0 ? 'NO_MATCH' : 'READY';
  } catch (e) {
    if (this.alive && request === this.requestId) { this.stateText = 'INDEX_ERROR'; }
  }
}
// aboutToDisappear 中:this.alive = false; ++this.requestId;
requestId 不是业务任务ID TL-062。前者每次输入变化都会增加,用来判定结果是否过期;后者用于排障日志关联和截图说明。alive 代表组件是否仍允许接纳结果,页面退出时失效;再次进入应由新实例重新创建可用状态。若使用缓存的长期服务对象,不能简单把共享alive设为永久false,还要按订阅者管理生命周期。
为了展示更完整的产品状态,空结果至少分为三种:没有输入、正常查询但没有命中、数据库打开或读取失败。它们不能都显示“暂无图片”。用户看到第三种提示时应该能点击“重试”;没有命中的页面则可以建议调整标签词,但不应悄悄改成联网搜索,更不能未经授权上传照片内容。
五、把示意图当作验收清单,而不是跑分证据
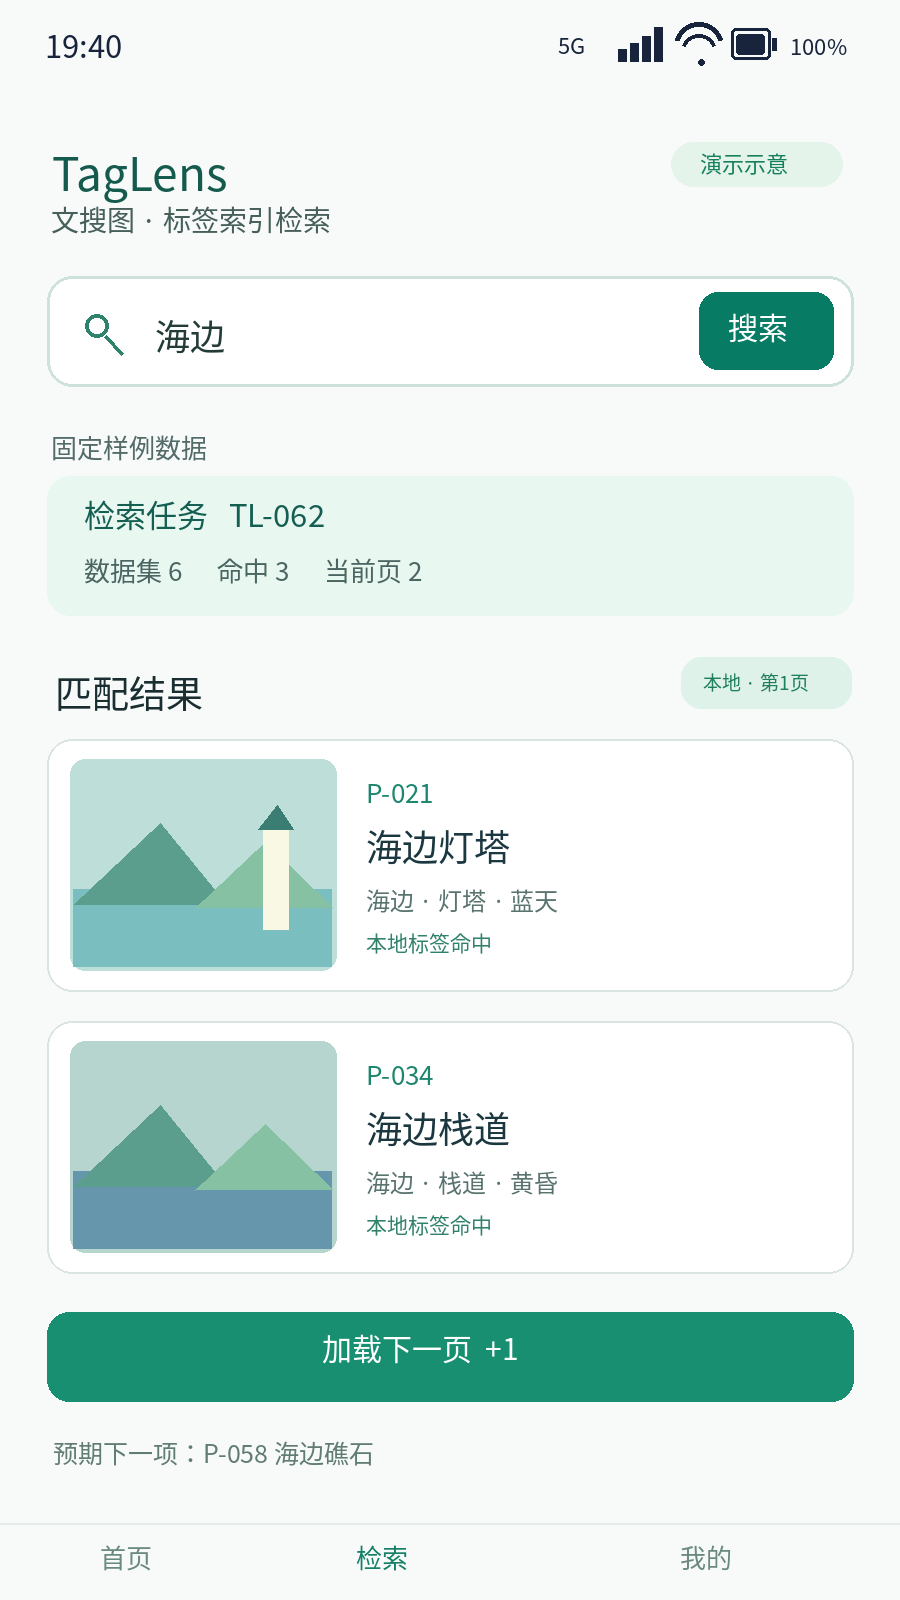
本篇手机图展示的是约定好的固定场景:时间19:40,任务TL-062,输入“海边”,数据集6,命中3,第一页2条(P-021、P-034),还有1条在下一页。开发图的HiLog也是为了说明如何组织日志的示意文字,不表示实际设备已运行。日志建议至少包含request、query、offset、rows、state,但应避免原样记录可能包含隐私的用户输入;正式产品可使用脱敏词指纹。
验收可以按四组反例推进。第一组连续初始化两次,检查相同ID没有被插入两份;第二组先请求第一页、再请求下一页,检查P-058只出现一次;第三组把查询从“海边”改成“森林”,延迟旧请求的完成顺序,确认旧结果被丢弃;第四组删除一个图片的实际文件但保留索引,确认出现资源不可用提示而不是崩溃。本文只给出预期验收方法,没有宣称这些实验已经完成。
如果后续换成端侧向量搜索,索引中应保留版本、来源、图片ID和模型版本等字段,并将向量相似度与标签匹配分开标记。那时“文搜图”才可能覆盖自然语言描述图片的更多场景;现在这份实现保持朴素,但接口和失败边界明确,适合做后续复杂检索的可测基线。
六、技术边界与进一步阅读
本例依赖本地关系型数据库,默认没有跨设备同步、没有系统照片扫描权限,也没有端侧视觉模型推理。数据库已损坏、媒体URI已失效、标签发生多语言歧义、数据量上升到几十万项等情况,需要新的产品策略,不能拿固定六张示例图推导性能结论。生产环境还应处理数据库迁移、并发写入、图片权限时效及用户删除数据后的清理。
以上API名称与用途按华为官方 ArkData 关系型数据库文档和 RdbPredicates、ResultSet 参考核对;因为没有本地DevEco编译环境,代码按核心路径给出,具体SDK约束、类型检查和实际设备表现应以项目构建结果为准。
官方资料: 关系型数据库指南 · RdbPredicates参考 · ResultSet参考。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)