
ArkTS Worker:文搜图候选排序版本栅栏与旧回包隔离【鸿蒙心迹】
搜索框里输入“雨后街灯”,页面先返回一组图片;紧接着用户换了关键词,旧搜索的结果却慢半拍抵达。列表瞬间回到上一个查询,使用者看不出来发生了什么,开发者也很容易把它误判成列表刷新问题。对于文搜图应用,算出相似度只是后半段工作,确保结果属于当前请求反而是前面的工程边界。
本文用 LensQueue 做一条最小闭环:主线程保留搜索状态,ArkTS Worker 在独立线程处理已有向量的相似度计算,结果回到页面之前经过版本栅栏。场景中的 48 张候选图、任务 IMG-083、三个命中项,以及 rev=4 均是人工构造的示例数据,不代表调用了真实向量模型,也不代表真机性能记录。
一、先明确文搜图链路到底分哪几层
真实的文搜图通常包括媒体索引、图像和文本向量化、相似度计算、候选排序以及结果展示。前几步可能依赖模型、数据库或专门的系统能力,本篇不把它们笼统包装成一个神奇的“搜索 API”。我们只验证已有向量进入排序阶段时的线程通信与结果归属,把模型推理与媒体读取留在独立模块中。
假设主线程已经拿到每张图片的向量,查询语句也已经转成同维度查询向量。这里采用二维向量,目的是让排序逻辑可读,而不是宣称二维数据可以完成实际的语义检索。项目把文件分为 pages/SearchPage.ets、workers/RankWorker.ets、model/SearchProtocol.ets。前者只负责交互与状态,中间模块承担数值运算,协议文件定义跨线程允许传递的普通数据。
容易混淆的第一件事是“停止显示旧结果”和“终止旧计算”。这不是同一个动作。用户切换查询后,即便 Worker 中的旧排序尚在进行,只要页面不接受旧版本回包,就能避免视觉结果倒退;但 CPU 资源可能仍然消耗。真实项目若候选量很大,还需要在投递频率、工作负载和 Worker 调度上继续做限制。本篇讨论的是逻辑取消,而不是中断系统线程。
1. 用可重现的样本确定结果,而不是猜模型分数
首先解决“演示截图与代码数据不一致”的问题:48 个候选中指定 P-018、P-021、P-037 的向量更接近查询,其他样本统一放在正交方向。这样结果顺序由数学计算得出,稳定可解释。
// model/SearchProtocol.ets:仅用于演示的固定向量样本
export interface VectorItem { id: string; values: number[] }
export interface RankRequest { jobId: string; rev: number;
  query: number[]; items: VectorItem[] }
export interface RankReply { jobId: string; rev: number; ids: string[] }

export function demoItems(): VectorItem[] {
  const items: VectorItem[] = [];
  for (let n = 1; n <= 48; n++) {
    const id = `P-${n.toString().padStart(3, '0')}`;
    let values: number[] = [0, 1];
    if (n === 18) values = [1, 0];
    if (n === 21) values = [0.9, 0.1];
    if (n === 37) values = [0.8, 0.2];
    items.push({ id, values });
  }
  return items;
}
这段数据生成器不会访问相册,它只提供一组可检查的输入。jobId 识别一次业务会话,rev 区分同一会话里连续发出的查询,二者不能互相替代。跨 Worker 只发送数字、字符串和数组,避免传递页面组件实例或带有业务句柄的复杂对象。后续接入真实向量库时,只需要保持协议不变,并检查向量长度、有限值和归一化策略。
二、页面维护一个事实:当前查询版本是多少
1. Worker 只回报计算,页面才决定是否采用
UI 页面必须能回答三个问题:搜索是否仍在等待、结果来自哪次请求、离开页面是否还可能收到消息。这里用 activeRev 作为单调递增的版本号;旧消息仍然可以到达,但不会改写当前结果。重点是把监听器在页面出现时绑定、离开时释放,不让已退出的页面继续响应线程消息。
下方代码解决 Worker 创建、消息验收和资源释放。为突出状态管理,仅展示页面的关键成员与生命周期片段;它们位于同一个 @Entry @Component 组件内。
// pages/SearchPage.ets(关键成员,import 协议类型与 worker)
import { worker, MessageEvents } from '@kit.ArkTS';
import { RankRequest, RankReply, demoItems } from '../model/SearchProtocol';

@Entry
@Component
struct SearchPage {
  @State keyword: string = '雨后街灯';
  @State activeRev: number = 0;
  @State resultIds: string[] = [];
  @State status: string = '待检索';
  private rankWorker?: worker.ThreadWorker;
  private readonly jobId: string = 'IMG-083';

  aboutToAppear(): void {
    this.rankWorker = new worker.ThreadWorker('entry/ets/workers/RankWorker.ets');
    this.rankWorker.onmessage = (event: MessageEvents): void => {
      const reply = event.data as RankReply;
      if (reply.jobId !== this.jobId || reply.rev !== this.activeRev) {
        console.info(`LensQueue job=${reply.jobId} rev=${reply.rev} ignored`);
        return;
      }
      this.resultIds = reply.ids;
      this.status = '已更新';
      console.info(`LensQueue job=${reply.jobId} rev=${reply.rev} results=${reply.ids.length}`);
    };
  }

  aboutToDisappear(): void {
    this.activeRev++; // 令可能在途的消息立即失效
    this.rankWorker?.terminate();
    this.rankWorker = undefined;
  }

  private submitSearch(): void {
    if (!this.keyword.trim() || !this.rankWorker) return;
    this.activeRev++;
    this.status = '检索中';
    this.resultIds = [];
    const request: RankRequest = {
      jobId: this.jobId, rev: this.activeRev,
      query: [1, 0], items: demoItems()
    };
    this.rankWorker.postMessage(request);
  }

  build() {
    Column({ space: 14 }) {
      Text('LensQueue 文搜图').fontSize(24)
      TextInput({ text: this.keyword, placeholder: '输入关键词' })
        .onChange((value: string) => { this.keyword = value; })
      Button('开始检索').onClick(() => this.submitSearch())
      Text(`任务 ${this.jobId} | rev=${this.activeRev} | ${this.status}`)
      ForEach(this.resultIds, (id: string) => { Text(id).fontSize(18) },
        (id: string) => id)
    }.padding(20).width('100%')
  }
}
这里的 activeRev++ 是整个方案的分水岭:每次点击先宣告旧结果失效,再发送新任务。回包必须同时匹配 jobId 与 rev;只比对关键词会漏掉用户连续两次输入相同文字的情况。resultIds 是业务数据,组件是否以三列卡片、单列列表或缩略图网格呈现,都不改变它的归属规则。
terminate() 用于页面不再需要 Worker 时释放线程资源;它不是每次修改关键词都要做的操作。对于有页面缓存或多路复用的应用,应把创建与销毁放到真正对应的宿主生命周期中。代码中的 console.info 便于定位顺序,实际发布前应避免在日志里记录敏感搜索词和私有文件路径。
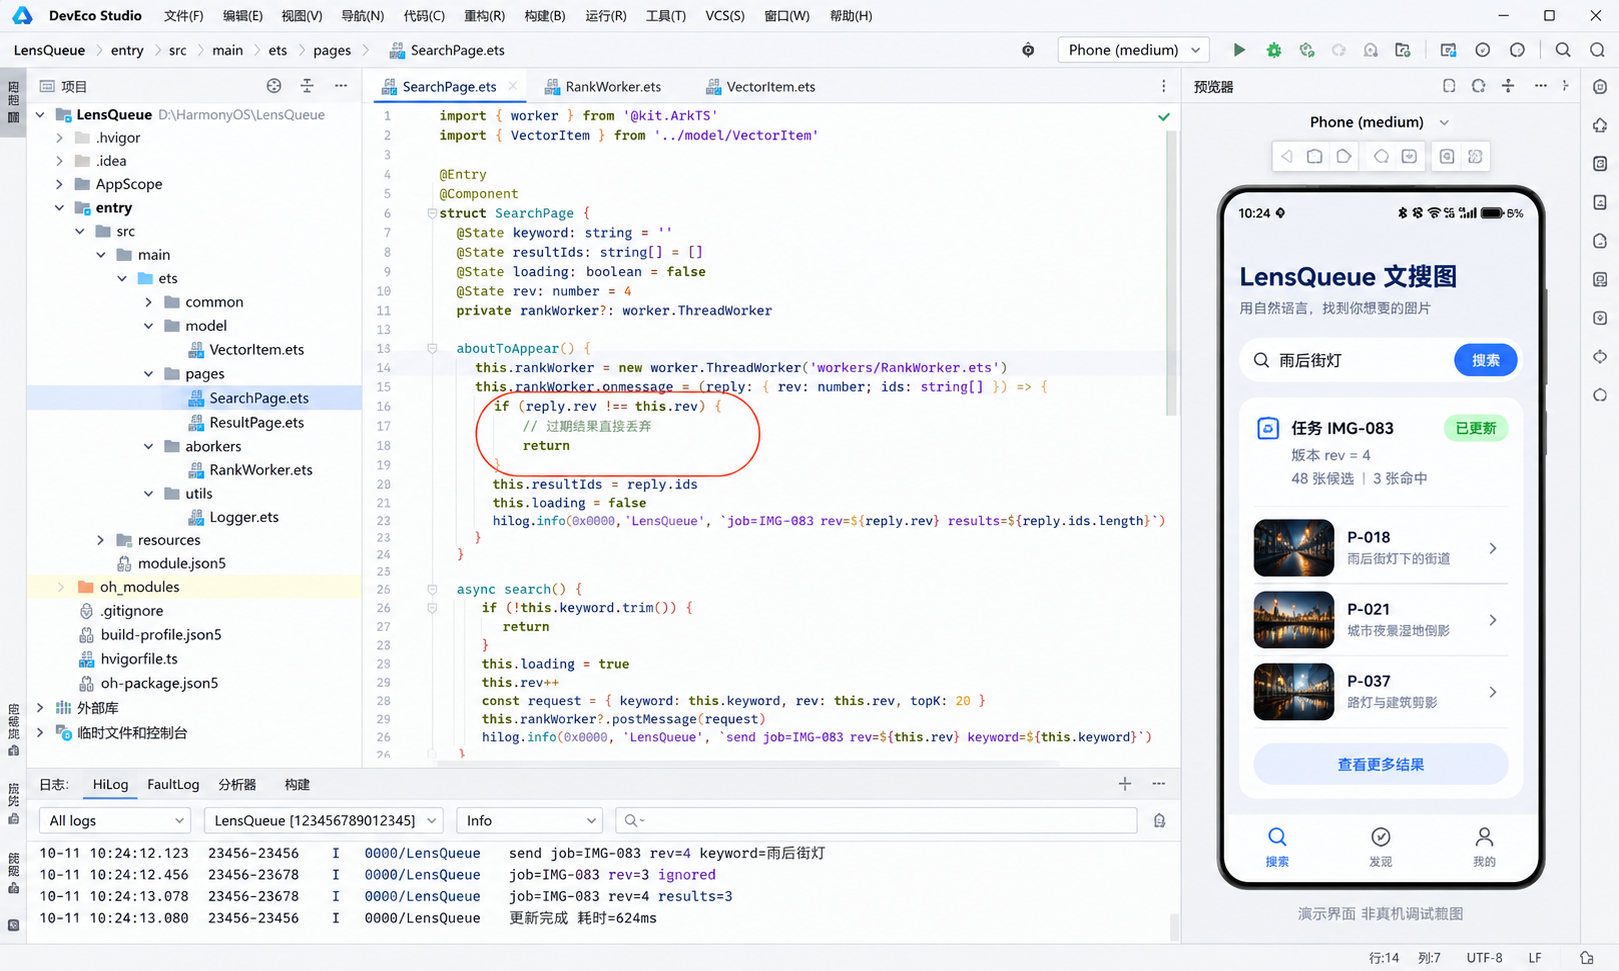
上图是按项目结构绘制的 DevEco Studio 演示图,底部日志表达两件事:rev=3 ignored 不更新界面,rev=4 results=3 才会落入当前列表。图内局部代码为了排版做了省略,实际接入应以正文的 Worker 路径和协议定义为准。它不是已经运行通过的 IDE 证据。
三、排序放到 Worker:不让展示层背负计算细节
Worker 负责数值工作,主线程只接受排序后的 ID。对于已有向量,本例使用余弦相似度;真实模型有自己的向量归一化与排序约定,不能机械套用演示中的阈值。下面的代码解决“消息到了 Worker 之后怎样保持输入输出协议”的问题。
// workers/RankWorker.ets
import { worker, ThreadWorkerGlobalScope, MessageEvents } from '@kit.ArkTS';
import { RankRequest, RankReply, VectorItem } from '../model/SearchProtocol';

const port: ThreadWorkerGlobalScope = worker.workerPort;
function cosine(a: number[], b: number[]): number {
  if (a.length !== b.length || a.length === 0) return -1;
  let dot = 0, aa = 0, bb = 0;
  for (let i = 0; i < a.length; i++) {
    dot += a[i] * b[i]; aa += a[i] * a[i]; bb += b[i] * b[i];
  }
  return aa === 0 || bb === 0 ? -1 : dot / Math.sqrt(aa * bb);
}
port.onmessage = (event: MessageEvents): void => {
  const request = event.data as RankRequest;
  const ids = request.items
    .map((item: VectorItem) => ({ id: item.id,
      score: cosine(item.values, request.query) }))
    .sort((a, b) => b.score - a.score)
    .slice(0, 3).map((item) => item.id);
  const reply: RankReply = {
    jobId: request.jobId, rev: request.rev, ids
  };
  port.postMessage(reply);
};
有两个取舍值得交代。其一,Worker 可以隔离计算负担,却不保证无限制并行;如果每敲一个字都立即投递 48 个候选,队列依旧可能堆积。工程中可以给输入加防抖,或者在任务尚未完成时只保留最新的待处理请求。其二,数值例子里 0 向量返回 -1,是演示约定,不是统一的模型标准;实际项目需要统一异常输入策略,不能靠 sort 悄悄吞掉 NaN。
同一个 Worker 内顺序处理多批请求时,旧回包未必能及时撤销;但只要 UI 在回包阶段比较代际编号,至少不会出现旧查询覆盖新界面的错误。要真正降低浪费,还应减少不必要的向量拷贝、分批索引和重复发送。Worker 通信支持普通数据传递,线程之间并不会自动共享 ArkUI 的 @State。
四、把三类检查点放到日志和页面中
演示约定在第四次有效查询时到达 IMG-083 / rev=4:候选数 48,最终显示 3 张,即 P-018、P-021、P-037。在它之前的 rev=3 消息即使稍后抵达,也只能记录“ignored”,不能再改写当前结果。图片中的“1.2 s”是用于展示布局的占位时长,并非测量数据。
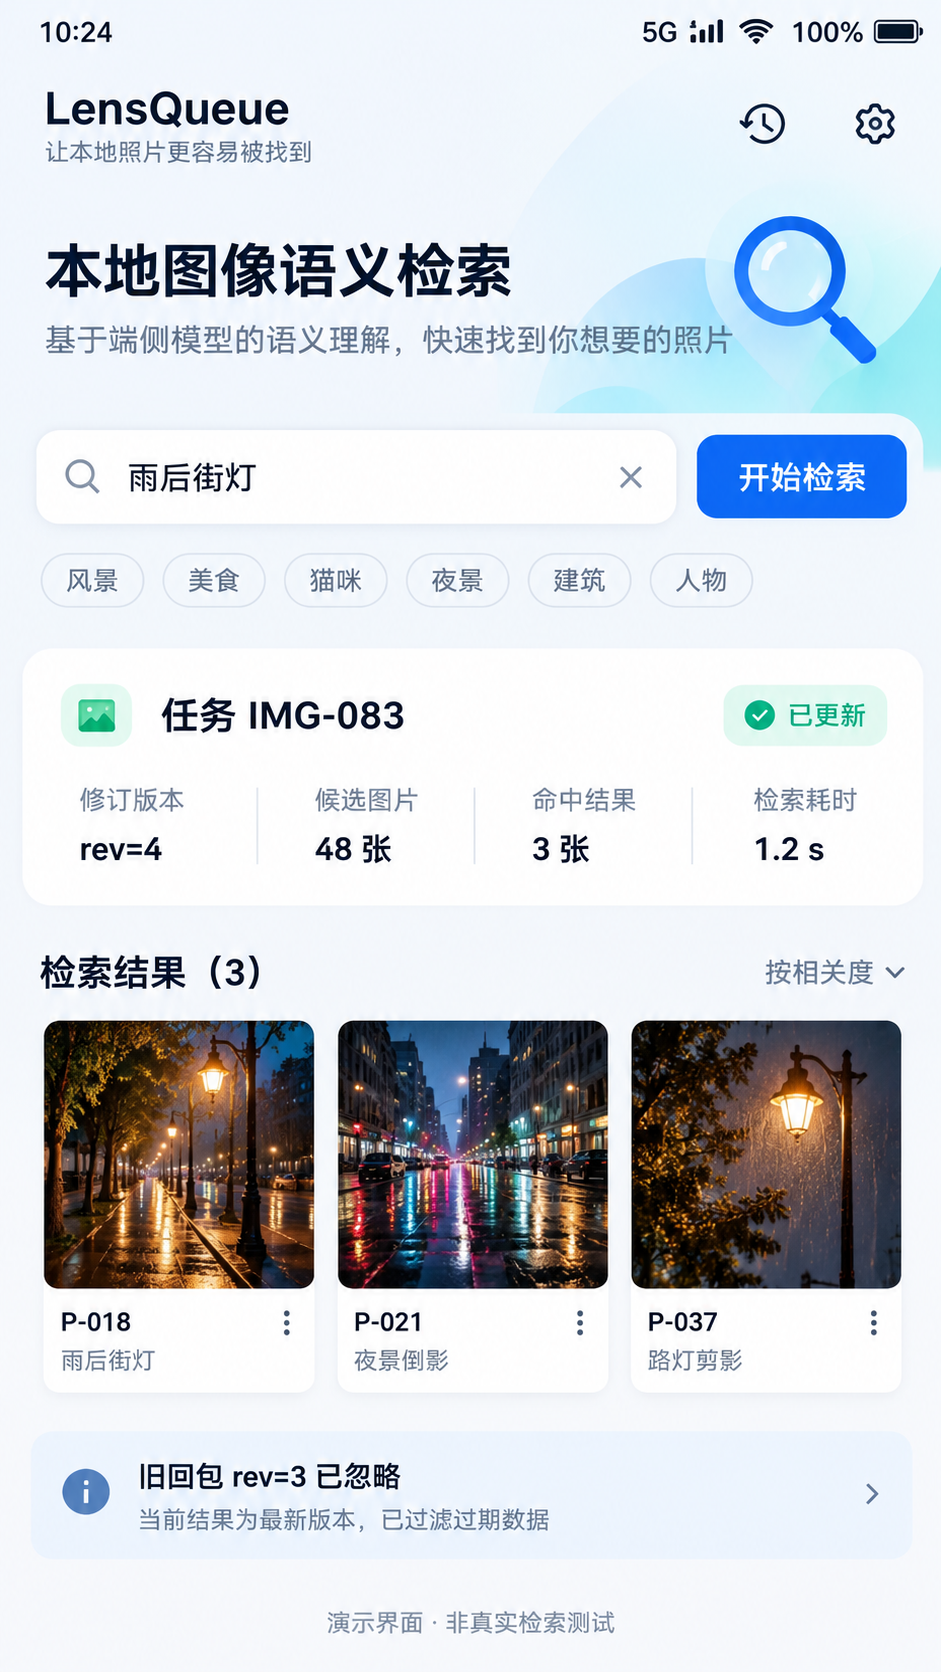
这张竖版图是纯手机界面演示稿。它把任务 ID、版本号、结果 ID 和“旧回包已忽略”放在同一屏上,目的是让人直接检查状态约束。它不能证明模型检索质量,也不能证明 Worker 在特定设备上的吞吐量。配套的验证应分三步:先用固定样本断言三条 ID 的顺序;再人为控制消息到达顺序,确认旧版本始终不覆盖;最后在实际设备上观察频繁输入、切后台、页面销毁和内存变化。
对于多入口搜索页,还要区分页面实例与业务会话。单纯递增页面内的 rev 不足以跨进程重建;恢复状态时应增加会话 ID 或重置接收通道。假如用户切换相册或索引版本,最好让索引版本也进入请求协议,否则“同一个关键词”仍可能引用过期候选。需要离线持久化时,可另外引入 ArkData,而不要把 Worker 当作可靠存储。
五、边界清楚之后,文搜图才好继续扩展
这个实现解决了一个很窄但真实的工程问题:候选评分完成的时间,不应决定界面展示哪一次查询。Worker、版本栅栏和资源释放分别守住计算线程、结果归属和页面生命周期。它们不会代替向量模型,也不能宣称完成了 HarmonyOS 文搜图的系统级能力接入。
本文代码使用官方文档中的 worker.ThreadWorker、workerPort、postMessage、onmessage 和 terminate 形态;在真实项目中仍需结合目标 SDK、工程路径和 ArkTS 静态检查进行编译验证。更值得继续研究的是索引版本升级、候选分批、内存压缩和查询取消协议,而不是给搜索框再加一层动画。
参考资料:
- 华为开发者文档《主线程与 Worker 线程的实时通信》:https://developer.huawei.com/consumer/en/doc/harmonyos-guides-V5/worker-communicates-with-mainthread-V5
- 华为开发者文档《同步任务开发指导(TaskPool 和 Worker)》:https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/sync-task-development
配图为本篇独立生成的界面与封面演示素材,代码未在本次交付环境中进行 DevEco Studio 编译或真机运行。所有任务、图片 ID 与日志为教学情境数据。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献6条内容

所有评论(0)