
从 24 到 25 字节:compactstr4cj 的 CJMP 鸿蒙适配与 UTF-8 实测
前言:给短标签换一种存法
状态码、页面标签、配置项名字,这些字符串通常很短。为了装几个字节,再给内容单独分配一块缓冲区,看起来有些浪费。compact_str 的思路很直接:短内容放进存储体,变长后再切到堆缓冲区。这次 compactstr4cj 的鸿蒙示例就从一个临界值开始看——二十四字节还能内联,二十五字节会发生什么。
先说明“紧凑”的对象。这里的原生存储体是二十四字节,仓颉类通过句柄持有它。仓颉对象、原生句柄分配、FFI 字符串转换仍有开销,所以不能把它写成整个仓颉对象只有二十四字节,或整个调用链零堆分配。本文看的是存储表示与接口语义,没有用一组页面操作去推断性能提升比例。
24、25:先对照页面的读数
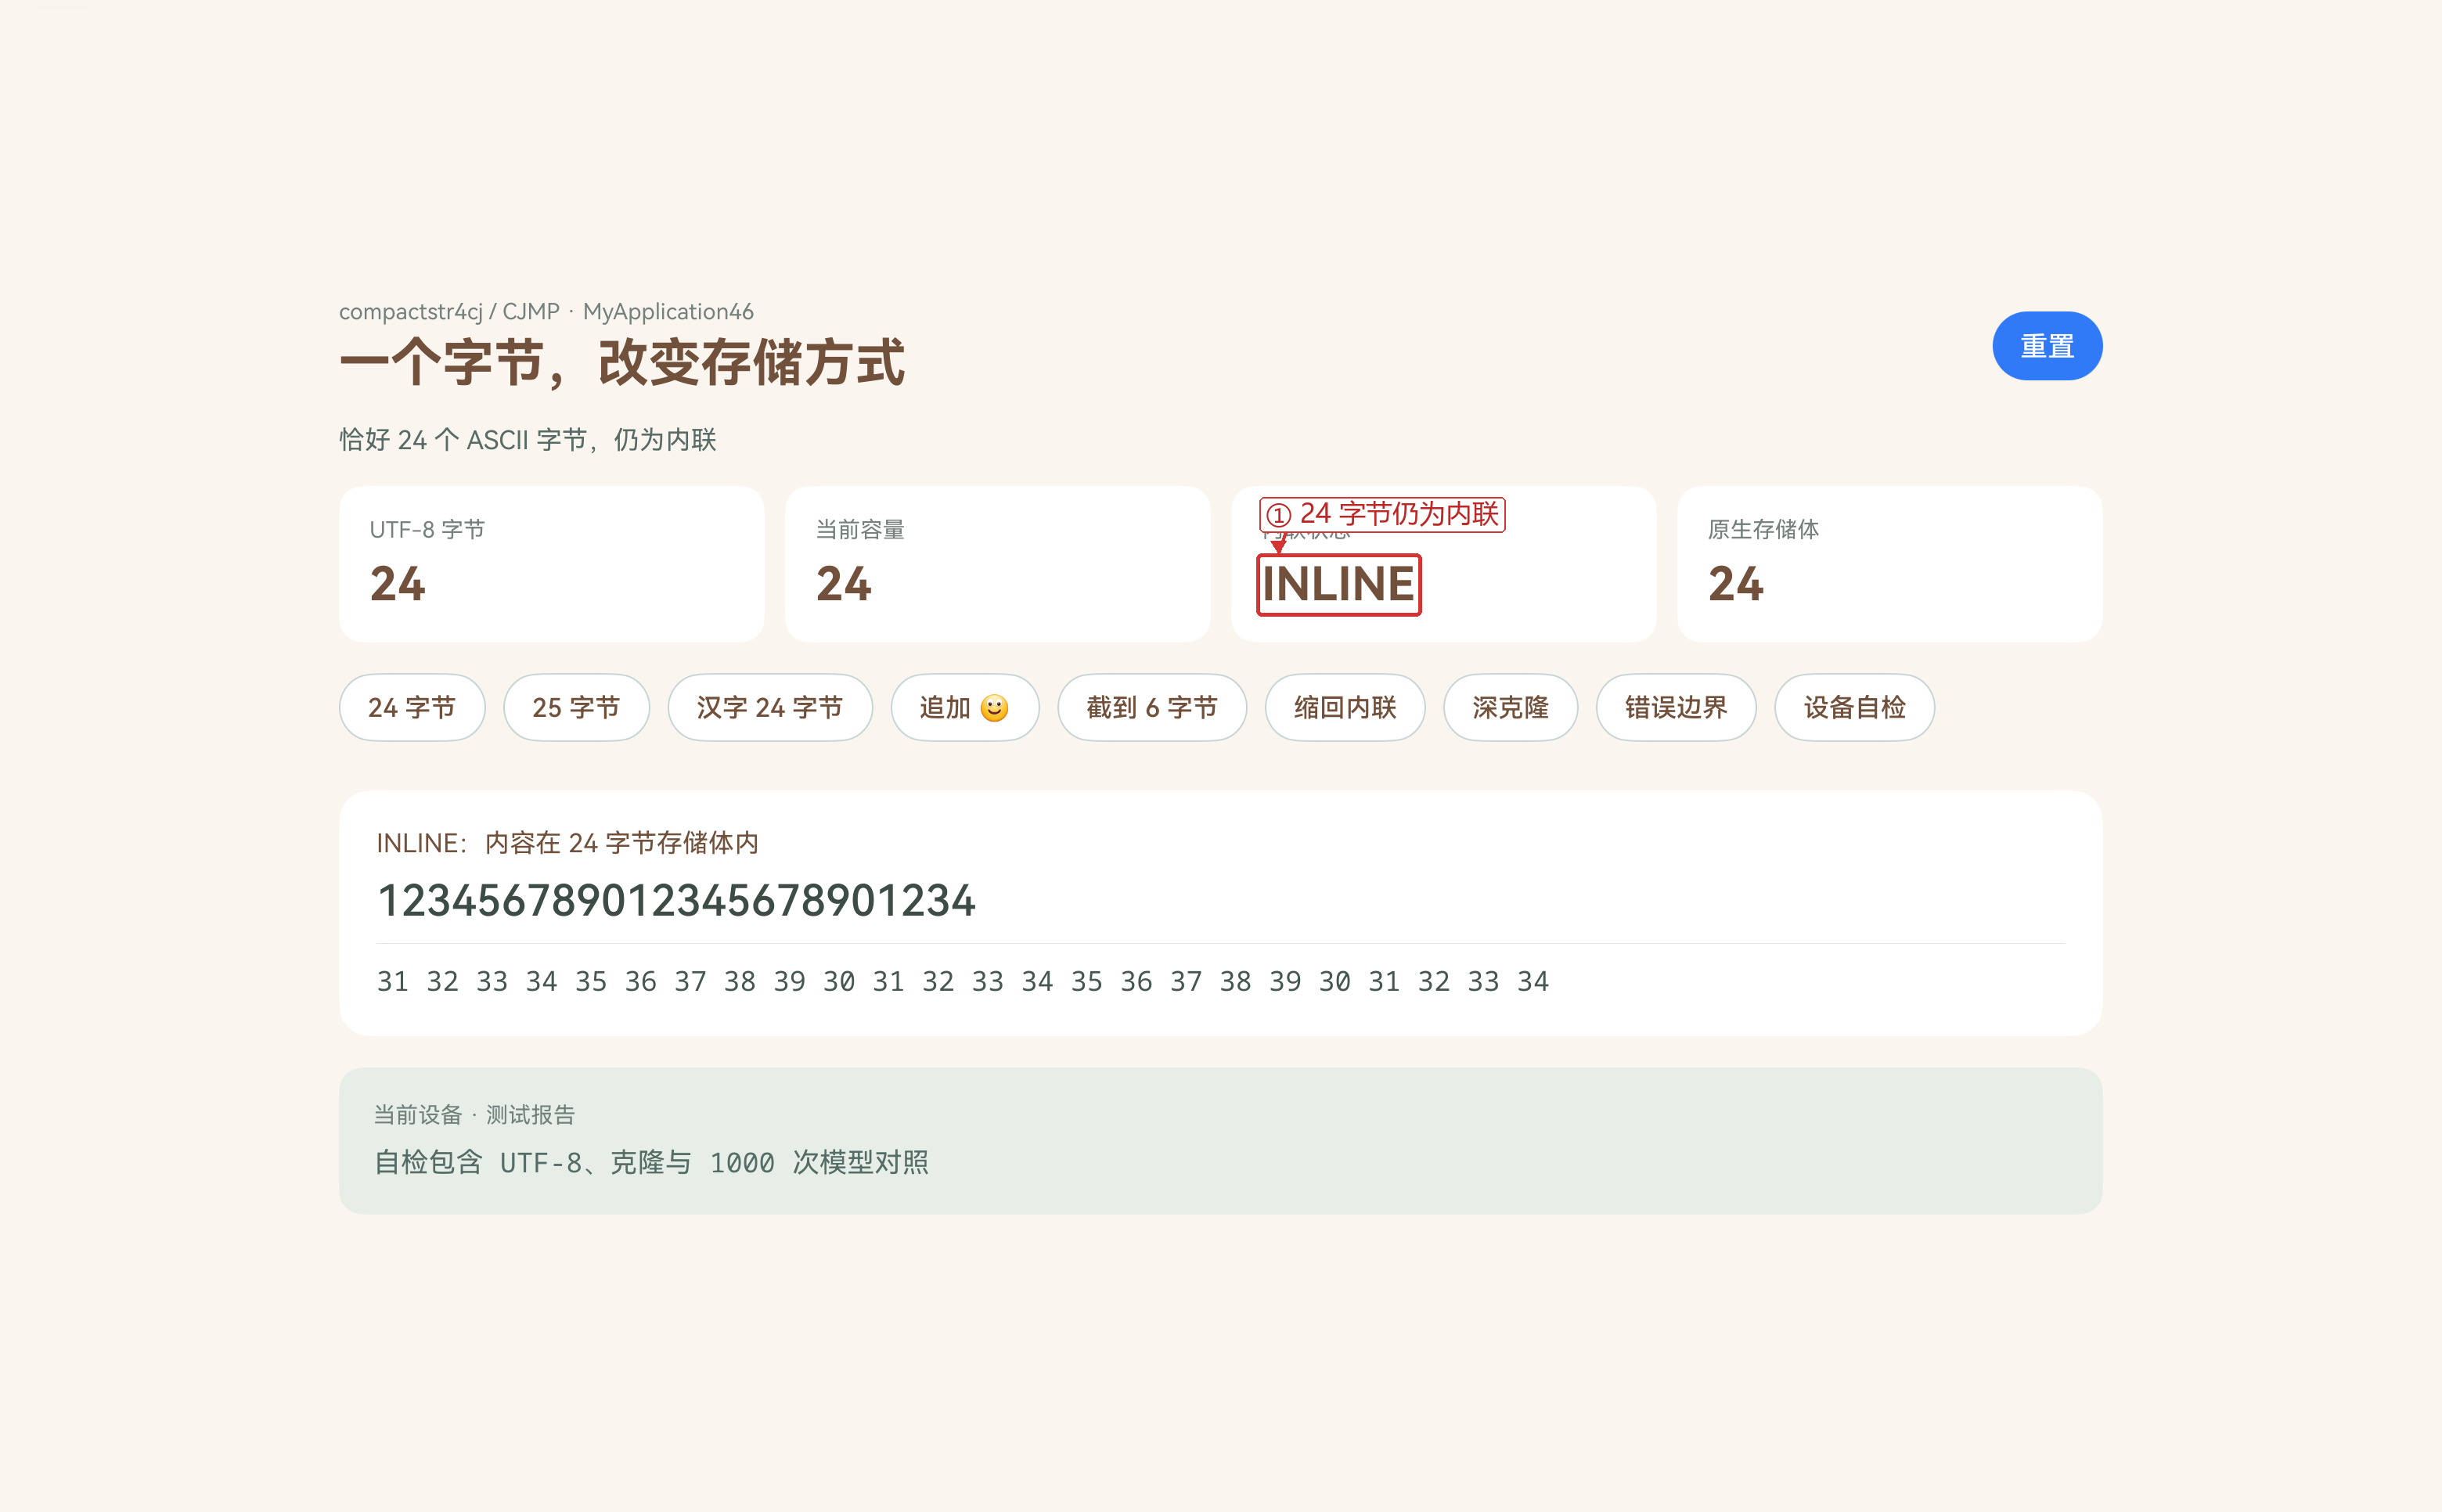
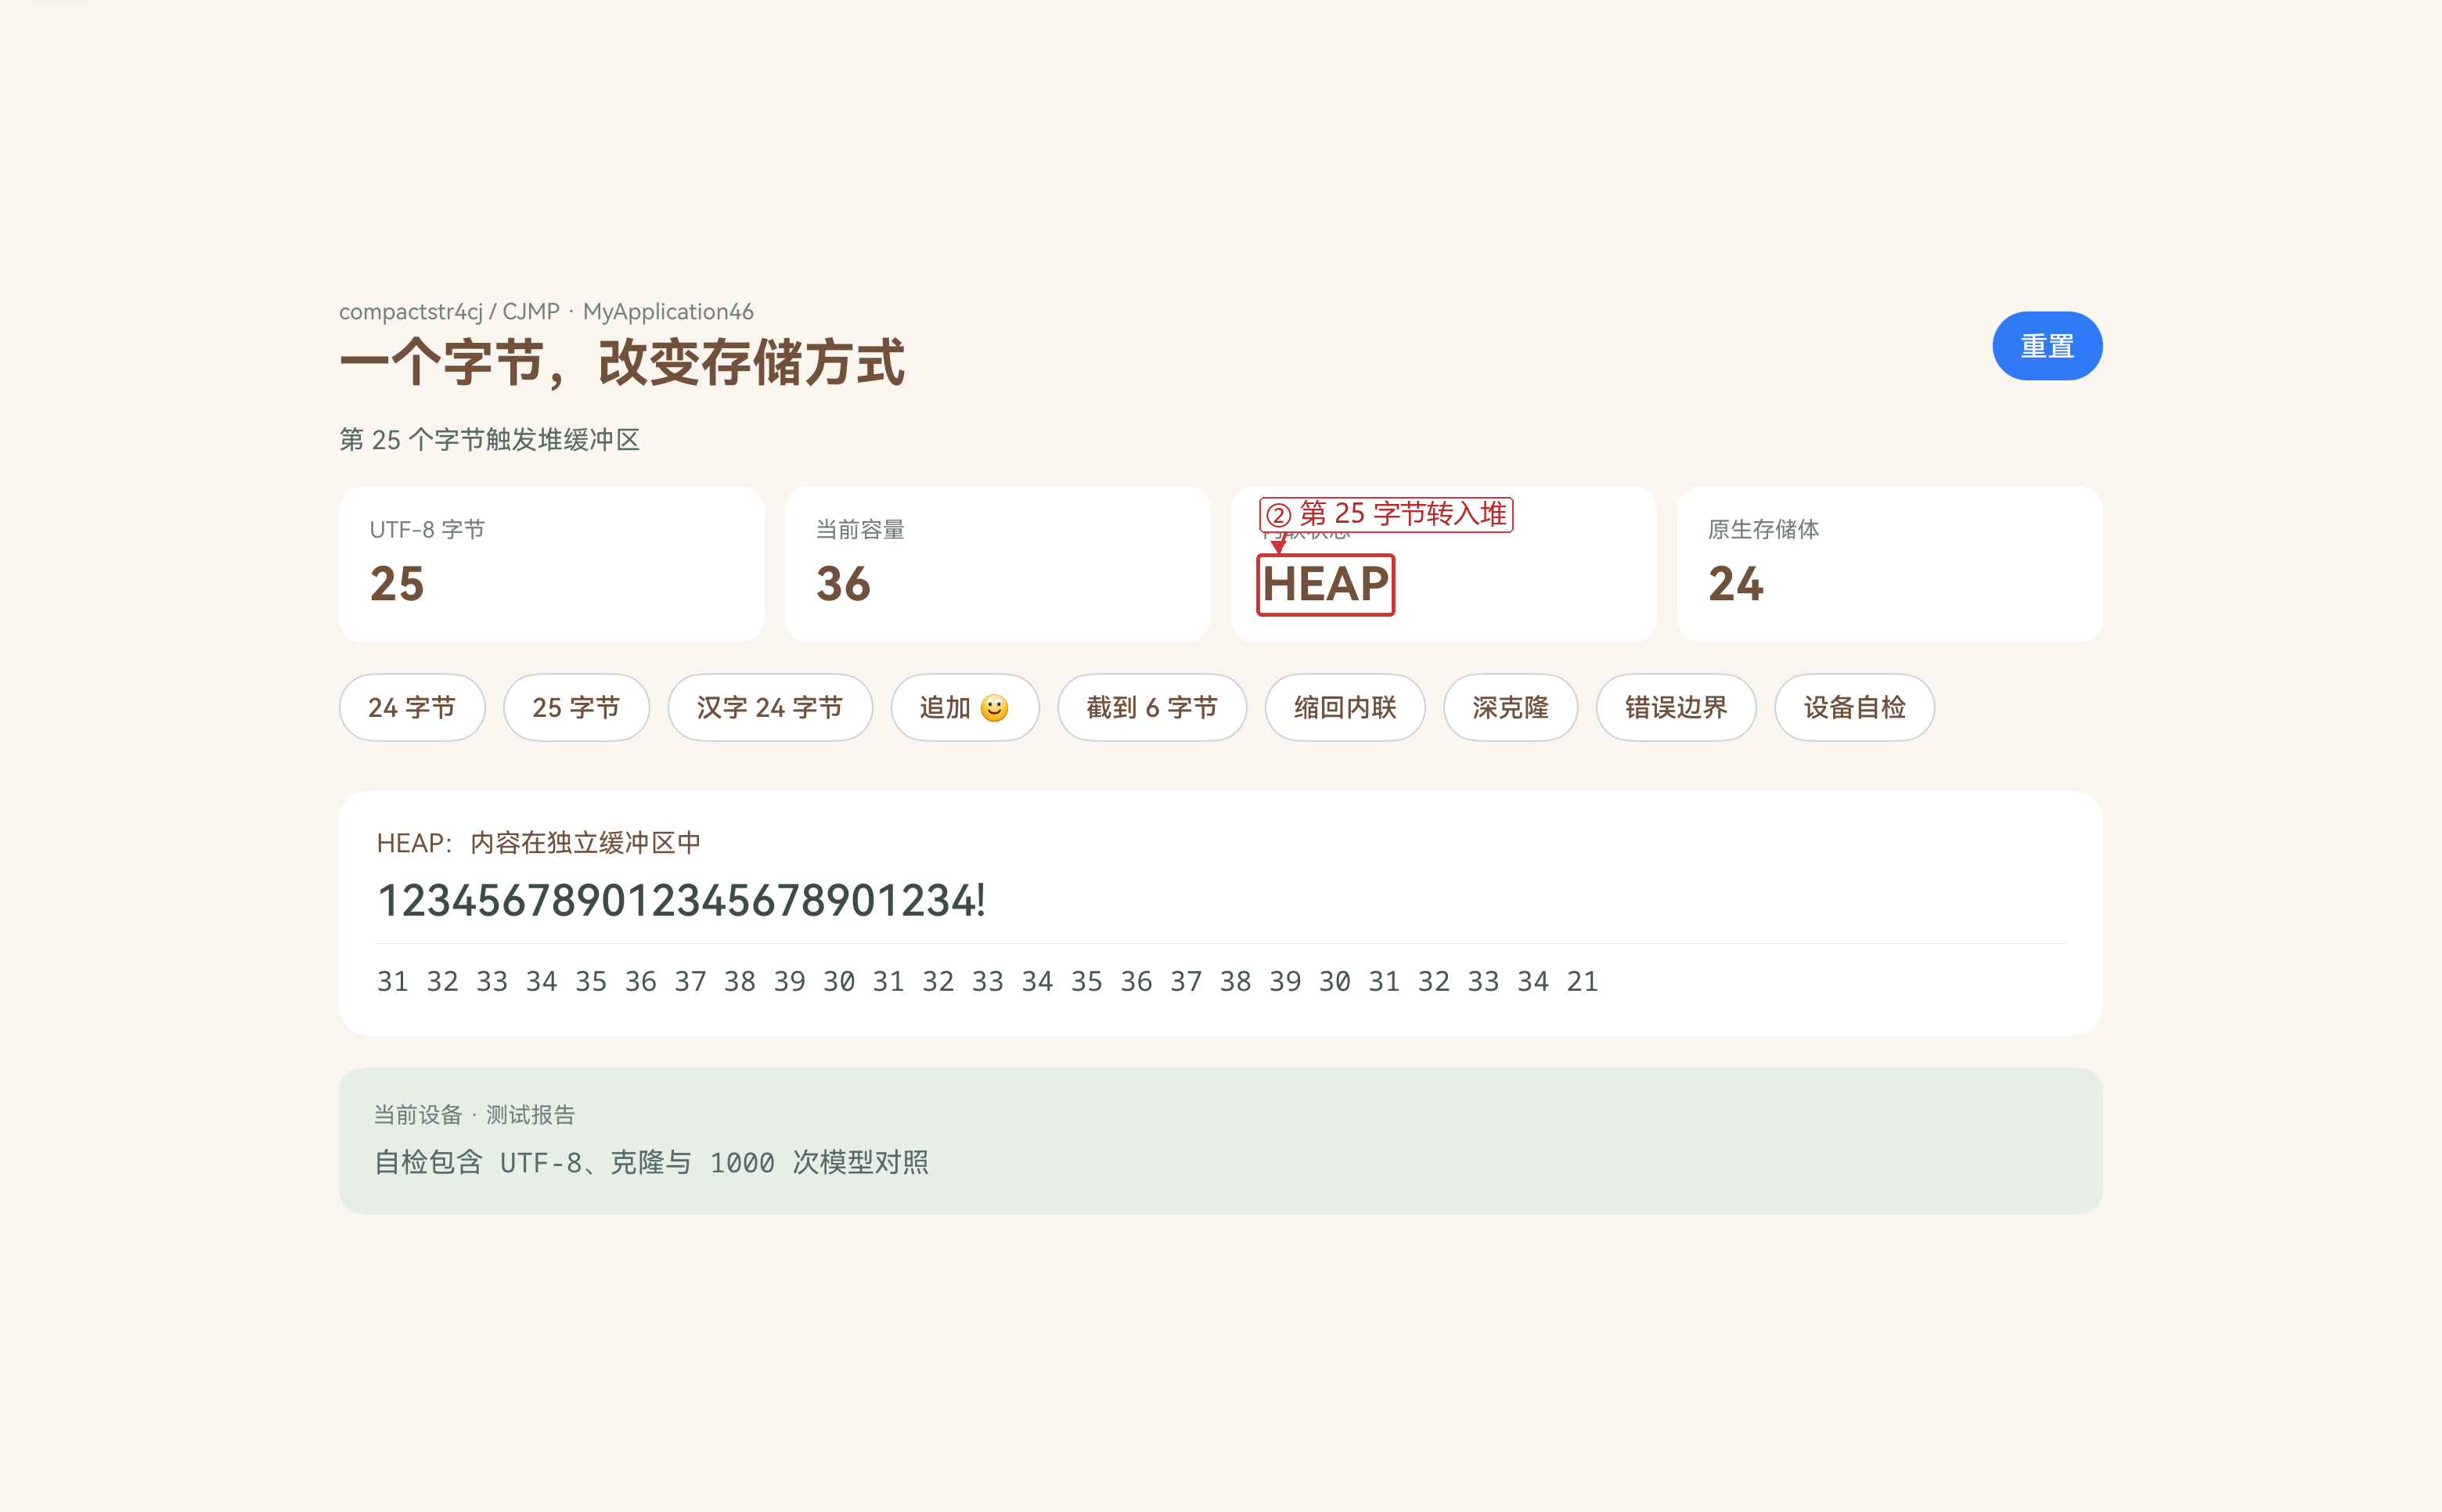
MyApplication46 里有两个相邻按钮。二十四个 ASCII 字节显示 INLINE、容量二十四;再加一个感叹号,长度变为二十五、状态变成 HEAP,容量是三十六。这个容量来自原生后端的增长规则,不是 ArkTS 根据长度猜出的标签。页面的长度、容量、内联状态都来自同一个仓颉库结果。
| 输入 / 操作 | 字节数 | 存储状态 |
| 24 个 ASCII 字节 | 24 | INLINE |
| 24 个 ASCII 字节再加 ! | 25 | HEAP,容量 36 |
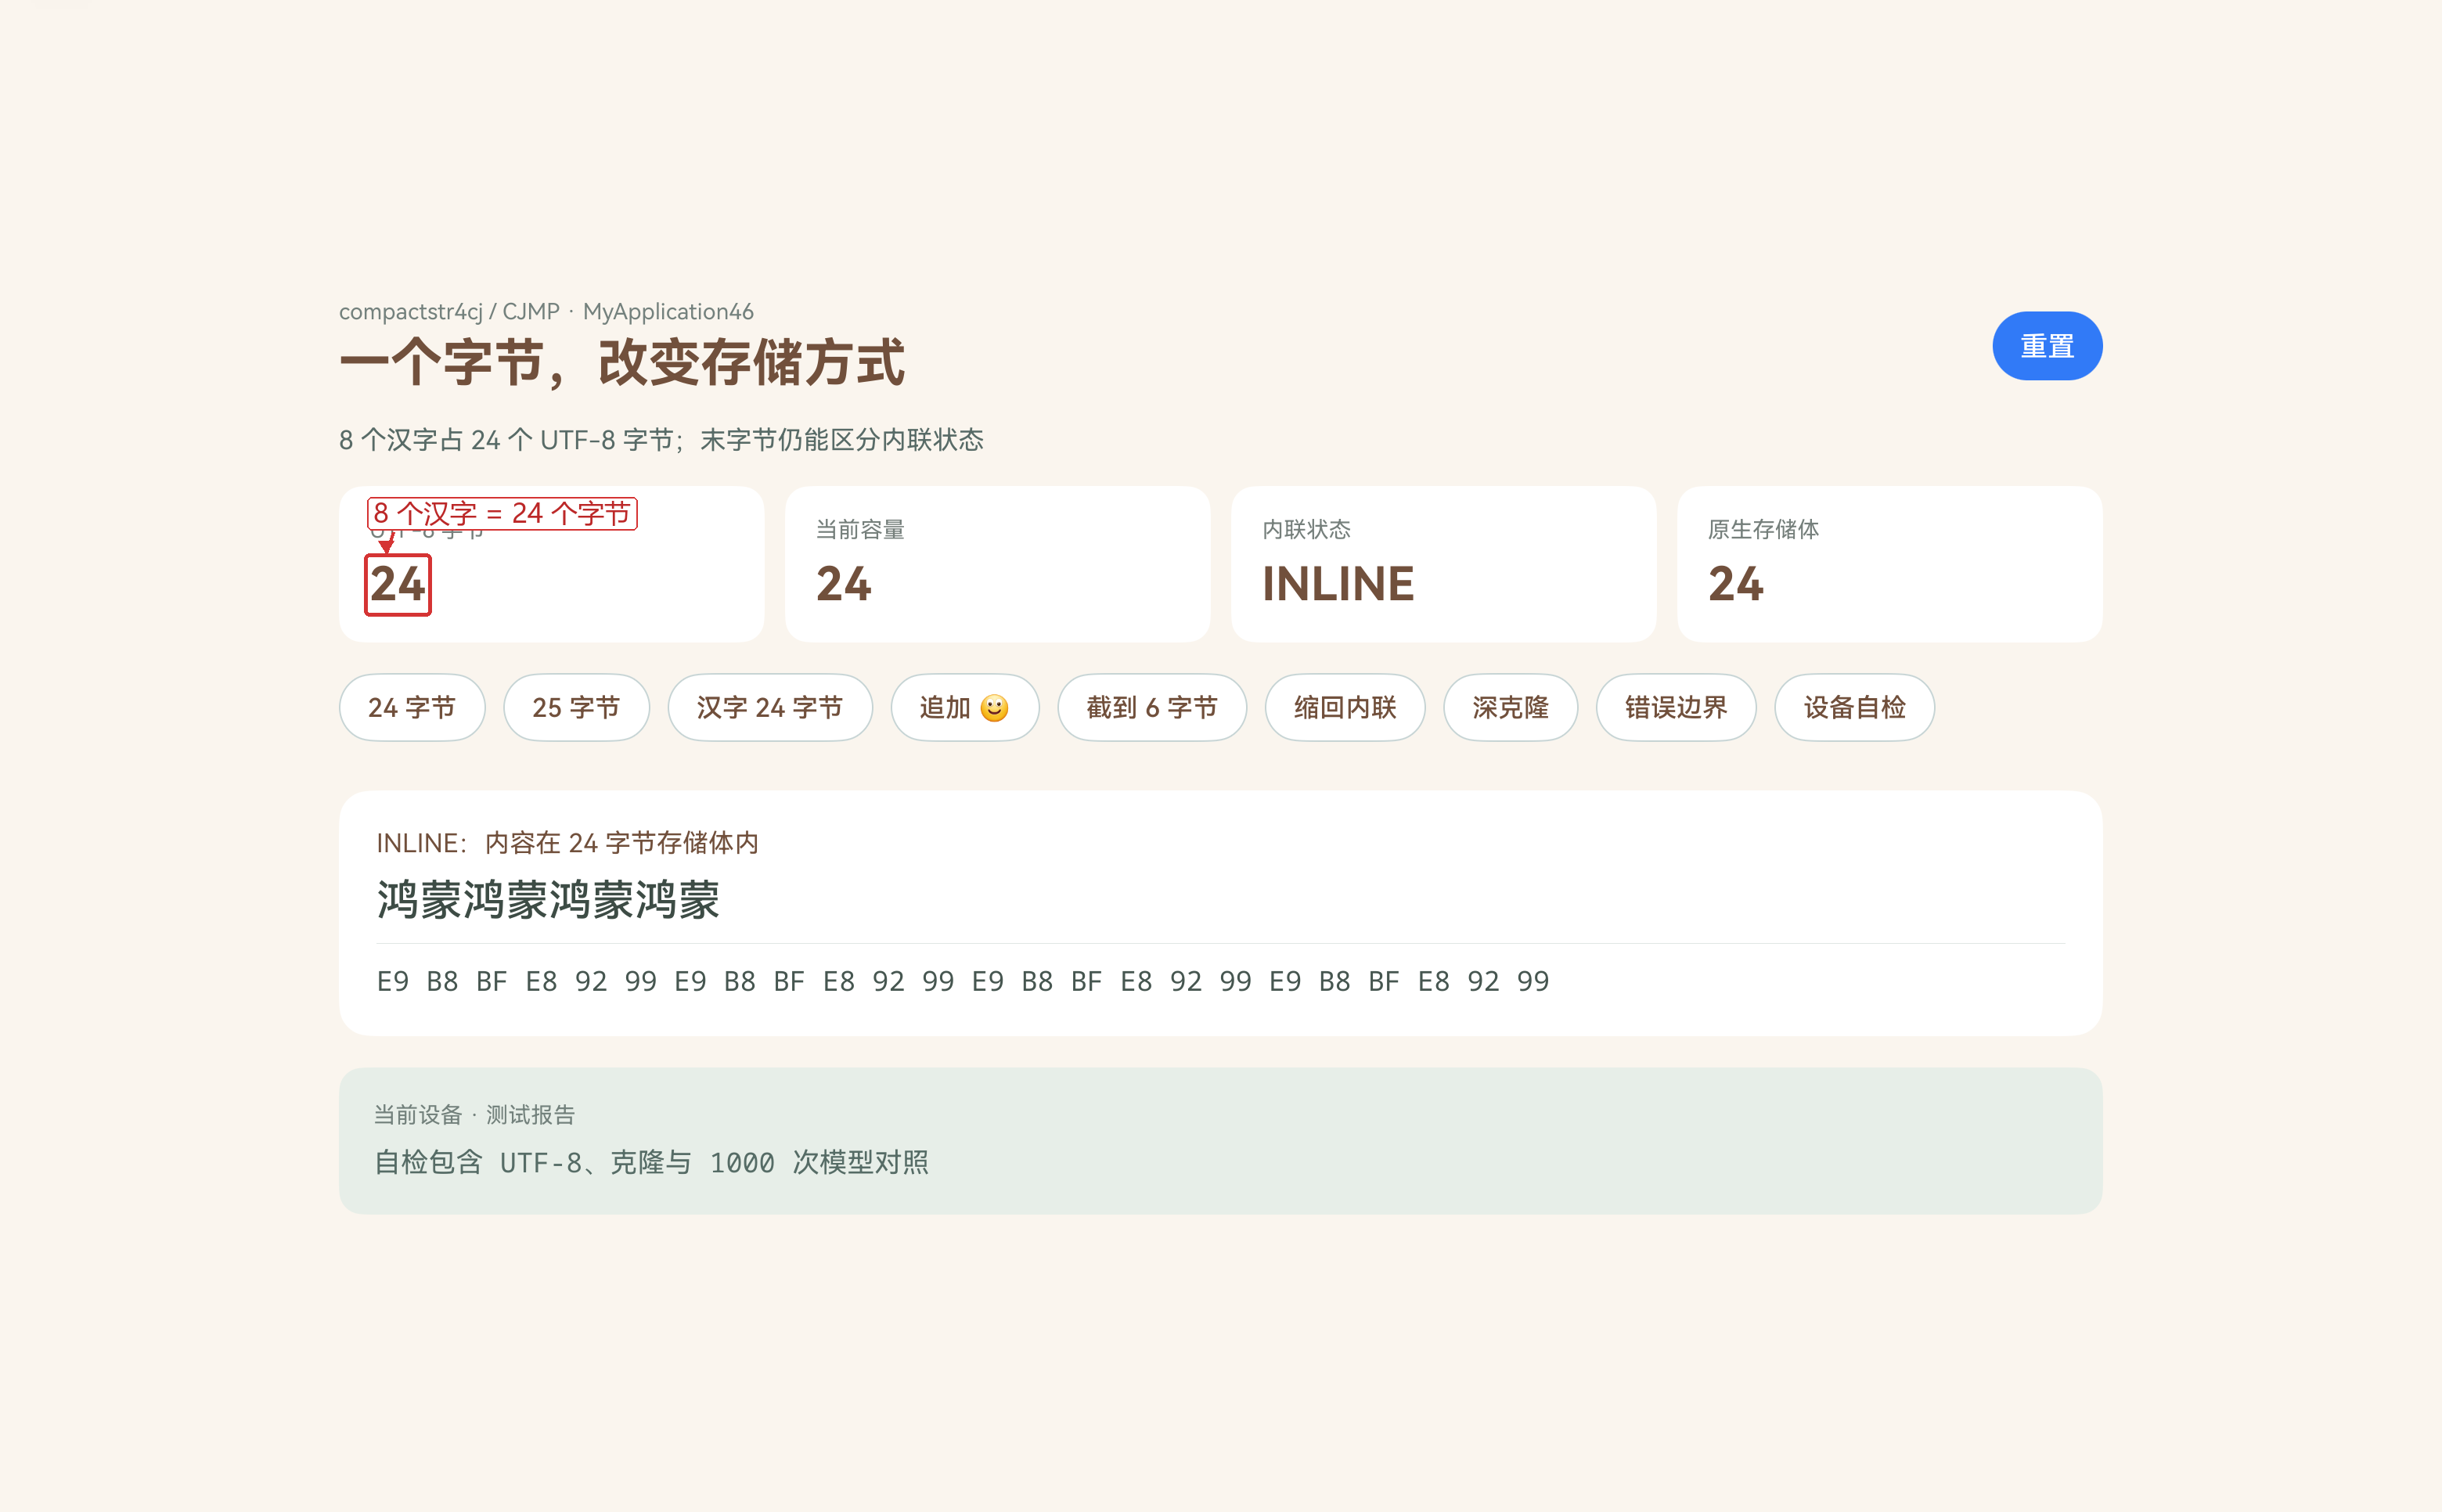
| 鸿蒙重复四次 | 24 | INLINE |
| 上面追加一个 emoji | 28 | HEAP |
| 截到 6 字节 | 6 | 先保留 HEAP |
| 显式 shrinkToFit | 6 | 返回 INLINE |
上游固定提交 9696af7f7a9451478766b19dedac7371594eee0d,compact_str/Cargo.toml 标记 0.10.0。原始 MIT 许可和源码快照随包保留。适配保留了短串内联、长串堆存储的表示思路,但仓颉 API 和 C 后端是明确范围的重实现,没有把 Rust crate 的全部接口和布局承诺一并搬过来。
原生存储体与最后一个字节
typedef union { unsigned char bytes[24];struct {unsigned char *ptr;uint64_t len;unsigned char cap[7];unsigned char tag;} heap; } Compact;
_Static_assert(sizeof(Compact)==24 && sizeof(void*)==8,"64-bit layout required");
#define LIMIT ((uint64_t)64*1024*1024)
static int is_heap(const Compact *s){return s->bytes[23]==0xfe;}
uint64_t cs_len(const Compact *s){return is_heap(s)?s->heap.len:s->bytes[23]>=0xc0?s->bytes[23]-0xc0:24;}
uint64_t cs_capacity(const Compact *s){if(!is_heap(s))return 24;uint64_t n=0;for(int i=0;i<7;i++)n|=(uint64_t)s->heap.cap[i]<<(8*i);return n;}
static unsigned char *data(Compact *s){return is_heap(s)?s->heap.ptr:s->bytes;}
int32_t cs_inline(const Compact *s){return !is_heap(s);}
int32_t cs_sizeof(void){return sizeof(Compact);}
void *cs_new(void){Compact *s=calloc(1,sizeof *s);if(s)s->bytes[23]=0xc0;return s;}
void cs_free(Compact *s){if(s){if(is_heap(s))free(s->heap.ptr);free(s);}}
在当前两种六十四位小端架构上,内联表示和堆表示共用二十四字节。短于阈值时,最后一个字节记录长度;堆状态使用单独标记。恰好二十四字节时没有空位再存长度,但一个完整 UTF-8 字符串的最后一个字节只能是 ASCII 或续字节,可以与较高的状态标记区分。
这也是不能随便装入任意字节数组的原因。后端先验证 UTF-8,包括续字节、过长编码、代理区间和最大码点约束。输入保持合法,最后字节的判别才成立。库当前限定六十四位小端与六十四 MiB 内容上限,三十二位和大端没有验证,也没有按目录名称把它们列为支持平台。
UTF-8 截断:六字节可以,一字节不行
八个汉字正好占二十四个 UTF-8 字节,一个常见 emoji 再占四字节。这些数字跟“看见几个字”不是同一个概念。库的 byteLength、reserve 和 truncate 都按字节工作,所以方法名字和 README 会强调这一点,避免调用方拿字符数直接当偏移量。
int32_t cs_truncate(Compact *s,uint64_t n){
    uint64_t old=cs_len(s);if(n>=old)return 0;
    if((data(s)[n]&0xc0)==0x80)return EILSEQ;
    set_len(s,n);return 0;
}
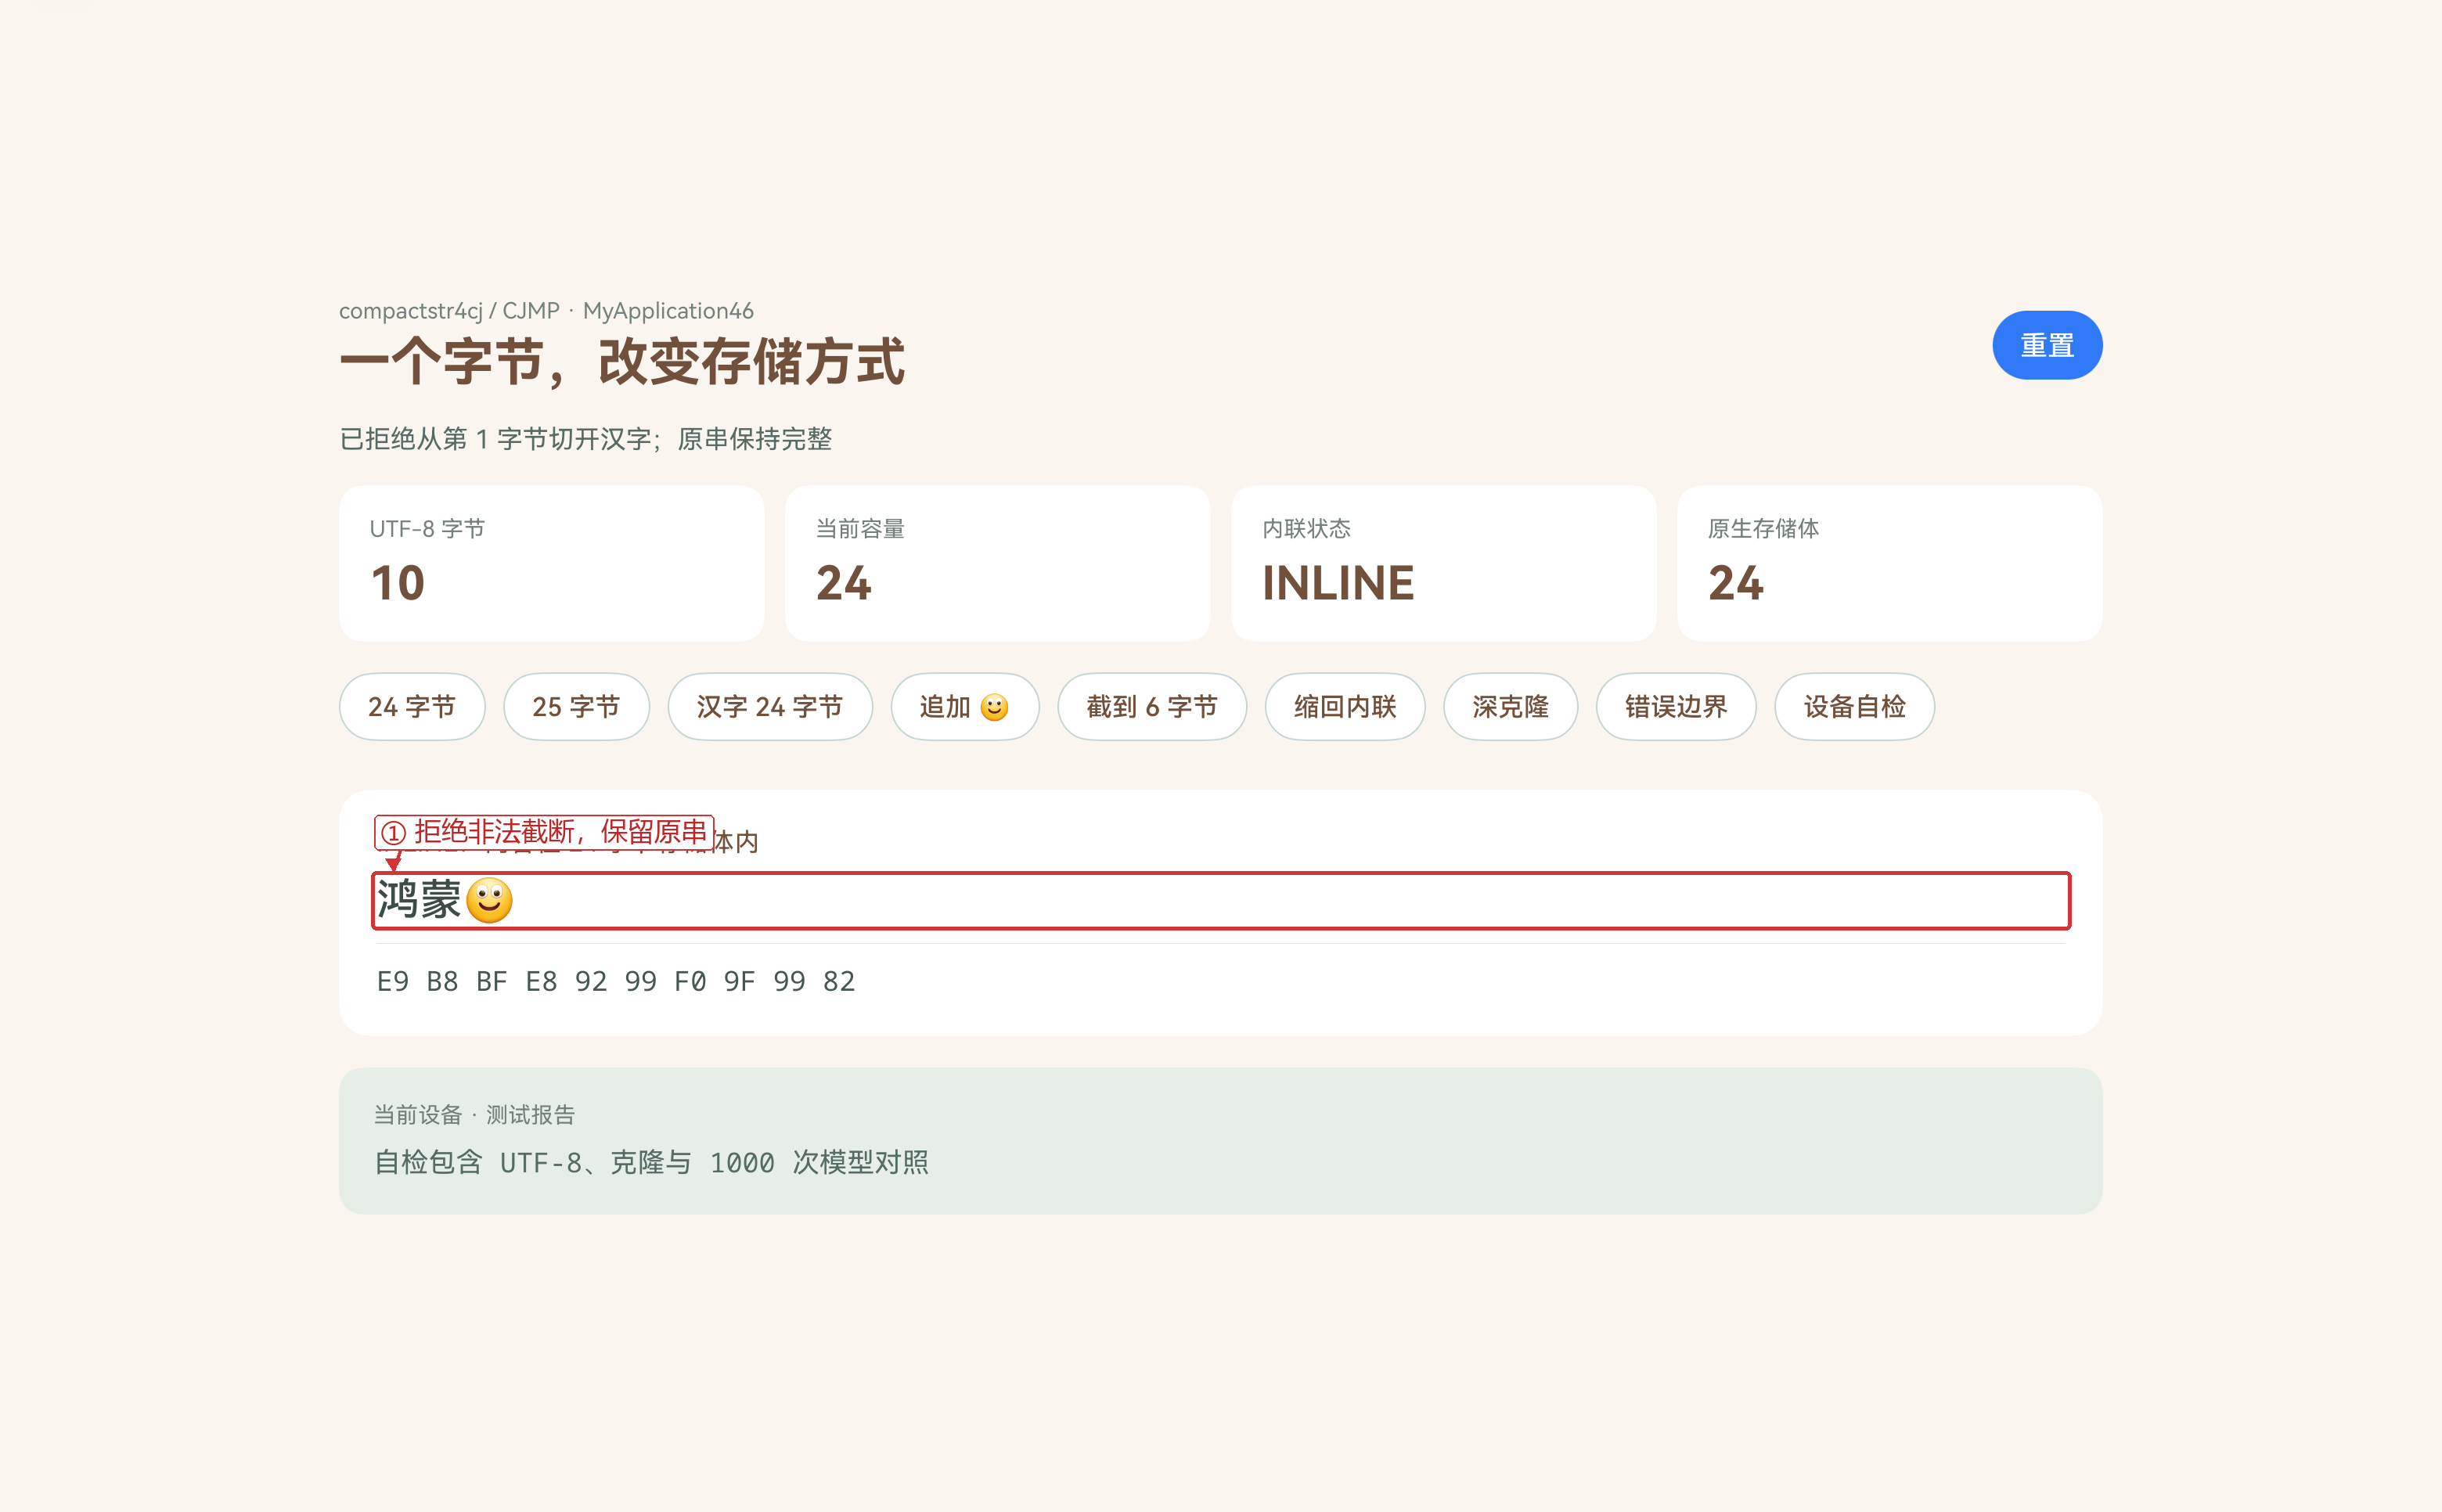
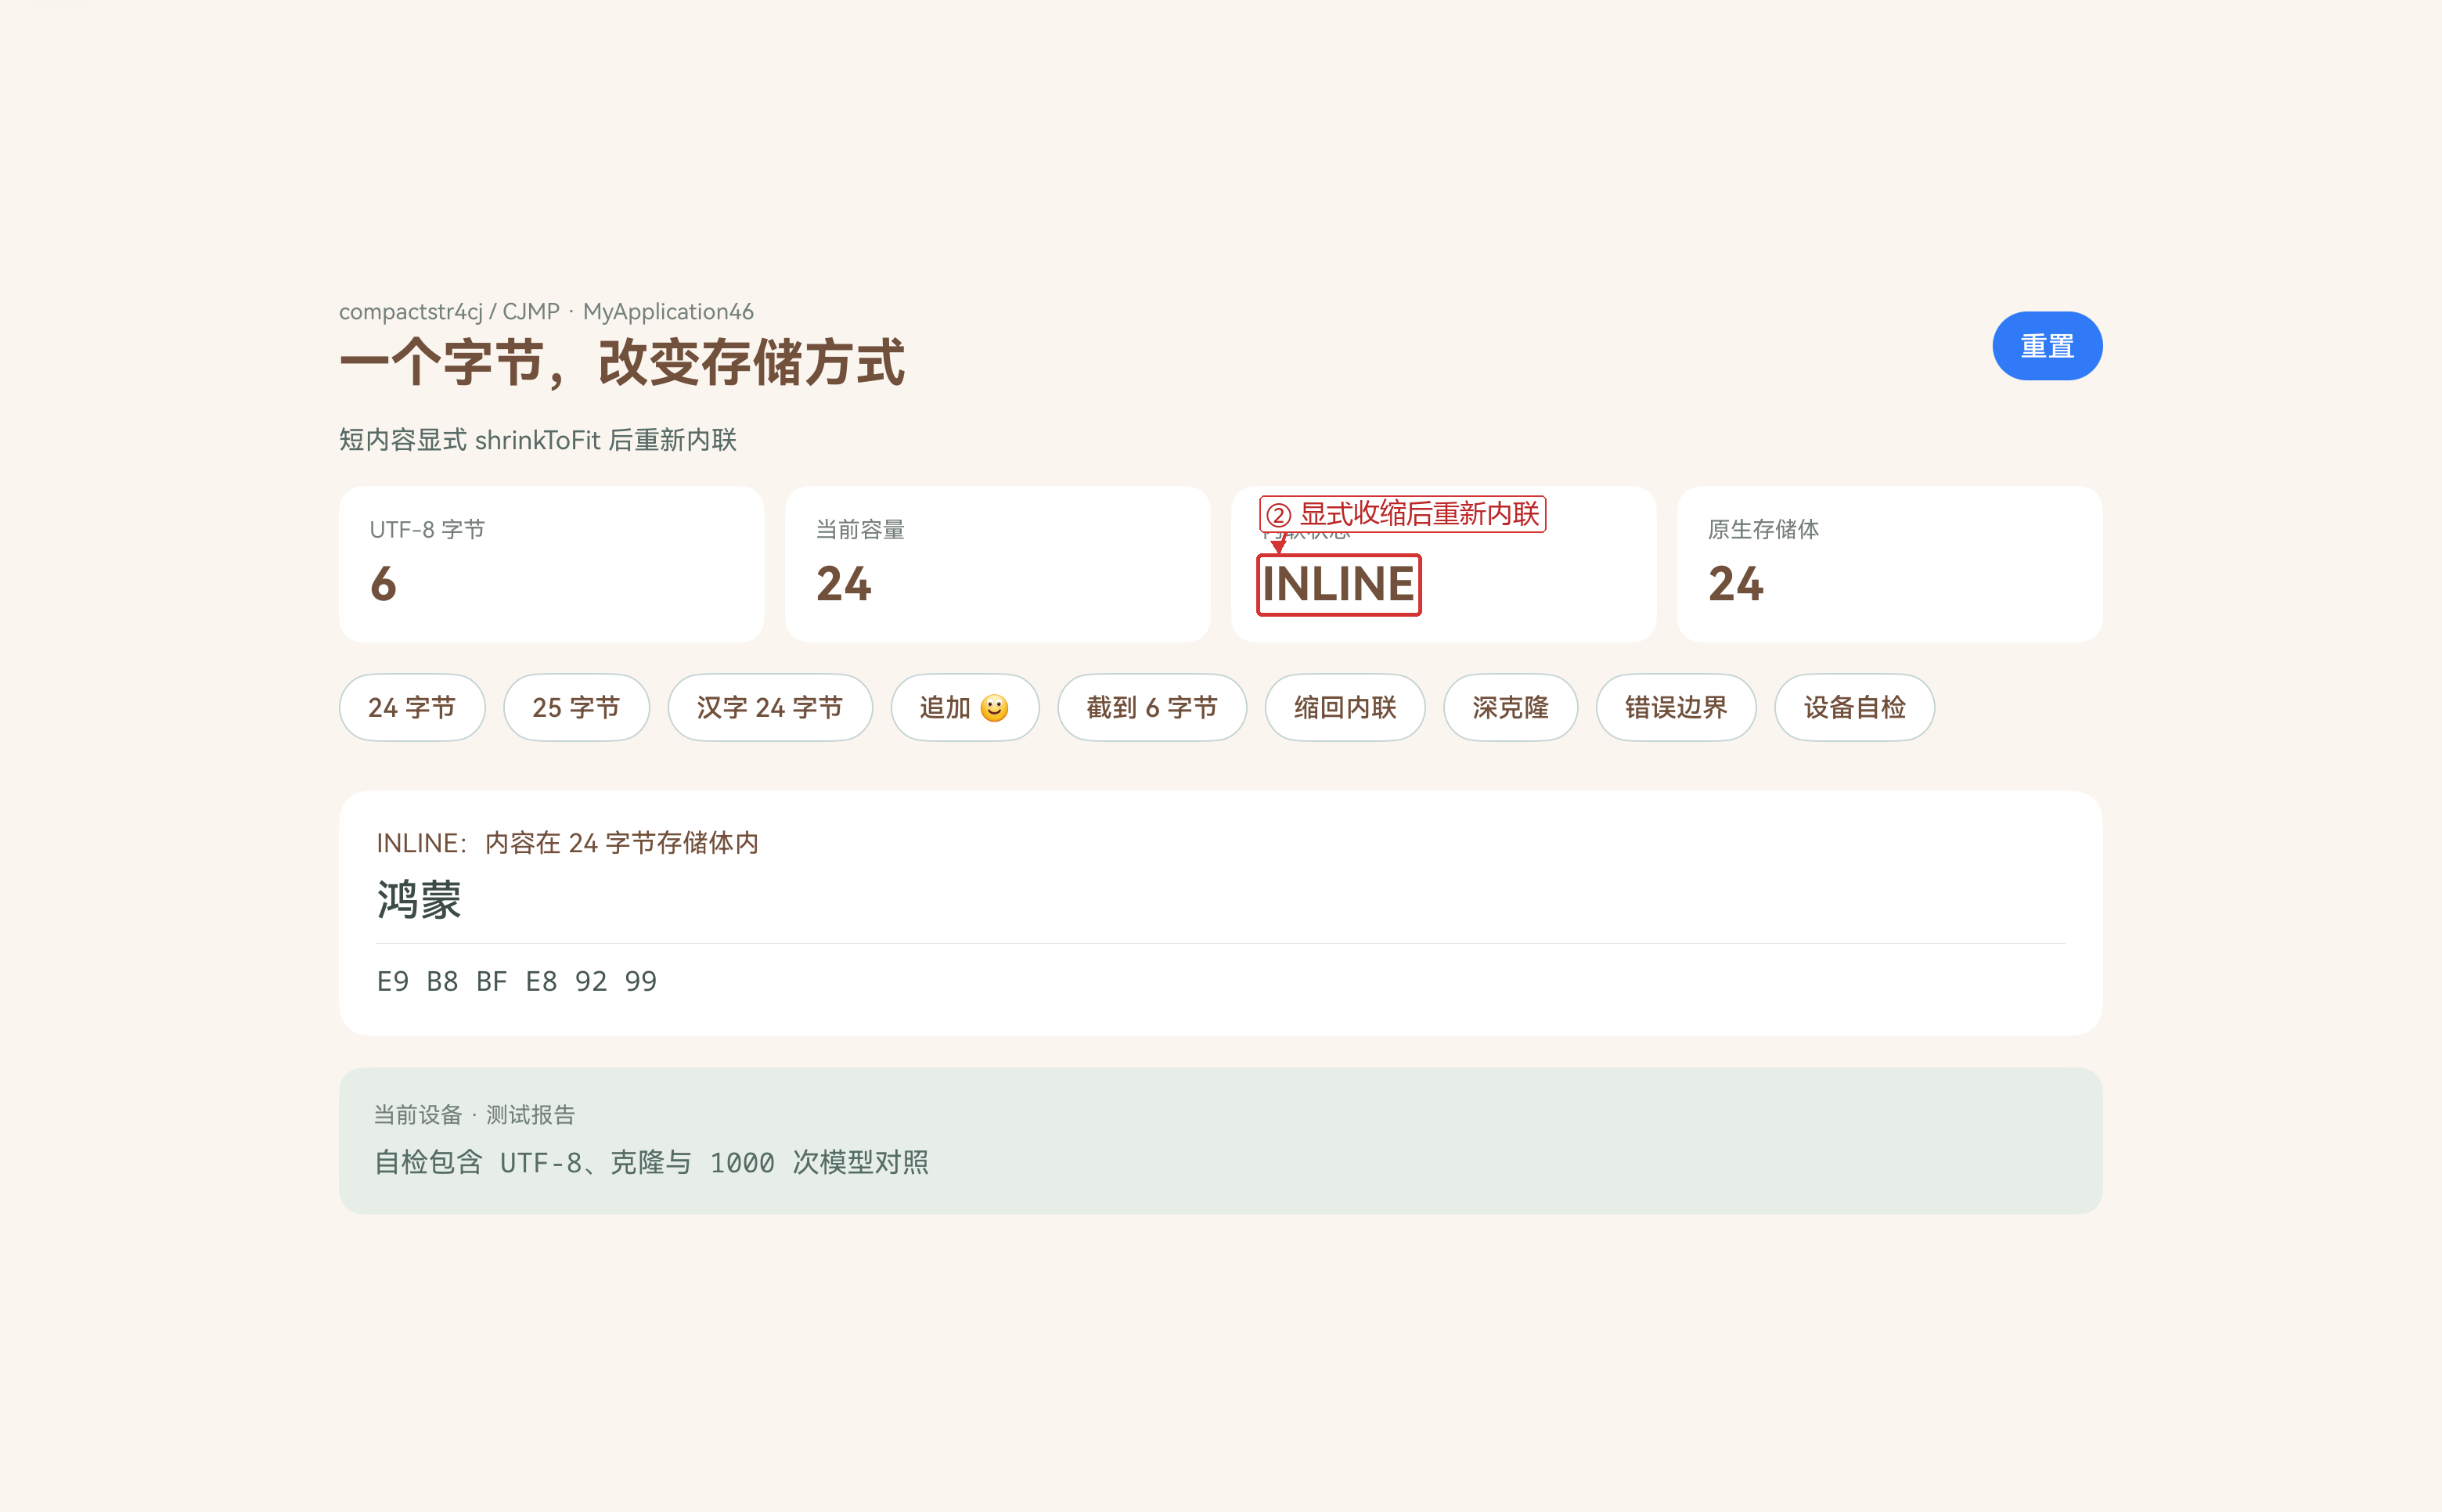
截断位置如果落在续字节上,后端拒绝操作,原内容保持不变。错误边界按钮装入“鸿蒙🙂”,然后尝试截到第一个字节,页面保留完整字符串并给出拒绝提示。截到第六字节则是合法边界,得到“鸿蒙”。大于当前长度的 truncate 是无操作,负数由仓颉门面提前拒绝。
还有一项不容易从普通示例看出来:嵌入 NUL。库的 toString 逐字节取回指定长度,再按 UTF-8 构造仓颉字符串,没有依赖 C 风格的零终止读取。设备自检包含 A、NUL、B 的三字节往返;当前页面没有给 NUL 提供输入框,不把这个库层检查写成一个已展示的界面功能。
public func toString(): String {
        ensureOpen();let bytes=Array<UInt8>(byteLength,{i => unsafe {cs_byte(handle,UInt64(i))}})
        return String.fromUtf8(bytes)
    }
变短以后,什么时候释放容量
长字符串已经在堆上,截短并不马上搬回内联区。这样后面又追加内容时,可以继续使用已有容量。需要主动收缩时调用 shrinkToFit:短内容复制回二十四字节区域,旧堆缓冲区释放。页面把截断与收缩分成两个按钮,方便观察长度和存储状态分别在哪一步改变。
int32_t cs_shrink(Compact *s){
    uint64_t n=cs_len(s);if(!is_heap(s))return 0;
    if(n<=24){unsigned char tmp[24]={0};memcpy(tmp,data(s),n);free(s->heap.ptr);memcpy(s->bytes,tmp,24);if(n<24)s->bytes[23]=(unsigned char)(0xc0+n);return 0;}
    if(cs_capacity(s)==n)return 0;unsigned char *p=malloc(n);if(!p)return ENOMEM;
    memcpy(p,data(s),n);free(s->heap.ptr);s->heap.ptr=p;set_cap(s,n);return 0;
}
reserve 接收额外字节数,并不是目标总容量。扩容至少覆盖请求,按约一点五倍当前容量增长;超出上限会拒绝且不破坏现有内容。clone 则复制出独立可变内容,修改副本不会改变原串,但没有承诺复制旧容量。复制内容与复制容量是两件事,使用时应按本版接口约定理解。
public func append(value: String): Unit {
        ensureOpen();let bytes=unsafe {LibC.mallocCString(value)}
        let code=unsafe {cs_append(handle,bytes,UInt64(value.size))};unsafe {LibC.free(bytes)};checked(code)
    }
public func close(): Unit {if(!closed){unsafe {cs_free(handle)};handle=CPointer<Unit>();closed=true}}仓颉封装实现 Resource,正常使用可显式 close 或放进 try 资源作用域,析构作为兜底。FFI 创建的临时字节串调用后释放,原生指针不交给 ArkTS。接口按拥有线程串行使用;这一版不提供跨线程共享可变字符串的同步承诺。
CJMP 工程落到哪些目录
| 项目 | 本次实际配套 |
| 框架 | CJMP Tools 0.2.2 / logic-module / native |
| IDE | DevEco Studio 6.1.1.300 |
| SDK / 编译器 | HarmonyOS 6.1.1(24) / 仓颉与 cjpm 1.1.3 |
| 模拟器 | x86_64,6.1.1.350 |
| 真机 | MatePad Edge,arm64-v8a,6.1.1.120 |
环境搭建直接引用 CPF-RN 的基础工具文件,RN 专有依赖不照搬到这个 CJMP 工程。CJMP 0.2.2 文档给出的仓颉配套是 1.1.0-beta.22,本机实际为 1.1.3,构建目录与 C ABI 桥按实际 SDK 调整。活动优先要求 HarmonyOS 7/API 26;目前完成的是 API 24 双端实测,API 26 仍需要换配套后重新验证。
harmony/cjmp/compactstr4cj/
  project.conf
  logic-module/cjpm.toml
  logic-module/common/compact_string.cj
  logic-module/hos/native/compact_core.c
  logic-module/hos/native/napi_bridge.c
  logic-module/hos/test_suite.cj
  hos/compactstr4cj/
  scripts/build-logic.ps1
example/harmony/MyApplication46/| 位置 | 本次改动 |
| common/compact_string.cj | 仓颉公共类型、资源关闭、字节接口及 FFI 转换 |
| native/compact_core.c | 24 字节表示、UTF-8 验证、扩容、收缩和深克隆 |
| cjpm.toml / scripts | 公共包与原生后端的目标架构编译、运行依赖收集 |
| hos/compactstr4cj | HAR 门面、类型定义、外部 common 目录的构建钩子 |
| hos/demo.cj / test_suite.cj | 返回实际状态,执行模型与边界检查 |
| example/harmony/MyApplication46 | 真实依赖 HAR 的按钮演示和字节读数 |
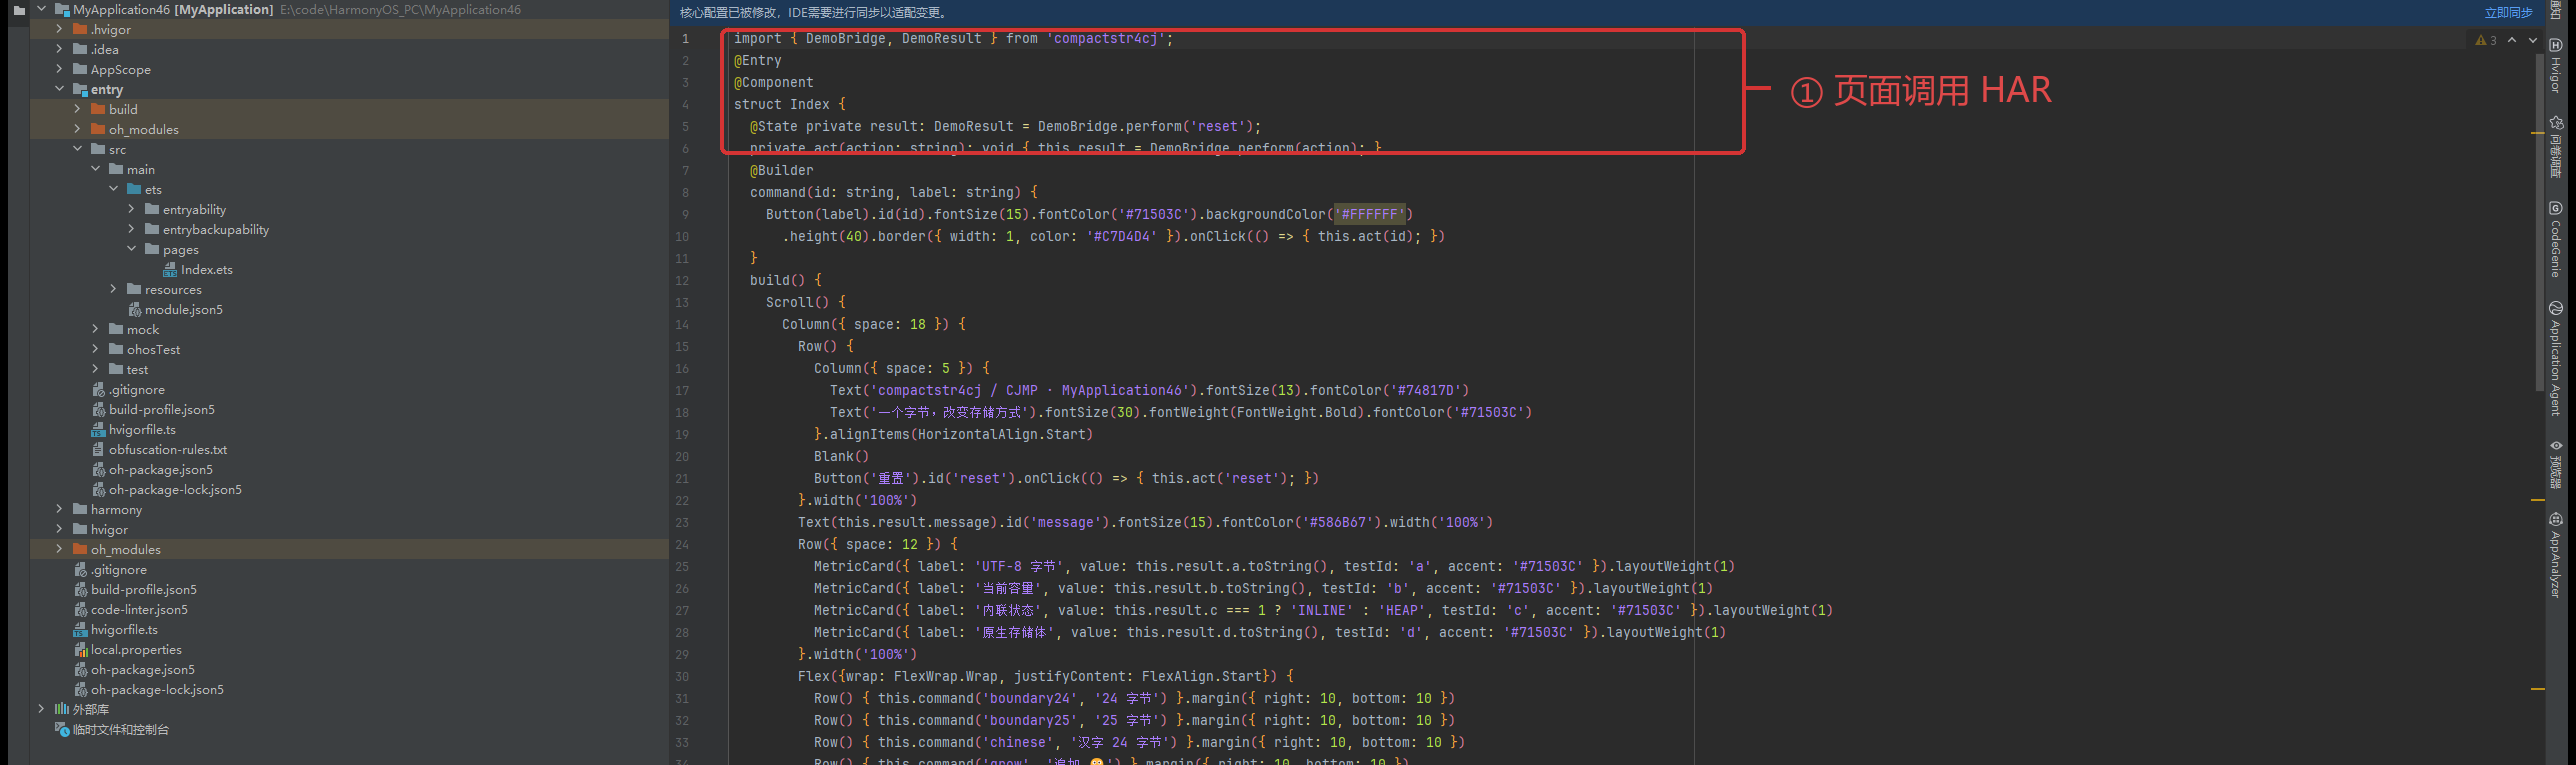
harmony 目录有实际适配实现,example 是能导入 compactstr4cj 的鸿蒙应用。项目类型使用 CJMP 官方 logic-module/native 模板,仓颉公共包由 cjpm 编译,原生 C 后端只放平台相关存储实现。HAR 编译前先构建外部 common 源码,避免改了库文件,增量构建却继续复用旧结果。
设备演示与测试记录
模拟器和 MatePad Edge 都从同一版源码构建的 HAP 安装运行。GIF 按实际操作顺序记录二十四字节、二十五字节、汉字、追加 emoji、截断、收缩、深克隆、错误边界及设备自检。每次按钮操作后,还读取页面真实读数核对长度、状态与内容;下面这些画面不是网页预览或设计稿。
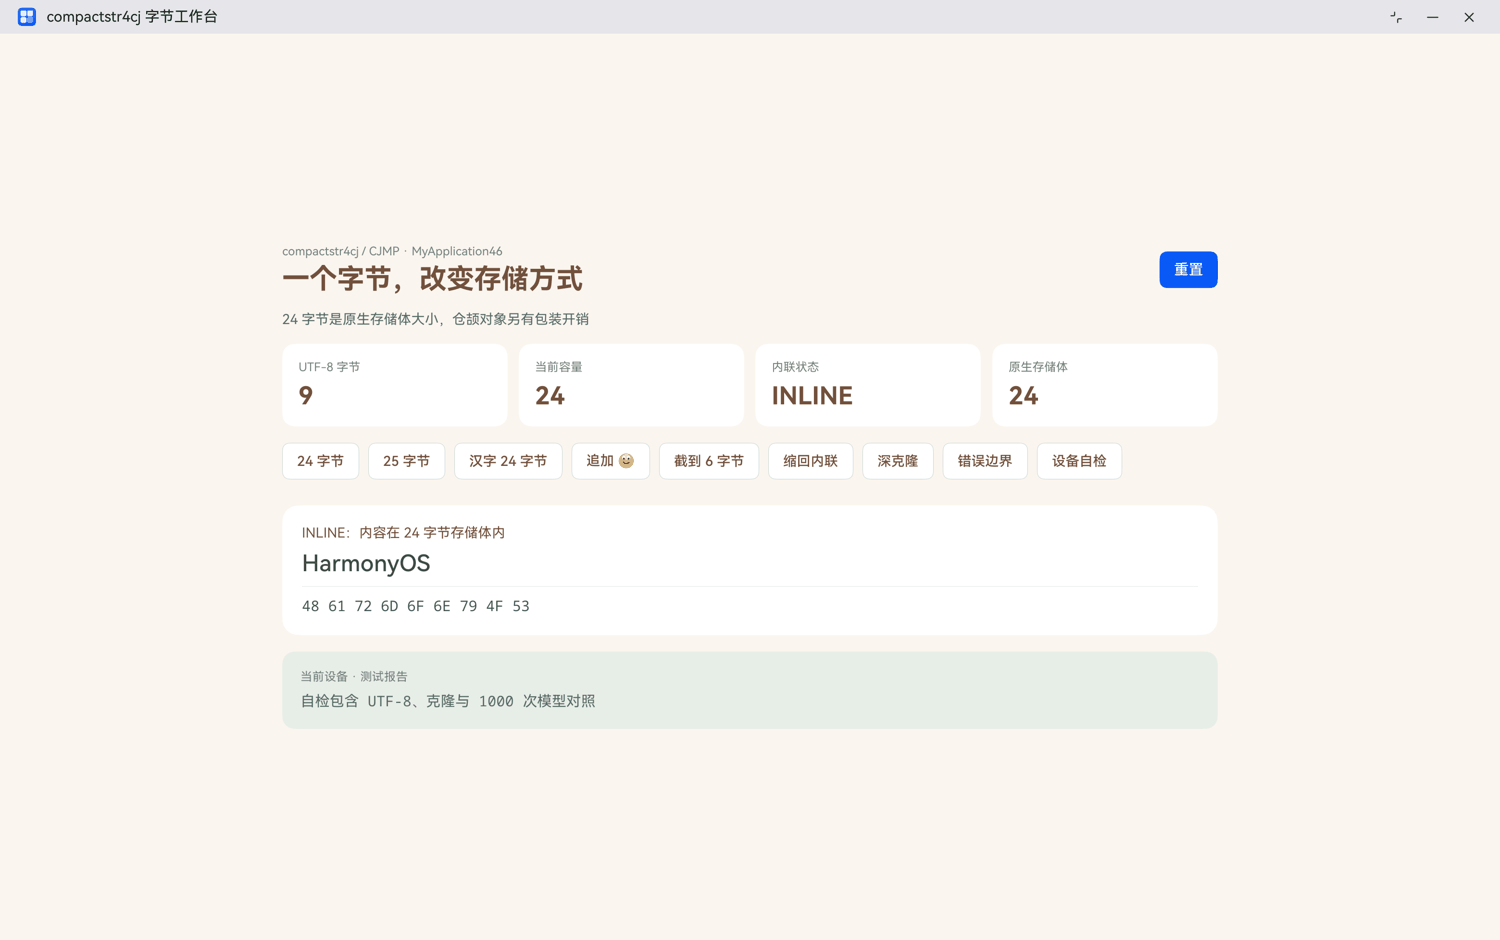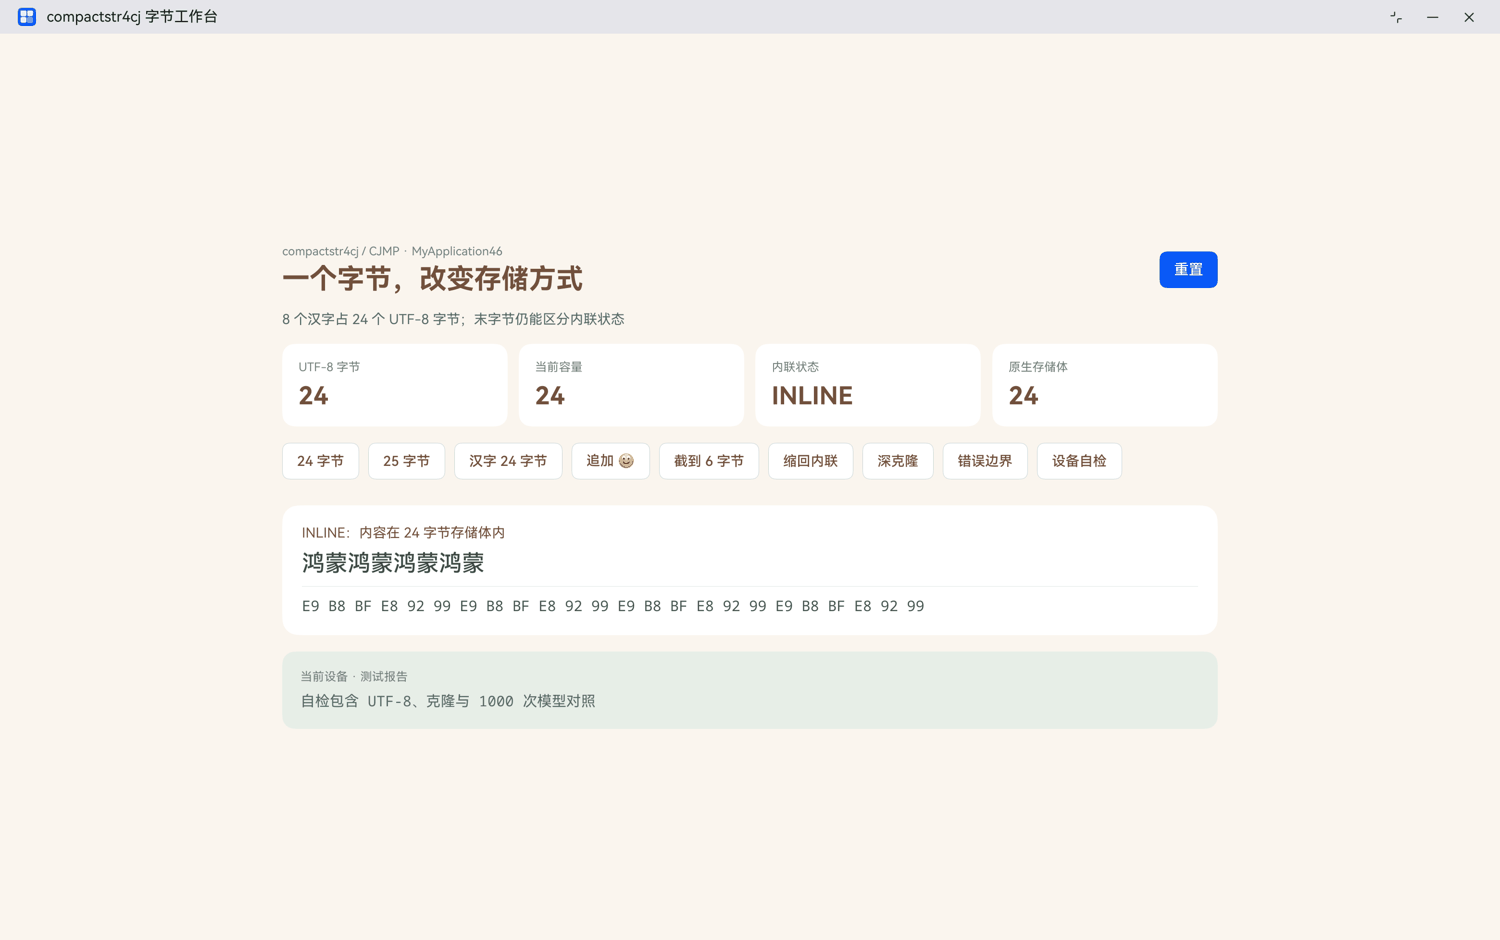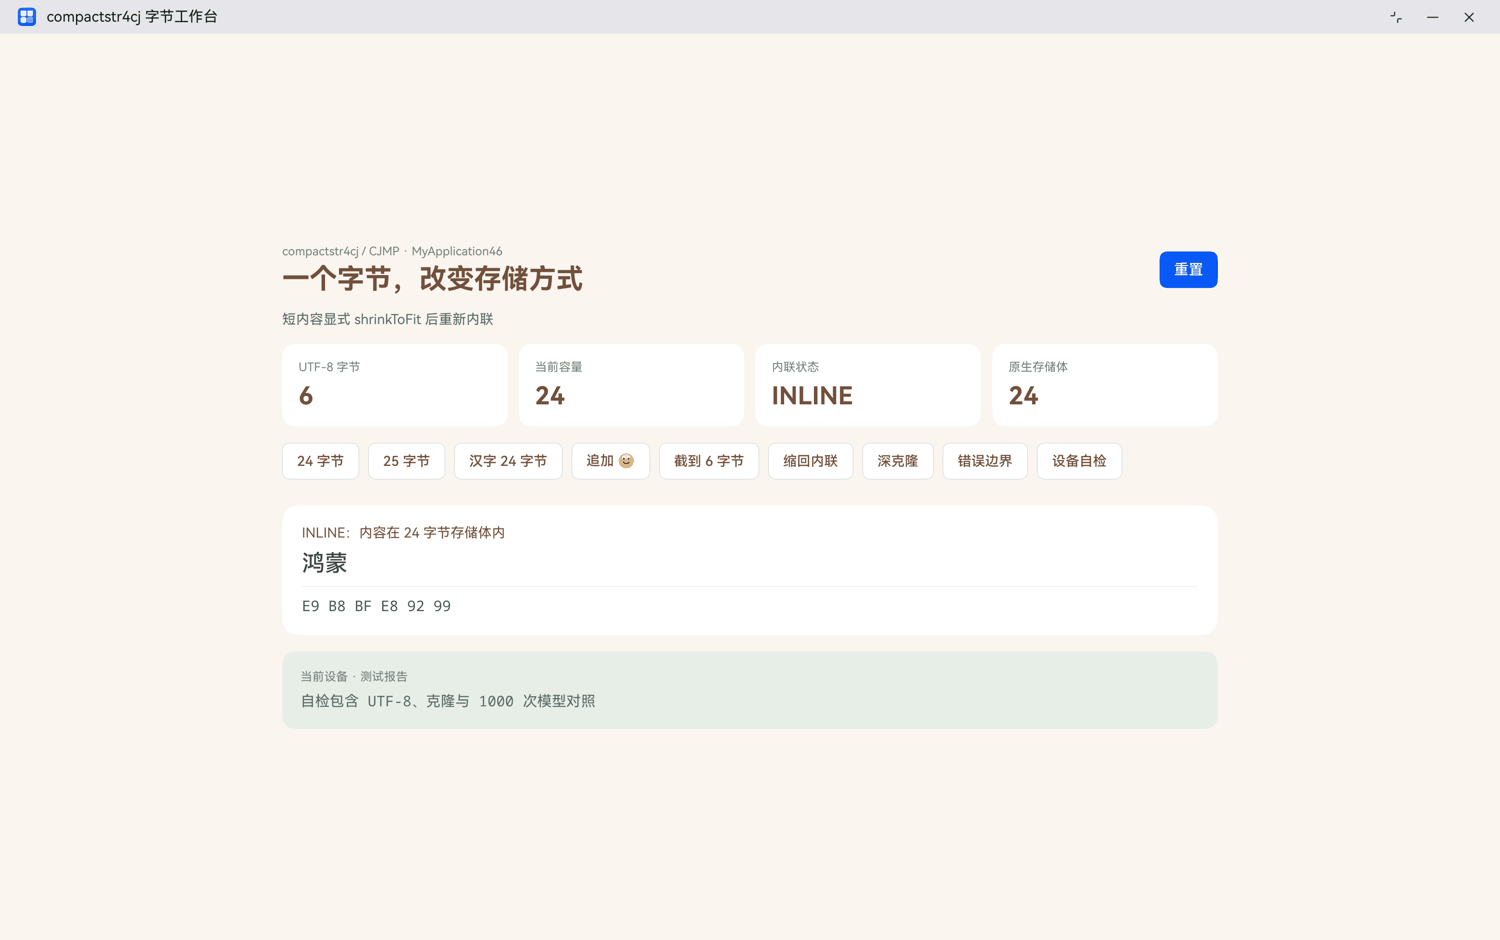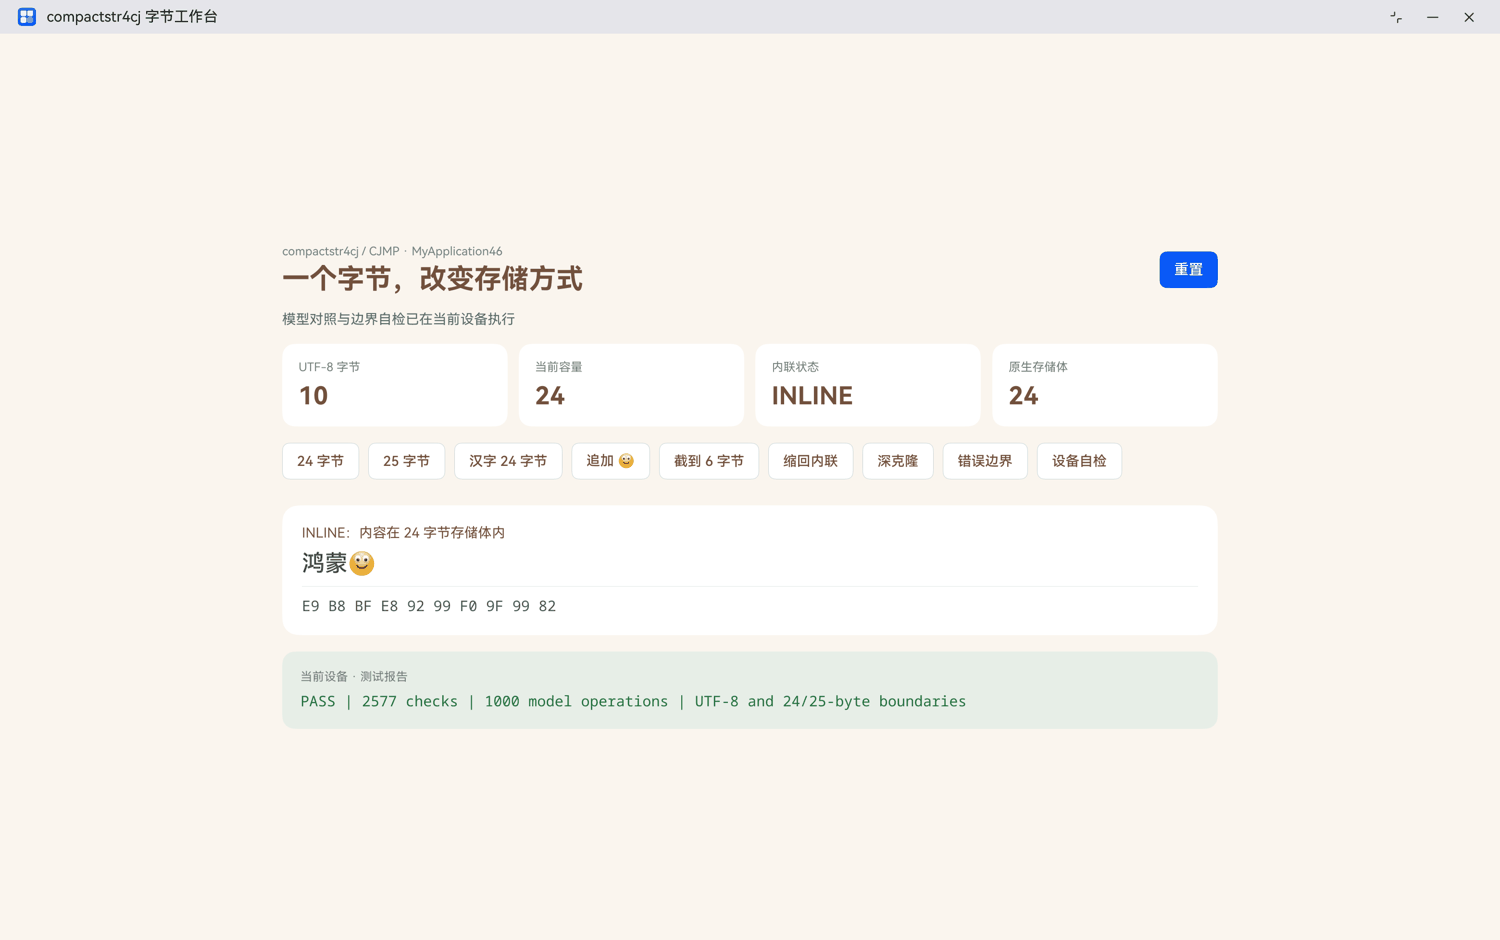
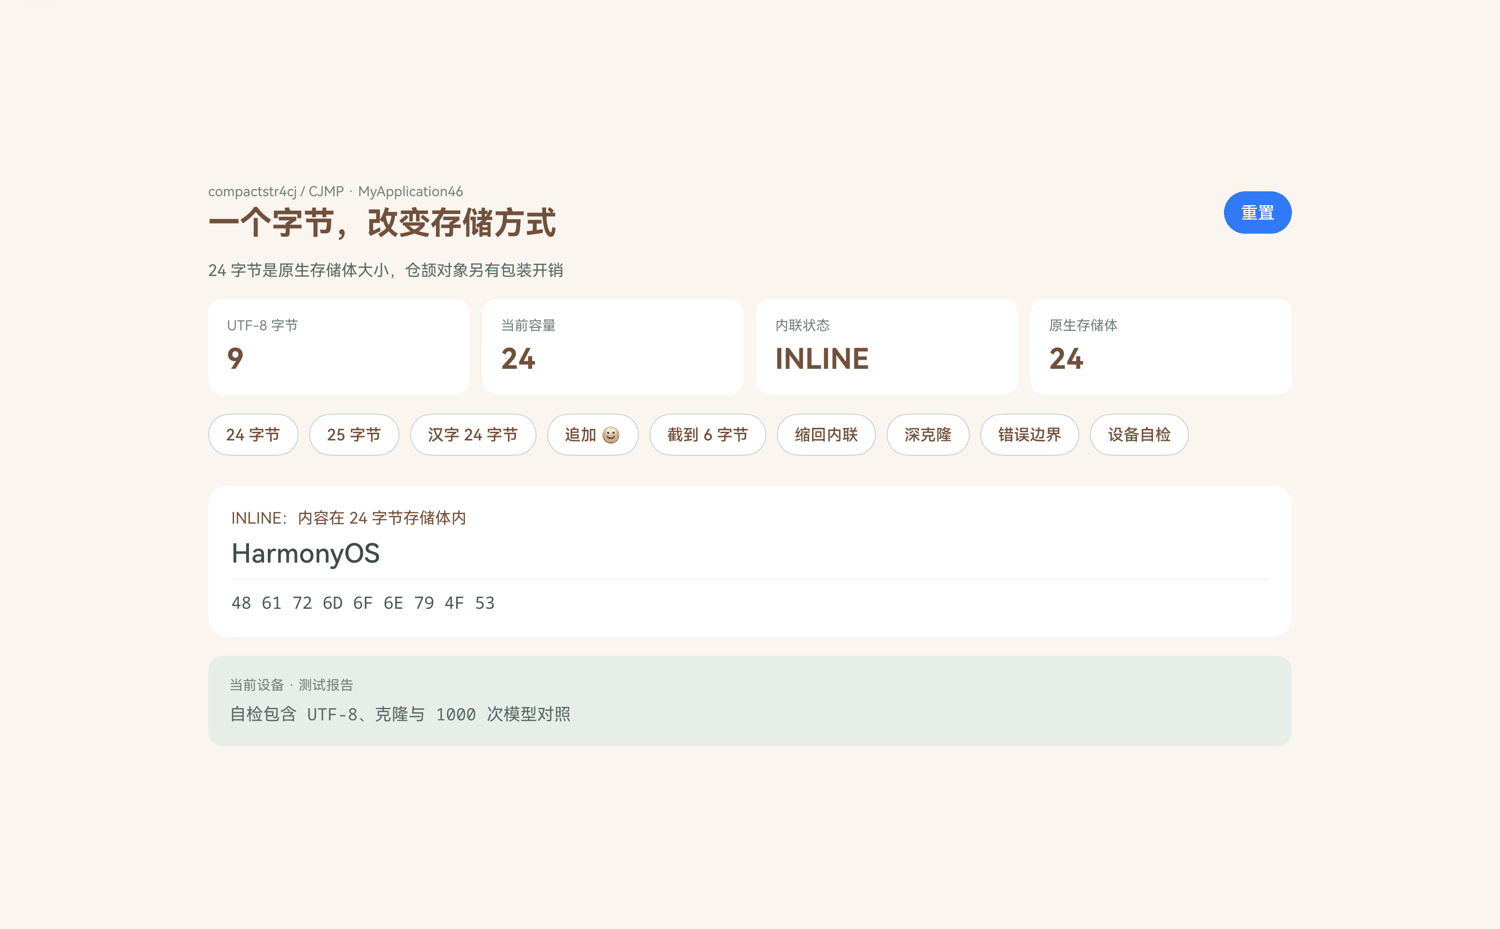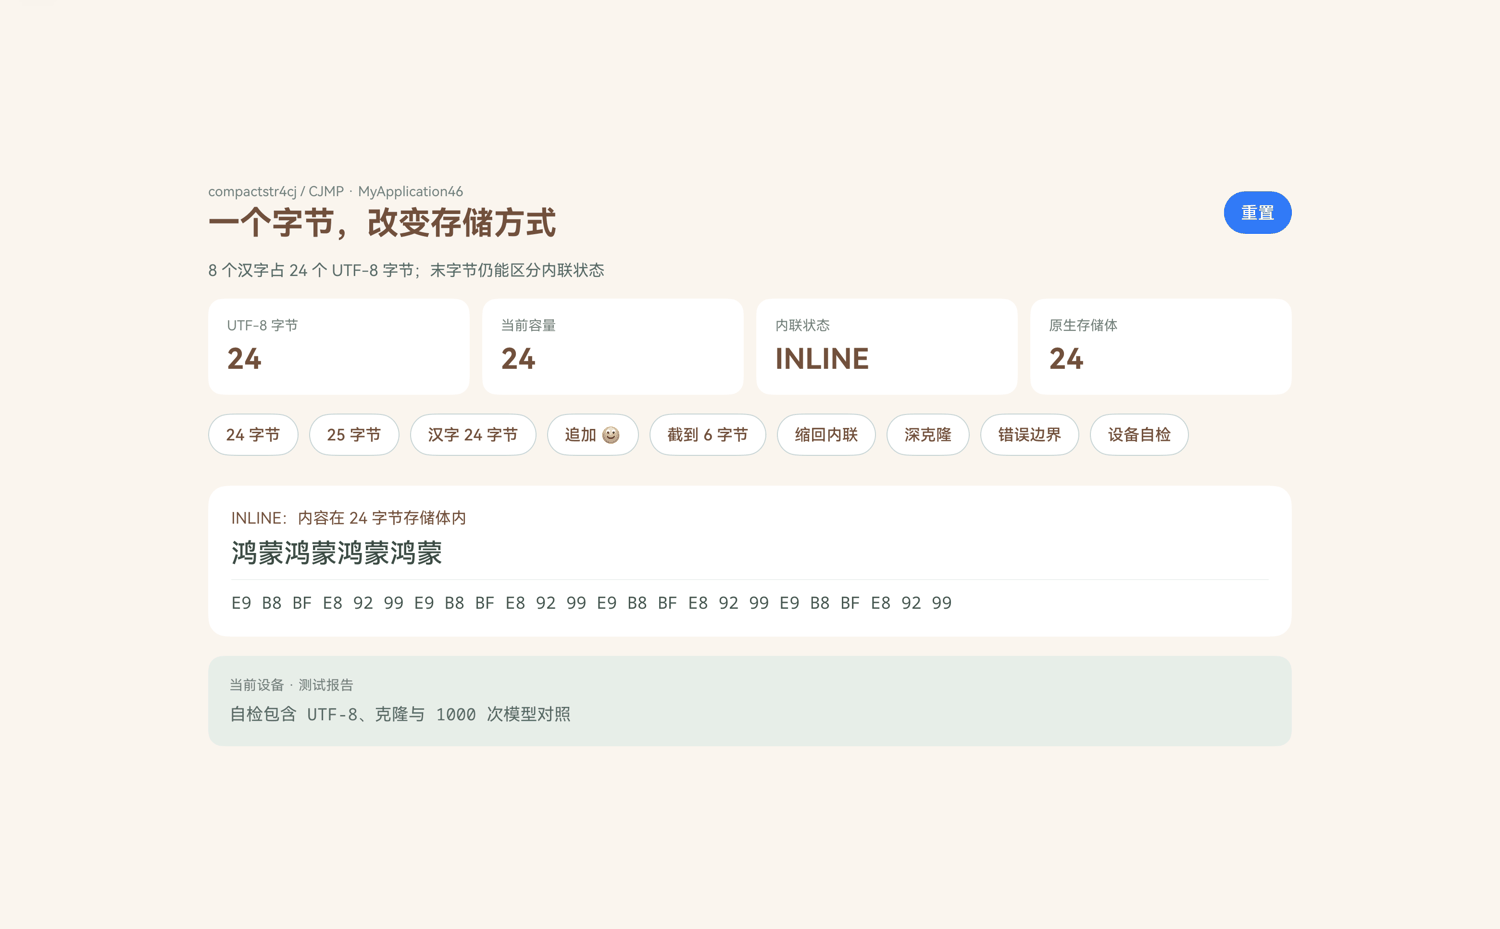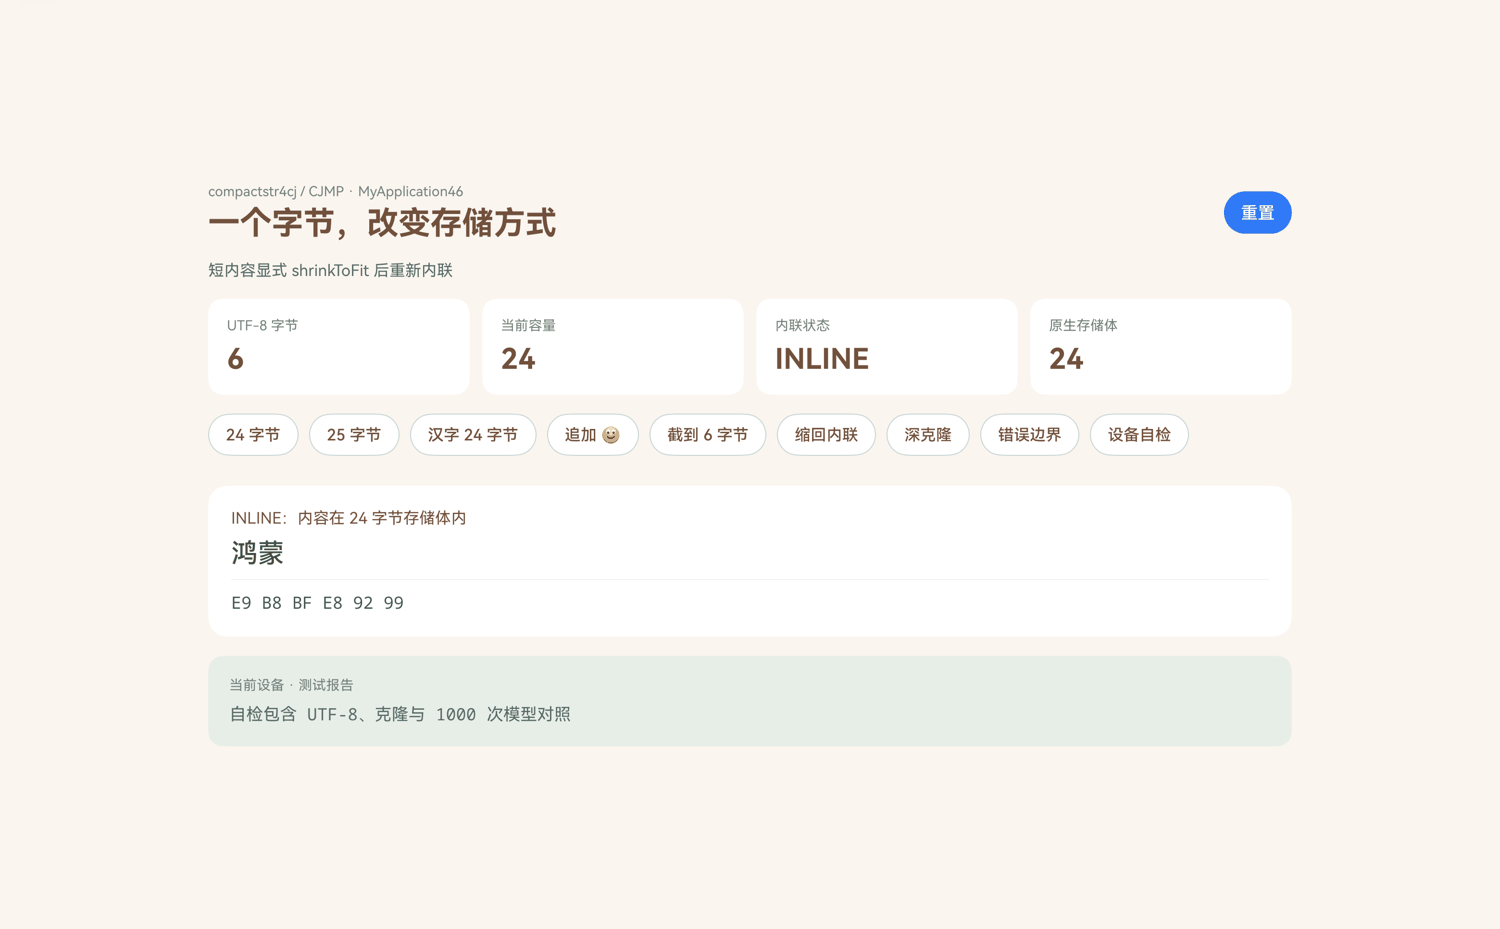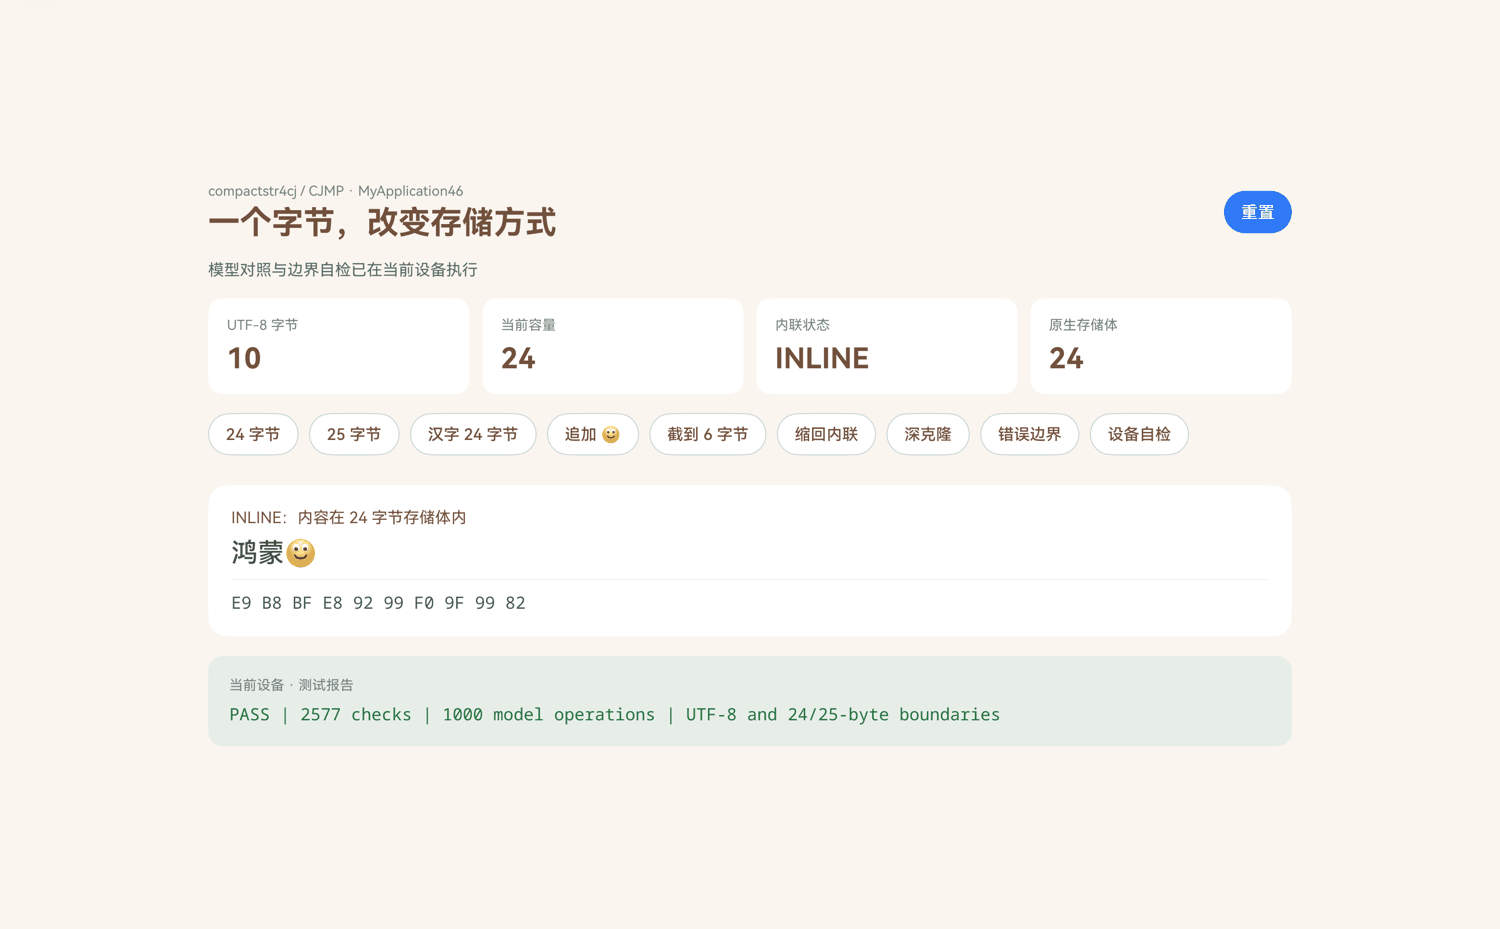
测试包先检查零到八十字节的 ASCII 内容与阈值,再做一千次构造、追加、预留、收缩、截断和清空的模型对照。模型使用仓颉标准 String,逐次检查内容、字节长度与容量不变量;另外覆盖合法与非法 UTF-8 边界、克隆独立性、嵌入 NUL、超限预留和关闭后调用。两端各返回二千五百七十七项检查通过。
PASS | 2577 checks | 1000 model operations | UTF-8 and 24/25-byte boundaries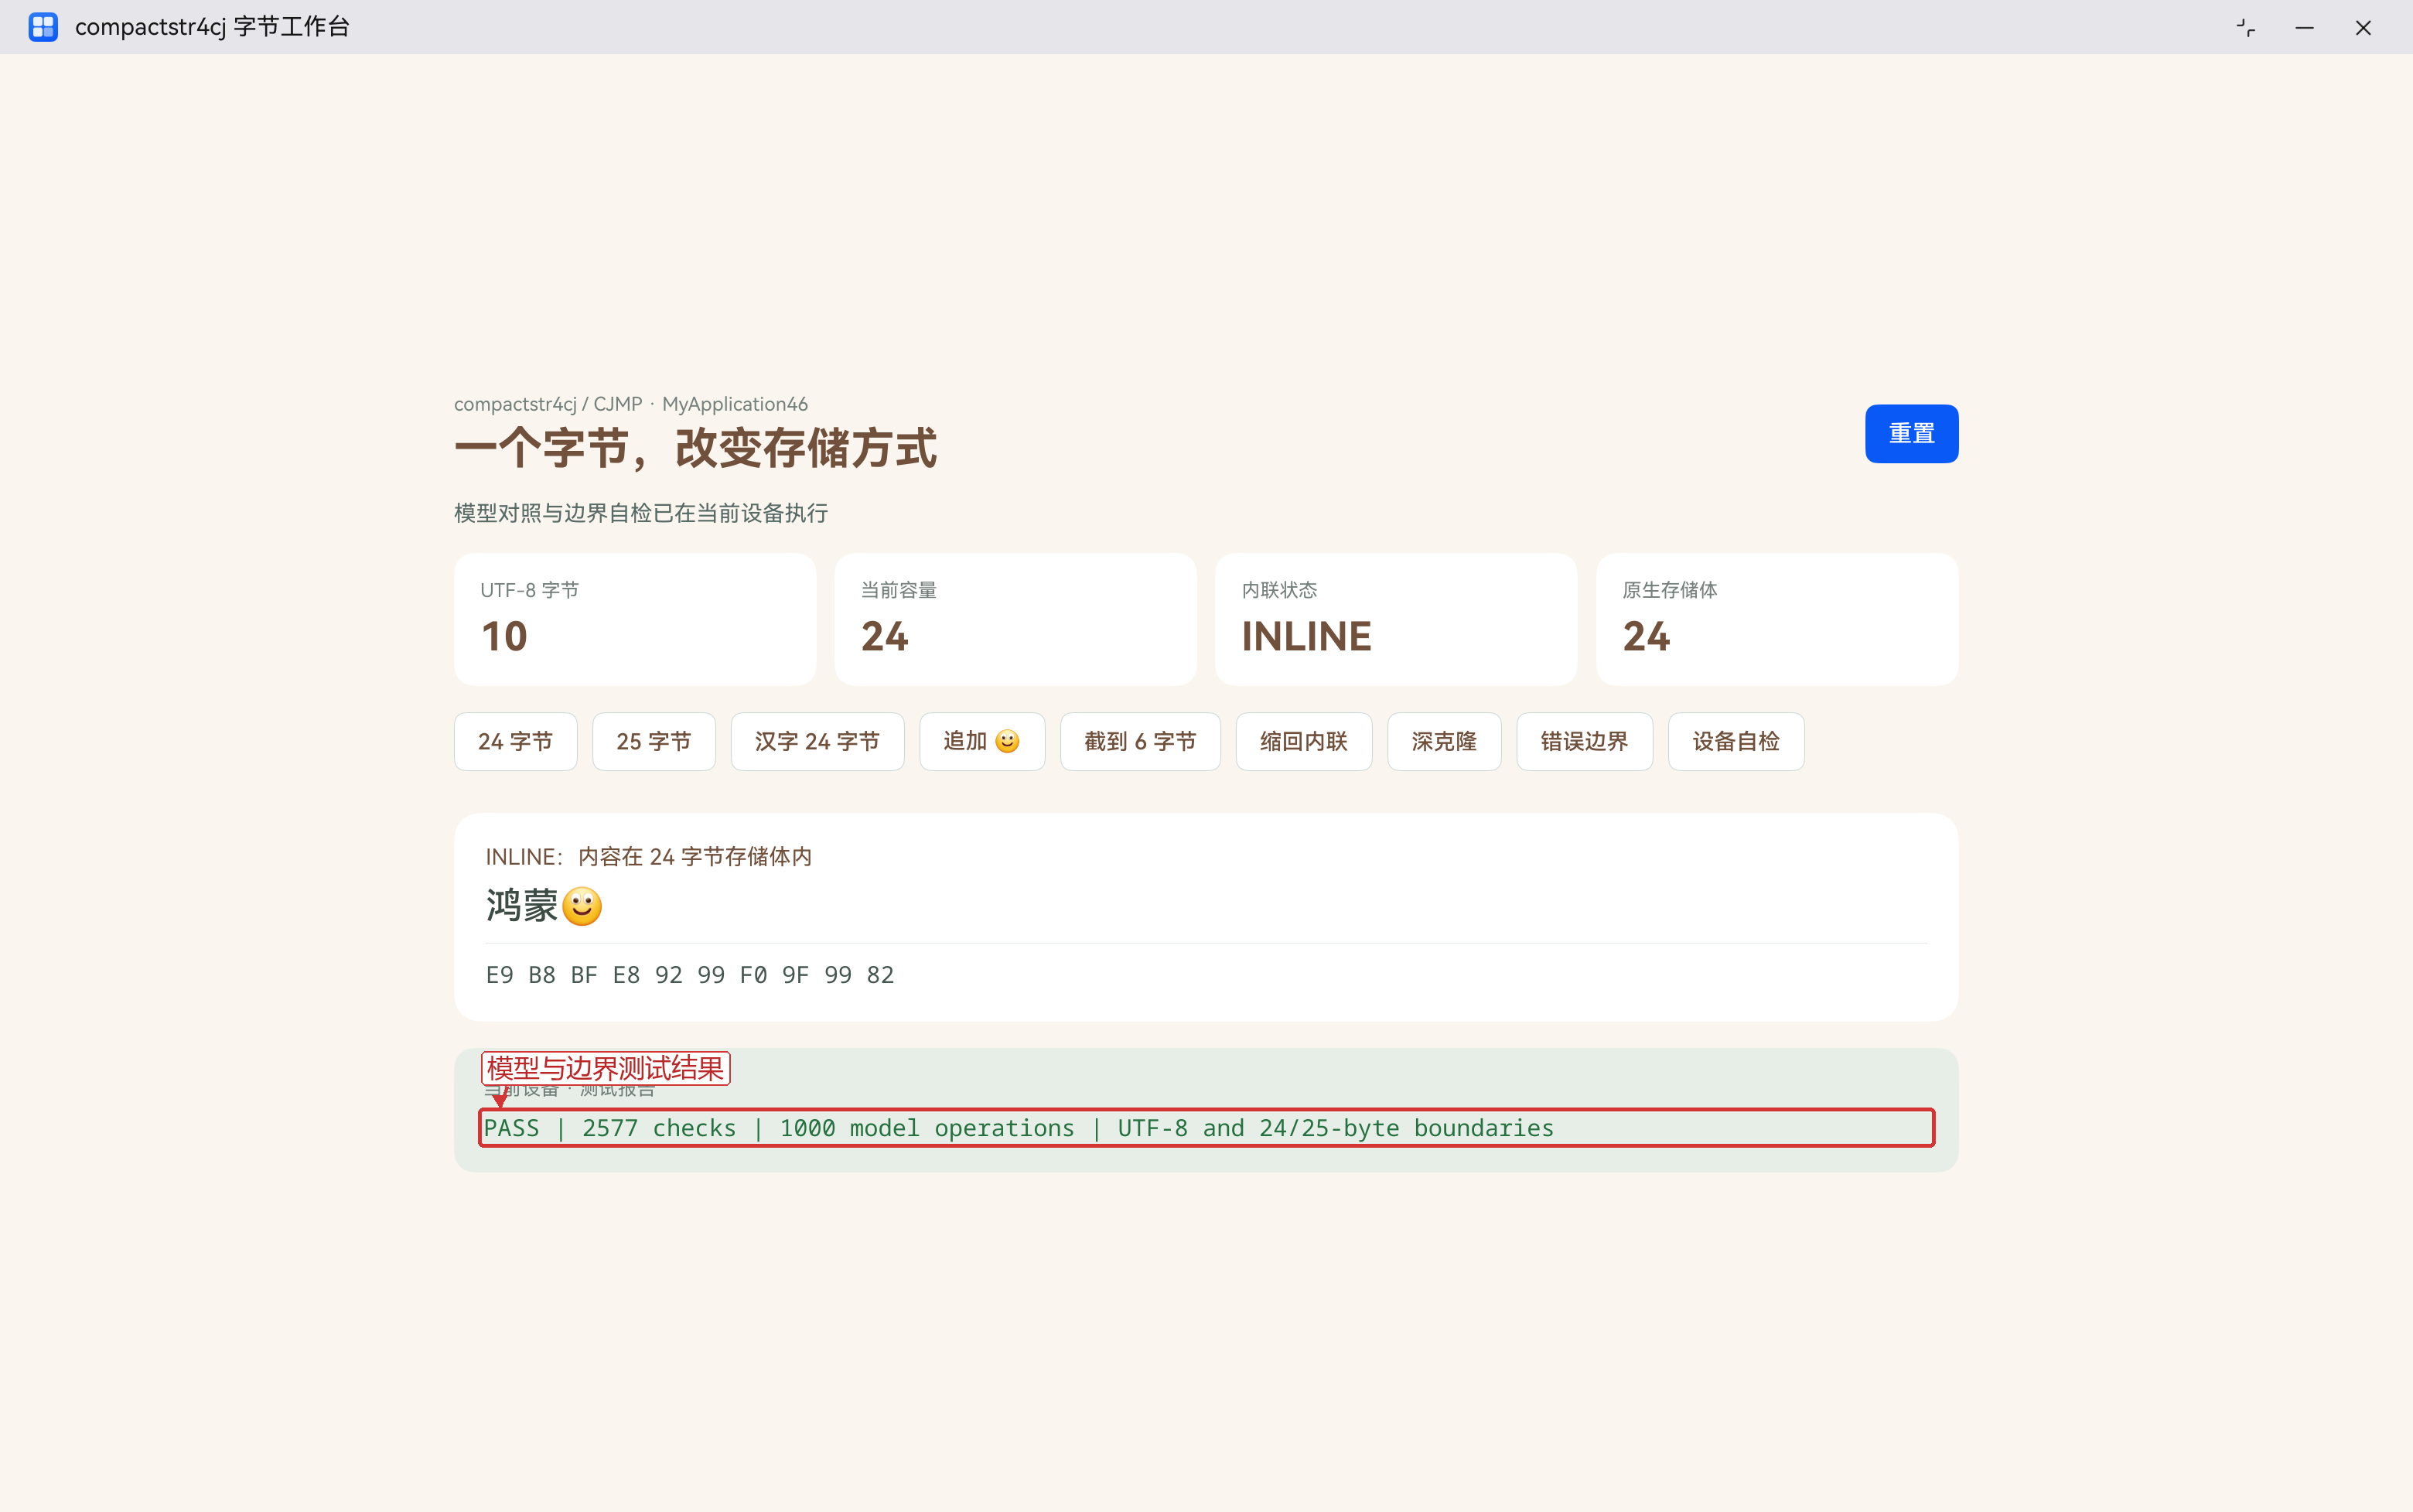
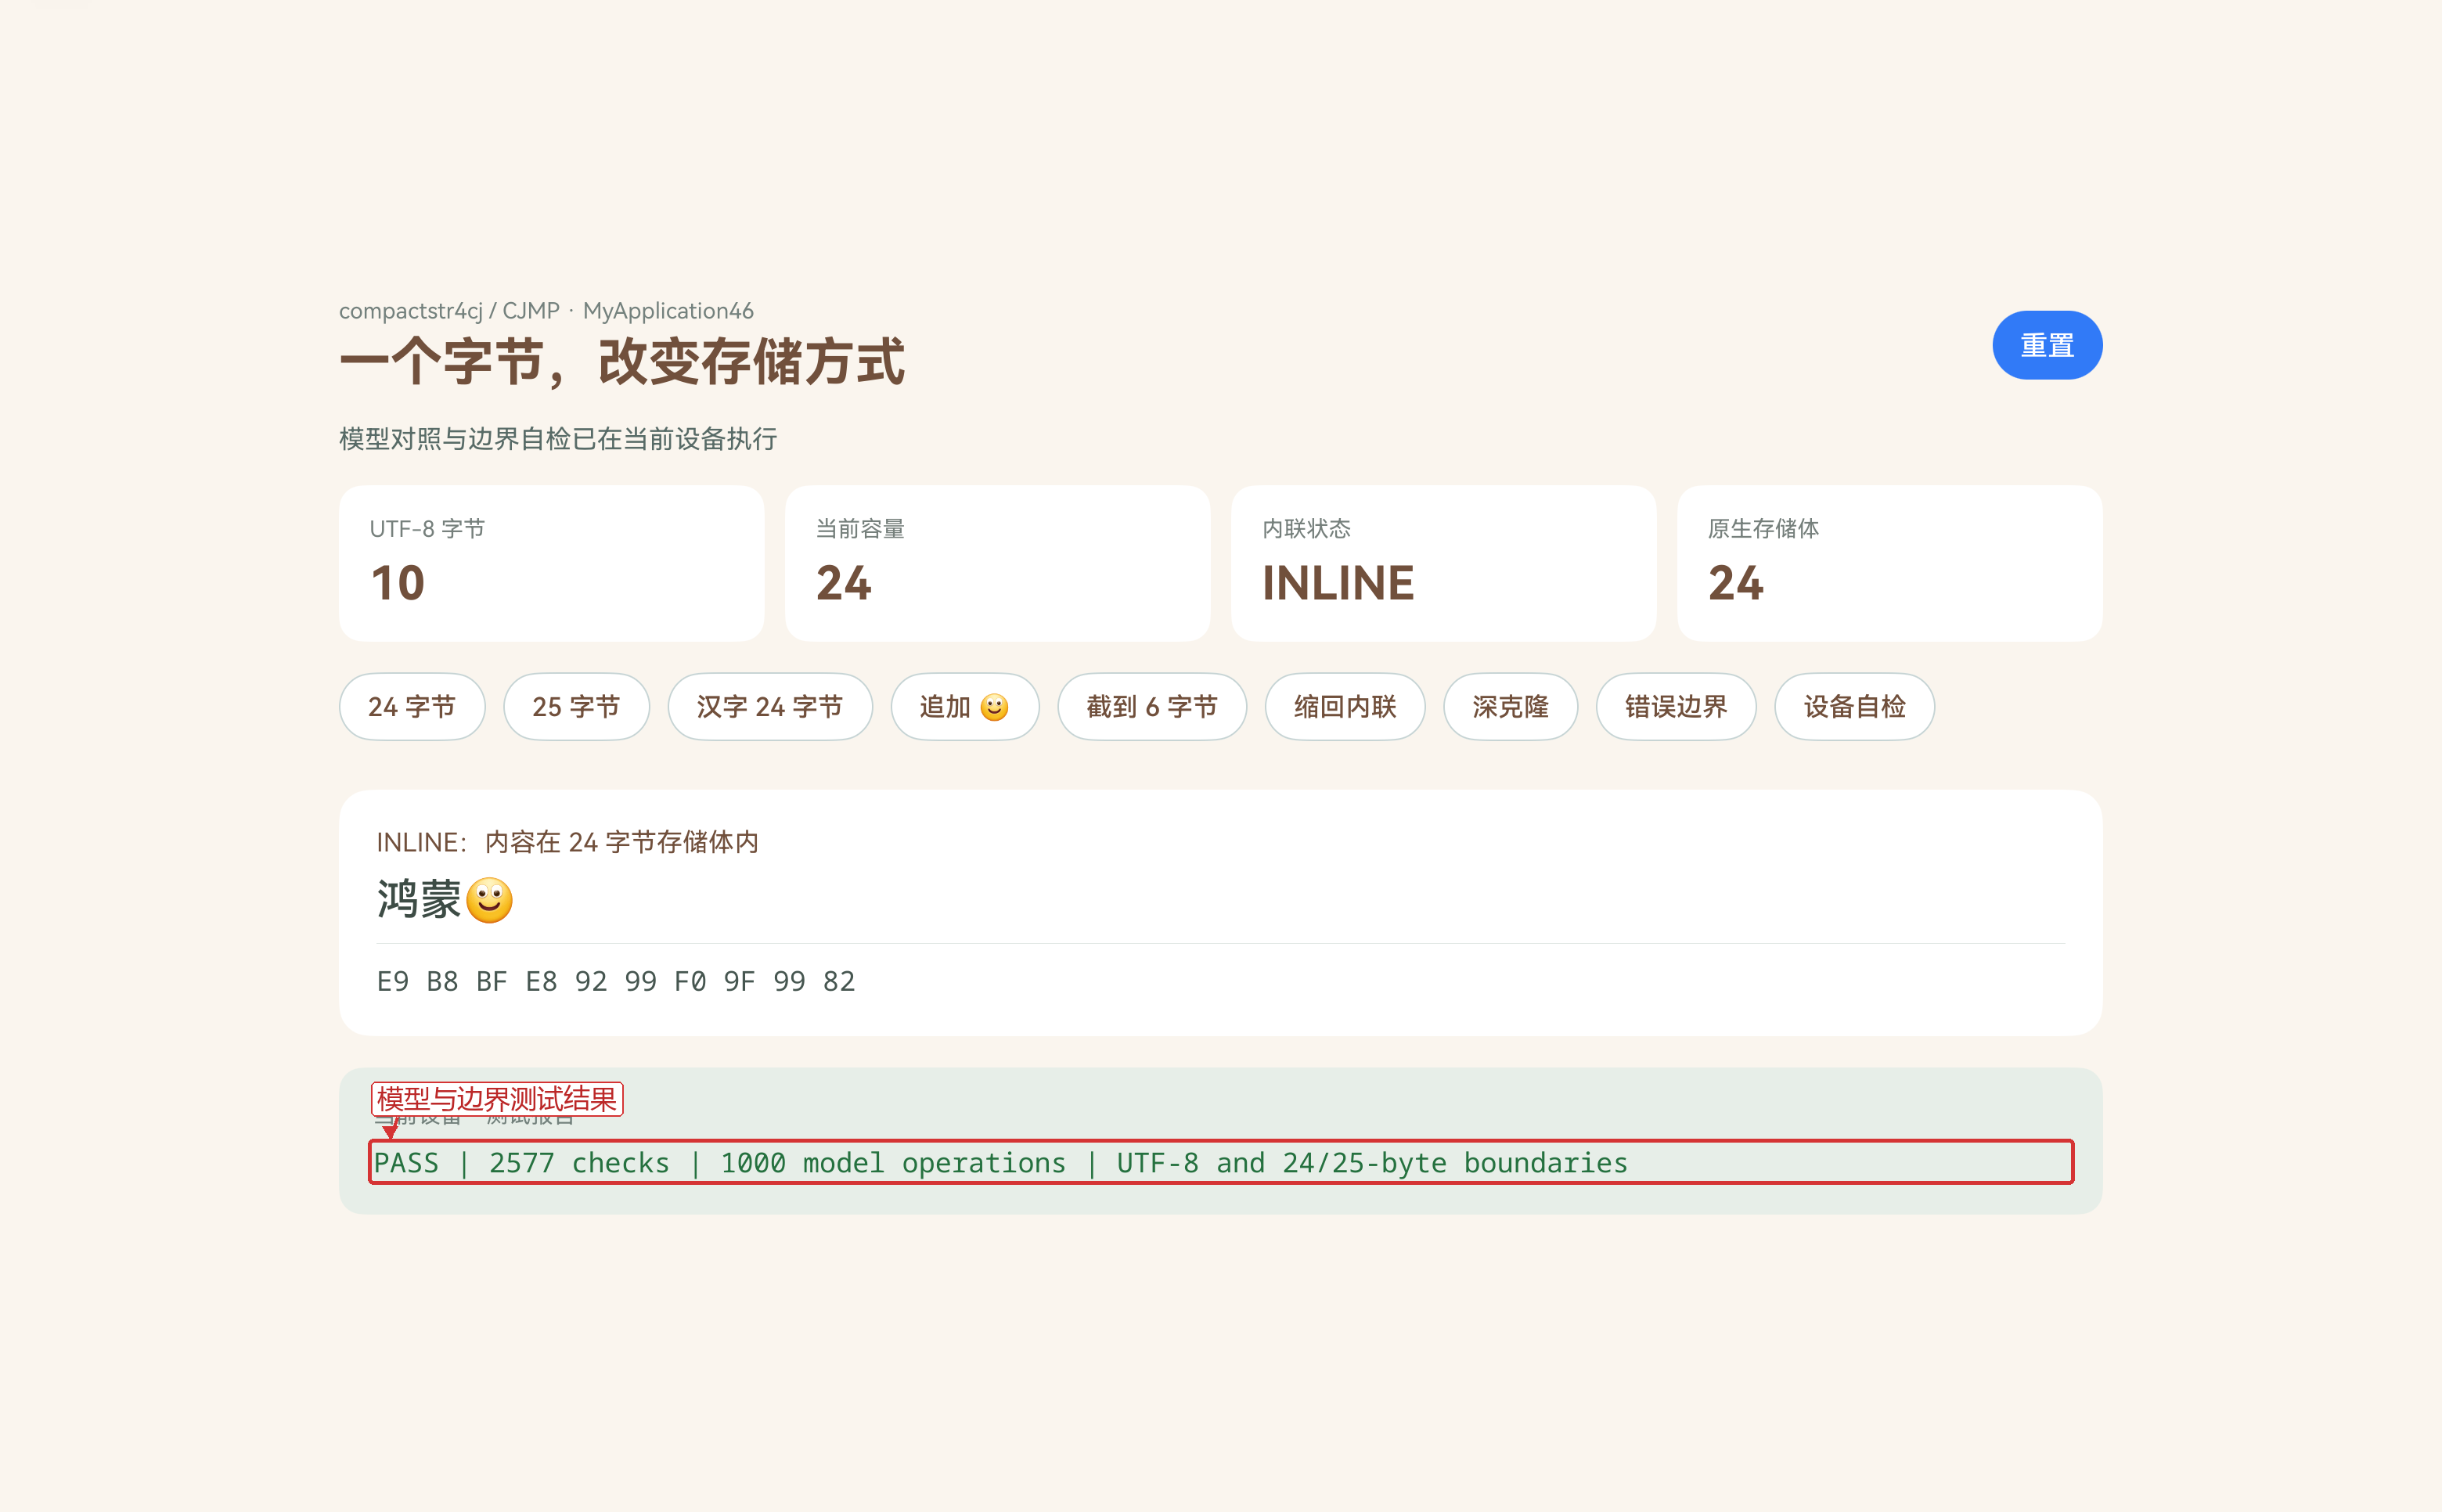
画面复核时也修正了正文颜色:系统深色主题会使未设置颜色的字符串在白卡片上难以辨认。最终显式指定颜色后重新构建和录制,测试数据与最终包哈希一起保存。正确读到字符串只是其中一步,还需要让用户在实际界面上看清它。
小结
这版实现的是一组可复现的短字符串接口,关注字节阈值、内容正确性和资源释放。Rust 的 Option 布局优化、const_new、String 零拷贝转换、format 宏、serde 和数据库集成等能力尚未移植。Android/iOS 没有实测,运行速度与内存收益也没有做系统基准,因此这里不写性能提升百分比。
cjmp build har --platform ohos-arm64项目开源地址:compactstr4cj(AtomGit)。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献22条内容

所有评论(0)