
HarmonyOS 7 ArkData UTD:跨应用拖入素材32KiB门禁【鸿蒙心迹】
一、拖进来的不是文件,而是一份还没有可信身份的声明
作品收集页最容易被误解的地方,是用户松开手指后界面已经出现一张卡片,开发者就认为素材接收完成。实际上,视觉上的拖放动作、系统承载的数据、业务愿意保存的内容,是三个不同的事实。拖入对象可能带着文本、网页片段、图片描述,也可能包含当前页面根本不支持的格式。同一份内容还可能在不同记录里以不同样式出现。若把事件里的第一条记录直接写入作品库,页面看起来很顺畅,边界却已经失守。
本文关注的是拖入内容进入业务层之前那一小段交接:究竟认可哪种声明、怎样核对字节预算、旧页面的回调还能不能动当前会话、重复记录会不会被当作新作品。它并不实现跨设备文件传输,也不把一个MIME字符串视为授权凭证。为了把问题限定在可复核的范围内,我把系统拖拽事件与业务校验器拆成两个端口,以八条固定记录来说明校验策略。没有调用真实系统拖拽,所以示意页面上的通过和拒绝只是本地规则模型的结果。
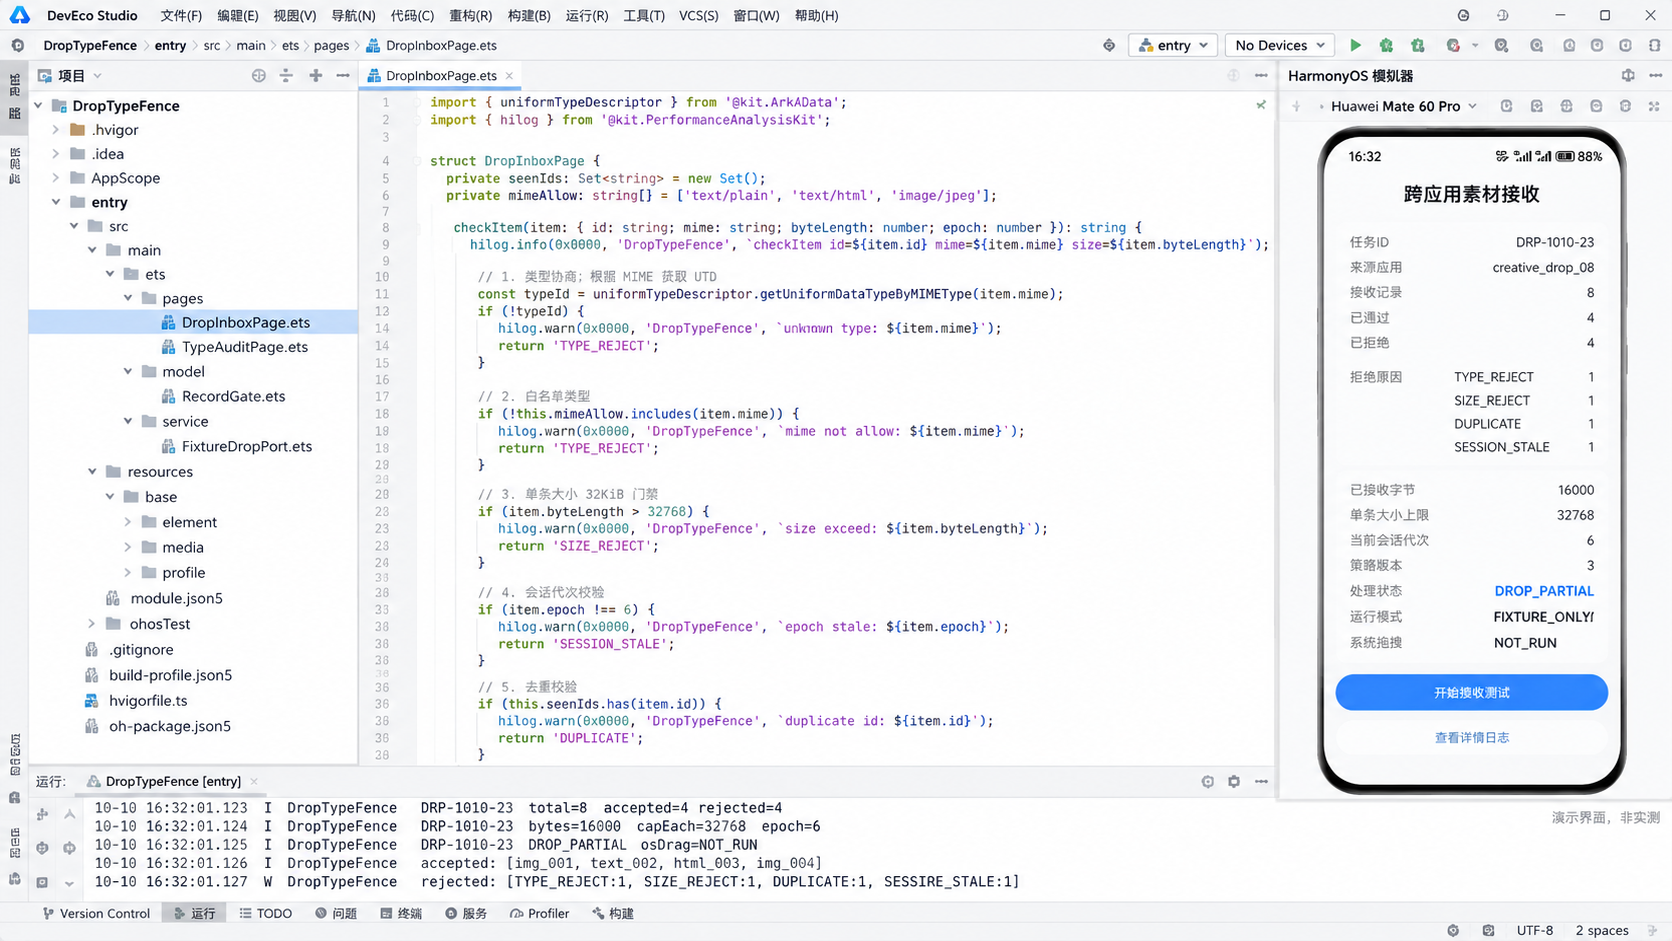
Demo取名为DropTypeFence,主页面DropInboxPage负责显示接收清单,TypeAuditPage负责展开展示拒绝原因;RecordGate接收已经归一化的输入,FixtureDropPort只提供固定记录。任务号DRP-1010-23,数据批次creative_drop_08,策略版本3,当前会话代次6。我们先固定这些名称,再让代码、页面和日志使用同一份合同,避免调试时因为时间、索引和状态名不一致而把注意力耗在素材上。
二、接收端不能把MIME映射当成安全裁决
UDMF把跨应用、跨设备的数据交换表达为统一数据类型与统一数据结构。官方UTD文档区分了标准类型之间的归属关系,也提供从MIME映射到统一类型标识的接口。这对接收方非常有价值:不同来源的声明终于能通过相对一致的语言描述。问题在于,类型映射解决的是“如何称呼它”,并不能自动证明内容真实、安全、属于本次会话。getUniformDataTypeByMIMEType对于未命中情形还可能按规则返回动态类型,因此不能依赖“有返回值”来放行。
我们的内容工具只支持三类输入:text/plain、text/html和image/jpeg。前两者仅进入文本候选区,后者进入图片候选区;其它类型无论映射出的UTD是否存在,一律按业务白名单拒绝。这不是说PDF不安全,而是这个入口没有为PDF预览、病毒扫描、持久化策略与许可证提示准备完整处理链路。支持能力的缺口,最好在数据入库前清楚暴露,而不是让用户看到一张“接收成功”但永远打不开的空卡片。
还要留意大小限制的量纲。本文的32768严格是单条记录的字节数,换算为32KiB,而非32KB,也不是全部批次的总大小。我额外给一次业务批次设置65536字节的上限,两者作用不同:单条上限抑制异常记录,批次上限抑制大量小记录的累积占用。在真实产品里,记录的声明长度还需要与实际取得的字节长度交叉核对,不能只信发送方给的数字。本例尚未取得系统真实数据,使用的是已写死的夹具长度。
从工程组织上看,入口首先接收的是一个应用自定义的FixtureRecord,里面只放不带权限意义的ID、MIME、长度、代次和摘要键。后续若接入onDrop,需要另外实现事件数据提取与临时资源生命周期,不能把这里的类型直接冒充系统回调参数。以下代码解决的是MIME大小写与空格归一,并把系统的UTD映射结果作为可观测信息,同时让显式白名单承担准入判断。
import { uniformTypeDescriptor } from '@kit.ArkData';

export interface FixtureRecord {
  id: string;
  mime: string;
  byteLength: number;
  epoch: number;
  fingerprint: string;
}
export interface TypedRecord extends FixtureRecord {
  utdId: string;
}
export function describeRecord(input: FixtureRecord): TypedRecord {
  const mime = input.mime.trim().toLowerCase();
  let utdId = 'UNRESOLVED';
  try {
    utdId = uniformTypeDescriptor.getUniformDataTypeByMIMEType(mime);
  } catch (_error) {
    // 映射失败只影响诊断,不改变业务白名单。
  }
  return { ...input, mime: mime, utdId: utdId };
}
这段代码没有读任何设备文件,也没有凭空把未知MIME变成允许的格式。后续若要支持image/png或音频,应该新增处理器和验收样例,而不是仅在一个数组里多写一行。映射异常也不会导致页面直接崩溃:显示诊断字段UNRESOLVED,让下一道业务门禁决定拒绝。fingerprint是夹具为排查重复提供的键,并非加密签名,不能拿它判断外部数据是否可信。
三、门禁顺序会决定拒绝原因是否可解释
在同一条记录同时有多个问题时,系统必须明确先检查哪一项。本文固定顺序为:会话代次、MIME白名单、单条及批次大小、重复键,最后才将数据加入本轮接收账本。会话最先检查,是为了让旧页面的迟到消息不产生任何额外工作;类型其次,是为了避免对根本不受理的数据做解码尝试。把重复检查放在写入前,目的不是追求某个数字好看,而是让一次业务动作能够幂等。
对单条大小还要防止负值、非整数和超大整数。虽然这里的输入来自本地夹具,在真正边界上不该允许NaN、小数长度或负长度经过算术计算进入预算。对于数字溢出与二次读取变化,应由真正的数据端口用已取得的字节长度再做一次判断。跨应用传来的文本也不能未经清洗直接渲染为可执行HTML;接受text/html在当前Demo里只意味着把它放进待检查区,不意味着调用ArkWeb执行其中脚本。
门禁只持有当前会话已接受的指纹集合,不直接持有原始系统对象。该集合在新会话开始时整体重建,避免上一位操作者的记录影响下一位。下面的代码展示业务核心;输入长度来自夹具,真实接入必须用真实字节数替代。所有通过、拒绝的结果都用有界枚举表示,诊断页不会从自由文本推断状态。
type GateCode = 'ACCEPT' | 'TYPE_REJECT' | 'SIZE_REJECT' |
  'DUPLICATE' | 'SESSION_STALE';

export class RecordGate {
  private acceptedFingerprints: Set<string> = new Set();
  private acceptedBytes: number = 0;
  private readonly allowMimes: string[] = ['text/plain', 'text/html', 'image/jpeg'];
  readonly activeEpoch: number = 6;

  check(record: TypedRecord): GateCode {
    if (record.epoch !== this.activeEpoch) return 'SESSION_STALE';
    if (!this.allowMimes.includes(record.mime)) return 'TYPE_REJECT';
    const bytes = record.byteLength;
    if (!Number.isSafeInteger(bytes) || bytes < 0 || bytes > 32768 ||
      this.acceptedBytes + bytes > 65536) return 'SIZE_REJECT';
    if (this.acceptedFingerprints.has(record.fingerprint)) return 'DUPLICATE';
    this.acceptedFingerprints.add(record.fingerprint);
    this.acceptedBytes += bytes;
    return 'ACCEPT';
  }

  totalBytes(): number { return this.acceptedBytes; }
}
这里的先后次序必须写入测试,不应该由某次重构意外改变。设想一条来自代次5的HTML同时超过32KiB,系统应报告SESSION_STALE,因为它已经不属于当前页面。如果先查长度,错误日志看起来像“大文件被拒绝”,排查者反而会去调整预算。实际产品可以另设多原因诊断模式,但不应让多个相互矛盾的原因同时改变业务结果。上面的单次返回保证只有一个主要拒绝码。
清单的提交也不能无脑把ACCEPT就等同于“已永久导入”。本文分成“模型已接受”与“持久化已完成”两条状态线。图中的绿色标签只代表前者,文件复制、图片解码、HTML消毒、数据库写入都还在另一个尚未实现的端口。这类诚实的中间态对技术文章尤为重要:不能因为把按钮画成绿色就宣称跨应用素材已完整落库。
四、八条输入,四个拒绝理由各司其职
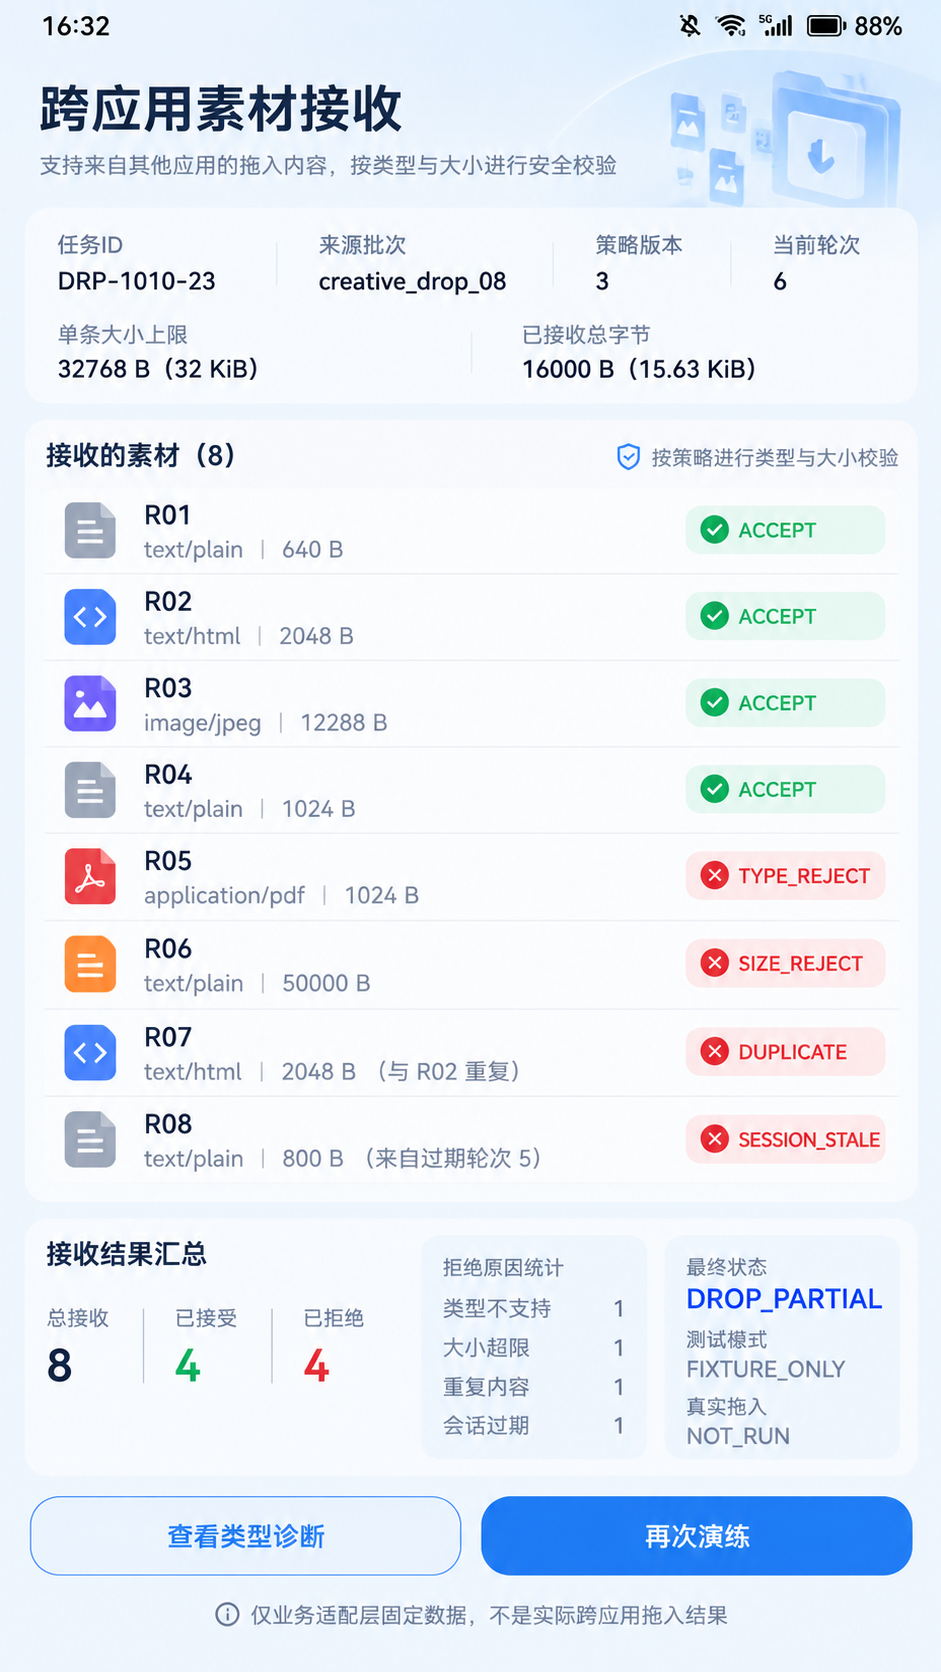
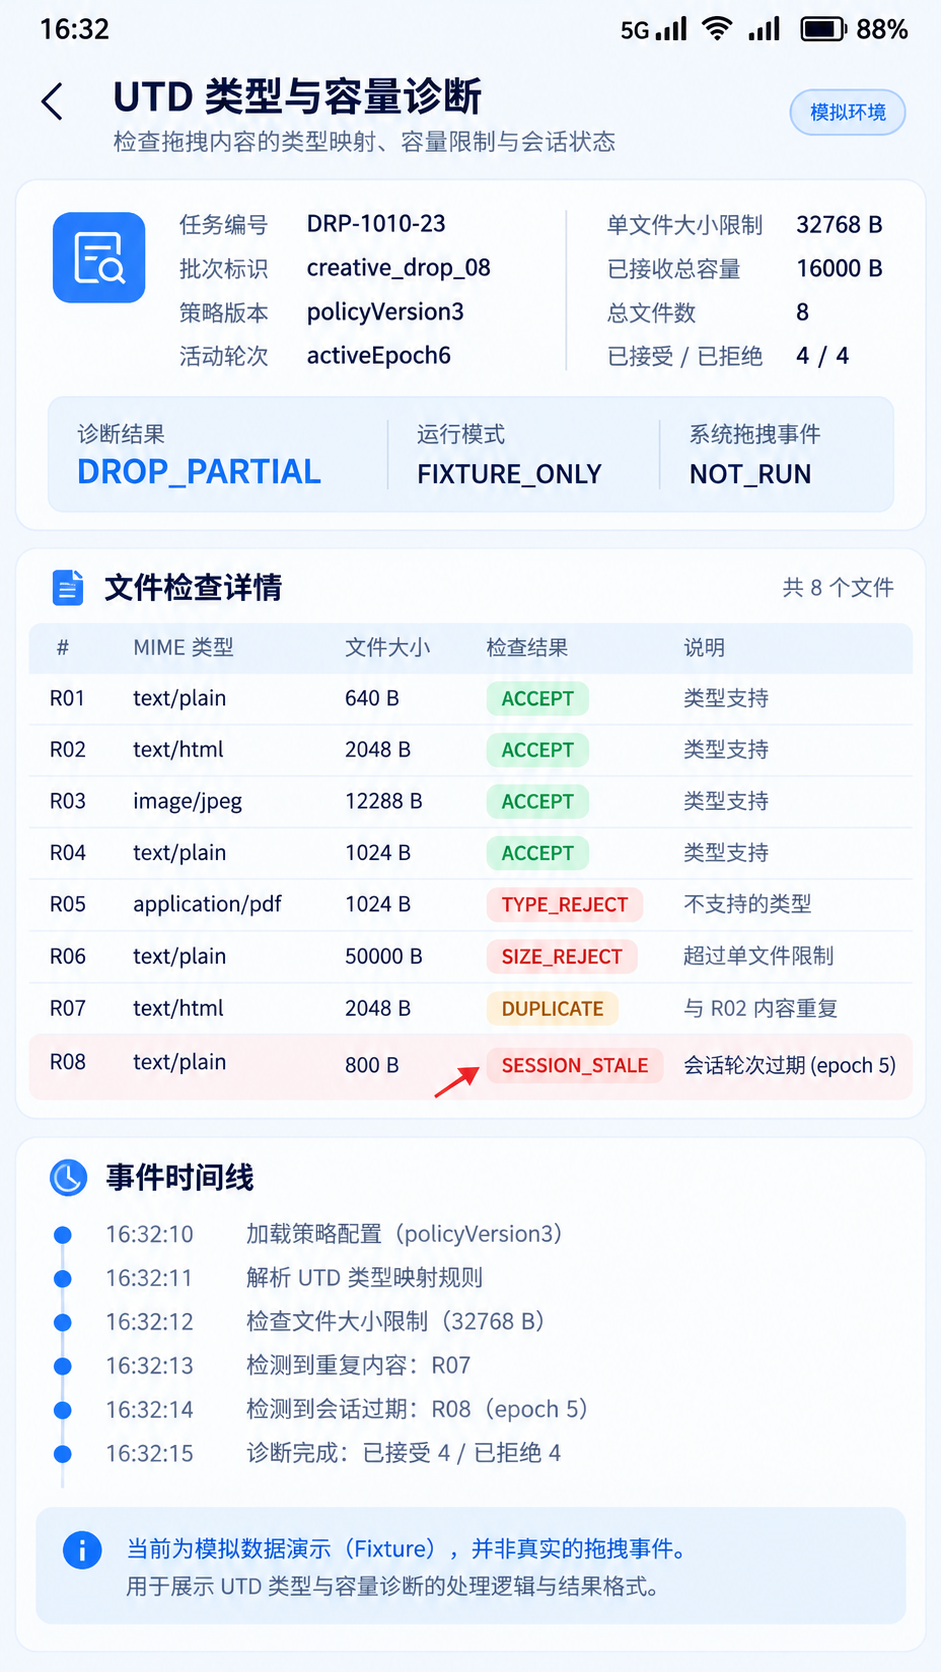
为了让读者能在没有NFC标签、没有另一台手机的情况下检查判定逻辑,固定记录批次只包含八条。R01为640字节纯文本,R02为2048字节HTML,R03为12288字节JPEG,R04为1024字节纯文本,这四条通过,合计16000字节。R05是1024字节PDF,命中TYPE_REJECT;R06是50000字节纯文本,命中SIZE_REJECT;R07声明与R02相同的内容指纹,命中DUPLICATE;R08虽然只有800字节,却来自代次5,因此命中SESSION_STALE。
输入表的功能并非证明UTD解析覆盖了所有厂家格式,而是证明业务层对“未知、过大、重复、过期”有可区分的归宿。这四类错误在用户界面上也应使用不同文案:不支持的类型提供变通路径,过大的文件提示压缩,重复内容提示已在清单,过期会话只提示本次操作已失效,不要让用户去修改文件本身。本文把结果统一为DROP_PARTIAL,表示当前批次部分可接受、部分仍需要处理,不将它伪装为系统拖入完成。
验收时最好额外关心三个反例。第一,如果R06先被接受再统计大小,UI和账本可能短暂超限;第二,若重复内容指纹没有按会话清理,新一轮导入同一张授权图片就会被无故拒绝;第三,UI从详情页返回后,旧回调可能晚于新回调,如果仅按当前路由字符串检查,两个不同的页面实例会被误判为同一会话。为此,epoch必须由接收实例明确持有,页面消失时旧实例失效,而不是只根据文件名匹配。
本地模型还会保留各项计数:received=8、accepted=4、rejected=4、TYPE_REJECT=1、SIZE_REJECT=1、DUPLICATE=1、SESSION_STALE=1、acceptedBytes=16000。任意一个拒绝分支忘记计数,账本就无法解释accepted + rejected = received是否成立。反过来,如果仅看总量8/4/4,也不能证明四种拒绝都经历过,因此需要逐条断言状态名称。
五、日志要指向动作,而不是把外部内容全部打印出来
真实拖拽数据可能包含联系人、粘贴文本、工作文档、图片元信息。工程日志不应该直接写出完整HTML、原始路径或拖拽的二进制内容。本文只记录脱敏ID、MIME大类、长度、会话代次和判定码,重复键也只写一个固定摘要标识,不把它当作安全哈希。这样既能复盘规则,也避免诊断页面成为第二个泄漏入口。
我把日志缩成两个层面:一个是任务摘要,形如DRP-1010-23 total=8 accepted=4 rejected=4;另一个是原因细项,显示四个拒绝码的计数。时间轴在16:32:10加载策略,16:32:11核对MIME,16:32:12检查容量,16:32:13拒绝重复R07,16:32:14拒绝旧会话R08,16:32:15给出总结果。这些时间均为设计夹具,不是抓取到的HiLog真实输出,更不表示耗时达到了某项性能指标。
日志的生命周期还应短于业务数据。页面离开时要撤销尚未完成的接收事务,清空对临时文件的持有,若未来接入文件描述符,应在成功与异常两条路径中成对关闭。图片解码出的PixelMap、临时URI授权、外部拖入的数据对象,都不能长期被RecordGate保存。这个Demo刻意让门禁只保存数字与指纹,目的就是把平台资源释放问题限定在数据适配器,而不是散落到列表组件的每个按钮回调里。
六、把可验证边界留给真正的系统接入
这套设计的一个重要取舍,是没有把onDrop的回调签名、UnifiedData记录读取与拖入资源持有写成一段貌似能跑的万能代码。官方统一数据类型文档说明了UTD映射规则,拖拽指南也介绍了拖入的数据传递场景;但具体接入还取决于目标控件、来源应用、权限、设备协同条件和目标API版本。离开当前固定输入范围去描述平台行为,必须在DevEco编译和设备权限验证后再下结论。
接入真正的拖拽端口时,我会按先后关系设置四个验收关口:先取得系统事件及记录数量,再明确每条记录的实际字节量,之后按本门禁执行类型与会话校验,最后将可接受的内容交给安全存储适配器。任一步失败,都不能回填“已保存”的成功标签。对JPEG,还要验证声明类型与实际文件内容一致,解码时设定图片像素上限;对HTML,必须先净化内容,再决定可否展示。这些扩展都是下一阶段工作,不属于本轮夹具已验证结果。
如果目标是跨设备拖拽,还应单独验证设备能力与网络条件,不能把“同系统内跨应用”直接推断成“任何设备间都可以”。同样,32KiB来自这个Demo的业务保护策略,不是HarmonyOS UDMF强制的系统上限,不应写进公共API说明。最值得保留的结论不是一个神奇的阈值,而是所有外部记录都要走同一条可解释、可撤销、可审计的准入路径。
此次素材包只完成应用侧门禁方案、固定夹具的预期演算和示意界面;没有DevEco Studio编译记录,没有真实跨应用拖拽事件,也没有数据库提交结果。下一次真正验证时,应提供原始事件摘要、目标设备API等级、已授予的权限、拒绝码清单和资源释放日志,再把状态从FIXTURE_ONLY推进到可以被设备数据支持的结论。
七、核对表与依据
文章与四张图共享以下不变量:任务DRP-1010-23,批次creative_drop_08,策略版本3,当前代次6,单条上限32768字节;八条记录中接受四条、拒绝四条,接受字节合计16000,四种拒绝各一条;应用状态DROP_PARTIAL、模拟模式FIXTURE_ONLY、真实系统拖入NOT_RUN。如果后续修图发现这些字段不一致,应以明确的数据合同为准重生成,而不是悄悄改写正文来迎合一张错误示意。
官方资料:华为《标准化数据定义概述》(2026-03-09)阐述UTD、数据结构和多样式数据的关系;《Uniform Data Definition and Description》明确getUniformDataTypeByMIMEType的接口与可能的动态类型返回;官方拖拽场景说明给出应用内与应用间的边界。本文类型白名单、32KiB上限、fingerprint与epoch均是应用自主策略,不是系统内建校验器。
资料入口:https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/unified-data-definition-overview;https://developer.huawei.com/consumer/en/doc/harmonyos-references-V14/js-apis-data-uniformtypedescriptor-V14;https://developer.huawei.com/consumer/cn/doc/doccenter-ux-design/hmi-scenes-drag-0000001795410277。
八、让夹具能够抓住改坏门禁的代码
单看首页展示八张卡片,实际很容易把“数据正确”错认为“规则正确”。一个更有价值的做法,是在校验器旁边放一份具名样例集合:每条记录都声明希望得到哪个拒绝码;校验器改动后先检查八个逐条结果,再检查总计数与字节账本。这样当有人把MIME判断移到会话判断之前、或者为了性能把重复指纹判断删掉,回归检查会在相应的R05至R08上直接失败,而不只是首页的一个红色数字变化。
夹具需要固定记录顺序,因为acceptedBytes和seen是有状态的。对文件导入来说,顺序本身就是业务规则的一部分:先接受哪个素材会影响剩余预算,尤其当多个有效大文件同时排队时。本文选用顺序执行只是为了把账本解释清楚;如果后续改成并发解码,必须增加串行提交阶段,不能让多个Promise并行读取同一个旧预算后都认为自己有资格通过。接受阶段可以并行预检、不可并行无锁记账,是这个实现最重要的扩展约束之一。
代码中的固定夹具用于解释输入合同,不是从第三方应用真实读出的记录。四条有效记录和四条错误记录被明确列出来,期望值不应该由程序运行结果反算出来,否则校验器把错误全部标成成功,测试也会跟着高兴。输入里的fingerprint只演示幂等键机制,不具备抗碰撞保证,真实应用要根据业务身份、会话标识及经过验证的内容摘要重新确定指纹的生成与保存范围。
const fixture: FixtureRecord[] = [
  { id: 'R01', mime: 'text/plain', byteLength: 640, epoch: 6, fingerprint: 'a01' },
  { id: 'R02', mime: 'text/html', byteLength: 2048, epoch: 6, fingerprint: 'a02' },
  { id: 'R03', mime: 'image/jpeg', byteLength: 12288, epoch: 6, fingerprint: 'a03' },
  { id: 'R04', mime: 'text/plain', byteLength: 1024, epoch: 6, fingerprint: 'a04' },
  { id: 'R05', mime: 'application/pdf', byteLength: 1024, epoch: 6, fingerprint: 'a05' },
  { id: 'R06', mime: 'text/plain', byteLength: 50000, epoch: 6, fingerprint: 'a06' },
  { id: 'R07', mime: 'text/html', byteLength: 2048, epoch: 6, fingerprint: 'a02' },
  { id: 'R08', mime: 'text/plain', byteLength: 800, epoch: 5, fingerprint: 'a08' }
];
const expectCodes: string[] = ['ACCEPT', 'ACCEPT', 'ACCEPT', 'ACCEPT',
  'TYPE_REJECT', 'SIZE_REJECT', 'DUPLICATE', 'SESSION_STALE'];
const gate = new RecordGate();
fixture.forEach((record: FixtureRecord, i: number) => {
  const actual = gate.check(describeRecord(record));
  if (actual !== expectCodes[i]) throw new Error(`${record.id}: ${actual}`);
});
if (gate.totalBytes() !== 16000) throw new Error('byte ledger mismatch');
这里最需要解释的是“重跑”。如果保持同一个RecordGate实例重复执行这段代码,第二次的R01就会被识别为重复,这是合理的会话状态,却会让夹具误报失败。所以每次校验都必须重新实例化一个门禁,或者显式创建新的会话代次并清空旧账本。真实UI中的“再次演练”按钮也应该执行这个动作,不能简单触发同一个对象的check循环。凡是把测试输入、状态对象、输出断言绑定在同一生命周期的实现,回归结果才有可解释性。
九、准备上线时还要补齐的安全与体验债
第一项债是输入的双重身份。MIME和UTD只是标记,内容实际格式可能不同。一个带JPEG扩展名的文件可以不是JPEG,一个HTML片段可以内嵌大量外部引用。接收端必须在业务白名单之外,补上文件魔数与结构检查、编码边界、内容净化和目标应用的权限评估。否则日志里写着ACCEPT,下一步解码时仍可能出错。这里的放行不等同于最终安全,也不构成防恶意输入的完整方案。
第二项债是用户可理解的失败。TYPE_REJECT应告诉用户当前只支持什么类型,SIZE_REJECT应展示单条上限与实际体积,DUPLICATE要给出已接收项目的可定位标识,而SESSION_STALE最好提示“页面已经更新,请重新拖入”,不该把系统内部的epoch数字暴露成用户必须理解的概念。开发日志可以保留机器码,界面文案却必须用正常人的语言说清楚下一步能做什么,且不能泄漏敏感路径和全文内容。
第三项债是取消与回收。拖拽可能发生在窗口切换、页面隐藏或应用退后台期间。接收端需要明确会话结束的触发点,取消仍在排队的图片解码与网络读取,把已借出的资源按其原始所有者归还,并在必要时删除本次事务创建的临时文件。若以后使用真正的UDMF UnifiedData、文件描述符、PixelMap等系统对象,应为每种对象制订拥有者和释放函数表,而不是用一个通用clear()假装所有资源都已经释放。
第四项债是计量精度与性能。实际字节数不能由字符数简单代替:Unicode多字节文本、HTML序列化后的实体编码、压缩图片大小与解码后像素占用完全可能相差几个数量级。32KiB在本文仅约束接收记录的外层载荷,并没有约束JPEG解码后的内存,解码仍需要独立像素预算。若数据来自网络、跨设备通道或高频连续拖入,还需测量读取速率、拒绝比例、取消耗时和临时目录的资源基线,避免小数据积累造成长尾卡顿。
最后是API版本和真实可用性。不同设备与系统版本可能采用不同的拖拽承载能力,部分行为还有来源应用参与。本文不声称某台手机、某个系统版本完成了八条系统事件测试。读者把本例搬进项目时,要先在开发工具中以实际目标API编译、使用来源不同的真实应用拖入、观察回调与授权生命周期,再拿固定夹具作为对照验证业务门禁。只有经过这些步骤,文章里的状态才能从演示模型提升为可验证的产品结论。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献230条内容

所有评论(0)