
【调优工具】Flutter鸿蒙应用为什么选择使用HiSmartPerf
由于Flutter鸿蒙应用的系统能力是依赖HarmonyOS的,从端到端分析性能的话,就天然分为了两个部分:
第一部分是Dart侧,可以直接使用官方推荐的DevTools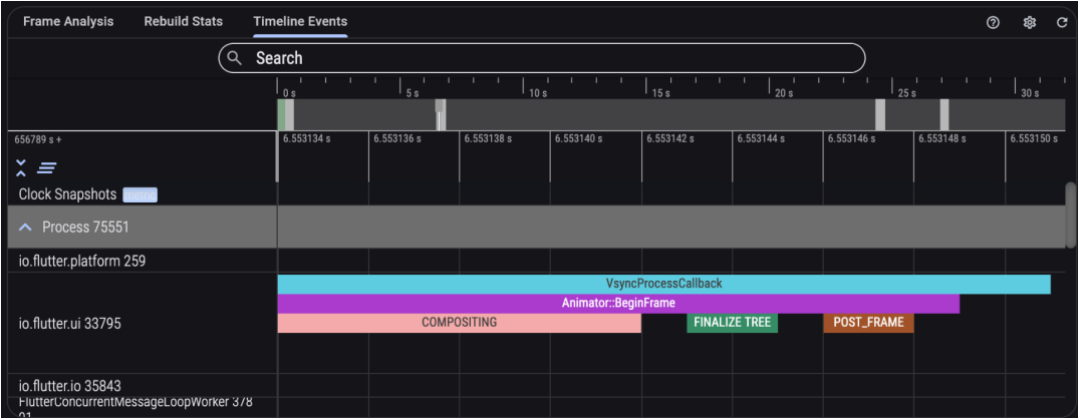
第二部分是HarmonyOS系统侧,我推荐的是HiSmartPerf(之前叫SmartPerf)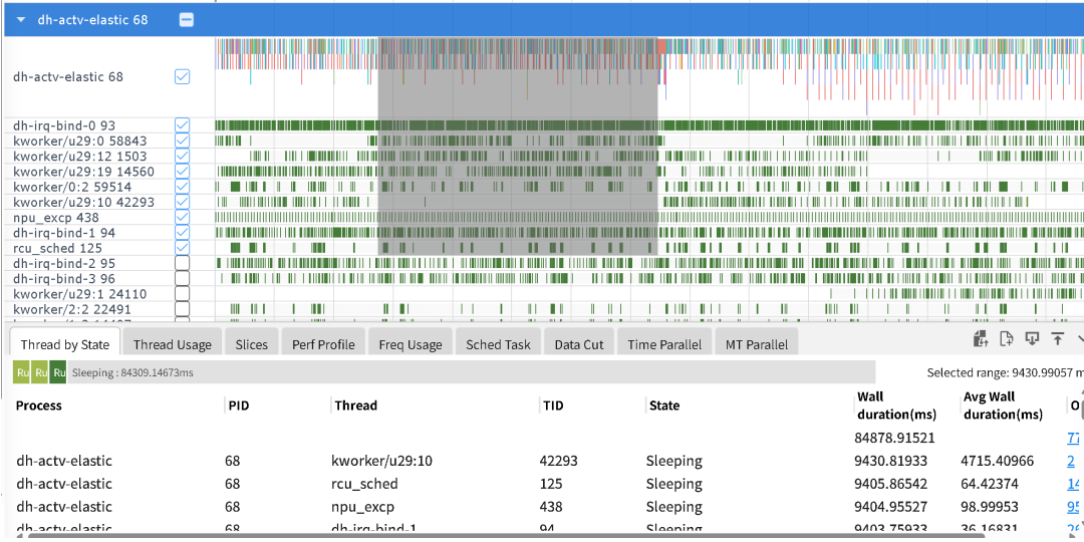
我们使用DevTools的Timeline是能看到每一帧在 UI 线程和 Raster 线程上怎么花销的,而CPU的调度、RenderService的合成、内存的回收、文件IO等这些发生在应用进程之外的事,DevTools就无法看不到了,这一部分就是这一系列HiSmartPerf工具的专长了!
那么HiSmartPerf是什么?
- Google开源的性能分析工具Perfetto(官方网址为perfetto.dev)应该大厂的小伙伴都知道,这个工具的前身是Systrace,Android性能领域的小伙伴肯定都用过;那么HiSmartPerf 大家可以理解为专为HarmonyOS系统打造的性能调优工具,目前也是开源的,能力覆盖非常完整,是鸿蒙系统及应用调优的专业工具。
可能小伙伴们就要问了,我只是调试个应用而已,为啥要用这个系统级工具?因为我们的应用,在系统层面只是一个进程而已,在HiSmartPerf上,也就只是一个泳道图罢了,我们可以通过系统级的抓取,全局看到整个系统级调度。比如同一帧掉了,可能是Dart build慢,可能是raster被GPU拖住,也可能是线程没抢到调度,而后两种问题根因的答案都在系统trace里!
一、如何理解HiSmartPerf的观测点
HiSmartPerf 的所有观测点都落在操作系统层:内核 tracepoint、perf 硬件采样、eBPF、procfs、系统服务。而任何 Flutter 鸿蒙应用,无论 Dart 代码怎么组织,在操作系统眼里都是一个标准的OHOS用户态进程。
HiSmartPerf 工具观测的是进程与系统,工具不关心进程里跑的是什么框架,框架只是进程里的一段用户态代码。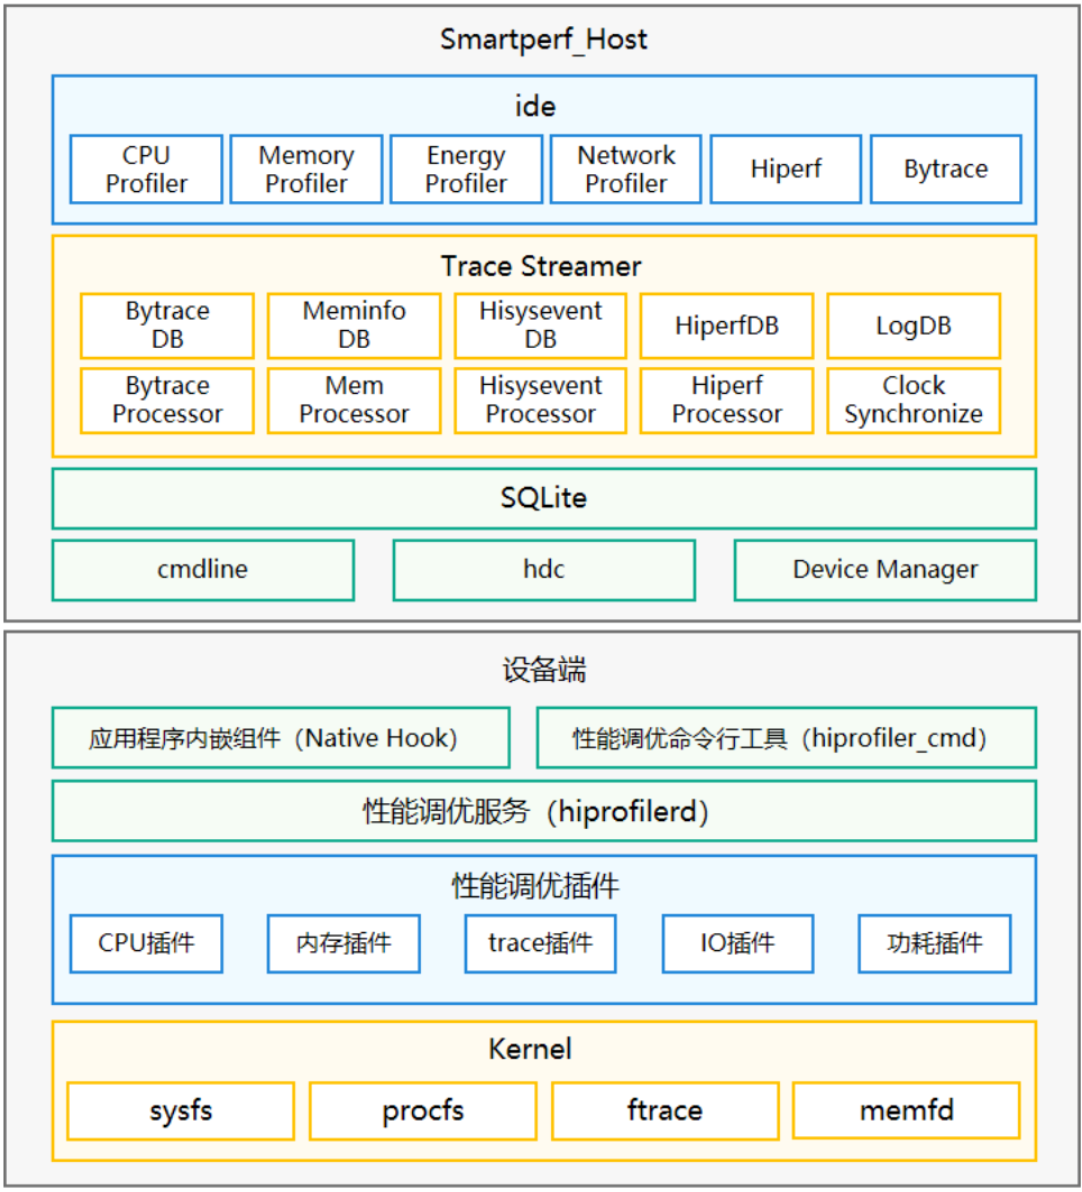
二、数据源全在系统层
HiSmartPerf下的hiprofiler_cmd工具生成的命令会下发给设备端的采集插件,而插件分两类:
流式插件(如 ftrace 插件,按固定周期从内核缓冲区读数据)
轮询插件(memory、cpu、diskio 等,按采样间隔主动采集)
所有插件询问的对象是内核与系统服务。主要数据源如下:
| 面板/数据 | 底层机制 |
|---|---|
| CPU 泳道、调度、唤醒树 | ftrace(sched 相关 tracepoint) |
| FrameTimeline | 图形子系统 trace 事件 |
| hiperf | perf_event 采样 |
| NativeMemory | malloc/free hook |
| smaps 五泳道 | 轮询 /proc/pid/smaps |
| Bio / FileSystem / SysCall | ftrace 块层事件、系统调用追踪 |
| page_fault | eBPF 探针 |
| Xpower / hilog | 系统功耗与日志服务 |
解析侧同样如此:通过 trace_streamer 把 trace 转成 sqlite,解析的事件格式来自内核与系统服务,与应用框架没有任何耦合。
三、Flutter 鸿蒙应用就是一个标准 OHOS 进程
把一个 Flutter 鸿蒙应用解剖开,每一层都是标准 OHOS 组件:最外面是 ArkTS 壳层(EntryAbility,跑在 ArkTS 运行时),往里是平台 C++ 嵌入层(负责把引擎接进系统),再往里是 libflutter.so(引擎:Dart VM、Rasterizer、各工作线程),最底下是 Dart AOT 产物加插件 so。三个关键事实撑起可观测性:
进程是系统拉起的: 安装后就是 HAP,进程由系统的 AbilityRuntime 体系启动,走同一套生命周期。启动八阶段泳道(ProcessTouchEvent 到 First Frame)的标记是系统打的,与应用框架无关。
线程是内核线程: Platform、UI、Raster、IO,每条在内核里都是普通的调度单元,有 tid、优先级、调度策略、唤醒关系。HiSmartPerf 的 CPU 泳道、唤醒树作用在它们身上,和作用在任何系统线程身上完全一样。
引擎的输出走系统标准通道: 上一个 DFX 系列已经证实过,引擎日志的三个源头(FML_LOG、平台 C++ 层、ETS 嵌入层)全部汇入 HiLog。日志如此,trace 也如此,引擎源码里的 trace 插桩在 OHOS 构建下接到系统 tracing,引擎内部事件因此能进入 trace 流。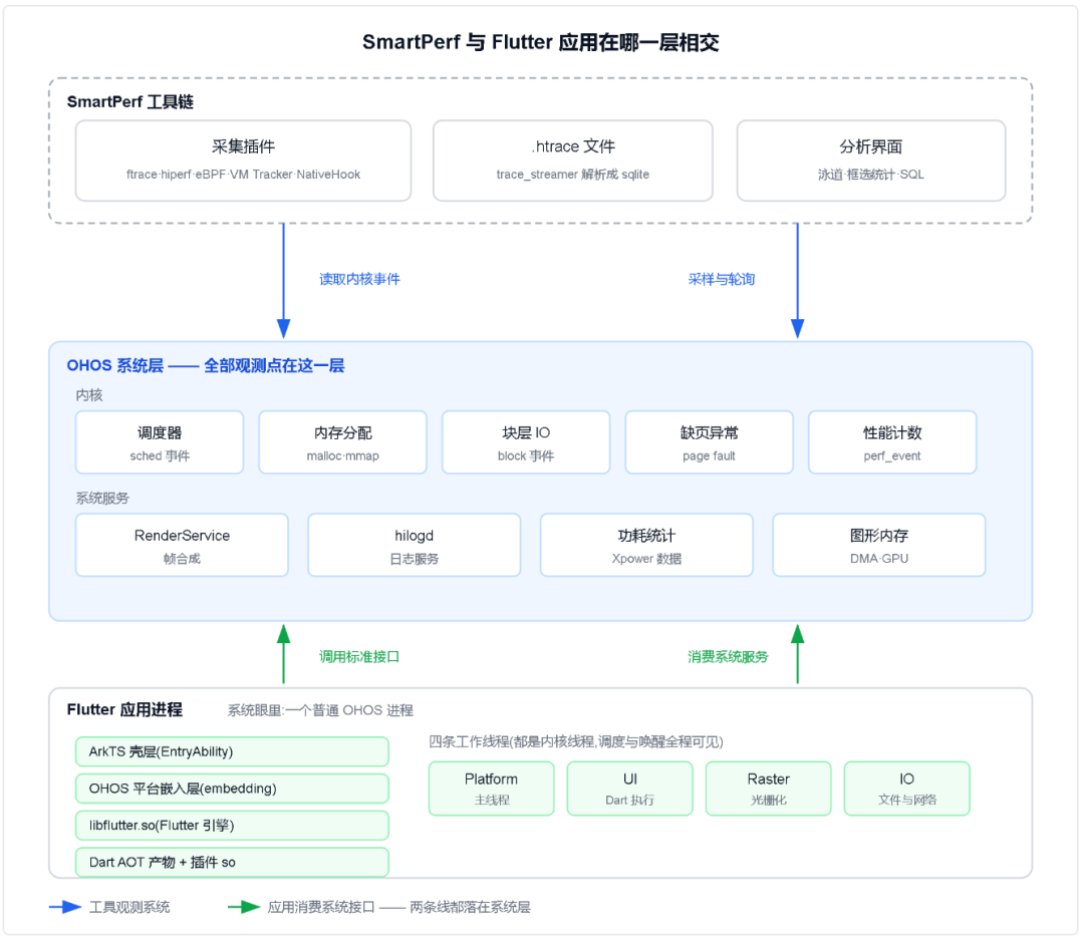
打开一份真实 trace,看到的就是这个结构:每个进程一条泳道,Flutter 鸿蒙应用和系统服务、其他应用并排平铺。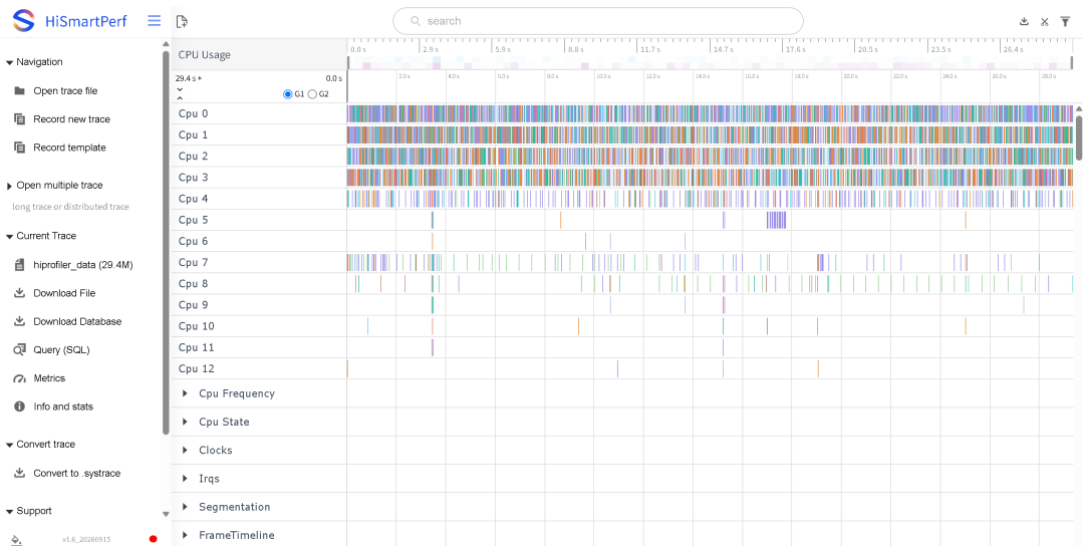
图:一份真实 trace 打开的样子
四、引擎与系统的每个边界都是标准接口
Flutter 应用和系统的每次交互都发生在 OHOS 标准接口上,而这些接口正是 HiSmartPerf 的观测点,帮助大家理解:
上屏:嵌入层通过 XComponent 拿到 OHNativeWindow,Raster 线程把画好的帧放进这个窗口的 buffer,经 BufferQueue 提交给 RenderService 合成,再交硬件合成器上屏。从系统看,Flutter 应用就是一个往 BufferQueue 生产画面的进程,和 ArkTS 自绘应用、视频播放器是一样的。
VSync:引擎向系统订阅垂直同步信号来驱动每帧,信号源在系统侧,分发可被记录。
内存:引擎和插件的每次分配经过 malloc/mmap。
图形内存走系统通道,所以 DMA、Skia GpuMem 泳道能反映 Flutter 的图像资源。
IO:Dart 侧的文件读取最终落到系统调用与块层。
所以:引擎是 OHOS 系统接口的一个普通消费者,消费行为全部可被系统侧观测。
拿掉帧来走一遍这条接缝,每一站都有对应的观测面板: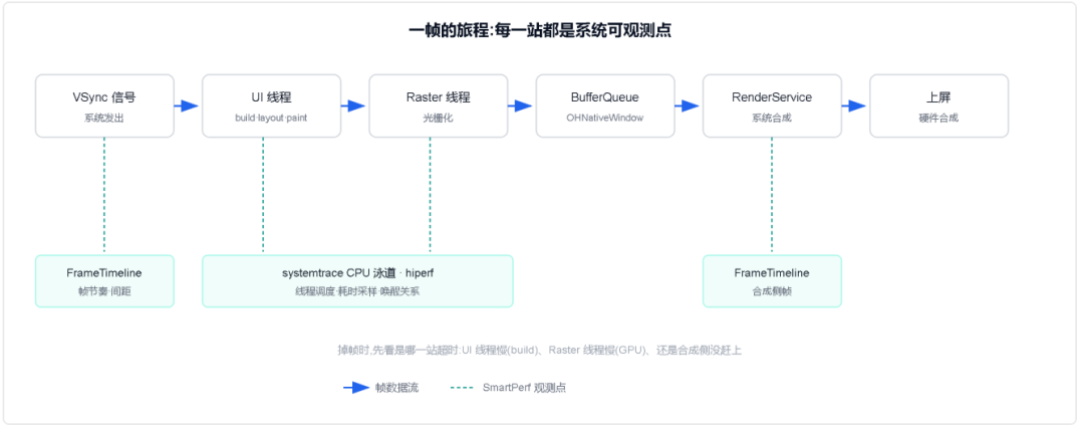
图:UI 线程、Raster 线程在应用进程内,合成与上屏在系统侧,全程可观测
以上就是开篇的所有内容了,理解了这篇的初衷,后面大家就跟着我一步一步把HiSmartPerf用起来!
点赞+关注
关注 CPF-Flutter 社区
“AI再牛,技术不能丢

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 3
 0
- 0


 已为社区贡献15条内容

所有评论(0)