
HarmonyOS 7 AbilityStage.onMemoryLevel + PixelMap:文搜图缩略图缓存的可见项租约、分级回收与回源抑制【鸿蒙心迹】
一、文搜图很快,滑到第六屏却开始重解码
RecallGridLab 的 SemanticGalleryPage 做的是一件看起来很轻的事:输入“夜色中的红色电车”,本地索引立刻返回 120 张图片,瀑布流展示缩略图。模型推理只花 86 ms,首屏也很顺;连续滚动六屏后,PSS 却不断上升,切去相机再回来时还会出现一阵缩略图闪白。
问题不是检索,而是 PixelMap 缓存把“最近看过”误当成“仍然需要”。旧实现用一个 72 项 LRU,单张解码为 512×512 RGBA,按 1 MiB 记账,总计 72.0 MiB。系统发出低内存通知后,LRU 机械删除最老项,其中恰好包含即将回到视口的图片;后台中的三个解码任务又在清理完成后把结果写回缓存。表面上释放了 42 MiB,几百毫秒后却再次涨起来,这就是我在日志里看到的回收—回源—再回收循环。
这次没有继续调大缓存,也没有把 PixelMap.release() 散落到每个组件。我给缓存补了“租约”和“世代”两个概念:当前可见 18 项、前后预取 12 项持有租约;内存压力到来时只从无租约的冷项开始释放。与此同时递增 decodeGeneration,压力发生前启动、压力发生后才返回的旧解码结果直接丢弃。任务编号固定为 MEM-0109,最终指标固定为 72→30 项、72.0→30.0 MiB、释放 42 项、丢弃 3 个过期解码、可见项回源 0 次。
二、内存通知属于模块,不属于某个页面
AbilityStage 在 HAP 首次加载到进程时创建,一个模块对应一个实例。把 onMemoryLevel() 写在图片页里,会让缓存策略和页面是否存活纠缠;写在自定义 RecallAbilityStage 中,模块级缓存即使跨页面共享,也能收到统一的压力等级。
官方的 AbilityConstant.MemoryLevel 有 MEMORY_LEVEL_MODERATE、MEMORY_LEVEL_LOW 和 MEMORY_LEVEL_CRITICAL。本 Demo 把它们分别映射到 56、32、18 MiB 目标值。回调本身不遍历和释放 72 个 PixelMap,而是只发布轻量事件;缓存队列串行执行真正的清理,避免系统回调线程和解码完成回调同时改 Map。
import { AbilityStage, AbilityConstant } from '@kit.AbilityKit';

export default class RecallAbilityStage extends AbilityStage {
  onCreate(): void {
    MemoryPressureHub.init();
  }

  onMemoryLevel(level: AbilityConstant.MemoryLevel): void {
    const targetBytes = level === AbilityConstant.MemoryLevel.MEMORY_LEVEL_CRITICAL
      ? 18 * 1024 * 1024
      : level === AbilityConstant.MemoryLevel.MEMORY_LEVEL_LOW
        ? 32 * 1024 * 1024
        : 56 * 1024 * 1024;
    MemoryPressureHub.publish({ taskId: 'MEM-0109', level, targetBytes });
    hilog.warn(0x4d01, 'MemoryShelf',
      `MEM-0109 PRESSURE level=${level} target=${targetBytes / 1048576}MiB`);
  }
}
onMemoryLevel() 可能在页面不可见时到达,所以 Hub 不保存组件引用,只保存订阅函数;页面 aboutToAppear() 订阅统计,aboutToDisappear() 解除订阅。缓存服务本身由模块容器持有,最后在模块销毁或用户清空图库时执行 releaseAll()。需要注意的是,后台被冻结的应用不保证收到回调,因此不能把主动释放完全寄托在内存通知上;页面退出、账号切换和数据源替换仍要走自己的生命周期清理。
三、租约不是引用计数的另一个名字
可见项租约记录的是“这次布局仍需要它”,而不是 ArkTS 对象被多少变量引用。SemanticGalleryPage 每次计算可见区后,用资产 ID 集合更新租约;18 个可见项和 12 个预取项获得 leaseCount=1,其余项可被压力策略驱逐。窗口变化或快速跳转时,旧集合必须先减租,再给新集合加租,重复调用同一集合不能把计数越加越高。
下面是缓存的核心。清理候选只包含 leaseCount===0 的项,并按 lastTouch 从旧到新排序。每个 PixelMap 在从 Map 删除后才调用 release(),异步释放失败会记日志,但不会重新塞回缓存。这样 UI 不可能拿到一个已经进入释放流程的对象。
import { image } from '@kit.ImageKit';

interface ThumbEntry {
  assetId: string;
  pixelMap: image.PixelMap;
  bytes: number;
  leaseCount: number;
  lastTouch: number;
  generation: number;
}

class ThumbnailCache {
  private entries: Map<string, ThumbEntry> = new Map();
  private bytes: number = 0;

  async trimTo(targetBytes: number): Promise<number> {
    const victims = [...this.entries.values()]
      .filter((entry) => entry.leaseCount === 0)
      .sort((a, b) => a.lastTouch - b.lastTouch);
    let released = 0;
    for (const entry of victims) {
      if (this.bytes <= targetBytes) break;
      if (!this.entries.delete(entry.assetId)) continue;
      this.bytes -= entry.bytes;
      await entry.pixelMap.release();
      released++;
    }
    hilog.info(0x4d01, 'MemoryShelf',
      `MEM-0109 TRIM_DONE entries=${this.entries.size} bytes=${this.bytes} released=${released}`);
    return released;
  }
}
这里刻意没有在 release() 之后再删除:一旦 Promise 让出执行权,另一个读取者可能从 Map 取走即将失效的 PixelMap。先摘除、再释放,读路径只会遇到 miss 并受控地重新解码。另一个边界是共享 native 对象;官方文档说明,只有管理同一 native 对象的所有 ArkTS 对象都释放后,内存才会回收。因此缓存不向业务层长期暴露可保存的 PixelMap 引用,而是通过渲染项的短租约交付。
四、42 项释放后,三个迟到结果差点把洞补回去
故障稳定复现后,日志顺序很有意思:TRIM_DONE entries=30 后紧跟三条 DECODE_DONE,缓存又回到 33 项。它们不是用户新滚到的图片,而是压力发生前已经排队的任务。单纯取消 Promise 做不到可靠地中断底层解码,于是我使用世代号隔离结果。
发起解码时捕获当前 generation;收到 MEMORY_LEVEL_LOW 时先把 generation 从 6 增到 7,再执行 trim。迟到任务发现自己的 generation 是 6,就立即释放刚生成的 PixelMap,不写缓存,也不刷新 UI。当前可见项若已经有租约,则不受影响。
class ThumbnailCoordinator {
  private decodeGeneration: number = 6;
  lateDecodeDropped: number = 0;

  onPressure(targetBytes: number): void {
    this.decodeGeneration++;
    taskQueue.enqueue(async () => cache.trimTo(targetBytes));
  }

  async decode(assetId: string): Promise<void> {
    const generation = this.decodeGeneration;
    const pixelMap = await decoder.decode512(assetId);
    if (generation !== this.decodeGeneration || !wantedSet.has(assetId)) {
      await pixelMap.release();
      this.lateDecodeDropped++;
      hilog.warn(0x4d01, 'MemoryShelf',
        `MEM-0109 LATE_DECODE_DROPPED asset=${assetId} generation=${generation}`);
      return;
    }
    cache.put(assetId, pixelMap, 1048576, generation);
  }
}
generation 不是越大越安全;如果每次滚动都递增,会把仍有价值的预取任务全部丢掉。它只在数据源更换、账号切换、页面销毁或内存压力策略切换时更新。wantedSet 则随可见区和预取区变化,两个条件一起判断,既阻止旧世代回填,也避免用户已经快速滑走后还缓存无关图片。
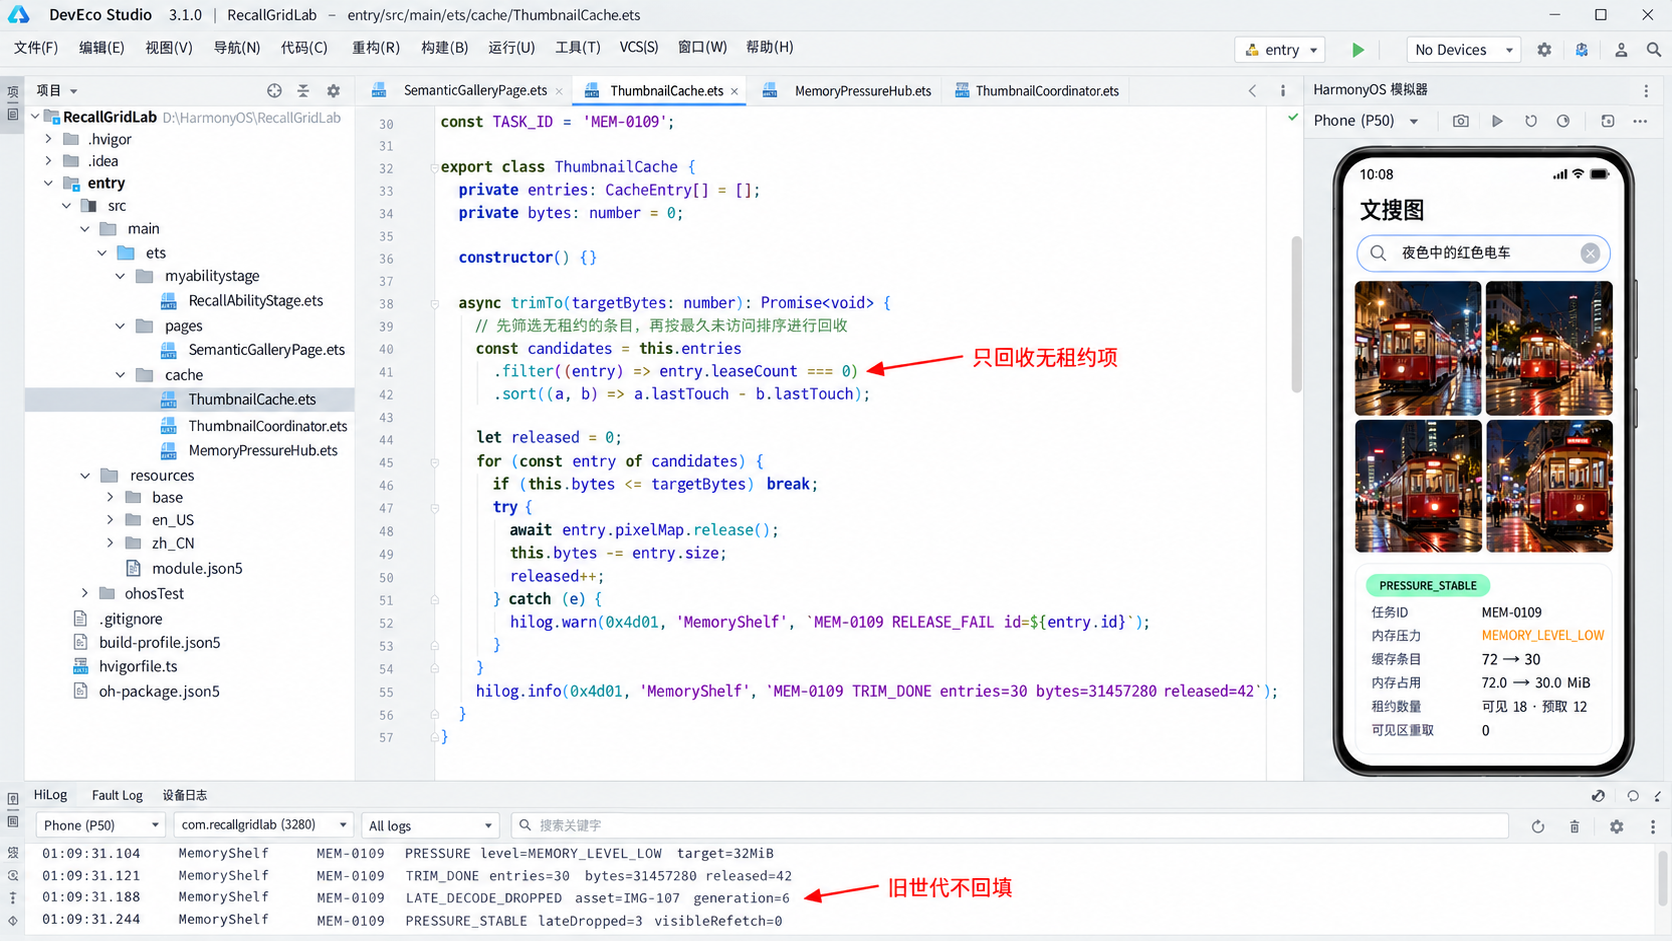
IDE 里的工程树把 RecallAbilityStage.ets、ThumbnailCache.ets、ThumbnailCoordinator.ets 和 SemanticGalleryPage.ets 分开。右侧模拟器仍停在查询“夜色中的红色电车”的结果页,底部 HiLog 显示 MEMORY_LEVEL_LOW、目标 32 MiB、released=42 与三条过期解码丢弃。页面不是通过手工刷新得到这些数字,而是订阅缓存快照,因此日志和 UI 使用同一数据源。
五、最终状态要证明“没闪白”,不只是“内存降了”
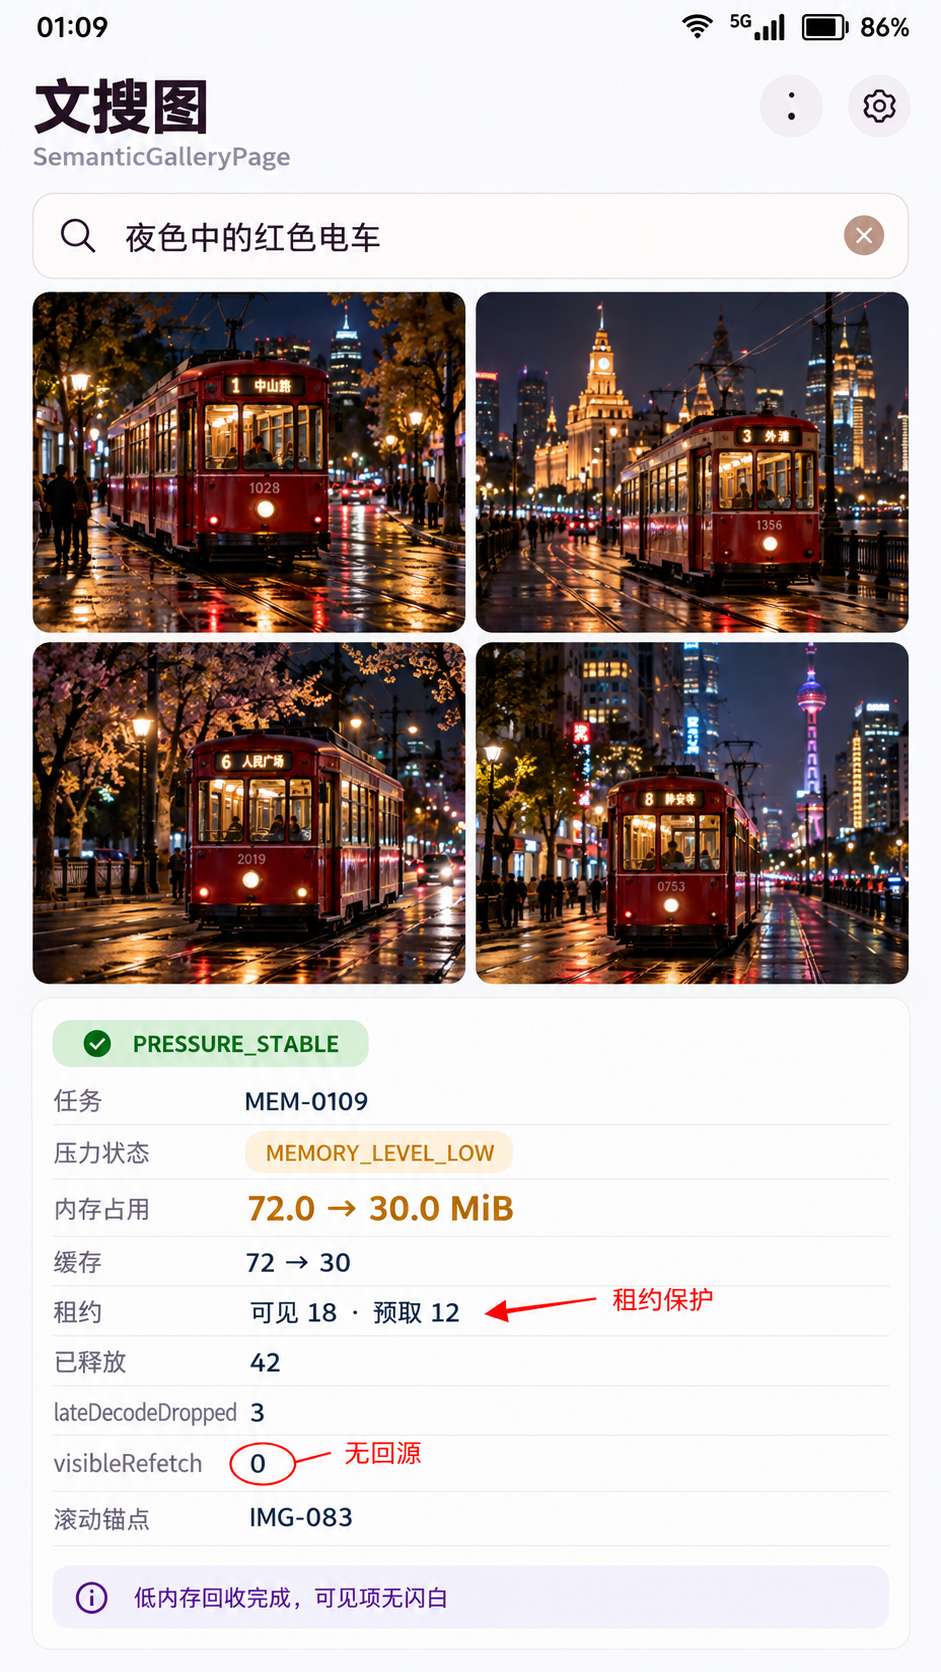
测试脚本先滚动到资产 IMG-083,此时可见 18 项、预取 12 项、缓存共 72 项。随后在调试入口模拟 MEMORY_LEVEL_LOW。清理结束后缓存保留 30 项、30.0 MiB,42 个无租约 PixelMap 已释放;三个旧世代解码结果返回后被立即释放,lateDecodeDropped=3。脚本再向上、向下各滚一屏,18 个可见项没有产生回源请求,visibleRefetch=0,滚动锚点仍是 IMG-083。
手机页最终状态为 PRESSURE_STABLE,不是笼统的“优化完成”。状态卡同时展示任务 MEM-0109、压力等级 MEMORY_LEVEL_LOW、缓存 72→30、内存 72.0→30.0 MiB、租约 18+12、释放 42、迟到丢弃 3、可见回源 0。这些数字缺一项,就无法判断是有效回收还是把代价推迟到了下一次滚动。
我还用 Allocation 与 Snapshot 做了两轮对照。压力前后 ArkTS Map 条目与 native PixelMap 数量同步下降;连续触发三次 LOW,第二、三次 released=0,说明 trim 是幂等的。页面退出后解除统计订阅,但缓存按模块策略保留;切换到另一图库时 generation 更新、租约清零并执行 releaseAll(),没有留下对旧资产的闭包引用。
六、几条容易把优化写成新故障的边界
第一,不要释放仍在组件树中显示的 PixelMap。租约更新必须跟布局可见区同一批次提交,先获得新租约,再释放旧租约,才能避免切屏瞬间的空窗。第二,release() 是资源生命周期终点,后续读取像素数据会失败;缓存命中路径必须只返回 Map 中仍有效的条目。第三,压力回调可能连续到达,清理任务必须串行,目标值取更严格的一次,不能并发释放同一对象。
第四,18 MiB 的 CRITICAL 目标只保留可见 18 项并取消预取,这会牺牲下一屏速度,但比进程被系统终止更可控。第五,缩略图按 1 MiB 记账是本 Demo 的 512×512 RGBA 结果;真实项目应根据解码尺寸和像素格式计算,不能拿文件压缩大小代替 native 占用。第六,内存压力恢复后不要立刻把 42 项全部预热回来,恢复策略采用每秒最多 4 项,并在用户真实滚动方向上预取。
这次让我更确定,文搜图性能不能只盯模型耗时。检索结果出来之后,解码、缓存、组件可见性和系统内存压力组成了另一条生命周期。onMemoryLevel() 提供信号,租约保护正在使用的资源,generation 拦住迟到回填,PixelMap.release() 才真正完成回收。四个环节连起来,30 MiB 的稳定缓存才比 72 MiB 的“命中率漂亮”更有价值。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)