
HarmonyOS 7 PixelForge 图像超分工程实录 04:ArkData × SR Cache:超分结果缓存、源图变更与版本失效【鸿蒙心迹】
03 把大图分块以后,PixelForge 已经能把 4439×2959 的城市全景分成 4 块,控制到 168.9MB 左右的峰值,再通过 96px 输入重叠、288px 输出重叠和 Feather Blend,把接缝差异从 12.8% 压到 1.9%。
真正继续用下来以后,新的浪费很明显。
我反复打开同一张图:
old_photo_960x640.jpg
如果每次都:
decode
→ SR
→ encode
即使单次只有几百毫秒,用户还是会觉得“为什么刚刚算过还要重新算”。
所以 04 开始加缓存。
但我没有直接写:
key = 文件名
因为这几乎一定会埋坑。
同一个文件名可能被覆盖;超分倍率会变;HarmonyOS 7 的系统能力实现会迭代;PixelForge 自己的编码参数也可能调整。
真正的缓存必须回答两个问题:
什么时候可以复用?什么时候必须失效?
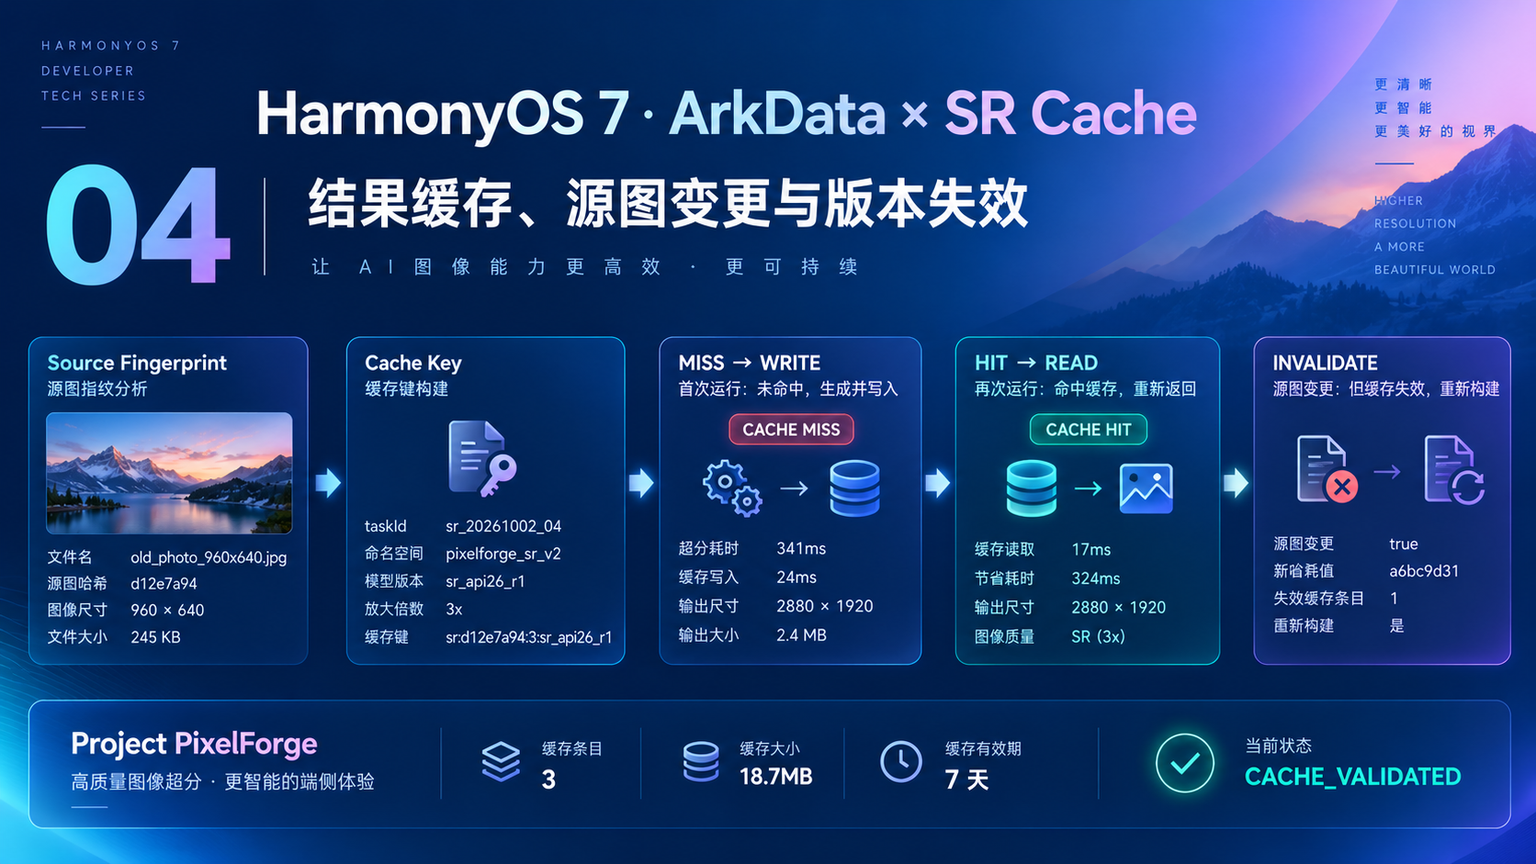
本轮统一数据:
taskId:
sr_20261002_04

cacheNamespace:
pixelforge_sr_v2

source:
old_photo_960x640.jpg

sourceFileSize:
245KB

sourceHash:
d12e7a94

modelRevision:
sr_api26_r1

requestedScale:
3x

cacheKey:
sr:d12e7a94:3:sr_api26_r1

firstRun:
MISS → WRITE

buildCost:
341ms

cacheWriteCost:
24ms

outputSize:
2880 × 1920

outputFileSize:
2.4MB

secondRun:
HIT → READ

cacheReadCost:
17ms

savedCost:
324ms

sourceChanged:
true

newSourceHash:
a6bc9d31

staleEntriesEvicted:
1

cacheEntries:
3

cacheSize:
18.7MB

ttl:
7d

status:
CACHE_VALIDATED
一、04 的缓存对象不是 PixelMap,而是“结果文件 + 元数据”
前两篇一直强调:
大 PixelMap 不应该长期留在页面或队列里
缓存阶段更不能反过来把 PixelMap 放进全局 Map。
PixelForge 真正缓存的是:
超分结果文件

结果宽高

源图 hash

scale

modelRevision

创建时间

最后访问时间
内存里只保留轻量索引。
这样 App 重启以后缓存仍然有效,同时不会让 PixelMap 成为长期驻留对象。
二、为什么文件名不能当 Cache Key
第一版最简单:
old_photo_960x640.jpg
→ old_photo_sr.jpg
然后用户在相册里编辑原图,又覆盖回:
old_photo_960x640.jpg
文件名完全没变。
如果仍然读旧超分结果,用户看到的是:
新原图
+
旧缓存
这是非常明显的错误。
所以 04 第一层变成:
Source Fingerprint
当前:
d12e7a94
它是 PixelForge 当前用于测试的短摘要展示值,正式实现内部保存完整 hash。
三、Cache Key 至少包含 sourceHash + scale + modelRevision
当前 key:
sr:d12e7a94:3:sr_api26_r1
构建器:
export class CacheKeyBuilder {
  build(
    sourceHash: string,
    scale: number,
    modelRevision: string
  ): string {
    return [
      'sr',
      sourceHash,
      scale.toString(),
      modelRevision
    ].join(':')
  }
}
三项分别解决:
源图变化
倍率变化
模型 / 能力版本变化
只要其中一个改变,旧 cache 就不会命中。
四、为什么还要 modelRevision
用户没改图片,仍然可能需要重算。
例如:
sr_api26_r1
→
sr_api26_r2
能力输出策略、质量或兼容范围发生调整。
如果 cache key 没模型版本:
旧结果会永久掩盖新能力
所以 modelRevision 是一个业务侧显式版本。
它不等于系统内部模型真实版本号。
而是 PixelForge 用来控制“哪些输出可以互相复用”的工程版本。
五、ArkData Preferences 只保存索引,不保存 2.4MB 图片
HarmonyOS ArkData Preferences 很适合保存轻量 Key-Value 信息。
但超分结果:
2.4MB
不适合直接塞进 Preferences。
所以 04 的结构是:
Preferences
→ cache index

filesDir / cacheDir
→ output image file
索引:
export interface SrCacheEntry {
  key: string

  sourceHash: string
  scale: number
  modelRevision: string

  outputPath: string

  width: number
  height: number

  fileSizeBytes: number

  createdAt: number
  lastAccessAt: number
  expiresAt: number
}
Preferences 只保存 JSON 元数据。
真实图片继续走文件系统。
六、第一次 MISS 以后,必须先完整生成再 WRITE
本轮第一次:
MISS
完整处理耗时:
buildCost=341ms
写缓存:
cacheWriteCost=24ms
真正顺序:
query cache
→ MISS

decode
→ SR
→ validate
→ encode temp file

rename / commit result
→ write index
不能先写 index,再慢慢写图片。
否则中途失败会留下:
索引存在
文件不存在
的脏缓存。
七、写缓存也要做“两阶段提交”
这一段解决缓存文件半写状态。
export class SrCacheWriter {
  async commit(
    key: string,
    tempPath: string,
    finalPath: string,
    entry: SrCacheEntry
  ): Promise<void> {
    await this.fileOps
      .rename(
        tempPath,
        finalPath
      )

    try {
      await this.indexRepo
        .put({
          ...entry,
          key,
          outputPath:
            finalPath
        })
    } catch (error) {
      await this.fileOps
        .remove(finalPath)

      throw error
    }
  }
}
先得到完整文件。
索引写失败就删文件。
缓存状态始终:
要么完整存在
要么不存在
八、第二次 HIT 的 17ms 不是“超分只要 17ms”
第二次:
HIT → READ
耗时:
17ms
它只包含:
计算源图 fingerprint

构建 cache key

读取索引

确认文件存在

读取结果元数据 / URI
没有重新执行 AI 超分。
所以节省:
341 - 17
=
324ms
本轮手机图明确写:
savedCost=324ms
这比只显示“缓存命中”更能说明缓存价值。
九、命中缓存以后,不马上 decode 大结果 PixelMap
结果文件:
2880 × 1920
如果 Cache HIT 后立刻为了列表预览解码成大 PixelMap,缓存虽然省了 AI,内存又被抬高。
所以命中以后先返回:
outputPath
width
height
UI 根据展示尺寸决定是否:
加载缩略图
只有用户进入高清查看页才解码完整结果。
04 的缓存优化同时兼顾:
算力
内存
十、源图变化时,新 hash 自动让旧 key 失效
本轮后半段我故意重新保存原图。
文件名仍然:
old_photo_960x640.jpg
但内容 hash 变成:
a6bc9d31
于是新 key:
sr:a6bc9d31:3:sr_api26_r1
旧 key:
sr:d12e7a94:3:sr_api26_r1
不会再命中。
这就是内容寻址比文件名寻址可靠的地方。
十一、旧缓存不会立刻全删,而是进入 stale
源图改变以后,旧条目没有任何继续命中的机会。
当前清理:
staleEntriesEvicted=1
但真实产品不必每一次变更都同步删所有旧 cache。
可以:
标记 stale

后台 / 空闲时清理
避免用户修改源图时被文件 I/O 阻塞。
PixelForge 当前测试为了方便观察,立即清理 1 条旧项。
十二、TTL=7d 是项目策略,不是 ArkData 规则
当前:
ttl=7d
表示 7 天未访问的缓存可以清理。
这是 PixelForge 的产品策略。
不是 Preferences 或 HarmonyOS 的固定限制。
实际可以按:
缓存空间

结果生成成本

用户使用频率
动态调整。
十三、Cache Index 里要记录最后访问时间
每次 HIT:
lastAccessAt
都会更新。
后续清理优先淘汰:
过期
+
最久未访问
而不是简单:
文件最大的先删
因为大文件可能恰好最常用。
缓存清理应该服务用户行为,而不是只追求最小目录。
十四、缓存总大小也必须有上限
当前:
cacheEntries=3

cacheSize=18.7MB
这还很小。
以后大图 03 的 13317×8877 结果进入缓存,单文件就可能非常大。
所以最终 CachePolicy 还会有:
maxEntries
maxBytes
ttl
任一达到阈值都触发清理。
04 先把:
cacheSize
加入 Metrics,就是为后续策略留基线。
十五、DevEco 图重点看 key 的构成和 invalidate
开发图:
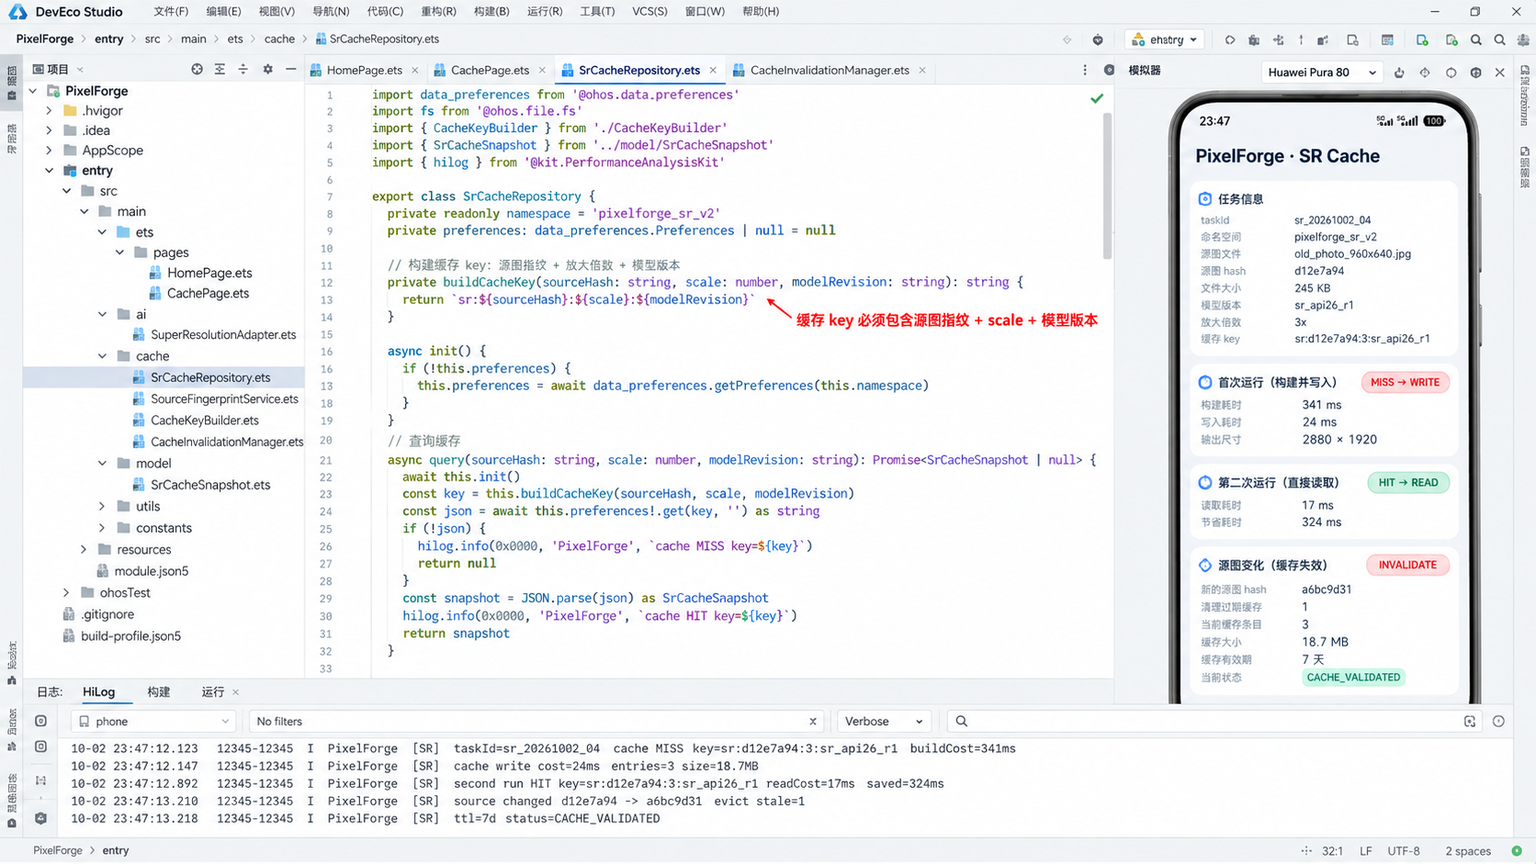
HiLog:
taskId=
sr_20261002_04

cache MISS

key=
sr:d12e7a94:3:sr_api26_r1

buildCost=
341ms

cache write=
24ms

entries=
3

size=
18.7MB

second run HIT

readCost=
17ms

saved=
324ms

source changed

d12e7a94
→
a6bc9d31

evict stale=
1

ttl=
7d

status=
CACHE_VALIDATED
这条日志把缓存为什么命中、为什么失效都说清楚。
十六、运行图把 MISS、HIT、INVALIDATE 放在一个页面里
最终运行图:
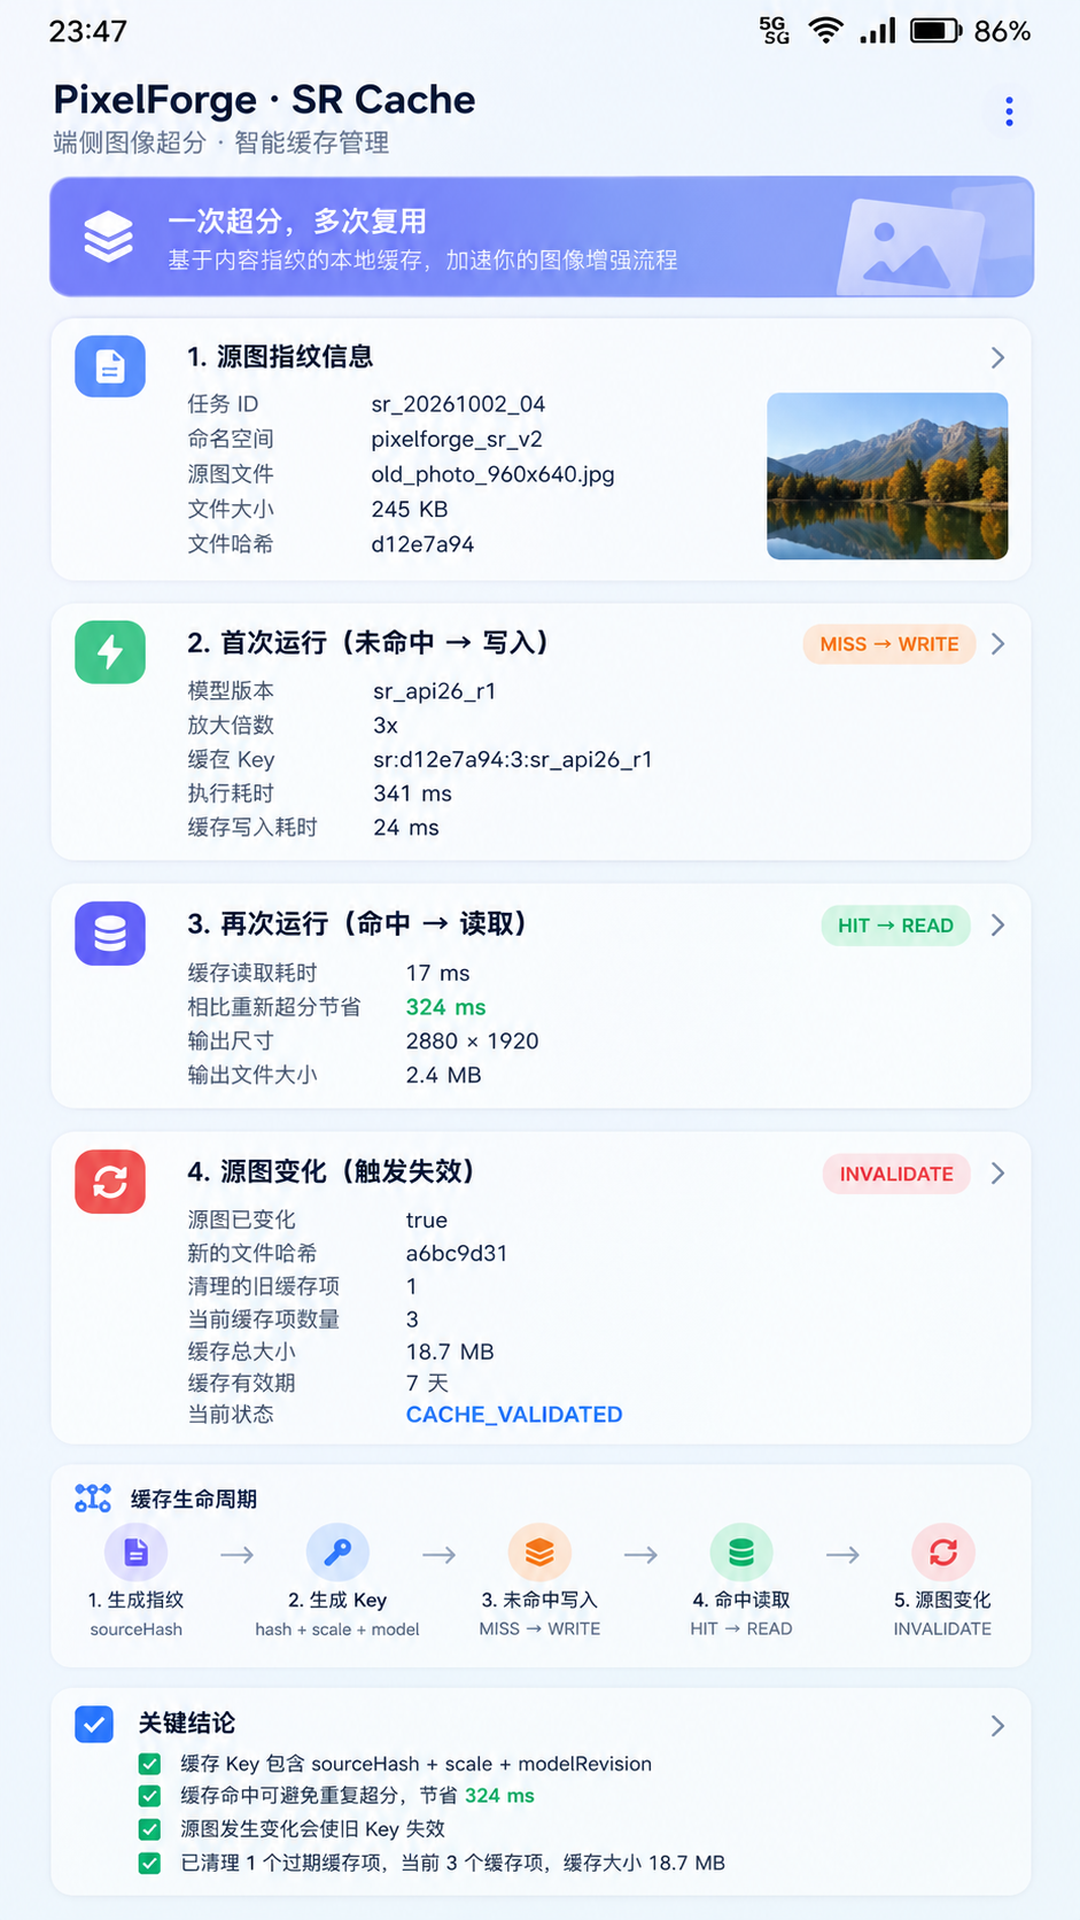
三个阶段:
第一次
MISS → WRITE

第二次
HIT → READ

源图变化
INVALIDATE
用户不用理解 Preferences。
但开发者一眼能看到:
cacheKey
modelRevision
hash
读写耗时
清理数量
最终:
CACHE_VALIDATED
十七、缓存命中也要确认文件还存在
Preferences 索引可能存在:
entry
但用户清理缓存目录、系统回收临时文件或异常写盘后,文件本身可能没了。
所以 HIT 前还检查:
file exists
file size matches
如果失败:
BROKEN_CACHE_ENTRY
删索引,按 MISS 重建。
不能把“索引命中”直接当成“缓存可用”。
十八、模型版本变化时要批量失效,但不用同步全删
如果:
sr_api26_r1
→
sr_api26_r2
所有 r1 key 都自然无法命中。
这已经保证正确性。
后台清理再慢慢删 r1 文件即可。
这种设计把:
正确性
和:
空间回收
拆开。
非常适合大文件缓存。
十九、缓存 key 以后还可能加入编码参数
当前输出固定:
JPEG
quality=95
所以 key 暂时只有:
sourceHash
scale
modelRevision
如果以后用户可以选:
PNG
WebP
JPEG quality
这些参数也必须进入 key。
否则不同输出配置会错误复用同一文件。
04 先把这个边界写进设计,不急着扩大参数表。
二十、CACHE_VALIDATED 的验收条件
最终状态至少代表:
第一次 MISS 正常生成

结果写入采用完整提交

第二次 HIT 不重复 AI 超分

读取耗时 17ms

节省 324ms

key 包含 sourceHash / scale / modelRevision

源图内容变化后自动失效

旧 stale 项可清理

缓存文件不存在时能回退 MISS

TTL 和空间大小可治理
这些全部成立以后,缓存才不是一个“全局 Map”。
二十一、下一篇:缓存有了,应用切后台时任务还可能被打断
04 以后:
单图
批量
大图分块
缓存
都已经能工作。
下一步真正会遇到:
用户点超分
切到后台
系统回收页面

编码还没结束
结果还没 commit
05 会继续处理:
Stage 生命周期
临时输出文件
任务恢复
异常写盘
前后台状态
缓存目录和两阶段写入会成为恢复链的重要基础。
二十二、Cache Key 还应该绑定输出编码策略
04 当前固定:
JPEG
quality=95
所以图片格式没有进入 key。
但如果后面支持:
JPEG 90
JPEG 95
PNG
WebP
同一个 SR PixelMap 会得到不同输出文件。
因此最终 Cache Key 模型其实应该预留:
sourceHash
scale
modelRevision
encodeProfile
当前 sr:d12e7a94:3:sr_api26_r1 可以理解成“输出编码策略固定”的简化版本。
一旦编码参数对用户开放,就必须升级 cache schema。
二十三、缓存索引要有 schemaVersion,避免应用升级后读不懂旧数据
Preferences 里保存的是 JSON。
如果下一个版本给 SrCacheEntry 增加:
encodeProfile
qualityScore
deviceModel
旧缓存结构可能不完整。
所以 Cache Index 加:
schemaVersion
读取时:
支持当前版本
→ 正常使用

可迁移旧版本
→ 迁移

无法迁移
→ 视为 MISS
宁可重算一次,也不要因为一份旧索引让缓存链进入不可解释状态。
二十四、缓存命中以后也要验证模型输出尺寸
哪怕 key 命中、文件存在,也可能出现历史 Bug:
索引写的是 2880×1920
实际文件损坏或尺寸不对
所以首次读取某个缓存文件时,PixelForge 会做轻量验证:
文件头可读
宽高匹配
格式匹配
不需要完整 decode 大 PixelMap。
如果验证失败:
CACHE_CORRUPTED
→ delete entry
→ rebuild
缓存是性能优化,不能成为正确性的单点依赖。
二十五、命中统计要区分“查询命中”和“最终可用命中”
当前手机图显示:
HIT → READ
17ms
这是最终可用命中。
内部 Metrics 其实还会区分:
indexHit
fileHit
validatedHit
例如:
indexHit=true
fileExists=false
不能算真正命中。
如果只统计“Preferences 里找到了 key”,命中率会虚高,优化判断也会失真。
二十六、缓存清理不能在 UI 主链里一次删很多大文件
当缓存从:
18.7MB
增长到几百 MB 时,一次同步清理几十个文件会明显卡住用户操作。
所以清理策略最终是:
本次请求只标记 stale / expired

空闲阶段
分批删除
UI 最多看到:
清理任务已安排
而不是等待所有文件删除完才返回结果。
缓存治理和批量 SR 一样,本质上也需要队列和节流。
二十七、源图 fingerprint 计算本身也需要成本控制
如果每次打开一张 500MB 素材都完整 SHA-256 整个文件,fingerprint 自己就可能比查缓存还慢。
当前 245KB 图片没有这个问题。
未来大文件可以组合:
文件大小
修改时间
快速分段 hash
必要时完整 hash
先做快速判断。
只有疑似变化时再做完整校验。
工程上“缓存为了省时间”不能变成“为了查缓存先花更多时间算 hash”。
二十八、缓存和 03 的 Tile Manifest 可以共用同一个版本体系
大图结果不一定只缓存最终图。
以后可以缓存:
tile 结果
stitch 中间结果
最终图
但它们都应该绑定:
sourceHash
scale
modelRevision
tilePlanRevision
如果 overlap 从 96 改成 128:
tilePlanRevision
变化。
旧 tile 缓存就不能继续拼。
这就是为什么 04 先把版本失效机制做稳:后面缓存对象越来越多时,仍然有统一失效规则。
二十九、缓存写失败不能让主任务变 FAILED
超分已经成功并且用户拿到了结果,但:
cache index write
失败,这时不应该把整个 SR 任务改成 FAILED。
正确状态:
SR_READY

cacheState=
WRITE_FAILED
结果仍然可用,只是下一次需要重新计算。
缓存属于优化层,不应该反过来决定核心业务是否成功。
三十、CACHE_VALIDATED 代表的是“正确性优先的缓存”
04 最终不是在追求最高命中率。
而是在保证:
该命中的才命中

不该命中的一定失效

损坏文件自动回退

模型升级不误复用

源图变化不误复用

缓存失败不破坏主结果
只有做到这些以后,324ms 的节省才真正有意义。
否则一个偶发返回旧图的缓存,性能再快也不能用。
三十一、缓存命中率不是越高越好
如果为了提高 HIT 率,把 modelRevision、编码策略或源图 fingerprint 从 key 里删掉,数字可能会非常漂亮,但错误复用也会同步增加。
所以 PixelForge 更关注:
validated hit rate
stale rebuild count
corrupted cache count
wrong-result count
真正理想的缓存不是“什么都命中”,而是“所有命中都可信”。这一条会在 06 最终回归里继续作为结果一致性指标,而不是只统计节省了多少毫秒。
补充一点:04 当前所有缓存指标都只针对本机本地缓存,不包含云端同步、分布式缓存或跨设备复用。后续如果接入跨设备能力,缓存身份、权限和一致性边界都需要重新设计,不能直接沿用这一版结论。
参考资料
- ArkData 文档中心:
https://developer.huawei.com/consumer/cn/doc/ - Preferences Native API:
https://developer.huawei.com/consumer/cn/doc/doccenter-references/api/capi-preferences-oh-preferences - HarmonyOS 文件系统与本地存储:
https://developer.huawei.com/consumer/cn/doc/doccenter-atomic-service/develop-file-system - Image Kit 图像解码:
https://developer.huawei.com/consumer/en/doc/atomic-guides/atomic-image-decoding

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)