
HarmonyOS 7 PixelForge 图像超分工程实录 01:Image Super-Resolution × PixelMap:输入规格归一化、目标尺寸与单图结果校验【鸿蒙心迹】
ReleaseGuard 系列已经把上架审核工程做完,这一轮我换到一个完全不同的方向:HarmonyOS 7 / API 26 的图像超分。
新 Demo 叫 PixelForge。
它不是相册,也不是修图工具,而是一个专门用来把“低清图片 → 端侧增强 → 结果校验 → 保存”这条链拆开的实验工程。HarmonyOS 7 官方社区目前已经把图像超分列为 API 26 的新 AI 开放能力之一,官方专题强调的典型价值很明确:低分辨率、模糊或细节不足的图片可以在端侧做智能放大与清晰度增强,用来实现“小图传输、高清呈现”;华为 HiAI 图像超分页面也长期将“1x 去压降噪”和“3x 放大浏览”作为典型场景。
这个系列固定 6 篇:
01 输入规格归一化、目标尺寸与单图结果校验
02 批量队列、PixelMap 生命周期与内存峰值
03 大图分块、重叠边界与拼接缝治理
04 结果缓存、源图变更与版本失效
05 前后台切换、结果写盘与异常恢复
06 多尺寸、多格式、耗时与内存回归验收
第一篇不追求一次性塞进所有能力,只先把一张图的生命周期跑稳。
本轮统一数据:
taskId:
sr_20261002_01

project:
PixelForge

source:
old_photo_960x640.jpg

input:
960 × 640

inputFileSize:
312KB

pixelFormat:
RGBA_8888

requestedScale:
3x

target:
2880 × 1920

actualOutput:
2880 × 1920

supportProbe:
true

decodeCost:
18ms

srCost:
284ms

encodeCost:
41ms

peakMemory:
54.6MB

status:
SR_READY
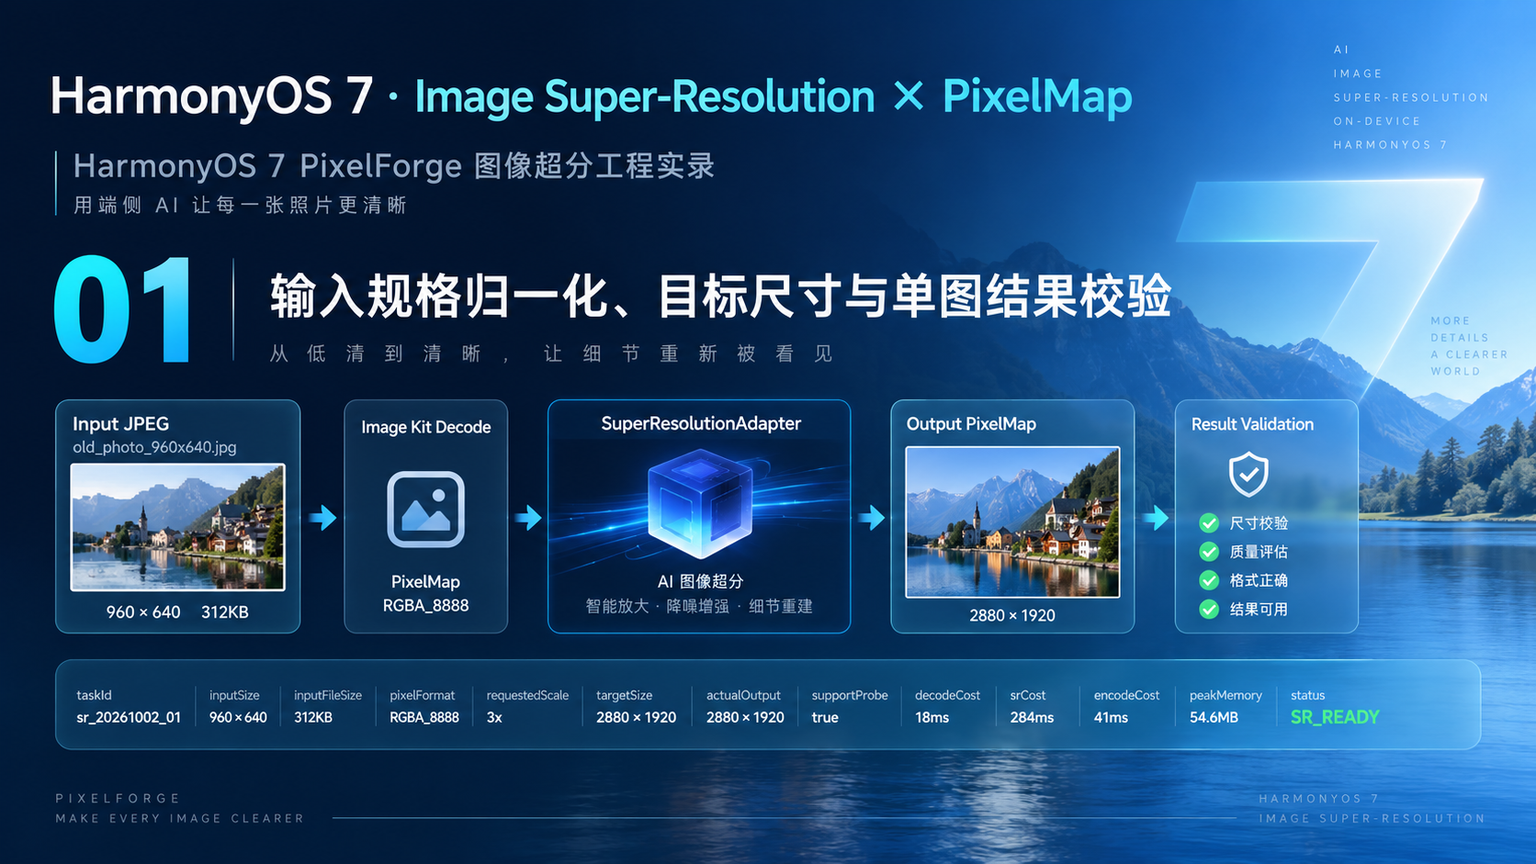
一、第一篇先解决一个基础问题:超分不是“给 Image 组件放大”
如果只是 UI 上把图片从:
960 × 640
显示成:
2880 × 1920
ArkUI 完全可以做。
但那只是显示缩放,源图信息没有增加。
PixelForge 这一篇真正需要验证的是:
输入 PixelMap
→ 调用端侧超分能力
→ 得到新的输出 PixelMap
→ 输出尺寸正确
→ 结果可编码保存
所以我把 UI 组件和图像数据层完全拆开。
页面只订阅:
SrTaskSnapshot
真正的图像处理放在:
ImageDecodeService
SuperResolutionAdapter
OutputValidator
OutputEncoder
四个模块里。
二、先把 Image Kit 的输入生命周期理顺
HarmonyOS 当前 Image Kit 文档已经反复强调一个很容易踩的坑:ImageSource、PixelMap、编码器都存在明确的异步生命周期;如果 createPixelMap、packToFile 等异步操作还没完成就提前 release,可能出现崩溃或 Use After Free。
所以 PixelForge 不会写成:
createPixelMap()
→ 不 await
→ release()
第一段代码解决的是“解码输入 PixelMap,拿到真实尺寸,再安全释放 ImageSource”。
import { image } from '@kit.ImageKit'

export class ImageDecodeService {
  async decode(
    filePath: string
  ): Promise<image.PixelMap> {
    const source =
      image.createImageSource(
        filePath
      )

    try {
      const info =
        await source.getImageInfo()

      if (
        info.size.width !== 960 ||
        info.size.height !== 640
      ) {
        console.warn(
          `unexpected input ${info.size.width}x${info.size.height}`
        )
      }

      const pixelMap =
        await source.createPixelMap({
          editable: false
        })

      return pixelMap
    } finally {
      source.release()
    }
  }
}
这里 ImageSource 可以在 PixelMap 已经成功创建后释放,因为后续处理只持有 PixelMap。
但 PixelMap 不能跟着一起 release。
它还要继续进入超分与编码链。
三、业务层不要直接散落系统超分调用
HarmonyOS 7 当前图像超分是系统 AI 开放能力。
我不希望页面里直接写一堆系统接口调用。
所以项目内部统一定义:
export interface SuperResolutionRequest {
  scale: number
}

export interface SuperResolutionResult {
  pixelMap: image.PixelMap

  width: number
  height: number
}

export interface SuperResolutionAdapter {
  isSupported():
    Promise<boolean>

  process(
    input:
      image.PixelMap,
    request:
      SuperResolutionRequest
  ):
    Promise<
      SuperResolutionResult
    >
}
真正对接 HarmonyOS 7 图像超分能力的 SDK 调用放进实现类。
文章里的 Adapter 是 PixelForge 自己的工程边界,不把某个版本的具体 API 名写死在业务代码里。
这样后面系统能力签名、参数或返回结构调整时,页面和任务状态模型不用跟着重写。
四、3x 只是本轮请求,不能把“输出一定等于输入乘 3”写死
本轮输入:
960 × 640
目标:
2880 × 1920
结果恰好也是:
2880 × 1920
但 PixelForge 不会把验证写成:
outputWidth === inputWidth * 3
因为真实能力还可能有:
输入尺寸约束
输出上限
内部对齐
设备能力差异
社区最新实践里甚至专门讨论了大图输入后实际输出尺寸和“简单按倍率相乘”不一致的问题。
所以项目保存两套值:
requested target

actual output
这是非常重要的边界。
五、目标尺寸验证只负责“本轮工程预期”
第二段代码解决的是:
系统返回结果以后
业务怎么判断这次任务是否满足自己的预期
export interface OutputExpectation {
  targetWidth: number
  targetHeight: number
}

export class OutputValidator {
  async validate(
    result:
      SuperResolutionResult,
    expected:
      OutputExpectation
  ): Promise<boolean> {
    const info =
      await result.pixelMap
        .getImageInfo()

    const widthOk =
      info.size.width ===
      expected.targetWidth

    const heightOk =
      info.size.height ===
      expected.targetHeight

    return (
      widthOk &&
      heightOk
    )
  }
}
当前:
target:
2880 × 1920

actual:
2880 × 1920
所以通过。
以后如果能力因为输入约束返回不同尺寸,日志会同时保留 requested 和 actual,不会误写成“超分失败”。
六、像素格式要在进入 AI 前统一
本轮 PixelForge 统一:
RGBA_8888
原因不是说图像超分永远只支持这一种格式,而是业务链路需要一个清晰的输入标准。
原图可能来自:
JPEG
PNG
WebP
相机 PixelMap
图库资源
解码后如果格式和可编辑状态各不相同,后面内存估算、编码和生命周期都很难统一。
所以第一篇先规定:
进入 Adapter 前
必须拿到可识别的 PixelMap
并记录 pixelFormat
不符合当前项目输入规则时,先走转换层,而不是让 AI Adapter 自己处理所有杂质。
七、单图任务状态要把每一步耗时分开
本轮不是只记录:
totalCost
而是:
decodeCost=18ms
srCost=284ms
encodeCost=41ms
如果以后同一张图突然从 343ms 变成 900ms,先看哪一段回退。
任务模型:
export interface SrTaskSnapshot {
  taskId: string

  source: string

  inputWidth: number
  inputHeight: number

  targetWidth: number
  targetHeight: number

  actualWidth: number
  actualHeight: number

  decodeCostMs: number
  srCostMs: number
  encodeCostMs: number

  peakMemoryMb: number

  status:
    'PREPARING' |
    'RUNNING' |
    'VALIDATING' |
    'ENCODING' |
    'SR_READY' |
    'FAILED'
}
这套 Snapshot 会一直沿用到后面的批量和回归。
八、编码完成之前不能释放输出 PixelMap
Image Kit 当前“常见崩溃报错问题”文档给了一个很典型的案例:packToFile 是异步操作,如果没有 await 就在 finally 里释放 PixelMap,可能直接造成崩溃。
所以第三段代码专门把释放顺序写清楚:
import { image } from '@kit.ImageKit'

export async function encodeResult(
  pixelMap:
    image.PixelMap,
  fd: number
): Promise<void> {
  let packer:
    image.ImagePacker |
    null = null

  try {
    packer =
      image.createImagePacker()

    await packer.packToFile(
      pixelMap,
      fd,
      {
        format:
          'image/jpeg',
        quality:
          95
      }
    )
  } finally {
    packer?.release()
  }
}
注意这里不在函数内部 release PixelMap。
因为 PixelMap 的 Owner 是整个任务 Coordinator。
谁创建 / 接收它,谁负责最终释放。
九、Coordinator 要确保成功和失败都释放两份 PixelMap
单图流程最终有两份大对象:
inputPixelMap
outputPixelMap
真正的资源收口:
export class SuperResolutionCoordinator {
  async execute():
    Promise<void> {
    let input:
      image.PixelMap |
      null = null

    let output:
      image.PixelMap |
      null = null

    try {
      input =
        await this.decoder.decode(
          'old_photo_960x640.jpg'
        )

      const supported =
        await this.adapter
          .isSupported()

      if (!supported) {
        throw new Error(
          'SR_NOT_SUPPORTED'
        )
      }

      const result =
        await this.adapter
          .process(
            input,
            { scale: 3 }
          )

      output =
        result.pixelMap

      await this.encoder
        .save(output)

      this.status =
        'SR_READY'
    } finally {
      output?.release()
      input?.release()
    }
  }
}
这个 finally 是第一篇真正要固定下来的模式。
后面批量任务每一张图都要重复遵守。
十、峰值内存 54.6MB 为什么值得从第一篇就记
原始 PixelMap:
960 × 640 × 4 bytes
≈ 2.34MB
输出 PixelMap:
2880 × 1920 × 4 bytes
≈ 21.1MB
再加:
解码缓存
AI 中间资源
编码缓存
UI 预览
实际峰值不可能只等于 23MB。
本轮观测:
54.6MB
这个数字属于 PixelForge 当前设备与任务的工程基线,不是系统规格。
第二篇会直接用这条思路解释:
为什么批量超分不能想当然地把 6 张图一起跑。
十一、DevEco 图重点看“输出校验”和“资源释放”
开发图:
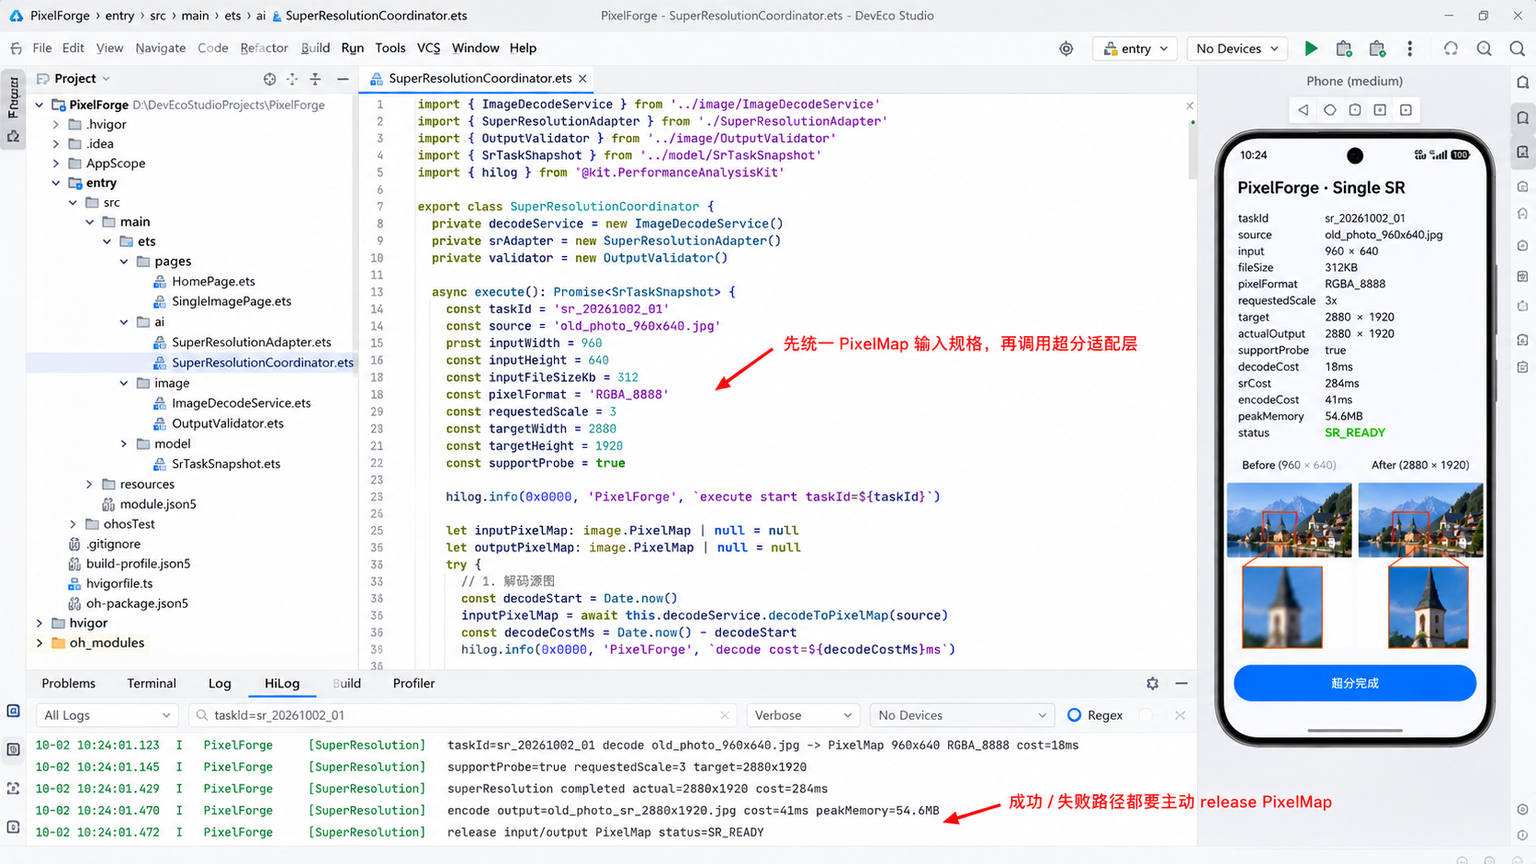
统一 HiLog:
taskId=
sr_20261002_01

decode
old_photo_960x640.jpg

PixelMap:
960x640
RGBA_8888

decodeCost=
18ms

supportProbe=
true

requestedScale=
3x

target=
2880x1920

actual=
2880x1920

srCost=
284ms

encodeCost=
41ms

peakMemory=
54.6MB

release input/output PixelMap

status=
SR_READY
如果只打印“超分成功”,后面大图和批量出问题时几乎没有排查依据。
十二、运行图把“前后结果”和“任务证据”放在一起
最终运行图:
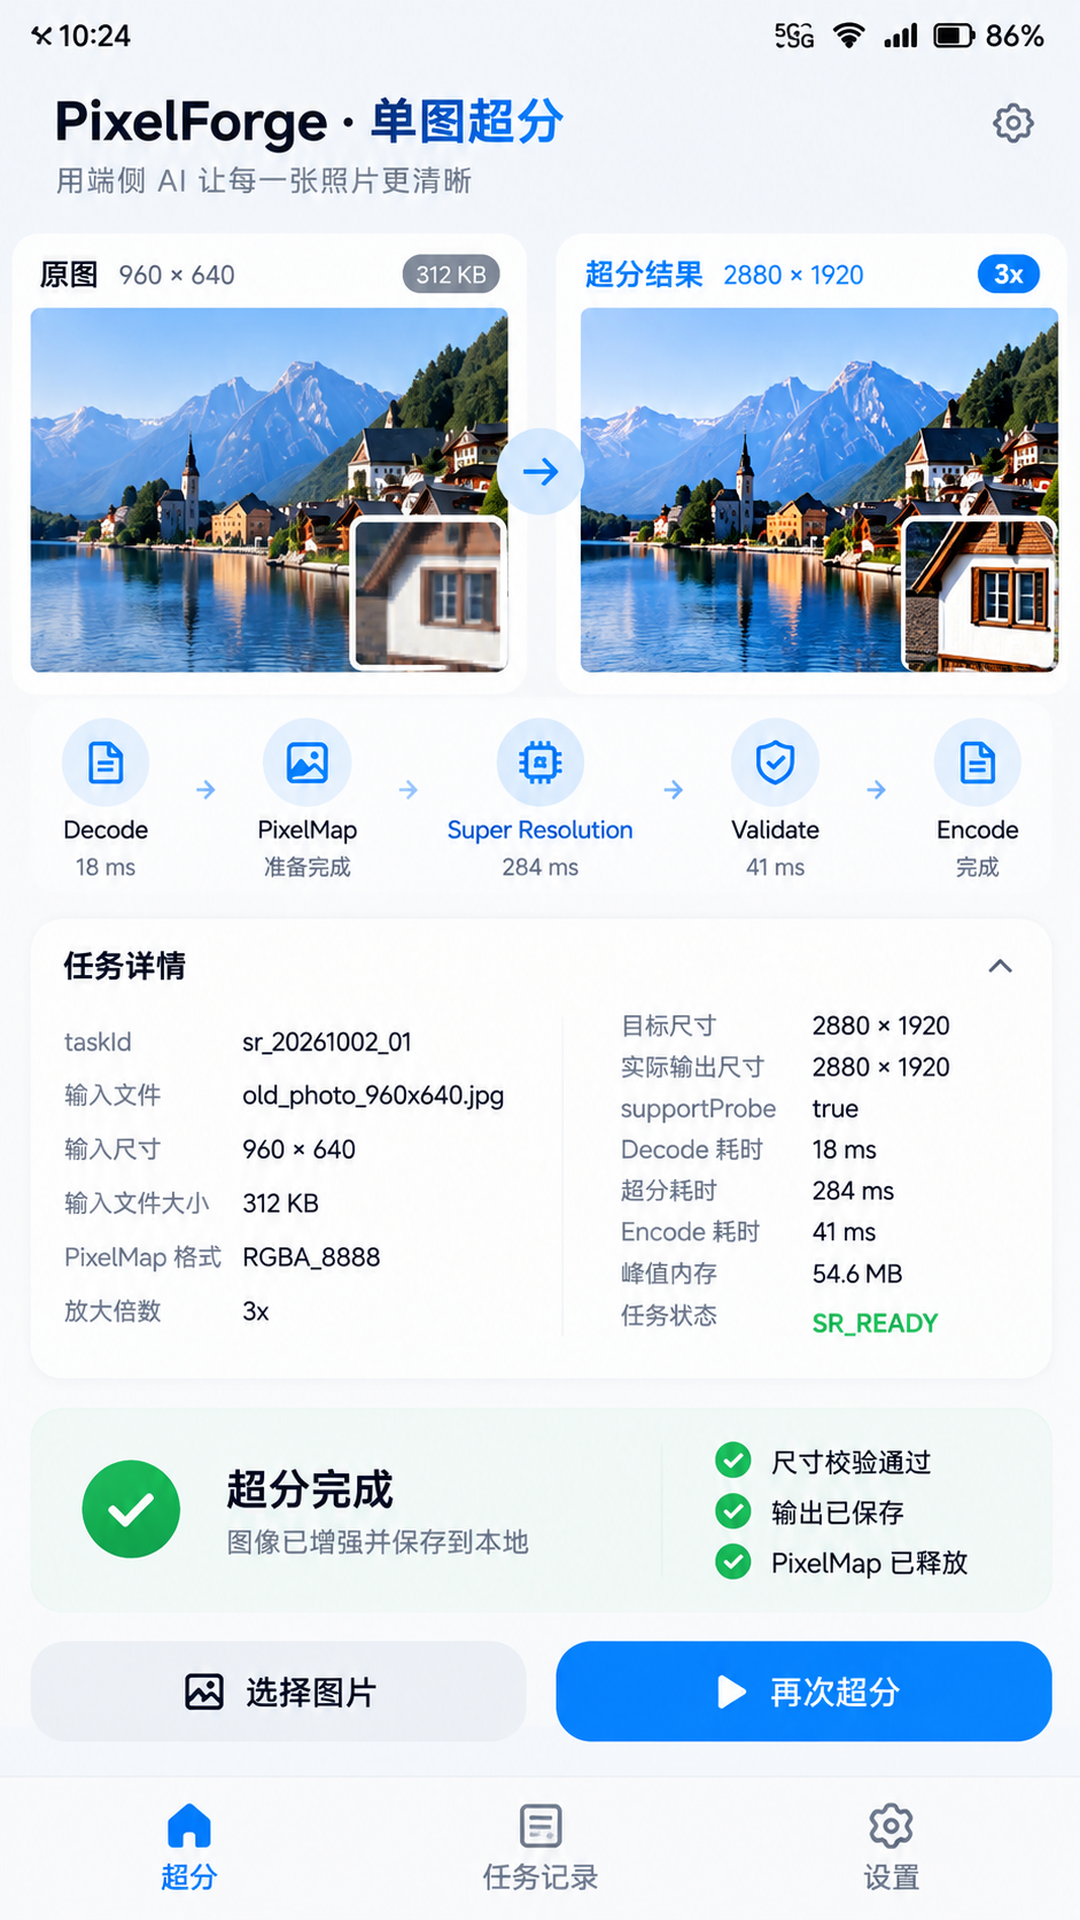
左边:
960 × 640
312KB
右边:
2880 × 1920
3x
中间流程:
Decode
18ms

Super Resolution
284ms

Encode
41ms
最后:
PixelMap 已释放
SR_READY
这张图证明的不是“AI 图变清晰了”这么简单。
真正证明的是:
一张图从文件到 PixelMap
进入超分
拿到输出
编码
释放
整条工程链可以稳定收口。
十三、为什么第一篇不直接做 4K 大图
因为 HarmonyOS 7 最新社区实践已经专门提醒:
大图
输出尺寸
内存
会成为图像超分的高频工程问题。
第一篇先用:
960 × 640
建立稳定生命周期和性能口径。
第三篇才会真正处理大图分块。
如果第一篇就上 4000px 原图,出问题以后很难判断:
能力接入错
还是输入太大
还是 PixelMap 没释放
十四、能力不支持时,降级路径不能伪装成 AI 成功
supportProbe=true 是当前测试数据。
如果某台设备能力不可用:
supportProbe=false
PixelForge 会:
保留原图
允许普通缩放浏览
显示“当前设备不支持超分”
不会偷偷用普通插值放大后仍然标成:
AI 超分结果
产品降级可以有,但能力语义不能造假。
十五、第一篇最后固定六组反向测试
第一组,960×640 JPEG 正常生成 2880×1920。
第二组,输入文件不可读,状态进入 FAILED,input PixelMap 不残留。
第三组,supportProbe=false,任务不进入 AI process。
第四组,输出尺寸与 target 不一致,记录 actual,不覆盖真实结果。
第五组,编码失败,output / input PixelMap 仍然在 finally 释放。
第六组,连续执行 20 次,任务结束后活动 PixelMap 数量回到 0。
全部通过以后,本轮才记:
SR_READY
十六、下一篇真正会遇到的是“单图没问题,批量就爆内存”
单图峰值:
54.6MB
看起来完全可以接受。
但如果 6 张图片同时开始:
6 × input PixelMap
6 × output PixelMap
AI 中间缓冲
内存很快就会放大。
02 会继续 PixelForge,不换 Demo。
我会故意做一组:
并发 3
峰值 287.9MB
然后把任务队列收回:
concurrency=1
峰值 118.6MB
专门处理批量队列、PixelMap 生命周期和重复执行。
十七、EXIF 方向和真正像素尺寸要在解码以后确认
相册里的图片经常有一个容易被忽略的问题:文件记录的宽高和用户“看到的方向”不一定完全等价。
例如一张竖图,文件像素可能是:
4032 × 3024
依赖方向信息旋转以后才以竖图显示。
所以 PixelForge 不会只读取文件名里的:
960x640
当成最终事实。
真正进入任务前,要以 ImageSource / PixelMap 的 ImageInfo 为准,记录:
decodedWidth
decodedHeight
rotationNormalized
只有方向和尺寸已经归一化,目标尺寸计算才稳定。
否则最典型的问题就是:
目标本来想做 1920×2880
最后却按横图算成 2880×1920
第一篇测试素材已经是正常横图,因此没有触发旋转分支,但接口先保留。
十八、结果“更清晰”不能只靠尺寸判断
输出:
2880 × 1920
只能证明尺寸符合预期。
它不能自动证明:
细节真的更好
没有明显伪影
没有颜色异常
没有边缘过锐
所以 OutputValidator 后面会分成两层:
Structural Validation
尺寸 / 格式 / 是否可编码

Quality Validation
锐度 / 噪声 / 人工视觉确认
01 只把结构校验做成自动 Gate。
质量层先保留人工对照图。
这也是手机图里特意放“局部放大 Before / After”的原因:超分结果不是只看一个绿色状态,而是要让开发者能快速观察窗口、屋檐和树线这类细节区域。
后续 06 再把可量化指标加入回归,但仍不会把“某个分数高”直接等价成用户一定觉得更清晰。
十九、编码质量参数也要固定,否则前后对比会失真
本轮编码:
JPEG
quality=95
如果输出端用:
quality=60
即使 AI 超分结果本身很好,落盘后又会被强压缩一次。
最终看到的模糊到底来自:
超分
还是 JPEG 二次压缩
就无法区分。
所以 PixelForge 的单图基线固定:
输入原文件不改
超分输出 JPEG quality=95
同一套预览缩放算法
性能报告同时记录:
encodeCost=41ms
后续如果切 PNG、WebP 或 HEIF,会单独建新基线,不和当前 41ms 混在一起比较。
二十、页面离开不能立刻释放正在运行的 PixelMap
还有一个生命周期问题和 Image Kit 官方崩溃指南高度相关。
如果用户刚开始超分就退出页面,页面 aboutToDisappear 里直接:
input.release()
output.release()
而 AI / encode 还没完成,仍然可能形成提前释放。
所以 PixelForge 不让页面拥有 PixelMap。
页面退出只做:
unsubscribe task state
真正资源由 SuperResolutionCoordinator 持有。
任务完成或失败以后,Coordinator 在 finally 里统一释放。
如果未来增加取消能力,也会采用:
发出 cancelRequested
等待当前不可中断步骤安全结束
再 release
而不是 UI 生命周期一到就强制回收。
二十一、单图基线还要保存“运行环境版本”
同样一张图片:
960×640
今天跑 284ms,下一次系统升级后可能变成 260ms 或 330ms。
如果报告里只有耗时,没有环境,数据没有比较意义。
所以 PixelForge 的 Metrics 还会保存:
HarmonyOS version
API level
device profile
app build version
SR adapter revision
文章图片为了保持清爽没有把这些字段全部画出来,但真实测试报告会保留。
到 06 做回归时,每一组性能数据都必须和环境版本绑定。
二十二、第一篇真正留下的是一条可观测的单图协议
做到这里,PixelForge 的单图协议已经非常明确:
文件
→ ImageSource
→ PixelMap
→ 支持性检查
→ 超分
→ 输出尺寸校验
→ 编码
→ 结果 URI
→ release
每一步都有状态、耗时和 Owner。
这条协议一旦稳定,后面无论批量、大图分块还是前后台恢复,都只是在改变“怎么调度”和“怎么存储”,不会再重新解释 PixelMap 到底应该什么时候释放。
二十三、最后再给单图任务加一条“结果不可复用旧状态”的约束
用户连续选择两张图片时,第二次任务不能沿用上一张的:
actualOutput
status
previewUri
peakMemory
所以每次新建 taskId 都先生成全新的 Snapshot,再开始 Decode。
只有当本次 Encode 真正完成后,页面才把 SR_READY 对应的结果 URI 暴露出来。
这样即使第二张图在 Decode 阶段失败,也不会因为页面还保留上一张预览而误以为“这次超分已经成功”。
这种状态隔离看起来和图像算法无关,却能避免非常典型的 UI 假成功问题。到后面的 Batch、Cache 和异常恢复里,taskId 与结果一一对应仍然会继续保留。
参考资料
- HarmonyOS 7(API 26) 图像超分开发者实践合集:
https://developer.huawei.com/consumer/cn/forum/topic/0204224159448225375 - 图像超分辨率能力介绍:
https://developer.huawei.com/consumer/cn/hiai/engine/image-super-resolution - Image Kit 常见崩溃报错问题:
https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/image-common-mistakes

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献165条内容

所有评论(0)