
HarmonyOS 7 Core File Kit + DocumentViewPicker:批量文档导入中的 URI 去重、并发复制限流与文件句柄闭环【鸿蒙心迹】
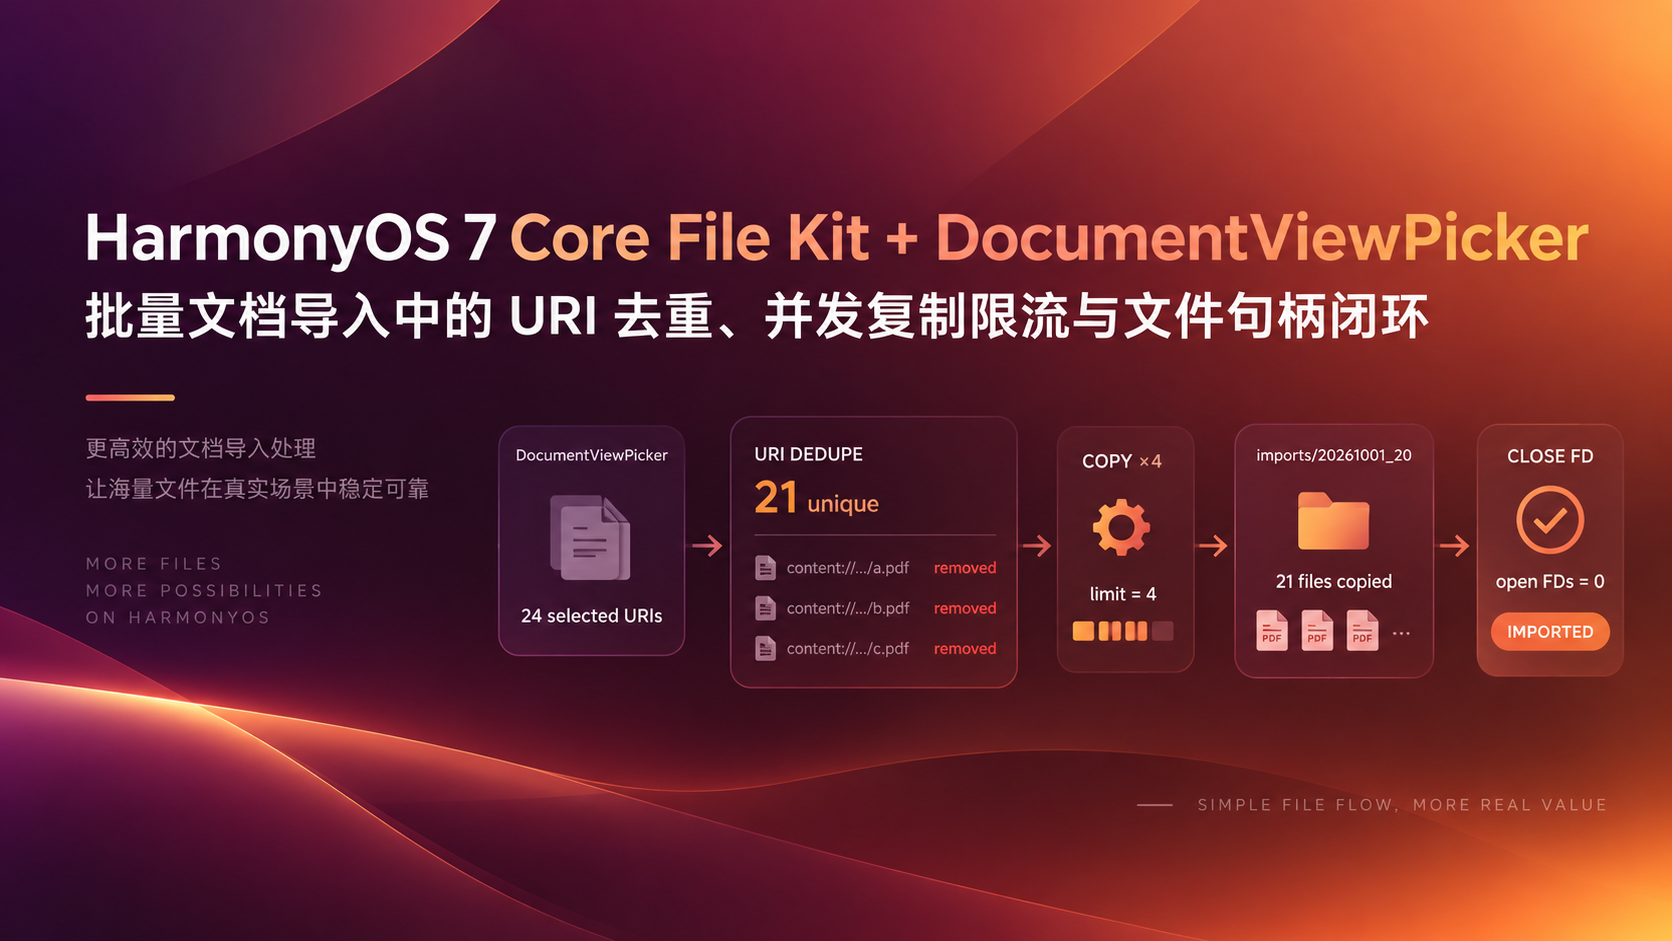
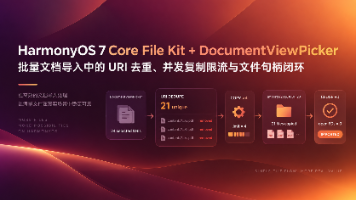
DocumentImportLab 通过 DocumentViewPicker 一次选择多份 PDF,再复制进应用沙箱。单文件时没问题,选二十多份后会遇到重复 URI、I/O 峰值和 FD 泄漏。
本文只处理三件事:URI 去重、复制并发限流、源/目标文件描述符在所有路径上闭环。
本次数据:
- Session:
doc_import_20261001_20 - State:
IMPORTED - Selected:
24 - Unique URIs:
21 - Duplicates:
3 - Concurrent Limit:
4 - Copied:
21 - Failed:
0 - Open FDs:
0 - Total Size:
86.4 MB - Output Dir:
imports/20261001_20 - Last File:
spec_21.pdf - Last Cost:
842 ms
一、DocumentViewPicker 只负责让用户选文件,导入策略仍然属于业务
Core File Kit 的 DocumentViewPicker 会打开系统文件选择页。Picker 本身不需要额外申请文件选择权限,但应在 UIAbility 场景中调用。
我把 Picker 这一层保持得很薄:
import { picker } from '@kit.CoreFileKit'
import { common } from '@kit.AbilityKit'

private async pickDocuments(): Promise<string[]> {
  const context =
    getContext(this) as common.UIAbilityContext

  const options =
    new picker.DocumentSelectOptions()

  const documentPicker =
    new picker.DocumentViewPicker(context)

  return await documentPicker.select(options)
}
Picker 返回 URI 数组。URI 不是普通本地路径,后续打开、读取和复制都应该在明确生命周期内完成。
页面拿到 URI 后先生成导入计划,再进入复制阶段。
二、第一层治理是 URI 去重,别把重复文件交给后面的 I/O
本次用户选择了 24 个 URI,其中 3 个重复项。
最简单也最可靠的做法就是先用 Set 去重:
private normalizeUris(
  selected: string[]
): string[] {
  const unique =
    Array.from(new Set(selected))

  this.selectedCount =
    selected.length

  this.uniqueCount =
    unique.length

  this.duplicates =
    selected.length - unique.length

  return unique
}
最终得到 Selected=24、Unique URIs=21、Duplicates=3。
去重使用完整 URI,而不是文件名;不同目录出现同名文件很正常。
内容重复判断应在复制后做 Hash。
三、21 个文件不要一次性 Promise.all,复制并发固定为 4
批量复制最容易写成:
await Promise.all(uris.map(copyOne))
文件少时没问题,用户一次选很多大 PDF 后,就会同时打开一批源文件和目标文件,FD 与磁盘 I/O 峰值都不好控制。
这次我直接按 4 个一组执行:
private async copyInBatches(
  uris: string[]
): Promise<void> {
  const LIMIT = 4

  for (let i = 0; i < uris.length; i += LIMIT) {
    const group =
      uris.slice(i, i + LIMIT)

    await Promise.all(
      group.map((uri, offset) =>
        this.copyOne(
          uri,
          i + offset + 1
        )
      )
    )
  }
}
并发限制的目标是控制 I/O 峰值。本次 Concurrent Limit=4,21 个文件全部成功,Last Cost=842 ms。用户取消时停止提交下一组即可。
四、稳定性的关键,是 finally 里把两个 FD 都关掉
单个 URI 的复制看起来很简单:打开源 URI、创建沙箱文件、copy、close。
问题通常出在异常路径。源文件打开成功,目标文件创建失败;或者 copy 到一半抛异常,如果 close 只写在正常路径,FD 就会泄漏。
所以我把资源闭环写死在 finally:
import { fileIo } from '@kit.CoreFileKit'

private copyOne(
  uri: string,
  index: number
): void {
  let src: fileIo.File | undefined
  let dst: fileIo.File | undefined

  const name =
    `spec_${index.toString().padStart(2, '0')}.pdf`

  const outPath =
    `${this.outputDir}/${name}`

  try {
    src = fileIo.openSync(
      uri,
      fileIo.OpenMode.READ_ONLY
    )

    dst = fileIo.openSync(
      outPath,
      fileIo.OpenMode.READ_WRITE |
        fileIo.OpenMode.CREATE
    )

    fileIo.copyFileSync(
      src.fd,
      dst.fd
    )

    this.copied++
    this.lastFile = name
  } catch (_) {
    this.failed++
  } finally {
    if (src) {
      fileIo.closeSync(src)
    }

    if (dst) {
      fileIo.closeSync(dst)
    }
  }
}
最终 Open FDs=0。只有异常路径也能保证 close,批量导入才算闭环。
即使未来改成异步复制,源和目标也必须在 finally 里释放。
五、输出目录和文件名由业务管理
我没有直接把用户原文件名当成沙箱文件名,而是写到:
imports/20261001_20/spec_01.pdf
一直到:
spec_21.pdf
这样既避免原文件名冲突,也方便按批次清理。若必须保留原名,就把“展示名”和“沙箱存储名”分开保存。
正式项目可以为每个批次写 manifest,记录原 URI、沙箱文件名、大小和状态。
六、失败不能让整批任务失去可解释性
单文件失败只记录错误,批次继续;如果业务要求“全成或全败”,就需要临时目录和最终 commit。批量任务必须明确成功数和失败数。
七、调试页只保留跟资源闭环有关的数据
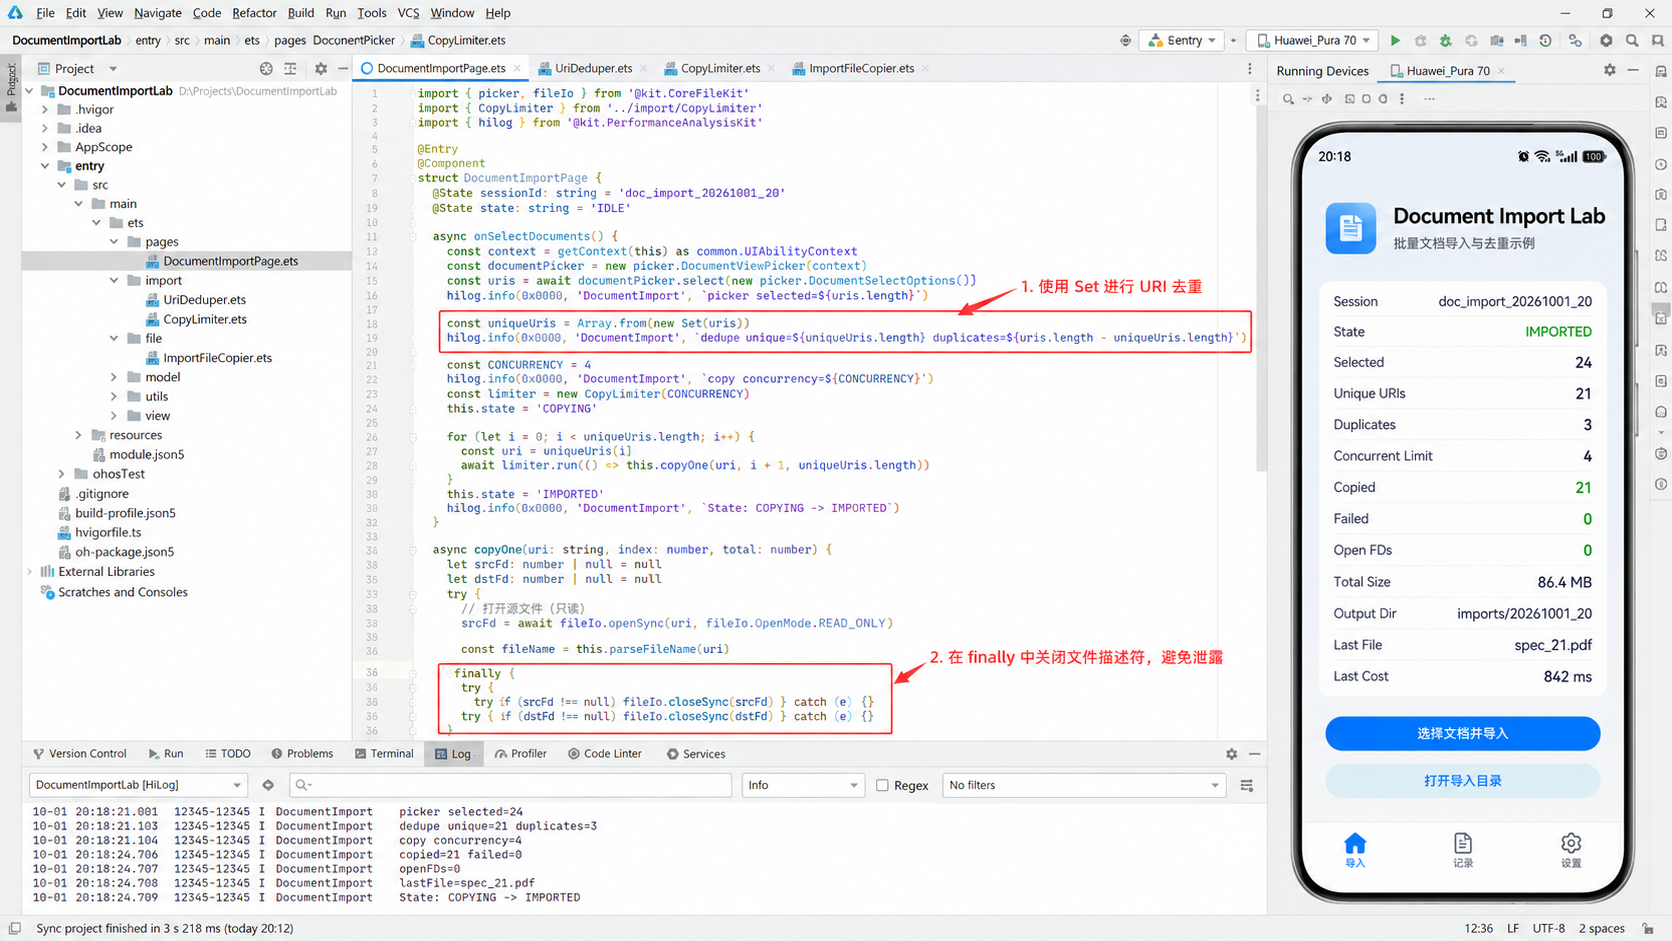
工程拆成 DocumentImportPage、UriDeduper、CopyLimiter 和 ImportFileCopier。HiLog 输出:
picker selected=24
dedupe unique=21 duplicates=3
copy concurrency=4
copied=21 failed=0
openFDs=0
lastFile=spec_21.pdf
State: COPYING -> IMPORTED
八、最终运行结果重点看 Open FDs=0
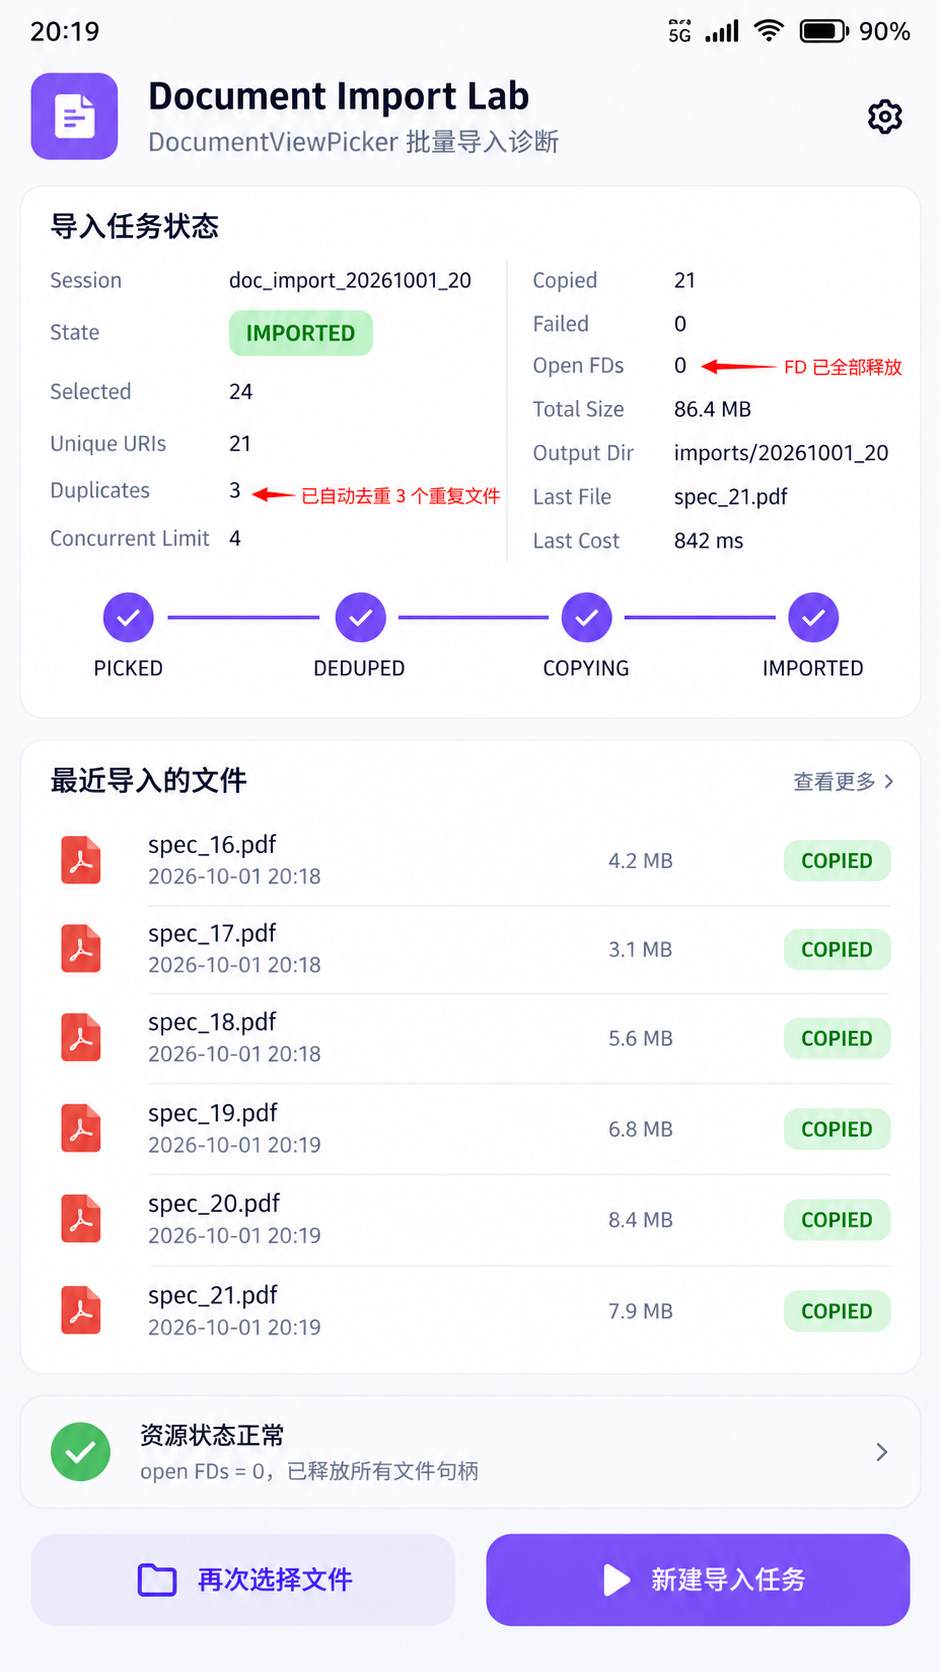
运行页最终显示:
- Selected:
24 - Unique URIs:
21 - Duplicates:
3 - Concurrent Limit:
4 - Copied:
21 - Failed:
0 - Open FDs:
0 - Total Size:
86.4 MB - Output Dir:
imports/20261001_20 - Last File:
spec_21.pdf - Last Cost:
842 ms
如果 Open FDs 还在增加,导入就不能算完成。
九、正式项目还要处理几个 Picker 边界
正式项目还要注意:Picker 应从 UIAbility 上下文拉起;URI 不应被当永久路径;系统可选择数量不等于应用应同时处理数量;用户取消后已打开的 FD 仍必须走 finally。导入后的 OCR、索引或 Hash 也应进入独立后处理队列。
十、这次真正补上的,是“选择文件”和“安全导入”之间那一段
最终状态链路是:
PICKED → DEDUPED → COPYING → IMPORTED
DocumentViewPicker 负责让用户安全选择文件,Set 负责去重,并发分组控制 I/O 峰值,finally 负责把每个文件句柄关干净。
批量导入真正稳定,是每一步都有明确边界。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)