
HarmonyOS 7 QuickDock 闪控窗开发实录 06:floatView × 回归验收:25轮场景回归、资源基线与发布前收口【鸿蒙心迹】
QuickDock 到第五篇,已经把所有关键能力都拆成了相对独立的状态层:
TaskRegistry
业务任务

DisplayModeCoordinator
闪控窗 / 闪控球

WindowSessionStore
位置 / 暂存

BackgroundTaskPolicy
前后台运行策略

FloatRecoveryCoordinator
窗口异常恢复

QuickDockResourceRegistry
显示资源治理
最后一篇我不再增加任何系统 API。
因为现在更重要的问题已经从:
能不能做
变成:
连续做 25 轮以后
状态还对不对
资源还干不干净
性能有没有明显回退
所以 06 固定做 6 类场景 × 25 轮完整回归。
本轮统一数据:
taskId:
float_accept_20261002_06

cases:
6 / 6

cycles:
25

modeSwitches:
100

dragRestores:
25

surfaceRebuilds:
25

stateLoss:
0

duplicateWindow:
0

listenerLeak:
0

timerLeak:
0

avgUpdate:
7.4ms

p95Update:
13.6ms

maxUpdate:
19.8ms

baselineMemory:
136.2MB

after25Cycles:
137.0MB

memoryDelta:
+0.8MB

activeResourcesAfterDispose:
0

status:
PASS
这些数据是 QuickDock 当前 Demo 在固定测试条件下的工程基线,不是 HarmonyOS 系统规格。
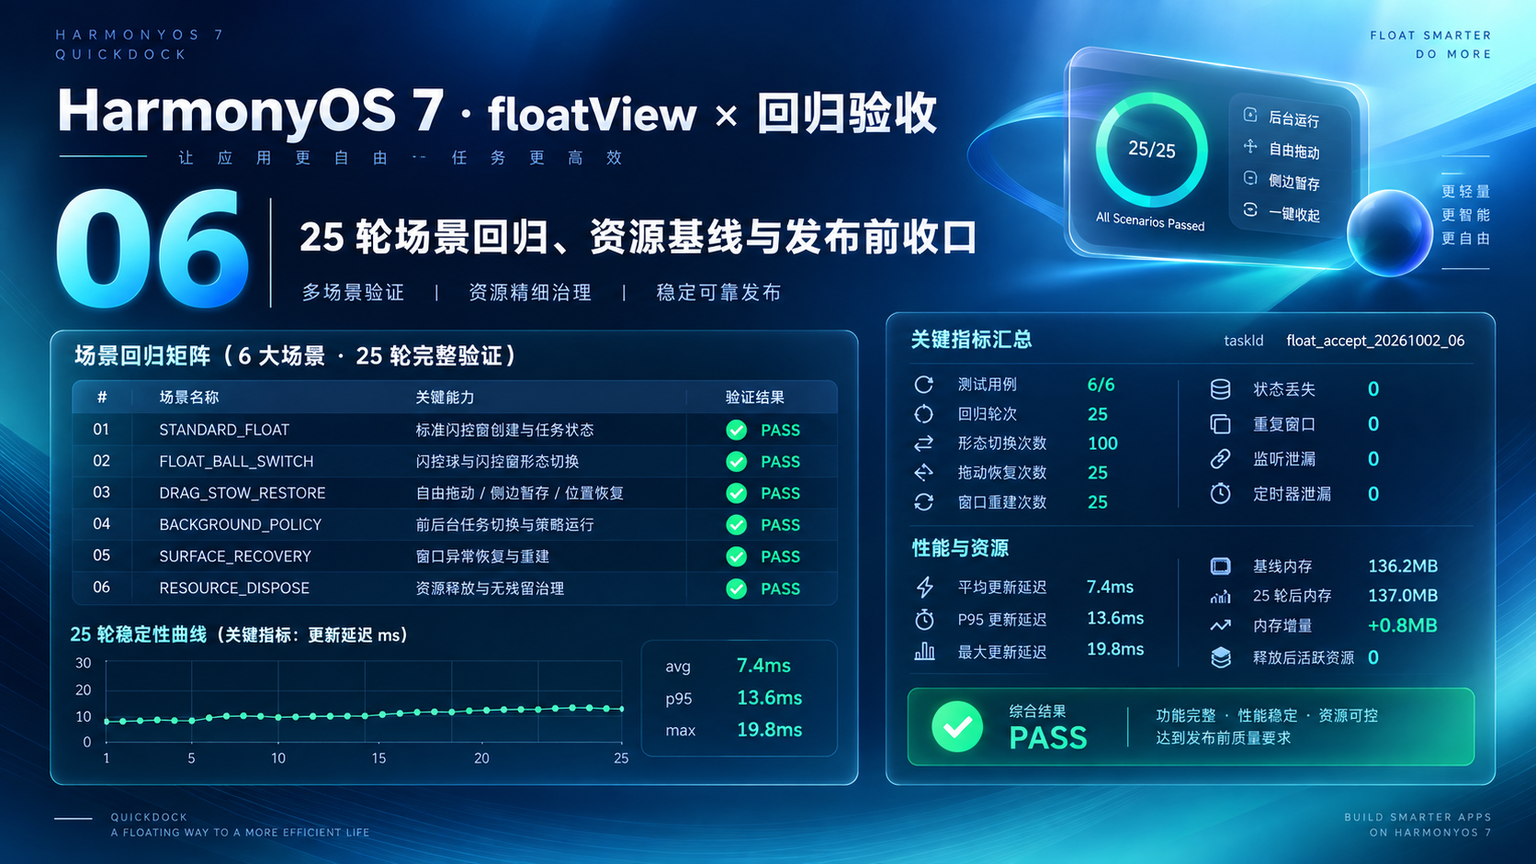
一、最终矩阵固定六个场景
回归场景和前五篇一一对应:
01 STANDARD_FLOAT

02 FLOAT_BALL_SWITCH

03 DRAG_STOW_RESTORE

04 BACKGROUND_POLICY

05 SURFACE_RECOVERY

06 RESOURCE_DISPOSE
每轮都按固定顺序执行。
这样出现:
cycle=17
scenario=SURFACE_RECOVERY
时可以直接定位,不需要重新手工复现整个用户操作。
二、STANDARD_FLOAT 验证最基础的单实例关系
第一场景每轮都做:
show
update
hide
show
要求:
floatWindowId
始终 quickdock_float_01

Task listener
始终 1

duplicateWindow
始终 0
这一条看起来最简单,却是后面所有场景的基础。
如果标准窗口本身都能重复创建,闪控球、异常恢复和前后台只会继续放大问题。
三、FLOAT_BALL_SWITCH 验证同一任务时间线
第二场景固定:
FLOAT_VIEW
→ FLOATING_BALL
→ FLOAT_VIEW
25 轮一共形成:
modeSwitches=100
因为每轮还包含一次暂停 / 恢复显示状态的双向切换。
断言:
taskId 不变
tickSeq 单调递增
progress 不倒退
floatWindowId 不变
ballId 不变
这里真正要防的是:
切一次形态
创建一份新业务状态
最终 stateLoss=0 说明 25 轮里没有发生状态分裂。
四、DRAG_STOW_RESTORE 验证位置状态能跨形态稳定恢复
第三场景固定位置链:
732 / 128
→ drag
→ RIGHT / STOWED
→ restore
→ 732 / 128
每轮都检查:
normalized 合法
edge=RIGHT
lastFloatingPosition 未被 STOWED 覆盖
restore 后经过 clamp
最终:
dragRestores=25
全部成功。
这一项主要验证第三篇的位置模型不是“只成功一次”。
五、BACKGROUND_POLICY 验证后台资格和业务状态不混淆
第四场景每轮建立两任务:
compress_assets_01
LOCAL_COMPUTE

upload_release_02
DATA_TRANSFER
进入后台后:
upload
→ RUNNING_BACKGROUND

compress
→ SUSPENDED_POLICY
回前台:
compress
→ RUNNING
如果用户主动把任务设成 PAUSED_BY_USER,回前台则不能自动恢复。
这个 case 不是测试网络速度,而是测试:
状态语义
有没有被前后台生命周期覆盖。
HarmonyOS 当前 Background Tasks Kit 明确属于受约束后台任务机制;长耗时常驻计算仍应结合 Worker 等并发机制处理线程模型,两者不能混为一谈。citeturn561364search0turn561364search2
六、SURFACE_RECOVERY 每轮都主动丢一次显示层
第五场景不是“等偶发错误”。
我直接主动触发:
FLOAT_SURFACE_LOST
然后检查:
TaskRegistry 不重建

activeJob 不重新调度

位置仍然来自 WindowSessionStore

旧 Adapter 释放

新 Adapter 创建

listenerCount=1
25 轮最终:
surfaceRebuilds=25
每次都成功回到当前任务。
没有:
duplicateWindow
也没有:
listenerLeak
七、RESOURCE_DISPOSE 是整套场景的最终收口
第六场景每轮最后执行:
cancel update timer
unbind listener
dispose ball
dispose float window
dispose adapter
assert registry empty
最终:
activeResourcesAfterDispose=0
这是 05 的 ResourceRegistry 在 25 轮里的真正压力测试。
如果某一轮:
timer=1
最终整个 case 就失败,不会因为 UI 看起来正常而继续算 PASS。
八、Runner 不随机操作,而是固定场景顺序
最终测试 Runner:
export class QuickDockAcceptanceRunner {
  private readonly scenarios = [
    'STANDARD_FLOAT',
    'FLOAT_BALL_SWITCH',
    'DRAG_STOW_RESTORE',
    'BACKGROUND_POLICY',
    'SURFACE_RECOVERY',
    'RESOURCE_DISPOSE'
  ]

  private readonly cycles:
    number = 25

  async run():
    Promise<void> {
    for (
      let cycle = 1;
      cycle <= this.cycles;
      cycle++
    ) {
      for (
        const scenario
        of this.scenarios
      ) {
        await this.runScenario(
          scenario,
          cycle
        )

        this.assertState()
        this.assertResources()
      }

      await this.memoryTracker
        .record(cycle)
    }
  }
}
固定顺序的好处是每一个版本都能做可比回归。
随机拖窗口很像“测试很多”,但失败以后很难重现。
九、状态断言只检查业务事实,不检查视觉截图
全场景固定核心状态:
taskId
jobId
taskState
progress monotonic
activeJob
displayMode
例如:
export class StateContinuityAssert {
  verify(
    before:
      QuickTaskSnapshot,
    after:
      QuickTaskSnapshot
  ): void {
    if (
      before.taskId !==
        after.taskId
    ) {
      throw new Error(
        'TASK_ID_CHANGED'
      )
    }

    if (
      after.progress <
        before.progress
    ) {
      throw new Error(
        'PROGRESS_ROLLBACK'
      )
    }
  }
}
最终:
stateLoss=0
代表没有 taskId 被换掉,也没有进度倒退。
十、ResourceAssert 要求每轮结束都能回到同一基线
资源检查不是只在第 25 轮做。
每轮结束都验证:
window=0
ball=0
listener=0
timer=0
adapter=0
然后下一轮重新开始。
这样如果第 8 轮开始泄漏,第 8 轮就会失败。
不会等 25 轮结束以后才发现总数变成 18,却不知道从哪一轮开始。
十一、性能看 update 延迟,不只看窗口 create
这一条回归记录的主要性能指标是:
UI 状态更新延迟
最终:
avg=7.4ms
p95=13.6ms
max=19.8ms
这个口径包括:
TaskStore 更新
→ 当前可见 Display Adapter 更新完成
不是完整业务任务耗时。
我更关心它,因为 QuickDock 的价值就是:
任务持续跑
窗口及时反映状态
如果 update 延迟从 7ms 变成 100ms,小窗即使能显示,也会让用户觉得状态“粘住了”。
十二、P95 比平均值更能看出偶发卡顿
平均:
7.4ms
很漂亮。
但如果 10 次里有 1 次 200ms,平均值仍然可能看起来正常。
所以正式基线同时看:
avg
p95
max
当前项目内部阈值:
P95 < 20ms
Max < 30ms
本轮:
13.6
19.8
全部通过。
这些阈值只是 QuickDock 当前工程标准,不是官方硬性限制。
十三、内存基线只在所有临时资源释放后采样
回归内存:
baseline:
136.2MB

after25:
137.0MB

delta:
+0.8MB
采样点必须固定在:
Float View dispose
Ball dispose
Listener off
Timer clear
Adapter dispose
全部完成以后。
如果窗口还开着就采样,数字当然会高。
最终关注的是:
每轮收口后
基线有没有阶梯上涨
本轮没有明显持续增长。
十四、DevEco 图里只保留最终矩阵和资源结果
开发图:
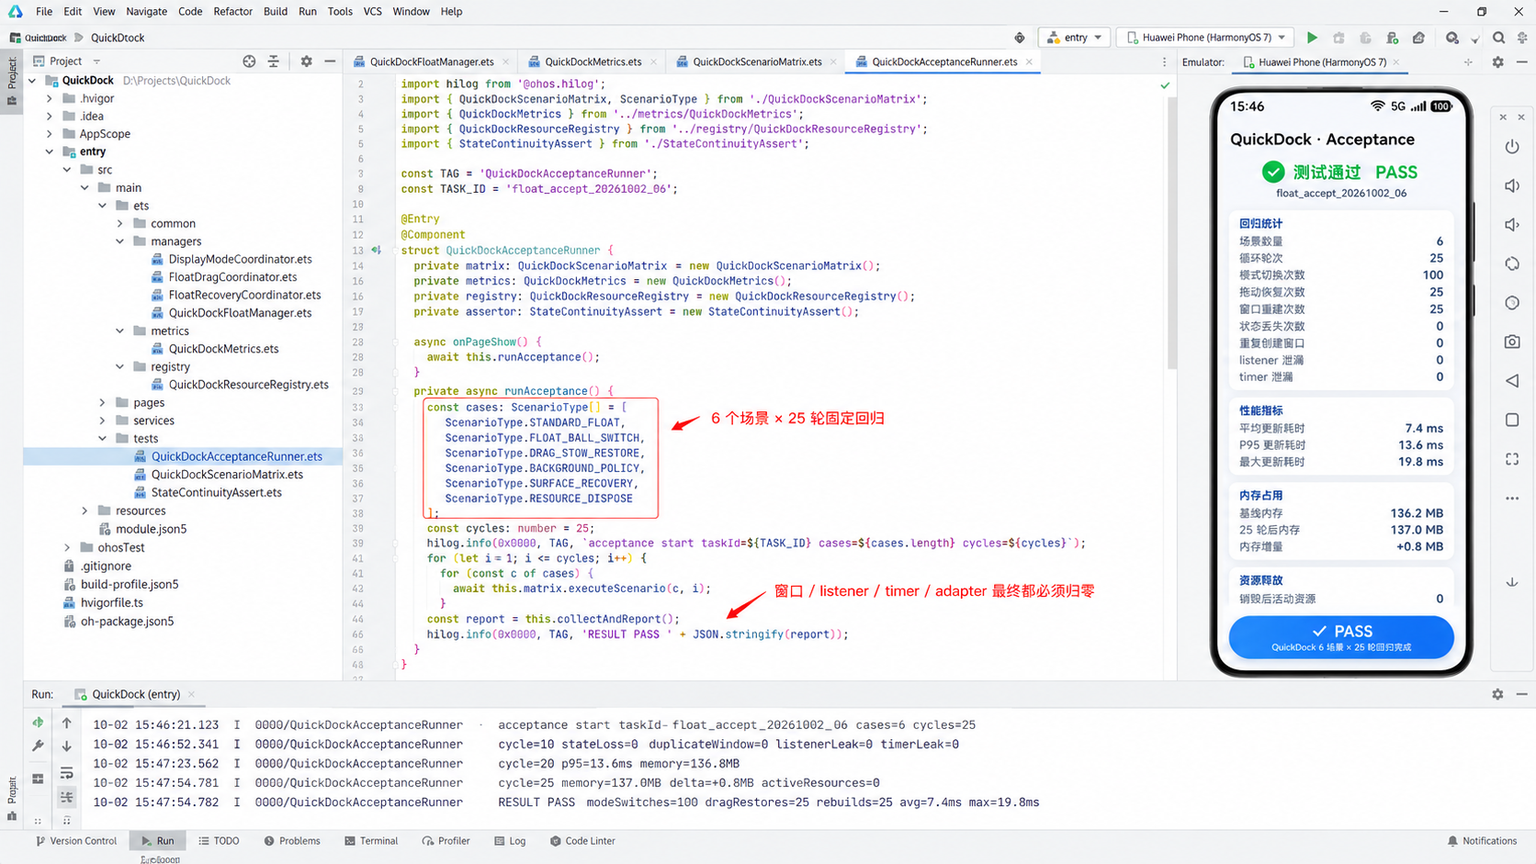
HiLog:
acceptance start

taskId=
float_accept_20261002_06

cases=6
cycles=25

cycle=10
stateLoss=0
duplicateWindow=0
listenerLeak=0
timerLeak=0

cycle=20
p95=13.6ms
memory=136.8MB

cycle=25
memory=137.0MB
delta=+0.8MB
activeResources=0

RESULT PASS

modeSwitches=100
dragRestores=25
rebuilds=25
avg=7.4ms
max=19.8ms
这一屏比某个窗口效果图更能证明系统能力真正被工程化。
十五、运行图把 6 个场景全部标成 PASS
最终运行图:
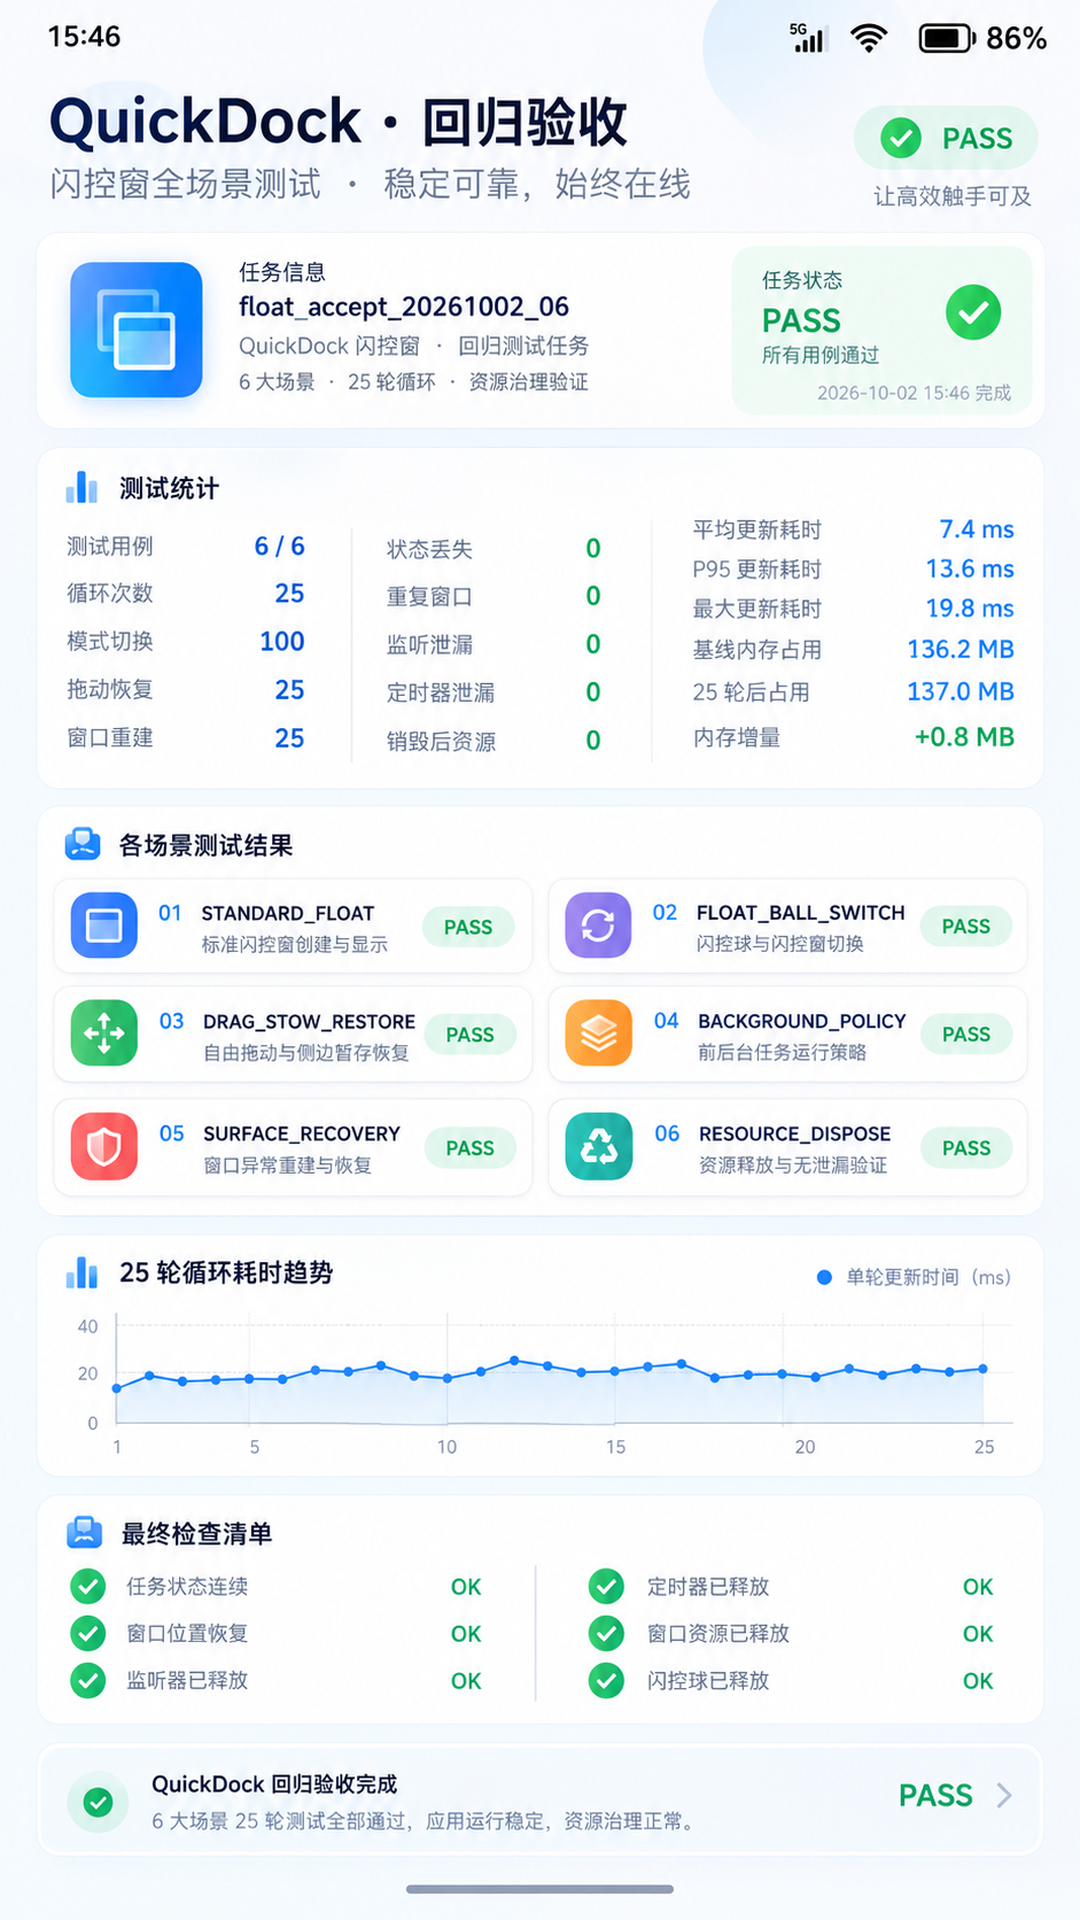
统一数据:
taskId:
float_accept_20261002_06

cases:
6 / 6

cycles:
25

modeSwitches:
100

dragRestores:
25

surfaceRebuilds:
25

stateLoss:
0

duplicateWindow:
0

listenerLeak:
0

timerLeak:
0

avg:
7.4ms

p95:
13.6ms

max:
19.8ms

memory:
136.2 → 137.0MB

delta:
+0.8MB

activeResourcesAfterDispose:
0

status:
PASS
到这里,QuickDock 的 6 篇主线正式收口。
十六、这六篇最终留下的是一套窗口能力的工程边界
回头看整个系列:
01
窗口不是任务

02
不同形态共享同一任务状态

03
位置状态独立于任务状态

04
后台策略独立于显示恢复

05
资源创建必须有明确 Owner

06
所有临时资源最终必须回到 0
这些边界比某个 API 调用更重要。
以后换成:
下载
上传
视频导出
AI 推理
设备同步
只要仍然是长任务 + 系统悬浮展示,很多结构都可以复用。
十七、正式发版前还要把测试入口隔离
Acceptance 页面不会出现在普通用户入口里。
最终构建策略:
internal / debug
→ 保留回归入口

release
→ 移除测试按钮
→ 保留必要 Metrics
→ 降低高频日志
这样工程仍然可回归,但不会把测试工具暴露给用户。
十八、QuickDock 到 06 正式结束
这个系列固定 X=6,到这里完成。
继续写 07,已经很容易重复:
换一种任务
再跑一次窗口
下一轮应该换到一个明显不同的技术方向和 Demo,从新的 01 开始。
优先考虑仍然与当前系列差异明显的:
精准碰一碰 / 跨设备投递

应用上架审核 / AppGallery Connect

图像超分
而不是继续扩展闪控窗。
十九、每个场景都要有独立失败码
最终 Runner 不会只返回:
FAIL
因为六个场景的失败性质完全不同。
我给每类失败定义清晰代码:
FLOAT_DUPLICATED

TASK_STATE_LOST

POSITION_RESTORE_FAILED

BACKGROUND_POLICY_MISMATCH

SURFACE_REBUILD_FAILED

RESOURCE_NOT_CLEAN
例如:
cycle=13
scenario=DRAG_STOW_RESTORE
error=POSITION_RESTORE_FAILED
比:
test failed
有用得多。
失败以后 Runner 会立刻保存这一轮上下文,不继续跑后面几十次操作把现场冲掉。
二十、25 轮里还要检查任务 ID 是否被“偷偷换掉”
很多状态连续性问题不会表现成进度倒退。
一种更隐蔽的错误是:
窗口恢复以后
新建了一个 task
progress 恰好还是 73%
视觉上完全一样。
所以最终回归会持续检查:
taskId
同一业务任务在形态切换、位置恢复和 Surface 重建过程中不能变化。
只有真正开始下一条业务任务时,才允许新 taskId。
这也是为什么前几篇一直把 taskId 放进 HiLog 和图片里。
二十一、后台场景回归不能依赖真实网络速度
如果每轮都真的上传几十 MB 文件,25 轮测试会受到网络波动影响。
最终 Acceptance Runner 使用可控的业务测试 Adapter:
DataTransferTestAdapter
它仍然走:
BackgroundTaskPolicy
状态转换
TaskRegistry
UI 更新
但传输进度由固定测试序列推进。
真实网络集成测试另外跑。
这样这一篇的性能指标测的是:
窗口状态更新和生命周期链路
而不是 Wi‑Fi 快慢。
二十二、位置回归也不能依赖手工拖动
DRAG_STOW_RESTORE 场景使用固定输入:
start:
732 / 128

end:
920 / 356

edge:
RIGHT
Runner 直接调用 DragCoordinator 的测试入口,走和真实手势相同的业务逻辑。
这样 25 轮位置恢复结果可以直接对比。
如果靠人工拖,每轮差几十像素,最后很难判断 clamp 和 normalized 是否发生回归。
二十三、窗口恢复场景里要模拟两种失败
SURFACE_RECOVERY 不只测:
rebuild success
还会插入一条失败路径:
Adapter rebuild failed
要求:
TaskRegistry 继续存在
activeJob 不变
资源 Registry 不新增泄漏
允许下一次重新显示
最终统计的 25 次 surfaceRebuilds 是成功恢复次数,失败分支则单独做 fault injection,不进入正常性能平均值。
这样“恢复失败时不破坏业务”也被纳入最终验收。
二十四、内存曲线看每轮收口点,而不是只看起点和终点
136.2MB → 137.0MB 看起来很稳。
但如果中间曾经:
136
148
162
150
137
只看头尾也会掩盖问题。
所以 MemoryTracker 保存 25 个释放后采样点。
当前趋势没有出现持续阶梯增长。
如果某轮资源已经全部归零,但内存释放后仍连续上涨,就要继续查:
业务缓存
历史 Snapshot
Repository
日志缓冲
而不是只盯 Window Registry。
二十五、ResourceRegistry 为 0 也不代表一切都安全
最终还检查:
TaskStore listener collection size
Scheduler pending snapshot
Recovery lock
Display session state
因为 Registry 只能统计登记过的资源。
如果某个开发者忘记注册一个 listener,Registry 永远不会知道它泄漏。
所以第六篇还通过 Owner 自身状态做交叉验证。
最终要求:
Registry=0
Owner active=false
Listener collection=0
Timer id=-1
Pending snapshot=null
多个口径都一致,才算真正干净。
二十六、发布前性能阈值是“基线”,不是营销数字
本轮内部阈值:
P95 < 20ms
Max < 30ms
Memory Delta < 3MB
它们的价值是:
下一版本还能不能和这一版比较
而不是拿出去宣称:
HarmonyOS 闪控窗 7.4ms
7.4ms 只是 QuickDock 当前测试工程在当前输入下的 UI 状态更新平均耗时。
换设备、换任务复杂度、换窗口内容,数字都可能变化。
文章里保留边界,比追求漂亮数字更重要。
二十七、最终报告还保存每个场景的收口快照
25 轮最后一次结束后,我保存:
STANDARD_FLOAT:
window=0

FLOAT_BALL_SWITCH:
mode=FLOAT_VIEW
ballVisible=false

DRAG_STOW_RESTORE:
position=732/128

BACKGROUND_POLICY:
no active background lease

SURFACE_RECOVERY:
rebuilding=false

RESOURCE_DISPOSE:
activeResources=0
这相当于一份“最终状态证明”。
不是只看过程中有没有报错,还要看每条临时链路结束以后,系统最终停在哪里。
二十八、正式发布前还要关闭高频诊断日志
开发阶段为了看清:
position
tickSeq
listenerCount
timerCount
日志非常密集。
Release 不需要每 250ms 输出一次进度。
最终会把日志分级:
INFO
关键生命周期

WARN
降级 / 回滚

ERROR
资源释放失败

DEBUG
高频进度和测试细节
回归能力保留,但不让诊断本身成为新的性能开销。
二十九、QuickDock 最终收口的是一条“可持续任务”工程主线
从第一篇到最后一篇,没有换 Demo,也没有换业务任务模型。
整个演进是:
任务独立于窗口

窗口形态独立于任务

位置独立于任务

后台策略独立于窗口

资源 Owner 独立明确

所有临时资源最终可归零
这套结构真正适合复用到长耗时任务,而不只是做一张好看的悬浮窗截图。
所以系列到 06 停止是合理的。
下一轮再继续闪控窗,只会换业务壳子重复同样的生命周期问题。
三十、验收开始前和结束后都要做一次空闲基线检查
25 轮数据只有在起点和终点都干净时才有意义。
所以 Runner 最前面先确认:
window=0
ball=0
listener=0
timer=0
adapter=0
然后才创建第一轮 Float View。
第 25 轮结束以后再检查一遍同样的空闲基线。
如果起点不干净,说明上一次测试已经留下残留;如果终点不干净,说明本轮没有收口。两种情况都不能继续拿内存和性能数字做结论。
三十一、最终 PASS 是工程状态,不是“页面看起来正常”
最后一页显示绿色 PASS,看起来很简单,但它背后同时要求:
功能场景全通过
业务状态连续
资源全部释放
位置可恢复
后台策略正确
异常恢复可用
性能没有明显回退
任何一项失败,最终状态都不会显示 PASS。
这也是整个 QuickDock 连载最后想留下的判断标准:系统窗口能力真正进入产品,不是“能调 API”,而是生命周期、状态和资源都有明确证据。
参考资料
- HarmonyOS 7 闪控窗开发指南:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/float-view-guide
- HarmonyOS 文档中心:Background Tasks Kit:https://developer.huawei.com/consumer/cn/doc/
- 常驻任务并发场景:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/resident-task-overview
- 耗时任务并发场景:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/time-consuming-task-overview

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献140条内容

所有评论(0)