
HarmonyOS 7 QuickDock 闪控窗开发实录 04:Background Tasks Kit × Stage:前后台任务切换与窗口异常恢复【鸿蒙心迹】
03 把 QuickDock 的拖动、侧边暂存和位置持久化做稳定以后,窗口这条线终于没有太多悬念。
第四篇开始处理真正复杂的业务状态:
应用进入后台
两个任务并存
不同任务后台策略不同
当前闪控窗切换展示任务
Float Surface 中途丢失
回前台后恢复
这一篇我故意没有写成“应用后台后任务继续跑”。
因为 HarmonyOS 的后台任务是受系统调度和场景约束的。当前 Background Tasks Kit 提供短时任务、长时任务等机制,不同业务要选择匹配的后台模式;官方最佳实践里也明确用长时任务保障视频导出、上传、下载等长耗时业务在后台持续执行。
所以 QuickDock 04 把两个任务拆开:
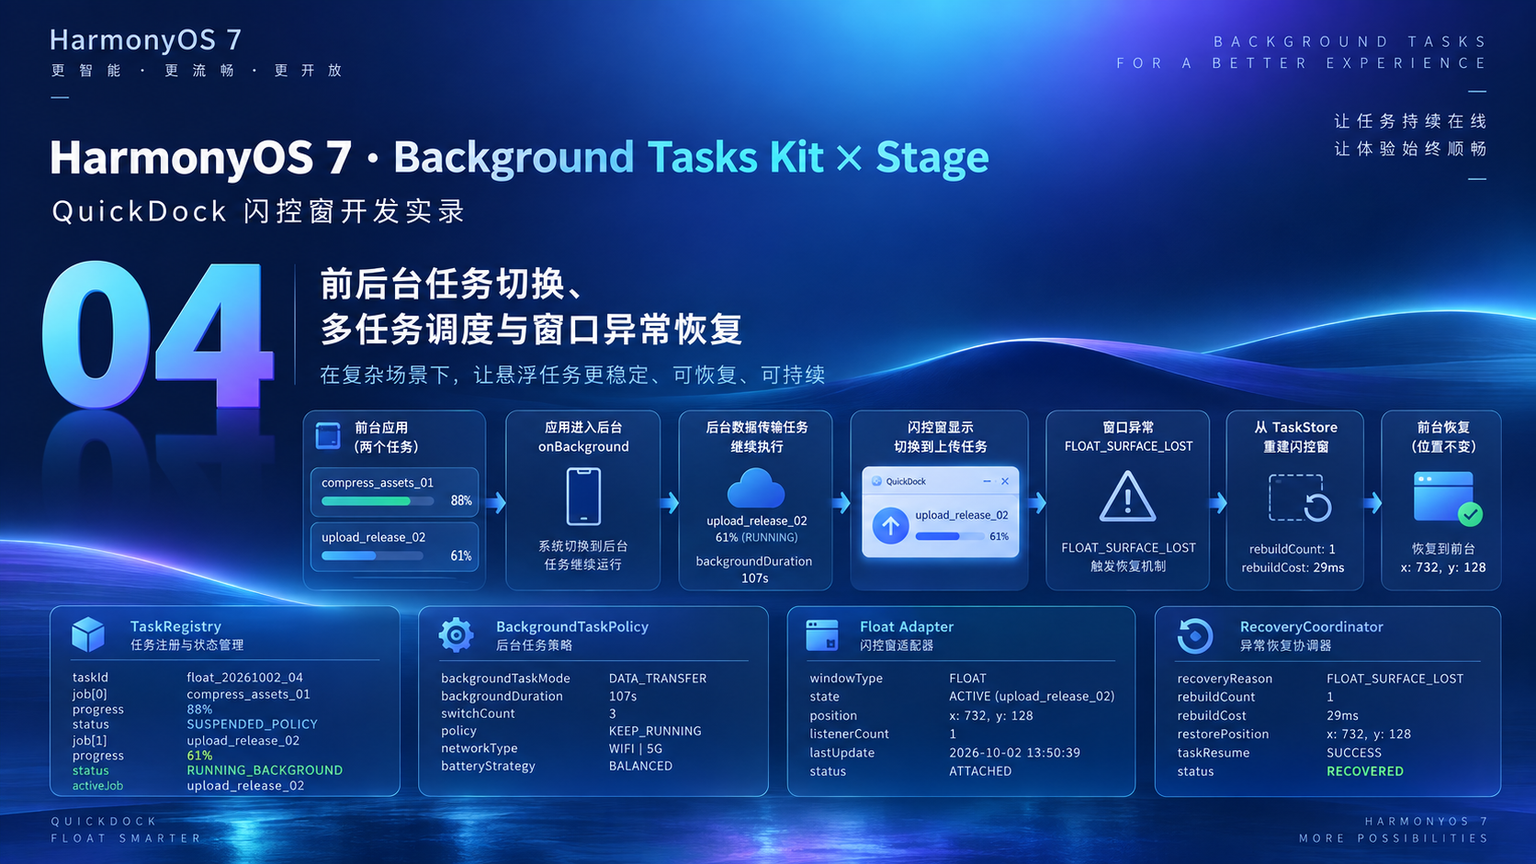
compress_assets_01
本地计算
88%
SUSPENDED_POLICY

upload_release_02
数据传输
61%
RUNNING_BACKGROUND
当前闪控窗显示的是:
upload_release_02
本轮统一数据:
taskId:
float_20261002_04

taskCount:
2

job0:
compress_assets_01

job0Progress:
88%

job0State:
SUSPENDED_POLICY

job1:
upload_release_02

job1Progress:
61%

job1State:
RUNNING_BACKGROUND

activeJob:
upload_release_02

mode:
FLOAT_VIEW

backgroundTaskMode:
DATA_TRANSFER

backgroundDuration:
107s

switchCount:
3

recoveryReason:
FLOAT_SURFACE_LOST

rebuildCount:
1

rebuildCost:
29ms

listenerCount:
1

restoredPosition:
x=732, y=128

status:
RECOVERED
一、前后台切换以后,最不该做的是“所有任务一视同仁”
如果 TaskRegistry 里有两个任务:
本地压缩
数据上传
应用进入后台时不能简单:
全部继续
也不能:
全部暂停
应该由任务类型决定策略。
QuickDock 增加:
policy/
└── BackgroundTaskPolicy.ets
先把业务类型抽象出来:
export type QuickTaskKind =
  'LOCAL_COMPUTE' |
  'DATA_TRANSFER'

export type BackgroundDecision =
  'KEEP_RUNNING' |
  'SUSPEND_POLICY'

export class BackgroundTaskPolicy {
  resolve(
    kind: QuickTaskKind
  ): BackgroundDecision {
    if (
      kind ===
        'DATA_TRANSFER'
    ) {
      return 'KEEP_RUNNING'
    }

    return 'SUSPEND_POLICY'
  }
}
这是项目自己的决策层。
真正申请 HarmonyOS Background Tasks Kit 能力的代码仍然放在 Adapter / Service 里,不把系统调用散到页面。
二、为什么上传任务可以继续,压缩任务这里选择暂停
当前 Background Tasks Kit 的长时任务模式包含数据传输等明确场景;官方文档也强调后台任务需要按实际业务选择合适机制,避免无限制占用资源。
所以 QuickDock 本轮对:
upload_release_02
采用:
DATA_TRANSFER
后台策略。
而本地压缩:
compress_assets_01
在当前 Phone Demo 里没有强行声明“后台无限执行”,而是:
RUNNING
→ SUSPENDED_POLICY
回前台再恢复。
这个设计比文章里一句“后台继续压缩”更符合系统约束。
如果未来切到符合其他后台模式的设备与场景,再由 Policy 决定是否允许继续。
三、TaskRegistry 从单任务升级成两任务,但 Float View 仍然只显示一个 activeJob
这一篇正式把 Store 从单任务升级成 Registry:
export interface RegistryTask {
  taskId: string
  jobId: string
  title: string

  kind: QuickTaskKind

  progress: number
  state:
    'RUNNING' |
    'RUNNING_BACKGROUND' |
    'SUSPENDED_POLICY' |
    'COMPLETED'
}

export class TaskRegistry {
  private tasks:
    Map<string, RegistryTask> =
      new Map()

  private activeJobId:
    string = ''

  setActive(
    jobId: string
  ): void {
    if (!this.tasks.has(jobId)) {
      return
    }

    this.activeJobId =
      jobId
  }
}
两个任务可以同时存在。
但标准闪控窗当前只显示:
activeJob
否则 320×184vp 的小窗很快会变成完整任务管理器。
四、进入后台时,activeJob 也可能切换
进入后台前:
activeJob:
compress_assets_01
但压缩任务被策略挂起以后,继续显示一个:
88%
SUSPENDED_POLICY
意义不大。
所以 QuickDock 自动切到:
upload_release_02
61%
RUNNING_BACKGROUND
这次:
switchCount=3
包含:
用户手动切一次
后台策略切一次
前台恢复切一次
显示任务切换,不等于业务任务迁移。
只是 Float View 选择不同 Snapshot 显示。
五、Stage 生命周期只触发策略,不直接改任务内部实现
UIAbility:
onBackground
onForeground
不应该直接:
upload.start()
compress.pause()
而是通知 Coordinator:
export class ForegroundBackgroundCoordinator {
  constructor(
    private registry:
      TaskRegistry,
    private policy:
      BackgroundTaskPolicy
  ) {}

  onBackground(): void {
    this.registry
      .all()
      .forEach(
        (
          task:
            RegistryTask
        ) => {
          const decision =
            this.policy.resolve(
              task.kind
            )

          if (
            decision ===
              'KEEP_RUNNING'
          ) {
            this.registry
              .markBackgroundRunning(
                task.jobId
              )
          } else {
            this.registry
              .suspendByPolicy(
                task.jobId
              )
          }
        }
      )
  }
}
生命周期只是“系统环境发生变化”的信号。
真正任务怎么处理,由业务 Policy 和对应 Service 决定。
六、后台数据传输使用系统能力,Window 只是状态出口
upload_release_02 进入:
RUNNING_BACKGROUND
以后,QuickDock 会通过 Background Tasks Kit 的适配层申请匹配的数据传输能力。
这里最重要的一条仍然是:
Background Task
!=
Float View
即使闪控窗短暂不可见,上传任务仍然由后台任务机制管理。
反过来,即使 Float View 还显示,系统也不意味着允许任意本地计算无限在后台跑。
这两个能力不能互相替代。
七、这一篇专门模拟一次 FLOAT_SURFACE_LOST
前两篇都是正常显示路径。
04 我主动做一个异常:
任务仍在
Store 正常
Float View Surface 丢失
异常标记:
FLOAT_SURFACE_LOST
关键规则:
重建显示层,不重建 TaskRegistry。
所以 FloatRecoveryCoordinator:
export class FloatRecoveryCoordinator {
  private rebuildCount:
    number = 0

  async rebuild(
    reason: string
  ): Promise<void> {
    const snapshot =
      TaskRegistry.shared()
        .activeSnapshot()

    const position =
      WindowSessionStore.shared()
        .lastPosition()

    await FloatViewAdapterFactory
      .current()
      .rebuildFromSnapshot(
        snapshot,
        position
      )

    this.rebuildCount++
  }
}
任务不会重新开始。
上传仍然是:
61%
窗口只是重新读取当前 Snapshot。
八、异常恢复后 listener 必须仍然只有 1
窗口重建最容易带来的副作用是:
旧 listener 没解绑
新窗口又注册一个
下一次进度变化就会收到两份 UI Update。
所以恢复以后检查:
listenerCount=1
本轮:
rebuildCount=1
listenerCount=1
如果变成 2,恢复不能记成成功。
九、位置恢复继续复用第三篇数据
窗口 Surface 重建后:
x=732
y=128
不是重新回默认左上角。
第三篇做的 WindowSessionStore 在这里直接复用。
恢复顺序:
TaskRegistry 当前 activeJob
→ WindowSessionStore lastPosition
→ Adapter rebuild
→ bind single listener
→ show
因此 03 的位置工程并不是独立小功能,而是 04 异常恢复真正依赖的基础。
十、前后台期间的 107 秒,到底发生了什么
当前回归数据:
backgroundDuration=107s
在这段时间里:
upload_release_02
36% → 61%
RUNNING_BACKGROUND

compress_assets_01
88%
SUSPENDED_POLICY
回前台后:
compress_assets_01
允许重新 RUNNING
如果用户切回压缩任务,窗口继续从 88% 显示,不会从头开始。
这就是 TaskRegistry 独立存在的价值。
十一、DevEco 图里要同时看到策略和恢复
开发图:
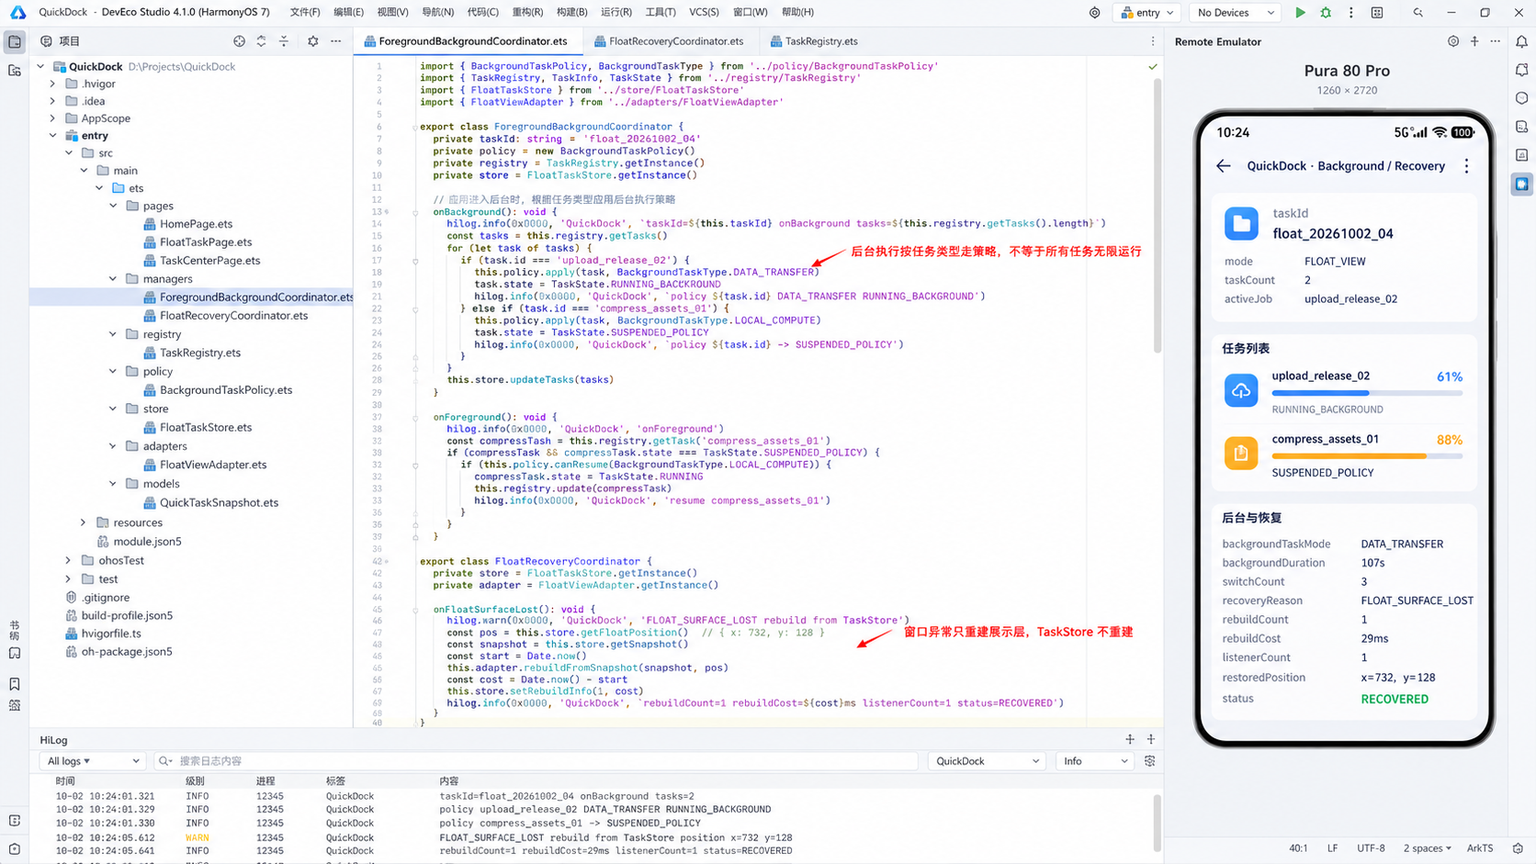
本轮 HiLog:
taskId=
float_20261002_04

onBackground
tasks=2

policy
upload_release_02
DATA_TRANSFER
RUNNING_BACKGROUND

policy
compress_assets_01
SUSPENDED_POLICY

FLOAT_SURFACE_LOST

rebuild from TaskStore
position x=732 y=128

rebuildCount=1
rebuildCost=29ms

listenerCount=1

status=RECOVERED
这套日志能明确区分:
任务策略问题
和:
窗口恢复问题
十二、运行图第一次出现两个任务
最终运行图:
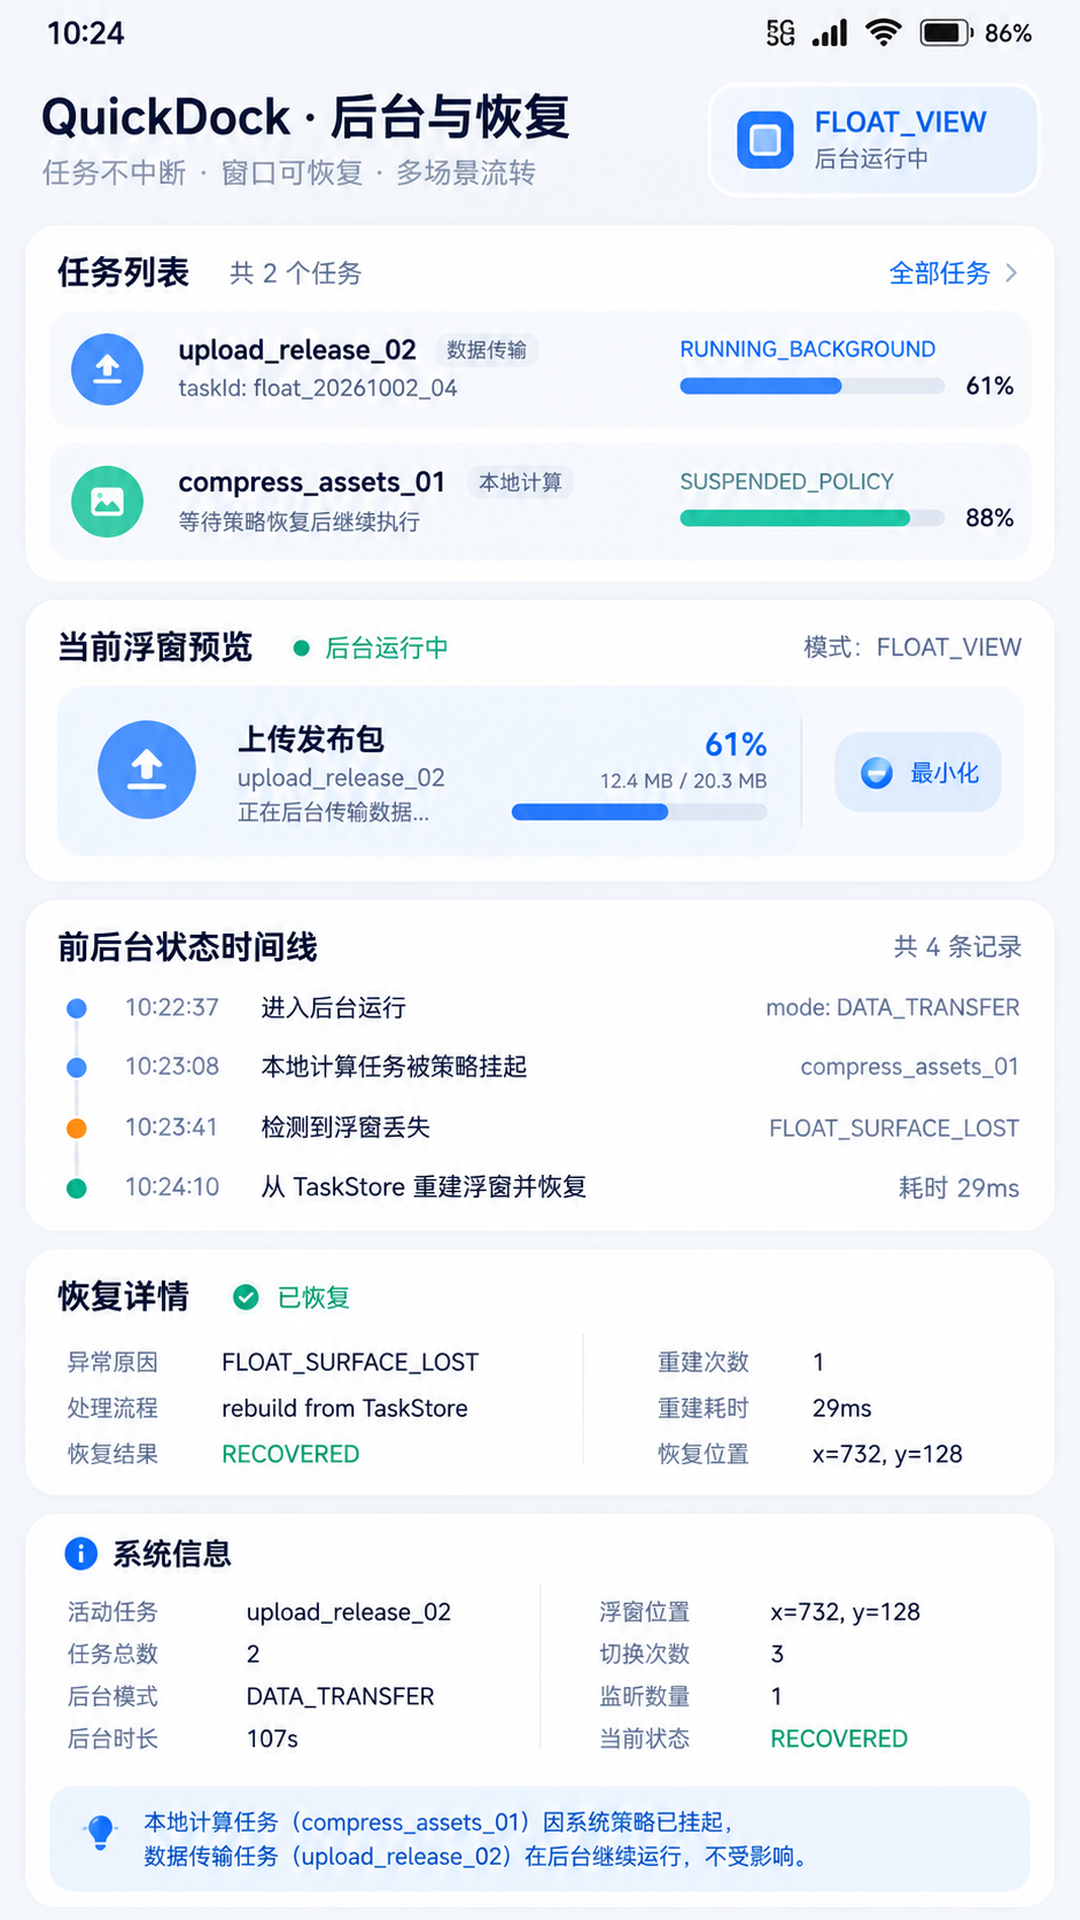
任务列表:
upload_release_02
61%
RUNNING_BACKGROUND

compress_assets_01
88%
SUSPENDED_POLICY
当前 Float View:
activeJob:
upload_release_02
异常恢复:
FLOAT_SURFACE_LOST
→ rebuild
→ RECOVERED
位置:
732 / 128
所有数据与 DevEco、日志保持一致。
十三、为什么本地压缩不偷偷放 Worker 就宣称“后台无限继续”
HarmonyOS 当前并发指导确实建议长耗时、常驻计算把工作放到 Worker,避免阻塞 UI 主线程。
但:
Worker
解决的是:
不要阻塞 UI
不是:
应用进后台后系统一定允许无限执行
后台生命周期和系统调度仍然要遵守 Background Tasks Kit 的规则。
所以 QuickDock 把两个问题分开:
线程执行模型
和
后台运行资格
这条边界对技术文章很重要,否则很容易把“子线程”误写成“后台保活”。
十四、多任务切换也不能复制任务对象
现在 Registry 有两个 Task。
Float View 切换显示时,只改变:
activeJobId
不会把任务内容复制进 WindowState。
否则:
TaskRegistry 61%
WindowState 58%
又会重回第二篇解决过的状态分裂。
所以多任务以后仍然保持:
TaskRegistry
= 业务事实源

Window
= 当前 activeJob 的投影
十五、应用回前台后,恢复顺序也必须固定
前台恢复流程:
onForeground

→ 重新评估 BackgroundTaskPolicy

→ compress_assets_01
SUSPENDED_POLICY → RUNNING

→ upload_release_02
继续 RUNNING

→ 检查 Float Surface

→ 如果已丢失
rebuild

→ 恢复 activeJob
不能一回前台就先新建窗口。
因为窗口真正需要展示的是评估后的最新 TaskRegistry。
十六、后台任务失败和 Float Surface 丢失是两类异常
这一篇还专门区分:
TASK_FAILED
与:
FLOAT_SURFACE_LOST
前者:
任务业务失败
→ Store = FAILED
→ UI 显示失败
后者:
任务仍正常
→ 只重建窗口
如果把两者都叫:
ERROR
后面根本无法判断到底要不要重启任务。
十七、RECOVERED 代表什么
最终状态:
RECOVERED
至少代表:
后台数据任务继续

本地计算遵守策略挂起

两个任务状态没有丢

Float Surface 可以重建

位置恢复正确

listener 仍然只有 1
不只是“窗口又出现了”。
十八、第四篇最后做了六组压力测试
第一组,进入后台 107 秒,上传继续、压缩挂起。
第二组,回前台以后压缩恢复,不重新生成 taskId。
第三组,切换 activeJob 三次,进度分别保持。
第四组,模拟一次 FLOAT_SURFACE_LOST,只重建 UI。
第五组,重建后位置仍是 732 / 128。
第六组,恢复后 listenerCount=1,没有重复订阅。
六组通过以后,本轮才记成:
RECOVERED
十九、下一轮 05 会把“偶发异常”升级成资源治理
做到 04,QuickDock 已经拥有:
Float View
Floating Ball
Drag
Edge Stow
Preferences
Background Task
Multi Task
Recovery
能力开始多起来以后,新的问题会变成:
重复创建
重复 listener
Window 没释放
Ball 没释放
Timer 没释放
TaskRegistry 任务已经结束但 UI 还在
05 会专门做生命周期冲突和资源治理。
06 最后再跑 25 轮完整回归,检查:
窗口实例
listener
timer
内存
切换耗时
任务状态
不再加新功能。
二十、任务 Registry 必须保存“为什么被挂起”,不能只有一个 PAUSED
compress_assets_01 在后台变成:
SUSPENDED_POLICY
我没有写成普通:
PAUSED
因为这两个语义不同。
用户点击暂停:
PAUSED_BY_USER
系统策略不允许当前场景继续:
SUSPENDED_POLICY
两者恢复条件也不同。
用户暂停的任务不能因为回前台就自动恢复;策略挂起的任务则可以在环境允许后恢复。
所以最终状态枚举更细:
export type RegistryTaskState =
  'RUNNING' |
  'RUNNING_BACKGROUND' |
  'PAUSED_BY_USER' |
  'SUSPENDED_POLICY' |
  'COMPLETED' |
  'FAILED'
04 当前压缩任务明确是:
SUSPENDED_POLICY
而不是用户主动暂停。
这条区别会继续影响 05 的生命周期治理。
二十一、后台任务申请失败时,要回退,而不是伪装成 RUNNING_BACKGROUND
数据上传任务计划申请:
DATA_TRANSFER
但系统能力申请仍然可能失败。
比如:
参数不合法
系统调度拒绝
能力不可用
这时绝对不能:
UI 仍显示 RUNNING_BACKGROUND
QuickDock 的处理是:
request background capability
→ success
→ RUNNING_BACKGROUND

request failed
→ BACKGROUND_DENIED
→ 根据业务决定暂停或回主应用
UI 会显示明确的“后台能力不可用”,而不是继续画一个假的 61% 进度。
当前本轮是成功路径,所以最终是:
RUNNING_BACKGROUND
但失败分支已经存在。
二十二、activeJob 切换不能改变 TaskRegistry 的排序和生命周期
闪控窗当前只显示一个任务。
从:
compress_assets_01
切到:
upload_release_02
只是改变:
activeJobId
不会:
暂停原任务
重排 Registry
重建 Task Runner
因此 switchCount=3 只表示显示焦点切换次数。
这和“任务切换”这个词很容易混淆。
更准确地说:
QuickDock 切换的是“当前展示任务”,不是“系统只允许一条任务活着”。
多任务模型如果没有这条边界,用户每点一次任务卡片就可能意外影响业务运行。
二十三、Float Surface 异常恢复还要防止重复 rebuild
如果 FLOAT_SURFACE_LOST 连续上报两次,第一次 rebuild 还没完成,第二次又进来,会出现:
rebuildCount=2
甚至重复订阅 listener。
所以 Coordinator 增加恢复锁:
export class FloatRecoveryCoordinator {
  private rebuilding:
    boolean = false

  async rebuild(): Promise<void> {
    if (this.rebuilding) {
      return
    }

    this.rebuilding = true

    try {
      const snapshot =
        TaskRegistry.shared()
          .activeSnapshot()

      const pos =
        WindowSessionStore.shared()
          .lastPosition()

      await FloatViewAdapterFactory
        .current()
        .rebuildFromSnapshot(
          snapshot,
          pos
        )
    } finally {
      this.rebuilding = false
    }
  }
}
当前最终:
rebuildCount=1
不是因为系统只触发了一次,而是 Manager 保证一次恢复流程只有一份。
二十四、回前台时先恢复业务状态,再恢复 UI
应用重新进入前台以后,最自然的写法是:
onForeground
→ show Float View
→ resume tasks
但这样窗口第一帧可能显示旧状态。
QuickDock 改成:
onForeground
→ 重新评估 task policy
→ 更新 TaskRegistry
→ 恢复 activeJob
→ 再检查 / 重建 Float View
所以窗口看到的第一帧就是最新状态。
例如本地压缩:
SUSPENDED_POLICY
→ RUNNING
如果 Float View 当前 activeJob 切回它,页面会直接显示 RUNNING,而不是先闪一下 SUSPENDED。
二十五、UIAbility 生命周期和 Background Task 生命周期不能互相替代
Stage 生命周期提供:
onForeground
onBackground
它告诉应用:
前后台环境变化了
Background Tasks Kit 解决的是:
某类业务是否可以在后台受约束地继续
这两个能力层级不同。
所以:
onBackground
并不等于:
开始一个后台任务
而只是触发 Policy 评估。
同样:
onForeground
也不应该直接把所有任务恢复 RUNNING。
只有状态和策略都允许的任务才恢复。
这种分层能避免生命周期回调里堆一大坨业务分支。
二十六、异常恢复以后,要检查旧 Adapter 有没有真正释放
FLOAT_SURFACE_LOST 重建新显示层后,如果旧 Adapter 还持有:
timer
listener
surface reference
即使用户只看到一个窗口,资源也已经重复。
所以恢复完成后的检查不仅是:
listenerCount=1
还包括:
activeAdapterCount=1
当前 04 先记录 listenerCount。
05 会把:
Adapter
Window
Ball
Timer
Listener
全部纳入统一资源 Registry。
第四篇先把异常重建的边界写清楚,为下一篇治理做准备。
二十七、多任务后台场景最后做了八组验收
第一组,两个任务同时存在,Registry 数量=2。
第二组,进入后台,上传进入 RUNNING_BACKGROUND。
第三组,本地压缩进入 SUSPENDED_POLICY。
第四组,后台 107 秒后上传从 36% 到 61%。
第五组,回前台压缩从 88% 继续,不生成新 taskId。
第六组,activeJob 切换 3 次,两个任务进度各自保持。
第七组,模拟 FLOAT_SURFACE_LOST,rebuildCount=1。
第八组,重建后:
listenerCount=1
position=732/128
status=RECOVERED
所有条件都满足,04 才正式结束。
二十八、这一篇最后留下的是“后台策略”和“显示恢复”两条独立链路
回头看第四篇,最重要的不是窗口异常本身。
而是把两条链彻底分开:
后台策略链:
Stage
→ BackgroundTaskPolicy
→ TaskRegistry

显示恢复链:
FLOAT_SURFACE_LOST
→ FloatRecoveryCoordinator
→ Adapter rebuild
两条链最后都读同一个 TaskRegistry,但互相不替代。
这让 QuickDock 后面即使换成:
下载
上传
视频导出
模型处理
仍然可以复用相同的窗口恢复架构。
参考资料
- HarmonyOS 7 闪控窗开发指南:https://developer.huawei.com/consumer/cn/doc/harmonyos-guides/float-view-guide
- Background Tasks Kit:https://developer.huawei.com/consumer/cn/doc/
- 常驻任务并发场景:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/resident-task-overview
- 后台视频导出最佳实践:https://developer.huawei.com/consumer/cn/doc/best-practices/bpta-video-background-export

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献230条内容

所有评论(0)