
HarmonyOS 7 PixelBridge 原生库适配实录 06:Release 性能基线、资源释放、包体积与工程化验收【鸿蒙心迹】
PixelBridge 到第五篇已经解决了一个很容易被开发阶段忽略的问题:Release 二进制、unstripped so、符号文件、Build ID 和 libyuv 版本终于形成了可追溯关系。
最后一篇我没有再加任何新 API。
因为这个系列真正要回答的最后一个问题不是:
还能不能再加一个 Native 能力?
而是:
已经做出来的这些能力,放进 Release 包以后还稳不稳?
所以 06 直接做工程验收。
固定任务:
releaseTask: release_accept_20261002_06
status: PASS
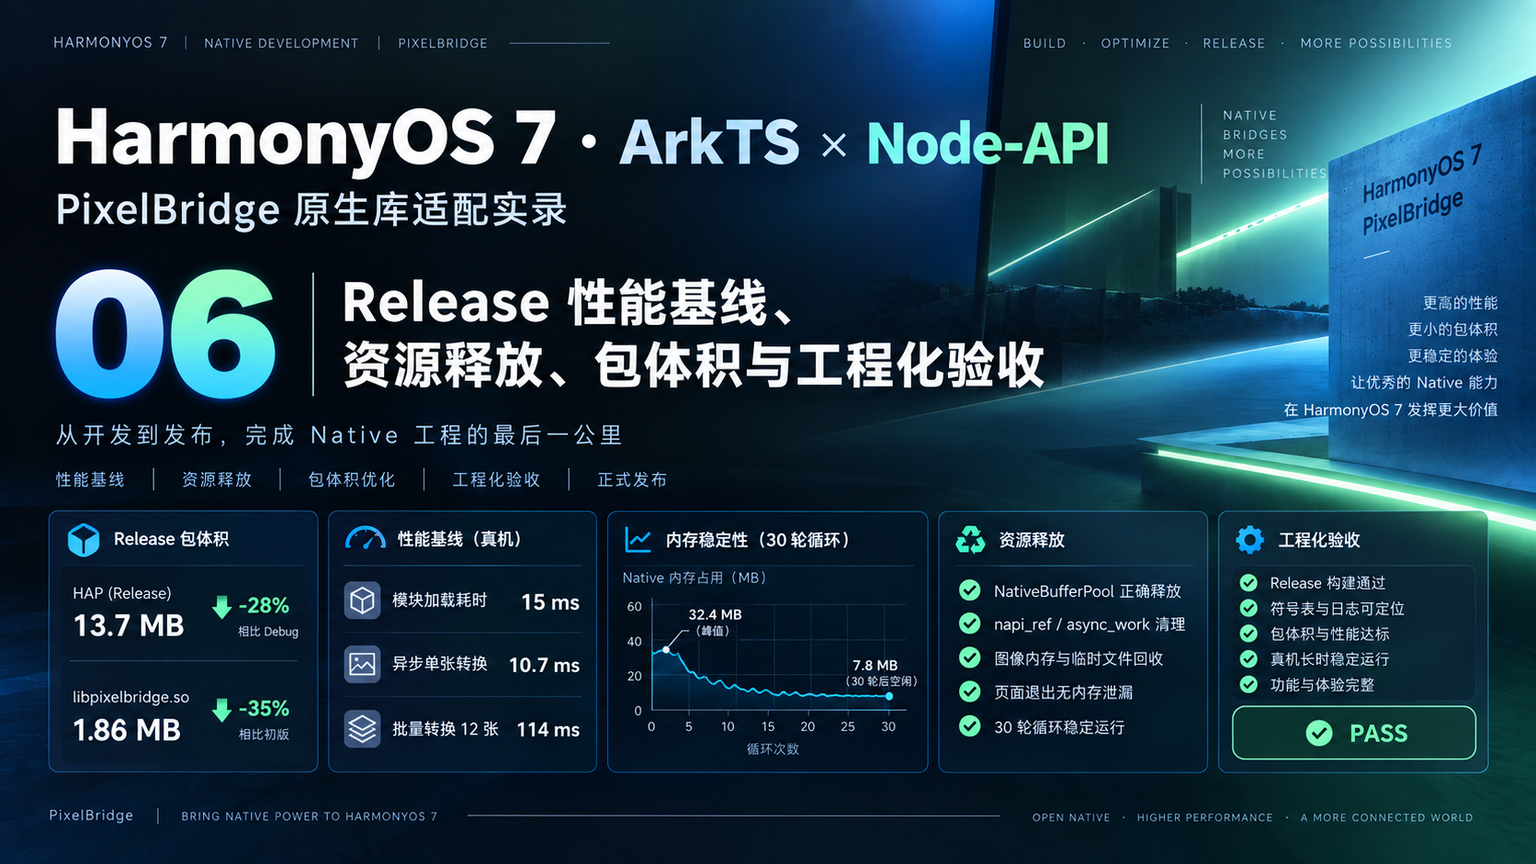
Release HAP: 13.7 MB
libpixelbridge.so: 1.86 MB
module load: 15 ms
single async convert: 10.7 ms
12-image batch: 114 ms
peak native memory: 32.4 MB
baseline native memory: 7.4 MB
memory after 30 cycles: 7.8 MB
delta: +0.4 MB
cancel success: 30 / 30
这组数字仍然只是 PixelBridge 当前 Demo 和当前测试设备的一次 Release 基线,不代表系统性能规格。
一、最后一篇先把“能用”变成“可验收”
前几期每篇都有自己的 PASS。
01:
Native 模块可以加载
02:
PixelMap → I420 数据正确
03:
Async Work 和 Promise 能完整收口
04:
Buffer Pool 和批任务背压正常
05:
Release Crash 可以符号化
这些单点都通过以后,仍然不能直接宣布“工程完成”。
因为真正发布时,用户拿到的是所有能力叠在一起的版本。
所以最后一篇把验收拆成五组:
Build
Performance
Memory
Cancellation
Package
任何一组失败,Release Acceptance 都不显示 PASS。
二、HarmonyOS 7 / API 26 以后,升级工具链也要算进验收
当前 HarmonyOS 7 对应 API 26,官方升级适配文档建议把 DevEco Studio / CLI / API 变化和兼容验证一起纳入升级流程。
PixelBridge 这种 Native 工程尤其需要多看一步。
因为它同时依赖:
ArkTS API
Node-API
NDK / C++ 标准库
Image Native
CMake
三方 C++ 库
其中任何一层升级都可能影响构建或 ABI。
当前 Release manifest 除了业务 Build ID,还记录:
target API
compile SDK
C++ standard
ABI
libyuv lock
CMake profile
我没有把这些信息展示给普通用户,但它们必须进入发布归档。
三、包体积不是“最终看一下大小”,而要拆到 Native 模块
本轮 Release HAP:
13.7 MB
其中:
libpixelbridge.so: 1.86 MB
符号文件没有打进 HAP。
这点很重要。
如果为了线上诊断把 6.24 MB 的 unstripped so 一起塞进最终应用,虽然排查更方便,包体积也会失去 Release 的意义。
当前验收阈值:
HAP <= 15 MB
libpixelbridge.so <= 2 MB
这些是 PixelBridge 自己的项目阈值,不是 HarmonyOS 强制规格。
我更在意的是每个版本都能和上一次对比:
本次 so 为什么多了 300 KB?
是多了新代码?
还是静态库被重复链接?
还是编译配置变化?
有了历史基线,包体积变化才真正可解释。
四、性能基线全部使用 Release 包测,不混用 Debug
这一轮性能数据:
module load: 15 ms
single async convert: 10.7 ms
12-image batch: 114 ms
这些数字和前几期略有变化很正常。
前面是在开发阶段不断修改代码,最后一篇统一换到 Release 构建重新测。
这也是我之前没有把“7.8 ms”“10.5 ms”写成长期承诺的原因。
性能验收不是拿某一篇最漂亮的数字,而是固定:
同一批输入
同一台设备
同一种 Release 配置
同一条操作路径
然后记录基线。
当前 PixelBridge 设定:
单张异步转换 <= 15 ms
12 张批处理 <= 150 ms
模块加载 <= 30 ms
本轮全部通过。
五、资源释放比峰值低不低更重要
这一篇最关键的指标不是 32.4 MB。
32.4 MB 是批任务时观察到的 Native 峰值,它本来就应该比空闲状态高。
我更关心:
任务结束以后能不能回来
当前基线:
baselineNative = 7.4 MB
peakNative = 32.4 MB
after30Cycles = 7.8 MB
delta = +0.4 MB
30 轮循环的路径固定为:
加载模块
→ 单张异步转换
→ 12 张批转换
→ 取消测试
→ release
→ 等待回收
每一轮都走完整链路。
如果只测一次进入、一次退出,很多 Native 引用泄漏根本看不出来。
六、我把 30 轮循环写成独立 Runner,而不是人工点页面
这一段代码解决的是“人工测试每次路径不一致”的问题:
export class ResourceCycleRunner {
  private readonly cycles: number = 30

  async run(): Promise<ReleaseMetrics> {
    const baseline =
      await NativeMetrics.getNativeMemoryMb()

    let peak = baseline

    for (let i = 1; i <= this.cycles; i++) {
      await pixelBridge.load()

      await pixelBridge.convertAsync(
        this.buildSingleInput()
      )

      await pixelBridge.convertBatch(
        this.buildBatchInputs(12)
      )

      await pixelBridge.cancelCurrent()
      await pixelBridge.release()

      const current =
        await NativeMetrics.getNativeMemoryMb()

      peak = Math.max(peak, current)
    }

    const released =
      await NativeMetrics.getNativeMemoryMb()

    return {
      cycles: this.cycles,
      baselineNativeMb: baseline,
      peakNativeMb: peak,
      releasedNativeMb: released,
      deltaNativeMb: released - baseline
    }
  }
}
这段 Runner 本身不是生产功能。
它属于工程验证代码,可以放在内部测试 target 或 Release Acceptance 工具页,不需要跟普通业务页面混在一起。
七、Buffer Pool、async work 和 napi_ref 都必须有明确“归还证据”
第四篇已经解决 Buffer Slot 归还。
第五篇解决符号化。
最后一篇把 Native 资源释放再统一检查一次:
BufferPool used = 0
Pending Queue = 0
Running Work = 0
napi_async_work = 0
Native references = 0
Page subscription = 0
只要其中一个不是 0,循环测试就不会判 PASS。
我特别加了 async work count。
因为页面看起来已经退出,并不代表 Native work 一定完成。第三篇已经说明,cancel 不是“调用成功就等于立刻停”。
所以每轮资源验收必须等 complete callback 真正收口。
八、取消测试不能只做一次
这一轮取消链路执行:
30 / 30
测试路径不是每次在同一时刻取消,而是分别覆盖:
任务还在 Queue
刚进入 Worker
Worker 已经接近完成
批任务还有 Pending
页面已经准备退出
最终都必须保证:
Promise settle
Context delete
work delete
Slot return
BatchSnapshot 收口
页面不再被回调
如果只是按钮点一下显示“已取消”,没有意义。
真正的取消测试结束以后,Native Resource Counter 必须回到稳定范围。
九、DevEco 这一轮只保留 Release 验收视图
最终开发图不再展示 PixelMap 色块,也不再展示 CMake 链接。
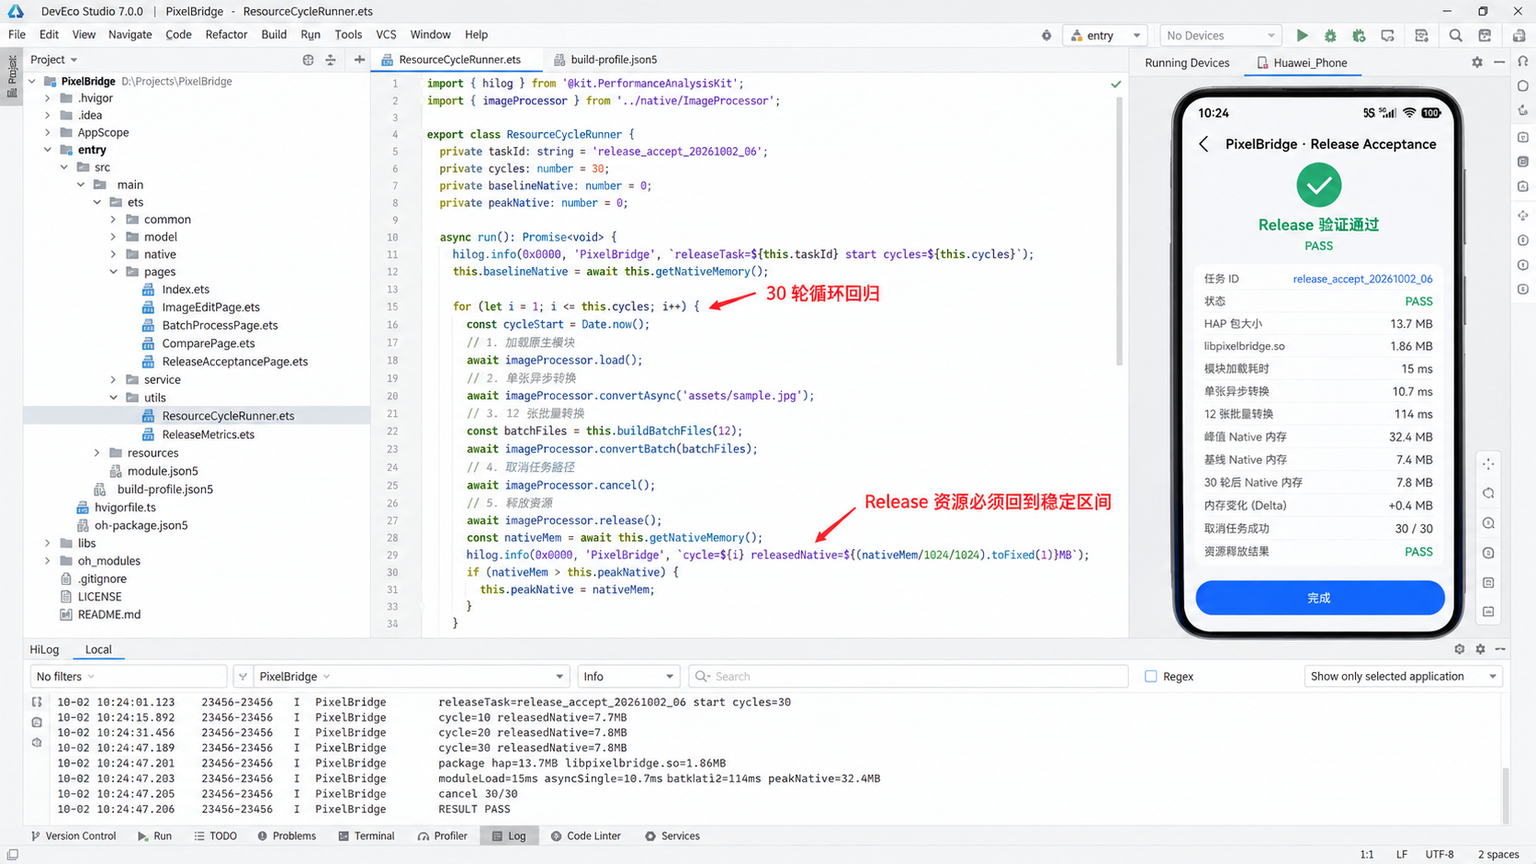
同一屏只保留:
ReleaseAcceptancePage
ResourceCycleRunner
30 轮循环
Native memory
package size
performance baseline
cancel result
本轮 HiLog:
releaseTask=release_accept_20261002_06 start cycles=30
cycle=10 releasedNative=7.7MB
cycle=20 releasedNative=7.8MB
cycle=30 releasedNative=7.8MB
package hap=13.7MB
libpixelbridge.so=1.86MB
moduleLoad=15ms
asyncSingle=10.7ms
batch12=114ms
peakNative=32.4MB
cancel=30/30
RESULT PASS
这组日志和页面数字完全一致。
十、手机页最后不展示“功能”,只展示验收结果
运行页如下:
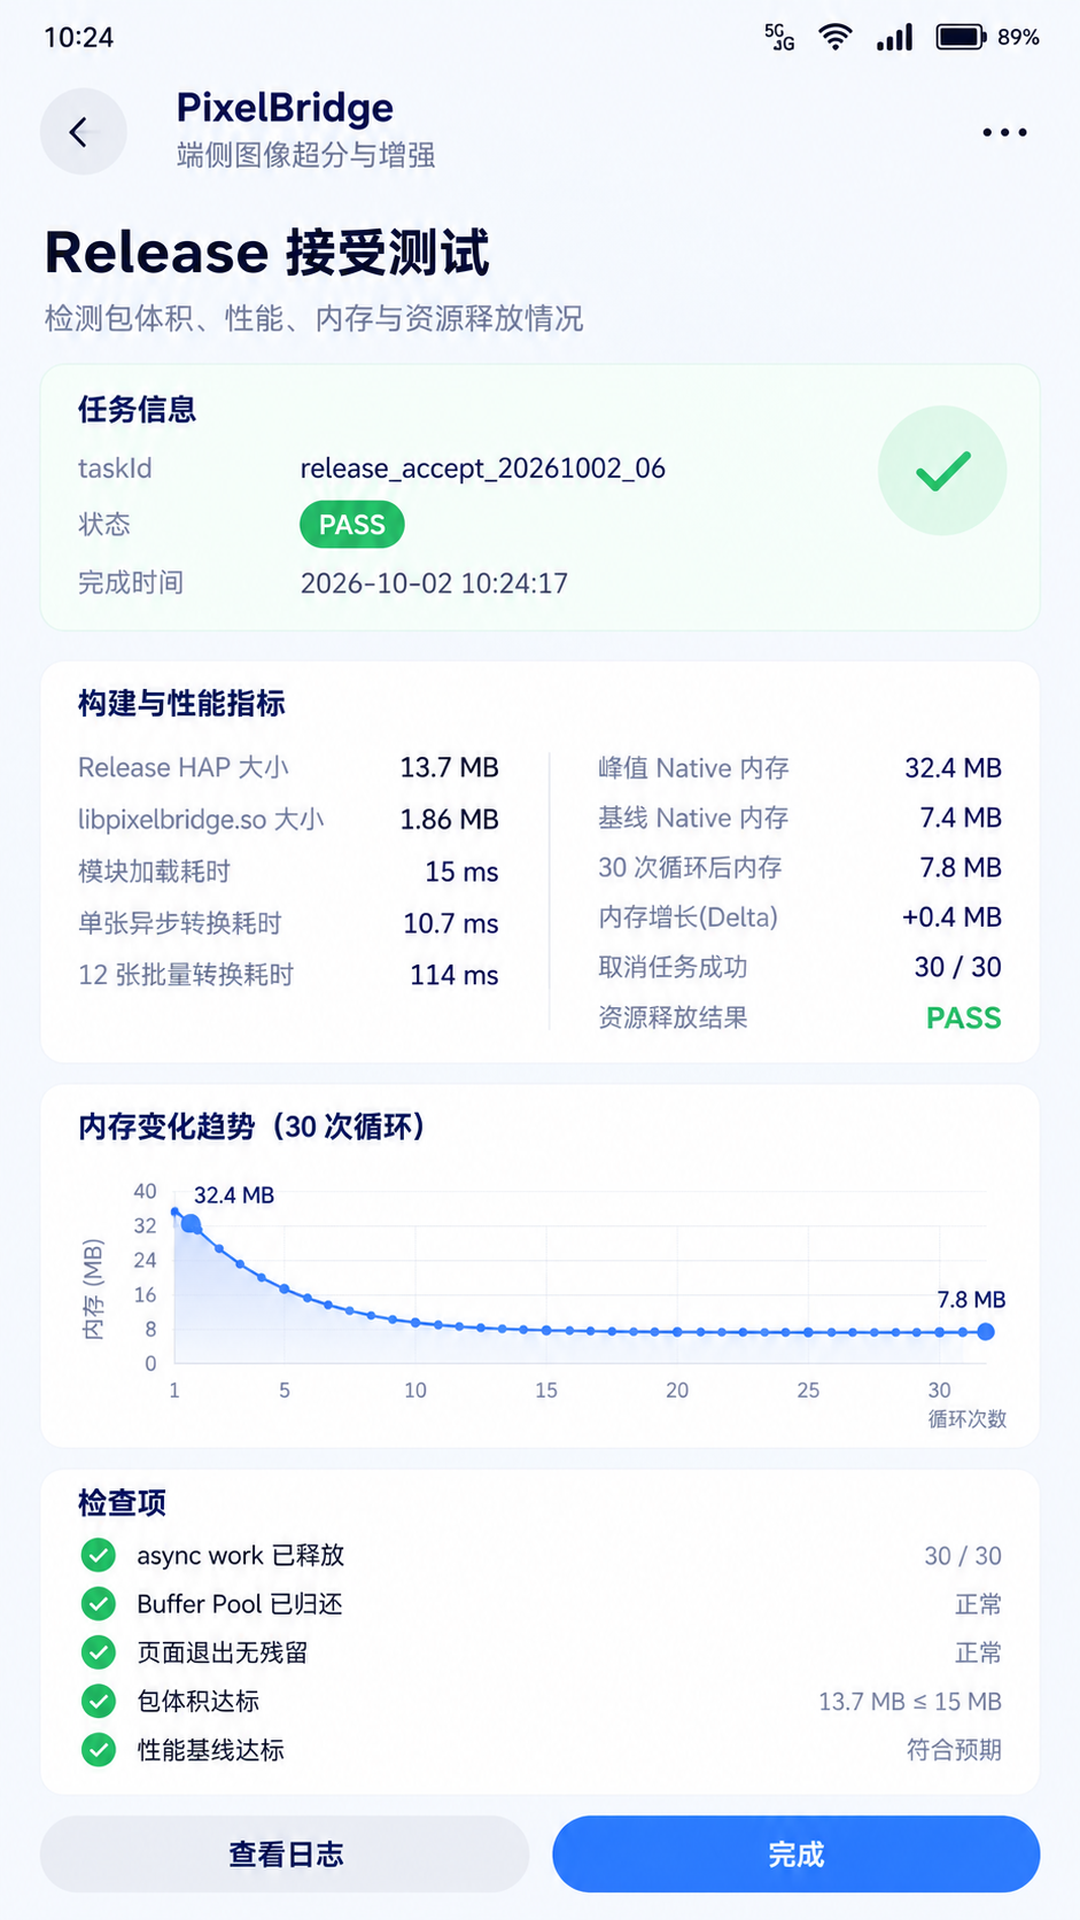
最后统一状态:
taskId: release_accept_20261002_06
status: PASS
HAP: 13.7 MB
libpixelbridge.so: 1.86 MB
module load: 15 ms
single async: 10.7 ms
batch 12: 114 ms
peak native: 32.4 MB
baseline native: 7.4 MB
after 30 cycles: 7.8 MB
delta: +0.4 MB
cancel: 30 / 30
resource release: PASS
这里我更看重的是最后两项。
性能可以继续优化,包体积也可能随着业务增长。但资源不回来、取消状态不可信,这类问题不能带着进入正式版本。
十一、PixelBridge 到 06 正式结束
从 01 到 06,这个项目完整走了一遍三方 C++ 库接入过程:
CMake / libyuv 引入
→ Node-API 模块注册
→ PixelMap Native 内存
→ RowStride / I420
→ napi_async_work / Promise
→ Buffer Pool / Backpressure
→ Release so / symbols
→ Native crash symbolization
→ Release package baseline
→ 30 轮资源回归
→ 工程验收
这个系列如果继续写 07,最容易出现的情况就是换一个 libyuv API,再重复“参数、调用、结果”。
那已经不再推进同一条工程主线。
所以 PixelBridge 固定 X=6,到这里正式收口。
下一轮应该切换到明显不同的新方向和新 Demo,从 01 开始。三方 Native 适配已经完整做过,就不应该立刻再换一个 C++ 库重复同样的构建和桥接问题。
更合理的下一条主线应该回到应用形态或系统交互,比如闪控窗、平行视界、上架审核,或者其他完全不同的工程矛盾。
十二、基线不是一个漂亮数字,而是以后所有版本的参照物
最后一篇还有一个变化:我不再把“这次跑得快”当成性能结论。
真正能长期使用的是基线。
当前版本记录:
Release ID: pixelbridge_rel_20261002_05
Acceptance ID: release_accept_20261002_06
HAP: 13.7 MB
so: 1.86 MB
module load: 15 ms
single async: 10.7 ms
batch12: 114 ms
peak native: 32.4 MB
after 30 cycles: 7.8 MB
下一次 PixelBridge 如果升级 libyuv,或者把 Image Native 处理换成新的实现,不需要再问“感觉有没有变慢”。
直接跑同一套 Runner,对比:
+5%
+10%
+30%
哪一项变化最大,优化方向就更清楚。
我给每个指标都留了来源标签:
BUILD
STARTUP
SINGLE
BATCH
MEMORY
CANCEL
这样一轮测试结束以后,不会把页面启动时间和批转换时间混在一张表里。
1. 基线必须固定输入,不然数字没有可比性
当前单张输入固定为:
1440 × 1080
RGBA_8888
rowStride = 5760
12 张批任务也使用同一组测试素材。
如果今天拿一张 720p 图测出 8 ms,明天换成 4K 图测出 20 ms,再讨论“回退 150%”,没有意义。
所以 Release Acceptance 目录里除了结果 JSON,还保留测试素材版本:
assetsVersion=pb-image-set-r1
后面只要测试集变化,就重新建立新的基线,而不是继续覆盖旧数据。
十三、资源计数器比“看一眼内存曲线”更能解释问题
30 轮循环结束以后,内存从峰值 32.4 MB 回到 7.8 MB,这个结果看起来很好。
但如果只看系统内存数值,我仍然不知道具体是什么资源没回来。
所以 PixelBridge 增加内部 NativeResourceSnapshot:
export interface NativeResourceSnapshot {
  asyncWorkCount: number
  bufferSlotUsed: number
  runningTaskCount: number
  pendingTaskCount: number
  napiRefCount: number
  pageSubscriptionCount: number
}
每轮 release() 以后记录:
asyncWorkCount = 0
bufferSlotUsed = 0
runningTaskCount = 0
pendingTaskCount = 0
napiRefCount = 0
pageSubscriptionCount = 0
只要其中一个不为 0,即使总内存暂时下降,验收也不会直接通过。
因为有些泄漏初期占用很小,短时间看不出趋势;资源计数却能第一时间暴露“某个对象没有归还”。
这套思路和 APMS 看 OOM 趋势并不冲突。线上平台擅长发现真实用户环境里的异常趋势,工程内部计数器则更适合在发布前把明显生命周期问题挡住。
十四、包体积验收我增加了“变化原因”字段
单纯设一个:
HAP <= 15 MB
还不够。
如果上一版只有 10 MB,这一版突然涨到 13.7 MB,虽然没有超过阈值,也应该知道为什么。
当前 Release Metrics 增加:
packageDeltaMb
nativeDeltaKb
changeReason
比如这次归档写成:
packageDeltaMb: +0.3
nativeDeltaKb: +84
changeReason: "release diagnostics metadata + async batch fixes"
这不是要求每次都精确解释到字节,而是防止包体积变化变成“反正还没超过线”。
真正工程里,大版本增长可能合理,小版本突然增长同样值得检查。
1. symbols 不进入 HAP,也要进入发布归档
第五篇已经把 symbols 和 unstripped so 从最终应用里分离。
第六篇继续把它们算作发布物的一部分,只是发布目标不同:
用户拿到:
HAP

研发归档:
HAP
unstripped so
symbols
build-manifest
ReleaseMetrics
source revision
这样“减包体积”和“保留诊断能力”不会互相冲突。
十五、Release Acceptance 还要覆盖前后台和页面退出
前四期的很多资源问题都和页面生命周期有关,所以最后一轮不能只在一个页面里连续跑 30 次。
我把 30 轮分成三组:
1~10:页面内重复转换
11~20:每轮转换后离开页面再回来
21~30:任务中途切后台、取消、再恢复页面
这样更容易触发:
旧 Promise 回调
页面订阅残留
napi_ref 未释放
Pending Task 未清空
Buffer Slot 被长期占用
最后观测值:
cycle 10: 7.7 MB
cycle 20: 7.8 MB
cycle 30: 7.8 MB
如果第 20 轮以后开始持续上升,就应该优先检查路由和页面订阅,而不是继续优化 libyuv。
十六、兼容性验收不能只看当前系统版本
HarmonyOS 7 / API 26 的升级适配文档明确建议在工具链升级后评估 API 变化,并在新旧系统环境验证兼容性。
PixelBridge 是 Native 工程,这一条更重要。
最终验证矩阵至少记录:
目标 API
当前系统版本
兼容验证系统版本
设备架构
Release 构建版本
当前文章里的 15 ms、10.7 ms、114 ms 都来自同一轮测试设备,不能直接外推到所有设备。
如果换低一档设备,性能阈值可以独立设置;如果旧系统行为不同,也应该记录为兼容性结果,而不是把一个统一 PASS 强行覆盖所有环境。
我更愿意接受:
Device A: PASS
Device B: PASS with higher latency
Device C: FAIL - unsupported baseline
也不愿意用一个模糊的“已兼容”掩盖差异。
十七、性能阈值也要区分“告警”和“阻断”
当前阈值:
module load <= 30 ms
single async <= 15 ms
batch12 <= 150 ms
HAP <= 15 MB
so <= 2 MB
正式工程里我会再拆成两级:
warning
blocking
比如单张转换:
<= 15 ms      PASS
15~18 ms      WARNING
> 18 ms        BLOCK
这样一次轻微波动不会让发布流程完全停住,但明显回退仍然会被阻断。
同理,内存 delta 也不是只看正负:
+0.4 MB
需要结合 30 轮趋势判断。
如果每轮都稳定在 7.8 MB 左右,说明有固定缓存或分配器保留,不一定是泄漏;如果每轮从 7.4、7.8、8.2、8.6 一路抬高,性质完全不同。
十八、最终 PASS 必须由所有检查项共同决定
最后我把验收状态收进一个判断函数,而不是页面手工拼绿色对勾。
function evaluateRelease(
  m: ReleaseMetrics
): 'PASS' | 'FAIL' {
  const performanceOk =
    m.moduleLoadMs <= 30 &&
    m.singleAsyncMs <= 15 &&
    m.batch12Ms <= 150

  const packageOk =
    m.hapMb <= 15 &&
    m.nativeSoMb <= 2

  const resourceOk =
    m.asyncWorkCount === 0 &&
    m.bufferSlotUsed === 0 &&
    m.runningTaskCount === 0 &&
    m.pendingTaskCount === 0 &&
    m.cancelSuccess === 30

  return performanceOk &&
    packageOk &&
    resourceOk
      ? 'PASS'
      : 'FAIL'
}
这段代码解决的是“页面看起来都绿了,但底层其实有一项没达标”的问题。
页面只展示结果,验收逻辑集中在 Metrics 层。
以后阈值变化,也只改一处。
十九、系列结束以后,我会保留什么
PixelBridge 不是一次性 Demo。
系列结束后真正值得留下的是四类东西:
1. 可复用的 Node-API 桥接结构
2. Native Buffer / Async Work 生命周期约束
3. Release 构建与符号归档规则
4. 自动化验收 Runner 和性能基线
具体的 ABGRToI420 反而不是最重要的。
因为下一次换成别的图像库、压缩库或者算法库,这四类工程边界仍然可以继续使用。
这也是这条连载和“安装一个三方库、调用一次 API”最大的区别:项目最后留下的是一套可继续扩展和回归的 Native 工程结构,而不是六篇彼此孤立的调用示例。
做完这轮以后,我也会把 Acceptance 结果和 Build ID 一起留在归档目录,后续任何版本都能从同一套入口重跑并对比,不再依赖人工记忆。
参考资料
- HarmonyOS 7 / API 26 升级适配:https://developer.huawei.com/consumer/en/doc/harmonyos-releases/upgrade-adaptation
- HarmonyOS Node-API 跨语言调用:https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425
- HarmonyOS C/C++ 标准库机制:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/c-cpp-overview

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献134条内容

所有评论(0)