
HarmonyOS 7 PixelBridge 原生库适配实录 03:Node-API Async Work、Promise 与页面退出后的任务收口【鸿蒙心迹】
前两期把 PixelBridge 的基础桥接和真实像素布局都跑通了。到第二期结束时,1440 × 1080 的 RGBA_8888 PixelMap 已经可以安全进入 C++,rowStride=5760,libyuv 的 ABGRToI420 单次转换耗时约 7.8 ms。
单次测试看起来没什么压力,真正把入口放回页面以后,问题很快暴露出来:点击“转换”时,页面偶尔会有一小下不跟手。把图像换成更大尺寸以后更明显。
这次没有继续优化 libyuv 本身,而是先把执行模型改掉。
目标很明确:
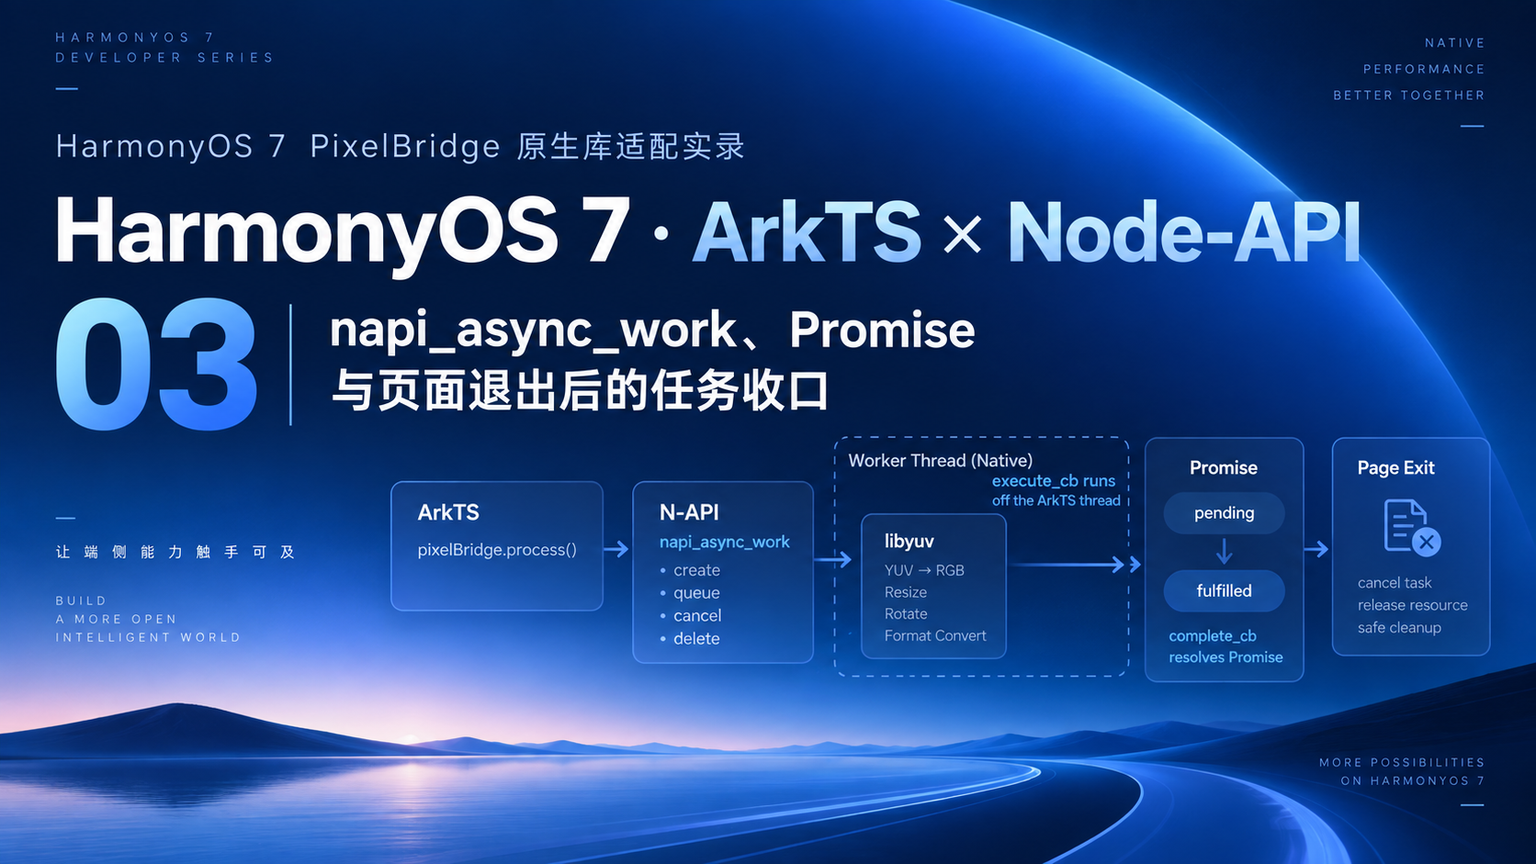
ArkTS 发起任务
→ Native 读取 PixelMap 元数据和像素
→ napi_async_work 进入工作线程
→ libyuv 在 execute_cb 执行
→ complete_cb 回到 ArkTS 线程
→ Promise resolve / reject
→ 统一释放 async work
本轮主任务固定为 async_convert_20261002_03。输入仍然沿用上一期 1440 × 1080 RGBA_8888,这样可以直接比较同步版和异步版,而不是一边改执行模型、一边换测试素材。
最终这轮的数据是:Native 前置准备 2.3 ms,工作线程转换 7.9 ms,complete 收尾 0.3 ms,总耗时 10.5 ms。总时间并没有神奇变短,但页面调用线程的连续占用从原来的约 10 ms 降到了 2.4 ms 左右。
一、异步化不是为了让 libyuv 算得更快
刚开始我也下意识盯着“7.8 ms 能不能变成 4 ms”。
后来实际测下来,换成 napi_async_work 后,libyuv 还是做同一份像素转换,worker 侧耗时甚至会在 7.6~8.3 ms 之间波动。这个结果很正常。
这一轮真正改变的是:
同步版:
ArkTS 调用线程
  └─ 读取像素 + libyuv + 构造返回值
     全部结束后页面继续

异步版:
ArkTS 调用线程
  └─ 读取元数据 / 准备纯 Native 输入
     └─ queue async work
        └─ 页面继续
Worker:
  └─ libyuv 转换
Complete:
  └─ resolve Promise
也就是说,优化目标是把 CPU 密集型转换移出原始 ArkTS 调用线程,而不是让同一个算法凭空提速。
HarmonyOS 当前 Node-API 异步工作项的官方说明也强调了这一点:execute_cb 在独立工作线程执行,不是在原始 ArkTS 线程;complete_cb 在执行结束后负责收口。这个模型非常适合 PixelBridge 这种纯 C/C++ 计算任务。
二、最重要的限制:execute_cb 里不要碰 napi_value
这一点我专门放在实现之前。
napi_async_work 的 execute_cb 运行在线程池工作线程。官方文档明确提醒,这里不能拿原始 env 去构造 napi_value。
这意味着我不能写成:
execute_cb
→ 继续从 PixelMap 的 napi_value 里取属性
→ 创建 ArkTS 对象
→ 返回结果
所以第三篇把数据边界重新切了一次。
Native 方法刚被调用时,仍然在原始 NAPI 调用上下文里,这时完成三件事:
1. 从 napi_value 得到 OH_PixelmapNative
2. 读取 width / height / pixelFormat / rowStride
3. 把像素复制进纯 C++ buffer
完成后,worker 只拿:
std::vector<uint8_t> rgba;
uint32_t width;
uint32_t height;
uint32_t rowStride;
这些不依赖 ArkTS Runtime 的普通 C++ 数据。
这也是为什么异步版页面占用仍然有 2.3 ms 左右:PixelMap 到纯 Native buffer 的准备动作还发生在排队之前。后面如果继续优化零拷贝,还得再处理 PixelMap 生命周期和 Native Buffer,这不是这一期顺手就能“省掉”的成本。
三、AsyncContext 变成这一期真正的任务对象
同步方法里,局部变量跟着函数返回就结束了。
异步以后,任务跨越了三个阶段:创建、worker、complete。用散落的指针会很快失控,所以我新增 AsyncConvertContext:
struct AsyncConvertContext {
    napi_env env = nullptr;
    napi_async_work work = nullptr;
    napi_deferred deferred = nullptr;

    std::string taskId;
    uint32_t width = 0;
    uint32_t height = 0;
    uint32_t rowStride = 0;

    std::vector<uint8_t> rgba;
    std::vector<uint8_t> y;
    std::vector<uint8_t> u;
    std::vector<uint8_t> v;

    double prepareCostMs = 0;
    double workerCostMs = 0;
    bool cancelled = false;
    int convertCode = 0;
};
这段结构解决的不是“怎么存变量”,而是把一次异步调用所拥有的资源放到同一个生命周期里。
谁创建它、谁在 complete 阶段 delete,它有明确边界。
这里没有保存页面对象,也没有保存 ArkTS 回调函数。当前接口使用 Promise,页面只持有 Promise,不让 Native Context 反向长期持有 ArkUI 对象。
四、创建 Promise 和 async work 时,失败路径必须从一开始就写
这一段代码解决的是“异步任务还没入队就失败时,Context 被漏掉”的问题:
napi_value ConvertPixelMapAsync(
    napi_env env,
    napi_callback_info info)
{
    auto* ctx = new AsyncConvertContext();
    ctx->env = env;
    ctx->taskId = "async_convert_20261002_03";

    napi_value promise = nullptr;
    if (napi_create_promise(
            env,
            &ctx->deferred,
            &promise) != napi_ok) {
        delete ctx;
        return nullptr;
    }

    if (!PreparePixelInput(env, info, *ctx)) {
        RejectImmediately(env, ctx->deferred, "PREPARE_FAILED");
        delete ctx;
        return promise;
    }

    napi_value resourceName = nullptr;
    napi_create_string_utf8(
        env,
        "PixelBridgeConvert",
        NAPI_AUTO_LENGTH,
        &resourceName
    );

    napi_status status = napi_create_async_work(
        env,
        nullptr,
        resourceName,
        ExecuteConvert,
        CompleteConvert,
        ctx,
        &ctx->work
    );

    if (status != napi_ok) {
        RejectImmediately(env, ctx->deferred, "ASYNC_CREATE_FAILED");
        delete ctx;
        return promise;
    }

    status = napi_queue_async_work(env, ctx->work);
    if (status != napi_ok) {
        napi_delete_async_work(env, ctx->work);
        RejectImmediately(env, ctx->deferred, "ASYNC_QUEUE_FAILED");
        delete ctx;
    }

    return promise;
}
这里有一个很容易忽略的地方:napi_create_promise() 成功以后,即使后面创建 async work 失败,也应该把 Promise 明确 reject,而不是返回一个永远 pending 的 Promise。
页面如果只写 .then() 不写 .catch() 当然也有问题,但 Native 侧不能因此把失败状态吞掉。
五、execute_cb 只做纯计算
真正的 libyuv 逻辑放到 worker:
static void ExecuteConvert(
    napi_env env,
    void* data)
{
    auto* ctx =
        static_cast<AsyncConvertContext*>(data);

    if (ctx == nullptr || ctx->cancelled) {
        return;
    }

    const auto begin =
        std::chrono::steady_clock::now();

    const int uvWidth =
        static_cast<int>((ctx->width + 1) / 2);
    const int uvHeight =
        static_cast<int>((ctx->height + 1) / 2);

    ctx->y.resize(ctx->width * ctx->height);
    ctx->u.resize(uvWidth * uvHeight);
    ctx->v.resize(uvWidth * uvHeight);

    ctx->convertCode = libyuv::ABGRToI420(
        ctx->rgba.data(),
        static_cast<int>(ctx->rowStride),
        ctx->y.data(),
        static_cast<int>(ctx->width),
        ctx->u.data(),
        uvWidth,
        ctx->v.data(),
        uvWidth,
        static_cast<int>(ctx->width),
        static_cast<int>(ctx->height)
    );

    const auto end =
        std::chrono::steady_clock::now();

    ctx->workerCostMs =
        ToMilliseconds(end - begin);
}
env 参数虽然会传进 execute callback,但这一段完全不使用它。
这不是“代码风格偏好”,而是线程模型决定的边界。
worker 里只允许纯 C/C++ 数据和线程安全逻辑。等它结束,再由 complete callback 把结果包装回 Promise。
六、complete_cb 才做 Promise resolve,并且只释放一次 work
HarmonyOS 当前 Node-API 异步任务指导里还有一个很重要的点:napi_async_work 建议单次使用,queue 以后需要在 complete 回调执行时或之后调用 napi_delete_async_work(),而且同一个 work 只能释放一次。
PixelBridge 把这一条写死进 Complete:
static void CompleteConvert(
    napi_env env,
    napi_status status,
    void* data)
{
    auto* ctx =
        static_cast<AsyncConvertContext*>(data);

    if (ctx == nullptr) {
        return;
    }

    if (status == napi_cancelled ||
        ctx->cancelled) {
        RejectConvert(
            env,
            ctx->deferred,
            "TASK_CANCELLED"
        );
    } else if (
        status != napi_ok ||
        ctx->convertCode != 0) {
        RejectConvert(
            env,
            ctx->deferred,
            "CONVERT_FAILED"
        );
    } else {
        napi_value result =
            BuildResultObject(env, *ctx);

        napi_resolve_deferred(
            env,
            ctx->deferred,
            result
        );
    }

    napi_delete_async_work(
        env,
        ctx->work
    );

    delete ctx;
}
这一段结束以后,任务才真正从 Native 世界里消失。
我没有在 ArkTS .finally() 里再调用一次 Native release。work 是 Native 创建的,也由 Native Complete 自己释放;ArkTS 管的是业务任务状态,不应该重复管理底层对象。
七、页面退出并不等于 worker 一定能立刻取消
这一轮另一个容易误解的点是 napi_cancel_async_work()。
官方文档明确提醒:调用取消接口时,即使底层 libuv 取消失败,也可能返回 napi_ok;最终仍然要看 complete callback 的 status。
也就是说,不能写:
cancel() 返回 napi_ok
= 任务已经停止
PixelBridge 当前的取消语义是:
用户离开页面
→ TaskRegistry 标记 cancelRequested
→ 尝试 napi_cancel_async_work
→ complete 根据 status 收口
→ 页面不再接受这次结果
如果 worker 已经开始执行,取消不一定能中途掐断 libyuv。当前任务只有 7~8 ms,强行在 C 函数中间做可中断并没有意义。
所以页面退出后的核心目标不是“让 CPU 在 0.1 ms 内立刻停”,而是:
- 后续结果不能再写进已经销毁的页面;
- Promise 必须最终 settle;
- work 必须只释放一次;
- Context 里的 Buffer 必须回收;
- 日志能区分正常完成和用户取消。
八、ArkTS 这一侧终于可以写成真正的异步调用
第三篇更新了 index.d.ts:
export interface AsyncConvertResult {
  taskId: string
  width: number
  height: number
  inputBytes: number
  outputBytes: number
  prepareCostMs: number
  workerCostMs: number
  totalCostMs: number
  state: 'RESOLVED'
}

export const convertPixelMapAsync:
  (pixelMap: image.PixelMap) =>
    Promise<AsyncConvertResult>

export const cancelConvert:
  (taskId: string) => boolean
页面层不再关心 Native work 句柄:
private disposed: boolean = false
private taskId: string = ''

async runConvert(): Promise<void> {
  this.state = 'QUEUED'

  try {
    const result =
      await pixelBridge.convertPixelMapAsync(
        this.pixelMap
      )

    if (this.disposed) {
      return
    }

    this.taskId = result.taskId
    this.workerCost = result.workerCostMs
    this.totalCost = result.totalCostMs
    this.state = 'RESOLVED'
  } catch (err) {
    if (!this.disposed) {
      this.state = 'FAILED'
    }
  }
}

aboutToDisappear(): void {
  this.disposed = true

  if (this.taskId.length > 0) {
    pixelBridge.cancelConvert(this.taskId)
  }
}
这里 disposed 仍然保留。
因为取消不是百分之百即时成功,页面退出后即使 Promise 过一会儿 resolve,也不能继续改一个已经不需要展示的页面状态。
九、这一轮 DevEco 里我盯的是线程边界
调试图里统一使用:
taskId=async_convert_20261002_03
input=1440×1080 RGBA_8888
rowStride=5760
prepare=2.3ms
worker=7.9ms
complete=0.3ms
total=10.5ms
uiBlocked=2.4ms
state=RESOLVED
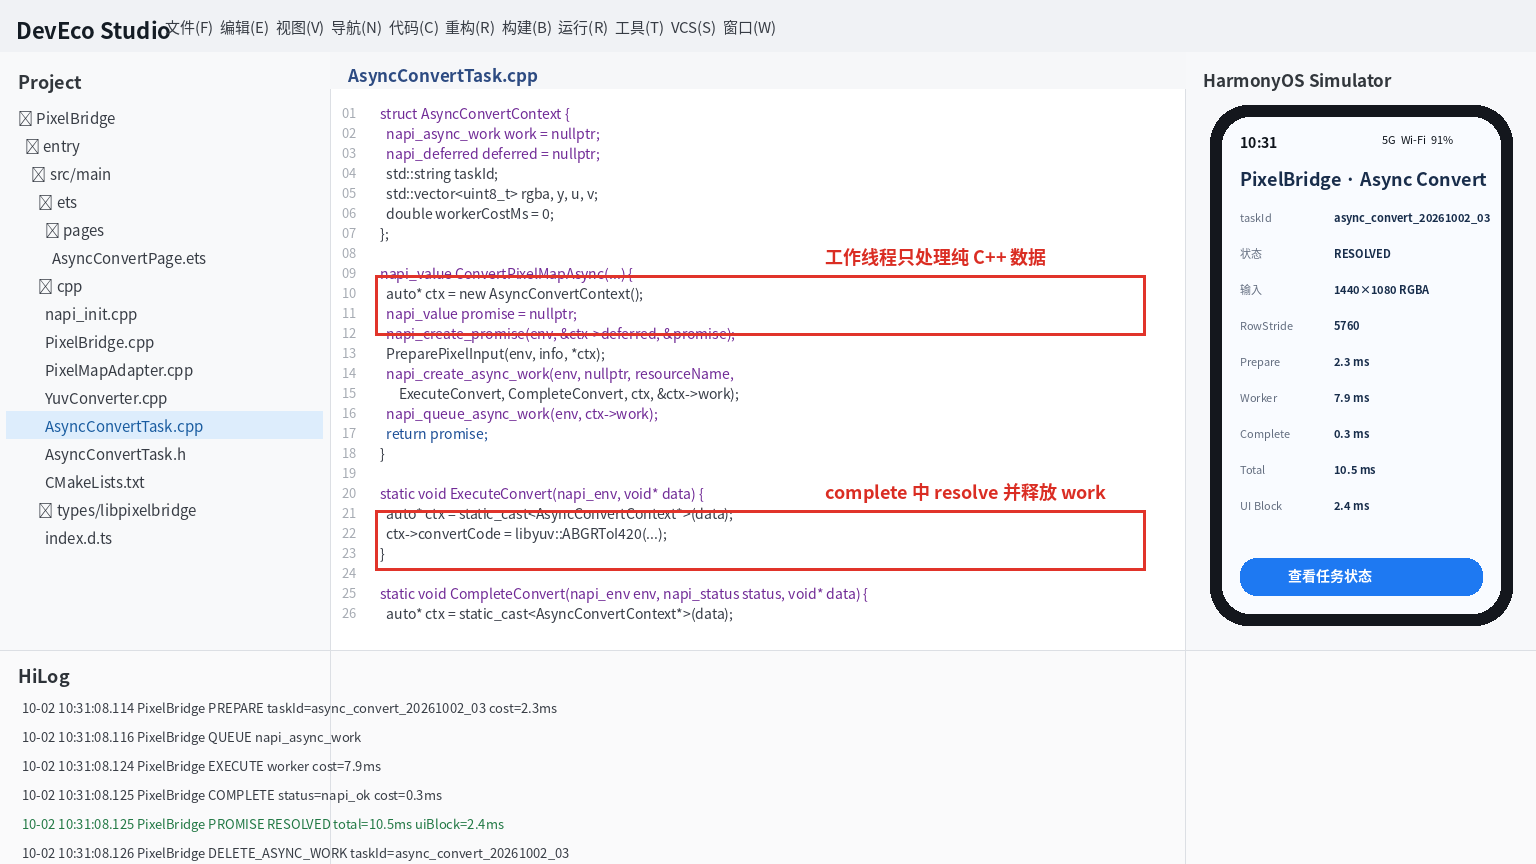
HiLog 我刻意把阶段拆开:
PREPARE thread=ArkTS
QUEUE
EXECUTE thread=worker
COMPLETE status=napi_ok
PROMISE RESOLVED
DELETE_ASYNC_WORK
只看一个 total cost 看不出异步化有没有意义。
现在即使总耗时比同步版多出零点几毫秒,也能看到页面连续占用明显下降,这才是这一轮想解决的问题。
十、手机运行页不再只显示“耗时”
最终运行状态如下:
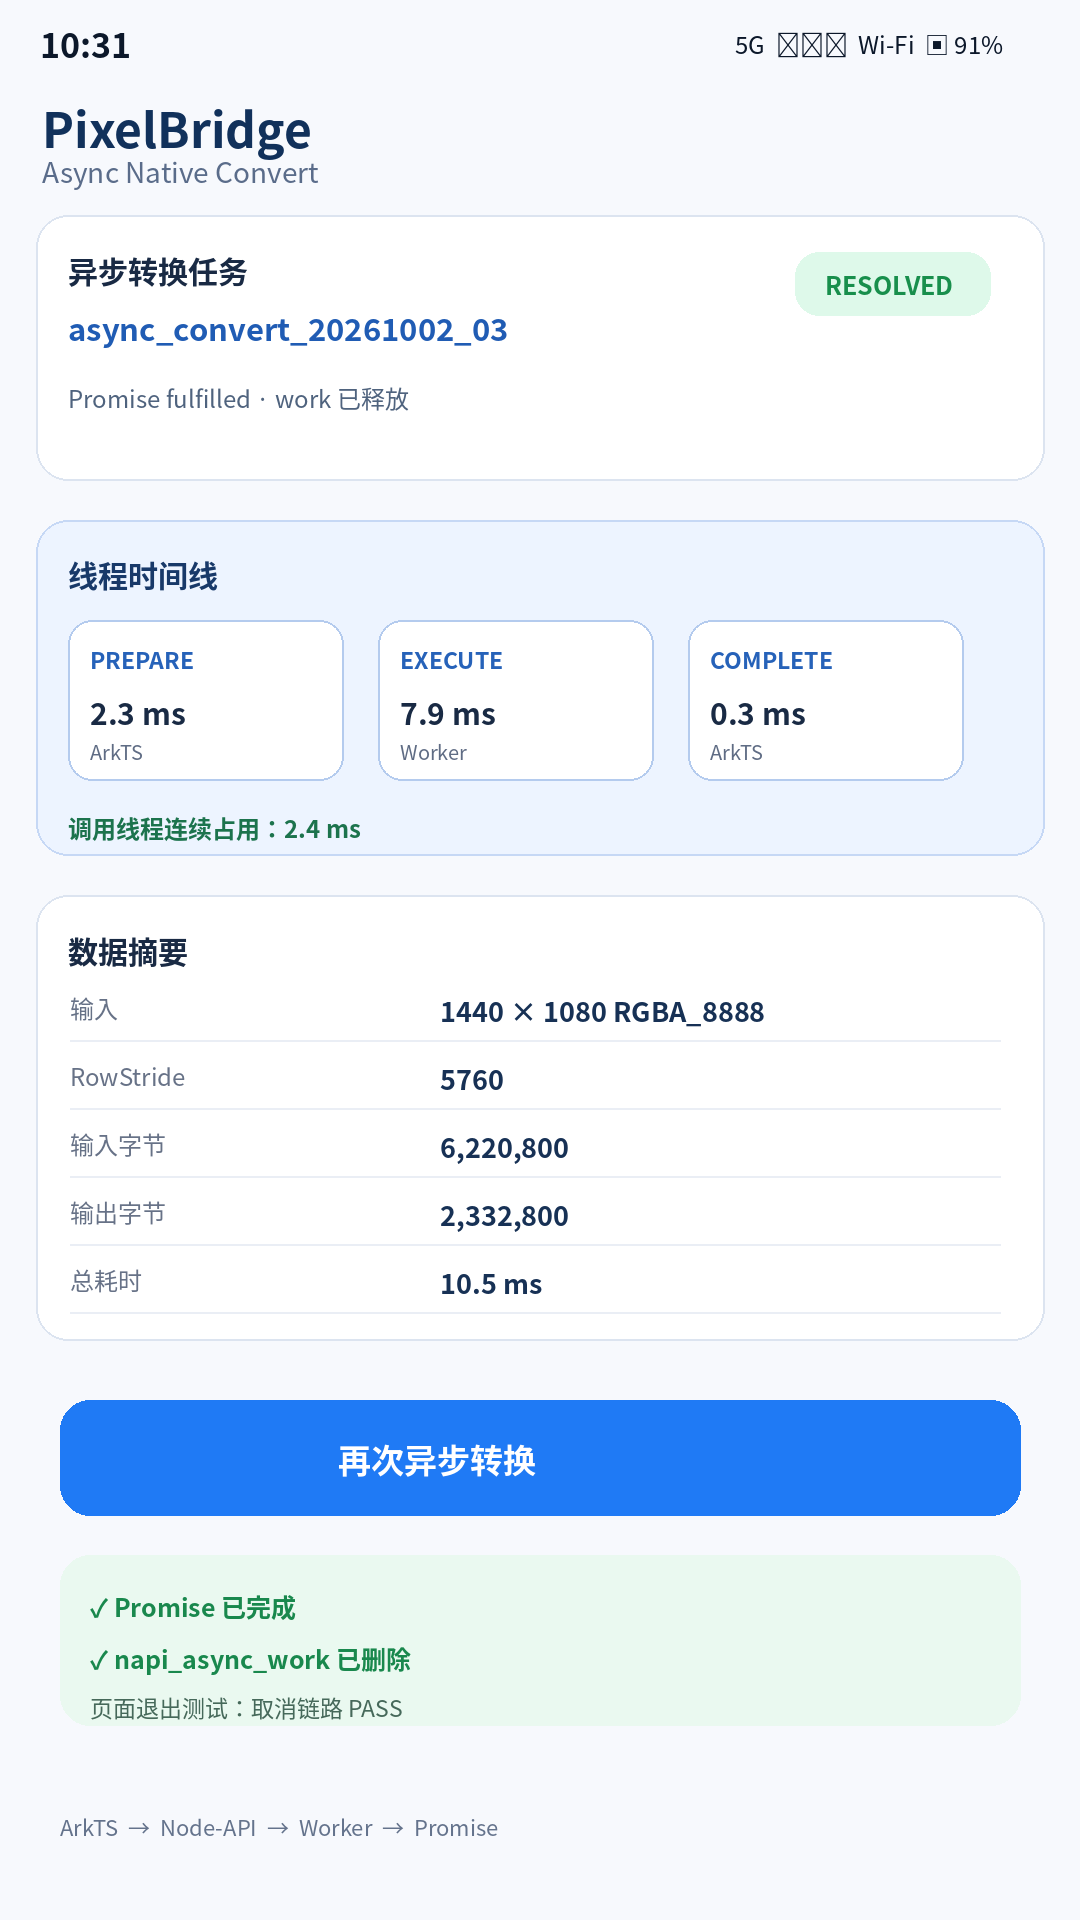
页面固定显示:
taskId: async_convert_20261002_03
status: RESOLVED
input: 1440 × 1080 RGBA_8888
rowStride: 5760
prepare: 2.3 ms
worker: 7.9 ms
complete: 0.3 ms
total: 10.5 ms
UI blocked: 2.4 ms
Promise: fulfilled
这次没有继续展示 Y/U/V 平面,因为第二篇已经验证过像素布局。
第三篇真正新增的是“任务从页面线程出去以后,怎么完整回来”。
单张图异步化以后,下一步自然会遇到更现实的问题:用户一次选择 12 张图片怎么办?
如果每张图都各自 new std::vector、各自 queue 一个 work,内存峰值和线程池竞争很快会比同步版更难看。
所以下一篇不会换 Demo,而是在 PixelBridge 里继续加 NativeBufferPool + BatchConvertQueue,把并发、队列上限、背压和批量取消统一起来。
十一、异步以后,日志顺序会比同步版本更“乱”
同步调用里,日志天然按照代码顺序出现:
prepare
convert
return
异步版本不是这样。页面可以连续启动两个不同任务,A 先 queue,B 后 queue,但两个 execute_cb 进入线程池以后,谁先结束并没有天然保证。官方文档也明确说明,不同 napi_async_work 的 execute callback 不保证顺序。
这对 PixelBridge 有两个直接影响。
第一,HiLog 里每一行必须带 taskId。没有 taskId 时,只看到两组 EXECUTE 和两组 COMPLETE,很难知道哪一次转换对应哪一次 Promise。
第二,业务上需要顺序时,不能因为“我先调用 A”就默认 A 一定先完成。相册批处理后面如果需要按用户选图顺序写结果,应该在 Batch 层重新排序,而不是依赖线程池完成顺序。
当前单任务页面暂时看不出这个问题,所以我额外做了 20 次连续提交测试。日志确实会出现后提交的短任务先 complete。这个结果反而让我确认了设计方向:Native work 负责执行,业务顺序由上层状态机管理。
十二、Promise settle 之后,页面还需要防重复消费
第三篇里 Promise 最终只有两种结果:
fulfilled
rejected
理论上一个 Promise 只会 settle 一次,但业务层仍然可能因为页面重建重复订阅同一个任务。
我在 ArkTS 侧没有把 Promise 本身放进 @State,而是让 AsyncConvertStore 保存纯数据快照:
export interface AsyncTaskSnapshot {
  taskId: string
  state: 'QUEUED' | 'RUNNING' | 'RESOLVED' | 'FAILED' | 'CANCELLED'
  workerCostMs: number
  totalCostMs: number
  updatedAt: number
}
页面重新出现时先读 Snapshot,而不是重新触发转换。
这个变化看起来和 Node-API 没关系,实际是异步任务一旦跨过页面生命周期后必须面对的问题。任务可以比页面活得久,页面也可能比一次任务活得久,两者不能再假设一一对应。
我专门测了一个场景:启动转换后立刻切到另一个页面,200 ms 后再回来。此时 Native work 早就结束,页面应该直接拿到 RESOLVED 快照,而不是再提交一次 async_convert_20261002_03。
十三、错误信息分层以后,定位速度快很多
同步版本失败时我只抛 CONVERT_FAILED,够简单,也够模糊。
异步链路多了一层以后,我把错误分成:
PREPARE_FAILED
ASYNC_CREATE_FAILED
ASYNC_QUEUE_FAILED
WORKER_CONVERT_FAILED
TASK_CANCELLED
COMPLETE_BUILD_RESULT_FAILED
不是为了把错误码数量做大,而是每一类对应完全不同的排查方向。
PREPARE_FAILED 先看 PixelMap 和 stride;ASYNC_QUEUE_FAILED 看 Node-API work 创建和运行时;WORKER_CONVERT_FAILED 才回到 libyuv;COMPLETE_BUILD_RESULT_FAILED 则说明 C++ 计算可能已经成功,只是返回 ArkTS 的对象构造出了问题。
实际开发里最浪费时间的情况,就是 Native 日志只留一句 failed。第三篇把阶段日志固定下来以后,即使没有调试器,也能从一组 HiLog 还原任务走到哪一步。
十四、这一期的验收,我不再用“页面不卡”这种主观判断
最终我给异步化设了六条可量化条件:
- 输入和第二篇保持完全一致,避免测试样本变化;
- worker 侧 libyuv 转换结果仍然
PASS; - 页面线程连续占用小于 3 ms;
- Promise 必须在成功、失败、取消三条路径都能 settle;
napi_async_work每个任务只 delete 一次;- 连续进入退出页面 30 次后,没有未收口 TaskContext。
其中最后一条我用 TaskRegistry 的 active count 验证。每轮页面离开后等 complete 收口,最终必须回到:
activeContext=0
activeWork=0
pendingPromise=0
这一组数字比“内存看起来没涨”更适合当前阶段。
因为第四篇马上就会引入 Buffer Pool,到那时内存本来就会故意保留可复用的 Slot。如果第三篇没有先把 Context 和 Work 的生命周期验干净,下一篇很难区分“Pool 设计保留内存”和“任务对象真的泄漏”。
十五、为什么这一期没有直接上线程安全函数
Node-API 还有线程安全函数等更复杂的跨线程通信方式,但 PixelBridge 当前转换任务的返回模型很简单:一次输入、一次计算、一次完成通知。napi_async_work + Promise 已经足够表达。
如果 worker 过程中需要持续上报 10%、20%、30% 进度,或者 Native 侧有一个长期存活线程要频繁把事件推回 ArkTS,线程安全函数会更合适。现在为了“看起来高级”提前引入,只会增加关闭、引用和跨线程回调的生命周期。
这也是我给这个系列定的原则:每一期只引入当前工程问题真正需要的机制。
第三篇需要的是把一次 CPU 密集型转换搬出 ArkTS 调用线程,并保证结束后能安全回到 Promise;没有持续事件流,就不额外造事件通道。
十六、把耗时拆开以后,下一步优化方向也更清楚
同步版只看到 10 ms 左右,很容易把所有时间都归给 libyuv。
现在拆完以后:
prepare  2.3 ms
worker   7.9 ms
complete 0.3 ms
如果后续继续优化,优先级就很明确。
worker 占比最大,适合比较不同 libyuv 路径、NEON 构建和输入尺寸;prepare 的 2.3 ms 则和 PixelMap 读取、内存复制直接相关;complete 只有 0.3 ms,目前没必要为了它增加复杂度。
工程优化最怕“凭感觉挑一段代码改”。第三篇最大的收益之一,就是把一个总耗时拆成可以分别观察的三个阶段。
参考资料
- HarmonyOS Node-API 异步任务:https://developer.huawei.com/consumer/cn/doc/doccenter-capabilities/use-napi-asynchronous-task
- HarmonyOS Node-API 跨语言调用:https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425
- Image_NativeModule PixelMap 位图操作:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/pixelmap-c

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献134条内容

所有评论(0)