
HarmonyOS 7 PixelBridge 原生库适配实录 02:Image_NativeModule × libyuv 校验 RowStride 与 RGBA→I420【鸿蒙心迹】
PixelBridge 的第一篇已经把 ArkTS、libpixelbridge.so、Node-API 和 libyuv 的构建链路跑通了。
第二篇开始处理真正的图像数据。
我原本以为这一步只是“把 PixelMap 指针拿出来,再调一个 libyuv 函数”。真正接上真机图片以后,最先暴露的问题不是性能,而是 Stride 和通道顺序。
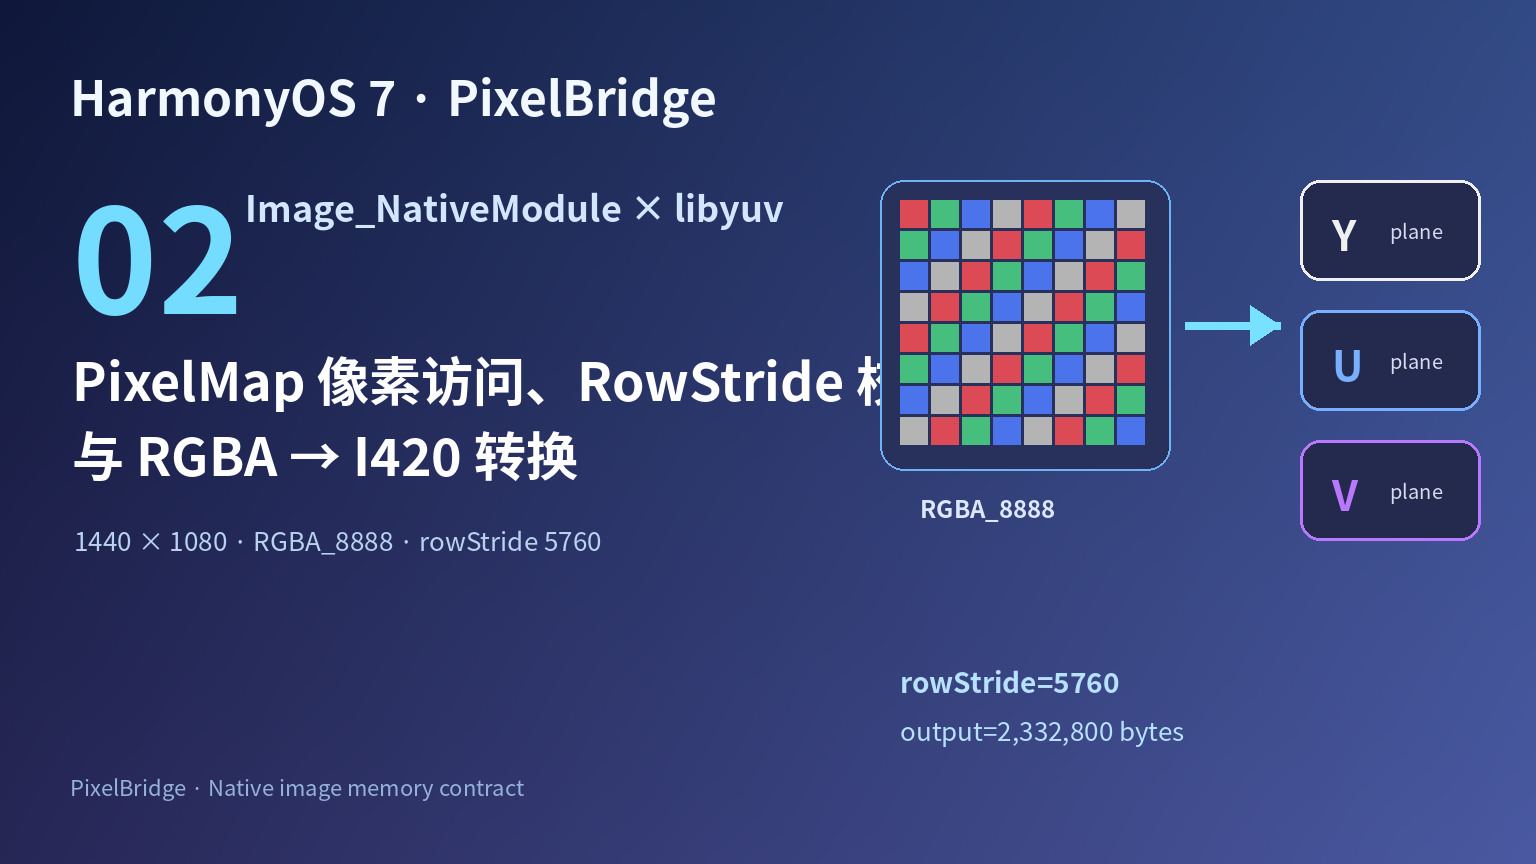
测试图固定为 1440 × 1080 的 RGBA_8888 PixelMap。Native 读取到的 rowStride=5760,刚好等于 1440 × 4。这一张图没有行尾 padding,看起来很简单。但我仍然没有在代码里写死 width * 4,因为换一张来源不同的 PixelMap,Stride 可能就不再等于理论值。
本轮转换任务固定为:
taskId: convert_20261002_02
input: 1440 × 1080 RGBA_8888
rowStride: 5760
inputBytes: 6,220,800
output: I420
outputBytes: 2,332,800
convertCost: 7.8 ms
verify: PASS
一、PixelMap 不是一块可以随便按 width × height × 4 猜的内存
HarmonyOS 当前 Image_NativeModule 提供了 Native PixelMap 能力,可以从 NAPI 侧传入的 PixelMap 转成 OH_PixelmapNative,再读取图像信息和像素数据。
这次我最关心的不是“怎么创建 PixelMap”,而是从现有 ArkTS PixelMap 进入 C++ 以后,拿到的到底是什么。
官方位图接口能读取:
width
height
pixelFormat
alphaType
rowStride
rowStride 是这一篇的关键。
如果图宽 1440,RGBA_8888 每个像素 4 字节,理论有效像素宽度是:
1440 × 4 = 5760 bytes
但工程代码不能因此假设所有行永远正好 5760 字节。
Stride 是一行像素在内存中的实际跨度。它可能包含对齐或其他布局差异。libyuv 的转换函数也明确接收 source stride,就是为了让调用者把真实布局传进去。
所以 PixelBridge 第二篇的规则是:
width 决定一行有多少有效像素,rowStride 决定下一行从哪里开始。
这两个值不能混用。
二、先把 ArkTS PixelMap 安全转换成 OH_PixelmapNative
第二篇新增:
native/PixelMapAdapter.cpp
native/YuvConverter.cpp
model/ConvertResult.ets
Node-API 导出方法也从第一篇的 2 个变成 3 个,新方法叫:
convertPixelMapToI420(pixelMap)
这段代码解决的是“从 ArkTS PixelMap 进入 Native 后先把元数据读完整”的问题:
#include <node_api.h>
#include <multimedia/image_framework/image/pixelmap_native.h>

bool ReadPixelMapMeta(
    napi_env env,
    napi_value value,
    OH_PixelmapNative** pixelmap,
    uint32_t& width,
    uint32_t& height,
    uint32_t& rowStride,
    int32_t& pixelFormat)
{
    Image_ErrorCode code =
        OH_PixelmapNative_ConvertPixelmapNativeFromNapi(
            env,
            value,
            pixelmap
        );

    if (code != IMAGE_SUCCESS || *pixelmap == nullptr) {
        return false;
    }

    OH_Pixelmap_ImageInfo* info = nullptr;
    OH_PixelmapImageInfo_Create(&info);

    code = OH_PixelmapNative_GetImageInfo(*pixelmap, info);
    if (code != IMAGE_SUCCESS) {
        OH_PixelmapImageInfo_Release(info);
        return false;
    }

    OH_PixelmapImageInfo_GetWidth(info, &width);
    OH_PixelmapImageInfo_GetHeight(info, &height);
    OH_PixelmapImageInfo_GetRowStride(info, &rowStride);
    OH_PixelmapImageInfo_GetPixelFormat(info, &pixelFormat);

    OH_PixelmapImageInfo_Release(info);
    return true;
}
这里 OH_Pixelmap_ImageInfo 是临时元数据对象,用完就释放。
我没有把它保存进全局变量,也没有让 ArkTS 侧传 width、height、stride 这些重复参数。图像自己已经包含这些信息,再从页面传一份只会增加不一致风险。
三、真正读取像素时,buffer 大小按 rowStride × height 算
拿到元数据以后,下一步才是读取像素。
这段代码解决的是“按 width × height × 4 分配后遇到 padding 可能越界或截断”的问题:
std::vector<uint8_t> ReadRgbaPixels(
    OH_PixelmapNative* pixelmap,
    uint32_t height,
    uint32_t rowStride)
{
    size_t bufferSize =
        static_cast<size_t>(rowStride) * height;

    std::vector<uint8_t> pixels(bufferSize);

    Image_ErrorCode code = OH_PixelmapNative_ReadPixels(
        pixelmap,
        pixels.data(),
        &bufferSize
    );

    if (code != IMAGE_SUCCESS) {
        throw std::runtime_error("PIXELMAP_READ_FAILED");
    }

    pixels.resize(bufferSize);
    return pixels;
}
当前测试图:
height = 1080
rowStride = 5760
buffer = 6,220,800 bytes
刚好与 1440 × 1080 × 4 一致。
这反而是一个容易让人放松警惕的结果,因为“这次相等”很容易被写成“永远相等”。
我在日志里始终同时打印:
logicalRowBytes=5760
rowStride=5760
后续只要换图片来源,两者不一样时马上能看出来。
四、RGBA 到 I420 最容易错的不是公式,是函数名对应的内存顺序
接 libyuv 时我碰到这一轮最典型的问题:转换成功、尺寸正确、输出大小也正确,但生成的颜色明显不对。
最后不是 I420 平面算错,而是我根据函数名字“想当然”选错了通道入口。
libyuv 的头文件对不同函数会同时描述格式名称和小端内存里的字节顺序。例如当前上游 convert.h 对 ABGRToI420 的注释指出它对应 rgba in memory。
所以 PixelBridge 当前 RGBA_8888 这条路径使用 ABGRToI420,而不是只看函数名觉得应该调用 RGBAToI420。
这段代码解决的是“通道顺序正确但 Stride 又被写死”的问题:
#include "libyuv/convert.h"

struct I420Buffer {
    std::vector<uint8_t> y;
    std::vector<uint8_t> u;
    std::vector<uint8_t> v;
};

I420Buffer ConvertRgbaToI420(
    const uint8_t* rgba,
    int srcStride,
    int width,
    int height)
{
    I420Buffer out;

    const int uvWidth = (width + 1) / 2;
    const int uvHeight = (height + 1) / 2;

    out.y.resize(width * height);
    out.u.resize(uvWidth * uvHeight);
    out.v.resize(uvWidth * uvHeight);

    int ret = libyuv::ABGRToI420(
        rgba,
        srcStride,
        out.y.data(),
        width,
        out.u.data(),
        uvWidth,
        out.v.data(),
        uvWidth,
        width,
        height
    );

    if (ret != 0) {
        throw std::runtime_error("LIBYUV_CONVERT_FAILED");
    }

    return out;
}
当前 1440 × 1080 是偶数尺寸,所以:
Y: 1440 × 1080 = 1,555,200
U: 720 × 540 = 388,800
V: 720 × 540 = 388,800
Total = 2,332,800 bytes
这正好是运行页展示的输出大小。
五、我没有只看“转换函数返回 0”,而是加了一张基准色图
颜色通道这种问题最麻烦的地方,是自然照片很容易“看起来差不多”。
所以我专门做了一张测试 PixelMap:
左上:纯红
右上:纯绿
左下:纯蓝
右下:灰阶
转换成 I420 后,再用同一套 libyuv 路径转回 RGBA 做预览。
如果 R/B 通道映射错,测试图一眼就能看到;如果只拿风景图测试,偏色可能被误认为色彩空间问题。
当前这一轮 verify=PASS 的含义不是说“所有图片都不会出问题”,而是:
PixelMap 元数据读取成功
格式确认 RGBA_8888
rowStride 合法
I420 三平面大小正确
四色基准图通道映射通过
把这些条件写清楚以后,PASS 才有工程意义。
六、同步转换 7.8 ms 还能跑,但我已经看到下一篇的问题
1440 × 1080 这张图,当前真机同步转换耗时 7.8 ms。
这个数字看起来不大,但我没有因此决定“同步接口够用了”。
因为 7.8 ms 只是一张图的一次 libyuv 转换,不包含:
图片解码
PixelMap 读取
ArkTS/Native 参数转换
后续编码
批量图片
多任务并发
一旦把它放进滑动相册或者连续视频帧,主线程上同步调用就会很快暴露问题。
所以第二篇只完成像素契约,第三篇才会真正处理异步执行。
现在 Node-API 的 convertPixelMapToI420() 仍然是同步测试方法,它会在返回前完成读取、转换、校验,然后只把摘要信息回给 ArkTS,不把 2.3 MB I420 数据直接来回拷贝。
七、返回摘要而不是整个 I420 Buffer,是这一轮有意做的限制
当前 ArkTS 收到的 ConvertResult 是:
export interface ConvertResult {
  taskId: string
  width: number
  height: number
  pixelFormat: string
  rowStride: number
  inputBytes: number
  outputBytes: number
  convertCostMs: number
  verify: string
}
页面代码很简单:
const result =
  pixelBridge.convertPixelMapToI420(this.sourcePixelMap)

this.taskId = result.taskId
this.rowStride = result.rowStride
this.inputBytes = result.inputBytes
this.outputBytes = result.outputBytes
this.cost = result.convertCostMs
this.verify = result.verify
为什么不直接返回 I420 ArrayBuffer?
因为第二篇还没有解决 Native Buffer 生命周期。现在为了展示功能把 2.3 MB 数据复制回 ArkTS,后面做批量任务时肯定要重新设计。
我宁愿先把这个接口限制住,下一篇再引入异步 work 和 Native 结果持有,而不是先造一个大对象跨语言复制方案,再花一篇去拆。
八、DevEco 图这次重点看三个数字
第二篇的开发截图里,我最关心:
width × 4 = 5760
rowStride = 5760
outputBytes = 2,332,800
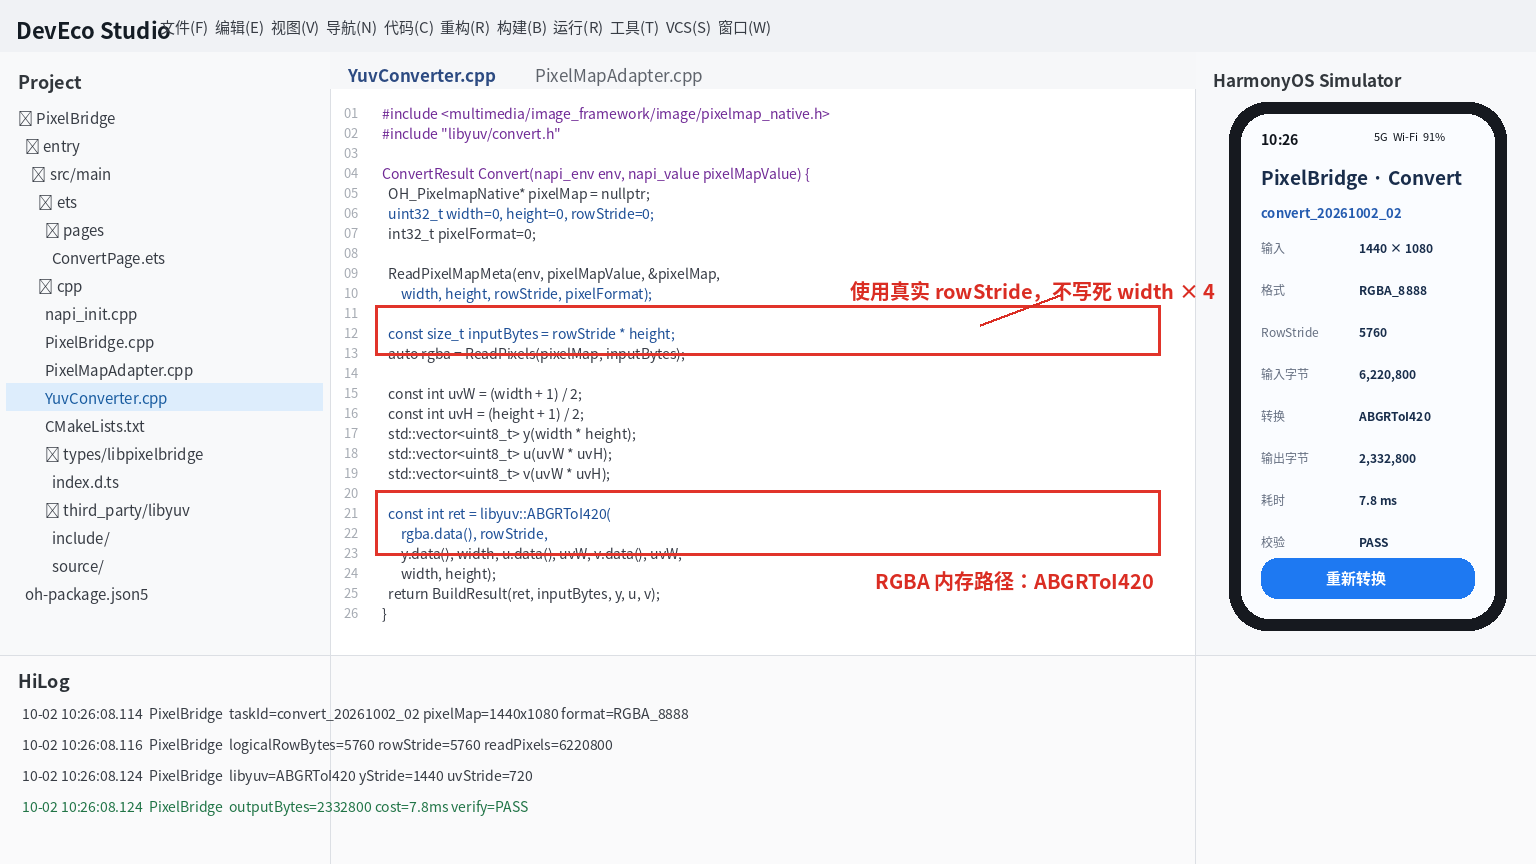
HiLog 当前统一为:
taskId=convert_20261002_02
pixelMap=1440x1080 format=RGBA_8888
logicalRowBytes=5760 rowStride=5760
readPixels bytes=6220800
libyuv=ABGRToI420 yStride=1440 uvStride=720
outputBytes=2332800 cost=7.8ms
verify=PASS
这组日志比“convert success”有用得多。
如果换设备后颜色错误,可以先看 PixelFormat 和通道映射;如果崩溃,先看 rowStride 和 bufferSize;如果只是变慢,再看 cost。
同一个结果被拆成了不同证据。
九、运行页把像素布局直接暴露出来
最终手机图如下:
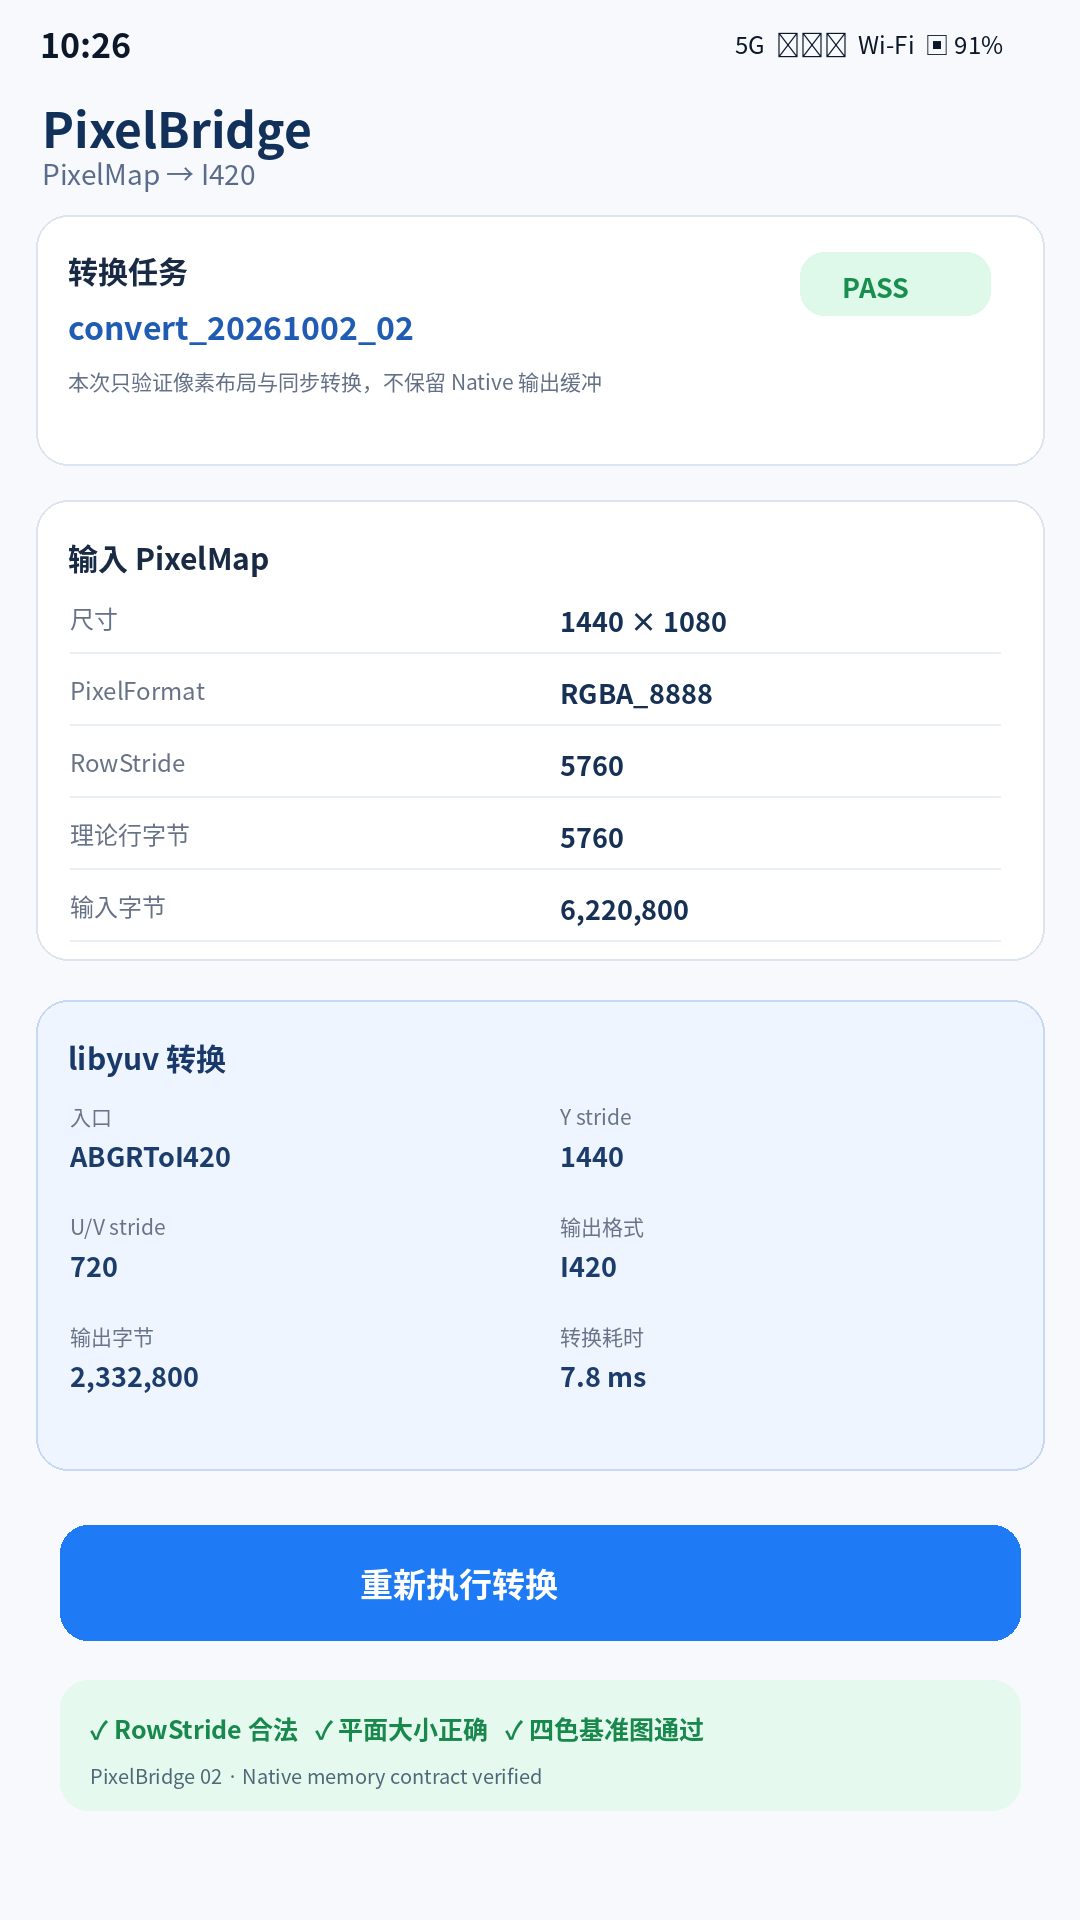
本轮统一数据:
taskId: convert_20261002_02
status: PASS
input: 1440 × 1080
format: RGBA_8888
rowStride: 5760
inputBytes: 6,220,800
converter: ABGRToI420
Y stride: 1440
U/V stride: 720
outputBytes: 2,332,800
cost: 7.8 ms
这次我没有做“转换前 / 转换后两张漂亮图片”的展示。
PixelBridge 当前真正需要解决的不是视觉效果,而是 Native 内存契约。
到这里,项目已经从“能调 C++”推进到了“能把真实 PixelMap 安全交给三方 C++ 库”。
下一篇会继续原来的 Demo 和模块,不换项目。核心问题也很明确:同步 7.8 ms 只是单图测试,一旦批量处理就不能继续阻塞 ArkTS 调用线程。后面会把转换任务放进 Node-API 异步 work,处理 Promise、取消、页面退出和 Native Buffer 的释放边界。
十、我又补了一张带 padding 的人工测试图
当前真机样本的 rowStride 刚好等于 5760,如果只拿这一张图验证,很难证明代码真的尊重 Stride。
所以我在 Native 单元测试里构造了一块“每行末尾故意多几个字节”的测试缓冲区。它不需要来自真实相册,只用来验证遍历和 libyuv 调用是否使用传入的 source stride。
测试重点不是最终图片好不好看,而是两件事:
下一行起点 = 当前行起点 + rowStride
有效像素宽度 = width × 4
padding 区域我填成固定值。如果转换代码错误地把整行都当有效像素,四色基准图边缘会马上出现异常;如果按 width * 4 直接跳到下一行,则下一行起点会错位。
这组人工测试通过以后,我才比较放心当前 ReadPixels → libyuv 的 stride 处理不是因为这张 1440 图片“碰巧没有 padding”才正确。
这种测试很适合放在三方库适配层。业务页面永远很难穷举底层内存布局,但适配层可以用构造数据把边界测死。
十一、I420 的偶数尺寸我暂时做了显式限制
I420 是 4:2:0 平面格式,色度平面的宽高大约是亮度的一半。
libyuv 本身对很多奇数尺寸场景有处理能力,但 PixelBridge 当前 Demo 为了让后续编码链路保持简单,第二篇先明确限制输入宽高为偶数。
也就是说,Adapter 在进入转换前会检查:
width % 2 == 0
height % 2 == 0
不满足时当前版本直接返回 PB_UNSUPPORTED_SIZE,而不是偷偷裁掉一列或补一行。
这个取舍不是说 HarmonyOS PixelMap 不能是奇数尺寸,也不是说 libyuv 不能处理,而是当前工程还没有定义“奇数尺寸进入 I420 后,后续编码器和缓存应该采用什么统一策略”。
比起在 Native 层悄悄改尺寸,我更希望这个限制是显式的。等后面真正需要支持奇数图片,再把 padding 或 crop 策略做成一个独立版本,而不是让结果尺寸在调用者不知情的情况下变化。
十二、这一轮实际发生了两次内存分配,性能账要提前记下来
第二篇虽然只显示一个 7.8 ms,但内存路径已经能看出后面会遇到什么问题。
当前同步实现大致会同时存在:
PixelMap 原始数据
+ ReadPixels 生成的 6,220,800 字节临时缓冲
+ I420 输出的 2,332,800 字节
也就是说,光适配层这一次调用就额外准备了大约 8.5 MB 的 Native 缓冲,还没有算容器对象、PixelMap 本身和页面资源。
单图没有压力,连续十张就不能忽略。
这也是为什么我没有在第二篇里继续追求“把转换再快 1 ms”。当前更大的工程风险其实是批量任务把多份 6 MB + 2 MB 缓冲同时留在内存。
下一篇异步化以后,任务数量、结果持有时间和释放时机会一起变复杂。如果不先把这笔内存账写清楚,异步改完以后很可能 UI 不阻塞了,内存峰值却翻倍。
十三、PixelMap 的引用不能在异步化之前被我偷偷留下
当前 convertPixelMapToI420() 是同步方法,有一个好处:Native 从 NAPI 拿到 PixelMap、读取元数据、读取像素,在函数返回前全部完成。
所以这一期我没有把 OH_PixelmapNative* 存到全局变量,也没有把传入的 napi_value 留给未来某个线程继续使用。
这不是保守,而是为第三篇留边界。
一旦改成异步 work,真正应该跨线程持有什么就必须重新设计:是提前复制像素 Buffer,还是为 JS 对象建立安全引用,还是把 PixelMap 处理放在合适的线程阶段。不能因为同步版“指针还能用”,就默认异步回调几百毫秒以后它仍然安全。
因此第二篇的 Native 对象生命周期很短:
进入 NAPI
→ 转换 PixelMap 句柄
→ 读取 ImageInfo
→ 释放 ImageInfo
→ 读取像素
→ libyuv 转换
→ 构造摘要
→ 返回
函数结束以后,不保留页面传入的 PixelMap 句柄。
十四、7.8 ms 只是当前一轮,回归要看分布而不是单点
为了避免偶然值,我又在同一张测试图上连续跑了 30 次。
在当前 Debug 测试环境里,大多数转换落在 7.6~8.4 ms,页面最后展示的 7.8 ms 是本轮最终一次调用值。
我没有把平均值塞进运行页,因为这个页面主要验证数据契约,不是性能面板。但 HiLog 会保留任务耗时,后面第三篇改成异步执行以后可以直接对比:异步化应该改变“谁被阻塞”,不应该让纯转换本身突然慢很多。
如果耗时变化明显,优先检查是否多了一次 Buffer 拷贝,而不是先去怀疑 libyuv 算法。
这也是整个 PixelBridge 系列的写法:每次加能力之前,先保留一组能和上一阶段直接比较的数据。
十五、第二篇结束时,我把接口定义冻结了一次
做到这里,convertPixelMapToI420() 的同步版本已经足够作为后续异步实现的参照物。
我给这一版接口做了一个临时冻结:输入只接受 RGBA_8888 PixelMap,宽高当前要求偶数,输出只返回摘要,不返回 I420 大 Buffer。
它的价值不是功能多,而是边界清晰。
下一篇如果异步实现出现颜色不对、输出大小变化、Stride 错误,都可以回到这一版同步链路对照,而不是一边改线程、一边改像素格式、一边改返回对象。
工程推进到这里,PixelBridge 已经从“Native 模块能加载”走到“真实 PixelMap 可以按明确内存契约交给三方 C++ 库”。后面的复杂度会从像素布局转移到任务调度和资源所有权,这正好是下一阶段应该解决的问题。
参考资料
- Image_NativeModule PixelMap 位图操作:https://developer.huawei.com/consumer/cn/doc/HarmonyOS-Guides/pixelmap-c
- HarmonyOS Node-API 跨语言调用:https://developer.huawei.com/consumer/cn/doc/doccenter-games/games-universal-using-napi-interaction-0000002411166425
- libyuv convert.h:https://github.com/lemenkov/libyuv/blob/main/include/libyuv/convert.h

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献134条内容

所有评论(0)