
HarmonyOS 7 ArkUI + UDMF:跨窗口拖拽落点中的数据解包、重复 Drop 去重与临时文件回收【鸿蒙心迹】
这次的 Demo 叫 DropInboxLab。页面只有一个落点区域:从图库、文件管理或另一个窗口拖内容进来,应用负责解包、筛选并导入。
真正跑起来以后,问题不在“怎么拖”,而在 Drop 之后。一次拖拽可能携带多条 UDMF 记录;业务入口也可能因为重试或状态切换被再次触发;处理中为了跨应用访问文件,还可能产生临时副本。如果只把逻辑堆进一个 onDrop,很快就会遇到重复入库、状态错乱和临时文件残留。
这一篇只处理这三个工程问题:数据怎么解、重复 Drop 怎么挡、临时资源怎么收干净。
一、先把一次 Drop 当成导入事务
ArkUI 的拖拽事件里,DragEvent.getData() 可以取得 UDMF 的 UnifiedData,再通过 getRecords() 获取记录。当前接口还定义了 190001 Data not found、190002 Data error 等获取异常;大数据场景可在 onDrop 阶段使用异步数据加载能力。
接口解决的是“怎么拿数据”,业务仍然要自己保证一致性。
本轮固定数据如下:
- Session:
drop_20261001_10 - Drop ID:
drop_20261001_10_03 - Records:
3 - Accepted:
2 - Duplicate Dropped:
1 - Cleanup Count:
2 - Temp Files:
0 - Last File:
IMG_20261001_1008.png
这里的 Duplicate Dropped = 1 不代表系统必然重复派发 Drop。工程上更合理的判断是:落点属于外部输入边界,只要后面会复制文件、写数据库或启动上传任务,就应该按幂等入口处理。
项目结构拆成四块:
entry/src/main/ets/
├── pages/DropInboxPage.ets
├── drag/DropSessionGuard.ets
├── drag/UdmfUnpacker.ets
└── file/TempFileLedger.ets
页面只负责状态,幂等、解包和资源台账分别独立。
二、第一段代码:副作用发生前先做去重
最早的实现是拿到数据就复制文件。这样只要入口执行两次,副作用也会执行两次。
所以先生成 Drop 业务键,再决定是否进入导入流程。
private async handleDrop(event: DragEvent): Promise<void> {
  this.state = 'PROCESSING'
  const data = event.getData()
  const records = data.getRecords()

  const dropKey = this.dropGuard.buildKey(
    this.sessionId, event.getDisplayId(), records
  )

  if (this.dropGuard.isDuplicate(dropKey)) {
    this.duplicateDropped += 1
    return
  }

  this.dropGuard.mark(dropKey)
  await this.consumeRecords(records)
}
这段代码解决的是“重复副作用”,不是简单重复日志。mark() 必须发生在复制、入库之前。
正式项目里我会给幂等键增加有效期。同一个文件十分钟后再次拖入,可能是用户的真实新动作;Demo 只在当前 Session 内去重,页面销毁时清空。
getData() 也要单独处理异常。拿不到数据时不能把当前 Drop 误标成已经完成,否则下一次真正拿到数据反而会被去重逻辑挡掉。
三、第二段代码:不要默认只有一个文件
单张图片测试时,records[0] 很容易让人误以为足够。直到一次拖进两张图片和一个 PDF,问题才暴露出来。
我的做法是先把 UDMF 记录转换成业务自己的 InboxFile,再按类型筛选。本 Demo 只接受图片,所以三条记录最后 Accepted 为 2。
async unpack(
  data: unifiedDataChannel.UnifiedData
): Promise<InboxFile[]> {
  const accepted: InboxFile[] = []

  for (const record of data.getRecords()) {
    const file = await this.toInboxFile(record)
    if (!file || !file.mimeType.startsWith('image/')) {
      continue
    }

    if (file.isTemporary) {
      this.tempLedger.register(file.localPath)
    }
    accepted.push(file)
  }

  return accepted
}
UdmfUnpacker 不直接更新页面。它只返回业务结果,页面再统一修改 Accepted、Last File 和 State。这样第三条记录失败时,不会出现“UI 已经显示成功,真实文件还没落稳”的半完成状态。
如果拖入的是大文件,我也不会把数据同步和业务导入绑在一次 UI 回调里。Drop 已发生、数据同步中、文件可用、业务提交完成应该是不同状态。
四、第三段代码:临时文件统一进台账
临时文件如果只在成功路径最后删除,任何中途异常都会留下垃圾。更麻烦的是,下一次重试已经无法判断哪些是本轮文件、哪些是上轮残留。
所以每次创建临时文件就登记到 TempFileLedger;正式文件提交后从台账中移除;其余内容在 finally 中清理。
private async consumeRecords(
  records: unifiedDataChannel.UnifiedRecord[]
): Promise<void> {
  try {
    const files = await this.unpacker.unpackRecords(records)

    for (const file of files) {
      await this.repository.importFile(file)
      this.accepted += 1
      this.lastFile = file.name
      this.tempLedger.commit(file.localPath)
    }
    this.state = 'IMPORTED'
  } catch (err) {
    this.state = 'FAILED'
  } finally {
    this.cleanupCount +=
      await this.tempLedger.cleanup(this.sessionId)
    this.tempFiles = 0
    this.state = 'CLEAN'
  }
}
Demo 的 Cleanup Count = 2 表示本轮产生过两个临时副本,最后均被回收;Temp Files = 0 才是我真正关心的验收结果。
页面销毁时还要取消未完成任务,Ability 销毁时可以再扫一次未提交台账,给异常退出留一个兜底。
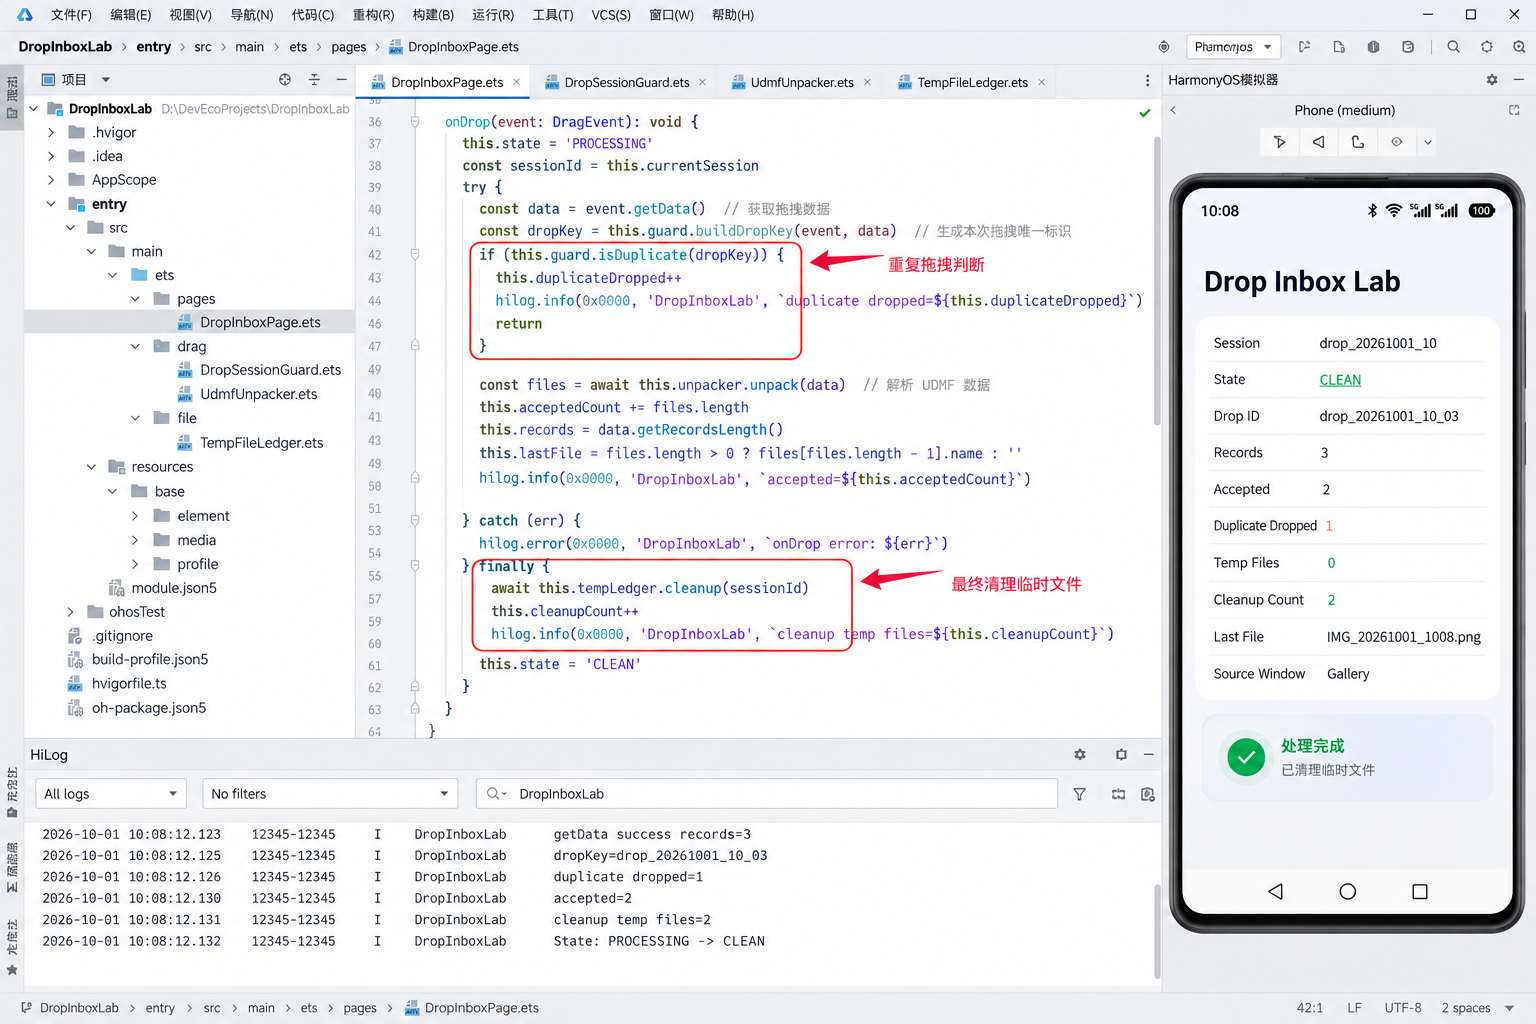
调试时我主要看:
getData success records=3
dropKey=drop_20261001_10_03
duplicate dropped=1
accepted=2
cleanup temp files=2
State: PROCESSING -> CLEAN
这些日志分别证明输入、幂等、筛选、释放和最终状态都闭环了。
五、我专门做了三种破坏性测试
第一种,在 getData() 后主动抛异常。预期页面可以短暂进入 FAILED,但 finally 仍会把临时文件清到 0。
第二种,连续两次拖入同一批文件。第一次 Accepted 变成 2;第二次只增加 Duplicate Dropped,不再产生新的业务文件。
第三种,在解包过程中离开页面。未完成导入被取消,台账保留可清理信息;再次进入页面时不应看到上一轮 loading,也不应残留临时文件。
最终手机运行图就是本轮验收结果:
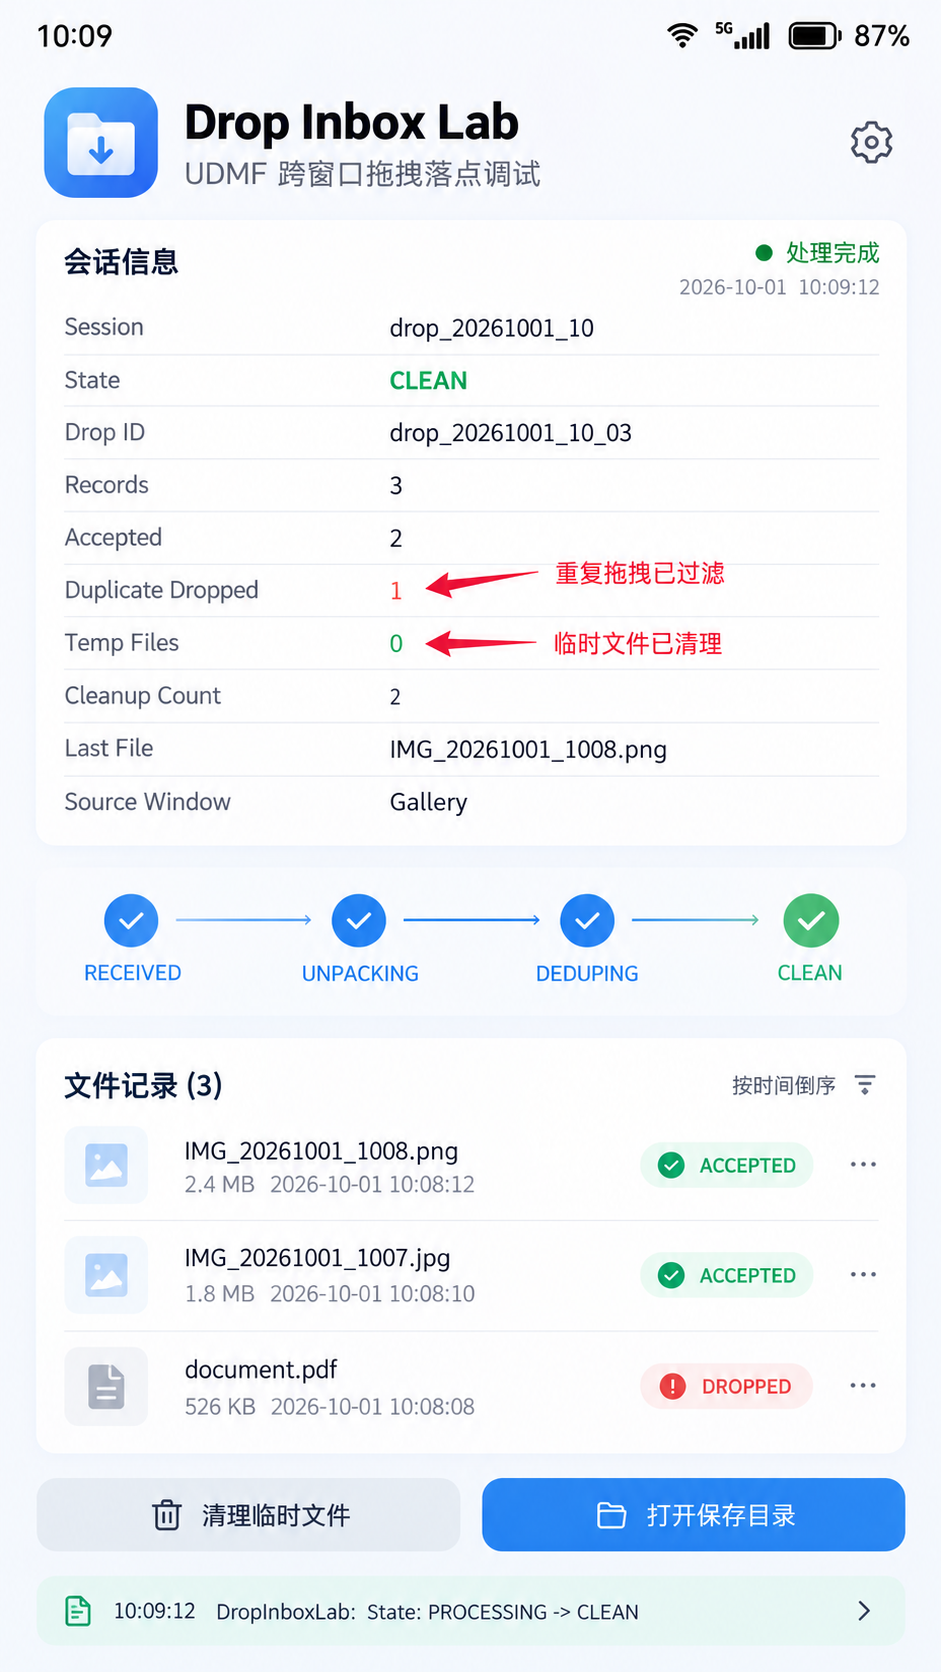
图里最有价值的不是绿色的 CLEAN,而是两个数字:Duplicate Dropped = 1 与 Temp Files = 0。前者说明副作用没有重复执行,后者说明资源生命周期真正结束。
六、正式项目还要注意两个边界
如果业务允许同一个文件重复导入,就不能拿 URI 做永久幂等键,应把 Session、时间窗口和内容摘要一起纳入计算。
如果文件很大,建议把“取 UDMF 数据”“复制文件”“业务提交”拆成可取消任务。跨设备或跨应用时,数据同步可能远慢于拖拽动画,页面只负责订阅状态,不要持有整个重任务。
我现在更愿意把 onDrop 当成一个外部 API 入口:它负责接收输入,但可靠性来自后面的校验、幂等、状态机和释放。
UDMF 解决的是数据统一,业务仍要自己完成一次可重复、可恢复、可清理的导入事务。
七、参考资料
- HarmonyOS ArkUI:拖拽事件、DragEvent、getData、getSummary、startDataLoading。
- HarmonyOS ArkData:UnifiedData 与 UnifiedRecord。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)