
Core Vision Kit × ArkTS on HarmonyOS 7:文搜图查询的 Unicode 归一化与别名回放【鸿蒙心迹】
搜索框里看起来相同的两句话,在程序里未必是同一串字符。用户从聊天软件复制“AI 大会 合影”,其中的字母可能是全角字符,空格也可能是全角空格;键盘再次输入“AI 大会 合影”,肉眼几乎看不出差异,缓存键、埋点和别名规则却会把它们当成两次不同查询。
本文用 LexiGallery 示例把问题拆成一条可观察的查询管线。页面叫 QueryTracePage,任务编号是 QUERY-NORM-0083,图片作用域为 album2026,topKey 设为 20。原始输入固定为 AI 大会 合影,经过 NFKC 与空白折叠后得到 AI 大会 合影,再依据 alias-cn-v3 生成补充查询 人工智能 大会 合影。两路结果分别返回 8 条和 9 条,按路径去重后保留 13 条,其中重复项 4 条,界面最终展示相似度最高的 6 条。
这些结果数量、耗时和相似度是为了说明工程逻辑而设计的演示数据,不冒充某台设备上的真实跑分。Core Vision Kit 负责语义检索,本文增加的归一化、别名和合并均是应用层策略,两者边界需要说清楚。
一、问题不在输入框,而在“同一句话有几种表示”
传统关键词搜索往往先做小写化、去空格,再把字符串交给后端。端侧文搜图面对的是语义模型,团队容易产生另一种直觉:模型既然理解语义,字符差异就不重要。这个判断只说对了一半。
模型可能对全角字母和普通字母给出接近结果,但工程系统仍要处理查询历史、推荐词、缓存、统计与问题复现。如果原始字符串直接作为键,五种视觉近似输入会形成五条历史;如果埋点只记录处理后的文本,又无法解释用户到底输入了什么。更麻烦的是,别名词典可能命中 AI,却命不中全角 AI,导致同一句话在不同输入法下走不同检索路径。
因此 LexiGallery 同时保留三个值:rawQuery 是用户原始输入,只在当前会话中用于回显;canonicalQuery 是规范化后真正参与规则和检索的字符串;queryFingerprint 由规范化文本、作用域和别名词典版本共同计算,用于诊断与短期去重。
指纹不是安全签名,也不应拿来证明文本未被篡改。它只是一个稳定的工程标识,让日志能回答“这两次查询是否使用同一份规则和语义输入”。敏感查询仍需要最小化保存,不能因为有了指纹就长期记录原文。
官方 textSearchImage.search(query, scope, topKey) 对查询词、作用域和返回数量有明确边界:查询长度为 1~100,不能是纯数字或纯字母;scope 为 1~32 位字母或数字;topKey 为 0~100。归一化之后必须重新校验这些约束,因为处理前合法不等于处理后仍然合法。
二、规范化不是“删掉所有符号”
粗暴清洗通常写成正则,只保留中文、数字和字母。它会误删地点中的连字符、产品型号中的加号,甚至改变用户本来想表达的内容。LexiGallery 只做三件可解释的事:NFKC 兼容归一化、把连续空白折叠成一个普通空格、去掉首尾空白。
这段代码解决什么问题:把全角字符和多种空白收敛成稳定文本,同时保留有语义的标点。
// search/QueryNormalizer.ets
export interface NormalizedQuery {
  raw: string
  canonical: string
  changed: boolean
  reason: string[]
}

export function normalizeQuery(raw: string): NormalizedQuery {
  const reasons: string[] = []
  const nfkc = raw.normalize('NFKC')
  if (nfkc !== raw) reasons.push('NFKC')

  const collapsed = nfkc.replace(/\s+/g, ' ').trim()
  if (collapsed !== nfkc) reasons.push('WHITESPACE')

  return {
    raw,
    canonical: collapsed,
    changed: collapsed !== raw,
    reason: reasons
  }
}
NFKC 会把兼容字符映射到更统一的形式,例如全角拉丁字母会收敛为普通字母。它也可能改变某些具有排版含义的字符,所以不能不经评估就用于所有文本场景。这里处理的是短查询,不是法律文本、密码或文件名;使用范围本身就是设计的一部分。
正则中的 \s+ 负责折叠连续空白。项目应通过当前 ArkTS 编译器与目标设备测试具体 Unicode 行为,不要凭桌面浏览器结果推断端侧完全一致。若产品需要保留换行或引号,规则还要更细,不能为了命中率把用户意图清空。
示例原始查询共有 9 个可见位置,规范化后为 AI 大会 合影。页面会显示转换原因 NFKC + WHITESPACE,而不是只给“已优化”这样的模糊提示。用户如果不希望应用改写查询,也可以切换到仅规范化、不扩展别名的模式。
三、别名扩展要版本化,还要限制爆炸
别名不是同义词越多越好。把 AI 扩展成“人工智能、智能、算法、模型”会让查询迅速偏离原意;多个词同时命中时,组合数量还会指数增长。LexiGallery 使用白名单词典,每条规则只有一个受控替代,并且最多生成两条查询:规范化原文与一条扩展文。
这段代码解决什么问题:对完整词元做受控别名替换,记录词典版本,并限制扩展数量。
// search/AliasDictionary.ets
export interface QueryVariant {
  text: string
  source: 'CANONICAL' | 'ALIAS'
  dictionaryVersion: string
}

const DICTIONARY_VERSION = 'alias-cn-v3'
const ALIASES: Record<string, string> = {
  'AI': '人工智能',
  '团建': '团队活动',
  '夜景': '夜晚 城市景观'
}

export function expandAlias(canonical: string): QueryVariant[] {
  const variants: QueryVariant[] = [
    { text: canonical, source: 'CANONICAL', dictionaryVersion: DICTIONARY_VERSION }
  ]
  const tokens = canonical.split(' ')
  const index = tokens.findIndex((token: string) => ALIASES[token] !== undefined)
  if (index < 0) return variants

  const expanded = [...tokens]
  expanded[index] = ALIASES[tokens[index]]
  variants.push({
    text: expanded.join(' '),
    source: 'ALIAS',
    dictionaryVersion: DICTIONARY_VERSION
  })
  return variants
}
这里按空格切词,是因为示例查询本身有清晰分隔。真实中文输入经常没有空格,不能声称这个方法完成了通用分词。若项目引入分词能力,应把分词版本也写入指纹,并用黄金查询集验证;否则一次词典升级就可能悄悄改变历史查询的行为。
别名替换采用完整词元匹配,避免 AI 出现在更长字符串中时被误换。Record 的键值也需要代码评审和产品确认,因为“夜景”扩展成“夜晚 城市景观”只在特定图库里合理。用户人名、地点、品牌和少数语言表达不宜自动替换。
词典版本 alias-cn-v3 进入日志,不意味着把整个词典上传。它让团队看到相同规范化文本在不同发布版本下可能走了不同候选。诊断时先比较版本,再比较模型与索引,能减少把应用规则变化误判成模型波动。
四、查询指纹必须包含作用域和规则版本
只对文本做哈希会漏掉两个关键事实:同一句话在 album2026 与 workdocs 中不是同一个检索任务;同一句话使用 alias-cn-v2 和 alias-cn-v3 时也可能生成不同候选。因此指纹材料由 canonicalQuery + scope + dictionaryVersion 组成。
这段代码解决什么问题:生成可复现但不具安全含义的查询指纹,并在规范化后执行官方参数边界校验。
// search/QueryIdentity.ets
export function validateSearchInput(query: string, scope: string, topKey: number): void {
  if (query.length < 1 || query.length > 100) throw new Error('QUERY_LENGTH')
  if (/^[0-9]+$/.test(query) || /^[A-Za-z]+$/.test(query)) {
    throw new Error('QUERY_PURE_ALNUM')
  }
  if (!/^[A-Za-z0-9]{1,32}$/.test(scope)) throw new Error('SCOPE_FORMAT')
  if (!Number.isInteger(topKey) || topKey < 0 || topKey > 100) {
    throw new Error('TOP_KEY_RANGE')
  }
}

export function fnv1a32(material: string): string {
  let hash = 0x811c9dc5
  for (let i = 0; i < material.length; i++) {
    hash ^= material.charCodeAt(i)
    hash = Math.imul(hash, 0x01000193)
  }
  return (hash >>> 0).toString(16).padStart(8, '0')
}

export function queryFingerprint(query: string, scope: string, version: string): string {
  return fnv1a32(`${version}\n${scope}\n${query}`)
}
FNV-1a 适合做短标识,不适合密码学验证。发生碰撞时,两条不同查询可能得到同一指纹,因此缓存中仍应比较完整规范化文本;日志可以显示 qf-7d31c8a4 这样的短值,但不能只凭它做安全判断。
QUERY_PURE_ALNUM 的命名强调这里检查的是“纯数字或纯字母”两类输入。包含中文的 AI 大会 合影 可以通过。应用不要自行扩大官方限制,例如把所有英文都拒绝,因为英文与中文混合查询是允许场景。边界应跟随当前 SDK 文档,而不是根据旧经验硬编码后永久不改。
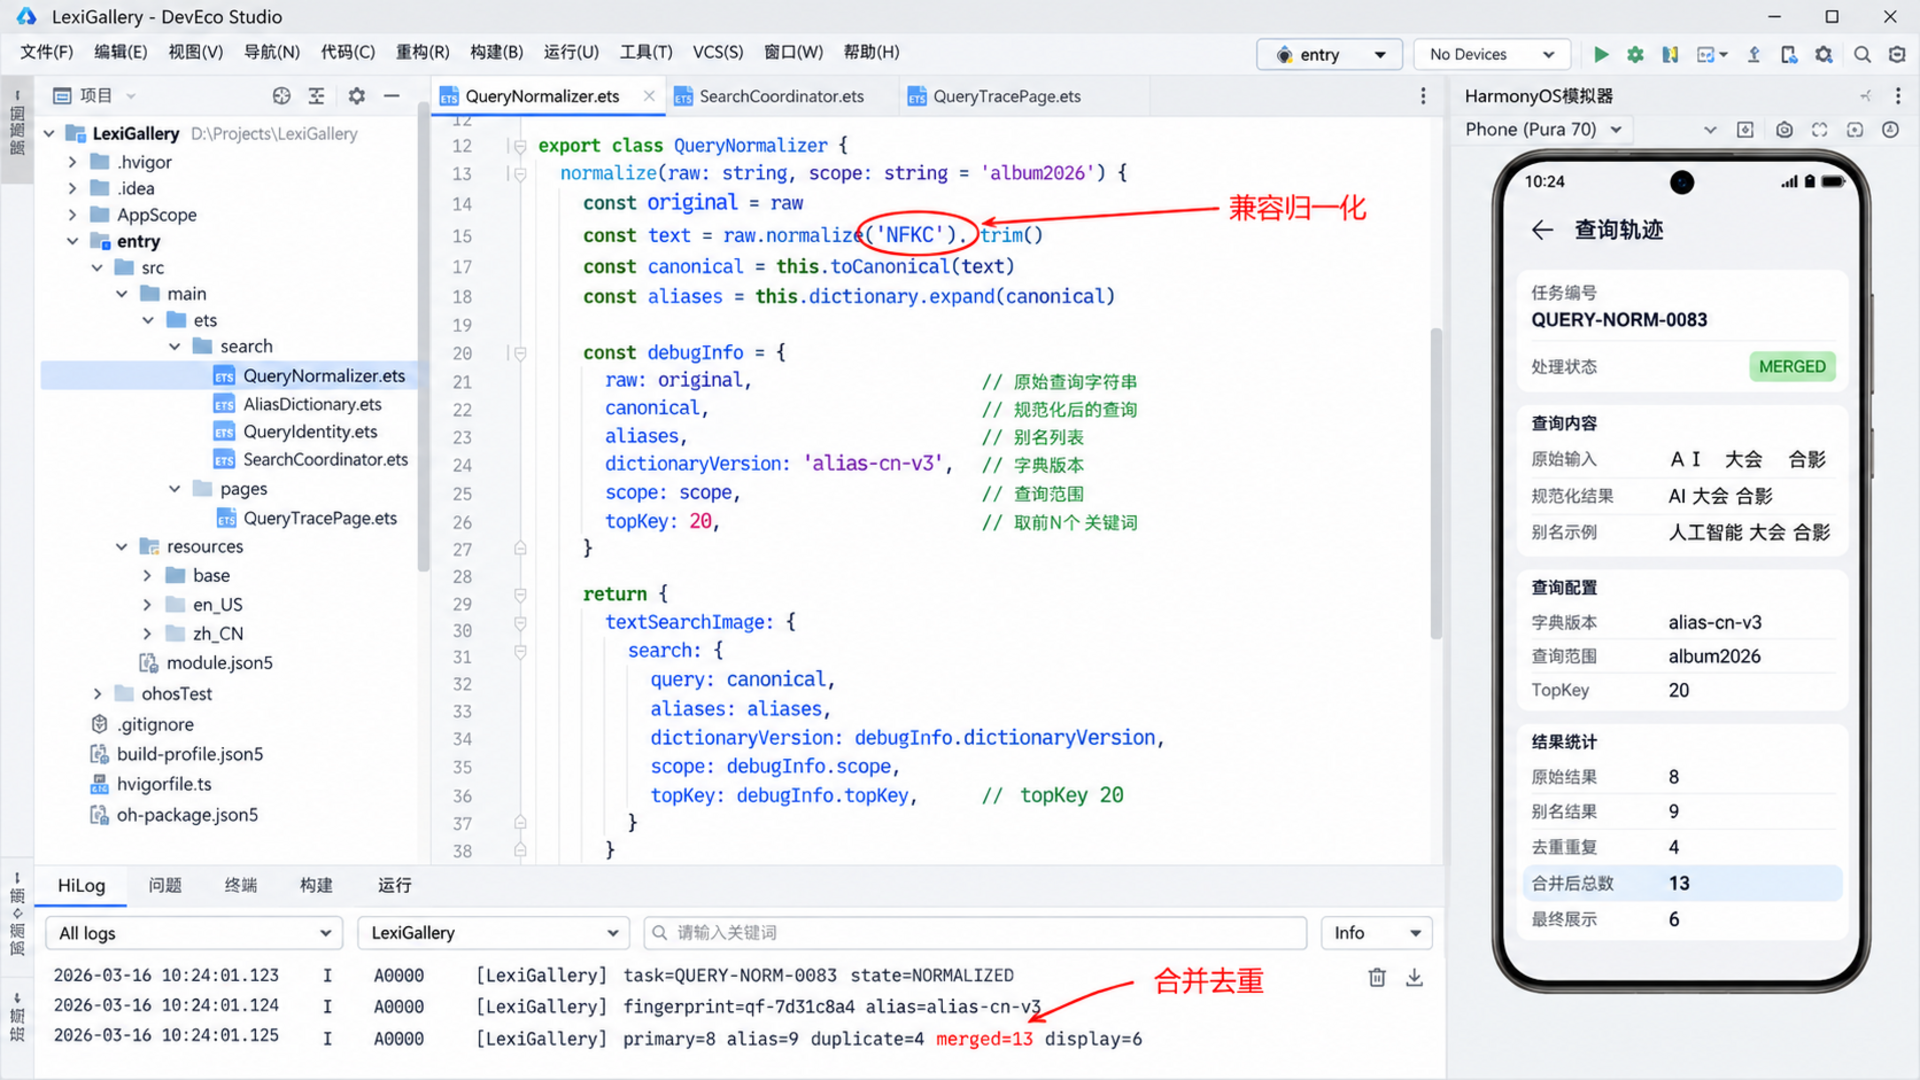
开发图把 QueryNormalizer.ets、AliasDictionary.ets、QueryIdentity.ets 和 SearchCoordinator.ets 放在同一工程中。右侧模拟器显示规范化与两条候选,底部 HiLog 记录指纹、词典版本和合并数量。它是按本文数据制作的演示图,不是实际 DevEco Studio 测试截图。
五、Core Vision Kit 只接收已经确认的候选
查询管线进入 SEARCHING 后,才调用 textSearchImage.search。服务初始化与释放由页面上层的会话持有者管理,不要每个候选都重复 init() 和 release()。两条候选顺序执行的好处是资源可控、日志简单;若并发执行,还要额外处理生命周期与部分失败。
这段代码解决什么问题:在单次服务会话中执行规范化查询和别名补充查询,并用统一结果结构合并。
// search/SearchCoordinator.ets
import { textSearchImage } from '@kit.CoreVisionKit'

interface RankedImage {
  imagePath: string
  similarity: number
  source: 'CANONICAL' | 'ALIAS'
}

export async function runSearch(raw: string): Promise<RankedImage[]> {
  const scope = 'album2026'
  const topKey = 20
  const normalized = normalizeQuery(raw)
  const variants = expandAlias(normalized.canonical)
  validateSearchInput(normalized.canonical, scope, topKey)

  const ready = await textSearchImage.init()
  if (!ready) throw new Error('VISION_INIT_FALSE')
  try {
    const merged = new Map<string, RankedImage>()
    for (const variant of variants) {
      validateSearchInput(variant.text, scope, topKey)
      const items = await textSearchImage.search(variant.text, scope, topKey)
      for (const item of items) {
        const previous = merged.get(item.imagePath)
        if (!previous || item.similarity > previous.similarity) {
          merged.set(item.imagePath, {
            imagePath: item.imagePath,
            similarity: item.similarity,
            source: variant.source
          })
        }
      }
    }
    return [...merged.values()].sort((a, b) => b.similarity - a.similarity).slice(0, 6)
  } finally {
    await textSearchImage.release()
  }
}
try/finally 保证服务在成功、搜索异常或合并异常时都进入释放路径。实际页面若连续搜索,应由明确的会话对象复用初始化状态,并在页面生命周期结束时成对释放;本文为了展示单次任务,把完整生命周期放在函数中。两种写法都要避免“已释放后继续搜索”和“重复初始化未释放”。
合并键使用 imagePath,因为官方结果对象返回沙箱路径、作用域和相似度。相同图片由两条候选命中时保留更高相似度,并记录来源。这里没有把两路相似度相加,因为不同查询下的分数不应在缺少验证的情况下随意累加。
别名查询失败时是否保留主查询结果,要由产品策略决定。LexiGallery 的演示选择:主查询失败则任务失败;别名补充失败则保留主查询结果,但在详情页显示 ALIAS_PARTIAL。不能把部分失败静默包装成完整成功,否则线上召回下降时很难定位。
六、运行页应该同时解释输入和结果
QueryTracePage 的首屏不会只展示六张图片。顶部依次列出原始输入 AI 大会 合影、规范化文本 AI 大会 合影、词典 alias-cn-v3、指纹 qf-7d31c8a4 和当前状态 MERGED。结果区域显示“主查询 8、别名查询 9、合并 13、重复 4、展示 6”。
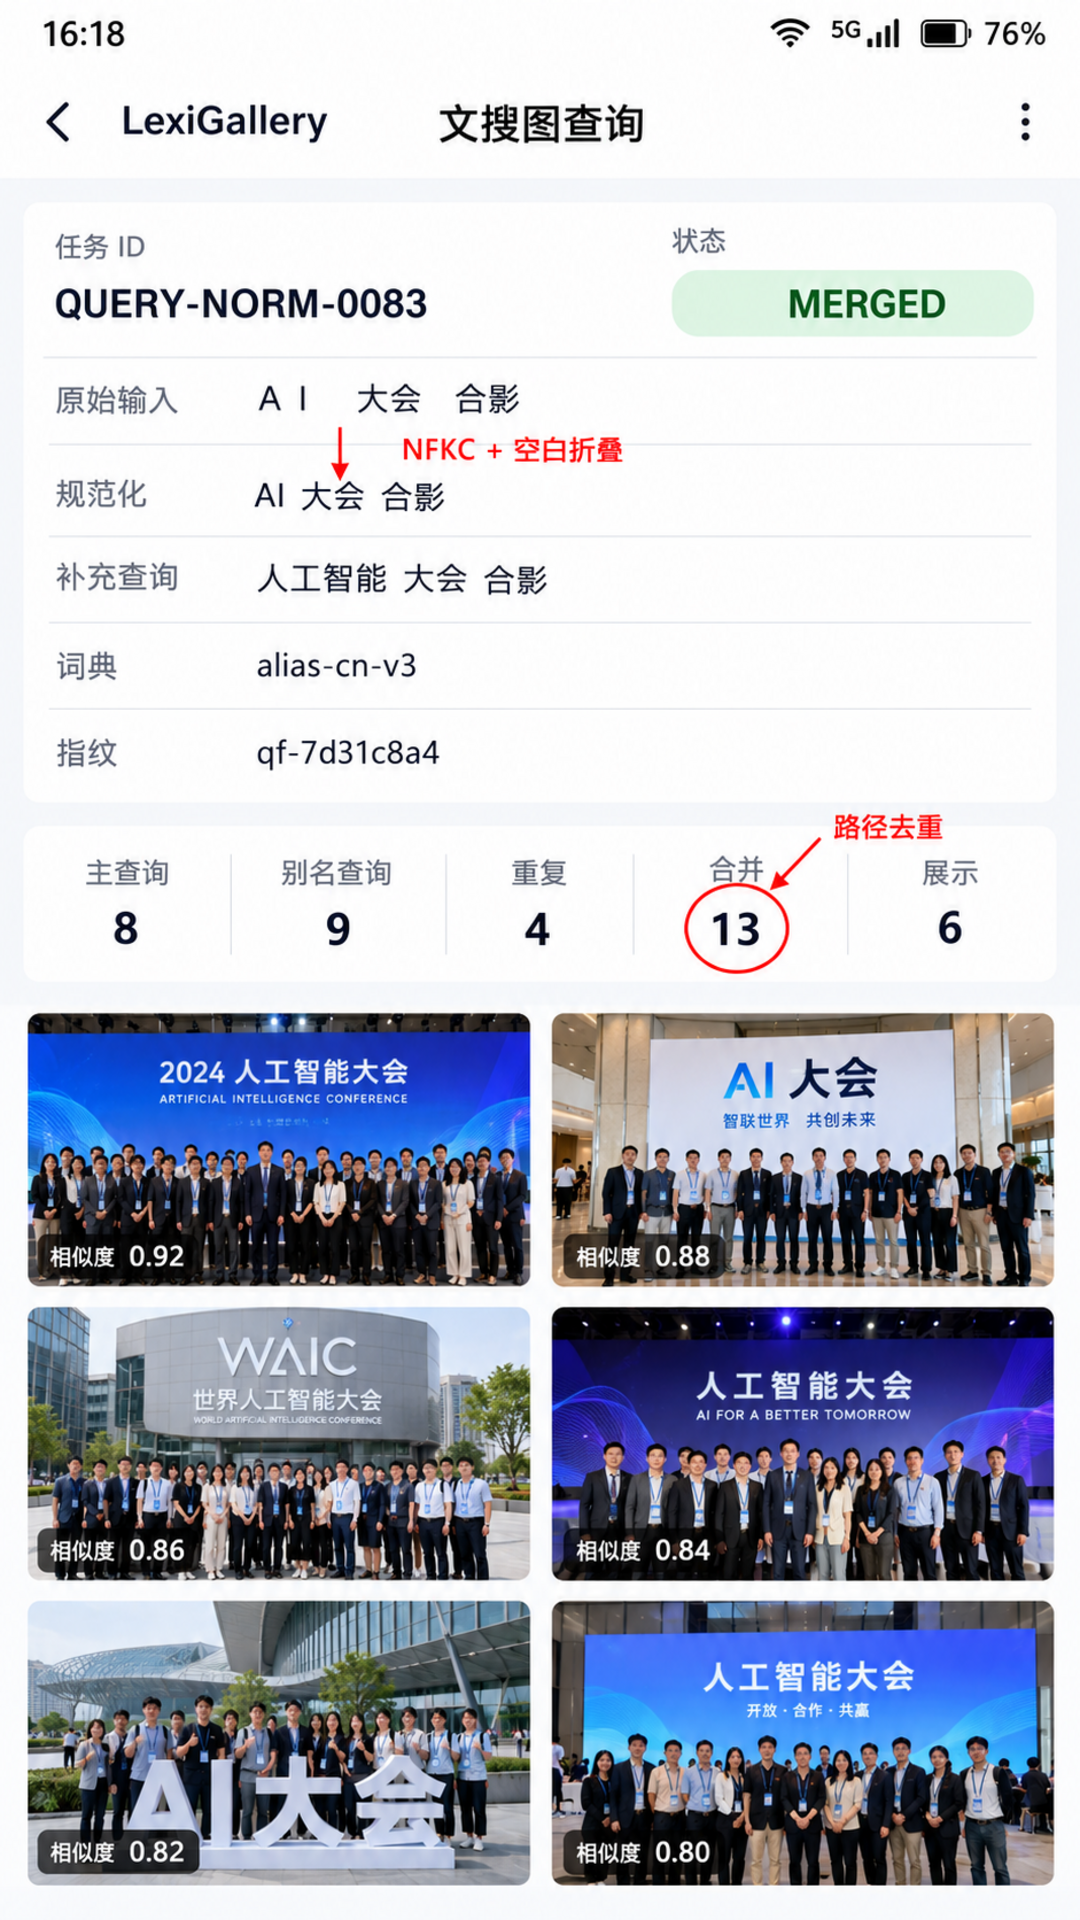
这些数字构成一条可以核对的等式:8 + 9 - 4 = 13,最后再截取 6 条。若界面只写“找到 13 张”,开发者无法判断别名是否真正贡献了新结果;若只写“两路共 17 条”,又会把重复图片算两次。
运行图的状态栏统一为 16:18、Wi‑Fi、5G、信号和 76% 电量。红色箭头只标出规范化前后差异和 alias-cn-v3,红圈用于提示合并后的 13 条,不把每个卡片都画成教学海报。
结果卡片可显示来源标签 CANONICAL 或 ALIAS,但普通用户未必需要看到工程术语。生产界面可以隐藏标签,只在诊断模式中显示。工程可观察性与最终产品体验不必使用同一层 UI。
七、详情页需要保留一条“可回放”的查询轨迹
详情图以时间线展示状态:RAW → NORMALIZED → EXPANDED → SEARCHING → MERGED。16:18:06.104 收到输入,16:18:06.106 完成 NFKC,16:18:06.108 生成两条候选,16:18:06.282 主查询返回 8 条,16:18:06.471 别名查询返回 9 条,16:18:06.476 合并为 13 条并展示 6 条。
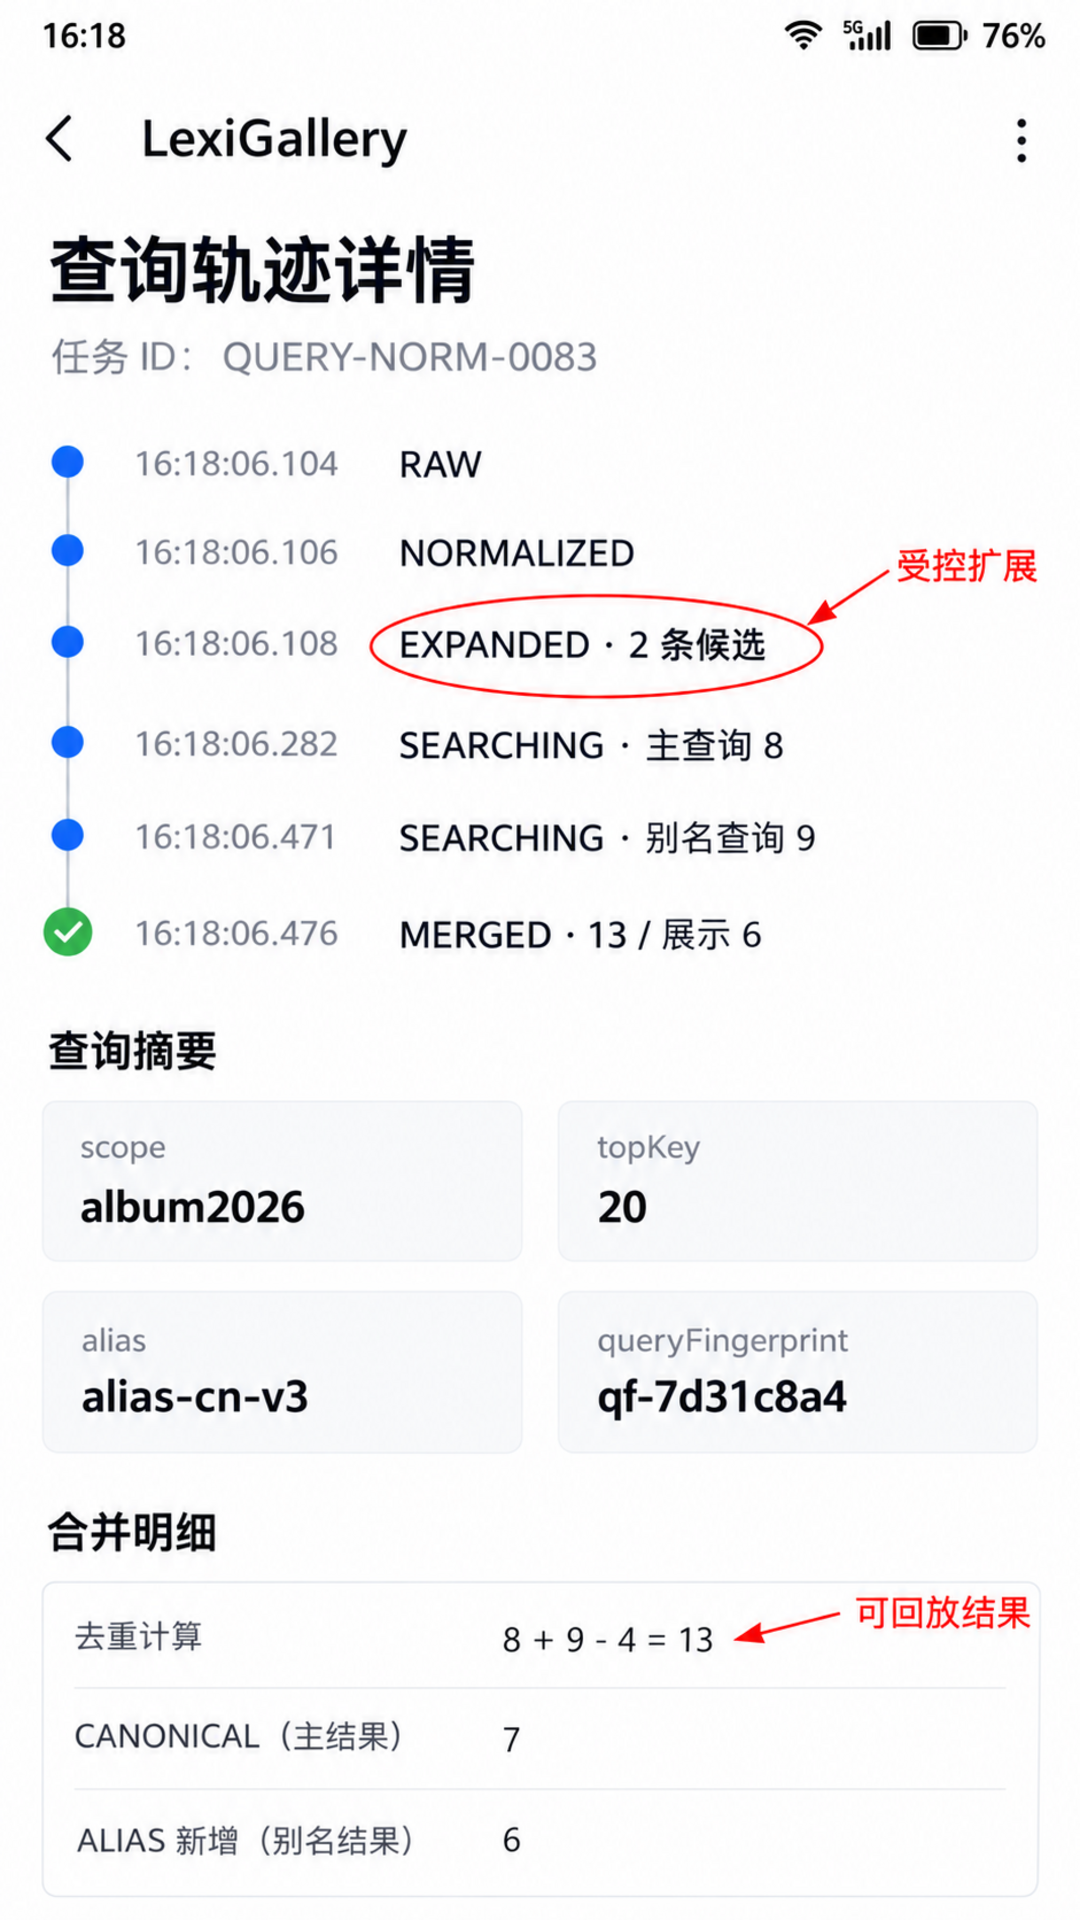
这条轨迹的意义不是证明速度快,而是让问题可复现。若用户反馈“同样输入结果不同”,首先核对 canonicalQuery、scope、aliasVersion 与指纹;若四者一致,再看索引代际和模型版本。本文不重复讨论索引迁移,而是把查询侧事实准备完整。
原始输入不建议长期落盘。日志可以记录字符类别变化,例如 FULLWIDTH_LATIN=2、SPACE_COLLAPSED=2,再记录规范化文本的短指纹。需要展示原文的诊断页面应限制在本地调试或用户主动导出,并在导出前明确提示。
八、五组容易被忽略的边界
第一组是空查询。由若干空白组成的输入在 trim() 后会变成空字符串,必须在调用服务前拒绝。不能把它交给 SDK 再依赖异常兜底,因为界面可以更早给出清晰提示。
第二组是纯字母。AI 规范化后仍是纯字母,不满足当前文档中的查询约束;AI 合影 则包含中文,可以继续。产品可以引导用户补充描述,不应偷偷追加一个无关汉字来绕过限制。
第三组是长度变化。NFKC 后长度可能变化,别名扩展也可能让文本超过 100。每一个候选都要重新校验,不能只检查原始输入。若扩展超限,保留规范化主查询并记录 ALIAS_TOO_LONG 更合理。
第四组是大小写。本文没有统一转小写,因为 AI 与某些缩写可能依赖大写语义,模型也可能有自己的处理。是否折叠大小写应由离线查询集验证,而不是照搬传统数据库搜索习惯。
第五组是重复别名。如果别名替换后与主查询相同,不应再次调用服务。候选生成后先按完整文本去重,可以避免无意义请求,也让“候选 2”真正表示两种不同语义表达。
九、如何验证归一化没有伤害召回
这类改动不能只看几个漂亮示例。建议维护一组黄金查询对,每组包含原始输入、期望规范化文本、是否允许别名、预期包含的图片 ID 和不应出现的图片 ID。全角、连续空格、复制粘贴标点、混合中英文和超长别名都要覆盖。
验收时分别运行“仅规范化”和“规范化加别名”两条管线,比较前六结果的命中、重复数和新增结果。别名带来更多结果不等于质量更好;如果新增项大多是无关图片,就应该删除规则或缩小适用作用域。
词典升级也要可回滚。alias-cn-v4 发布前保存黄金集结果摘要,若线上诊断发现某些查询偏移,可以暂时切回 v3。回滚的是应用层词典,不需要把 Core Vision Kit 的索引清空。两类版本的职责不同,不应混在一个开关里。
性能方面,第二条查询会增加一次端侧检索开销。可以只对高价值、低歧义别名启用,并限制候选数。缓存必须以包含词典版本和作用域的指纹为键,缓存命中后仍要确认索引代际是否匹配;否则旧结果会在图库变化后继续出现。
十、结论:先稳定输入,再讨论模型结果
LexiGallery 的核心不是给搜索框加一层“智能改写”,而是把不可见的字符差异变成可观察、可版本化、可回放的工程事实。原始输入 AI 大会 合影 经 NFKC 和空白折叠成为 AI 大会 合影,再由 alias-cn-v3 生成补充查询 人工智能 大会 合影。
两路结果 8 与 9 经过路径去重得到 13,重复项 4,最终展示 6。任务状态从 RAW 走到 MERGED,每一步都有输入、规则和数量。这样做不能保证所有查询都更准确,却能保证结果变化有迹可循,也能让别名策略在伤害召回时及时退出。
实际项目应继续关注模型与索引版本,但不要让“模型会理解”成为忽略字符串边界的理由。语义检索的上游仍然是文本,文本工程的细节会决定同一个意图是否进入同一条路径。
十一、规则变更需要自己的审计轨迹
查询归一化常被当作一个工具函数,改完正则就直接发布。真正进入产品后,它更像一份小型协议:输入字符如何收敛、哪些词允许扩展、生成几条候选、失败时是否降级,都可能改变结果。因此每次修改都应有规则版本、变更说明和黄金查询回归。
建议把归一化版本与别名版本分开。NFKC 和空白折叠可以标记为 normalize-v1,词典使用 alias-cn-v3。如果只更新“团建”的别名,不应让所有查询指纹都看起来像归一化算法发生了变化;反过来,若空白规则改变,也不能只提升词典版本掩盖影响范围。
发布报告至少列出三类差异:规范化文本发生变化的查询数、候选数量发生变化的查询数、前六结果发生变化的查询数。三者逐层收窄,可以看出改动究竟停留在字符串层,还是已经影响用户看到的图片。结果变化并不必然是坏事,但必须能解释。
回滚也要避免半新半旧。若界面加载了 v3 词典,后台缓存仍按 v2 指纹读取,就会出现日志与结果不一致。规则配置、指纹材料和缓存命名空间应作为一个发布单元切换;切换失败时恢复整个单元,而不是只替换词典文件。
对于远程下发词典,还要校验文件完整性、大小和结构,并保留上一份可用版本。本文不展开远程配置 API,重点是边界:未通过校验的词典不能进入查询主链,下载失败时继续使用已验证版本,并在诊断页显示实际生效版本。
十二、面向用户的改写提示应当克制
别名扩展发生在应用内部时,用户可能不知道系统实际搜索了两句话。如果扩展结果占比很高,界面可以显示“同时尝试:人工智能 大会 合影”,并允许关闭补充结果。这样既解释了召回来源,也给用户纠正错误别名的机会。
提示不应伪装成用户输入。搜索历史记录保存规范化原文 AI 大会 合影,补充候选作为附属信息;否则用户再次点击历史时,会误以为自己输入过“人工智能”。原始全角文本是否保留则取决于产品需求,通常只需在当前编辑会话中回显。
如果规范化后文本为空、过长或仍是纯字母,错误提示要对应真实原因。例如“请补充中文场景描述”比“搜索失败”更有帮助。服务异常与输入不合法也要区分:前者可以重试,后者需要用户修改内容。错误分类清楚,才能避免无意义的重复调用。
最后,查询改写不是纠正用户语言。别名只用于提升特定图库中的检索覆盖,不应该把方言、少数语言表达或个人称呼强行替换成所谓标准说法。规则越接近用户表达,就越需要保留退出通道和人工复查样本。
十三、参考资料
- 华为开发者联盟:textSearchImage(通过文本搜索图片)API,https://developer.huawei.com/consumer/cn/doc/harmonyos-references/core-vision-text-search-image-api
- 华为开发者联盟:Harmony Intelligence AI 开放能力与服务一览,https://developer.huawei.com/consumer/cn/harmonyos-ai
- 华为开发者联盟:HarmonyOS 7 文搜图专题,https://developer.huawei.com/consumer/cn/forum/topic/0203220028018131387

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 5
 0
- 0


 已为社区贡献6条内容

所有评论(0)