
HarmonyOS 7 + Node.js-fast-xml-parser:RSS-Atom 源结构漂移的规范化与实体门禁【鸿蒙心迹】
示例项目:FeedFence
页面:FeedImportPage
订阅源在浏览器里能打开,不代表它适合直接交给应用解析。RSS 里只有一条 item 时可能被解析成对象,多条时又变成数组;Atom 使用 entry、link@href 和命名空间;有的源把日期、ID、价格样式的文本自动转成数值。真正危险的不是某一条字段缺失,而是数据结构在版本和来源之间悄悄漂移。
FeedFence 把 fast-xml-parser 放在构建期 Node.js 工具中,而不是宣称该包已经成为 HarmonyOS 系统 API。工具先限制输入、验证 XML,再把 RSS/Atom 收敛成项目自己的 JSON;HarmonyOS 应用只读取打包后的 catalog.json。这样第三方解析器的版本、选项和异常不会直接进入运行时页面。
一、把不稳定 XML 留在构建边界之外
示例任务为 FEED-NORM-0075,输入文件 tech-weekly.xml,大小 184 KB,识别为 Atom 1.0。原始包含 42 条 entry,规范化后保留 40 条:1 条因为 ID 重复被拒绝,1 条因为缺少可用链接被拒绝。最终状态为 RAW_FETCHED → PREFLIGHT_OK → XML_VALID → NORMALIZED → BUNDLE_READY。
如果在应用启动时直接抓取并解析 XML,页面就必须同时处理网络、编码、XML 语法、RSS/Atom 差异、字段类型和渲染状态。任一异常都可能把“订阅源不可用”扩散成启动白屏。构建期规范化并不适合所有实时订阅场景,但对课程目录、官方资讯精选或随版本发布的内置源,它能显著缩小运行时边界。
本文固定最大输入 512 KB、最多 200 条、单条正文摘要最多 20 KB。这些都是 FeedFence 的产品限制,不是 fast-xml-parser 或 HarmonyOS 的平台上限。示例进度 96% 用于诊断页回放,不代表真实构建耗时。
二、第一道门不是解析,而是拒绝不需要的语法
FeedFence 不需要 DTD 和自定义实体,因此在进入解析器前直接拒绝 <!DOCTYPE 与 <!ENTITY。即使第三方库具备自己的实体处理策略,项目也没有理由接受业务不使用的语法。再配合字节上限,可以把异常膨胀和巨型输入挡在更靠前的位置。
这段代码解决什么问题。 它在 XML 验证和解析前建立输入体积、编码与实体语法门禁。
import { readFile } from 'node:fs/promises'

const MAX_BYTES = 512 * 1024
const forbiddenMarkup = /<!\s*(DOCTYPE|ENTITY)\b/i

interface RawFeed {
  path: string
  bytes: number
  xml: string
}

async function readFeed(path: string): Promise<RawFeed> {
  const data = await readFile(path)
  if (data.byteLength === 0 || data.byteLength > MAX_BYTES) {
    throw new Error(`FEED_SIZE_OUT_OF_RANGE:${data.byteLength}`)
  }
  const xml = new TextDecoder('utf-8', { fatal: true }).decode(data)
  if (forbiddenMarkup.test(xml)) {
    throw new Error('DTD_OR_ENTITY_NOT_ALLOWED')
  }
  return { path, bytes: data.byteLength, xml }
}
fatal: true 让非法 UTF-8 明确失败,避免替换字符悄悄进入 ID 和链接。状态只有在 size、编码和 forbidden markup 都通过后,才从 RAW_FETCHED 进入 PREFLIGHT_OK。任何失败都保留错误类别,不把它伪装成“0 条订阅”。
正则不是通用 XML 安全解析器,这里只用于项目主动禁用的两个声明。业务若必须支持 DTD,不应简单删除这道门,而要重新评估解析器版本、实体限制和输入信任边界。最安全的配置不是“选项越多越好”,而是只接受产品确实需要的语法。
三、验证与解析要使用同一份原始文本
fast-xml-parser 官方项目提供 XML 验证、解析与构建能力。FeedFence 先用 XMLValidator.validate 做语法验证,再用显式选项创建 XMLParser。标签值保持字符串,属性不丢弃,数组形态由 jPath 规则固定,避免一条 entry 与多条 entry 产生两种类型。
这段代码解决什么问题。 它锁定解析选项,并让 RSS item 与 Atom entry 无论数量多少都得到数组。
import { XMLParser, XMLValidator } from 'fast-xml-parser'

function parseXml(xml: string): unknown {
  const validation = XMLValidator.validate(xml)
  if (validation !== true) {
    throw new Error(`XML_INVALID:${validation.err.line}:${validation.err.msg}`)
  }

  const parser = new XMLParser({
    ignoreAttributes: false,
    attributeNamePrefix: '@_',
    parseTagValue: false,
    parseAttributeValue: false,
    trimValues: true,
    isArray: (_name: string, jPath: string) =>
      jPath === 'rss.channel.item' || jPath === 'feed.entry' ||
      jPath.endsWith('.link')
  })
  return parser.parse(xml)
}
parseTagValue:false 很关键。订阅 ID 00123、版本号 1.00 和长数字都应先按文本进入规范化层;是否转成数值由业务字段决定,而不是解析器猜测。RSS 与 Atom 的 link 也强制为数组,因为 Atom 常有 alternate、self 等多个链接。
版本要锁定在项目依赖文件与 lockfile 中。本文不写死某个当前版本号,避免把时间敏感信息变成长期结论;升级库时必须用黄金样本重跑输出摘要。开发者还应以当前官方文档核对选项名称,不能直接复制旧版本示例。
四、先识别协议,再进入各自的适配器
解析结果仍是 unknown。FeedFence 不让页面代码通过可选链到处猜结构,而是在构建脚本中识别根节点:存在 rss.channel 走 RSS 适配器,存在 feed.entry 走 Atom 适配器,其余格式直接拒绝。每个适配器只负责读取原协议,最终都输出同一个 FeedEntry。
适配器把两种协议都转换为同一份 FeedEntry:id、title、link、publishedAt 与 summary 全部先保持字符串。Atom 会优先选择 rel=alternate 的链接,没有时再取第一条;RSS 则从 guid/link/pubDate/description 映射。缺少最小字段时,外层根据检查位置记录 MISSING_ID 或 MISSING_LINK。不要把所有异常都吞成 undefined,否则构建报告无法解释为什么 42 变成 40。
正文摘要超过 20 KB 时,本文选择拒绝而不是截断。截断 XML/HTML 片段可能破坏语义,也可能留下半个实体。若产品允许截断,应在去标签和字符归一化之后按代码点处理,并把 truncated=true 写入模型。
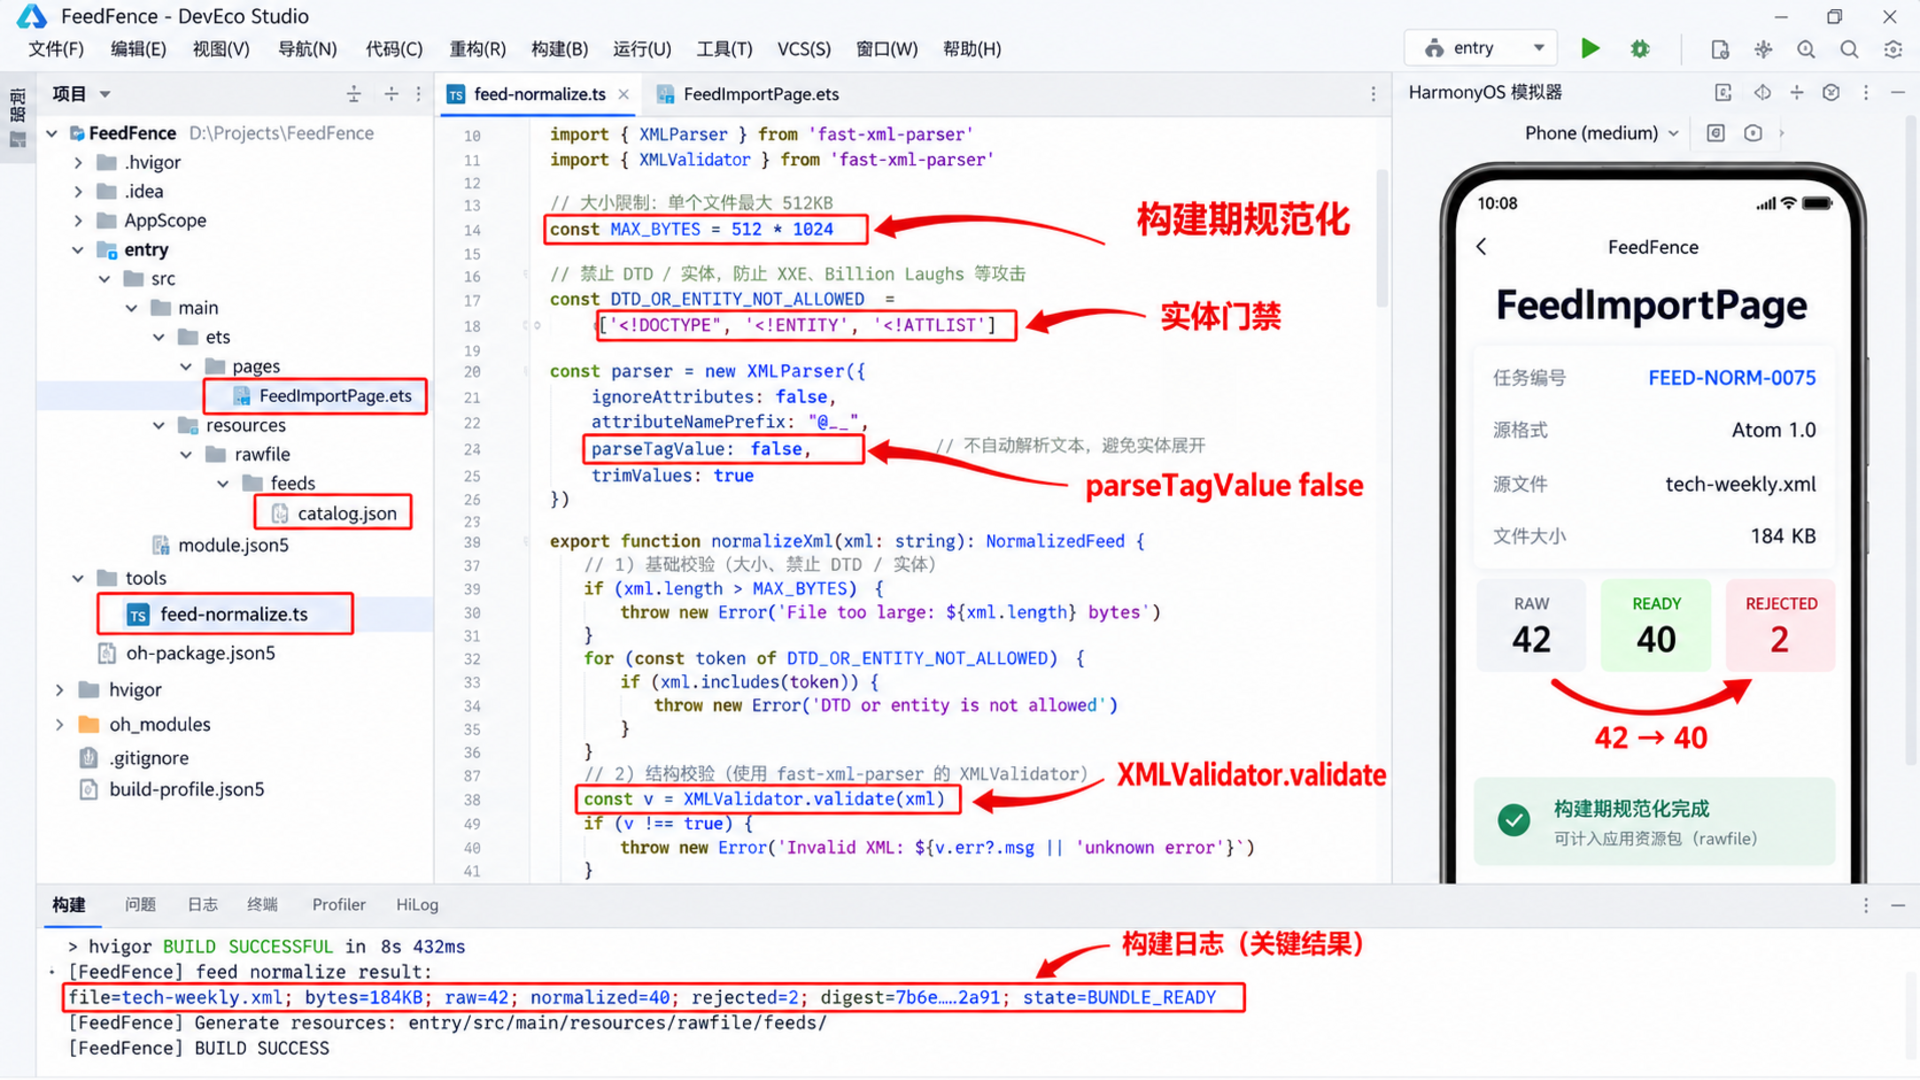
DevEco Studio 风格配图展示 FeedFence 的构建期流程:左侧工程树包含 tools/feed-normalize.ts 与 rawfile 输出,中间圈出实体门禁、parseTagValue:false 和数组规则,右侧模拟器展示 40 条已打包资讯,底部日志对应 raw=42 normalized=40 rejected=2 digest=7b6e…2a91。这是一张演示图,不是实际 IDE 或审核证据。
五、重复 ID 不能靠数组去重悄悄覆盖
订阅源可能把同一条内容重复返回,也可能两条内容共用空 ID。使用 Map 直接 set(id, item) 会让后一条静默覆盖前一条,最终数量看起来正确,却丢失了异常证据。FeedFence 对第一次出现的 ID 建立索引,后续重复项进入 reject 列表。
这段代码解决什么问题。 它执行条目上限、字段长度、重复 ID 和链接协议检查,并生成稳定诊断摘要。
const MAX_ENTRIES = 200
const MAX_SUMMARY_CHARS = 20 * 1024

function validateEntries(items: FeedEntry[]): {
  accepted: FeedEntry[], rejected: RejectItem[]
} {
  const accepted: FeedEntry[] = []
  const rejected: RejectItem[] = []
  const ids = new Set<string>()

  items.slice(0, MAX_ENTRIES).forEach((item, index) => {
    let reason: RejectItem['reason'] | undefined
    if (!item.id) reason = 'MISSING_ID'
    else if (!/^https:\/\//i.test(item.link)) reason = 'MISSING_LINK'
    else if (ids.has(item.id)) reason = 'DUPLICATE_ID'
    else if (item.summary.length > MAX_SUMMARY_CHARS) reason = 'TEXT_TOO_LONG'

    if (reason) rejected.push({ index, reason })
    else {
      ids.add(item.id)
      accepted.push(item)
    }
  })
  return { accepted, rejected }
}
链接策略只接受 HTTPS,这是 FeedFence 的发布资产规则,不是 RSS/Atom 标准要求。如果产品需要离线相对链接或其他 scheme,应通过显式白名单扩展。最多 200 条也要在报告里注明:若输入超过上限,应该生成 ENTRY_LIMIT_EXCEEDED,而不是无声切片;示例为简化展示了 slice,生产实现需在切片前判断长度。
本批 42 条中,索引 17 因 DUPLICATE_ID 拒绝,索引 31 因 MISSING_LINK 拒绝,最终 accepted=40。DOCTYPE/ENTITY 命中数为 0,说明门禁存在但样本没有触发,不能写成“已经验证恶意输入安全”。
六、输出 JSON 要绑定输入摘要和工具事实
规范化文件不仅包含 entries,还应有 manifest:任务 ID、输入文件、字节数、格式、输入摘要、工具配置版本、原始数量、接受数量和拒绝列表。页面加载时显示这份 manifest,能区分“源本来只有 40 条”和“42 条里拒绝了 2 条”。
摘要 7b6e…2a91 用于识别本批输入,不是签名,也不证明来源可信。若订阅源来自网络,构建系统还应固定下载地址、证书策略和缓存事实;如果源内容变化,应产生新摘要并重新走完整门禁。
输出路径为 entry/src/main/resources/rawfile/feeds/catalog.json。写入时先生成临时文件,完成 JSON 序列化和摘要后再原子替换,避免构建中断留下半份文件。CI 应把 rejected>0 设为警告还是失败,由发布策略决定;本文允许两条已解释拒绝项继续生成包,但不允许未知错误继续。
七、HarmonyOS 页面只消费稳定 JSON
运行时应用不再依赖 XML 解析器。FeedImportPage 通过 ResourceManager 读取 rawfile,TextDecoder 解码为 JSON,再映射为页面状态。页面无需知道 RSS、Atom、命名空间或实体语法,只处理 FeedBundle。
这段代码解决什么问题。 它让 ArkTS 页面只加载已经规范化的 JSON 资产,并对任务与条目数做最小事实校验。
import { resourceManager } from '@kit.LocalizationKit'

interface FeedBundle {
  taskId: string
  format: string
  sourceBytes: number
  rawCount: number
  acceptedCount: number
  rejected: RejectItem[]
  digest: string
  entries: FeedEntry[]
}

async function loadFeedBundle(rm: resourceManager.ResourceManager): Promise<FeedBundle> {
  const bytes = await rm.getRawFileContent('feeds/catalog.json')
  const text = new TextDecoder('utf-8', { fatal: true }).decode(bytes)
  const parsed = JSON.parse(text) as FeedBundle
  if (parsed.taskId !== 'FEED-NORM-0075' || parsed.entries.length !== 40) {
    throw new Error('FEED_BUNDLE_FACT_MISMATCH')
  }
  return parsed
}
这段运行时代码解决的是“读取已规范化资产”,不重复实现构建门禁。页面状态从 LOADING 进入 READY;解析失败、字段不匹配或条目数不符时进入 BLOCKED,并显示内置源不可用,而不是展示空白列表。
资源读取发生在页面或仓库层的明确生命周期中,不注册长期监听。若页面销毁时异步读取尚未返回,可以用 generation 拒绝旧结果提交;bytes 和 text 只在加载阶段存在,完成模型转换后释放引用,避免在状态中长期保存原始大字符串。
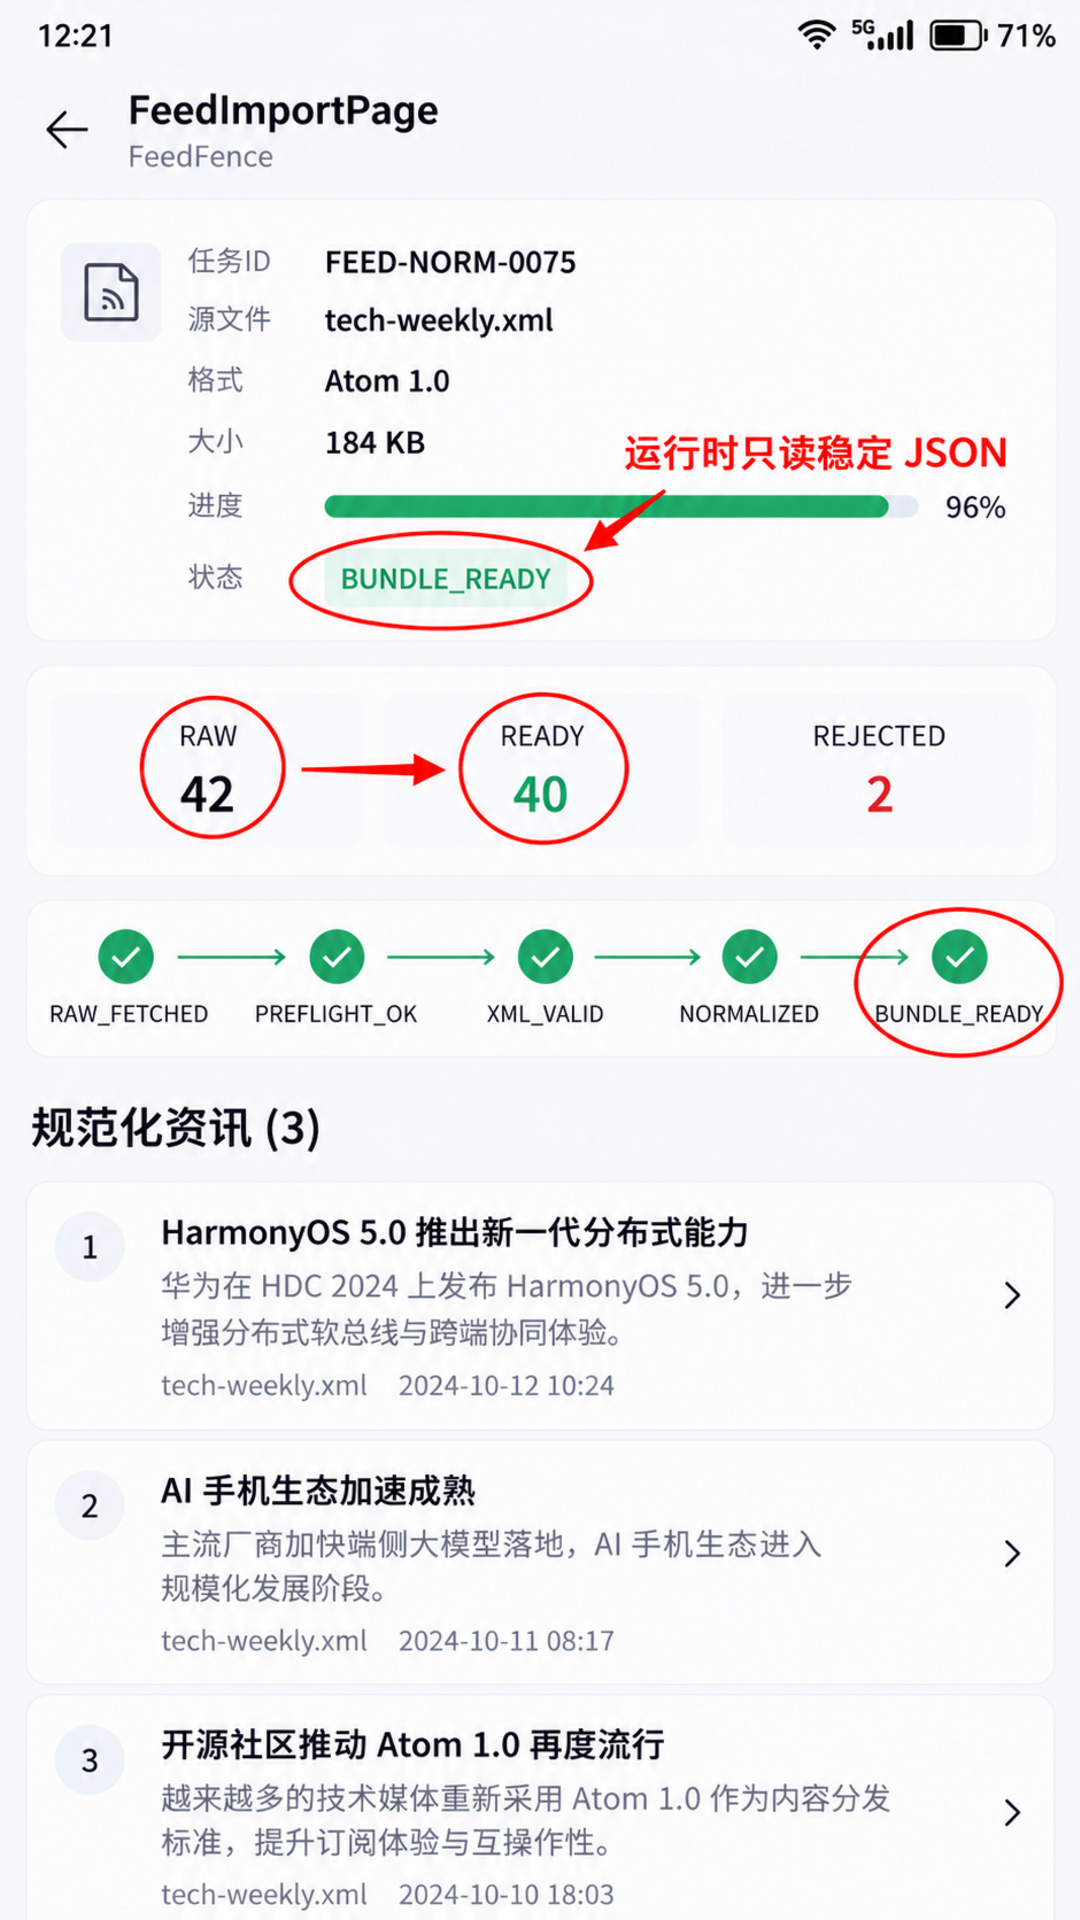
运行图时间 12:21、电量 71%,任务 FEED-NORM-0075,源 tech-weekly.xml,格式 Atom 1.0,184 KB。页面显示进度 96%、RAW 42、READY 40、REJECTED 2、状态 BUNDLE_READY,并展示构建后的资讯列表。这些数据与正文和日志一致。
八、拒绝项页面比“导入失败”更有用
开发者看到 40 条列表时,很容易忽略被拒绝的两条。FeedFence 提供诊断页,按索引、reason 和可公开的字段摘要展示异常。它不会展示完整正文,也不会把未经清洗的 XML 放进页面。
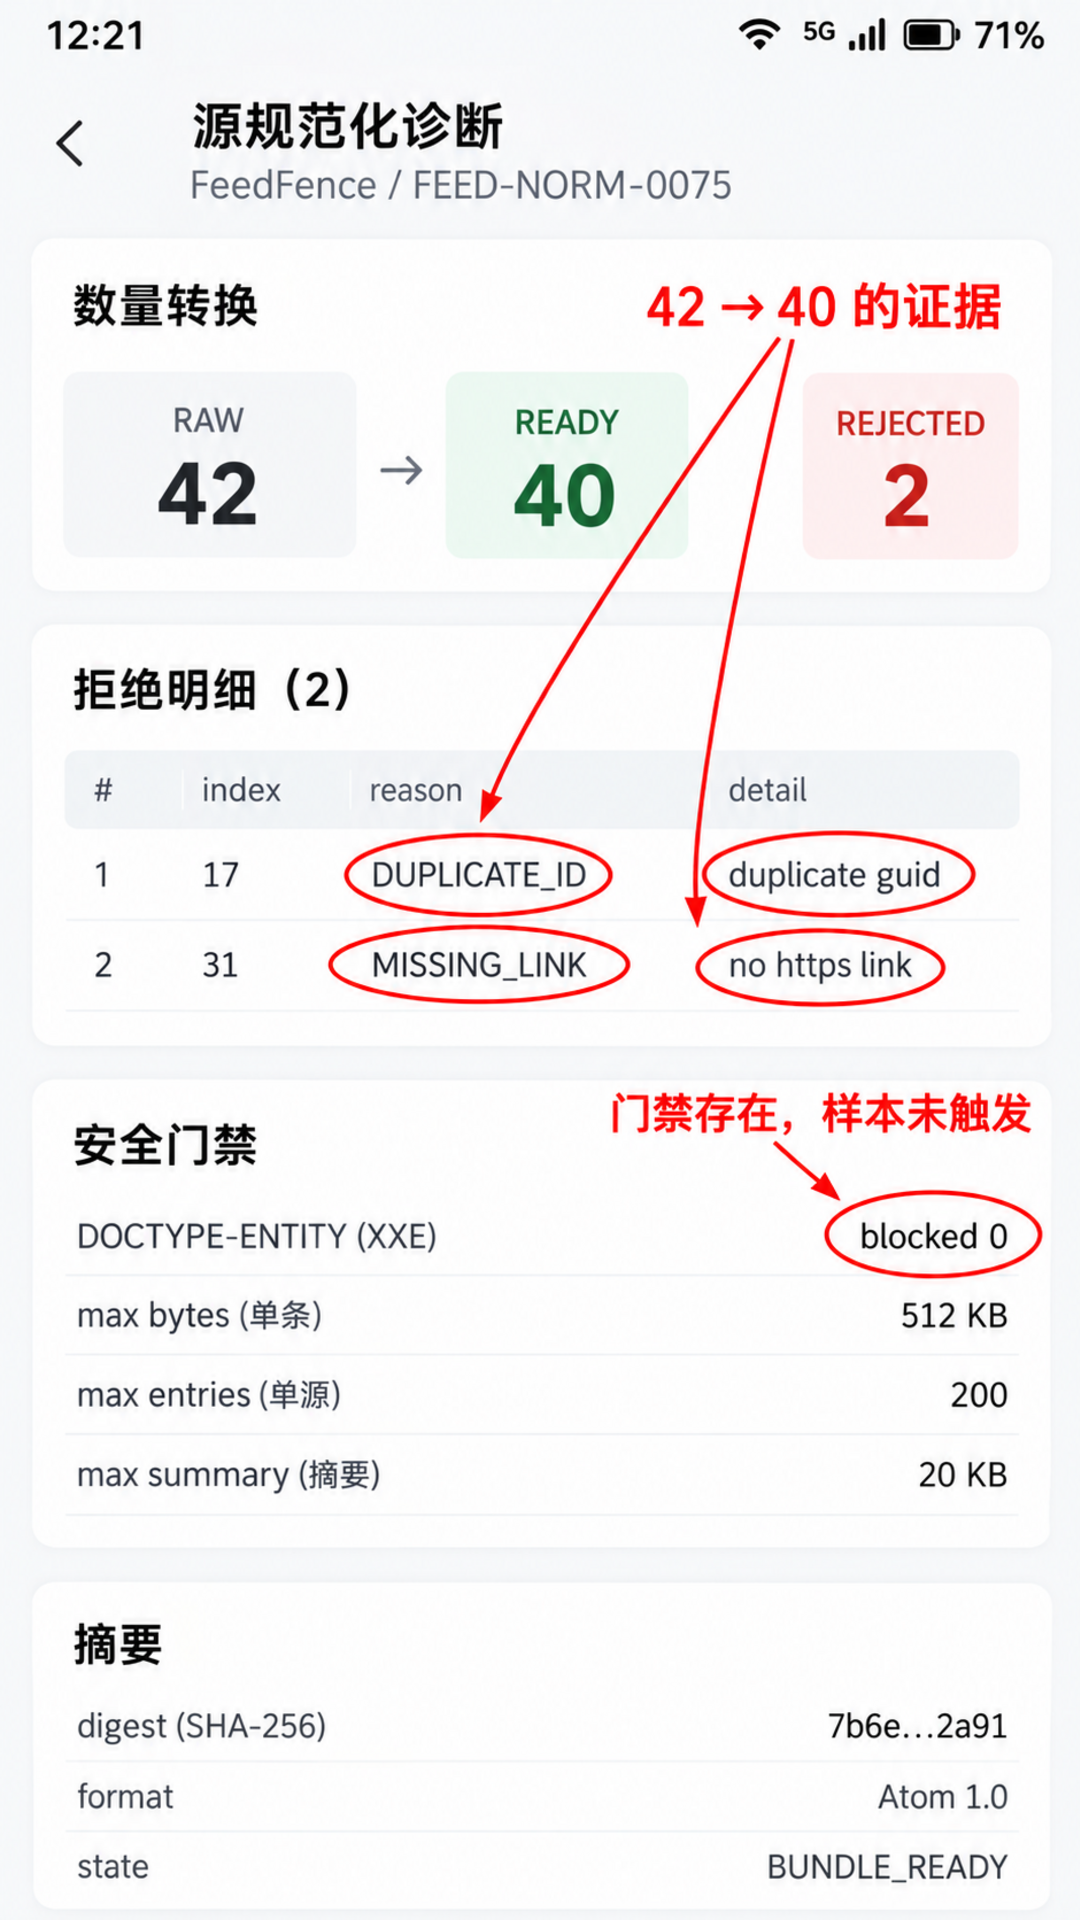
图中索引 17 为 DUPLICATE_ID,索引 31 为 MISSING_LINK;实体门禁显示 DOCTYPE/ENTITY blocked: 0,输入摘要为 7b6e…2a91。红色箭头把两个拒绝原因与 42 → 40 的数量变化连接起来,使“少了两条”变成可解释结论。
诊断页还显示限制:512 KB、200 entries、20 KB summary。它承担技术解释,不是审核结果页面。发布时是否允许 rejected=2,应由当前策略 ID 决定;如果这两条对应关键公告,构建即使技术上能完成,也可能需要人工阻断。
九、黄金样本要覆盖结构漂移而非只测一个文件
测试至少准备六类输入:单条 RSS item、多条 RSS item、Atom 多 link、带命名空间前缀、重复 ID、缺少链接。再加入超过 512 KB、非法 UTF-8、DOCTYPE、ENTITY、超过 200 条和超长摘要。每个样本固定期望状态、接受数量、拒绝 reason 与输出摘要。
升级 fast-xml-parser 后,先在锁定依赖的独立分支运行黄金样本。如果 parseTagValue、数组策略或属性表示变化,即使构建没有报错,也应通过快照差异阻断合并。第三方库升级不是只看 API 能否编译,还要看语义输出是否改变。
真实网络源还应保存脱敏后的最小失败样本。不要把完整订阅内容直接提交到仓库;可以裁剪到刚好复现结构漂移的一两条记录,并删除与问题无关的正文。这样既能复现,也能控制版权与隐私风险。
1. 下载过程也要形成可核对的输入事实
如果 XML 来自网络,RAW_FETCHED 不能只表示 HTTP 请求返回。构建器需要记录最终 URL、响应状态、Content-Type、Content-Length、ETag 或 Last-Modified、下载字节数和摘要。发生重定向时还要限制次数,并检查最终地址仍在允许域名范围内,避免配置错误把构建器带到意外来源。
Content-Length 只能用于前置判断,不能替代实际读取上限。服务端可能不提供该字段,也可能声明值与实际流量不一致;下载器应边读边累计,超过 512 KB 就中止,不把完整大文件写入磁盘后再报错。压缩响应还要区分传输字节与解压后字节,FeedFence 的上限针对实际送入解析器的文本大小。
缓存命中也必须可见。若构建网络失败而退回昨日缓存,manifest 应标明 source=cache 与缓存年龄,不能继续显示 RAW_FETCHED 让发布者误以为内容已更新。是否允许陈旧缓存由策略决定,关键公告源可以失败即阻断,普通资讯源可以在明确提示后使用缓存。
2. 命名空间前缀不能成为业务字段
Atom、RSS 扩展经常使用 content:encoded、media:thumbnail 一类命名空间字段。不同源可能为同一 URI 使用不同前缀,因此业务适配器不应把某个前缀字符串当成永久协议。更稳妥的做法是限定当前支持的扩展,并在黄金样本中覆盖前缀变化;未识别扩展只作为可选信息忽略,不影响最小 FeedEntry。
核心字段与扩展字段也应分层。ID、标题、链接和时间决定条目能否进入列表;图片、作者头像和分类标签属于增强信息,缺失时可以降级。若把所有字段都设为必需,一个无关的 media 扩展变化就会让整条资讯被拒绝。
对于 HTML 内容,解析 XML 成功不代表可以直接渲染。摘要里可能包含标签、内联样式或外链资源。FeedFence 在构建期只保存项目允许的纯文本摘要或经过独立清洗的结构;本文没有实现 HTML 清洗,因此不能把原始 content 节点直接交给 ArkWeb 或富文本组件。
3. 日期规范化要区分“无效”和“缺失”
RSS 的 pubDate 常见 RFC 822 风格,Atom 的 updated/published 通常采用 ISO 8601。将两者统一成 UTC 字符串之前,应保留原始值并记录解析结果。字段缺失可以按产品规则使用抓取时间,无效日期则更像源数据错误,两者不能都静默变成当前时间。
使用当前时间兜底尤其危险:每次构建都会让旧文章看起来像新内容,列表排序随构建时间改变,输出摘要也失去确定性。FeedFence 对缺失日期采用空值并把排序放到有日期的条目之后;对无效日期记录 INVALID_DATE,是否拒绝由策略决定。
时区偏移也不能丢。2026-10-01T12:21:00+08:00 与 UTC 表示是同一瞬间,规范化后可以统一存储 ISO UTC,但诊断报告仍应保留原始字符串。这样当源端时区写错时,开发者有证据回查,而不是只看到转换后的结果。
4. 输出必须确定,才能让差异有意义
同一输入、同一依赖锁和同一策略应产生字节级一致的 catalog.json。为此,条目排序不能依赖对象遍历偶然顺序,manifest 也不能写入每次变化的当前时间后再参与摘要。FeedFence 先按 publishedAt、id 建立稳定排序,JSON 使用固定缩进和换行,摘要只覆盖确定字段。
构建时间可以存在外层报告中,但不应让资源文件每次无意义变化。否则版本控制会显示整包更新,缓存也无法复用。拒绝项同样按原始 index 排序,reason 使用固定枚举,不把运行环境中的异常堆栈写进最终 JSON。
确定性还帮助定位第三方库升级。如果输入摘要不变、策略不变,输出摘要却变化,CI 可以立即要求查看 diff。变化可能来自数组策略、空白处理或属性表示,开发者可以在发布前确认,而不是等应用列表顺序异常后追查。
5. CI 门禁要区分错误、警告和观察项
不是所有 rejected 都应返回同一个退出码。DTD/ENTITY、非法编码、XML 语法错误、输入超限属于阻断错误;重复 ID、缺失可选摘要可以是警告;未知命名空间或内容数量下降则作为观察项。FeedFence 用策略文件把 reason 映射到 severity,而不是在脚本里散落 if。
本例的 DUPLICATE_ID 与 MISSING_LINK 被设置为警告,因此仍生成 40 条资源;若任一 critical 出现,状态不会进入 BUNDLE_READY,也不会覆盖上一次已验证的 catalog.json。CI 最终同时输出人读摘要和机器可读报告,便于本地与流水线使用同一规则。
数量下降也值得门禁。上一次 accepted=120,本次突然变成 4,即使每条都合法,也可能是上游分页、权限或源地址变化。可以设置相对波动阈值,并要求人工确认。这个规则属于发布健康度,不属于 XML 语法,但放在同一证据链上更容易解释。
6. 第三方依赖升级要带着锁文件和样本一起评审
仅修改 package.json 的版本范围不足以说明升级影响。评审应同时看到 lockfile 变化、官方发布说明、黄金样本结果、输出 diff 和构建体积。若库从 CommonJS 切换 ESM,构建脚本的导入方式也可能变化;这属于工具链事实,不能等 CI 运行环境报错后再补。
对于解析器,最重要的兼容性不是函数名,而是同一 XML 得到什么对象。isArray、文本自动转换、属性前缀和空节点行为都可能影响适配器。升级前后的对象快照可以放在测试产物中,但最终应用资源仍只保留规范化 JSON。
回滚也要明确:依赖回退后用同一输入重新生成,而不是把旧 catalog.json 手工复制回来。手工复制会让 manifest、lockfile 与资源事实不一致。可重复构建才是这套工具链真正的恢复能力。
十、结论:解析成功只是规范化的起点
FeedFence 最终把 184 KB 的 Atom 1.0 输入从 42 条收敛为 40 条稳定 JSON,并清楚记录 1 条重复 ID 与 1 条缺失链接。真正的工程价值不是换了一个 XML 库,而是建立了前置拒绝、显式选项、协议适配、字段门禁、清单输出和运行时隔离。
构建期方案的边界也很明确:它适合随版本发布、允许构建时更新的内容;对于实时订阅,仍需要在服务端或设备端运行同样的门禁,并设计缓存与降级。无论放在哪里,都不应让不稳定 XML 结构直接渗透到 ArkUI 页面。
这套方案还把第三方库的责任缩小到“验证并解析”。协议识别、字段语义、条目上限、错误等级和发布决策仍由项目自己掌握。库升级时只需重新跑同一组输入,比较规范化结果;应用页面不必跟着理解新的 XML 对象结构。
最终可交付的不是一句“解析成功”,而是能回答输入来自哪里、为什么少了两条、用了什么策略、输出摘要是什么,以及失败后是否保留上一份资源的一组事实。只有这些问题都能回答,BUNDLE_READY 才有工程意义。
参考资料:
- fast-xml-parser 官方仓库与文档:https://github.com/NaturalIntelligence/fast-xml-parser
- HarmonyOS Rawfile 资源与 ResourceManager API(以当前官方文档为准):https://developer.huawei.com/consumer/cn/doc/harmonyos-references/

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献110条内容

所有评论(0)