
HarmonyOS 7 + Core Vision Kit:文搜图索引代际切换与模型升级回滚【鸿蒙心迹】
示例项目:ScopeSwitch
页面:IndexMigrationPage
相册里的 128 张图片并不算大,真正麻烦的是“替换索引”这件事。旧索引仍在响应搜索,新索引又要逐张写入;如果直接清空再重建,用户会得到一段确定的空窗。如果把两个 scope 当成可随意切换的数据库分区,又会忽略能力升级后旧数据可能已经失效的边界。
本文把这类变化拆成两种:同一能力版本内的数据代际切换,以及能力或模型更新触发的全量重建。前者可以做双 scope 验证后切指针,后者不能承诺“瞬时回滚”,只能依赖图片清单重新构建。示例中的数值是为了说明状态机而设置的演示数据,不是设备实测,也不代表平台性能。
一、先把“升级”分成两种,否则回滚是假命题
textSearchImage 提供初始化、插入图片、按文本搜索、删除和清理数据等能力。工程层最容易犯的错,是把所有变化都叫成“索引升级”。实际上,图片集合变化与底层能力更新不是同一类风险。
第一类是内容代际变化。例如照片库完成一次去重,路径清单从 g12 变成 g13,但设备上的文搜图能力没有变化。此时可以把新图片写入 album_g13,继续让线上查询读取 album_g12;待固定探针通过后,应用只切换自己的 active scope。旧 scope 暂时保留,就能快速回退。
第二类是能力更新。官方错误边界明确提示,能力更新后需要清理数据并重新使用搜索。这里的 clearData 是全局动作,不能假设 album_g12 仍保留一套兼容旧模型的向量。也就是说,所谓“模型升级回滚”只能回滚应用版本、策略和图片清单,再重新建索引;不能把旧 scope 当成一定可用的热备。
ScopeSwitch 因此把迁移模式写进清单:CONTENT_GENERATION 允许 g12、g13 并存切换;CAPABILITY_REBUILD 必须先导出路径清单,再执行清理和全量重建。这个区分看似保守,却能避免在故障演练时才发现旧索引已经被清掉。
二、迁移清单不是进度条,而是可恢复的事实
本次演示任务为 INDEX-CUT-0072。旧 scope 是 album_g12,新 scope 是 album_g13,输入清单包含 128 张图片。状态从 G12_ACTIVE 进入 G13_BUILDING,验证完成后到达 G13_VALIDATED,最后才允许 POINTER_SWITCHED。页面显示的 88% 只是当前迁移进度,不参与是否切换的判断。
清单至少要保存任务 ID、模式、源代际、目标代际、路径摘要、总数、已插入数和失败列表。只存一个百分比无法恢复:重启后你不知道 88% 对应哪 112 张图片,也无法判断剩余路径是否与当前相册一致。
这段代码解决什么问题。 它把一次迁移定义为可序列化的代际清单,并用稳定字段表达“谁有资格被切为活动索引”。
type MigrationMode = 'CONTENT_GENERATION' | 'CAPABILITY_REBUILD'
type MigrationState =
  'G12_ACTIVE' | 'G13_BUILDING' | 'G13_VALIDATED' |
  'POINTER_SWITCHED' | 'G12_RETIRED' | 'FAILED'

interface IndexManifest {
  taskId: string
  mode: MigrationMode
  sourceScope: string
  targetScope: string
  pathDigest: string
  total: number
  inserted: number
  failedPaths: string[]
  state: MigrationState
  revision: number
}

const manifest: IndexManifest = {
  taskId: 'INDEX-CUT-0072',
  mode: 'CONTENT_GENERATION',
  sourceScope: 'album_g12',
  targetScope: 'album_g13',
  pathDigest: 'sha256:7ec1…39ad',
  total: 128,
  inserted: 0,
  failedPaths: [],
  state: 'G12_ACTIVE',
  revision: 72
}
这样写的关键不是类型漂亮,而是把迁移事实与 UI 状态分开。inserted 每完成一张才增加,failedPaths 保留原始输入,revision 用来拒绝旧任务晚到的回调。状态只能单向推进;页面重新创建后根据清单恢复,而不是从进度条反推事实。
容易出错的地方是把路径摘要当作安全签名。这里的 digest 只用于识别输入集合是否变化,不证明文件可信。真实项目还应处理图片被移动、权限变化和路径失效;若清单内容已变,不能继续复用旧的 88%。
三、构建新 scope 时,活动查询仍然读旧代际
同一能力版本内,新 scope 的写入可以在不改变活动指针的情况下进行。构建器一次只处理清单中的明确路径,失败项单独记录;它不会在遇到一张坏图时把整个 g13 宣布完成,也不会把页面上的“取消”误写成删除旧索引。
这段代码解决什么问题。 它把新 scope 的写入、状态推进和过期任务隔离在一个构建会话中。
import { textSearchImage } from '@kit.CoreVisionKit'

class ScopeBuilder {
  private generation: number = 0

  async build(paths: string[], draft: IndexManifest): Promise<IndexManifest> {
    const mine = ++this.generation
    const next: IndexManifest = {
      ...draft, inserted: 0, failedPaths: [], state: 'G13_BUILDING'
    }

    for (const path of paths) {
      if (mine !== this.generation) {
        return { ...next, state: 'FAILED' }
      }
      try {
        await textSearchImage.insertImage(path, next.targetScope)
        next.inserted += 1
      } catch (_) {
        next.failedPaths.push(path)
      }
    }
    return next
  }

  cancel(): void {
    this.generation += 1
  }
}
generation 不是平台参数,而是示例项目自己的提交权。取消或重启会话后,旧循环即使还返回,也不能继续更新当前清单。状态由 G12_ACTIVE 进入 G13_BUILDING,但线上搜索仍根据 active scope 读取 album_g12。
这里没有在循环中反复 init()。初始化与 release() 应由更上层的能力会话成对管理:进入文搜图功能时初始化,所有插入和搜索都结束后再释放。页面销毁只取消本页面的提交权,不应在后台构建仍运行时抢先释放公共会话。
演示把 128 张全部插入成功,页面显示 128/128;若有失败,验证阶段必须知道失败比例和具体路径。不要用 Promise.all 一口气推入大量任务并假设服务可以无限并发,批量节奏应按产品数据规模和官方限制控制。
四、切换前用固定探针验证,而不是只看插入成功
插入 128 次成功,只能证明写入调用没有抛出异常,不能证明搜索行为符合产品预期。ScopeSwitch 保存 6 条固定探针,例如“蓝色咖啡杯”“会议白板”“夜间街景”,并记录每条查询的期望图片集合。新 scope 至少要通过 6/6 探针,且 top-3 与基线重合率不低于约定阈值。
本批示例的 top-3 重合率为 0.83。它不是质量的绝对答案,只是一个发布门禁。真实项目还要按人像、文档和风景分桶,避免平均值掩盖某一类完全失效。
这段代码解决什么问题。 它在切指针前对目标 scope 做可重复的探针验证,并保留每条失败原因。
interface Probe {
  query: string
  expectedPaths: string[]
}

interface ProbeResult {
  query: string
  passed: boolean
  overlap: number
}

async function verifyScope(scope: string, probes: Probe[]): Promise<ProbeResult[]> {
  const report: ProbeResult[] = []
  for (const probe of probes) {
    const found = await textSearchImage.search(probe.query, scope, 3)
    const paths = found.map(item => item.imagePath)
    const hit = paths.filter(path => probe.expectedPaths.includes(path)).length
    report.push({
      query: probe.query,
      passed: hit > 0,
      overlap: hit / Math.max(1, probe.expectedPaths.length)
    })
  }
  return report
}
验证直接指定 album_g13,不会受活动指针影响。每条探针保留 query、结果路径和重合率,6/6 通过后清单才从 G13_BUILDING 进入 G13_VALIDATED。如果搜索调用失败,结果不能伪装成“零命中”;调用错误、空结果和质量不达标应是三种不同状态。
代码中的 imagePath 应以当前 SDK 的 ImageObject 定义为准;示例只展示项目所需字段。如果后续 API 定义发生变化,应在适配器中一次性转换,而不是让页面和脚本到处依赖原始对象。
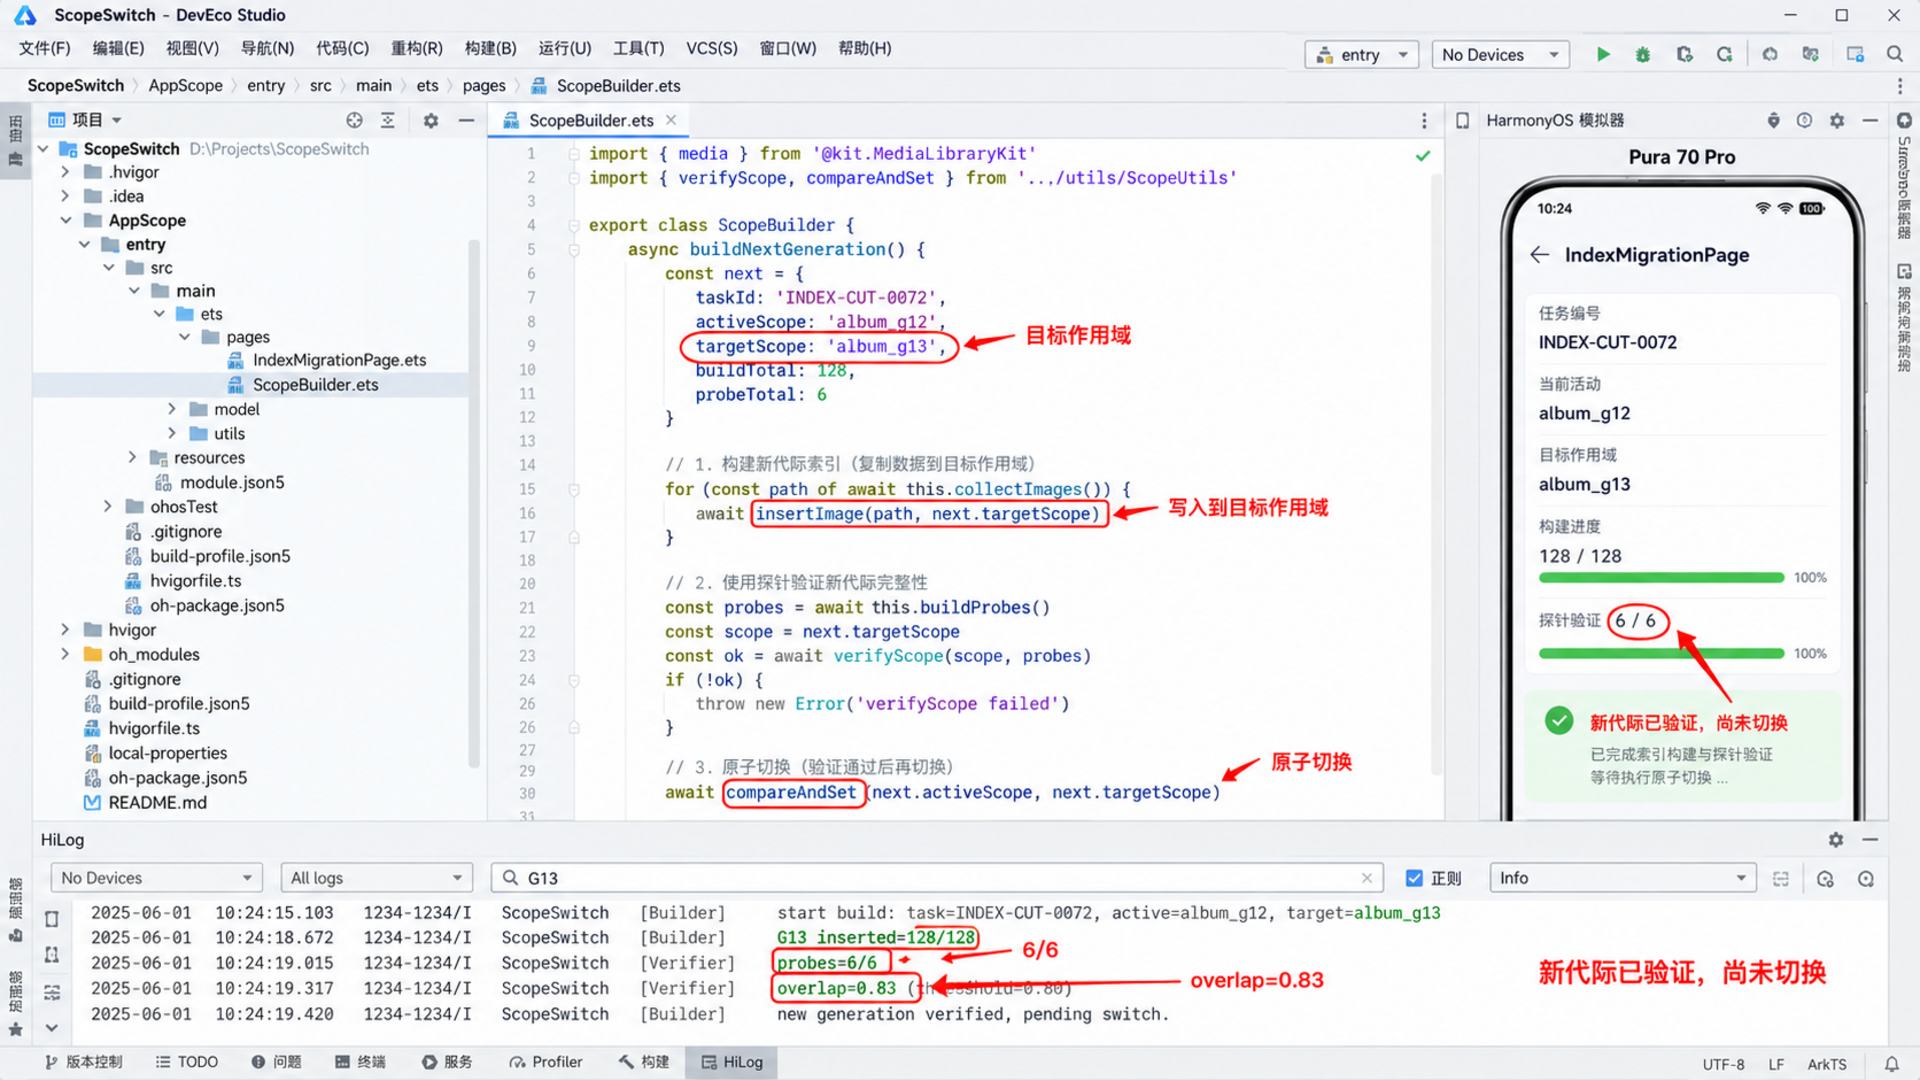
图中的 DevEco Studio 画面是与本文数据一致的演示配图,不是实际 IDE 运行证据。右侧模拟器仍显示 album_g12 为活动代际,底部 HiLog 同时记录 album_g13 inserted=128/128、probes=6/6 与 overlap=0.83,这正是构建与服务并行存在的阶段。
五、活动指针要小、原子、可校验
切换动作不应复制 128 条记录,也不应让 UI 自己拼 scope 名。应用只持久化一个很小的指针:当前 scope、对应 revision、清单 digest 和切换时间。这里的持久化实现由项目适配器提供,可以落到 Preferences 或项目已有的配置仓;文章不把自建 ActiveScopeStore 冒充系统接口。
这段代码解决什么问题。 它让活动代际的提交具备 compare-and-set 语义,防止两个迁移任务互相覆盖。
interface ActiveScope {
  scope: string
  revision: number
  manifestDigest: string
  switchedAt: string
}

interface ActiveScopeStore {
  read(): Promise<ActiveScope>
  compareAndSet(expectedRevision: number, next: ActiveScope): Promise<boolean>
}

async function commitScope(
  store: ActiveScopeStore,
  checked: IndexManifest,
  probesPassed: number
): Promise<boolean> {
  if (checked.state !== 'G13_VALIDATED' || probesPassed !== 6) return false
  return store.compareAndSet(checked.revision - 1, {
    scope: checked.targetScope,
    revision: checked.revision,
    manifestDigest: checked.pathDigest,
    switchedAt: '2026-10-01T11:24:00+08:00'
  })
}
compare-and-set 成功后,查询路由从 album_g12 切到 album_g13,状态进入 POINTER_SWITCHED。本例把切换操作记为 38 ms 的示例值,它只描述演示流程,不是设备性能承诺。失败时不覆盖新值,而是重新读取活动指针,确认是否已有更高 revision 提交。
最危险的写法是“先更新内存,再异步落盘”。进程在两步之间退出后,页面看到 g13,重启却回到 g12,日志又无法解释。实际项目应让持久化成功成为唯一提交点,内存状态从持久化结果派生。
六、运行页要让用户看见正在使用哪一代
切换之后,IndexMigrationPage 不只显示绿色成功图标,而是把任务、活动 scope、目标 scope、进度和探针结果放在同一页。这样调试人员能区分“g13 已构建”与“g13 已服务”,也能确认 88% 对应的是构建进度,而不是搜索质量。
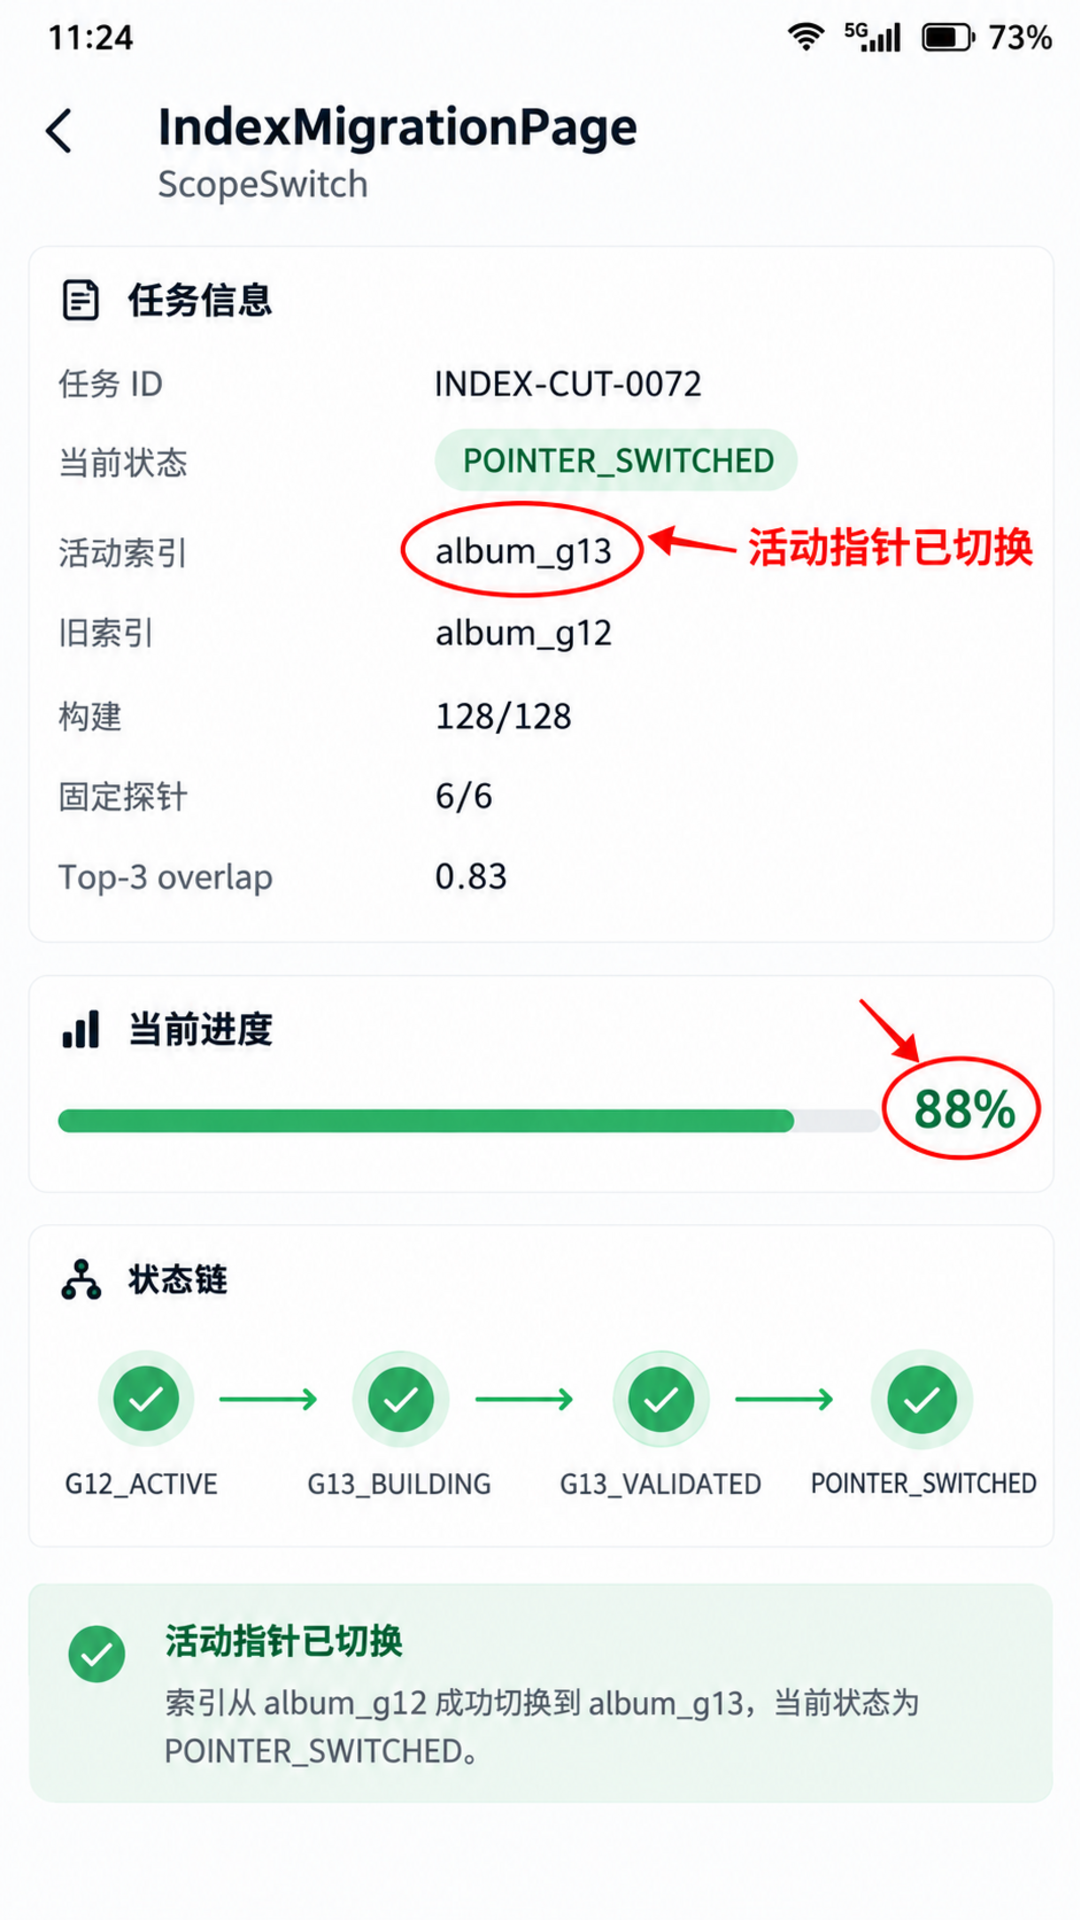
手机图中的时间为 11:24,任务为 INDEX-CUT-0072,活动代际已从 album_g12 指向 album_g13;构建为 128/128,探针为 6/6,top-3 重合率为 0.83。红色箭头只标出 POINTER_SWITCHED,因为真正决定用户查询落到哪一代的是这个提交点。
运行页还应提供“验证详情”,而不是提供一个无条件回滚按钮。回滚前先检查旧 scope 是否仍在保留期、当前能力版本是否变化、旧清单是否完整。只有内容代际切换且条件都满足,才允许把指针重新指回 g12。
七、模型更新后的回滚,实质是重新构建
当系统能力更新触发需要 clearData 的边界时,g12 与 g13 的热切换模型就结束了。执行清理前,ScopeSwitch 保存两样东西:图片路径清单与验证探针。清理后创建新的目标代际,例如 album_g14,重新插入并验证。旧 g12 的 scope 名可以留在历史记录里,但它不再代表可查询的数据。
这时页面上的“回滚到 g12”必须改写成“按 g12 清单重建”。两者耗时、可用性和风险完全不同。若产品要求搜索不中断,就需要业务侧提供降级策略,例如临时显示最近图片、文件名搜索或明确的维护提示,而不是声称底层旧索引还能工作。
clearData 也不应该被普通取消按钮调用。它的破坏范围比当前任务大,必须放在能力重建流程中,记录前置清单、当前版本事实和确认结果。本文不提供一键清理代码,正是为了防止复制示例时把全局动作放进页面级逻辑。
八、退役旧 scope 之前,先观察再删除
内容代际切换成功后,g12 仍保留一个观察窗口。ScopeSwitch 比较 g12 与 g13 的查询错误、空结果和探针漂移;同时处理清单中 3 条已失效路径。只有 g13 稳定、回滚窗口结束,状态才从 POINTER_SWITCHED 进入 G12_RETIRED。
退役是业务流程,不等于一定调用全局清理。可以根据官方删除能力逐张移除旧代际图片,也可以在数据规模允许时安排下一次维护重建。关键是任何删除都从清单驱动,不能用前缀猜测路径,更不能因为 scope 名里有 g12 就认定所有内容都可删。
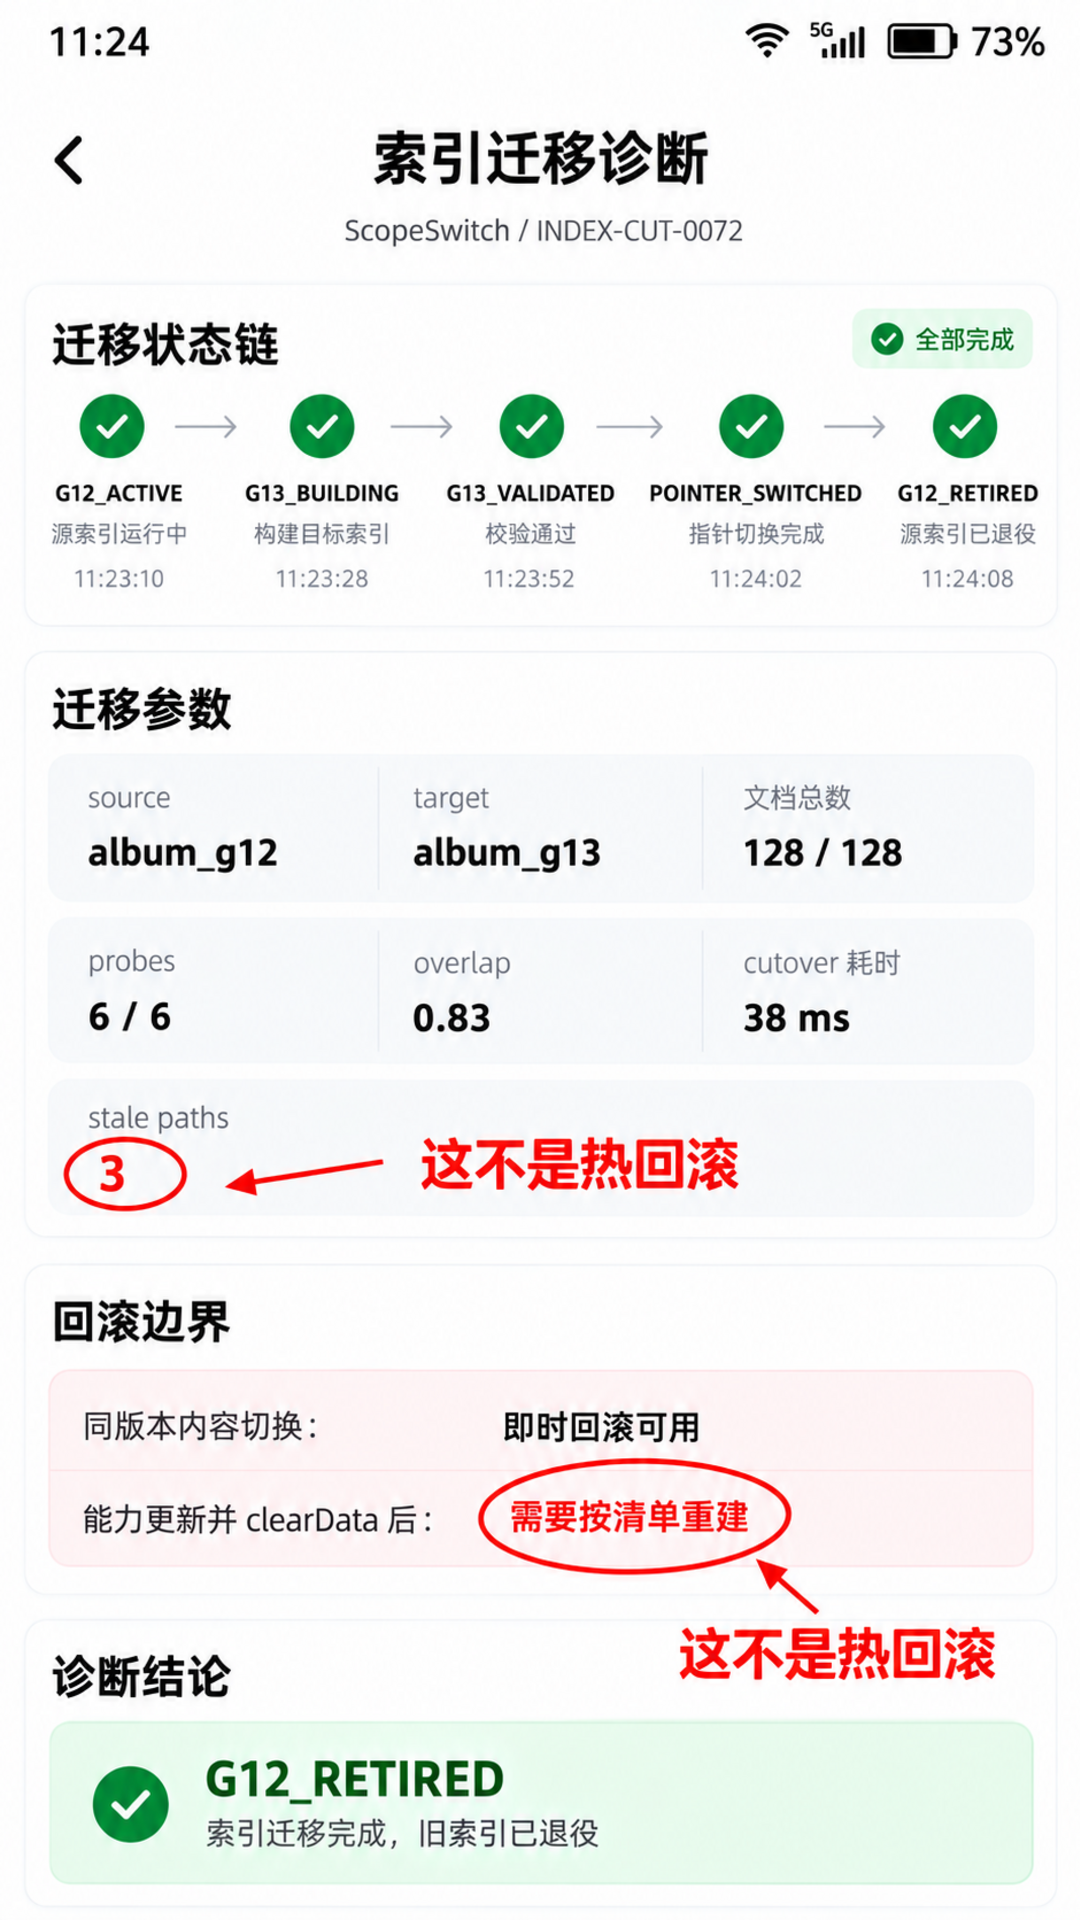
诊断页展示完整状态链:G12_ACTIVE → G13_BUILDING → G13_VALIDATED → POINTER_SWITCHED → G12_RETIRED。它还列出“即时回滚:可用”“能力更新后回滚:需重建”两个不同结论,并明确 3 条失效路径已经从退役计划中隔离。红圈用于强调回滚边界,而不是装饰界面。
九、把异常注入到迁移流程,而不是只测成功路径
这套状态机至少应覆盖四类故障。第一类是插入到第 77 张时进程退出,重启后根据清单继续,而不是把 77 张重复计数。第二类是探针 5/6 通过,必须停在构建完成但未验证状态。第三类是另一个 revision 已经切换指针,当前任务的 compare-and-set 必须失败。第四类是能力更新后出现需要清理的错误,流程必须转入 CAPABILITY_REBUILD,禁止继续显示“可热回滚”。
日志也应围绕事实组织:taskId、revision、scope、inserted/total、probePassed、activeScope 和错误类型。不要只输出“迁移成功”,否则线上看到空结果时无法判断是构建不全、指针未切、能力已更新,还是一条查询自身没有命中。
1. 重启恢复要重新确认输入,而不是盲目续跑
迁移清单写到 88% 后,应用可能被系统回收,也可能因为用户撤销照片权限而暂停。再次进入页面时,恢复逻辑首先重新枚举可访问路径,并计算新的集合摘要。摘要仍是 sha256:7ec1…39ad,才说明当前输入与任务创建时一致;如果摘要不同,即使已插入数仍为 112,也不能从第 113 项继续。
路径集合变化有三种常见原因。用户删除了照片,旧路径已经失效;系统媒体路径发生迁移,内容相同但标识变化;任务运行期间又新增了图片。三种情况不能都归结为“少一张”。ScopeSwitch 的处理是冻结当前 revision,记录差异集合,再由策略决定创建 g14 或重算 g13。恢复动作不直接修改活动指针,g12 始终保持服务能力。
已写入新 scope 的记录也不能仅凭本地计数认为存在。若能力进程、存储或版本事实发生变化,需要重新跑一条已知探针确认目标 scope 仍可查询。探针失败时,清单退回 G13_BUILDING 或进入 FAILED,而不是继续增加 inserted。这样做会多一次查询,却能阻止“本地进度很完整、实际索引已经失效”的假恢复。
2. 查询路由要携带读取时的 scope
切换窗口里最难追的日志,往往来自一次请求跨越了指针更新:请求创建时 active scope 是 g12,真正执行搜索前指针已经变成 g13。如果日志只打印最终活动值,排查人员会误以为结果一定来自 g13。正确做法是在请求创建时读取并冻结 scope,把它与 query、sequence 一起传入适配器,完成日志也打印同一值。
这不是要求所有请求在切换时取消。旧请求可以正常完成,但它的结果必须标明读取代际;新请求从 g13 开始。若页面采用联想搜索,还要继续使用 sequence 过滤过期结果,索引代际与请求时序是两条正交的控制线,不能用同一个数字替代。
统计同样要按 scope 分组。切换后的短观察期内分别计算 g12、g13 的调用失败、空结果与耗时分布,才能判断变化来自数据代际还是网络、权限和页面竞态。若所有指标混成一条曲线,回滚判断会失去证据。
3. 探针集也需要版本和维护责任
固定探针不是写完就不动的六句话。相册结构改变后,某个期望图片可能已经被用户删除;产品增加文档场景后,原来的风景探针也不足以代表风险。探针清单应有自己的版本、创建原因和最小覆盖说明,并与索引 manifest 一起归档。
探针维护要避免“为了让新版本通过而改答案”。当 g13 对一条查询的排序明显变化时,先人工检查新结果是否合理,再决定是模型行为变化、数据变化还是旧期望错误。修改期望必须形成新的 probe revision,旧报告仍保留;否则历史上的 6/6 与今天的 6/6 其实使用了两套答案,却看起来完全相同。
本例的 0.83 只用于演示 top-3 重合率。真实门禁可以同时保留至少一项绝对条件,例如每条探针至少命中一个人工确认的正样本,再配合分桶的相对指标。这样既不过度绑定完全相同的排序,也不会让一个不错的平均数掩盖某条关键查询完全失效。
4. 观测到异常时,先停止退役而不是立即反切
切换后出现空结果上升,不一定说明 g13 索引损坏。也可能是媒体权限刚被关闭、某类路径失效、查询语言变化或 UI 把 scope 传错。自动反切若不判断原因,可能把同样的问题带回 g12,还会让两次指针变更互相覆盖。
ScopeSwitch 的第一动作是冻结退役计划,保留 g12,并把当前 revision 标记为观察。只有当 g12 对同一批探针正常、g13 异常,且能力版本与权限事实一致,才满足快速回退条件。如果两代都失败,应该进入能力诊断,而不是在两个 scope 之间来回切换。
这也解释了为什么“保留旧 scope”只是风险缓冲,不是完整故障恢复方案。可恢复性来自清单、探针、原子指针、版本事实和降级页面共同作用。少了其中任何一项,按钮上的“回滚”都可能只是在改变一个字符串。
本文的 128/128、6/6、0.83、38 ms 与 88% 都是示例输入,目的在于验证文图和状态机的一致性。它们不能作为真实设备性能结论。真正发布前应在目标系统版本、真实相册规模和权限条件下重新采样。
十、结论:可回滚的是应用决策,不一定是旧向量
文搜图索引迁移的核心不在“再调用一次 insert”,而在于明确哪部分由系统能力负责,哪部分由应用自己承诺。同一能力版本内,scope 可以承担数据代际隔离,固定探针和原子指针让切换可验证、可撤销;能力或模型更新要求清理数据时,旧向量不再是可靠的回滚资产,真正可保留的是路径清单、验证集和迁移事实。
ScopeSwitch 的最终状态是 G12_RETIRED,但这个结论只针对演示的内容代际模式。若检测到能力更新,流程会停止热切换并要求重建。把这条边界写进代码和页面,比给所有失败都准备一个“回滚”按钮更诚实,也更容易在下一次升级时定位问题。
工程上真正值得保留的不是某个 scope 名,而是一套能重放的输入、能复核的探针和一次只有一个提交者的状态迁移。这样即使能力版本再次变化,团队仍能解释每一步发生了什么,并在明确代价后恢复服务。
参考资料:
- 华为开发者论坛,文搜图相关示例与说明:https://developer.huawei.com/consumer/cn/forum/topic/0203220028018131387
- HarmonyOS Core Vision Kit 文搜图 API 参考(以当前官方文档为准):https://developer.huawei.com/consumer/cn/doc/harmonyos-references/

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献105条内容

所有评论(0)