
HarmonyOS Image Kit + ArkTS 任务代次:图像超分批处理的晚到结果隔离与 PixelMap 释放【鸿蒙心迹】
一张图放大两倍并不难,难的是用户连续换图、取消、退到后台以后,页面仍然只接受属于当前任务的结果,而且不把已经失效的 PixelMap 留在内存里。本文用一个可复现的示例工程 ScaleQueue 拆解这层任务管理。示例数据用于说明状态机,并不冒充设备实测:任务号为 sr_20261001_06,输入图 poster_720p.jpg,尺寸 1280 × 720,目标为 2560 × 1440,界面时间统一为 12:14。
需要先把能力边界说清。HarmonyOS Image Kit 负责图像源解码、PixelMap 表示和编码等基础能力;本文的 SuperResolutionEngine 是项目自己的算法适配接口,可以连接经验证的本地模型、服务端能力或供应商 SDK。它不是系统内置 API。这样写虽然少了一个“神奇方法”,却能让代码在替换算法实现时仍然成立,也不会把论坛方案里的特定实现误写成通用系统能力。
一、真正难处理的是旧结果,而不是放大按钮
ScaleQueue 的页面叫 SuperResolutionPage。队列中有三张图,当前处理第 2 张。用户先启动任务,进度到 64% 时重新选择一张输入图,或者把倍率从 2 倍改成 4 倍。算法调用不会因为界面变了就自动消失;旧 Promise 仍可能在稍后完成。如果回调直接给 @State result 赋值,旧图会覆盖新图,页面显示的任务号和结果像素也会对不上。
这类问题常被误判成“异步回调顺序偶发异常”。更准确的说法是:调用方没有给结果定义所有权。一次操作至少要有三个身份字段:业务任务 ID、页面代次 generation、队列项序号。任务 ID 方便排查,代次决定回调是否仍有效,序号决定进度属于哪一项。三个字段不能互相代替。
示例状态采用下面这条路径:
READY → DECODING → RUNNING → COMMITTING → DONE
取消不直接跳回 READY,而是进入 CANCELLED。页面只在旧资源释放完毕后才允许开始新代次。算法适配器如果支持主动取消,可以同步通知;如果不支持,代次检查仍能阻止晚到结果污染页面。
1. 先定义项目接口,不虚构系统能力
这段代码解决超分实现来源不同、返回时序不一致的问题。
import { image } from '@kit.ImageKit';

export type ScaleFactor = 2 | 4;

export interface ScaleRequest {
  taskId: string;
  generation: number;
  factor: ScaleFactor;
  input: image.PixelMap;
}

export interface ScaleResult {
  taskId: string;
  generation: number;
  output: image.PixelMap;
  width: number;
  height: number;
}

export interface SuperResolutionEngine {
  upscale(request: ScaleRequest,
    onProgress: (value: number) => void): Promise<ScaleResult>;
  cancel?(taskId: string): Promise<void>;
}
接口只描述项目确实需要的契约,没有声明 image.superResolution() 之类未经核对的方法。输入与输出仍使用 Image Kit 的 PixelMap,算法层因此可以被替换。generation 同时放进请求和结果,是为了让适配器经过线程、进程或网络边界后仍能原样带回身份;只闭包捕获页面变量,在复杂实现中很容易丢失上下文。
容易忽略的地方是所有权。这里约定调用方拥有输入 PixelMap,适配器返回的新 PixelMap 由调用方接管。适配器不能私自释放输入,页面也不能在算法读取期间提前释放。若接入的 SDK 会复制输入,应在具体适配器文档中修改约定,而不是靠猜。
二、解码阶段就要建立资源账本
输入文件来自应用沙箱或用户授权后的可读位置。ImageSource 与 PixelMap 是两层对象:前者负责从数据源创建像素图,后者持有可供处理和显示的像素数据。两者的生命周期不同,不能因为最终只显示 PixelMap 就忘了关闭图像源。
这段代码解决文件描述符、ImageSource 与 PixelMap 的成对管理问题。
import { fileIo as fs } from '@kit.CoreFileKit';
import { image } from '@kit.ImageKit';

export async function decodeInput(path: string): Promise<image.PixelMap> {
  const file = fs.openSync(path, fs.OpenMode.READ_ONLY);
  let source: image.ImageSource | undefined;
  try {
    source = image.createImageSource(file.fd);
    const pixelMap = await source.createPixelMap({
      desiredSize: { width: 1280, height: 720 },
      desiredPixelFormat: image.PixelMapFormat.RGBA_8888
    });
    return pixelMap;
  } finally {
    if (source !== undefined) {
      await source.release();
    }
    fs.closeSync(file);
  }
}
try/finally 的意义不只是“写得严谨”。创建 PixelMap 失败时,文件仍要关闭;创建成功时,PixelMap 已成为独立资源,返回后由上层账本接管。desiredSize 在示例中固定为 1280 × 720,与页面和配图一致,但项目里不应盲目把所有输入压成同一宽高。更稳妥的策略是先读取图像信息,依据最大边、内存预算和模型输入约束计算尺寸,并保留原始宽高比。
这里没有把路径直接传给算法。解码集中在仓储层后,算法只看到 PixelMap,页面不会同时承担 URI、文件描述符、色彩格式和任务队列四种责任。若输入来自系统选择器,还要遵守授权 URI 的可访问范围;不能把临时访问能力当成永久文件路径。这个问题已在上一批素材中单独讨论,本篇不重复展开。
项目结构按职责拆开,而不是按“页面里放所有代码”的方式堆叠:
pages/SuperResolutionPage.ets:渲染任务与按钮。model/ScaleSession.ets:维护代次、状态和资源账本。engine/SuperResolutionEngine.ets:定义算法适配接口。repository/ImageRepository.ets:解码和输出落盘。components/ProgressCard.ets:展示任务sr_20261001_06的 64% 进度。
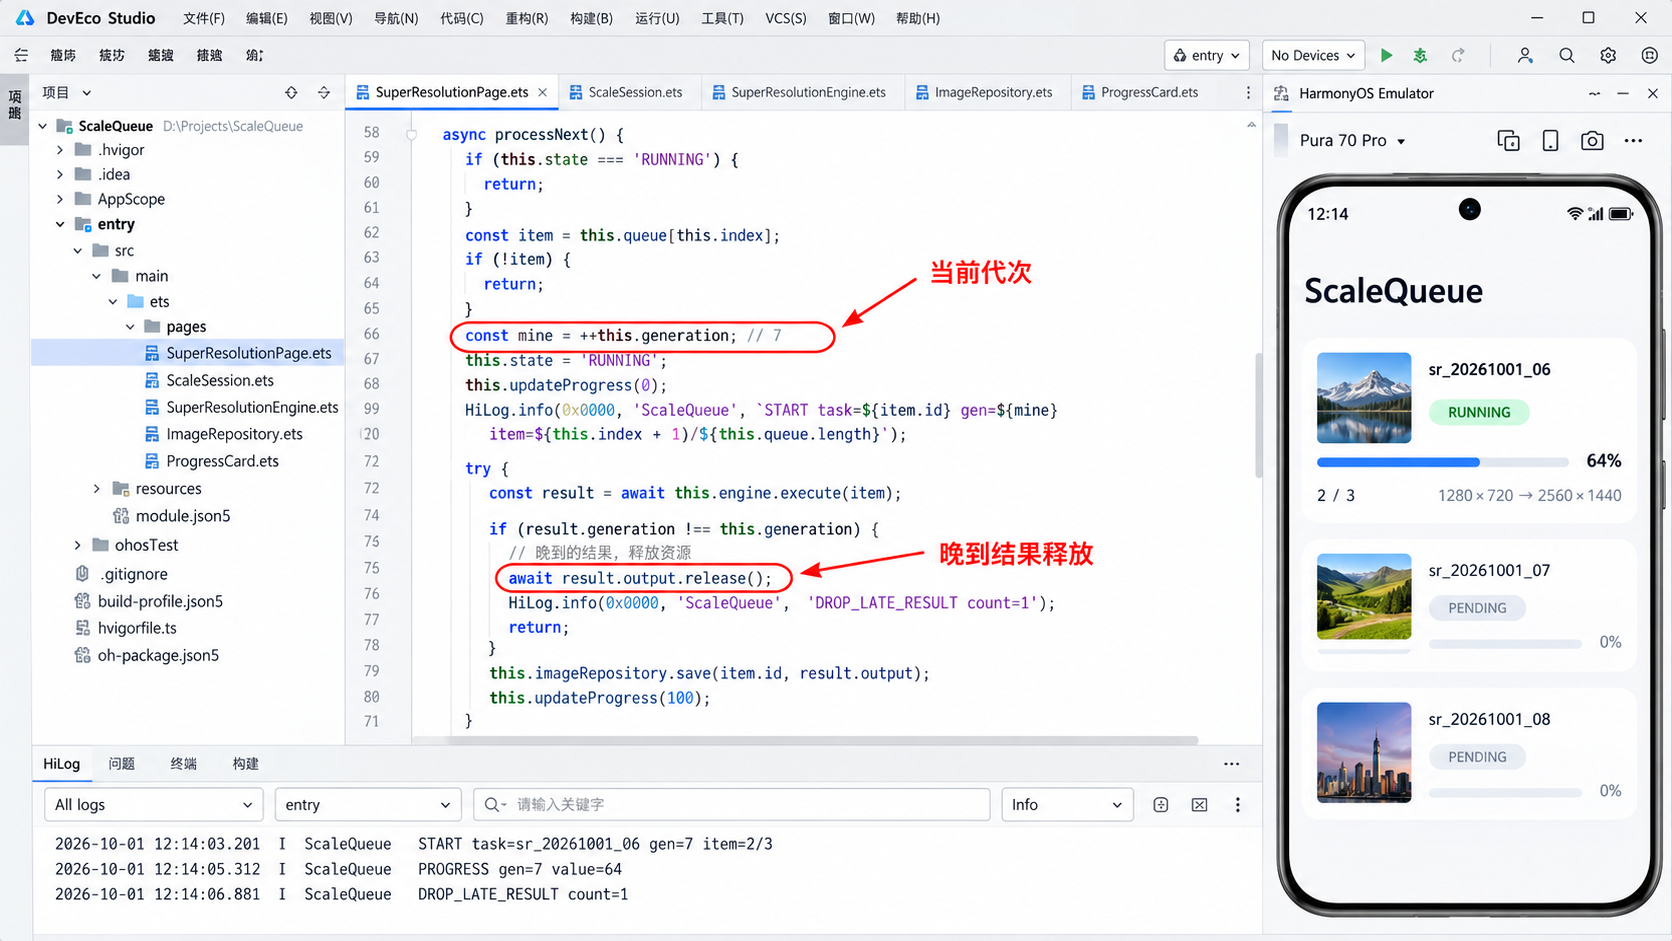
下图是示意配图,不是 DevEco Studio 实测截图。左侧目录、中间状态收敛代码、右侧模拟器以及底部 HiLog 使用同一组示例字段,目的是让调试路径一眼可对照。
三、用代次把晚到回调挡在状态之外
取消令牌并不总能让底层计算立即停下。很多模型推理一旦提交,就只能等待返回。因此页面需要第二道闸门:每次开始、换图、改倍率或销毁页面,都递增 generation。回调只有在代次、任务 ID 和页面存活状态同时匹配时才能提交。
这段代码解决连续操作时旧进度和旧结果覆盖当前任务的问题。
import { image } from '@kit.ImageKit';

type RunState = 'READY' | 'DECODING' | 'RUNNING' |
  'COMMITTING' | 'DONE' | 'CANCELLED' | 'FAILED';

export class ScaleSession {
  private generation: number = 6;
  private alive: boolean = true;
  private input?: image.PixelMap;
  private output?: image.PixelMap;
  state: RunState = 'READY';
  progress: number = 0;

  async start(taskId: string, engine: SuperResolutionEngine,
    input: image.PixelMap): Promise<void> {
    const mine = ++this.generation; // 本轮为 7
    this.input = input;
    this.state = 'RUNNING';
    this.progress = 0;

    const result = await engine.upscale(
      { taskId, generation: mine, factor: 2, input },
      (value: number) => {
        if (this.alive && mine === this.generation) {
          this.progress = Math.min(100, Math.max(0, value));
        }
      }
    );
    await this.commitIfCurrent(result);
  }

  private async commitIfCurrent(result: ScaleResult): Promise<void> {
    if (!this.alive || result.generation !== this.generation) {
      await result.output.release();
      return;
    }
    this.state = 'COMMITTING';
    await this.output?.release();
    this.output = result.output;
    this.progress = 100;
    this.state = 'DONE';
  }
}
这一轮从 generation=6 递增到 7。当进度为 64% 时,只有第 7 代回调能更新界面。假设第 6 代稍后返回,它的输出不会进入 this.output,而是立即 release()。这一步很重要:丢弃结果不等于释放结果。只写 return,页面表面上没有串图,资源仍可能累积。
状态先切到 COMMITTING,再释放旧输出并接管新输出,是为了避免“界面已经宣称完成,资源替换却还没结束”的时间缝隙。实际项目还要考虑 release() 失败后的日志策略。释放异常通常不该把已经得到的新结果改成业务失败,但必须带上任务号、代次和资源类型记录,便于识别持续泄漏。
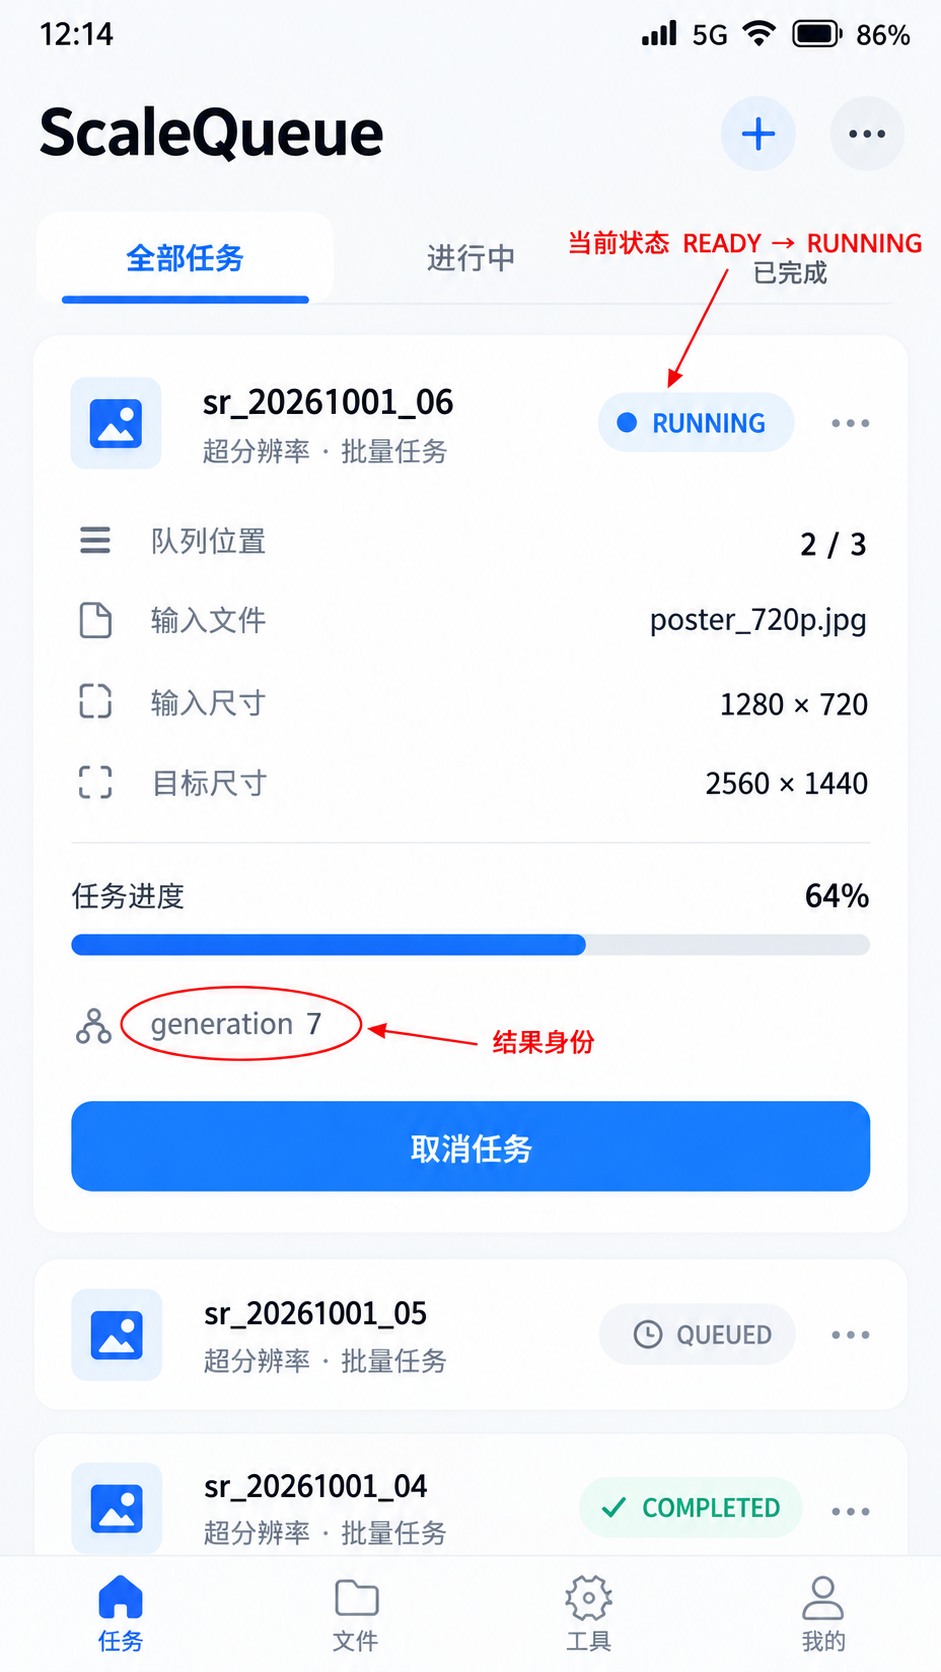
下面的手机运行画面仍是演示配图。它显示当前队列 2 / 3、任务 sr_20261001_06、输入与目标尺寸、RUNNING 状态和 64% 进度。红色箭头只标代次和进度,没有把每个控件都圈一遍。
四、取消是一次资源结算,不是换个按钮文字
页面上的“取消”通常有三种含义:用户想停止等待、底层任务确实已停止、资源已经可回收。三者发生时间可能不同。为了避免误导,示例点击取消后先递增代次,使所有旧回调失效;然后尽力通知引擎;最后释放当前持有的输入和输出。即使 cancel() 不可用,UI 也不会再接受旧结果。
这段代码解决取消、离页与重新开始之间的资源结算问题。
export class ScaleSession {
  // 其余字段与前文一致

  async cancel(taskId: string,
    engine: SuperResolutionEngine): Promise<void> {
    ++this.generation;
    this.state = 'CANCELLED';
    this.progress = 0;
    try {
      await engine.cancel?.(taskId);
    } finally {
      await this.input?.release();
      this.input = undefined;
      await this.output?.release();
      this.output = undefined;
    }
  }

  async dispose(taskId: string,
    engine: SuperResolutionEngine): Promise<void> {
    this.alive = false;
    await this.cancel(taskId, engine);
  }
}
这段实现强调成对关系:start() 接管输入,cancel() 或完成后的保存流程释放它;commitIfCurrent() 接管输出,下一次提交、取消或页面销毁释放它。项目中可以把输入在算法返回后更早释放,但前提是适配器已经明确不再读取。不能仅凭 Promise 完成就推断某个原生组件没有延迟访问。
dispose() 先把 alive 设为 false,再走取消逻辑。这样即便取消过程中又到一条进度回调,它也无法更新页面。ArkUI 组件销毁回调里不适合堆很长的阻塞流程;可让 session 自己异步结算,并把异常写入统一日志。若引擎持有线程或原生句柄,还需要在适配器中增加自己的 dispose(),与页面 session 的生命周期分层处理。
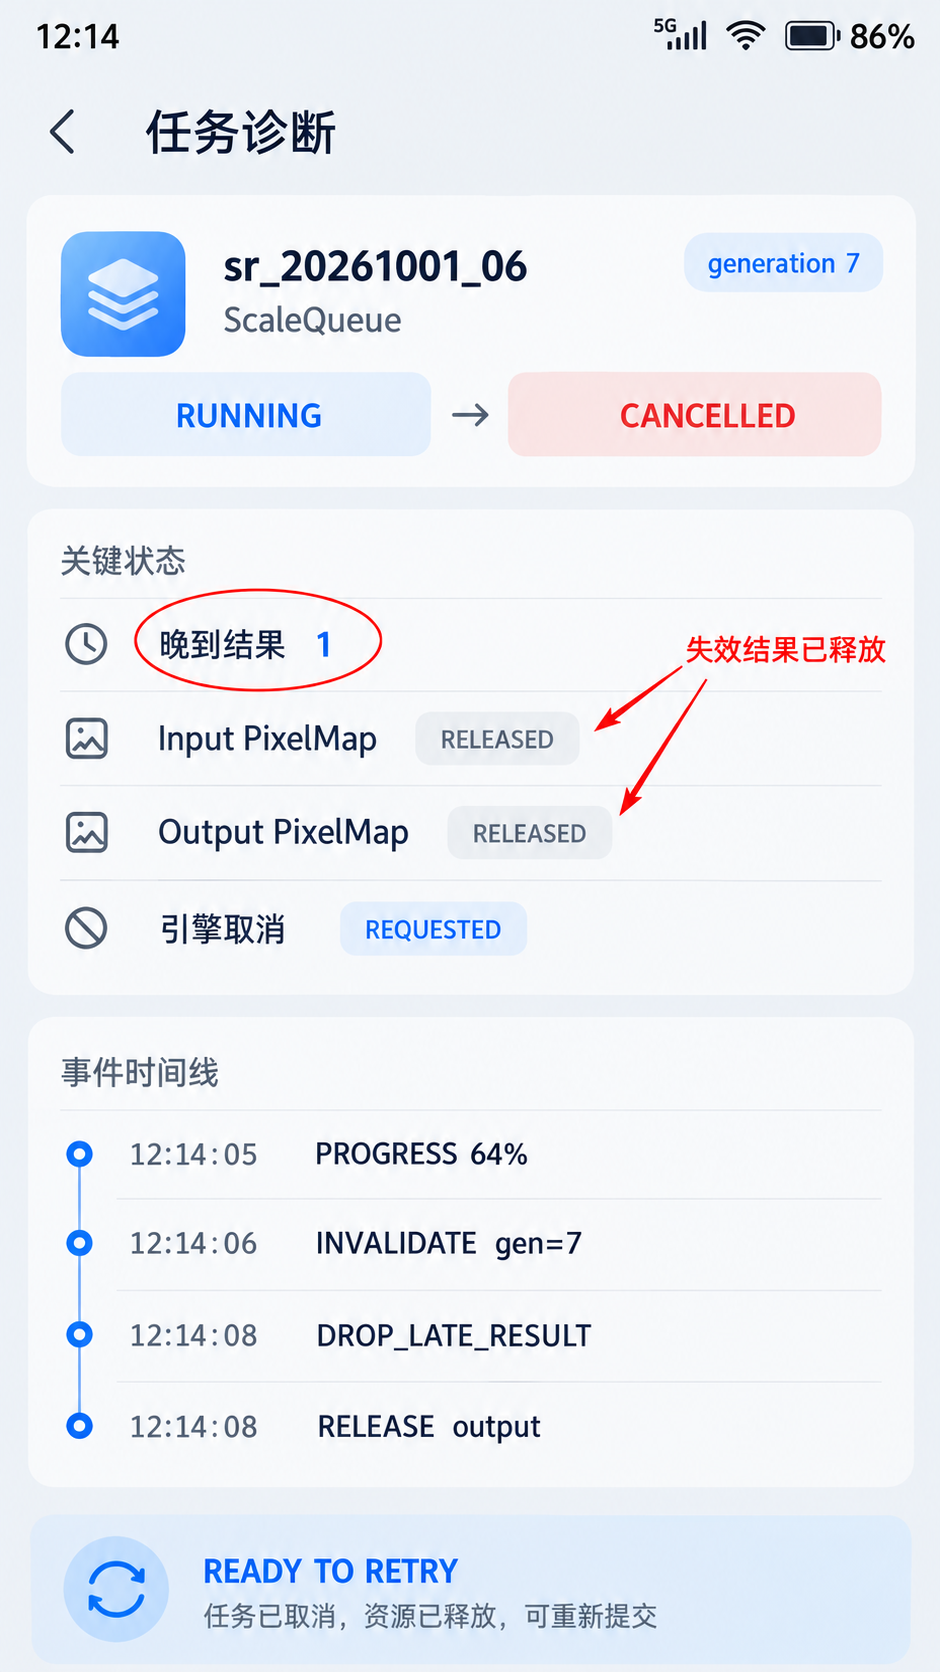
诊断页需要回答四个问题:当前是谁、旧结果去了哪里、哪些资源仍被持有、能否安全重试。示例诊断数据固定为:generation=7,状态从 RUNNING 进入 CANCELLED,丢弃晚到结果 1 个,输入与输出均显示 RELEASED,下一步为 READY TO RETRY。这比只打印“取消成功”更有用。
五、调试时按事件序列核对,不盯单条日志
任务串图很难靠一条错误日志定位。建议每条日志至少包含 taskId、generation、队列序号、状态和事件名。不要把整个图片路径、用户相册名称或模型返回对象全量写进日志;既增加噪声,也可能暴露不必要的信息。
示例的期望序列可以写成:
START task=sr_20261001_06 gen=7 item=2/3。PROGRESS task=sr_20261001_06 gen=7 value=64。- 用户换图后出现
INVALIDATE oldGen=7 newGen=8。 - 旧计算返回,记录
DROP_LATE_RESULT gen=7 count=1。 - 旧输出被释放,记录
RELEASE output gen=7。 - 新任务才有资格进入
COMMITTING和DONE。
如果只看最后的 DONE,无法知道中间是否有一次旧图短暂闪现。调试时应把状态转换与资源事件放在同一时间线里。对压力场景,可以连续执行“开始—换倍率—换图—取消—返回页面”,检查代次只增不减,且所有失效输出最终都有释放事件。
还有一个常见误区是用进度值判断新旧任务。两个任务都可能到 64%,进度不是身份。文件名也不是身份,同一文件可以用不同倍率、不同裁剪区域重复处理。只有调用方分配且不复用的代次,才能稳定表达“这是当前页面认可的那一次”。
六、交付前需要明确的边界
这套方案解决的是应用侧任务一致性与资源管理,不证明某个超分模型的画质、时延或功耗。算法能力要在目标设备、目标分辨率和目标场景上单独验证。尤其是 4 倍放大,输出像素数会显著上升;即使模型支持,也不代表页面能同时保留输入、输出、预览副本和编码缓存。
演示中的 1280 × 720 → 2560 × 1440、64% 和丢弃 1 个晚到结果,是为了让正文与图片拥有可核对的数据,不是性能基准。真正的性能结论至少应记录设备、系统版本、模型版本、冷热启动、输入格式、内存峰值和统计方法。没有这些条件,不应写“提升多少”之类数字。
上线前还应补齐四项检查:一是切后台或页面销毁时能否结算;二是编码或保存失败时输出是否仍可释放;三是并发上限是否由统一队列控制;四是第三方算法或模型的许可证、隐私与数据流向是否明确。任务状态机不能替代这些合规工作,但能让责任边界更清楚。
最后留下一个判断:图像超分页面最值得先写的不是漂亮的比较滑杆,而是结果所有权。只要“谁能提交、谁负责释放、何时失效”三件事没有答案,增加并发、缓存或动画都会放大偶发问题。把系统 Image Kit 能力与项目算法适配层分开,再用代次收住晚到回调,页面才有继续扩展的基础。
七、把失败拆成能恢复和必须重建两类
失败如果只有一个 FAILED,页面很难决定按钮应该显示“重试”还是“重新选择”。更实用的划分依据不是异常类名,而是当前资源还能不能继续用。比如编码输出失败时,超分得到的 PixelMap 仍可能有效,用户可以换一个目标路径再次保存;输入解码失败时,连算法入口都没有,应该回到选图;模型进程断开或原生上下文失效时,本轮 session 往往需要重建。
可以给失败事件加三个字段:阶段、资源结算情况、建议动作。阶段包括 DECODE、INFERENCE、COMMIT、ENCODE;资源情况只描述应用现在持有什么,不猜底层状态;建议动作使用 RETRY_CURRENT、RESELECT_INPUT、RECREATE_ENGINE。这些字段适合日志和诊断页,不一定全部展示给普通用户。界面文案仍应简洁,比如“处理未完成,可重试”,而不是把内部错误码直接丢出来。
以 sr_20261001_06 为例,若算法在 64% 报错,session 先核对 generation=7 是否仍为当前代次。如果用户已经换图,错误属于旧代次,只记录 DROP_LATE_ERROR,不能把新任务页面改成失败;如果仍是当前代次,则进入 FAILED,释放输入,并保留可重建引擎的上下文。错误回调与成功回调一样需要身份检查,这是不少实现遗漏的地方。
重试也不能复用旧 generation。用户点一次重试,就是一次新意图,必须生成第 8 代。否则第 7 代某个更晚的成功回调仍可能穿过检查。任务 ID 可以保留以便把重试串在同一业务链路中,但日志应增加 attempt=2 或新代次;两者分别表达“同一个业务任务”和“不同的一次执行”。
网络型超分适配器还要考虑上传已经完成、响应没有回来时的取消。应用侧可以停止等待并让第 7 代失效,却未必能撤回服务器计算。此时隐私说明、服务端保留策略和计费语义都属于适配器边界,不能用一个可选 cancel() 掩盖。本文的接口允许尽力取消,但明确不承诺远端立即停止。
八、用一张验收表覆盖时序,而不是只点一次成功路径
任务管理的缺陷通常需要特定顺序才出现。手工验收至少应覆盖以下组合:正常完成;进度过程中换倍率;进度过程中换输入;连续点击开始;取消后立即重试;算法成功但页面已销毁;保存失败后再次保存;三项队列在第 2 项失败;应用进入后台后恢复。每个组合都检查页面状态、当前代次、持有资源与日志事件,而不只是看有没有结果图。
正常完成的期望是第 7 代从 RUNNING 进入 COMMITTING 再到 DONE,进度最终为 100,旧输出若存在必须先释放。换输入的期望是旧代次失效,新输入解码完成后生成新代次,旧结果到达时仅增加丢弃计数。连续点击开始则应由按钮禁用或 session 幂等控制,不能产生两个都自称当前的第 7 代。
页面销毁场景尤其值得单独跑。销毁发生时 alive=false,之后无论进度、成功还是失败回调都不能更新 ArkUI 状态。晚到的成功结果要释放,晚到错误只写受控日志。如果回调里捕获了整个页面对象,即使有 alive 判断,也可能延长页面生命周期;适配层最好回调到轻量 session,再由页面订阅可见状态。
队列第 2 项失败时,还要明确第 3 项是否继续。批量修图通常有“失败即停”和“跳过继续”两种策略。ScaleQueue 示例采用失败即停,因为用户需要先确认失败原因;如果产品选择跳过继续,队列状态应记录每项结果,而不是让总进度从 64% 突然跳到下一张而没有失败标记。
验收记录中不建议只写“通过”。更可复核的格式是:操作序列、期望状态序列、最终持有资源、是否出现晚到事件、截图或日志片段。例如“开始第 7 代—64% 换图—旧结果返回”对应“第 7 代失效、第 8 代开始、旧输出释放、当前任务不变”。这类记录以后替换算法实现时还能继续复用。
九、内存预算应从同时存活的对象推算
一张 RGBA_8888 像素图的基础数据量可以粗略按宽乘高乘四字节估算。1280 × 720 约为三点五兆字节,2560 × 1440 约为十四兆字节,但这只是像素缓冲的量级,不包括解码器、模型张量、图形纹理、编码缓存和对齐开销。页面同时保留原图、结果图、比较视图副本和算法中间张量时,峰值会明显高于两张图相加。
因此资源账本不应只有“有没有释放”,还要知道“为什么仍要持有”。输入在算法完全结束后,如果比较视图只需要输出和缩略图,就可以释放原始大图;预览可以使用单独的小尺寸 PixelMap,保存时再使用完整输出;批量队列不要提前解码全部原图。每个选择都会影响交互速度与峰值内存,应该由场景取舍,而不是照搬一个固定数字。
还要防止 UI 组件在资源释放后继续引用同一个 PixelMap。释放前先让可观察状态脱离该对象,等待界面下一次构建接管占位内容,再执行释放会更安全。具体时序要结合当前组件和 SDK 行为验证;本文不把某个延迟值写成通用答案。重要的是让“从 UI 移除引用”和“释放原生资源”成为一对可追踪事件。
当工程引入缓存时,缓存也必须参加所有权协议。缓存拿到的是独立副本、共享引用还是可重新解码的文件路径,三种策略完全不同。共享 PixelMap 最容易出现一方释放、另一方仍显示的问题。没有引用计数或明确转移语义时,宁可缓存输出文件与缩略图,也不要把大像素对象在多个页面之间随意传递。
十、参考资料与核对说明
- HarmonyOS Image 模块 API 参考:https://developer.huawei.com/consumer/cn/doc/harmonyos-references/js-apis-image
- HarmonyOS 图像超分社区主题(用于了解方向,具体接口仍以当前官方文档与项目依赖为准):https://developer.huawei.com/consumer/cn/forum/topic/0208219078052443133
- HarmonyOS 应用开发入口:https://developer.huawei.com/consumer/cn/harmonyos/develop/
本文不声明未经设备验证的性能结果。图片均为本篇字段一致的界面演示图,不是实际 IDE 或真机测试证据。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献105条内容

所有评论(0)