
HarmonyOS 7 Vector Store + TaskPool:文搜图嵌入模型升级的双索引迁移与原子切换【鸿蒙心迹】
新模型上线以后,“红色跑车”的搜索结果确实更准了,但用户新增的照片能搜到,半年前的照片却突然沉到了结果底部。问题不在检索语句,而在新旧嵌入向量已经不能放在同一个距离空间里比较。
我给这次迁移做了一个独立工程:VectorEpoch Lab。迁移任务编号是 embed_20261001_18,旧模型 clip_v3 输出 512 维向量,新模型 clip_v4 输出 768 维向量。本地共有 12,840 张图片,17:08 时已完成 10,272 张,进度 80%,剩余 2,568 张。
运行状态不是简单的 RUNNING,而是 DUAL_READ。新查询使用 clip_v4 生成文本向量,同时在 v4 影子索引和 v3 正式索引中检索,然后按版本内部分数归一化合并。当前查询 p95 为 42 ms,回滚状态 READY,只有进度、数量和校验和全部通过,才会把活跃 epoch 从 v3 切到 v4。
一、模型换了,向量就不再是同一种数据
一开始我只在表里增加了 modelVersion字段,然后让后台任务逐条覆盖向量。这个做法有两个问题。第一,512 维和 768 维根本无法在同一索引配置中并存;第二,即使新旧模型维度相同,它们的嵌入空间也不能直接比距离。
这和普通字段迁移不同。把用户名从 64 个字符改成 128 个字符,旧值仍然可读;但嵌入模型换代以后,向量的每个分量都只在当前模型的语义空间里有意义。所以我不再把 v4 当作 v3 的一次就地升级,而是把它当成一个全新索引 epoch。
当前数据目录中有 media_catalog、embedding_manifest和两个物理索引。media_catalog 保留稳定的 assetId、修改时间和可见状态;manifest 记录 epoch、模型摘要、维度、已处理数和校验和;向量数据则放在 vec_clip_v3 与 vec_clip_v4_shadow。
二、先写影子索引,再决定是否切换
这段代码解决的是“迁移到一半应用被杀,下次启动如何继续,又不会污染当前正式索引”。每个批次先在 TaskPool 生成嵌入,再用一个 RDB 事务写入影子索引和迁移游标。
export class EpochMigrator {
  async migrateBatch(manifest: EpochManifest, assets: MediaAsset[]): Promise<void> {
    const task = new taskpool.Task(buildEmbeddings, {
      model: 'clip_v4',
      dimension: 768,
      items: assets.map(item => ({ id: item.assetId, uri: item.uri }))
    })
    const vectors = await taskpool.execute(task) as EmbeddingResult[]

    const tx = await this.rdb.createTransaction()
    try {
      await this.vectorStore.upsert('vec_clip_v4_shadow', vectors, tx)
      await this.manifestDao.advance(tx, manifest.epoch, vectors.length,
        checksumOf(vectors))
      await tx.commit()
    } catch (error) {
      await tx.rollback()
      throw error
    }
  }
}
这里不把向量以 ArkTS 对象长期留在主线程。TaskPool 返回一个批次后就交给数据层,事务成功后释放临时结果。如果应用在写向量后、更新游标前中断,事务会回滚;下次仍从原游标重做这批,不会出现“数据已经存在,进度却不知道”的半成功状态。
批次大小定为 64,不是因为 64 是通用最优值,而是在这台测试设备上,它让单次峰值内存、事务时间和取消响应比较均衡。正式项目应根据图像尺寸、模型耗时和设备压力调整,不要把 Demo 批量直接带到所有机型。
任务的恢复点也没有只存一个自增行号。相册资产会增删,行号在下一次查询时并不稳定;游标实际由 modifiedAt + assetId 组成,并在 manifest 中记录本批次输入摘要。恢复时先确认模型文件摘要仍是 clip_v4,再从复合游标继续。如果应用更新替换了同名模型,却沿用旧游标,前后批次会来自两个不同权重版本,最终数量完全正确,语义空间却已经裂开。
我还给迁移调度加了温度、电量和前后台限制。页面离开并不等于立刻销毁迁移任务,但设备进入低电量或温控等级升高时,当前批次完成后会暂停,不再领取下一批。选择批次边界暂停,是为了避免把一个事务停在半路。再次恢复时先读 manifest,而不是相信内存里的 processed,所以系统回收进程也不会让进度倒退或虚增。
三、双读不是把两组距离混在一起排序
迁移进度只有 80% 时,新索引不能单独服务,否则未迁移的 2,568 张图会像被删除一样从搜索结果中消失。但 v3 和 v4 的 cosine 分数分布不同,不能直接把 0.83 和 0.79 放在一起比。
下面这段代码解决的是“迁移期间既要优先使用新索引,又不能让旧照片消失”。查询先在两个 epoch 内各自取 TopK,再使用对应版本的分位映射做归一化,相同 assetId 只保留 v4 结果。
export async function dualSearch(query: string): Promise<SearchHit[]> {
  const [q3, q4] = await Promise.all([
    embedText('clip_v3', query),
    embedText('clip_v4', query)
  ])
  const [oldHits, newHits] = await Promise.all([
    vectorStore.search('vec_clip_v3', q3, 40),
    vectorStore.search('vec_clip_v4_shadow', q4, 40)
  ])

  const merged = new Map<string, SearchHit>()
  for (const hit of oldHits) merged.set(hit.assetId, normalize(hit, 'v3'))
  for (const hit of newHits) merged.set(hit.assetId, normalize(hit, 'v4'))
  return [...merged.values()].sort((a, b) => b.rankScore - a.rankScore).slice(0, 40)
}
双读是过渡状态,不是长期架构。它会多做两次文本嵌入与两次检索,所以 p95 从单索引的 27 ms 增加到 42 ms。这个代价可以接受,但不应在迁移完成后仍保留。如果页面退到后台,当前查询的两个子任务都要取消,不能只取消 UI 合并阶段。
归一化曲线来自固定验证集,而不是从当前四十条结果临时计算。临时做 min-max 会被极端分数拉伸,同一个查询在相册新增一张照片后就可能发生大幅跳变。v3 和 v4 各自保存一份分位点,把原始相似度映射到版本内百分位,再进入融合排序。这个分数只用于迁移阶段,切换完成以后直接返回 v4 的原始排序,避免长期维护两套不可解释的权重。
重复资产的处理也必须明确。同一张照片如果已经进入 v4,融合时不能因为 v3 也命中就获得两次加分。我用 assetId 去重,并明确让 v4 覆盖 v3;还没迁移的资产只有 v3 结果。这样随着迁移进度增长,一张资产只会从旧版本结果平滑替换为新版本结果,不会突然在列表里出现两份。
四、原子切换只改指针,不在切换时搬数据
最早的切换脚本会把 vec_clip_v4_shadow 重命名为正式表,同时删除 v3。数据量一大,这个操作很难保证短时完成,失败后也不容易判断当前名字指向哪份数据。
现在的做法是物理索引名不变,只在 manifest 中修改 activeEpoch。这段代码解决的是“所有验收条件通过时一次切换,任何一项不满足都继续留在 v3”。
export async function promoteEpoch(expected: PromotionGuard): Promise<void> {
  const tx = await rdb.createTransaction()
  try {
    const manifest = await manifestDao.lockForUpdate(tx, 'clip_v4')
    if (manifest.processed !== expected.total ||
        manifest.dimension !== 768 ||
        manifest.checksum !== expected.checksum ||
        manifest.state !== 'VERIFIED') {
      throw new Error('EPOCH_NOT_READY')
    }
    await manifestDao.setActiveEpoch(tx, 'clip_v4')
    await manifestDao.setRollbackEpoch(tx, 'clip_v3')
    await tx.commit()
  } catch (error) {
    await tx.rollback()
    throw error
  }
}
切换之后 v3 不立即删除,而是进入只读回滚期。如果 v4 的无结果率、重复率或查询耗时超出阈值,只需在新事务中把 activeEpoch 指回 v3。数据清理是另一个低优先级任务,要等回滚观察窗结束后再执行。
lockForUpdate 的目的不是单纯防止两个按钮同时被点。后台迁移、定时校验和开发调试页都可能尝试更新 manifest,如果不串行化,校验任务读到 VERIFIED 后准备切换的几毫秒内,另一个失败批次可能已经把状态改成 PAUSED。事务中的二次检查把“看到可以发布”和“真正发布”变成同一个原子判断。
切换操作本身不触碰 12,840 条向量,因此耗时与图库规模无关。用户正在搜索时,当前请求会持有它开始时读到的 epoch,新请求读取新的 active 指针;不会出现一个请求前半段查 v3、后半段查 v4 的情况。正式服务还应把 epoch 写进查询日志,出现排序投诉时才能还原当时使用的模型和索引。
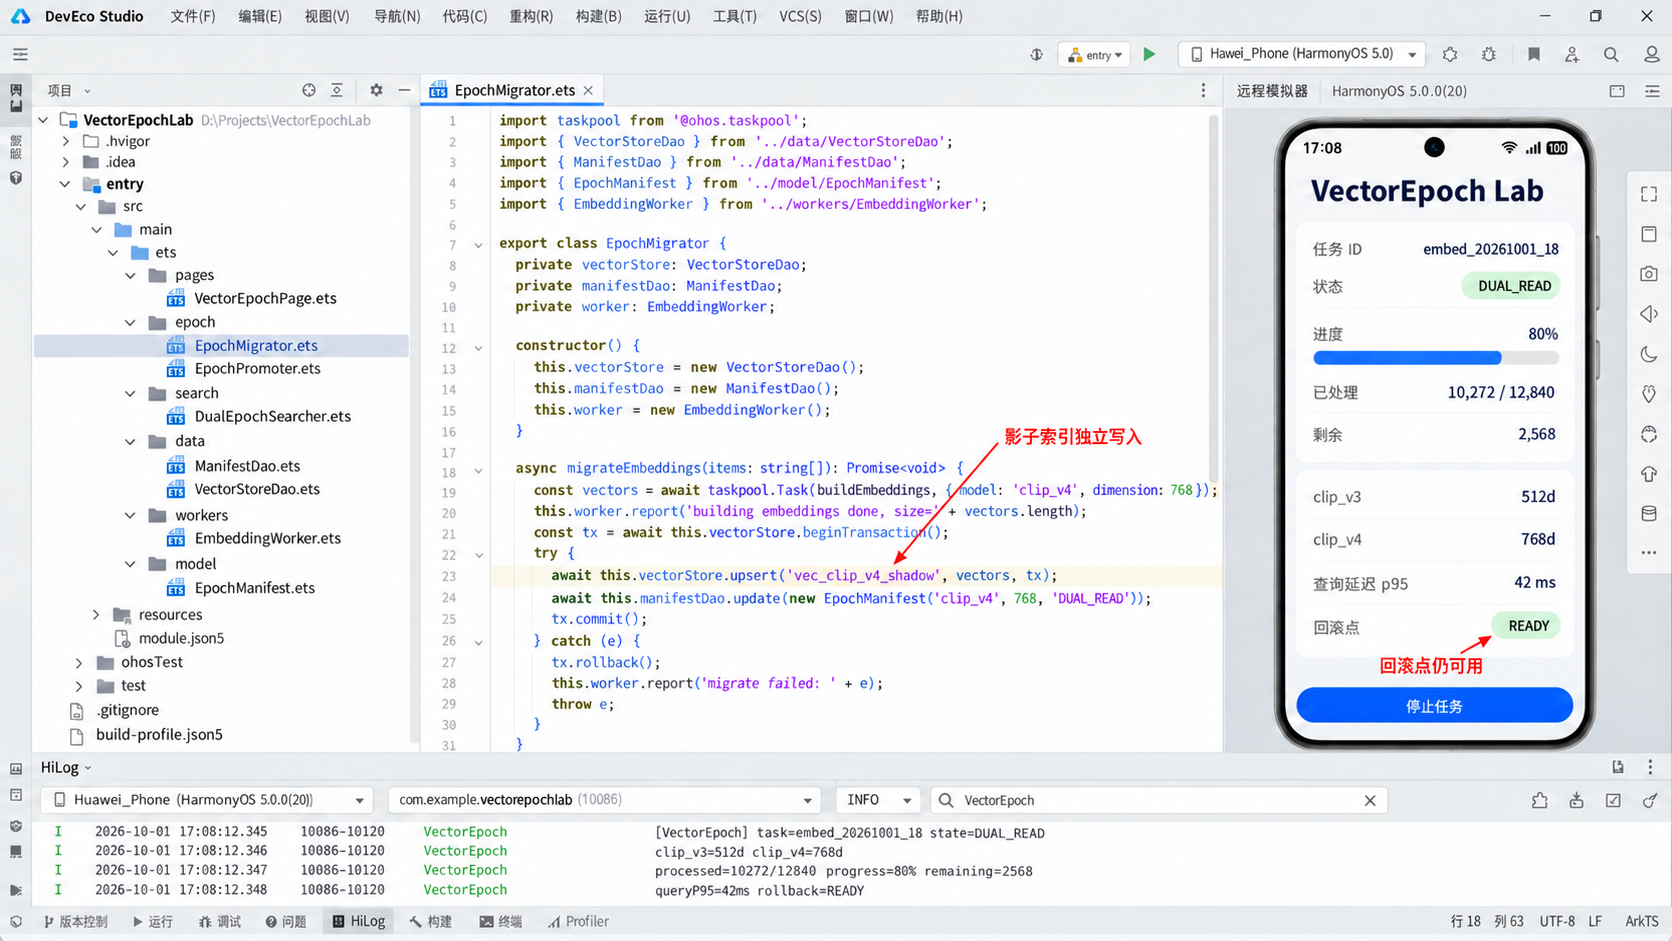
DevEco Studio 图中,左侧目录包含 epoch / search / data / workers,中间停在 EpochMigrator.ets,右侧模拟器显示 embed_20261001_18 / DUAL_READ / 80%。底部日志把 clip_v3 512d、clip_v4 768d、10272/12840、p95=42ms 和 rollback=READY 放在同一个视野里,用来证明当前是可回滚的双读,而不是两份向量被混到一张表中。
五、数量对上了,还不等于索引可以接管
迁移 12,840 张并得到 12,840 条向量,只能说没有少行。我还做了三层校验。第一层检查 assetId、模型版本和维度;第二层对向量做非法值、范数与摘要检查;第三层使用一组固定文本查询做回归,观察 Top10 中的基准图片是否仍在合理位置。
查询回归不要硬性要求 v4 与 v3 顺序完全相同,否则模型升级永远无法带来改善。比较的是人工标注集的命中率、无结果率和明显错误样本。当前 Demo 的红色跑车查询在 v4 中提升了前三位命中,而“黑板上的手写公式”没有出现退化。
我另外随机抽取了 200 条向量重新计算,检查存储值与模型输出的余弦差;这一步能抓住字节序、浮点精度和错误模型文件等“行数正确、内容错误”的问题。校验任务读取影子索引时只拿必要列,并限制并发,不能为了证明索引正确把迁移本身挤到后台。校验失败会把状态置为 VERIFY_FAILED,但不会删除影子索引,开发者可以保留失败样本继续定位。
还有一个容易漏的边界:迁移期间用户可能删除照片。生成向量前和写入前都要校验 modifiedAt与可见状态,否则影子索引会复活已删除资产。新增照片则同时写入当前活跃 epoch 和迁移目标 epoch,避免迁移进度追不上活数据增长。
六、手机页面要告诉我们“为什么还没切换”
迁移页没有只放一个 80% 进度条。它展示 v3 和 v4 的维度、已完成与待处理数量、双读耗时、校验状态以及回滚点。这样即使任务停在 80%,也能区分是设备在后台暂停,还是某批次校验失败。
进度来自已提交事务的 manifest,不使用“TaskPool 已经返回多少条”作为完成数。后者在事务回滚时会产生假进度:UI 显示 80%,数据库可能只有 79%。页面订阅 manifest 快照,每个批次提交后才刷新一次,既减少频繁重绘,也保证截图上的 10,272 真的是已经可检索的数据。
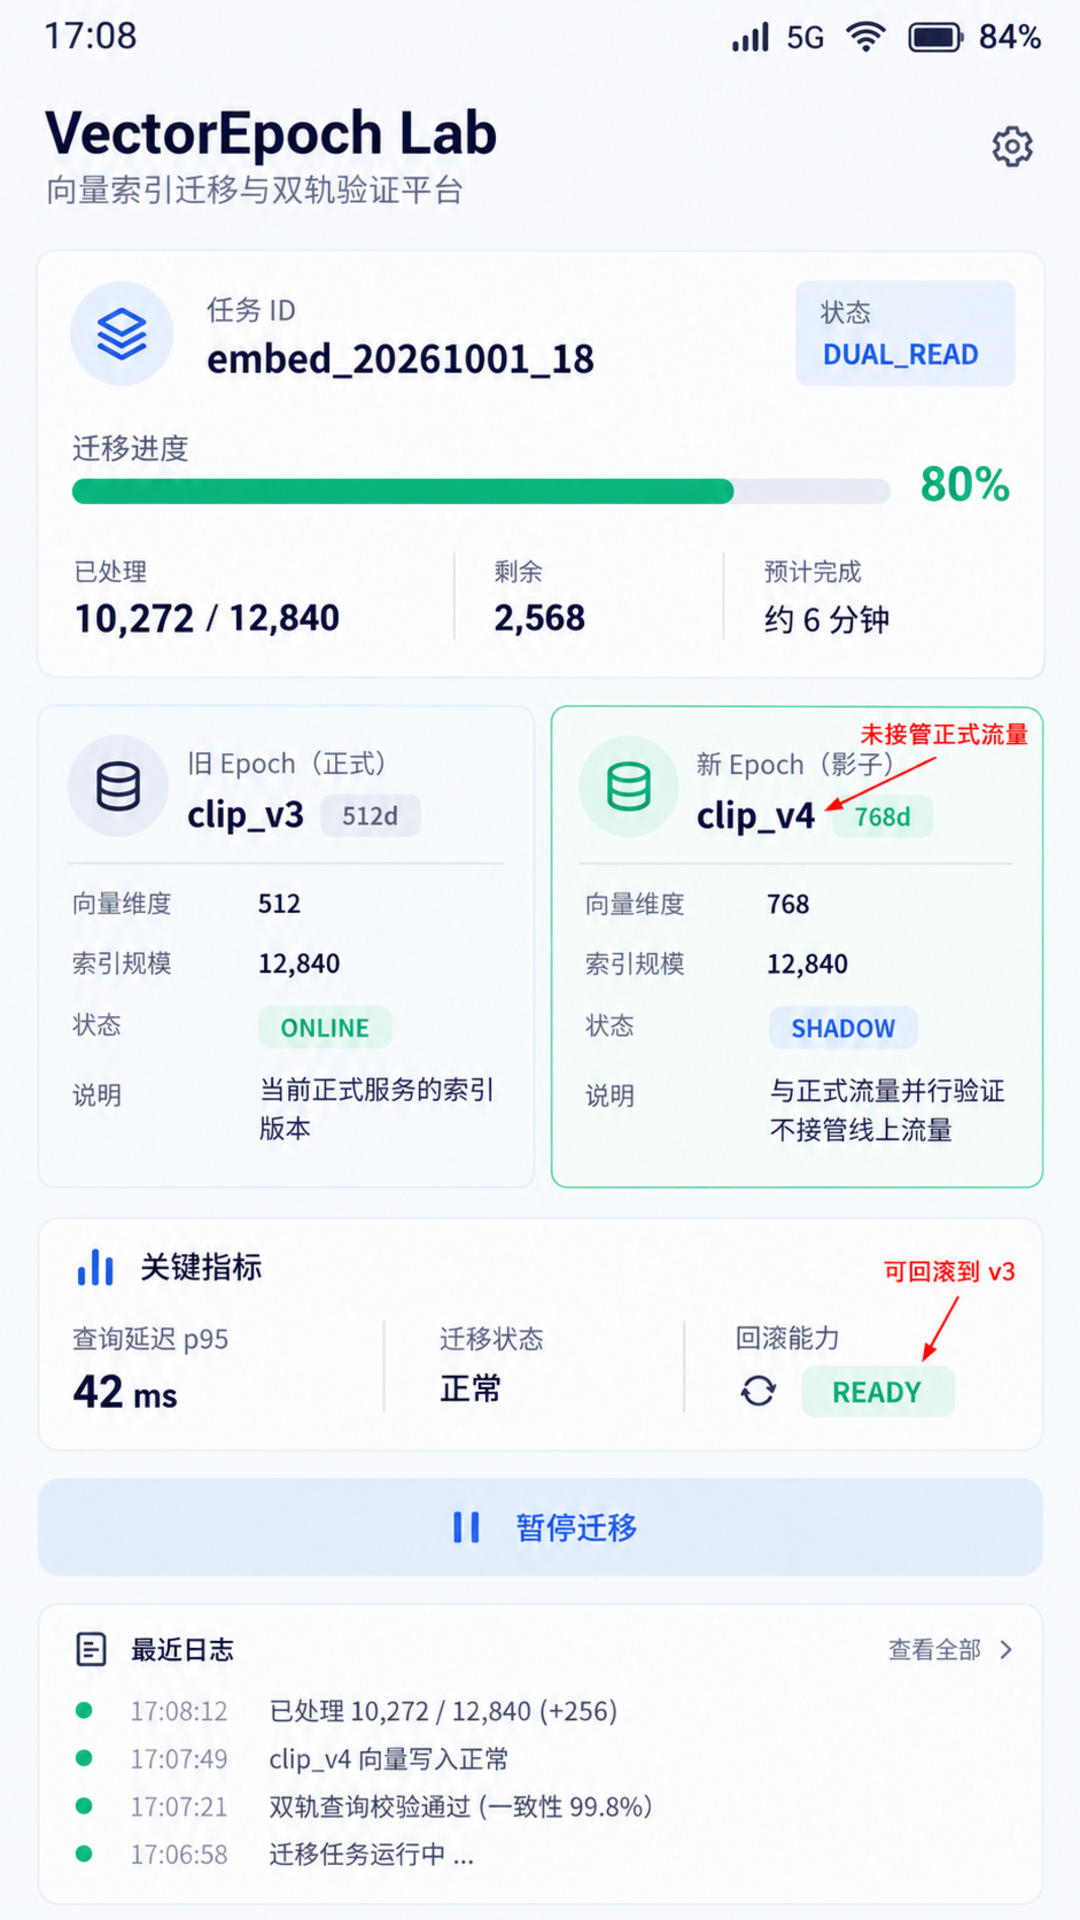
17:08 的手机页数据与正文保持一致:任务 embed_20261001_18,状态 DUAL_READ,v3 为 512d,v4 为 768d,进度 10,272 / 12,840,剩余 2,568,p95 42 ms,回滚 READY。红色批注只标出“影子索引未接管”和“回滚指针仍保留”,两个判断比一个漂亮的进度数字更有用。
七、模型升级应该像数据发布,不像文件替换
这次工作最大的改变,是不再把嵌入模型看成一个替换后立即生效的资源文件。它实际上改变了整个向量语义空间,因此需要独立版本、影子数据、过渡查询、验收门禁和回滚指针。
embed_20261001_18 在 80% 时没有急着把 v4 变成正式索引。它继续让 v3 承担完整性,v4 提供已迁移数据的新模型结果,直到 12,840 条数据、维度、摘要和回归样本都对上。对文搜图来说,新模型的准确率很重要,但比“更准”更基础的,是升级过程中旧照片仍然可被找到。
上线后的观察也沿用同一套 epoch 视角。我把无结果率、点击后返回率、重复资产率和 p95 都按 activeEpoch 分开统计,避免把 v3 的稳定数据和 v4 的异常平均在一起。只要回滚窗口还在,告警就携带当前与备用 epoch;值班人员看到问题时可以先切回 v3,再保留 v4 现场排查,而不是一边承受错误结果一边重新生成全库向量。
影子索引最终删除前还要过两个条件:回滚观察期结束,且没有任何活跃查询仍持有 v3 快照。清理任务先把 v3 标记为 RETIRED,等待引用计数归零后再分批释放文件。这样资源回收不会和搜索线程争用句柄,也不会因为一次删除失败把 active 指针弄乱。真正稳定的升级,不是切换按钮按下的那一刻,而是旧资源退出后系统仍能解释每一次状态变化。
参考资料:

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)