
HarmonyOS Native C++ + libarchive:离线资源包解压的路径穿越防护与配额熔断【鸿蒙心迹】
离线地图、模型、课件和皮肤资源常被打成压缩包,由应用下载后解包。功能实现并不难:读取条目、拼接输出目录、写文件。安全问题也恰好藏在这三步里——条目名可能包含 ../,可能是绝对路径,可能借助符号链接绕出目标目录;压缩包本身只有十几兆,解压后却可能占满应用沙箱。
本文构造一个 HarmonyOS Native C++ 演示工具 ArchiveGuard,页面名为 OfflinePackPage,任务编号 PACK-GUARD-0057。待检查文件是 offline-map-v12.tar.zst,压缩体积 18.4 MB,共 326 个条目。预扫描发现两条危险路径,声明展开体积为 271.4 MB,超过 256 MB 配额,状态因此为 SCANNING → BLOCKED。替换包包含 324 个条目,展开体积 183.7 MB,最终进入 VERIFIED_READY。所有结果来自演示夹具,不宣称对真实生产包完成过安全审计。
一、先扫描元数据,别边读边写
最危险的实现通常长这样:archive_read_next_header() 取到条目后,立刻把 archive_entry_pathname() 拼到应用目录,然后创建文件。此时安全检查与副作用交错。一旦第 200 个条目才发现越界路径,前 199 个条目已经写进磁盘,回滚需要追踪所有目录、权限和链接,稍有遗漏就留下半成品。
ArchiveGuard 把流程拆成两个阶段。第一阶段只读取头部和跳过数据,建立清单,检查路径、类型、条目数量和声明大小;只有整包通过,第二阶段才重新打开归档并写入临时目录。写完后再以目录切换或业务指针更新的方式发布。这样 BLOCKED 状态没有任何业务资源落盘,恢复动作只是丢弃输入包或等待替换包。
libarchive 官方头文件给出的典型读取顺序是:archive_read_new()、启用所需 filter/format、打开数据源、循环 archive_read_next_header(),最后释放。官方示例还说明,若只枚举头部,可使用 archive_read_data_skip() 跳过当前条目数据。本文沿用这一公开接口,不虚构 HarmonyOS 专有解压 API。
二、路径合规不是一个 startsWith 判断
假设目标目录是应用沙箱内的 files/offline/map-v12。危险条目 ../../etc/passwd 在字符串拼接后看似仍含有目标前缀,但路径规范化后会逃离根目录。绝对路径 /data/storage/el2/base/cache/payload.bin 更直接,它绕过相对根。反斜杠、空路径、重复分隔符、. 段、.. 段和 NUL 字节都需要在进入文件系统前统一处理。
这段代码解决什么问题:对归档条目名做纯词法规范化,并拒绝绝对路径、父级回退和空路径。
#include <string>
#include <string_view>
#include <vector>

struct PathCheck {
  bool ok;
  std::string normalized;
  std::string reason;
};

PathCheck CheckRelativePath(std::string_view raw) {
  if (raw.empty()) return {false, {}, "EMPTY_PATH"};
  if (raw.front() == '/' || raw.front() == '\\') {
    return {false, {}, "ABSOLUTE_PATH"};
  }
  if (raw.find('\0') != std::string_view::npos) {
    return {false, {}, "NUL_BYTE"};
  }

  std::vector<std::string> parts;
  std::string current;
  auto flush = [&]() -> bool {
    if (current.empty() || current == ".") {
      current.clear();
      return true;
    }
    if (current == "..") return false;
    parts.push_back(current);
    current.clear();
    return true;
  };

  for (char ch : raw) {
    if (ch == '/' || ch == '\\') {
      if (!flush()) return {false, {}, "PARENT_SEGMENT"};
    } else {
      current.push_back(ch);
    }
  }
  if (!flush()) return {false, {}, "PARENT_SEGMENT"};
  if (parts.empty()) return {false, {}, "EMPTY_NORMALIZED_PATH"};

  std::string normalized;
  for (const auto& part : parts) {
    if (!normalized.empty()) normalized.push_back('/');
    normalized += part;
  }
  return {true, normalized, {}};
}
为什么不调用文件系统的 canonical 直接判断?预扫描阶段目标文件尚未创建,canonical 对不存在路径的行为会让逻辑变复杂;更重要的是,词法合法不等于磁盘安全。上面的函数只负责第一道门:把条目变成可比较的相对路径,并明确拒绝 ..。第二阶段写盘时仍要防止目标树中已有符号链接导致路径重定向。
状态没有因为某个条目合法就变化。扫描器会收集整包问题,直到达到诊断上限或遇到不可恢复的格式错误。演示中两条危险路径分别得到 PARENT_SEGMENT 与 ABSOLUTE_PATH,页面只展示前两项,但日志保留条目序号,便于包生产方定位。
易错点是“先替换 ../ 再放行”。这种清洗会把攻击路径静默改写成另一个有效路径,可能覆盖同名业务文件。安全解包应拒绝整个包,让供应链修复输入,而不是猜测发送方意图。
三、配额必须按展开体积累计,并防整数溢出
压缩体积不能代表解压成本。18.4 MB 的包声明展开体积 271.4 MB,已经超过演示配额 256 MB。此外还要限制条目数、单文件大小、目录深度和未知大小条目。只检查总大小不够:十万个零字节文件同样能消耗大量 inode 和扫描时间。
这段代码解决什么问题:在不解压数据的前提下累计条目元数据,并对数量、单文件与总展开体积执行熔断。
#include <archive.h>
#include <archive_entry.h>
#include <cstdint>
#include <limits>

struct ScanQuota {
  int64_t maxEntries = 1000;
  int64_t maxSingleBytes = 64LL * 1024 * 1024;
  int64_t maxExpandedBytes = 256LL * 1024 * 1024;
};

struct ScanStats {
  int64_t entries = 0;
  int64_t expandedBytes = 0;
  int unsafePaths = 0;
  std::string reason;
};

bool AddChecked(int64_t value, int64_t* total) {
  if (value < 0 || *total > std::numeric_limits<int64_t>::max() - value) return false;
  *total += value;
  return true;
}

bool ApplyQuota(archive_entry* entry, const ScanQuota& quota, ScanStats* stats) {
  if (++stats->entries > quota.maxEntries) {
    stats->reason = "ENTRY_LIMIT";
    return false;
  }
  const int64_t size = archive_entry_size_is_set(entry) ? archive_entry_size(entry) : -1;
  if (size < 0) {
    stats->reason = "UNKNOWN_ENTRY_SIZE";
    return false;
  }
  if (size > quota.maxSingleBytes) {
    stats->reason = "SINGLE_FILE_LIMIT";
    return false;
  }
  if (!AddChecked(size, &stats->expandedBytes) ||
      stats->expandedBytes > quota.maxExpandedBytes) {
    stats->reason = "EXPANDED_SIZE_LIMIT";
    return false;
  }
  return true;
}
使用 int64_t 并不自动安全,累计前仍要检查加法溢出。未知大小条目在演示策略中直接拒绝,这是为了让预扫描给出确定上界。如果业务必须支持未知大小流,就要在第二阶段按实际写入字节再设一层硬限制,并确保超过阈值时立即停止、关闭句柄、删除临时目录。
这里的 64 MB 单文件、256 MB 总量和 1000 条目都是 ArchiveGuard 的产品策略,不是 libarchive 默认值,也不是 HarmonyOS 平台上限。实际值应来自设备档位、磁盘预算和资源包协议。配额还应给下载缓存、临时解包和正式目录分别留预算,不能把可用空间全分给最终文件。
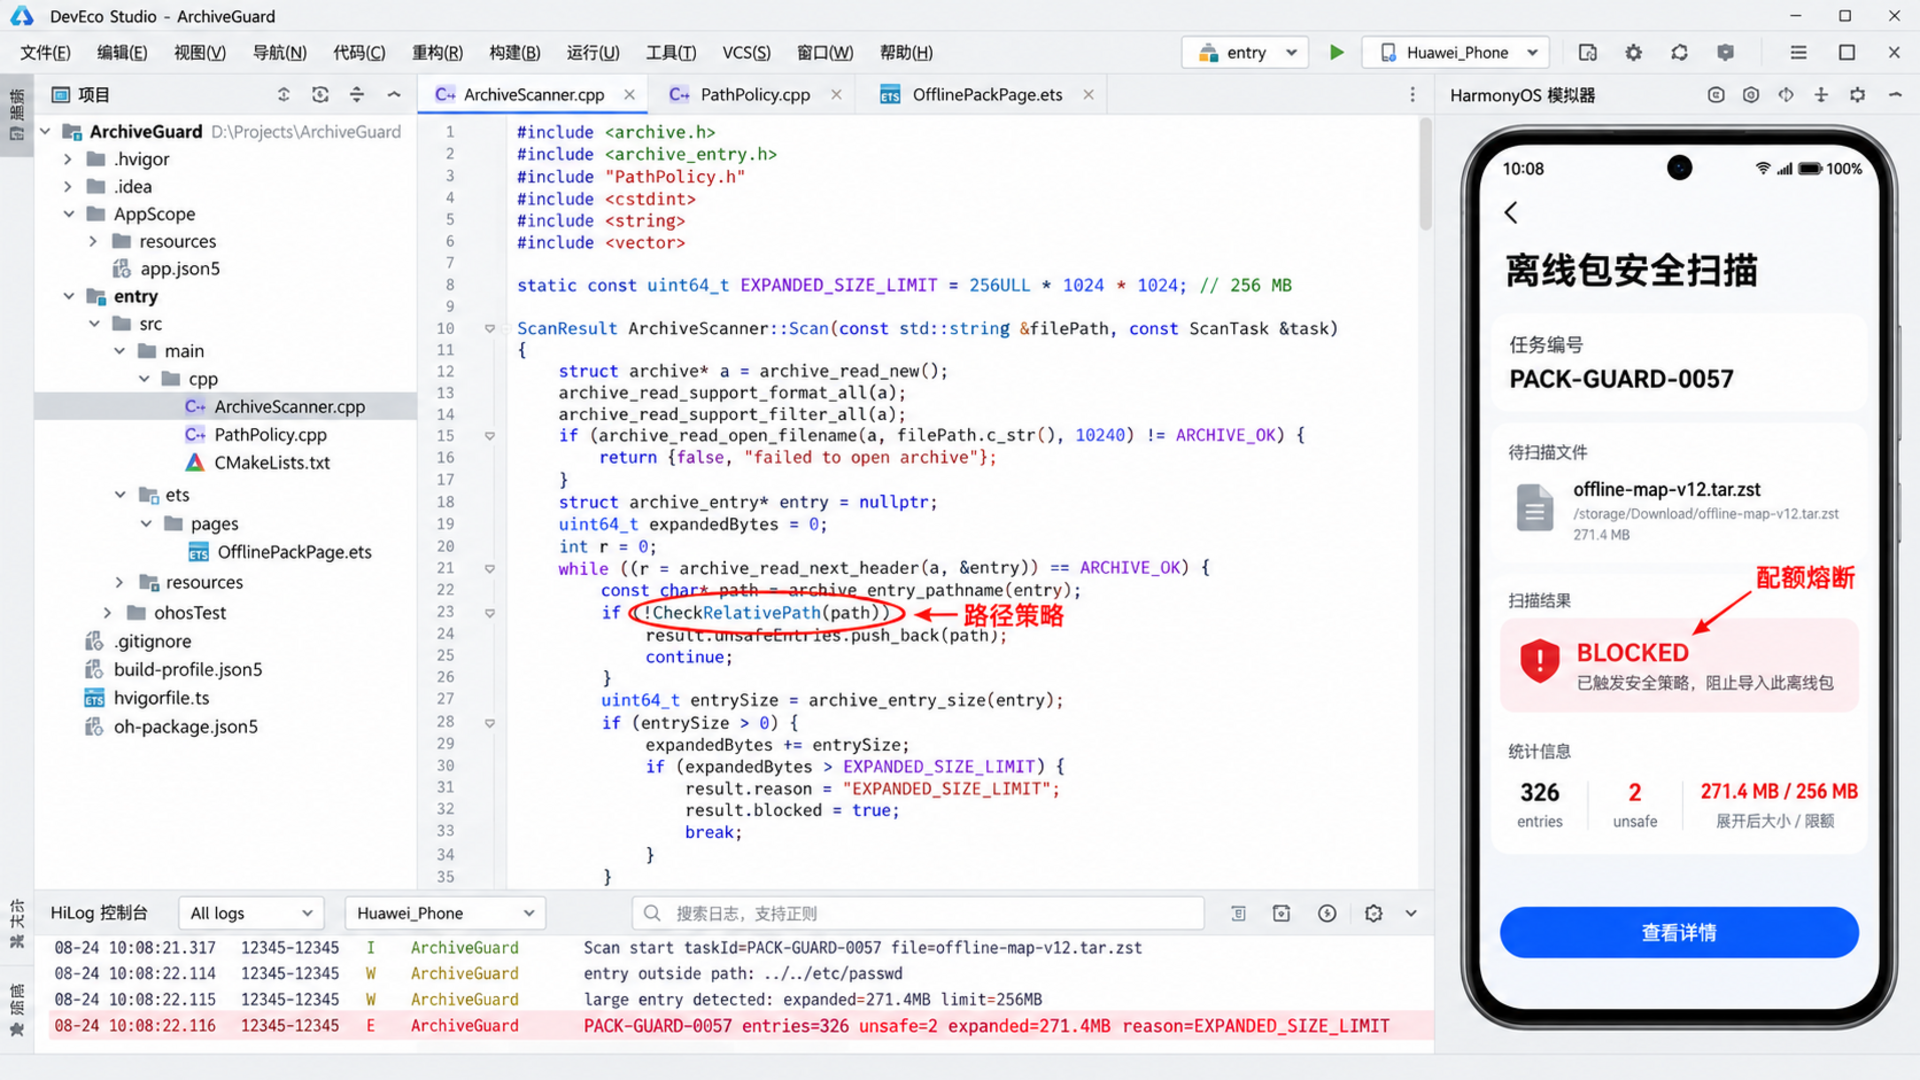
开发配图中,左侧工程树将 ArchiveScanner.cpp、PathPolicy.cpp 和 OfflinePackPage.ets 分开;中间 C++ 代码停在 EXPANDED_SIZE_LIMIT;右侧模拟器显示 BLOCKED;底部 HiLog 记录 PACK-GUARD-0057 entries=326 unsafe=2 expanded=271.4MB。这是演示界面,不冒充 DevEco Studio 的真实运行证据。
四、把扫描器做成有明确所有权的 Native 对象
压缩包扫描可能持续数百毫秒,不能阻塞 ArkUI 主线程。Native 层负责顺序读取,ArkTS 层只接收阶段性结果。边界上最重要的不是传很多字段,而是定义所有权:扫描任务只能结束一次,归档句柄只能释放一次,页面离开后不得继续回调已销毁的 UI。
这段代码解决什么问题:用 RAII 管理 libarchive 句柄,并完成只读预扫描的主循环。
#include <memory>

struct ArchiveDeleter {
  void operator()(archive* value) const {
    if (value != nullptr) archive_read_free(value);
  }
};
using ArchivePtr = std::unique_ptr<archive, ArchiveDeleter>;

ScanStats ScanArchive(const std::string& file, const ScanQuota& quota) {
  ScanStats stats;
  ArchivePtr reader(archive_read_new());
  if (!reader) {
    stats.reason = "ALLOC_READER_FAILED";
    return stats;
  }
  archive_read_support_filter_all(reader.get());
  archive_read_support_format_all(reader.get());
  if (archive_read_open_filename(reader.get(), file.c_str(), 10240) != ARCHIVE_OK) {
    stats.reason = archive_error_string(reader.get());
    return stats;
  }

  archive_entry* entry = nullptr;
  int result = ARCHIVE_OK;
  while ((result = archive_read_next_header(reader.get(), &entry)) == ARCHIVE_OK) {
    const char* name = archive_entry_pathname(entry);
    const PathCheck path = CheckRelativePath(name == nullptr ? "" : name);
    if (!path.ok) {
      ++stats.unsafePaths;
    }
    if (!ApplyQuota(entry, quota, &stats)) break;
    archive_read_data_skip(reader.get());
  }
  if (result != ARCHIVE_EOF && result < ARCHIVE_OK && stats.reason.empty()) {
    stats.reason = archive_error_string(reader.get());
  }
  if (stats.unsafePaths > 0 && stats.reason.empty()) stats.reason = "UNSAFE_PATH";
  return stats;
}
ArchivePtr 把释放动作绑定到作用域,任何提前返回都会调用 archive_read_free()。扫描阶段没有 archive_write_*,因此不会创建文件。archive_read_data_skip() 表达了“只读头部”的意图,即便官方示例指出进入下一条目时库也可自动跳过,显式调用更利于代码审查。
需要注意两个边界。其一,archive_entry_size() 是归档声明值,不是可信事实;它适合预筛,但不能替代写入阶段的实际字节计数。其二,启用 support_filter_all 和 support_format_all 会扩大接受面;生产项目若协议固定为 tar+zstd,收窄到所需 filter 与 format 更利于减少体积和输入面。
libarchive 的磁盘写入接口提供 ARCHIVE_EXTRACT_SECURE_NODOTDOT 与 ARCHIVE_EXTRACT_SECURE_SYMLINKS 等安全选项。即便已经做词法检查,写盘阶段仍应启用等价保护,因为磁盘上的现有链接可能改变解析结果。安全策略需要“应用层白名单 + 库的安全选项 + 沙箱根目录”三层同时成立。
五、ArkTS 页面只消费不可变结果,不拼接原生指针
页面状态被限定为 IDLE、SCANNING、BLOCKED、VERIFIED_READY、FAILED。Native 层返回普通值对象:任务 ID、条目数、危险路径数、展开字节和原因。ArkTS 不持有归档条目指针,也不在回调里再次读取 Native 可变内存。
这段代码解决什么问题:把扫描结果映射为确定的 UI 状态,并丢弃页面离开后到达的旧任务回调。
type GuardState = 'IDLE' | 'SCANNING' | 'BLOCKED' | 'VERIFIED_READY' | 'FAILED'

interface NativeScanResult {
  taskId: string
  entries: number
  unsafePaths: number
  expandedBytes: number
  reason: string
}

@Entry
@Component
struct OfflinePackPage {
  @State state: GuardState = 'IDLE'
  @State detail: string = ''
  private activeTask: string = ''
  private visible: boolean = false

  aboutToAppear(): void { this.visible = true }
  aboutToDisappear(): void {
    this.visible = false
    this.activeTask = ''
  }

  async scan(file: string): Promise<void> {
    const taskId = 'PACK-GUARD-0057'
    this.activeTask = taskId
    this.state = 'SCANNING'
    const result: NativeScanResult = await archiveGuard.scan(file, taskId)
    if (!this.visible || this.activeTask !== result.taskId) return

    const mb = (result.expandedBytes / 1024 / 1024).toFixed(1)
    this.detail = `${result.entries} entries · ${result.unsafePaths} unsafe · ${mb} MB`
    this.state = result.unsafePaths > 0 || result.reason.length > 0
      ? 'BLOCKED' : 'VERIFIED_READY'
  }
}
页面离开时把 activeTask 清空,不代表 Native 线程一定被取消,但能保证迟到结果不会污染新页面。更完整的实现还应向 Native 层发送取消标记,使扫描循环在条目边界尽快退出。取消和资源释放要分开理解:回调被忽略之后,归档句柄仍必须由 RAII 正常回收。
状态从 SCANNING 进入 BLOCKED 的判定是危险路径数大于零,或扫描原因非空。替换包重新发起同一个业务任务时,建议使用新的执行 token,而不是只比较固定任务号;本文为保持图片与正文简洁,把业务任务号固定为 PACK-GUARD-0057,生产代码应另加递增 attempt。
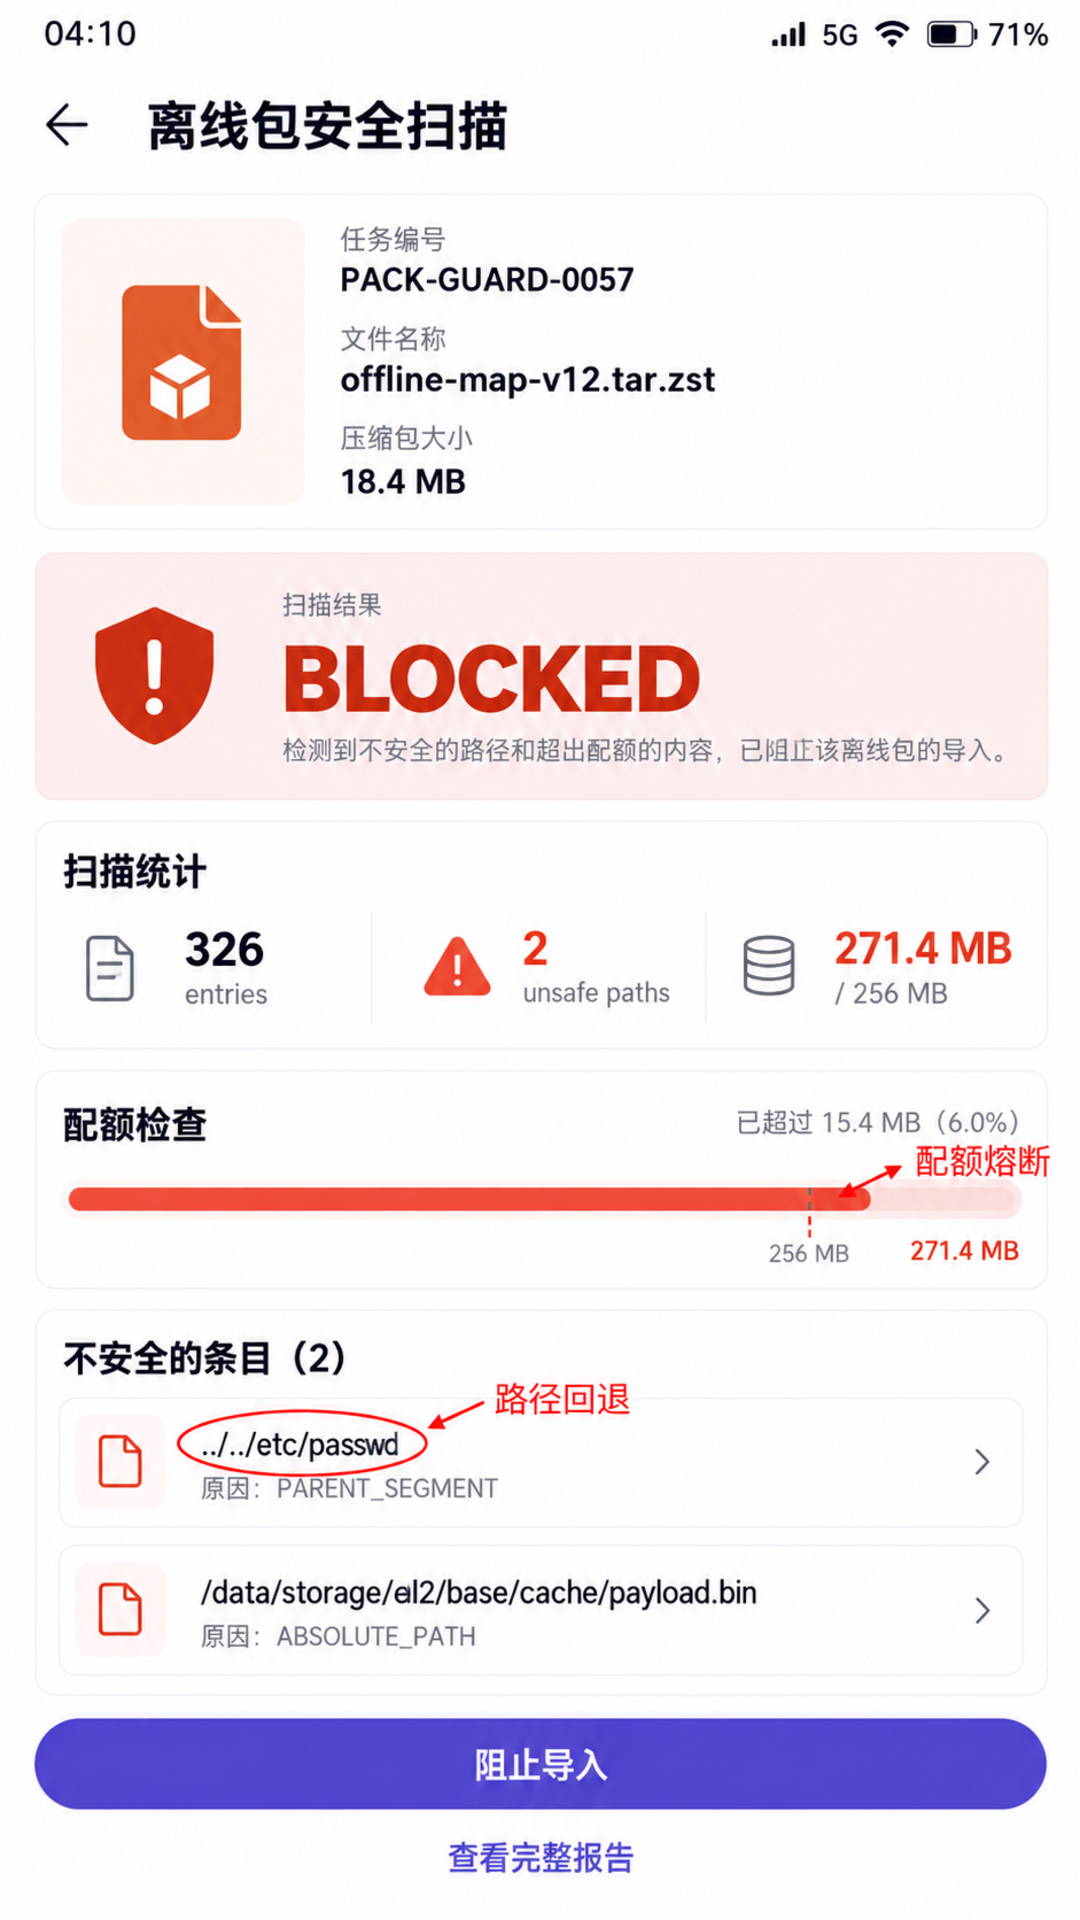
运行图展示首包扫描结果:18.4 MB、326 entries、2 unsafe paths、271.4 MB / 256 MB,状态为 BLOCKED。红色箭头分别指向父级回退路径与配额条,顶部状态栏时间 04:10、电量 71%。
六、替换包不是“忽略错误继续解压”
遇到坏包后,一个诱人的产品需求是“跳过两个危险条目,其余继续用”。这会造成内容与签名清单不一致,也会让同一版本在不同设备上得到不同文件集。ArchiveGuard 的恢复动作是整包替换:供应方生成 324 条目的修正版,展开体积 183.7 MB,再次从零预扫描,通过后才进入 VERIFIED_READY。
诊断页保留两次尝试:Attempt 1 为 BLOCKED,原因包括 PARENT_SEGMENT、ABSOLUTE_PATH 与 EXPANDED_SIZE_LIMIT;Attempt 2 为 VERIFIED_READY,unsafe=0,183.7 MB。这里的“VERIFIED”只表示通过本文定义的结构与配额策略,不代表完成数字签名验证、恶意内容检测或业务语义校验。命名边界必须写进接口文档,避免上层把它误解为完整供应链可信。
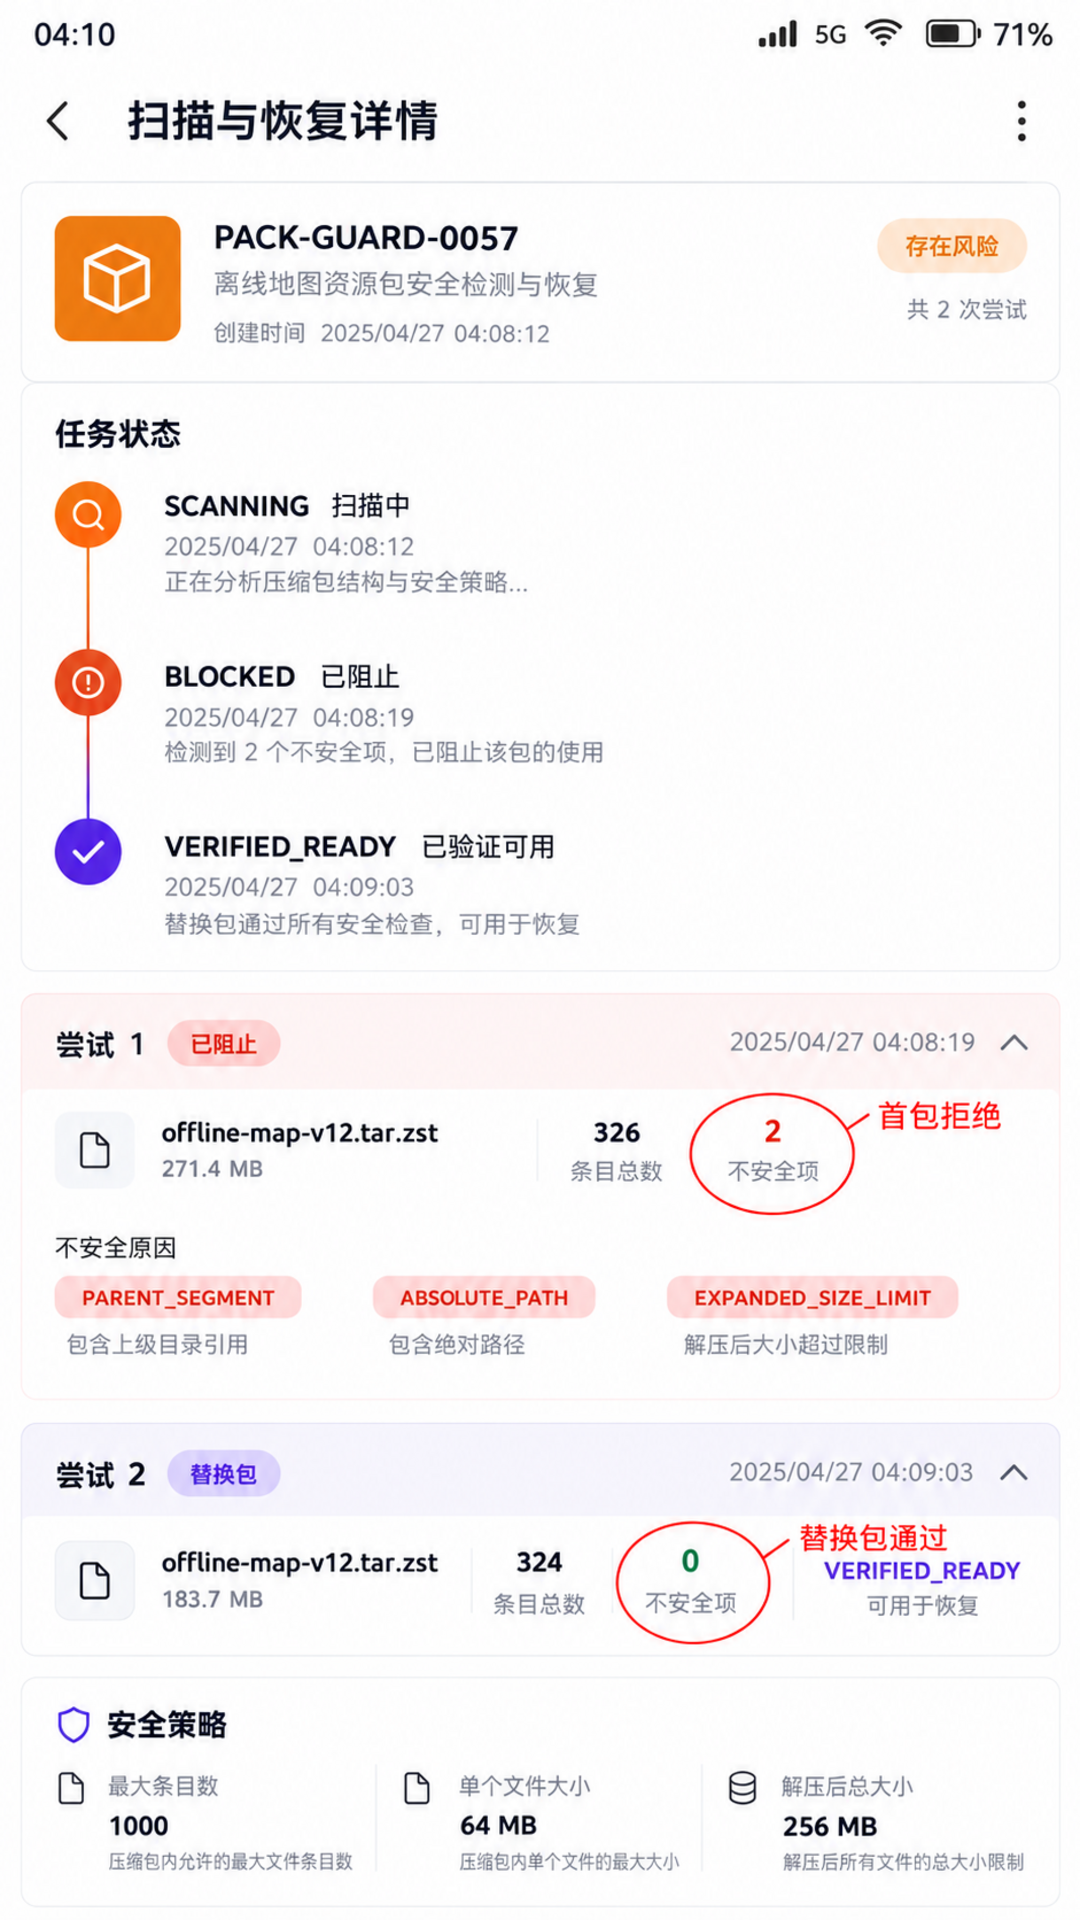
详情图用时间线呈现 SCANNING → BLOCKED → VERIFIED_READY,同时展示两个被拒路径和替换包统计。红圈标出第二次尝试的 unsafe=0,让图片承担恢复逻辑说明,而不是重复首页数据。
七、真正落盘时还要补齐四道闸门
第一道是文件类型白名单。普通文件与目录可以按协议处理,符号链接、硬链接、设备节点和 FIFO 默认拒绝。若产品确实需要链接,必须为链接目标单独做根目录约束,不能沿用普通文件路径检查。
第二道是实际写入计数。声明大小可能错误或缺失,写入循环每消费一块数据都要增加 actualExpandedBytes,超过 256 MB 立即熔断。临时文件应关闭后删除,异常路径要覆盖短写、磁盘满、取消和进程退出。
第三道是临时目录隔离。不要直接写正式资源目录。使用任务专属临时目录,任务 ID 与随机 token 共同命名;全部完成后校验清单,再原子更新业务指针。失败时只清理该明确目录,避免广泛递归删除。
第四道是内容完整性。本文聚焦解压边界,没有实现签名与摘要校验。生产分发至少要在可信清单中固定包摘要、协议版本和期望文件集合,并在解压前后分别校验。结构安全解决“写到哪里、写多少”,不解决“内容是否来自可信发布者”。
还有一个工程取舍:把 libarchive 作为三方库引入时,应固定来源与版本,记录许可证和编译选项,并只启用协议需要的压缩算法。本文不写死某个未经核验的 HarmonyOS SDK 或 libarchive 版本号;API 以 libarchive 官方当前头文件为依据,具体集成需按项目工具链重新编译和回归。
1. 用恶意夹具验证拒绝顺序
安全测试不应该只准备一个包含 ../ 的 zip。至少要覆盖绝对路径、连续父级段、反斜杠分隔、空路径、超长名称、重复文件名、同名文件与目录、符号链接后跟子文件、硬链接、未知大小、单文件超限、总量超限和条目数超限。每个夹具只突出一个首要问题,另准备一个混合夹具验证扫描器能否在诊断上限内稳定收敛。
拒绝顺序也要固定。ArchiveGuard 先检查条目名称和类型,再累计配额;但即使路径已不安全,仍可在不读取数据的前提下继续收集有限数量的问题。遇到格式损坏、读取器进入 fatal 状态或诊断条数达到上限则立即停止。这样页面不会因为恶意包包含十万条坏路径而生成十万条字符串并耗尽内存。
对总量配额的测试不能只相信头部声明。可以准备一个声明大小合理但实际数据超出的异常夹具,确认第二阶段的实际字节计数能够中止写入。还要模拟磁盘空间在扫描后、写入前发生变化:预扫描通过不是预留空间,真正落盘仍可能返回空间不足。此时状态应是 FAILED,不能沿用 BLOCKED,因为前者是环境失败,后者是输入被策略拒绝。
2. 临时目录清理要窄、可重试、可审计
清理代码是安全边界的一部分。任务失败时只允许删除由当前任务创建、且根路径经过校验的临时目录。不能把服务端下发的版本号直接拼成删除目标,也不能在根目录变量为空时继续递归操作。删除前验证父目录和任务 token,删除后记录结果;失败则进入下一次启动时的孤儿目录清理队列。
孤儿清理需要年龄阈值,避免把仍在运行的并发任务当垃圾。目录元数据可保存任务 ID、创建时间、目标版本和完成标记。只有没有完成标记、超过阈值、且不在当前活跃任务集合中的目录才可删除。这个机制比“启动时清空 tmp”复杂一些,却能显著降低多任务或进程恢复场景中的误删风险。
正式目录也不应被覆盖式写入。更可靠的发布方式是版本化目录加一个很小的当前版本指针:新目录全部校验通过后再更新指针,旧目录延迟回收。若进程在更新前退出,用户仍使用旧版本;若更新后退出,新版本已经完整。是否能依赖特定文件系统原子语义,需要按平台与实际 API 验证,不能仅凭桌面系统经验推断。
3. 性能优化不能绕过安全扫描
有人会担心两遍读取增加耗时,进而建议边扫描边解压。对本地文件而言,第二遍通常仍命中系统缓存,额外成本换来清晰事务边界;对大包可考虑让第一遍只读头部,第二遍顺序写入。若数据源不可重放,则应先落到受配额限制的下载缓存,再执行双阶段流程,而不是降低安全要求。
扫描进度应基于已处理条目或已读取压缩字节,并明确它只是“检查进度”,不能假装成精确解压百分比。archive_entry_size() 的总和在扫描完成前并不知道,早期百分比容易回退。页面可展示条目数和当前阶段,等清单建立后再给出第二阶段的字节进度。
Native 线程每处理若干条目检查一次取消标记,频率要在响应与锁开销之间平衡。取消后不再投递业务结果,但仍要执行句柄释放和临时文件关闭。若回调通道已经销毁,Native 侧也应安全丢弃事件;不要用“页面会忽略”代替线程侧生命周期治理。
4. 上线前把策略变成机器可读配置
配额若散落在 C++ 常量、ArkTS 提示语和服务端文档中,迟早会出现页面写 256 MB、Native 实际限制 200 MB 的分裂。更稳妥的方式是由 Native 层暴露一份只读策略摘要,UI 只负责格式化;策略包含最大条目数、单文件上限、总展开上限、允许格式和链接规则,并带一个版本号写入日志。
策略可以随应用版本调整,但不应由未签名的远端字段随意放宽。服务端可要求更严格的限制,客户端本地上限则构成不可突破的硬边界。遇到旧资源包不兼容时,应通过版本迁移或重新打包解决,而不是临时关闭 PARENT_SEGMENT、链接检查或实际写入计数。
最终验收至少核对:首包没有产生正式文件;两条危险路径在日志与页面中的原因一致;271.4 MB 在 256 MB 阈值前被拒;替换包重新扫描而非复用旧清单;页面离开时旧回调被丢弃;任何提前返回都能释放 reader。任务 PACK-GUARD-0057 只有同时满足这些条件,才算完成结构安全闭环。
八、结语:安全解包是一个事务,不是一个 for 循环
离线包处理最可靠的模型是“扫描—判决—写临时区—校验—发布”。路径检查必须发生在任何写入之前,配额既看声明值也看实际值,句柄与回调需要明确所有权,失败不能留下部分可见资源。
演示任务 PACK-GUARD-0057 给出了一组可复查数据:首包 18.4 MB、326 条目、两条危险路径、声明展开 271.4 MB,在 256 MB 配额前进入 BLOCKED;替换包 324 条目、183.7 MB、危险路径为零,进入 VERIFIED_READY。这些数据证明的是策略闭环,而不是宣称完成生产环境渗透测试。
参考资料:
- libarchive 官方头文件与读取流程:https://github.com/libarchive/libarchive/blob/master/libarchive/archive.h
- libarchive 官方示例:https://github.com/libarchive/libarchive/wiki/Examples
- FreeBSD libarchive 磁盘写入安全选项手册:https://man.freebsd.org/cgi/man.cgi?query=archive_write_disk_set_options&sektion=3

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)