
HarmonyOS 7 + Core Vision Kit-TaskPool:文搜图相似度阈值分桶与硬负样本回流【鸿蒙心迹】
文搜图接口返回了相似度,工程里最容易做的决定就是找一个全局阈值:大于 0.72 展示,小于 0.72 丢弃。这个实现只需要一行代码,却把三个问题揉在一起:人像描述、票据文字和风景语义的分数分布并不相同;TopK 结果中的高分错误项往往有稳定模式;阈值一旦改动,如果没有可重复的样本集,团队只能靠几次手工搜索判断“好像更准了”。
本文用 ThresholdBench 演示工程,把阈值从 UI 常量改造成可审计的校准产物。任务编号是 SEARCH-CAL-0061,页面为 SearchAuditPage,索引作用域固定为 cal2026。演示样本含 240 条查询,每条查询有一个预期命中;全局阈值 0.72 的基线是 TP=219、FP=40、FN=21,精确率 84.6%、召回率 91.3%。经过分桶与 37 条硬负样本回流后,结果变为 TP=213、FP=11、FN=27,精确率 95.1%、召回率 88.8%。这些是文中构造的验收数据,用于说明方法,不代表官方能力的通用精度。
一、阈值不是模型参数,而是业务决策
HarmonyOS 7/API 26 的 textSearchImage 提供文本搜索图片能力。官方 API 返回 ImageObject[],每个对象包含图片沙箱路径、scope 和范围为 [-1, 1] 的 similarity;search(query, scope, topKey?) 的 topKey 范围为 0~100。接口负责召回与排序,却不会替业务决定“多少分可以展示”。
这条边界很重要。0.72 并不是平台保证的正确线,也不应该被写成“模型阈值”。它只是某批样本、某种内容分布、某个误判成本下的产品策略。票据搜索错把小票当发票,可能影响归档;风景搜索少展示一张相近照片,代价通常更低。两个场景共用一个阈值,看起来统一,实际上掩盖了不同风险。
ThresholdBench 把查询分为三类:portrait、document、scenery。校准后的阈值分别是 0.78、0.83、0.69。票据类最高,因为数字、表格和白底纸张会产生大量“长得像”的硬负样本;风景类最低,因为语义更宽,过高阈值会吞掉合理结果。阈值表与代码一起进入版本控制,每次变更都要附带样本统计。
二、先保存原始分数,别在采集阶段做裁剪
校准工作的第一个原则,是把原始结果与展示策略分开。采集阶段如果已经按 0.72 过滤,后续就无法评估 0.69 或 0.83,也看不到阈值附近的错误样本。演示代码每次搜索取 topKey=20,保存路径、scope、similarity、查询类别和人工标签;UI 展示再读取策略阈值。
这段代码解决什么问题:按官方签名调用文搜图能力并保存未经业务阈值裁剪的原始候选,保证校准可重放。
import { textSearchImage } from '@kit.CoreVisionKit';
import { BusinessError } from '@kit.BasicServicesKit';

type QueryBucket = 'portrait' | 'document' | 'scenery';

interface RawCandidate {
  queryId: string;
  query: string;
  bucket: QueryBucket;
  imagePath: string;
  scope: string;
  similarity: number;
}

async function collectCandidates(
  queryId: string,
  query: string,
  bucket: QueryBucket
): Promise<RawCandidate[]> {
  try {
    const results = await textSearchImage.search(query, 'cal2026', 20);
    return results.map(item => ({
      queryId,
      query,
      bucket,
      imagePath: item.imagePath,
      scope: item.scope,
      similarity: item.similarity
    }));
  } catch (error) {
    const err = error as BusinessError;
    console.error(`[ThresholdBench] search failed code=${err.code}`);
    return [];
  }
}
为什么使用固定 scope 和 topKey?scope 是索引隔离边界,校准集必须与线上相同语义域;topKey 固定后,不同阈值报告才有可比性。状态从 COLLECTING 进入 RAW_READY 时,保存的是完整候选,不做 similarity >= threshold。如果官方返回错误码 1013100003,文档要求清理数据后重新使用能力,工程应进入显式的 INDEX_REBUILD_REQUIRED,而不是吞掉异常并输出空报告。
容易出错的是把“没有结果”和“调用失败”都表示为空数组。示例为压缩篇幅返回空数组,但真实项目应携带错误状态,否则评估会把服务异常误判成 FN。初始化与释放也必须成对:页面或服务启动时调用 textSearchImage.init(),任务结束或生命周期退出时调用 release();不要每条查询重复初始化,也不要在仍有搜索任务时提前释放。
三、用混淆矩阵决定阈值,不用单个漂亮案例
阈值评估需要最小的标签模型。每条查询至少标记一个预期路径,并允许额外候选被标记为相关或不相关。对某个阈值而言,相关且通过的是 TP,不相关却通过的是 FP,相关但被挡住的是 FN。精确率回答“展示出来的结果有多少是对的”,召回率回答“应该找到的结果有多少被找到”。
这段代码解决什么问题:在任意阈值下计算 TP、FP、FN、精确率和召回率,为分桶比较提供统一口径。
interface LabeledCandidate extends RawCandidate {
  relevant: boolean;
}

interface Metrics {
  threshold: number;
  tp: number;
  fp: number;
  fn: number;
  precision: number;
  recall: number;
}

function evaluate(rows: LabeledCandidate[], threshold: number): Metrics {
  let tp = 0;
  let fp = 0;
  let fn = 0;
  rows.forEach(row => {
    const accepted = row.similarity >= threshold;
    if (accepted && row.relevant) tp += 1;
    if (accepted && !row.relevant) fp += 1;
    if (!accepted && row.relevant) fn += 1;
  });
  const precision = tp + fp === 0 ? 1 : tp / (tp + fp);
  const recall = tp + fn === 0 ? 1 : tp / (tp + fn);
  return { threshold, tp, fp, fn, precision, recall };
}
基线阈值 0.72 得到 TP=219、FP=40、FN=21。精确率计算为 219/(219+40)=84.6%,召回率为 219/(219+21)=91.3%。这些数字要一起看:只追求更高阈值,精确率会上升,但 FN 也会增加;只追求召回,结果页会被似是而非的图片污染。
项目里的常见错误是只统计 Top1 是否正确。Top1 适合衡量排序头部,但无法回答“展示十张时有几张错误”。另一个错误是允许同一图片同时出现在训练决策和验收集里,阈值会对已知样本过拟合。演示把 240 条查询按固定 hash 分成校准集与验证集,硬负样本只追加到下一轮,不回写当前报告。
四、分桶校准要有单调、可解释的搜索过程
阈值不是越精细越好。按每个关键词单独配置会变成不可维护的规则库,按三类业务风险分桶则相对稳定。本例候选阈值从 0.60 到 0.90,步长 0.01;每个桶先满足最低召回约束,再选择 FP 最少的阈值。portrait 要求 recall≥0.88,document≥0.84,scenery≥0.92。
扫描 31 个阈值乘三类样本属于纯计算,可以下放 TaskPool。官方规范强调子线程不要直接或间接引入 UI 状态,也要根据性能数据控制并发度。这里把输入压成普通可序列化数组,输出也只是指标对象,避免在 @Concurrent 函数中访问 @State 或 UI 装饰器。
这段代码解决什么问题:在 TaskPool 中为每个类别扫描候选阈值,并在最低召回约束内选择 FP 最少的结果。
import { taskpool } from '@kit.ArkTS';

interface BucketPolicy {
  bucket: QueryBucket;
  minRecall: number;
}

@Concurrent
function calibrateBucket(
  rows: LabeledCandidate[],
  policy: BucketPolicy
): Metrics {
  let best: Metrics = evaluate(rows, 0.60);
  for (let step = 60; step <= 90; step += 1) {
    const current = evaluate(rows, step / 100);
    if (current.recall < policy.minRecall) continue;
    if (current.fp < best.fp ||
      (current.fp === best.fp && current.precision > best.precision)) {
      best = current;
    }
  }
  return best;
}

async function runCalibration(
  rows: LabeledCandidate[],
  policy: BucketPolicy
): Promise<Metrics> {
  const selected = rows.filter(row => row.bucket === policy.bucket);
  return await taskpool.execute(calibrateBucket, selected, policy) as Metrics;
}
这段代码没有从子线程修改页面状态,主线程只在 Promise 返回后写入报告。状态变化是 RAW_READY → CALIBRATING → REPORT_READY。如果任务失败,页面进入 FAILED 并保留原始样本,不把半份阈值表覆盖正式配置。
算法还留有明确边界:初始化时 best 只是占位,生产实现应区分“没有阈值满足最低召回”和“找到最优阈值”,否则一个不合格的 0.60 也可能被误写入配置。还要避免为很小的桶校准;样本过少时应回退全局阈值,并在报告中标注 insufficient_sample。
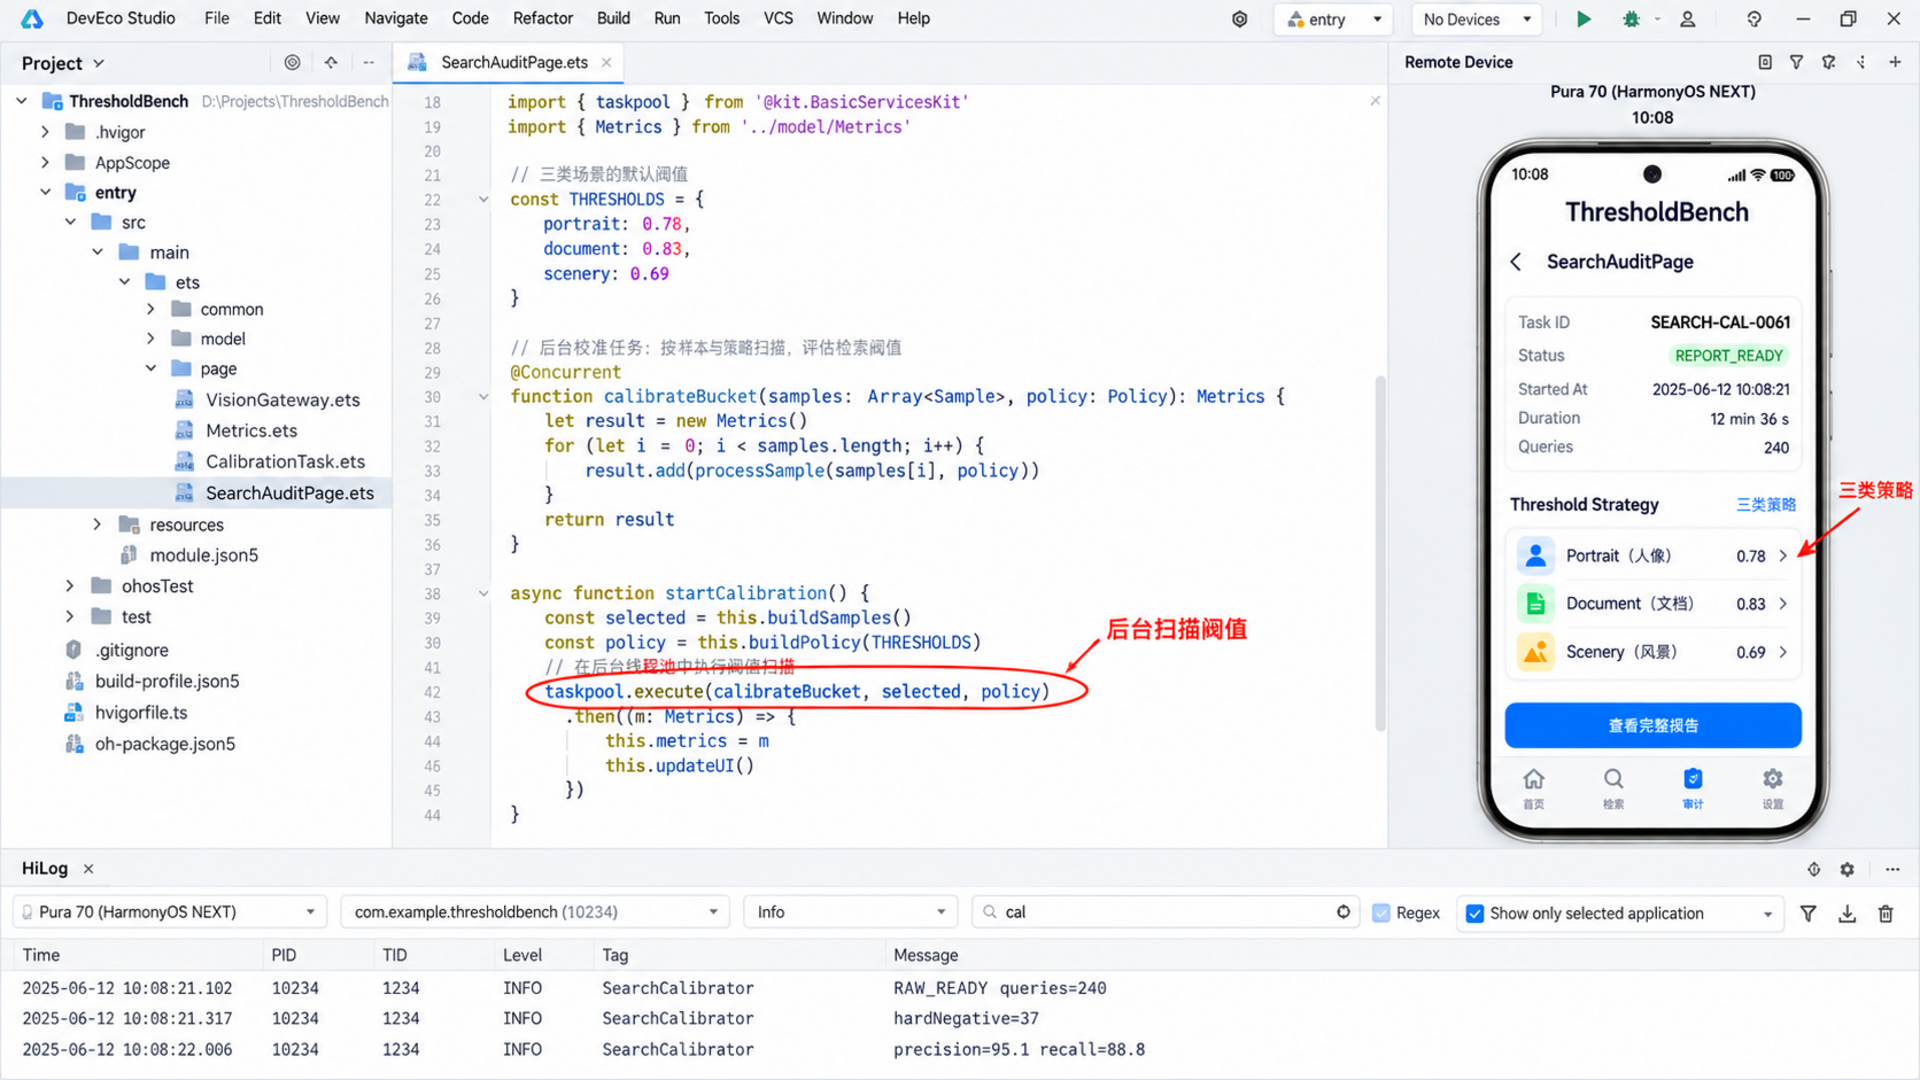
图中的白色 DevEco Studio 演示画面对应这套结构:左侧有 VisionGateway.ets、Metrics.ets、CalibrationTask.ets 和 SearchAuditPage.ets;中间代码显示 taskpool.execute(calibrateBucket...);右侧模拟器展示三类阈值;底部 HiLog 固定为 SEARCH-CAL-0061 RAW_READY 240、hardNegative=37、REPORT_READY precision=95.1 recall=88.8。该图用于说明,不是实际设备跑分截图。
五、硬负样本决定下一轮是否真的变好
阈值提高后,最有价值的不是“被挡住了多少图片”,而是“哪些错误图片仍然高分”。这类样本叫硬负样本:它们与查询在颜色、布局或局部对象上非常相似,却不符合业务语义。
演示中的典型查询是“报销发票”。正确发票分数 0.87;一张普通购物小票分数 0.79,在全局阈值 0.72 下会被展示,但低于 document 桶的 0.83。另一类硬负样本是“蓝色证件照”匹配到蓝色背景的非人像图片;还有“夜间桥梁”匹配到霓虹广告牌。这些错误不是随机噪声,应该带着 query、bucket、pathHash、similarity 和 reason 进入下一轮样本集。
这段代码解决什么问题:从已标注结果中提取高分错误项,并用匿名路径摘要形成可回流记录。
interface HardNegative {
  queryId: string;
  bucket: QueryBucket;
  pathHash: string;
  similarity: number;
  reason: string;
}

function collectHardNegatives(
  rows: LabeledCandidate[],
  thresholdByBucket: Record<QueryBucket, number>
): HardNegative[] {
  return rows
    .filter(row => !row.relevant &&
      row.similarity >= thresholdByBucket[row.bucket] - 0.05)
    .sort((a, b) => b.similarity - a.similarity)
    .slice(0, 37)
    .map(row => ({
      queryId: row.queryId,
      bucket: row.bucket,
      pathHash: stablePathHash(row.imagePath),
      similarity: row.similarity,
      reason: 'semantic_mismatch'
    }));
}
回流记录不保存完整沙箱路径,因为路径可能包含用户目录结构或素材命名。stablePathHash 是应用自有的稳定摘要函数,文中不指定算法,实际项目应使用团队已批准的哈希方案,并评估是否仍可关联个人数据。slice(0, 37) 对应本次演示的审核容量,不是官方限制。
硬负样本不应立即改变线上阈值。它们先进入下一批标注,再重新分割校准集与验证集。否则同一批错误样本既推动策略改变,又参与宣称策略变好,报告会产生数据泄漏。工程上应给配置文件写入 datasetVersion、policyVersion 和生成时间,但不要把设备标识或用户身份写进去。
六、运行页只展示策略结果,不暴露校准复杂度
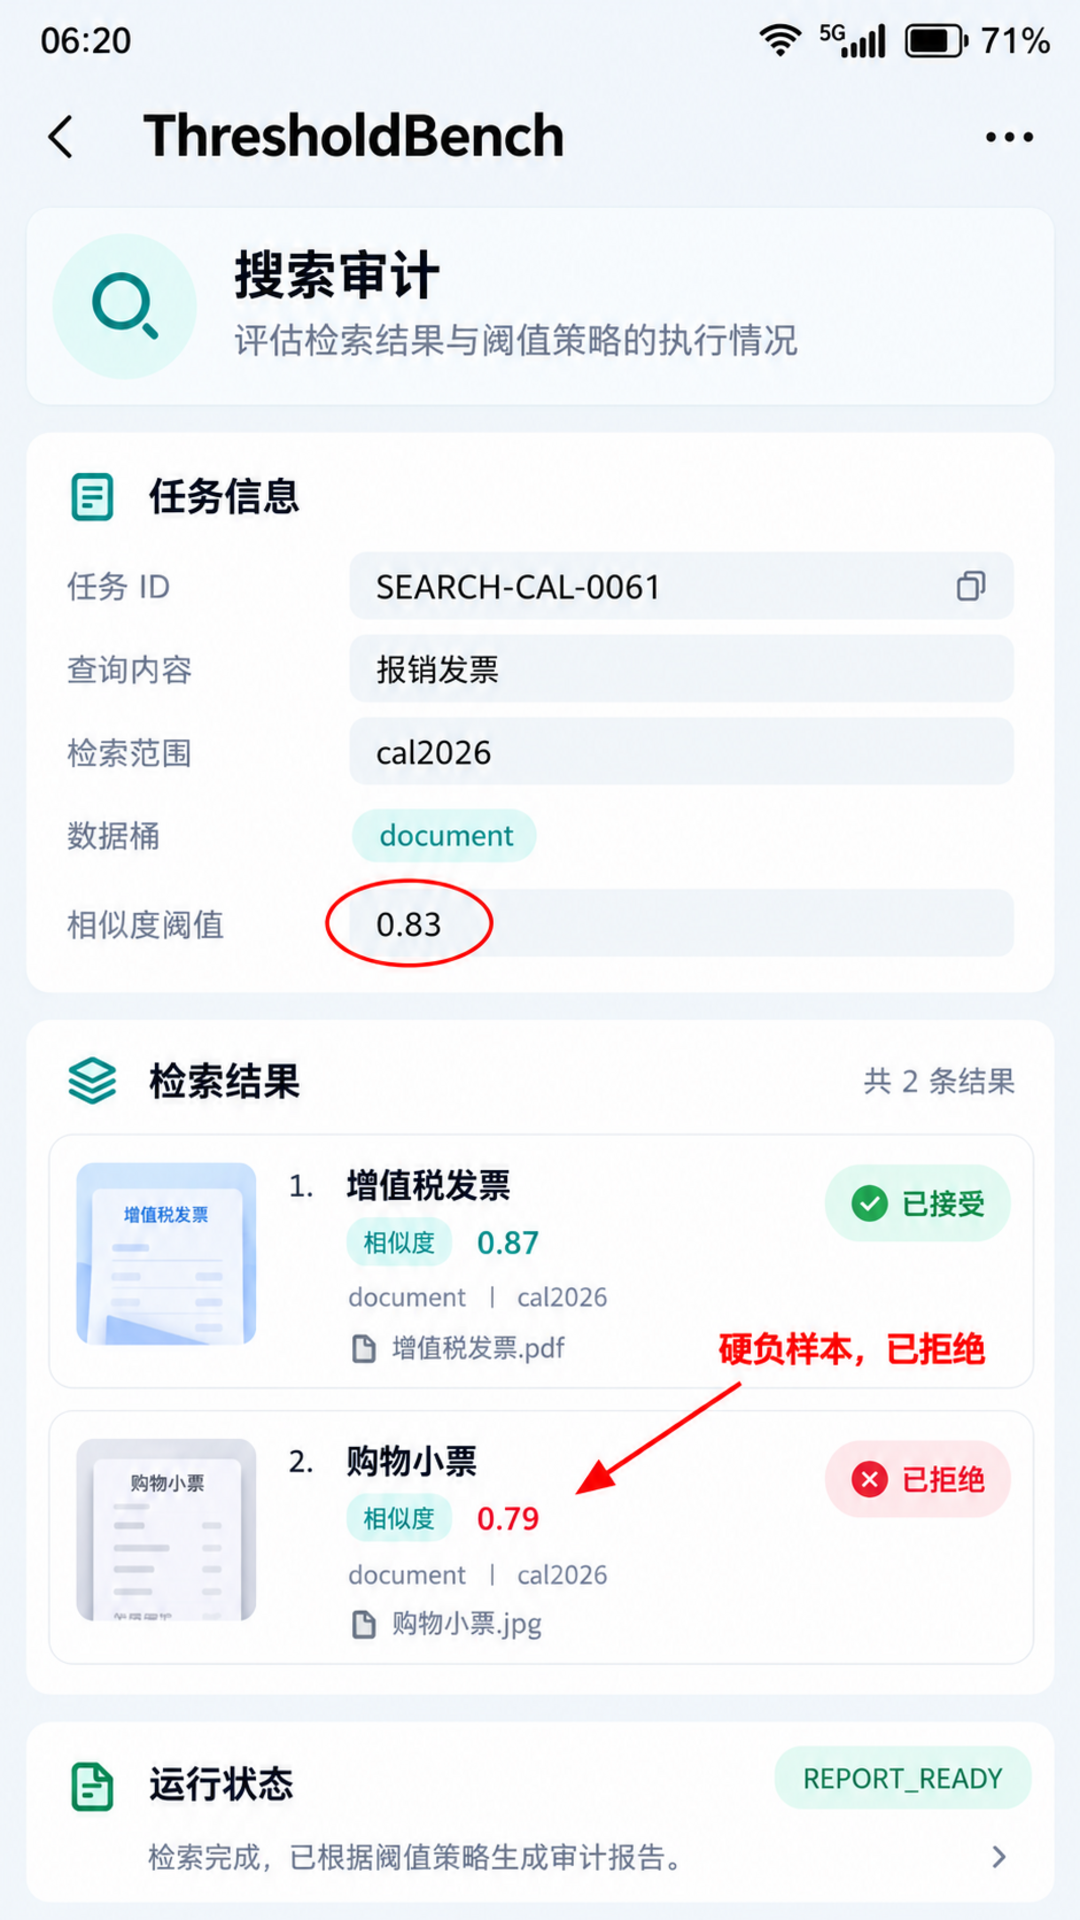
运行页时间为 06:20,状态栏显示 Wi‑Fi、5G、信号与 71% 电量。页面标题为 ThresholdBench,任务 ID SEARCH-CAL-0061,查询词“报销发票”,scope cal2026,当前类别 document,阈值 0.83。正确发票 0.87 被保留,购物小票 0.79 被标成“硬负样本,已拒绝”。
对普通用户来说,页面不需要解释 TP、FP 和 FN;只要结果稳定、错误项减少即可。开发模式可以显示阈值和类别,正式产品应避免把分数当作可信度承诺。相似度是排序信号,不是概率,也不代表 0.87 就有 87% 正确率。
交互还要处理边界输入。官方文档要求 query 长度 1~100,且不支持纯数字或纯字母。应用应在调用前校验并给出可理解提示;topKey 不应为了“尽量多”固定为 100,结果页只展示 20 条时,取 20 更有利于控制后续标注和渲染成本。
七、诊断页用同一组数字解释取舍
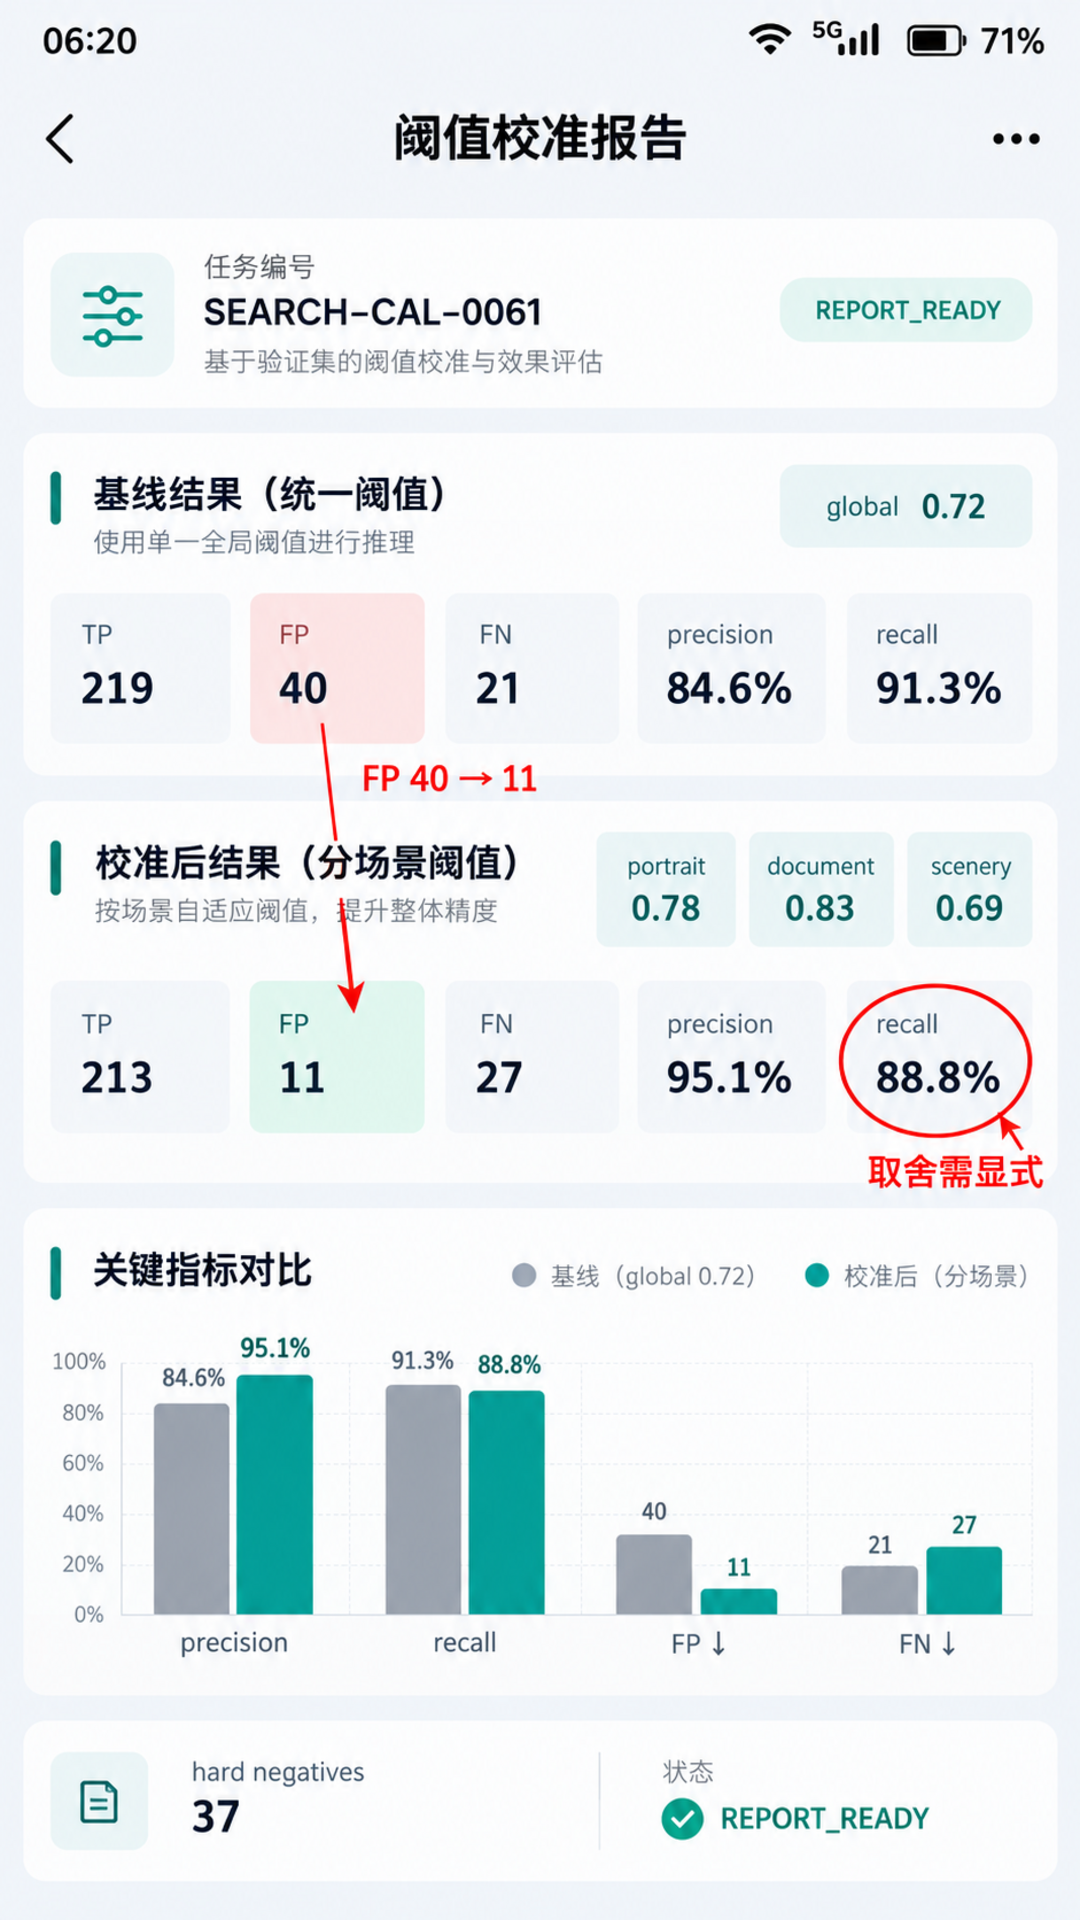
诊断页同样显示 06:20。左侧基线卡片为 global 0.72、TP 219、FP 40、FN 21、precision 84.6%、recall 91.3%;右侧校准结果为 portrait 0.78、document 0.83、scenery 0.69,TP 213、FP 11、FN 27、precision 95.1%、recall 88.8%。底部显示硬负样本 37 条,状态 REPORT_READY。
这些数字体现了明确取舍:FP 减少 29 条,精确率提高 10.5 个百分点,但 FN 增加 6 条,召回率下降 2.5 个百分点。不能只把绿色箭头放在精确率上而隐藏召回下降。对于文档类场景,这个取舍可能合理;对于“找回所有旅行照片”,用户可能更在意召回。最终策略应由业务风险决定,而不是由哪个指标更好看决定。
报告应保存分桶样本数,防止某个桶只有几条样本却产生两位小数的“精确结果”。还应记录系统版本、能力版本和索引构建版本;一旦能力更新触发 1013100003 并执行 clearData 重建索引,旧阈值不能自动被视为仍然有效,至少要重跑验证集。
八、把一次调参变成可持续门禁
最终发布门禁可以很克制:校准集生成候选阈值,验证集检查每个桶的最低 recall 与最高 FP;如果没有满足条件的阈值,构建不覆盖正式策略,只输出报告。策略文件只包含三类阈值、样本版本和摘要,不包含原始图片路径。
本例的验收状态是 REPORT_READY,不是“模型已优化”。平台能力没有被重新训练,变化发生在应用策略层。全局 0.72 被三类阈值替代,硬负样本形成下一轮输入,页面调用仍然是官方的 textSearchImage.search(query, scope, topKey)。这一区分能避免把应用层规则包装成模型能力,也能让问题定位更清楚。
资源释放同样不能遗漏。textSearchImage.init() 与 release() 应由同一个会话管理器成对负责;TaskPool 只承载纯计算,不在子线程触碰 UI,不注册长期监听。页面退出时如果校准任务仍在执行,应让结果带 generation,并在回到主线程时过滤过期报告,避免旧批次覆盖新策略。
最后保留三条边界。第一,阈值依赖内容分布,不能从一个 Demo 直接复制到另一个产品。第二,相似度不是概率,不能向用户展示成“正确率”。第三,硬负样本回流要遵守隐私与数据最小化原则,沙箱路径、EXIF 和用户查询都需要重新审视。只有把这些边界写进流程,阈值才从魔法数字变成可审计的工程决策。
九、样本治理决定报告能不能复现
阈值校准最容易被忽略的不是算法,而是样本身份。图片被替换、路径改变或标签被修正后,如果报告只保存一个 CSV 文件名,下一次重跑可能已经不是同一批数据。本例给数据集定义三层标识:datasetVersion=cal2026-r3 表示样本集合,labelRevision=7 表示标签修订,policyVersion=2 表示阈值选择规则。报告必须同时记录三者。
路径不能作为图片身份。沙箱路径会随导入、迁移或清理变化,也可能暴露用户目录。更稳妥的是在允许的本地处理边界内生成内容摘要,并只在评估存储中保存摘要、桶、标签和必要的分数。摘要相同但标签不同要进入冲突队列,不能用“最后一次写入”静默覆盖。冲突本身就是样本质量问题。
查询文本也需要分级。像“夜间桥梁”属于普通描述,可以直接进入演示集;包含姓名、证件号、地址或内部项目名的查询不应直接进入共享评估文件。可以将它归一为类别标签,或者由人工构造等价的非敏感表达。数据最小化不是校准完成后的清理动作,而应该发生在采集入口。
标签规则必须写得足够具体。对于“报销发票”,餐饮小票是否相关,取决于产品是寻找法定发票还是寻找所有报销凭证。没有定义时,两个标注者会给出不同答案,指标波动被误认为模型不稳定。本例把 document 桶的相关性定义为“包含完整发票要素、可作为目标归档对象”,普通购物小票因此标记为不相关。规则变更必须递增 labelRevision。
还要处理一条查询对应多个相关结果的情况。本文为了讲清公式,演示数据按每条查询一个预期命中统计;真实图库可能有连拍、裁剪副本和同一文档多页。此时应先定义查询级成功还是候选级成功,再选择指标。查询级指标适合回答“用户能否找到至少一张”,候选级指标适合回答“结果列表有多干净”。两个口径不能混在同一张图里。
十、门禁不应把波动伪装成确定性
240 条查询足以演示流程,却不足以让所有小数位都稳定。发布门禁除了比较点估计,还应关注样本量和波动。最简单的做法是设定绝对边界:document 桶验证集不少于 60 条,FP 不得超过 6,recall 不低于 0.84;样本不足时状态是 INSUFFICIENT_SAMPLE,不是 PASS。这样比仅比较“精确率不得低于 95%”更容易解释。
阈值变更也要限制幅度。如果某一轮从 0.72 跳到 0.88,即使验证集暂时通过,也可能说明样本分布或标签规则发生了结构性变化。门禁可以要求单次变化不超过 0.08,超出后转人工审核。这个限制不是为了阻止优化,而是提醒团队检查索引重建、能力升级和数据迁移是否同时发生。
对于能力升级,官方错误码 1013100003 已经给出明确边界:能力更新后需要调用 clearData,完成后再使用搜索。工程上应把这次重建视为新的索引世代。旧索引的阈值报告保留用于对比,但不能直接盖章新索引。重建完成后先跑一小组 smoke 样本,确认 init、insert、search、release 链路,再运行完整校准。
TaskPool 的失败也要进入报告。子线程抛错、输入无法序列化、页面退出导致 generation 过期,分别记为 TASK_FAILED、INPUT_INVALID 和 STALE_DROPPED。只有三个桶都返回有效指标,报告才进入 REPORT_READY。如果一个桶失败,不能用另外两个桶的结果生成“部分成功”配置,因为运行时会出现不可解释的回退组合。
上线后可以采集匿名的“用户主动移除结果”或“继续翻页”信号,但不能把行为直接当真值。用户移除可能是隐私偏好,不一定代表语义错误;继续翻页可能是想找特定构图,不一定说明召回不足。这些信号适合用于发现候选样本,再由明确规则审核,不能直接自动调阈值。
最终的发布产物应很小:三类阈值、版本字段、生成摘要与回退策略。原始分数、标签和硬负样本留在受控评估目录,不随应用包发布。运行时读取策略失败时回退到经过验证的上一版本,而不是回到源码里的随意常量。这样一次校准才真正形成工程闭环:数据可追溯、计算可复现、变更可审核、失败可回退。
回到演示里的“报销发票”,0.79 的购物小票被 0.83 阈值挡住只是表面结果。更重要的是团队知道它为什么被挡住、这条规则来自哪一版样本、对召回造成了什么代价,以及能力更新后何时必须重跑。阈值表因此不是藏在页面里的三个数字,而是一份带数据版本和失败条件的业务契约。
如果现阶段没有足够标注资源,可以先从几十条高频查询和线上明确误判开始,但报告必须标记样本不足,不能把小样本结果包装成稳定指标。随着硬负样本积累,再逐步扩大验证集。校准流程的价值不在于一次找到“永久正确”的阈值,而在于每次内容分布变化时,团队都有同一把尺子重新做决定。
官方资料(核对日期:2026-10-01):

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献92条内容

所有评论(0)