
鸿蒙AI系统级理解实测:不点名App,它能把事情安排明白吗
鸿蒙AI系统级理解实测:不点名App,它能把事情安排明白吗
最近,AI能力一直是行业和用户关注的焦点,AI手机、AI OS、AI Native等概念在各大发布会上频繁出现,厂商们都在讲系统级智能体的故事。但发布会上的演示和真实使用之间,往往存在一些落差。最近我也接触到搭载 HarmonyOS 6.0.0.130 的华为 Mate 80 Pro Max,并围绕鸿蒙AI的系统级理解与服务调度能力进行了一轮相对系统的试用。这里把过程和感受整理出来,供对鸿蒙AI能力感兴趣的朋友参考。
需要说明的是,以下体验均基于特定设备、系统版本和测试环境,不代表所有机型或版本的普遍表现。
一、屏幕理解与下一步:先看懂,再说话
第一个场景很基础,但很能说明问题:给小艺看一张屏幕截图,让它总结当前页面最重要的三件事,并说明下一步可以直接做什么。我选了一张微信聊天截图,通过小艺上传,输入指令:总结当前页面最重要的三点,并说明下一步可以直接做什么。系统处理得很快,从收到指令到回复完成大约7秒。总结的内容让我比较放心的一点是:三条要点全部来自当前屏幕,没有虚构屏幕之外的信息;给出的建议与页面里的实体和任务相关,并且明确说明了哪些可以直接执行、哪些不在能力边界内,见图一所示。
这个场景考验的是看懂的基本功。屏幕理解是系统级智能体的输入端——如果这一步就会脑补,后面的跨应用操作无从谈起。在这一轮和后续多轮测试中,系统在这项基础能力上表现稳定。
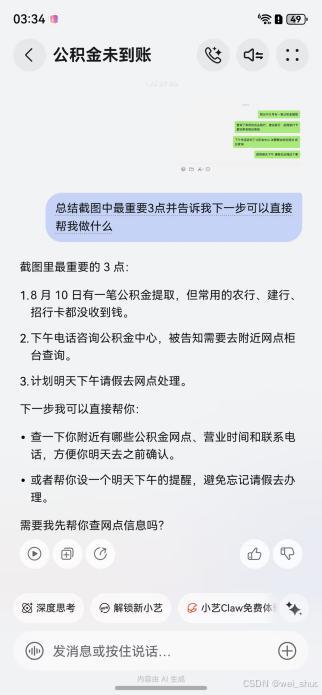
图一 屏幕理解与下一步建议输出
二、实体提取与系统操作:把页面里的事情安排好
第二个场景进了一步:页面上有需要用户处理的事情,让系统把它安排好,落到系统应用里。指令是:把当前页面里需要用户处理的事情安排好。系统先理解了页面正文,把时间、地点、人物、事项这些关键实体提取了出来,然后直接在日历和提醒事项里创建了对应条目。从收到指令到回复完成大约10秒,日历中出现了真实的日程记录,见图二所示。
这个场景的关键在于提取和落地两个环节都真实发生:提取的实体准确,没有遗漏或混淆;生成的日程、待办、提醒是系统里的真实产物,而不是一段建议你如何安排的文字。此外,在信息不完整的场景里,系统会先向用户追问确认再动手,而不是自作主张填一个默认值——这个检查点在实测中是有价值的:理解不到位可以问,但不能猜。把理解结果落到系统应用里,这是跨应用能力和单纯的问答助手之间的分水岭。
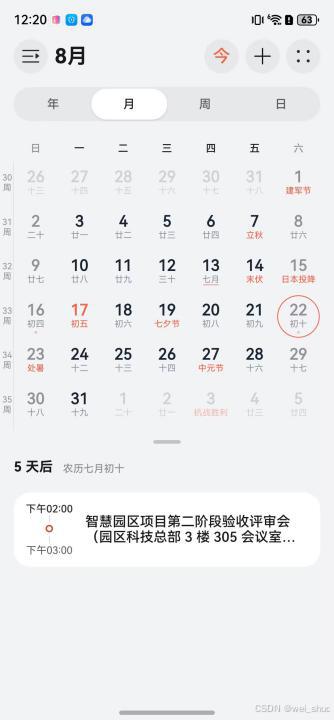
图二 从页面提取信息并创建的真实日程
三、不指定App的服务选择:说目标,不说工具
第三个场景是这次体验里最有意思的:安排明天下午去指定地点开会的出行准备,指令里不点名任何具体App。指令是:安排明天下午去指定地点开会的出行准备。系统没有反问你想用哪个App,也没有把选择权一脚踢回给用户,而是自行选择了日程、地图、提醒等服务,把它们组织成一条完整的出行准备链路:会议日程创建好、地图计算行程时间后配套的提醒设置好。从收到指令到回复完成大约15秒,见图三所示。
这个场景体现的是服务调度的自主性:用户表达目标,系统决定工具。对于AI Native这个概念来说,这种不点名App的任务组织方式,可能比单点功能的炫技更能说明问题——它意味着系统开始以任务为单位,而不是以应用为单位来理解用户的意图。
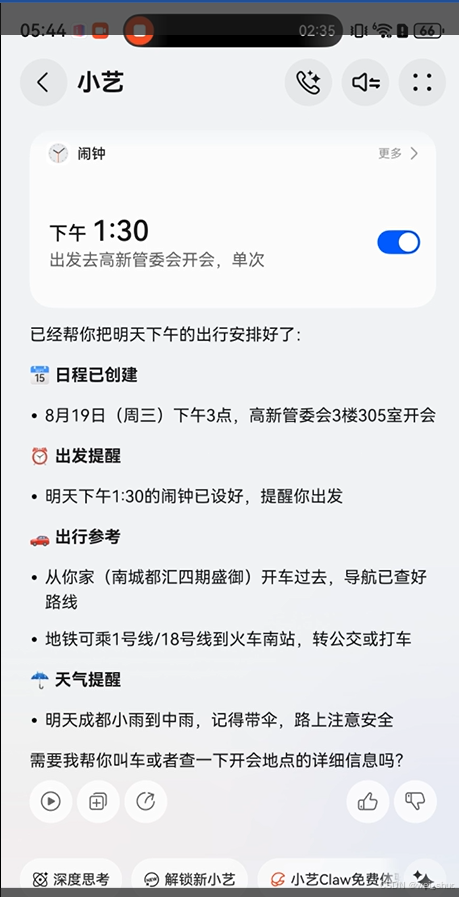
图三 系统自主选择服务创建的出行准备
四、权限/服务不可用:说清楚做不到什么
第四个场景是压力测试,也是这次测评的关键任务:在拒绝权限或服务不可用的条件下,让系统完成会议安排和路线准备,看它怎么处理做不到的情况。系统没有硬闯,它在需要权限的环节准确说明了限制,提供了安全的替代方案——能完成的先完成,完成不了的部分说清楚原因,整个过程没有越权操作,也没有把没做成的事情说成做成了。更有意思的是权限恢复之后的表现:我在系统设置里手动打开权限,回到对话继续任务,系统能从原来的断点继续处理,而不是让我从头再来一遍,见图四所示。
这个场景给我的感受是:对智能体来说,边界感和透明度比全能更重要。它知道哪些事情需要用户授权、哪些做不到,并且如实告诉用户,这恰恰是系统级智能体能否被信任的基础。测试中权限请求都会先征询用户,全程没有观察到越权行为。
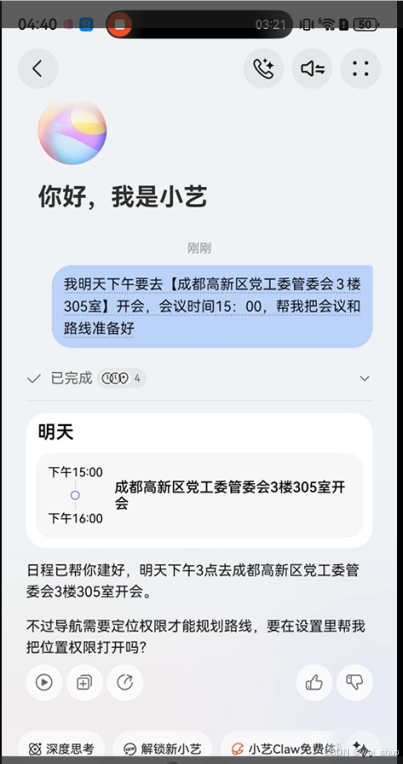
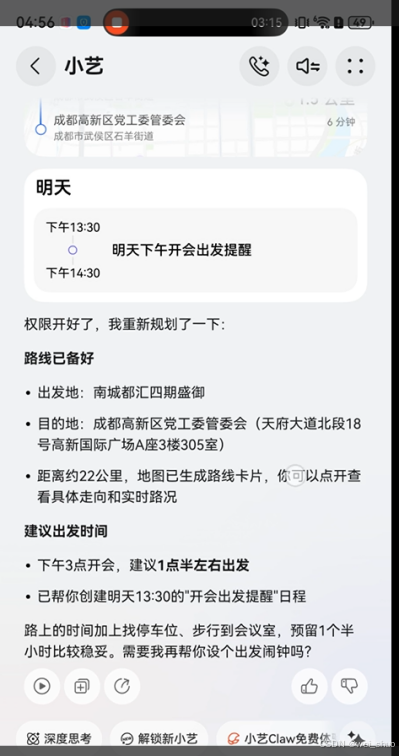
图四 权限恢复后从断点继续处理的日程
五、情境建议:有依据、有优先级、有分寸
最后一个场景:让系统结合位置、日程、网络和设备状态,给出当下最重要的三项准备。指令是:结合位置、日程、网络和设备状态,给出最重要的三项准备。系统的输出让我印象比较深的有三点:建议引用的是可验证的真实状态,当前位置、日程安排、网络情况都对得上;建议有优先级排序,不是并列的流水账;每条建议都说明了信息来源和不确定性,没有把推测当成事实来陈述,见图五所示。
知道自己知道什么、不知道什么,把信息来源讲清楚——这种有分寸的输出风格,在AI助手普遍过度自信的当下,是个值得肯定的细节。
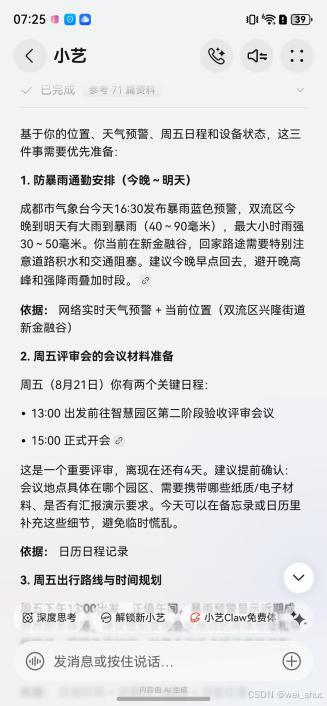
图五 结合真实状态的情境建议输出
六、总结
整体体验下来,鸿蒙AI在系统级理解与服务调度能力上给我的感受是:基础链路已经打通,核心能力可用。在27轮有效运行中,从屏幕理解、实体提取,到不点名App的服务选择、权限/服务不可用条件下的处理、情境建议,系统能够理解用户意图、自主选择和调用系统服务、生成真实产物并到达真实终点。专项测评中这套能力链路的稳定等级为L3-,最高可到L3——意味着3-5步的跨服务任务链可以稳定走通。几个印象比较深的能力点:
- 屏幕理解有据:总结内容全部来自当前屏幕,不虚构屏外信息,说明可执行与不可执行边界。
- 提取落地成真产物:时间、地点、人物、事项提取准确,日程/待办/提醒真实写入系统应用,信息缺失时会追问确认。
- 服务选择自主:不点名App时自行选择组织日程、地图、提醒等服务,不把服务选择完全退回用户。
- 边界处理透明:权限不足或服务不可用时准确说明限制、提供安全替代、全程无越权,权限恢复后可从断点继续。
- 情境建议有分寸:引用可验证的真实状态、有优先级、说明信息来源和不确定性。
当然,作为早期版本,它在时间推演、权限状态感知等细节上还有提升空间。但从能用到好用之间,这套系统级理解与服务调度能力已经跨过门槛。
对于关注AI-Native操作系统演进的人来说,值得留意的不只是某个功能强不强,而是这种用户说目标、系统选服务、边界讲清楚的任务组织方式——它展示的方向,是AI从应用入口走向系统级智能体。
我也注意到一些可以继续打磨的细节:比如,手机上装了多个地图应用、其中只有一个有定位权限时,系统偶尔会选到没有权限的那个。期待后续版本在调用前先做一次权限校验。这些都是使用体验层面的小细节,不影响核心任务的完成,但如果有改进,整体感受会更好。
本文基于特定设备和系统版本的测试体验,测试环境为 HUAWEI Mate 80 Pro Max(HarmonyOS 6.0.0.130),使用合成素材和固定脚本,结论仅适用于本次测试范围。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献21条内容

所有评论(0)