
HarmonyOS 7 文搜图实战 05:工程收口与体验打磨,把 SnapSeek 整理成可复用 Demo【鸿蒙心迹】
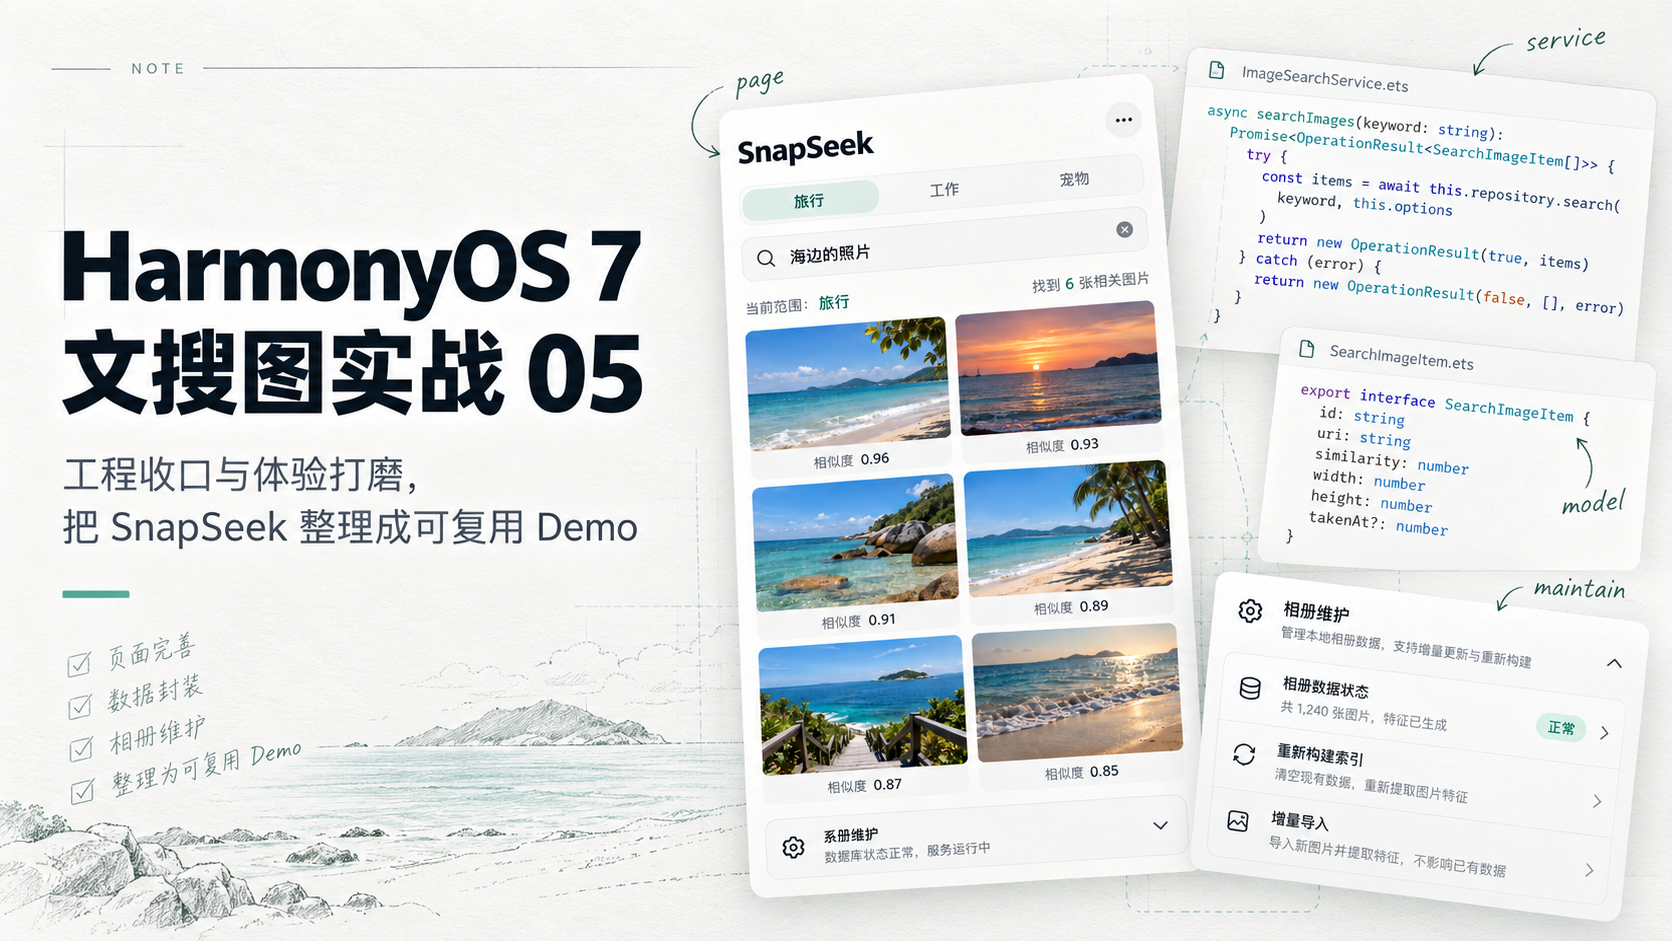
前四篇里,我把 SnapSeek 一步一步搭了起来:第一篇先把文搜图链路跑通,第二篇加上 Scope,让图库开始有边界,第三篇围绕 similarity 和 Query 去理解结果排序,第四篇再补上新增、删除、重建和 release,把维护链路补齐。到了第五篇,我不准备再追一个单独的小功能点了,而是做最后一次工程收口:把页面状态、Service、Model、日志、维护动作和最终体验重新整理一遍,让 SnapSeek 不只是“写了五篇”的 Demo,而是一套真正能拿来学习、演示、继续扩展的完整样例。
写连载最怕的一件事,不是写不出内容,而是一路往前加功能,最后整套东西虽然越来越多,却越来越散。
这一点在技术 Demo 里尤其明显。
第一篇时,页面很简单,逻辑也不复杂;
第二篇加了 Scope,状态开始变多;
第三篇开始研究 similarity,日志又多了一层;
第四篇把新增、删除、重建、release 都接进来以后,功能上当然更完整了,但同时也产生了另一个非常现实的问题:
如果现在停下来回头看,这套 Demo 还有没有“整体感”?
所谓整体感,不只是“能运行”,而是:
- 页面职责是不是清楚;
- 状态是不是已经开始乱了;
- Service 有没有开始做太多事情;
- Model 是否足够支撑前面的演进;
- 日志是不是有价值,还是已经变成噪音;
- 维护动作和搜索动作有没有边界;
- 最终读者拿到这套 Demo 时,能不能顺着它把文搜图的学习过程真的走一遍。
第五篇我最想做的,就是把这些东西一起重新整理。
因为我不希望 SnapSeek 最终只是“看过五篇就过去了”,而是希望它真能像一个小型样板工程一样,后面继续被用来演示、教学、测试或者做下一轮扩展。
所以第五篇的关键词,不再是“新能力”,也不再是“新增一个功能点”,而是:
收口。
一、第五篇真正要解决的问题,不是再加一个功能,而是让前四篇的东西重新变得清楚
做到第四篇以后,SnapSeek 从能力上说已经够用了。
它有:
- 初始化与搜索;
- Scope 分类;
- Query 与 similarity 观察;
- 图片新增与删除;
- 索引重建;
- release 生命周期。
如果从“功能列表”角度看,第五篇完全可以不写。
因为再往下加,很容易只是为了继续写而继续加。
但我觉得真正有价值的系列,写到最后不应该继续横向堆能力,而应该做一次纵向收束。
也就是说,问自己两个问题:
- 这些功能之间的职责边界清楚了吗?
- 如果别人拿到这个 Demo,能不能比较顺地看懂?
这两个问题一问,很多需要收口的点就会自己跳出来。
比如页面层现在已经管了不少事情:
- 当前 Scope;
- 当前 Query;
- 搜索结果;
- 状态文案;
- 维护动作触发;
- 局部日志观察。
如果继续把这些都揉在一个页面里,Demo 当然也能跑,但从第五篇开始,它就很难再被称为“清楚的学习样例”。
所以第五篇的第一件事,不是再加功能,而是重新看待前四篇沉淀下来的结构:
哪些该留在页面,哪些该收回 Service,哪些该下沉到 Model,哪些该成为一套更清晰的状态表达。
这就是第五篇和前面几篇最大的不同。
前几篇是在“往前推”,第五篇是在“回头整理”。
二、页面层先瘦身:页面不该继续同时承担“能力说明书”和“状态仓库”
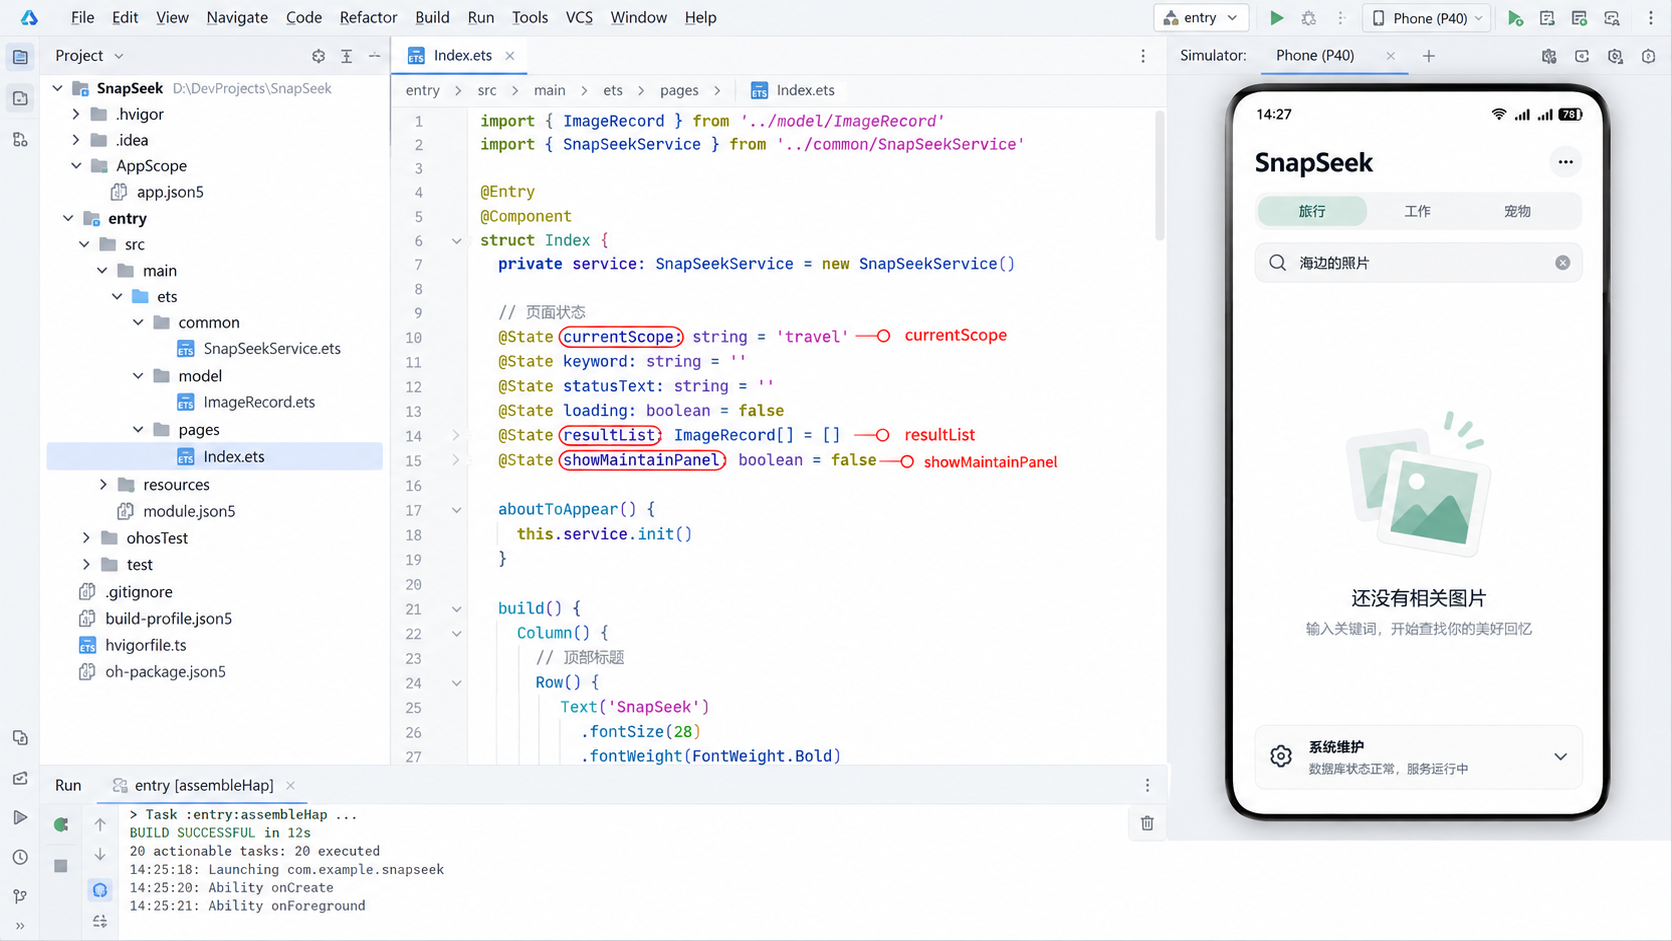
我回头看前四篇的 Index.ets,最明显的感受就是:它已经开始承担太多事情了。
这很正常。因为写连载的时候,为了让每一篇都能讲清楚某个点,页面层经常会暂时承担一些本来不该长期留在这里的职责。比如:
- 直接维护很多状态字段;
- 写一段临时测试逻辑;
- 把状态文案先拼在页面里;
- 为了演示方便,直接在页面里组织一些维护动作。
这些做法在前几篇都是合理的。
但到了第五篇,如果还保持这种状态,整套 Demo 就会越来越像“把实验步骤都留在桌面上”,而不是一个真正清晰的项目结构。
所以我做的第一件事,就是给页面瘦身。
页面保留的职责尽量收成三类:
-
显示当前状态
- Scope
- Query
- 搜索结果
- 状态文案
-
响应用户动作
- 点击搜索
- 切换 Scope
- 进入维护区操作
-
把动作交给更下层的能力或 ViewModel 式逻辑处理
为了让这个方向更明显,我把页面状态先收成一组更清楚的字段。
文件位置: entry/src/main/ets/pages/Index.ets
用途: 页面层只保留对外展示和交互必要的状态。
@State currentScope: SnapScope = 'travel'
@State keyword: string = ''
@State statusText: string = '请选择图库并输入描述'
@State loading: boolean = false
@State initialized: boolean = false
@State imported: boolean = false
@State resultList: SearchImageItem[] = []
@State showMaintainPanel: boolean = false
你会发现,这组字段和前面几篇差别不算特别大,但第五篇的重点不在“有没有这些字段”,而在于:
页面不再继续新增更多“为了讲解方便临时塞进来”的状态。
比如一些维护统计、重建过程中的细节记录、测试日志触发结果,我都不再继续堆进页面,而是开始往 Service 或更清楚的模型里收。
这一步做完以后,最大的变化其实不是代码量减少多少,而是页面终于开始重新像“页面”了。
三、Service 也要收口:它负责能力编排,不负责把所有业务都吞进去
很多 Demo 到最后会出现另一种极端:
页面太胖了,于是大家就把所有逻辑一股脑扔进 Service。
结果页面变干净了,Service 反而变成了一个新的大杂烩。
SnapSeek 如果第五篇不收这一层,也会往这个方向滑。
因为前四篇之后,Service 已经做了不少事情:
- 初始化能力;
- 插入图片;
- 搜索;
- 删除图片;
- 重建索引;
- release。
这些动作单独看都合理,但如果不重新定义边界,Service 很快就会开始同时承担:
- 数据管理;
- 状态记录;
- UI 文案判断;
- 调试逻辑组织;
- 能力调用。
所以第五篇里,我给 Service 的定位重新卡得更清楚一点:
Service 负责调用和编排文搜图能力,但不负责吞掉全部页面语义。
我会让它重点承担下面这几类事情:
-
能力生命周期
- init
- release
-
与检索数据直接相关的动作
- insertImage / addImage
- deleteImage
- search
- rebuildIndex
-
返回清晰的结果,不直接决定页面怎么说话
比如搜索结果我会让它返回统一结构,而不是在 Service 里直接拼状态文案。
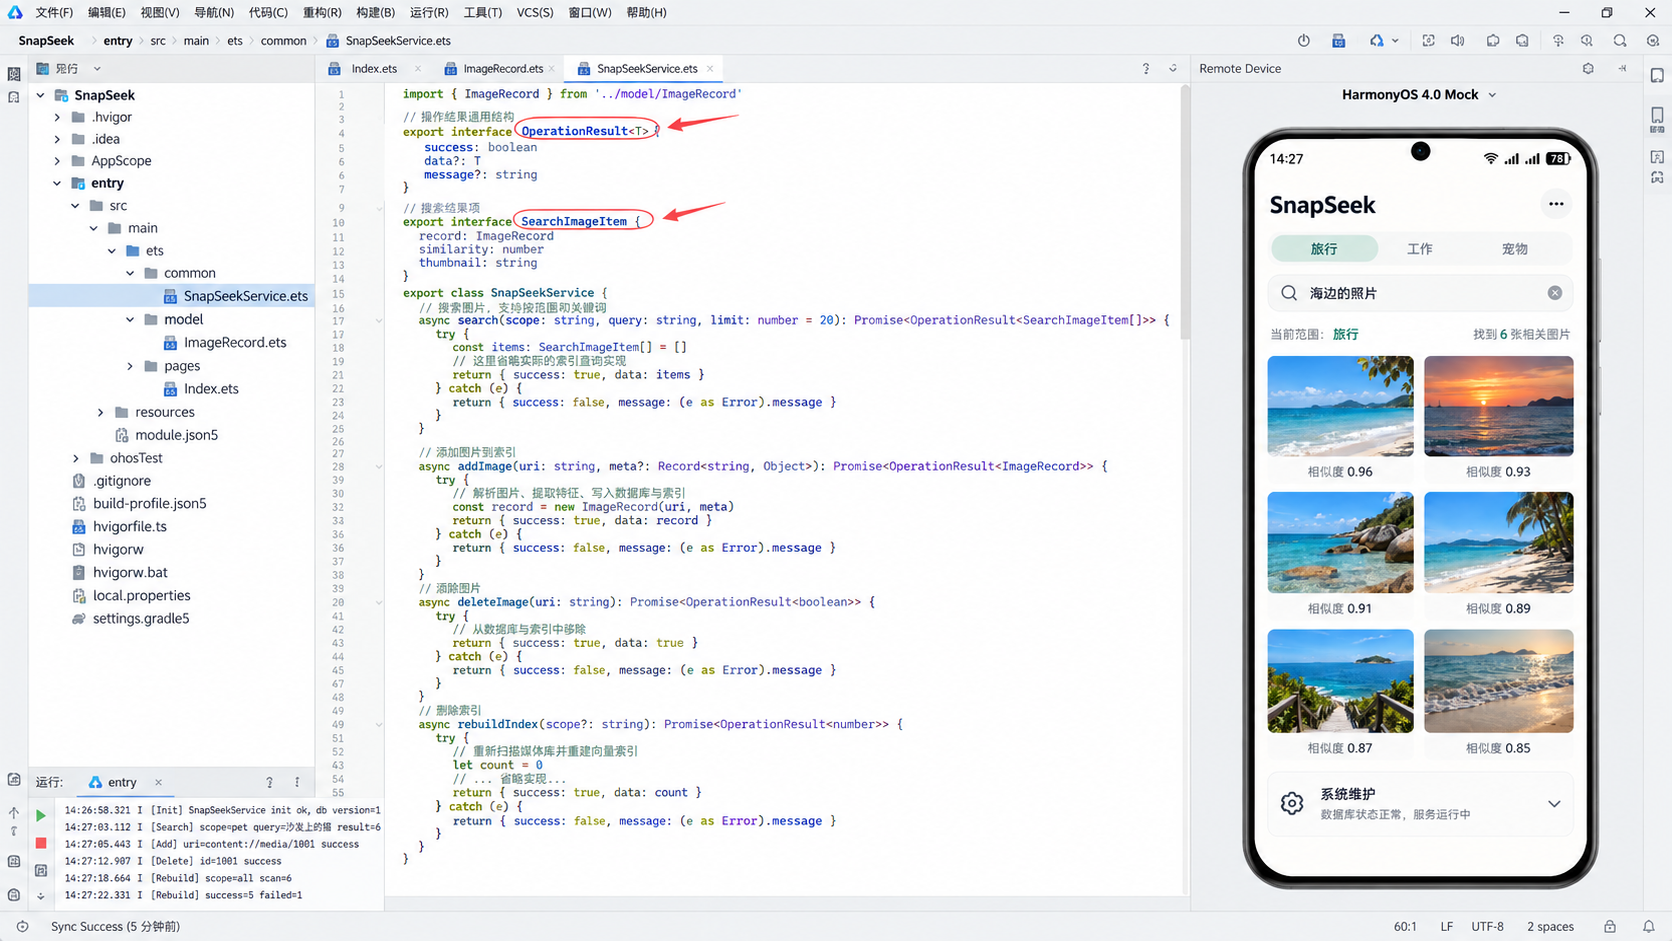
文件位置: entry/src/main/ets/common/SnapSeekService.ets
用途: 收口文搜图能力调用和结果返回。
export interface SearchImageItem {
  path: string
  similarity: number
  scope: SnapScope
}

export interface OperationResult {
  success: boolean
  message: string
}

class SnapSeekService {
  async search(
    query: string,
    scope: SnapScope,
    topK: number = 8
  ): Promise<SearchImageItem[]> {
    // const result = await textSearchImage.search(query, scope, topK)
    return []
  }

  async addImage(record: ImageRecord): Promise<OperationResult> {
    // 能力调用
    return {
      success: true,
      message: `已加入 ${record.scope} 图库`
    }
  }

  async deleteImage(record: ImageRecord): Promise<OperationResult> {
    // 能力调用
    return {
      success: true,
      message: '删除成功'
    }
  }

  async rebuildIndex(records: ImageRecord[]): Promise<OperationResult> {
    // clearData + rebuild
    return {
      success: true,
      message: '重建完成'
    }
  }
}
这里最重要的变化,不是“我多定义了一个 OperationResult”,而是 Service 的角色被重新说清楚了。
它负责把事情做完,
但页面怎么展示、状态怎么表达、提示文案怎么组织,不再全都塞给它。
这一点很关键。
因为第五篇讲的是工程收口,而工程收口最怕的就是“看起来分层了,其实只是把混乱从 A 挪到了 B”。
四、数据模型不能只服务当前功能,它还得服务“以后怎么看懂这个 Demo”
前面几篇里,Model 的演进已经做了不少事情:
- 第二篇加了 Scope;
- 第四篇加了 imported。
如果只是为了把功能跑通,这其实已经够用了。
但第五篇重新看一遍,我觉得 Model 还有一个常被忽略的角色:
它也是读者理解这套 Demo 的入口。
很多时候,一个项目能不能让人快速读懂,不是看首页多漂亮,而是看模型是否清楚。
因为模型一旦清楚,页面、Service、日志、维护动作之间的关系都会跟着清楚。
所以第五篇里,我会保留并强化两层模型:
1)图片记录模型
export interface ImageRecord {
  id: string
  path: string
  scope: SnapScope
  imported: boolean
}
这层是“图库事实”。
2)搜索结果模型
export interface SearchImageItem {
  path: string
  similarity: number
  scope: SnapScope
}
这层是“搜索视图”。
这样一来,读者很容易看懂两件事:
ImageRecord是你自己维护的图片清单;SearchImageItem是一次搜索得到的结果表现。
这两层长得有点像,但语义不一样。
前者偏持久化、偏维护;后者偏展示、偏排序。
第五篇我特别想把这层区别讲清楚。
因为前四篇一路走下来,SnapSeek 已经不是一个“简单页面”了,而是一个开始具备内部结构的小项目。
这种时候,如果模型还含糊,后面所有分层都会显得站不稳。
五、日志也要收口:不是删掉,而是从“全都打”变成“关键节点打”
第三篇和第四篇里,我其实写了不少日志。
那是有意为之,因为当时我们的目标就是研究结果、排查问题、观察重建过程。
但第五篇如果还继续无差别地把所有日志都保留着,项目会开始显得很吵。
这里我特别想强调一件事:
日志收口,不等于把日志删光。
真正合理的做法是:
从“每一步都想打”收成“关键节点打”。
我最后给自己整理了一版比较清楚的日志层级。
页面层保留的日志
- 用户发起了什么动作;
- 当前 Scope / Query 是什么;
- 是否进入了维护模式。
Service 层保留的日志
- init 成功或失败;
- search 参数与结果数量;
- add / delete 成功或失败;
- rebuild 成功数和失败数;
- release 结果。
不再强调的日志
- 过细的中间拼装细节;
- 每一次 UI 小更新;
- 没有帮助判断的重复打印。
最后收口下来,我希望日志至少能形成下面这种风格:
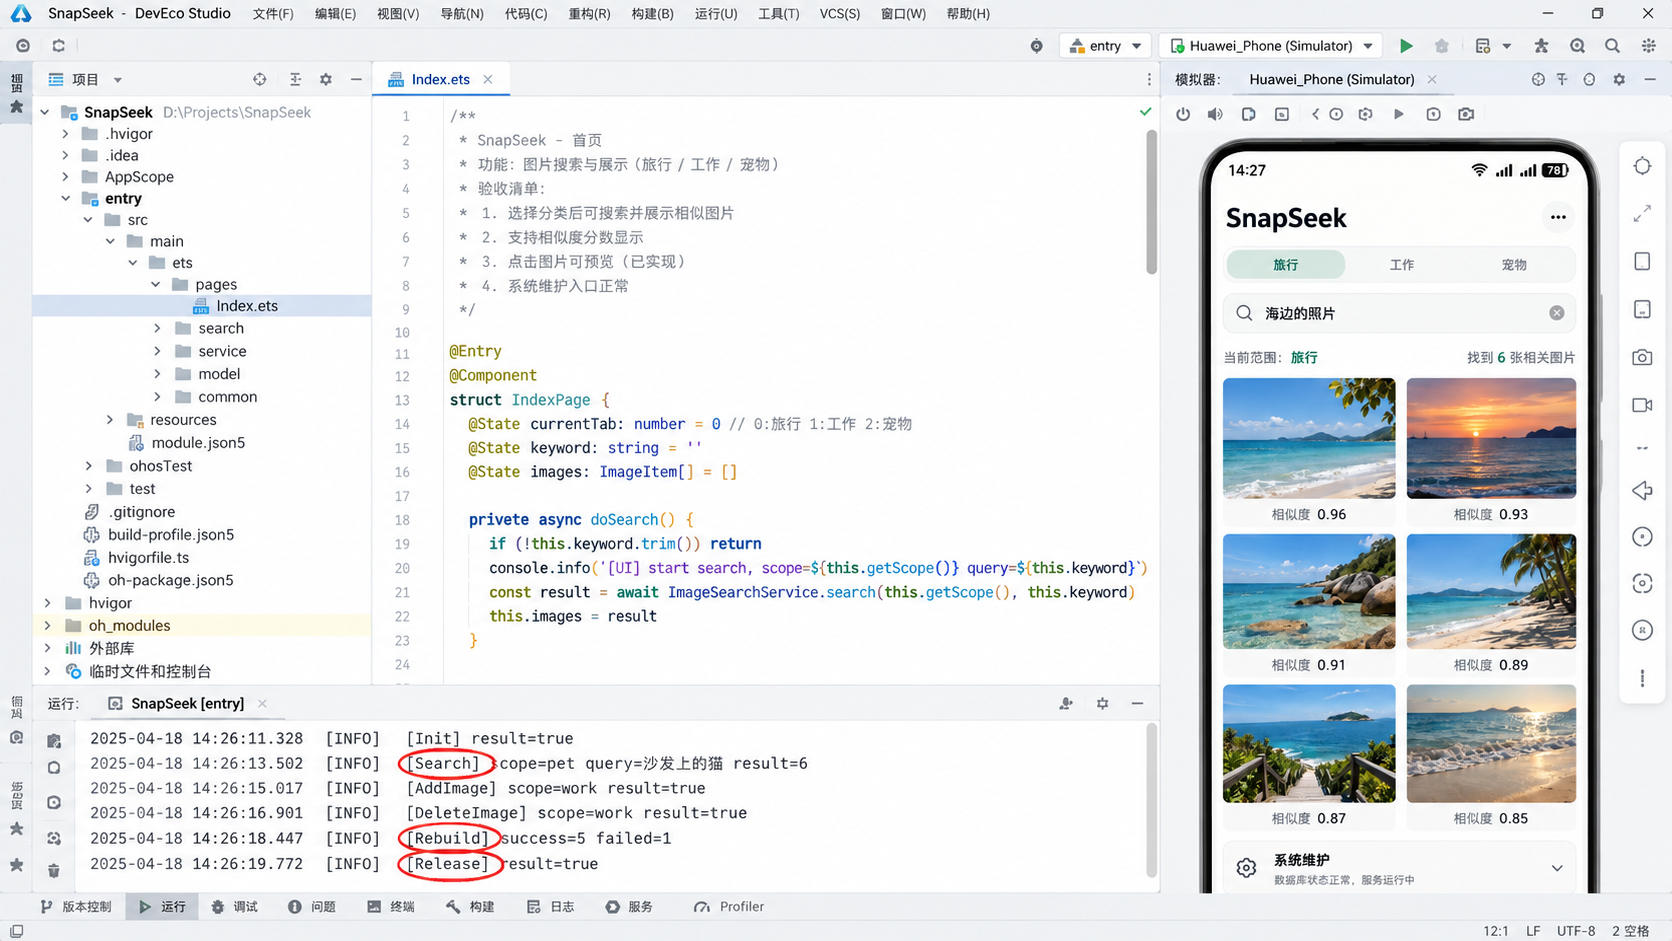
[Init] result=true
[Search] scope=pet query=沙发上的猫 result=6
[AddImage] scope=work result=true
[DeleteImage] scope=work result=true
[Rebuild] success=5 failed=1
[Release] result=true
这套日志看起来比第三篇、第四篇“安静”了不少,但我觉得反而更像一个最终交付的 Demo。
因为它留下了最关键的观察入口,却不会让人一打开控制台就被大量重复信息淹没。
而且从教学角度讲,这种节制感也很重要。
读者不是来背日志的,而是来理解:
- 哪些动作是主线;
- 哪些节点最值得观察;
- 出问题时应该先看哪几条记录。
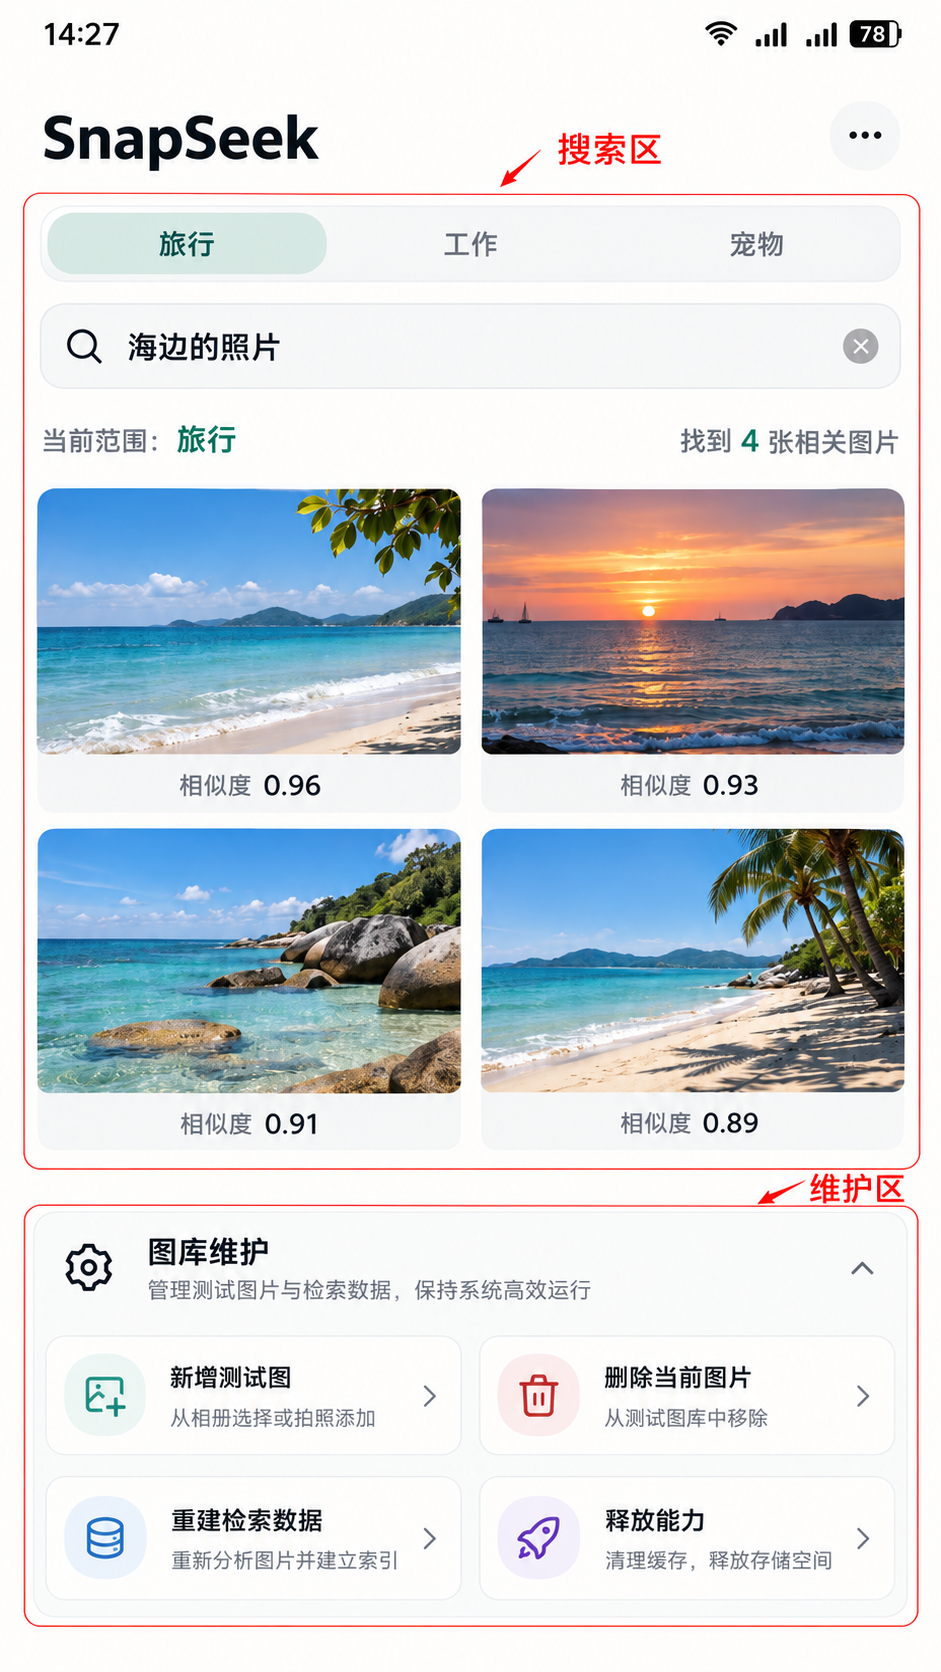
六、维护动作和搜索动作要彻底分区,这一步会直接决定“像不像完整产品”
第四篇我已经提过“维护区”这个想法,第五篇则要把它真正落稳。
原因很简单。
SnapSeek 到这个阶段,已经同时有两类动作:
第一类:主搜索动作
- 切换 Scope
- 输入 Query
- 执行搜索
- 查看结果
第二类:维护动作
- 新增测试图
- 删除当前图片
- 重建检索数据
- 释放能力
如果这两类动作继续混在一个平铺的大页面里,界面会开始很像一个“开发控制台”,而不是一个完整但克制的 Demo。
所以第五篇我会明确做一件事:
主搜索区负责日常使用,维护区负责工程操作。
这不只是 UI 整理,也是在把前四篇的学习路线收成一个更清晰的最终界面。
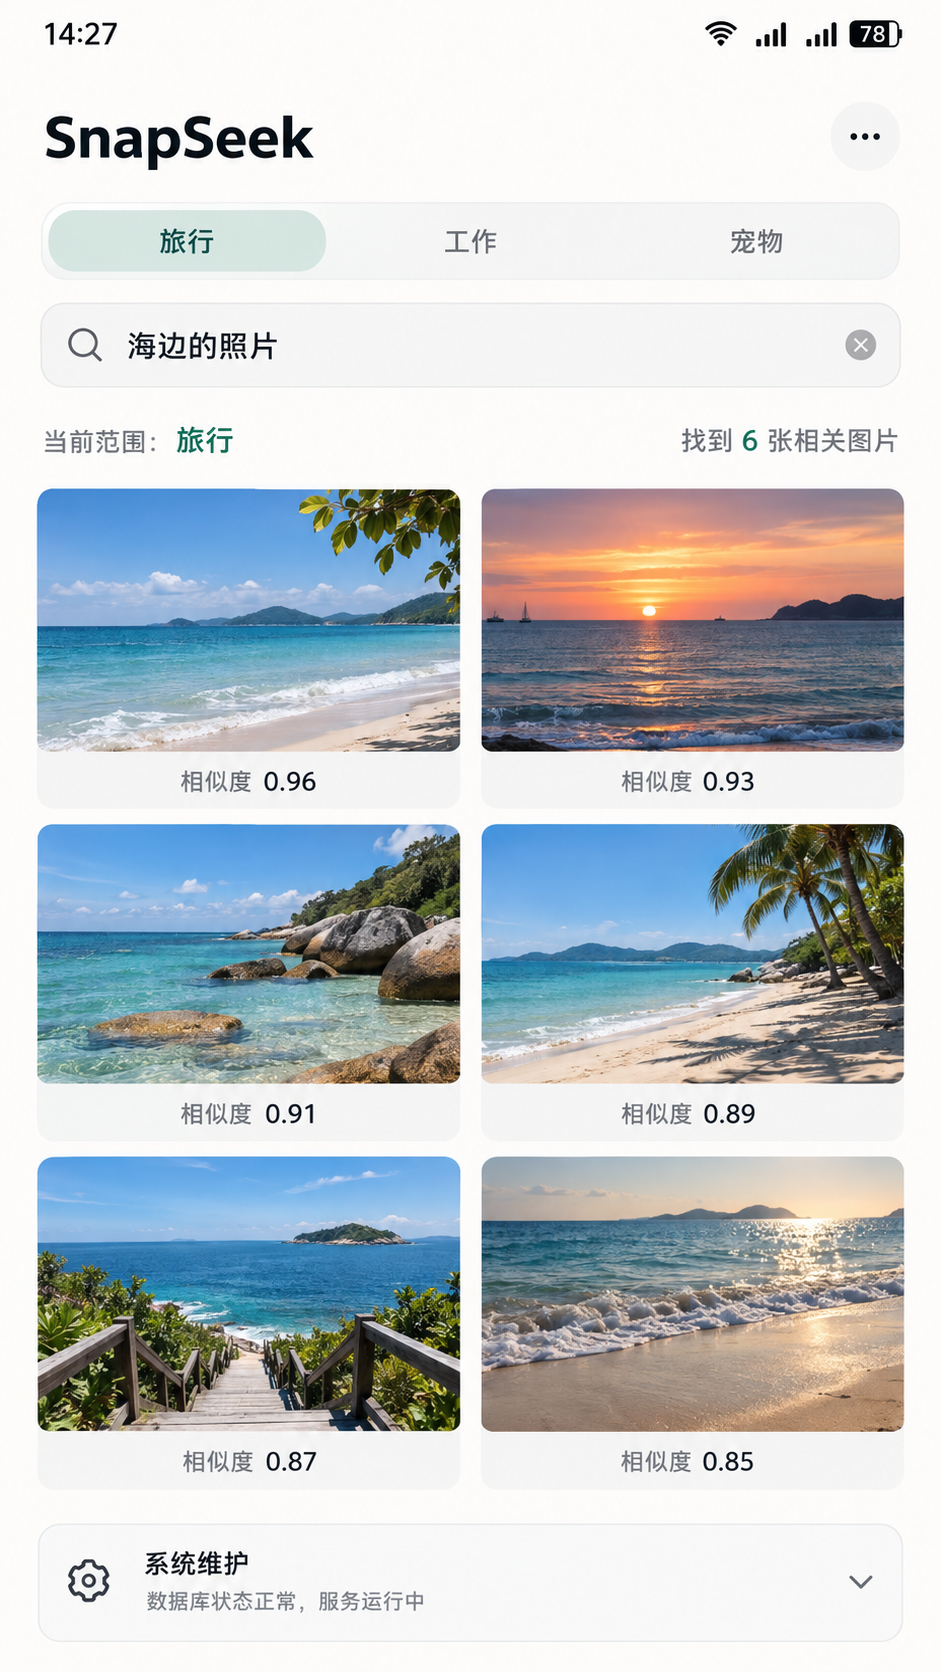
页面大致可以整理成这种结构:
Scope 区
  ↓
搜索输入区
  ↓
搜索结果区
  ↓
图库维护区
维护区默认可以是折叠或较低强调度状态。
只有在需要时,用户才展开去做新增、删除、重建和释放。
我特别喜欢这种收法。
因为它会让第五篇的 SnapSeek 在视觉上也和工程结构保持一致:
- 搜索,是主功能;
- 维护,是支撑功能;
- 两者都重要,但不应该抢同一个舞台。
这一步做完以后,整套 Demo 会明显更稳,也更像一份可复用样例,而不是把所有操作入口都摊开来展示。
七、我给自己补了一份“最终验收清单”,让第五篇真的像收尾而不是感想
第五篇如果只是写一些“我觉得现在结构更好了”的感想,其实是不够的。
因为收尾最怕空。
所以我给 SnapSeek 补了一份比较务实的最终验收清单。
它不是正式测试文档,但足够支撑这套 Demo 作为系列收口。
我会重点看下面这些项。
1)基础搜索链路是否仍然稳定
- 能初始化;
- 能导入测试图片;
- 能按 Scope 搜索;
- 结果区正常展示 similarity。
2)Query 与排序观察能力是否还在
- 固定 Scope 下更具体的 Query 是否能带来可观察的排序变化;
- 日志是否还能支持解释结果。
3)维护链路是否完整
- 新增图片后能进入检索;
- 删除图片后不会继续出现在结果里;
- 重建后 imported 状态和结果文案保持一致;
- release 后能重新进入初始化流程。
4)页面边界是否清楚
- 主搜索区和维护区是否分开;
- 页面状态是否比前几篇更克制;
- 页面没有继续膨胀成一个“什么都管”的大容器。
5)代码结构是否足够支撑读者理解
- Model 清楚;
- Service 角色清楚;
- 日志节点清楚;
- 页面职责清楚。
只有这些都过了,我才会认为第五篇不是“最后一篇凑数”,而是真的把前四篇收成一个完整结果。
八、我还会刻意保留一点“Demo 感”,而不是把它过度产品化
第五篇写到这里,还有一个很容易走偏的方向,就是为了显得“完整”,把 SnapSeek 继续往产品化方向做得很重。
比如:
- 加更复杂的导航;
- 加更重的设置页;
- 做一堆非主线视觉效果;
- 把维护流程做成很完整的后台管理感。
这些不是完全没价值,但我最后还是克制住了。
因为 SnapSeek 的身份,本质上仍然是一个文搜图学习 Demo,不是一个真正要上线的相册产品。
所以第五篇的收口原则,我给自己定得很明确:
要有工程感,但不要过度产品化。
也就是说:
- 结构要清楚;
- 体验要顺;
- 维护要完整;
- 但不要因为“想做得像个大项目”,把主线冲散。
这件事其实很重要。
因为一个好的学习型 Demo,最大的价值不在“像不像真正商业产品”,而在“能不能把关键问题讲清楚”。
SnapSeek 这个系列最值得保留的,就是它一路演进的过程感:
- 怎么把能力接进来;
- 怎么加 Scope;
- 怎么看 similarity;
- 怎么做维护;
- 怎么最后再收口。
第五篇如果太用力地往“产品包装”上走,反而会稀释这条线。
所以我更愿意让它保持一种“克制但完整”的状态:
看得出工程思路,但仍然是一份可以拿来学习和拆解的 Demo。
九、如果让我重新回头看这五篇,它们其实正好对应了一条很自然的学习路径
写到第五篇时,我自己也重新回看了一遍这套系列,结果发现它的节奏其实比我最初设想的还顺。
第一篇解决的是:
能不能跑起来?
第二篇解决的是:
应该在哪个范围里搜?
第三篇解决的是:
为什么结果排成这样?
第四篇解决的是:
图库变了以后怎么维护?
第五篇解决的是:
这些东西怎么重新收成一套清楚的工程样例?
这五个问题连起来,几乎就是一条非常自然的学习路径。
如果把它抽象一点,其实对应的就是:
能力接入
  ↓
边界建立
  ↓
结果理解
  ↓
维护恢复
  ↓
工程收口
我挺喜欢这种结构。
因为它不是“想到哪写到哪”,而是真正围绕一个 Demo,把文搜图从“先能用”一路推到“更像工程”。
而这也是我愿意写第五篇的原因。
如果没有最后这次收口,前四篇虽然各自都成立,但整个系列未必真的会变成一个完整的学习样例。
有了第五篇以后,这套东西终于不只是五篇独立文章,而开始像一条清楚的学习路线。
十、如果后面继续扩展,我会优先补哪些点,而不是再盲目加功能
第五篇做完以后,我反而比前几篇更清楚一件事:
一个 Demo 真正成熟的标志,不是它还能无限继续加功能,而是你已经知道下一步该加什么、不该加什么。
如果 SnapSeek 在这一版之后还要继续扩展,我不会马上去追更多花哨能力,而会优先看下面几个方向。
1)测试图片来源再真实一点
前面几篇为了保证学习过程稳定,很多测试图都是可控样本。
这个选择没有问题,但如果后面要进一步演示,我会考虑补一层更真实的图片来源流程,比如:
- 从一组固定资源目录导入;
- 按 Scope 批量导入;
- 对导入结果给出更清楚的统计。
这样做不是为了复杂化,而是为了让读者看到:
文搜图真正接入工程时,第一步往往不是“搜”,而是“把数据准备好”。
2)把示例 Query 做成更正式的引导
第三篇我已经意识到 Query 质量会直接影响排序。
所以如果后面继续扩展,我会更认真地做一层引导,比如:
- 空状态下给 3~5 个示例搜索词;
- 让不同 Scope 对应不同示例;
- 把“描述得更具体更容易找到目标图片”这件事提示得更自然。
这不是什么大功能,但它会直接改善第一次上手体验。
3)把维护动作进一步做成“只在需要时出现”
第五篇里我已经把维护区和搜索区分开了。
如果再往前一步,我更倾向于让维护区默认折叠,或者只在“开发 / 调试模式”下出现。
原因很简单:
SnapSeek 的主线始终是文搜图学习,不是后台管理。
维护动作要完整,但不应该一直抢主界面的注意力。
4)补一份更清楚的工程说明
如果 SnapSeek 后面真的要作为教学 Demo 继续使用,我会单独补一份工程说明,至少讲清楚:
- pages 里是什么;
- common 里是什么;
- model 里是什么;
- 哪些日志是关键观察点;
- 五篇文章分别建议先看什么。
这样一来,这套 Demo 就不只是“文章 + 配图”,而会更像一套真正可复用的学习资料。
所以第五篇结束时,我并不是觉得“这个项目完全结束了”,而是第一次比较确定:
这套 Demo 现在已经有了继续扩展的基础,接下来该做的是有节制地往前走,而不是见什么都加。
十一、本文小记
如果让我给第五篇下一个最直接的总结,我会说:
前四篇在帮 SnapSeek 长出能力,第五篇在帮它长出形状。
这个“形状”不是指 UI 漂不漂亮,而是:
- 页面边界更清楚了;
- Service 的角色更清楚了;
- Model 的职责更清楚了;
- 日志更克制了;
- 搜索动作和维护动作被重新分开了;
- 最终验收标准也更明确了。
这其实就是工程收口最重要的意义。
它不会像第一篇那样带来“哇,结果出来了”的新鲜感,也不会像第三篇那样让人对 similarity 产生很多讨论,但它会让整个系列从“内容很多”变成“结构清楚”。
对我来说,第五篇最值的地方,不是又做了一个新功能,而是终于把前四篇的成果整理成了一套真正能复用的 Demo。
如果后面再有人想用文搜图做一次教学、做一次分享、做一个样板工程,SnapSeek 到这里就已经比较像一份拿得出手的基础版本了。
而这也是我给这个五连载收尾时最想留下来的东西:
不是只会调用几个 API,
而是能把一个能力,一步一步做成一套讲得清、看得懂、还能继续扩展的小工程。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献58条内容

所有评论(0)