
HarmonyOS 7 文搜图实战 03:Similarity + Query 优化 SnapSeek 搜索结果排序【鸿蒙心迹】
第一篇里,我先把 SnapSeek 的第一条“文字 → 图片”链路跑通了;第二篇又补上了 Scope,让搜索开始有明确的图库边界。做到这里,Demo 已经能用,但新的问题也冒出来了:为什么这些结果会排成这样?同样搜“猫”,和搜“窗边晒太阳的猫”,结果为什么不一样?相似度到底该怎么看? 这一篇我就继续往前推,不再只关心“搜没搜到”,而是开始认真研究 similarity 和 query 表达方式,把 SnapSeek 从“会搜”进一步推进到“结果更像我想要的那样排序”。
前两篇做完以后,我对 SnapSeek 的整体感觉已经比最初清楚很多了。
第一篇让我确认了一件事:HarmonyOS 7 的文搜图能力,不是停留在说明文档里的“某个新接口”,它是真的能在一个普通 ArkUI 页面里形成闭环。
第二篇又让我确认了另一件事:如果不加 Scope,结果会越来越散;Scope 一加上去,搜索立刻就有了边界感。
可当我开始把 Scope 真正用起来以后,第三个问题马上就跳出来了,而且这个问题一点都不抽象,几乎是你每搜一次图都会遇到的:
为什么这些结果是现在这个顺序?
比如我在宠物图库里搜“猫”,结果能出来,这当然没问题。可如果我把搜索词改成“沙发上的猫”,排序就会变;再改成“窗边晒太阳的猫”,前几名又会重新洗牌。
这时候你就会发现,前两篇解决的是“有没有”和“在哪儿有”,而第三篇真正开始碰到的是“为什么它觉得这些图更像”。
从技术角度说,这就是 similarity 开始真正产生存在感的时候。
我这篇文章,想做的不是给 similarity 下一个神秘定义,而是围绕一个很实际的问题展开:
在 SnapSeek 里,怎么理解相似度,怎么观察 Query 对结果的影响,以及怎么把这些观察变成更稳的页面和调试策略。
一、第三篇要解决的问题,不是有没有结果,而是结果为什么这样排
第一篇的目标很明确:先让结果出来。
第二篇的目标也很明确:先把结果限制在正确的 Scope 里。
到了第三篇,如果还只是停留在“有结果就行”,SnapSeek 其实就很难继续往下长了。
因为用户真正感知到好不好用,不只是“返回了几张图”,更在乎:
- 这几张图为什么排前面?
- 第一张为什么比第二张更像?
- 换一种说法以后,为什么结果顺序变了?
- 看起来差不多的两张图,为什么相似度差了不少?
这些问题你不碰,它就一直在那儿。
而且它不像 Scope,那是比较明显的结构问题;similarity 更像一个“如果你不去解释,它就会一直让人心里发虚”的字段。
我一开始其实也想简单处理:
既然结果里带了相似度,那我是不是只要显示出来,文章就算讲到了?
后来很快发现,这样远远不够。因为真正重要的不是“把 0.921、0.882 打在 UI 上”,而是你要知道这些数字该怎么看、该拿来做什么、又不该过度拿它做什么。
第三篇真正要解决的,就是把这个问题讲清楚:
相似度不是摆设,但也不是一个一眼就能决定生死的阈值。
二、我先做的不是改 UI,而是给自己设计一组可观察的 Query
如果想认真研究排序,最忌讳的其实不是代码少,而是测试词太随意。
比如你今天搜“猫”,明天搜“风景”,后天搜“桌子”,每次都换图库、换图片、换语境,那最后你根本看不出来是 Query 变化导致结果变了,还是图片集合本身变了。
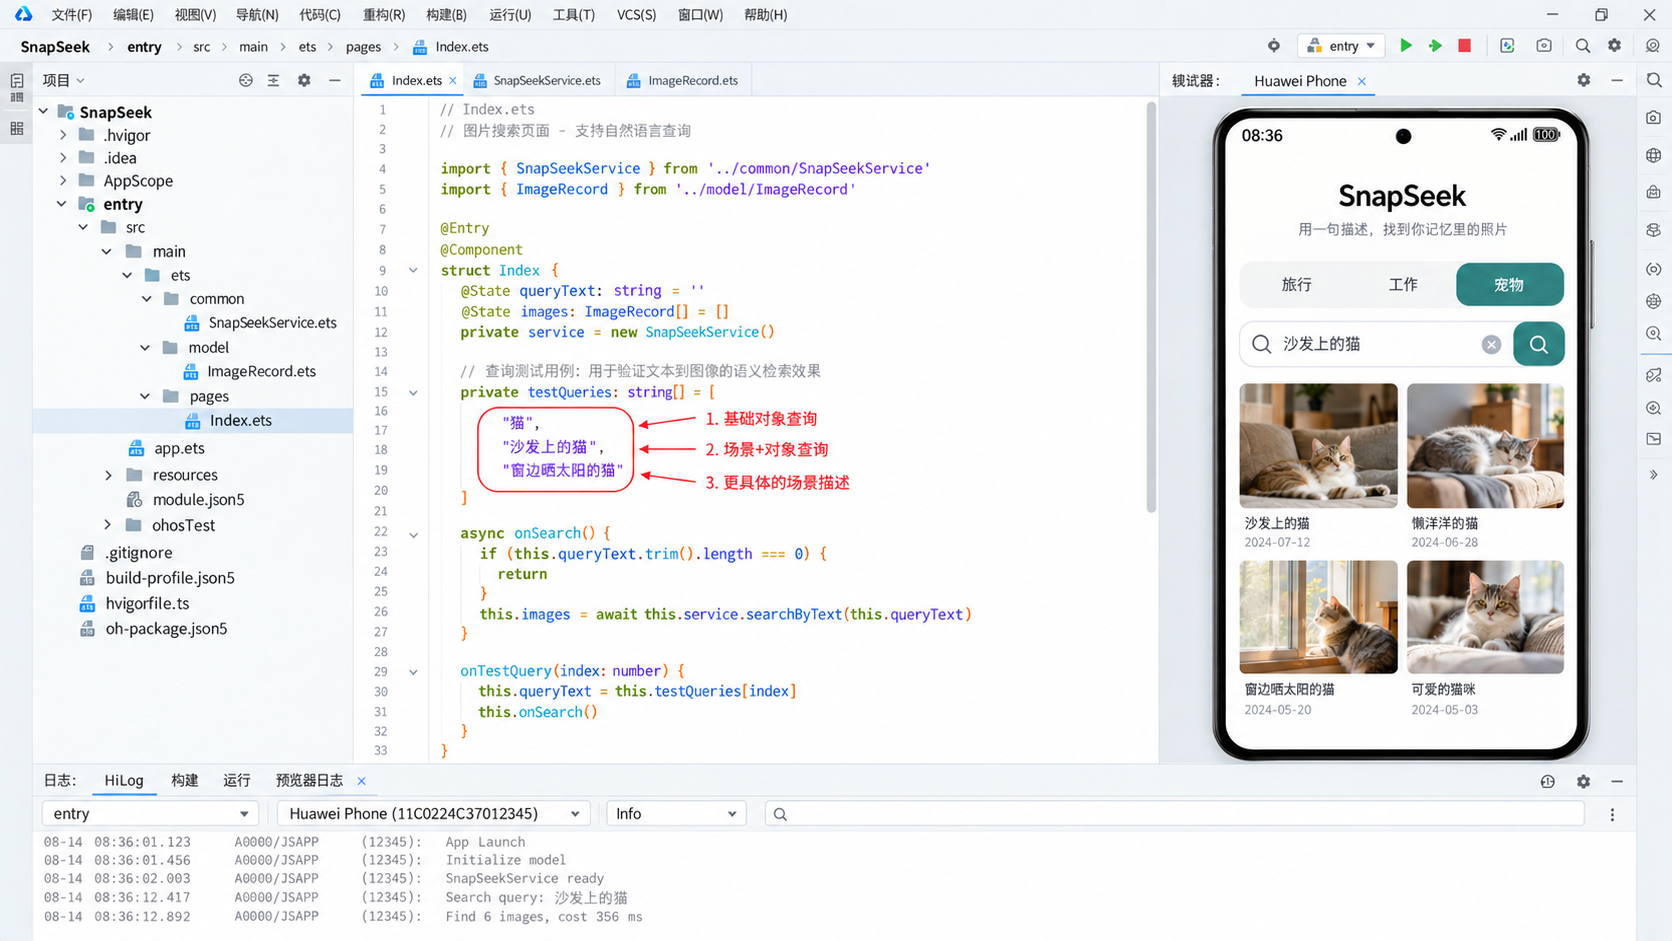
所以第三篇一开始,我先给自己定了一组更可观察的测试方法:
-
固定 Scope,不来回切换
比如这次就只观察pet或travel,尽量减少变量。 -
图片集保持不变
先不增删图片,也不换图片内容,避免把问题复杂化。 -
只逐步修改 Query 的表达粒度
例如:猫沙发上的猫窗边晒太阳的猫
这样做的好处特别直接。
因为你会越来越清楚地看到:
不是“搜图结果为什么总变”,而是当描述更具体以后,结果的排序为什么会跟着变。
这一步看起来像是在“研究词怎么写”,其实它在工程上特别重要。因为很多人第一次做文搜图时,会把重点都放在接口调用上,结果一旦 UI 出来,就容易把体验问题归结成“能力不够准”。实际上很可能不是不准,而是:
- 你的 Query 太宽泛;
- 你的 Scope 还不够稳;
- 你没有一套可重复观察的测试方式。
第三篇从这里开始,我觉得很有必要。因为它让 SnapSeek 第一次从“调用一个能力”变成了“开始认真研究结果”。
三、先把日志补起来:没有观察数据,谈排序只会凭感觉
前两篇里,我已经有基本日志了,比如初始化成功、导入成功、当前 Scope 是什么。但如果第三篇还继续停留在这种粗粒度日志层面,那你很难真的分析 similarity。
所以我第一步就把日志加细了一点。
文件位置: entry/src/main/ets/pages/Index.ets
用途: 搜索后记录 query、scope、结果数量和前几名 similarity。
async handleSearch() {
  const query = this.keyword.trim()

  if (!this.initialized || !this.imported || !query) {
    return
  }

  this.loading = true
  this.statusText = `正在 ${this.currentScope} 图库中搜索:${query}`

  try {
    const result = await this.service.search(query, this.currentScope, 8)
    this.resultList = result
    this.statusText = `当前范围:${this.currentScope},找到 ${result.length} 张相关图片`

    console.info(`[Search] query=${query}`)
    console.info(`[Search] scope=${this.currentScope}`)
    console.info(`[Search] result count=${result.length}`)

    result.forEach((item, index) => {
      console.info(
        `[Search] rank=${index + 1}, similarity=${item.similarity}, path=${item.path}`
      )
    })
  } finally {
    this.loading = false
  }
}
这段代码不复杂,但特别关键。因为从这一步开始,SnapSeek 不再只是“我搜一下,看 UI 里大概像不像”,而是能同时看到:
- 我搜了什么;
- 我在哪个 Scope 里搜;
- 一共返回了多少张图;
- 前几名分别是什么;
- 它们的 similarity 分别是多少。
很多时候,技术判断就是从这种“有点啰嗦”的日志里长出来的。
比如同样是搜“猫”,你会发现:
- 第一名和第二名差距可能并不大;
- 前三名的 similarity 很接近;
- 但当 Query 从“猫”变成“窗边晒太阳的猫”,排序就会明显变化。
如果没有这些数值证据,你就只能靠肉眼猜。
而只靠猜,很容易把“结果为什么变了”理解错。
四、我没有急着给 similarity 设阈值,因为它更适合先拿来做观察
看到 similarity 字段时,特别自然的一种反应是:
既然有分数,那我是不是可以定一个线?
比如 0.8 以上才算靠谱。
说实话,我一开始也想这么干。
但真正跑了几轮测试以后,我把这个念头先按住了。原因很简单:
similarity 在当前阶段更适合先拿来观察,而不是直接拿来裁决。
比如在旅行图库里搜“海边的照片”,前几名可能是:
- 0.921
- 0.882
- 0.856
- 0.803
- 0.776
- 0.743
你如果直接把阈值卡成 0.8,那后面两三张图会被干掉。
可问题是,它们真的就没价值了吗?未必。
再比如在宠物图库里搜“窗边晒太阳的猫”,你可能看到:
- 0.907
- 0.861
- 0.792
- 0.774
这时候第三张虽然没到 0.8,但从视觉内容上看,它还是非常接近目标的。
这让我越来越确定一件事:
第三篇里,similarity 最合适的角色,不是“通过 / 不通过”,而是“排序依据 + 调试证据”。
换句话说,我现阶段更愿意先把它用在两件事上:
-
解释排序
为什么第一张在前,第二张在后。 -
帮助观察 Query 的影响
同一组图,换一个更具体的描述后,分数和顺序怎么变。
这比一上来拍脑袋给它定个 0.8,要更稳妥。
五、我专门拿宠物图库做了一次 Query 递进实验
为了把这个问题观察得更清楚,我专门挑了一个比较容易直观看出差异的场景:宠物图库中的猫图。
我把 Scope 固定在 pet,然后依次用了三组 Query:
猫沙发上的猫窗边晒太阳的猫
这三组 Query 的关系很明确:
- 第一组最宽;
- 第二组加入了场景元素;
- 第三组进一步加入位置和动作感。
这样我就能非常直观地观察一个问题:
描述越具体,排序是否会更集中到我想要的那类图上?
为了方便演示,我还单独整理了一个简单测试方法:
文件位置: entry/src/main/ets/pages/Index.ets
用途: 在固定 Scope 下批量测试不同 Query。
private async runSimilarityTest() {
  const testQueries: string[] = [
    '猫',
    '沙发上的猫',
    '窗边晒太阳的猫'
  ]

  for (const query of testQueries) {
    const result = await this.service.search(query, 'pet', 6)

    console.info(`====================`)
    console.info(`[Test] query=${query}`)
    console.info(`[Test] scope=pet`)
    console.info(`[Test] result count=${result.length}`)

    result.forEach((item, index) => {
      console.info(
        `[Test] rank=${index + 1}, similarity=${item.similarity}, path=${item.path}`
      )
    })
  }
}
我特别喜欢这种“看起来有点笨,但非常清楚”的测试方式。
它不会一下子帮你得出所有结论,但它会让你更容易看明白:
- 是不是 Query 越具体,前几名越稳定;
- 是不是某些图虽然也有猫,但因为场景不符,排名就被挤下去了;
- 是不是某些结果一直稳定出现在前几名,说明它本身语义就很强。
这时候,similarity 才真正开始变成“有用的信息”,而不只是一个顺手展示出来的数字。
六、UI 上我做了一个很小的改动,但对理解结果特别有帮助
第三篇里,我没有一下子把 UI 做得很重。我只加了一个很小但很实用的东西:
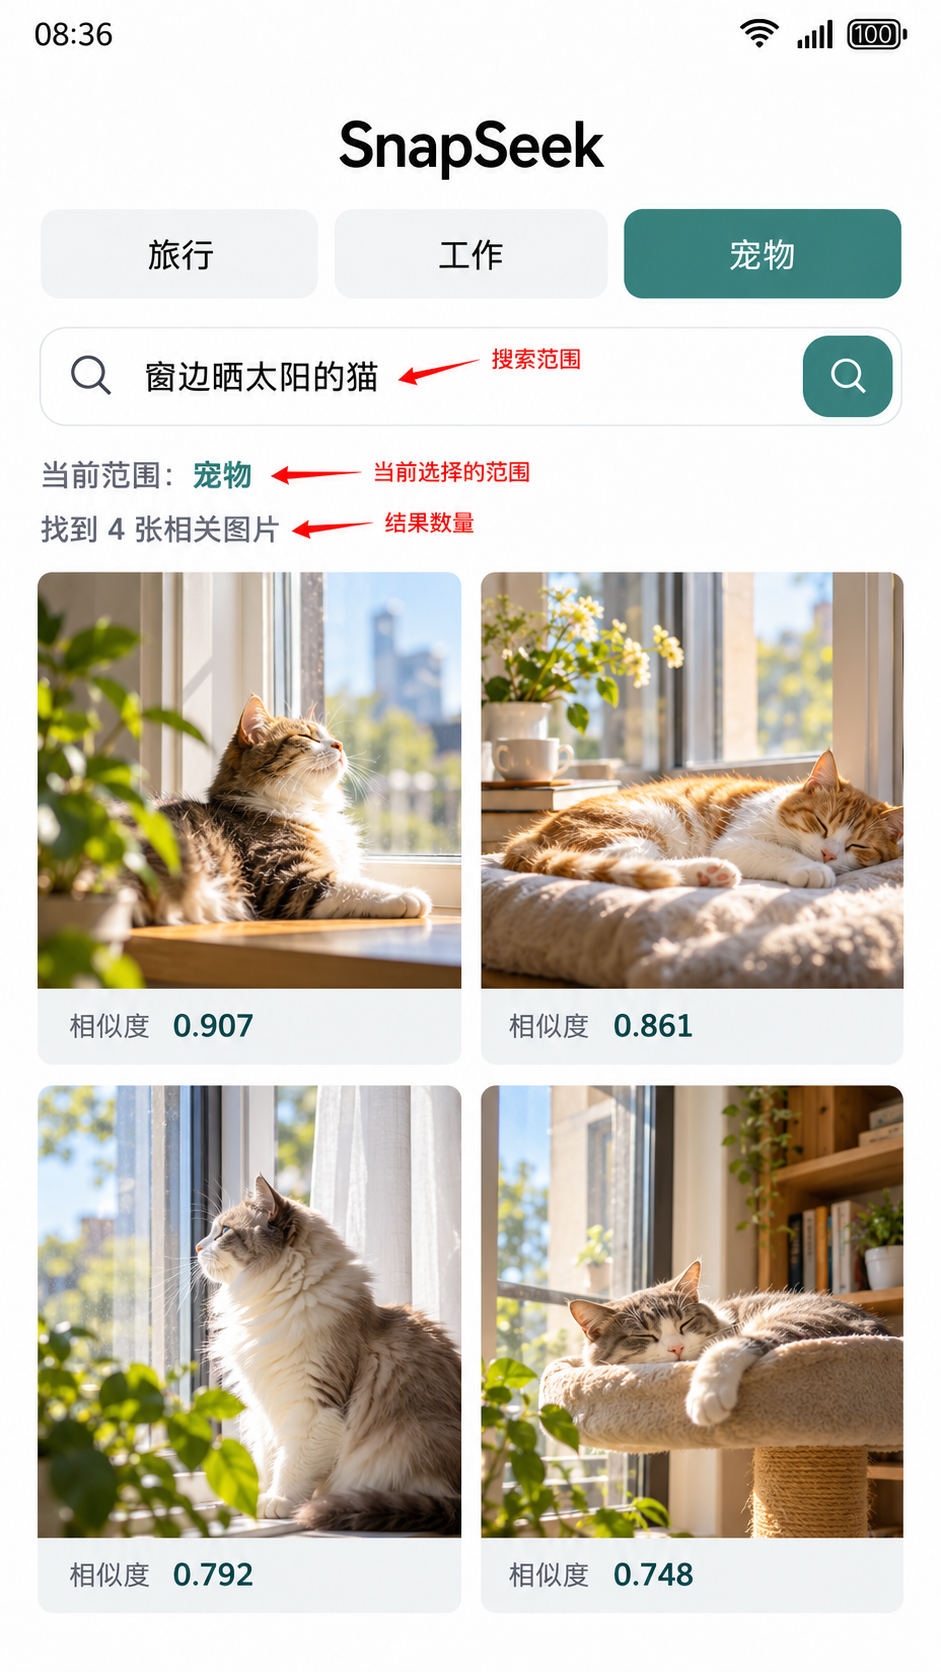
在搜索结果区域上方,把当前 Query 和当前 Scope 再明确显示一次。
原因很简单。第二篇以后,搜索不再是“全局搜索”,而是“在某个 Scope 中搜索某个 Query”。如果页面上只保留结果图,而不把当前上下文表达清楚,过一会儿你自己回来看,都会忘记这些结果到底对应的是什么条件。
所以我在 UI 上让它至少能明显看到:
- 当前 Scope;
- 当前 Query;
- 结果总数;
- 部分图的 similarity。
这个改动看着小,但调试时特别舒服。
你拍手机截图、看模拟器、翻日志,三者能迅速对上。
而且第三篇的主题本来就是“结果为什么这样排”,所以页面一定要帮助你建立这个因果关系,而不是只给你一堆图。
这也是我越来越明确的一点:
文搜图的 UI,不只是展示结果,更是在帮助你理解搜索上下文。
七、我为什么不建议第三篇就把 similarity 变成一个硬过滤条件
第三篇做到这里,很多人可能都会自然问一句:
既然你已经能看到 similarity 了,那为什么不直接加一个“只看 0.8 以上结果”的开关?
这个想法很合理,但我觉得第三篇还不是最合适的时候。
原因主要有三个。
1)我们对 similarity 的分布还不够熟
现在虽然有日志,也能看到排序,但测试样本还不够多。
如果太早把它变成硬过滤条件,很容易一开始就把“观察问题”变成“误伤结果”。
2)不同 Query 的语义力度本来就不一样
“猫”和“窗边晒太阳的猫”,对系统来说不是一个粒度。
如果你给它们套同一个阈值,结果很可能会不一致。
3)UI 体验还处在“解释结果”的阶段
第三篇的重点,是先让你能理解排序。
如果这时候直接上过滤开关,文章重心反而会被带偏——你开始讨论“阈值怎么调”,但对 similarity 本身的理解还没站稳。
所以我的选择是:
- 先展示 similarity;
- 先拿它做排序解释和调试;
- 先观察 Query 变化带来的结果差异;
- 不要急着把它变成硬性的裁判。
这并不是否认阈值过滤的价值,而是我觉得那应该放在更靠后的阶段,至少等你对样本分布、用户场景和结果容忍度有更多认识之后,再决定要不要做。
第三篇先把“看懂结果”这件事做好,比什么都重要。
八、部分图为什么适合加红色标注:因为第三篇讲的是“理解”,不是单纯展示
你这次特别强调,部分图可以加红色文字、箭头、圆圈来辅助文章,我觉得第三篇确实很适合,而且比前两篇更适合。
原因很简单:前两篇更多是在讲“结构”和“链路”,第三篇则开始讲“为什么”和“怎么看”。这种内容如果全靠文字,有时读者会在图上找不到你想强调的点。
我建议第三篇里最适合加红色标注的图有两类。
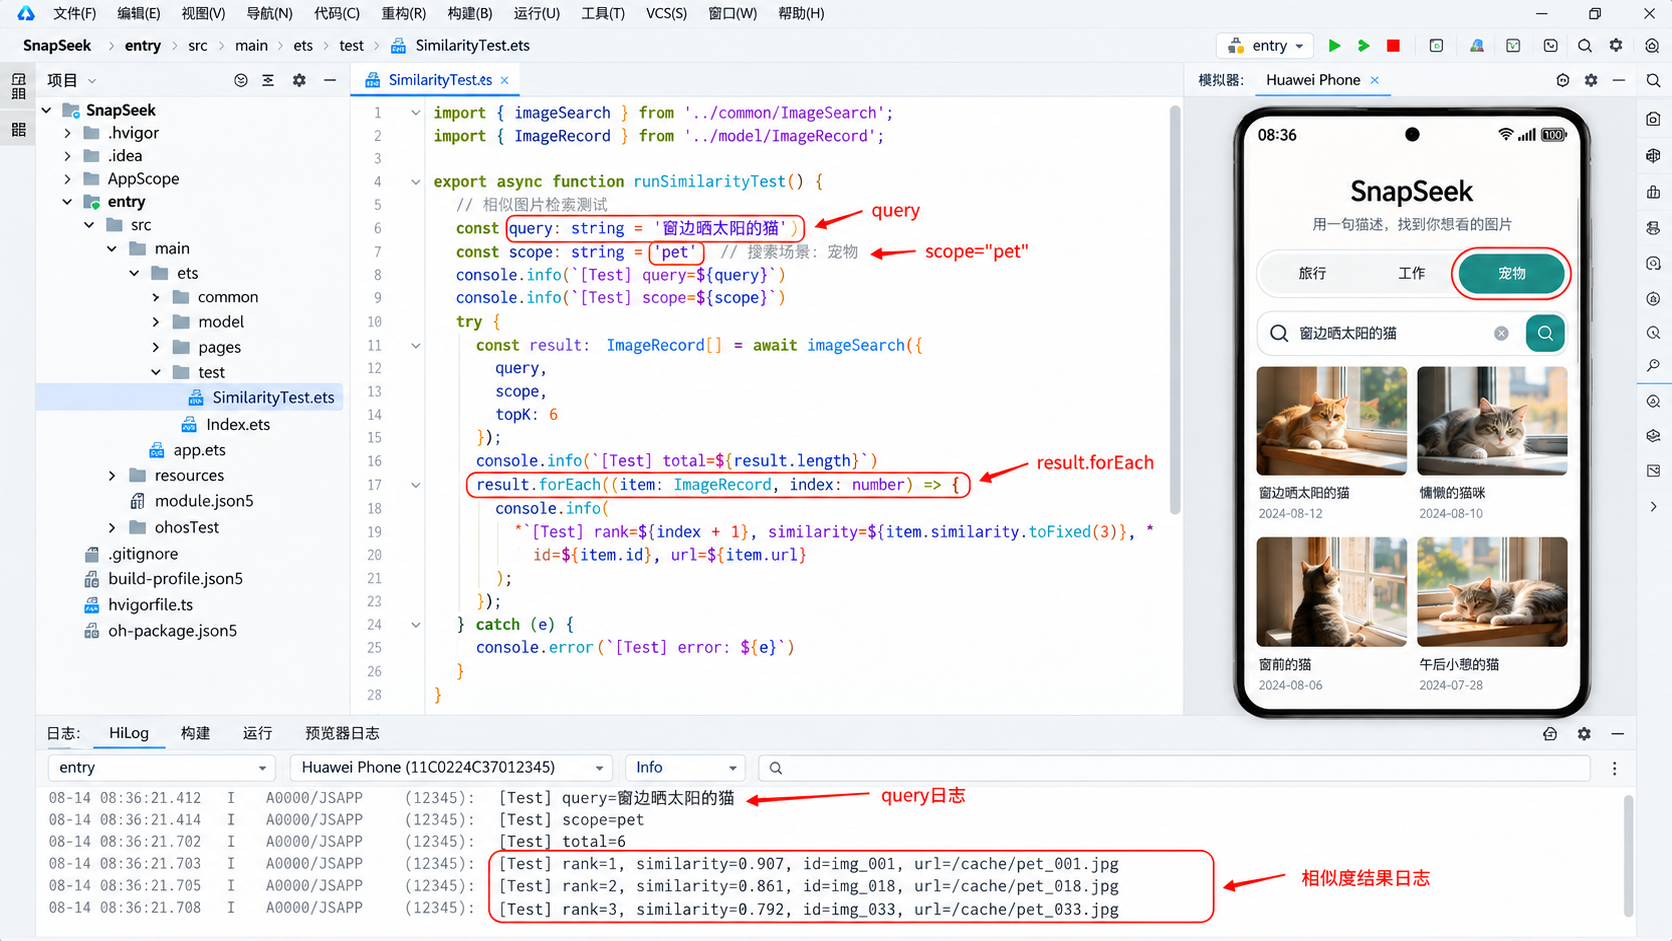
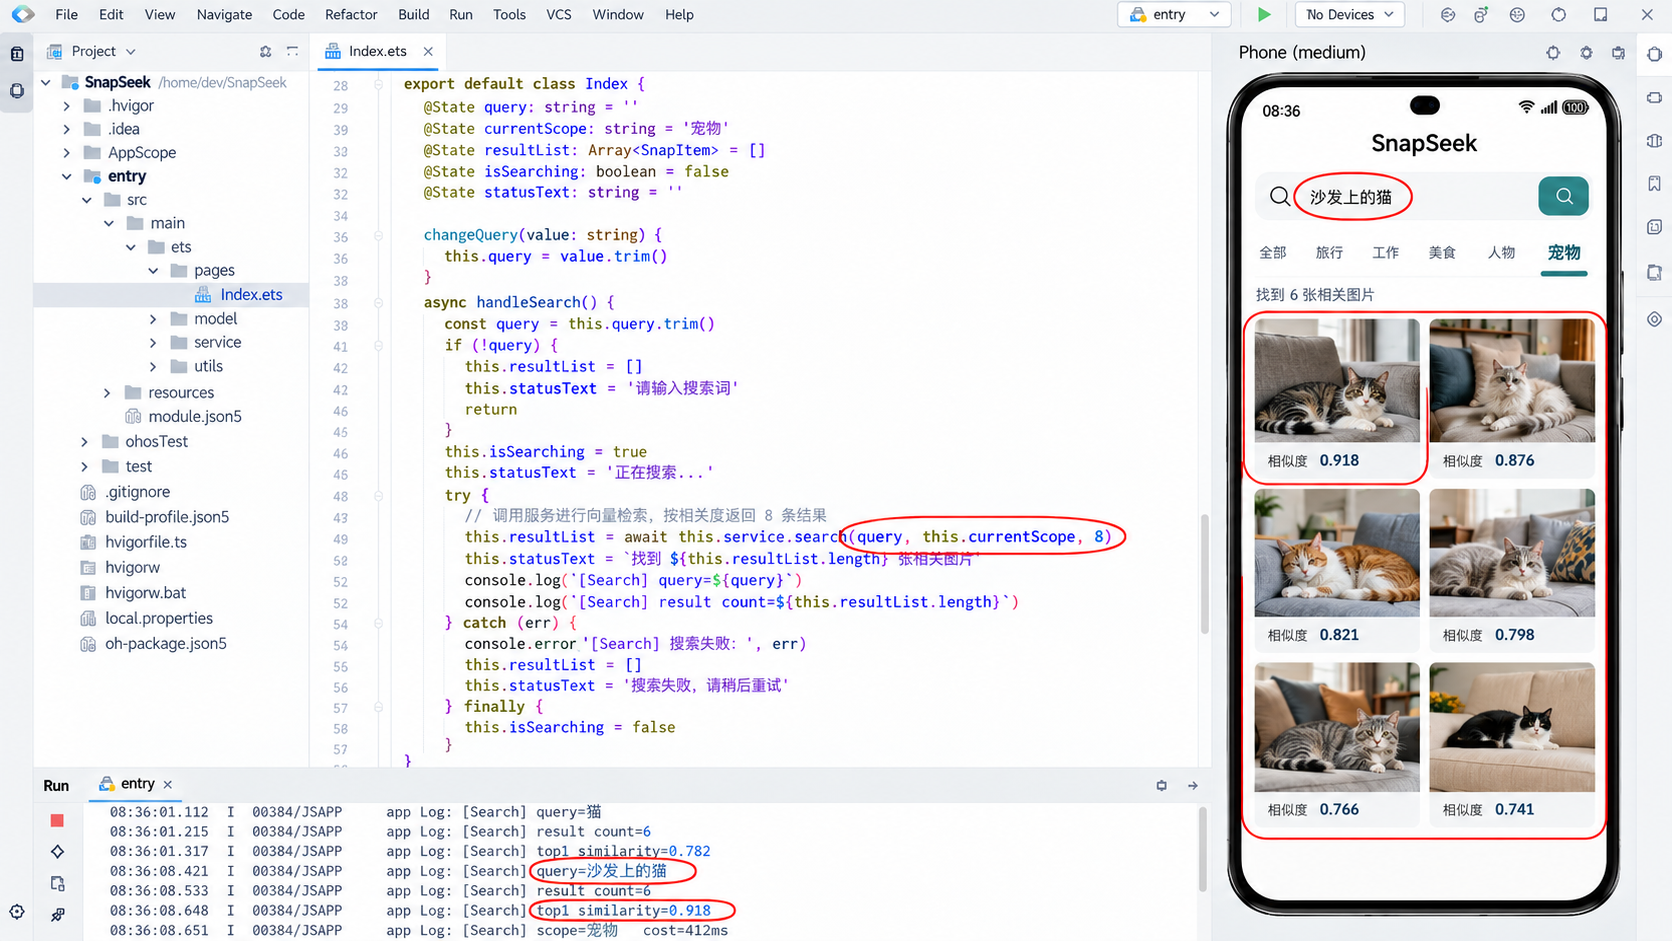
第一类:Similarity 测试的 DevEco 截图
这张图里最值得标出来的是:
query=...scope=...rank=1 similarity=...rank=2 similarity=...
因为读者一眼看过去,如果没有一点点强调,可能只会觉得“底部一堆日志”。
但只要你用红色细框、红色细圆圈或红色箭头轻轻标一下,信息一下就清楚了。
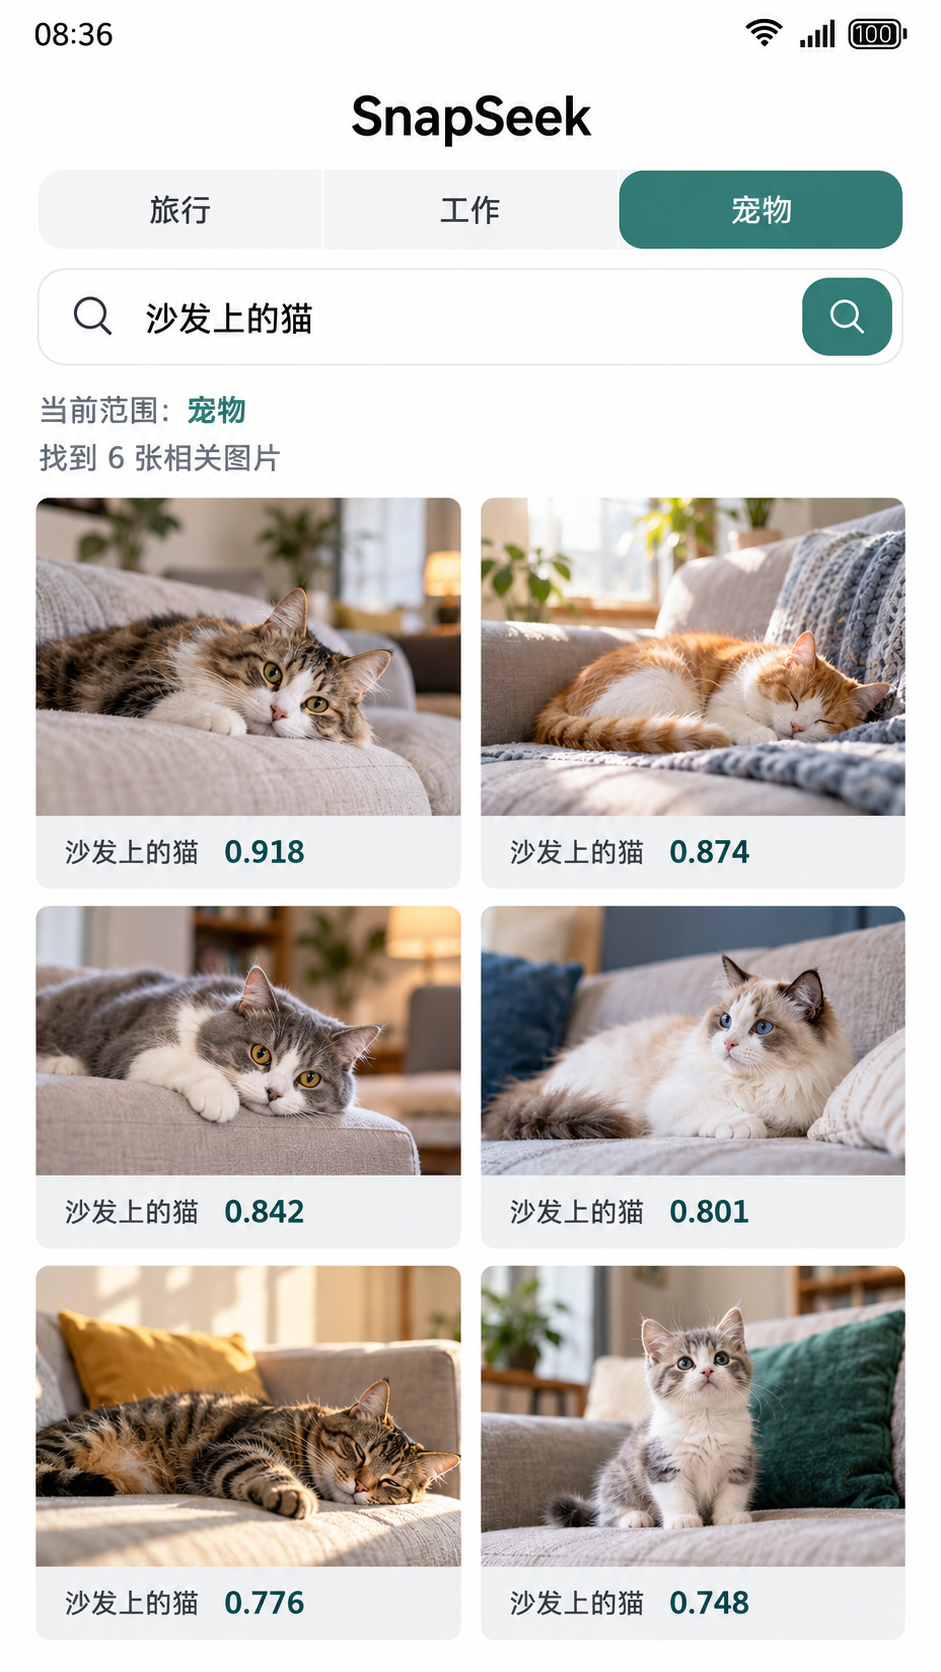
第二类:纯手机截图中的当前 Query 和当前 Scope
尤其是那张无手机边框的纯手机截图,如果你在图上适度标出:
- 当前 Scope;
- 当前搜索词;
- 当前结果数;
读者就很容易把这张图和文章中的讨论对应上。
但我还是坚持一点:
只在必要的图上标。
比如封面图和最后一张完成态结果图,我更倾向于保持干净;
真正需要“解释结构”和“指认重点”的,是中间那两三张功能图。
九、还有一个很重要的工程感受:Query 本身也是输入的一部分,不是随便写写
做到第三篇,我对文搜图这件事有一个越来越强烈的感受:
Query 不是可有可无的随手输入,它本身就是功能的一部分。
很多时候我们做普通搜索,会比较习惯把输入词当作一个完全自由的文本条件。可到了文搜图这里,你会更明显地看到:
- 输入词是不是太宽;
- 输入词有没有包含场景;
- 输入词有没有包含动作、位置或对象关系;
这些都会影响结果排序。
所以我现在看 SnapSeek,已经不太把它理解成“给图片搜一下”,而更像:
用户在用语言组织记忆,然后让系统去对接图片内容。
这就意味着,后面如果 SnapSeek 真继续做下去,Query 这一层其实也值得继续优化。比如:
- 要不要提供一些示例搜索词;
- 要不要保留最近搜索;
- 要不要在空状态时给用户提示“描述得更具体会更容易找到目标图片”。
这些都还没到第三篇要正式实现的时候,但第三篇至少已经把问题抛出来了:
输入方式本身,会直接影响结果排序。
这其实是个很好的信号。因为它说明 SnapSeek 已经不只是“点按钮调能力”了,而开始长出真正的产品思考。
十、我还顺手做了一件小事:把“示例搜索词”当成理解 Query 的入口
第三篇做到一半的时候,我还有一个挺强烈的感受:
不是每个用户都会天然写出一个“适合文搜图”的 Query。
这件事在开发者自己测试时不明显,因为我们知道自己在试什么,也知道为什么会输入“窗边晒太阳的猫”这种更具体的描述。可一旦把页面拿给别人看,对方第一反应往往就是很随手地输入两个字,比如:
- 猫
- 海边
- 桌子
- 风景
这样当然也能搜,但如果文章想继续往“体验为什么会这样”上走,就会发现一个问题:
很多人其实不知道,描述得更具体,结果排序往往会更收敛。
所以我第三篇里虽然没有正式去做“搜索引导功能”,但我会先在页面空状态或说明文案里放几条示例搜索词,比如:
海边的照片桌子上的电脑窗边晒太阳的猫
它的目的不是做营销,也不是装饰页面,而是给用户一个很轻的提示:
你不是只能输一个名词,完整一点的描述,往往能带来更稳定的结果。
这一步看着小,但我觉得它特别符合第三篇的主题。
因为第三篇最核心的事情,本来就是去理解 Query 对排序的影响。
如果你把 Query 继续理解成“随便输点什么都一样”,那第三篇的很多讨论就落不到体验上。
相反,只要给用户一点点示例,他就更容易明白:
- Query 可以带对象;
- Query 可以带场景;
- Query 可以带动作或位置;
- 描述越贴近你脑子里记得的画面,结果通常越容易靠前。
这其实也是我做 SnapSeek 到第三篇以后,一个越来越明确的判断:
文搜图不是“替代输入”,而是“更认真地使用输入”。
系统在帮你理解图片,但你也需要尽量把自己的记忆组织成一段更有信息量的话。
所以第三篇做完以后,我会把“示例搜索词”这件事暂时记下来。它现在还只是一个轻量提示,但到后面如果要继续做产品化,这很可能会变成一个值得认真优化的入口。
十一、我会怎么验收第三篇:不是看分数有没有显示,而是看我能不能解释结果
第三篇做完以后,我不会把验收标准写成“界面上有 similarity 字段”。
那太表面了。
我更看重下面这几件事。
1)固定 Scope 下,不同 Query 的结果是否真的产生变化
比如在 pet 中搜“猫”和“窗边晒太阳的猫”,结果顺序应该有可观察差异。
如果完全没有差异,那说明 Query 的递进测试没有真正成立。
2)日志能不能支持分析排序
我会检查日志里是不是至少有这些信息:
- query
- scope
- result count
- rank
- similarity
- path
因为第三篇不是只“看图说话”,而是要让排序有证据可查。
3)UI 是否能表达清楚当前上下文
Scope、Query 和结果总数,最好能同时看到。
否则过一会儿回头看截图,你自己都不一定记得这轮搜索的条件是什么。
4)没有过早引入硬阈值过滤
这点反而是我会主动检查的。
如果第三篇里为了“看起来更高级”提前做了 0.8 过滤,我会认为方向有点走偏了。因为这篇最重要的是理解 similarity,不是过早裁剪结果。
5)至少有一张“真截图感”的结果图
而且这张图最好能把 Query、Scope、结果区和相似度一起表达出来。
因为第三篇的核心,就是要把“结果为什么这样排”可视化。
如果这些点都满足,我才会觉得第三篇真正站住了。
它不只是多加了一个分数字段,而是开始建立“结果解释能力”。
十二、第三篇做完以后,第四篇该自然进入“增删和重建”了
写到这里,SnapSeek 的这条学习路线其实已经越来越顺了。
- 第一篇:把搜索链路跑通;
- 第二篇:加上 Scope,建立搜索边界;
- 第三篇:观察 similarity,理解 Query 和排序的关系。
接下来,第四篇很自然就该碰另一个绕不过去的现实问题了:
如果图片被删了、换了、重建了,检索数据怎么跟着维护?
因为做到第三篇,搜索结果虽然已经“更像我想要的那样排了”,但图库本身还是相对稳定的。
一旦进入真实使用场景,图库一定会变化:
- 图片新增;
- 图片删除;
- Scope 调整;
- 索引重建;
- 能力更新后的恢复。
这些问题都和前面三篇不冲突,反而是顺着它们自然长出来的。
所以第三篇结束时,我对 SnapSeek 的感觉已经不再是“一个能演示的 Demo”,而更像一个开始慢慢成形的小工具。
而第四篇,就是把这个小工具真正往“可维护”上再推一步。
十三、本文小记
如果让我给第三篇下一个尽量朴素的总结,我会说:
前两篇解决的是“有没有”和“在哪儿有”,第三篇开始解决“为什么排成这样”。
这是一个很关键的转折。
因为一旦你开始认真面对 similarity,SnapSeek 的讨论就不再只是“能力接入”了,而开始变成“能力如何被理解和使用”。
这中间最让我确认方向没错的一点,是我越来越能感觉到:
- Scope 让结果有边界;
- Query 让结果有倾向;
- similarity 让结果开始可以被解释。
而这三者一旦连起来,SnapSeek 就比前两篇更像一个真正的搜索工具了。
它当然还没有到“成熟产品”的程度,但已经明显过了“只是试试看能不能做”的阶段。
对我来说,这就是第三篇最大的意义:
它第一次让搜索结果不只是“出来了”,而是开始“说得通了”。
下一篇,我们就顺着这个方向,继续去碰更接近真实工程的一层:图片增删、索引重建和异常恢复。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献58条内容

所有评论(0)