
HarmonyOS 7 + TaskPool + Worker 学习笔记:并发任务模型、线程隔离与 UI 性能优化实践【鸿蒙心迹】
这篇学习笔记不是简单比较 TaskPool 和 Worker 的 API,而是从一次很典型的“页面一处理数据就卡”开始,把主线程、短时并发任务、独立线程之间的边界重新走了一遍。最后真正想弄清楚的,是耗时任务该放哪、结果怎么回来,以及 UI 为什么会因此变得稳定。
一、最开始的问题很普通:功能能跑,但页面就是不跟手
我第一次把批量数据处理塞进页面逻辑时,其实没有马上意识到并发模型会成为问题。
当时的需求很简单:页面加载一批图片元数据,对每条数据做尺寸计算、标签整理和 JSON 转换,然后把结果重新渲染到列表里。数据少的时候几乎感觉不到差别,十几条、二十几条都能正常跑。
真正把测试数据拉到一百多条以后,问题一下子暴露出来了。
点击“开始处理”以后,按钮会短暂失去响应;滚动列表时明显发涩;有时页面甚至像停住了一样,过一会儿才把结果一起刷出来。
代码没有报错,结果也是对的。站在“功能是否完成”的角度,它甚至算成功了。
但站在真实使用角度,这种成功没有意义。
后来我把这段逻辑拆开看,才发现问题并不神秘:计算工作和 UI 更新挤在了同一条执行路径里。 主线程既要处理用户点击、布局、绘制,又要跑一段持续几十到几百毫秒的计算。只要后者占住时间,前面的交互就只能等。
这也是我这次开始认真看 TaskPool 和 Worker 的原因。
我没有一上来问“哪个性能更高”,而是先问了三个更实际的问题:
- 什么任务适合交给 TaskPool;
- 什么任务更适合单独 Worker;
- 任务放出去以后,结果怎么安全回到页面。
这三个问题比背 API 更有用,因为它们决定了项目最后会不会重新回到“主线程什么都干”的老路上。
二、先把任务分清楚,再谈用哪种并发模型
刚开始学并发时,很容易把所有“耗时操作”看成同一种东西。
但真正做项目以后,我发现耗时任务至少要先分成几类。
第一类是一次性的短计算任务。比如批量解析几十条 JSON、计算缩略图尺寸、对一批数据做过滤排序。这些任务有明确输入,执行结束以后给一个明确结果,生命周期很短。
第二类是持续存在、需要反复通信的任务。比如一个长期运行的数据处理线程、持续接收消息的解析器、需要保存内部状态的工作线程。它不是执行完一次就结束,而是页面会不断和它交换消息。
第三类其实不是并发问题,而是异步 I/O。网络、文件、数据库很多时候本身就有异步接口,并不意味着一定要再套一层线程模型。
把这三类分开以后,TaskPool 和 Worker 的定位就清楚很多了。
我最后给自己的判断是:
- TaskPool 更像任务调度器。适合把可拆分、相对独立、执行完就结束的任务交出去。
- Worker 更像一条长期存在的工作线程。适合维护自己的运行上下文,通过消息持续接收任务、返回结果。
这两个模型不是“谁替代谁”,而是解决的问题不完全一样。
如果一开始就带着这个判断去写代码,后面的结构会清楚很多。
三、我先故意保留一版“主线程直接算”,作为对照组
为了看清优化到底有没有效果,我没有直接把旧代码删掉,而是保留了一版主线程执行逻辑。
它做的事情非常朴素:遍历数据、计算、组装结果,然后一次性更新状态。
async runOnUIThread() {
  const start = Date.now()
  const output: TaskResult[] = []

  for (const item of this.items) {
    const result = heavyCompute(item)
    output.push(result)
  }

  this.results = output
  this.uiCost = Date.now() - start
}
如果只看代码,这段写法甚至挺顺眼:逻辑集中,没有跨线程通信,也不需要额外的数据结构。
问题就在于,heavyCompute() 真正变重以后,这个“顺眼”是拿 UI 响应换来的。
我后来专门在循环里加了一些更接近真实项目的计算,比如字符串处理、结构转换、哈希计算和小规模数组聚合。很快就能看到一个非常明显的现象:任务耗时并不需要达到几秒,几百毫秒就足够让交互产生卡顿感。
这一步对我很重要。
因为以前谈性能优化时,很容易陷入“是不是一定要特别重的任务才值得优化”。实际并不是。UI 线程对连续占用非常敏感,几十毫秒、上百毫秒的同步工作叠起来,就可能让用户感受到不流畅。
所以后面的优化,我不再只看“总耗时”,还会同时看:
- 页面能不能继续点;
- 滚动是否稳定;
- 结果回来时有没有一次性大刷新;
- 日志里任务和 UI 更新是不是被清楚分开。
四、TaskPool 真正好用的地方,是让我开始按“任务”思考代码
TaskPool 我一开始最喜欢的一点,是它对现有业务结构的侵入相对小。
只要一段逻辑可以整理成明确输入和明确输出,就很适合先尝试任务化。
比如这次批量图片元数据处理,我把核心计算抽成了一个独立方法:
@Concurrent
function imageBatchTask(items: ImageMeta[]): TaskResult[] {
  const result: TaskResult[] = []
  for (const item of items) {
    result.push({
      id: item.id,
      score: calculateScore(item),
      summary: buildSummary(item)
    })
  }
  return result
}
页面层不再亲自循环,而是只负责创建任务、等待结果、更新状态:
async runTaskPool() {
  const start = Date.now()

  const task = new taskpool.Task(imageBatchTask, this.items)
  const data = await taskpool.execute(task) as TaskResult[]

  this.taskPoolCost = Date.now() - start
  this.results = data
}
这两段代码真正改变我的,不是“多线程终于跑起来了”,而是代码边界开始明显了。
以前一个页面方法里既有数据读取,也有计算,也有状态修改。改成 TaskPool 以后,我被迫把它拆成两部分:
- 工作任务只负责计算;
- 页面只负责调度和消费结果。
这个拆分非常值钱。
因为一旦任务可以被单独描述,它就更容易测试、更容易替换,也更容易判断到底该不该被放到并发环境里。
五、TaskPool 并不是“把任何代码扔进去就完了”
真正开始迁移以后,我也碰到了几个很典型的问题。
第一个问题是任务参数不能继续抱着页面对象不放。
原来在组件内部写逻辑时,随手访问 this.items、this.config、this.xxx 很自然。但并发任务不应该依赖一大坨页面上下文。更稳的做法是把真正需要的数据整理成纯输入,明确传进去。
第二个问题是任务内部不要直接改 UI 状态。
并发任务的输出应该是数据,而不是“顺便把页面上的几个 @State 改了”。页面状态仍然应该在结果回来后,由 UI 侧统一更新。
第三个问题是任务拆得太碎也会有成本。
如果一条很轻的计算也单独创建一个任务,调度、序列化和结果回传本身也会占时间。后来我更倾向于按批次处理,比如 100 条数据分成几个合理批次,而不是 100 条数据创建 100 个极细任务。
所以 TaskPool 真正的使用体验,不是“越多任务越并发”,而是:找到适合调度的任务粒度。
这也是我这次学习里特别想记下来的一个点。
六、Worker 给我的感觉完全不同:它更像一个有生命周期的后台伙伴
TaskPool 跑顺以后,我又用同一批数据做了一版 Worker。
它的思路和 TaskPool 很不一样。
Worker 不是每次都“创建一个任务等结果”,而是先准备一条独立线程,页面通过消息把任务发过去,Worker 处理完再把消息发回来。
页面这一侧大致是这样:
private dataWorker?: worker.ThreadWorker

startWorker() {
  if (!this.dataWorker) {
    this.dataWorker = new worker.ThreadWorker(
      'entry/ets/workers/DataWorker.ets'
    )

    this.dataWorker.onmessage = (event) => {
      const data = event.data as WorkerResult
      this.workerCost = data.cost
      this.results = data.result
    }
  }

  this.dataWorker.postMessage({
    type: 'ANALYZE',
    data: this.items
  })
}
Worker 侧则长期等待消息:
import worker from '@ohos.worker'

const workerPort = worker.workerPort

workerPort.onmessage = (event) => {
  const start = Date.now()
  const request = event.data as WorkerRequest

  if (request.type === 'ANALYZE') {
    const result = processItems(request.data)
    workerPort.postMessage({
      cost: Date.now() - start,
      result
    })
  }
}
写完这版以后,我对 Worker 的定位就非常直观了:它不是“另一个 TaskPool”,而是真的像一个常驻工作单元。
如果一个功能会持续收到多次任务,需要保存自己的线程内状态,或者希望业务和它长期通过消息交互,Worker 的结构会更自然。
反过来,如果只是“这批数据算一次,算完给我结果”,专门维护 Worker 的生命周期就未必划算。
七、真正联调时,我盯的不是线程数,而是 UI 有没有被放出来
并发优化最容易掉进一个误区:只看后台任务跑得快不快。
但这次我真正关心的是另一件事:任务出去以后,UI 线程是不是重新获得了响应空间。
所以我在 DevEco Studio 里同时看代码、模拟器和日志,把三种执行路径放在一起测。
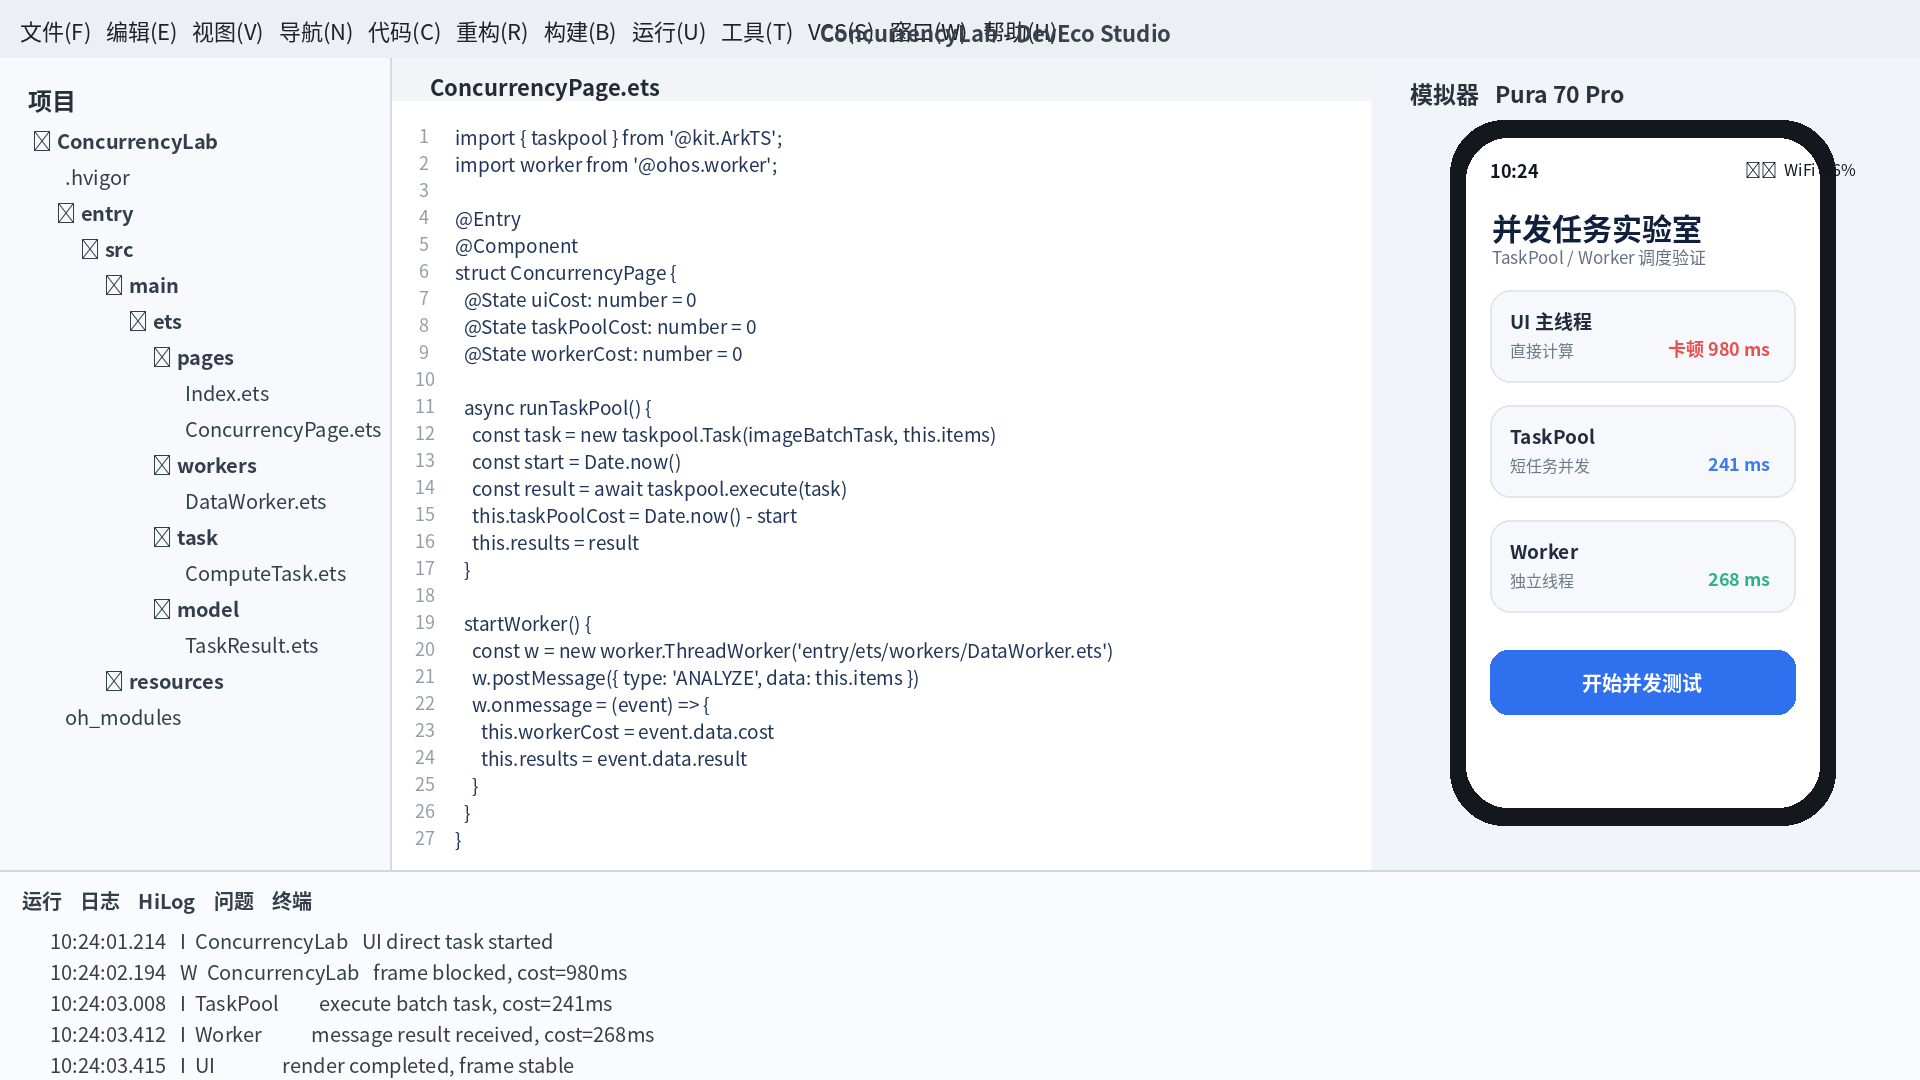
这一版调试里,我会刻意做几件事:
- 任务执行时不断滚动列表;
- 连续点击页面上的普通按钮;
- 观察日志里任务开始与结束时间;
- 观察结果回来的时候有没有一次性触发过重渲染。
如果主线程版本一执行,页面就明显迟钝,而 TaskPool / Worker 执行时页面仍然可以自然交互,那么这个优化才真正有意义。
这时候“总耗时”反而不是唯一指标。
例如 TaskPool 可能用了 241 ms,Worker 可能用了 268 ms,两者差几十毫秒并不代表前者就一定更适合。真正要结合的是:
- 任务是否一次性;
- 是否需要持续通信;
- 是否需要线程内状态;
- 创建和销毁频率如何;
- 页面是否能稳定消费结果。
八、我把三种执行方式放到同一个实验页以后,区别一下就看出来了
为了让这次学习不是只停留在日志里,我最后专门做了一个并发实验页。
页面顶部可以在 UI 主线程、TaskPool 和 Worker 三种模式之间切换,中间放同样的三类任务,下面显示运行耗时、结果条数和 UI 响应状态。
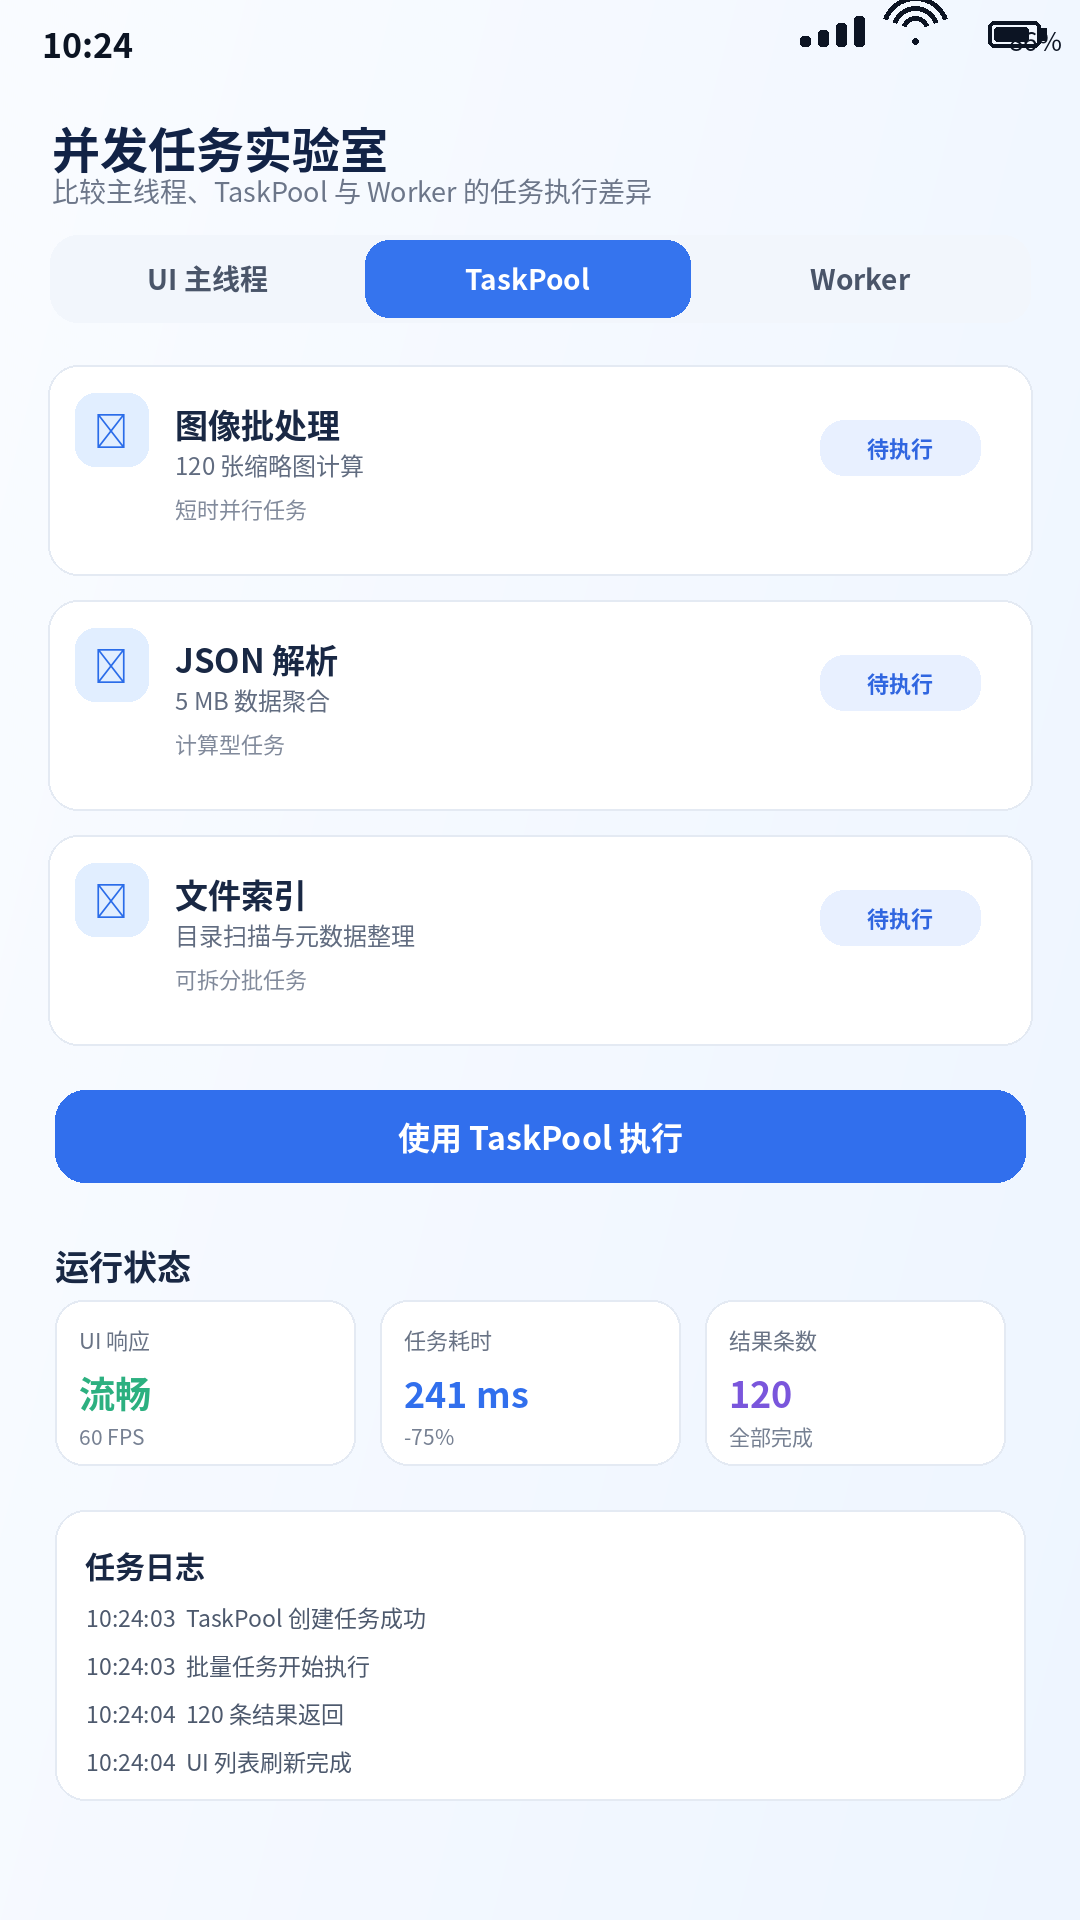
这个页面对我帮助很大,因为以前很多“并发模型的差异”只是脑子里的概念。
当三种方式跑同样一批任务时,区别就非常直观:
- UI 主线程执行时,任务代码最简单,但页面最容易受影响;
- TaskPool 很适合把一次性的计算任务挪出去;
- Worker 更适合建立长期通信关系。
而且把日志放在页面上还有一个好处:每一步都可以被验证。
例如:
- TaskPool 任务创建成功;
- 批量任务开始执行;
- 120 条结果返回;
- UI 列表刷新完成。
这样“并发执行”就不再是一个黑盒。
九、性能对比里,我最终没有只看“谁更快”
我最后又做了一页性能对比,把同一批任务在三种模式下的结果放在一起。
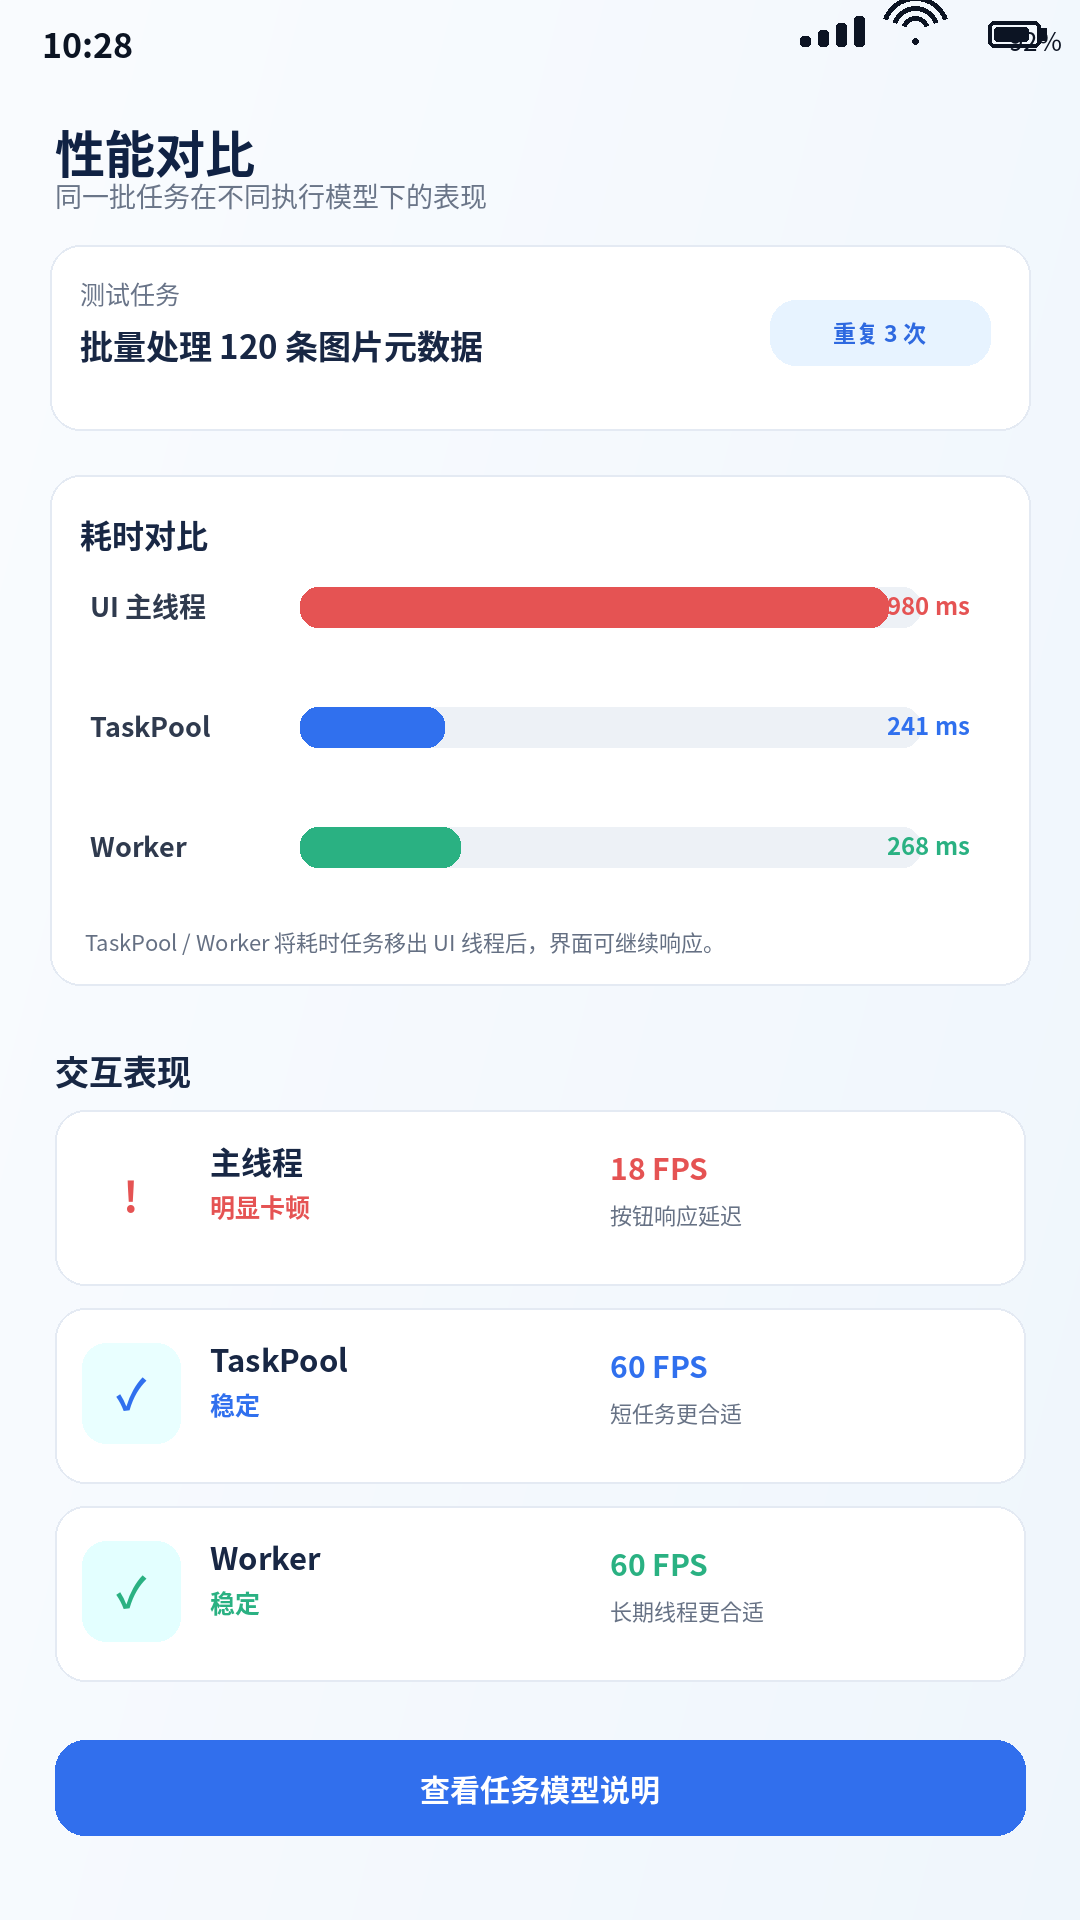
这个页面里,我故意没有做“TaskPool 胜出”或者“Worker 胜出”这种结论。
因为实际工程里,这种结论没有太大意义。
比如这一轮测试里:
- 主线程直接计算耗时接近 1 秒;
- TaskPool 约两百多毫秒;
- Worker 也是两百多毫秒。
真正明显的变化不是后两者差多少,而是UI 从明显卡顿恢复到了稳定响应。
再往下看,TaskPool 和 Worker 的选择其实更偏架构:
适合 TaskPool 的情况
任务边界清楚,一次执行结束,输入和输出都比较独立。例如批量数据处理、图片计算、一次性解析、可拆分的计算型任务。
适合 Worker 的情况
线程需要长期存在,页面会持续给它发消息,或者线程自己需要维护一份上下文。例如长期数据分析、持续协议解析、反复处理同一类消息。
这也是我觉得这次实验最有价值的地方:并发模型选型从“哪个 API 更强”变成了“哪个生命周期更匹配”。
十、结果回到 UI 以后,优化还没有结束
任务成功搬到并发环境以后,我又碰到一个很现实的问题:结果一次性回来太多,页面照样可能卡。
比如后台一次处理完几百条数据,然后 UI 侧立刻替换一个很大的数组,接着触发复杂列表重新构建。前面的计算虽然没有堵 UI,但最后这次大更新仍然可能产生明显压力。
所以我后来又补了两个小原则。
第一个是结果尽量结构化。后台不要把页面根本用不到的数据全部传回来,只返回 UI 真正需要的字段。
第二个是更新尽量可控。如果结果很多,可以考虑分批进入页面状态,或者尽量复用已有数据结构,避免一次大范围重建。
这个过程让我意识到,所谓“把耗时任务移出主线程”只完成了一半工作。
真正完整的性能链应该是:
主线程发现重任务 → 选择合适并发模型 → 后台处理 → 控制结果传输 → UI 轻量更新 → 释放任务或线程资源。
每一步都做得合理,最终才会得到稳定体验。
十一、这次学习里,我最后真正记住的是“线程只是手段,任务边界才是核心”
回头看这次练习,我觉得 TaskPool 和 Worker 最值得学的,并不是 API 数量。
真正改变我写代码方式的是:我会先判断一段逻辑到底属于页面,还是属于任务。
如果它是纯计算、输入输出明确,就尽量从组件里抽出来;如果它需要长期独立工作,就进一步考虑 Worker;如果只是正常异步 I/O,就不为了“用了线程”而硬套并发模型。
当这种边界建立以后,页面代码反而会变得轻很多。
它只需要做几件事:
- 发起任务;
- 显示状态;
- 接收结果;
- 更新界面。
至于真正的重活,交给更合适的执行环境。
十二、本文小记
如果用一句话总结这次学习,我会写成:TaskPool 和 Worker 解决的不是“代码怎么跑得更快”,而是“什么代码不该堵在 UI 线程上”。
这两个能力真正让我记住的几个判断是:
- 短时、一次性、可拆分任务,优先从 TaskPool 角度思考;
- 长期存在、需要持续消息通信的工作,更适合 Worker;
- 并发任务尽量使用清晰输入和输出,不要继续依赖页面对象;
- 后台计算结束以后,结果回传和 UI 更新同样需要控制成本;
- 性能优化不能只看任务耗时,还要看页面响应、渲染和用户操作是不是稳定。
后面如果继续往下做,我最想补两块:
- 一块是任务取消、超时和异常恢复,把并发任务从“能跑”做到“可控”;
- 一块是更完整的性能采样,把帧率、CPU、内存与任务耗时放在一起看,而不是只依赖日志里的一个时间差。
这一篇先把第一阶段的学习过程记到这里。至少到这一步,我已经不再把 TaskPool 和 Worker 当成两个并发 API,而是开始把它们放到一套更完整的任务模型里理解:页面负责交互,任务负责计算,线程负责隔离,结果再有节制地回到 UI。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 2
 0
- 0


 已为社区贡献58条内容

所有评论(0)