
ArkTS Runtime 的解释执行、AOT 编译与对象运行时模型【鸿蒙心迹】
同样一段 ArkTS 代码,第一次执行和跑了一段时间以后,成本为什么可能不一样?
做 ArkTS 性能优化的时候,最开始的思路很简单:代码写好了,跑起来就行。
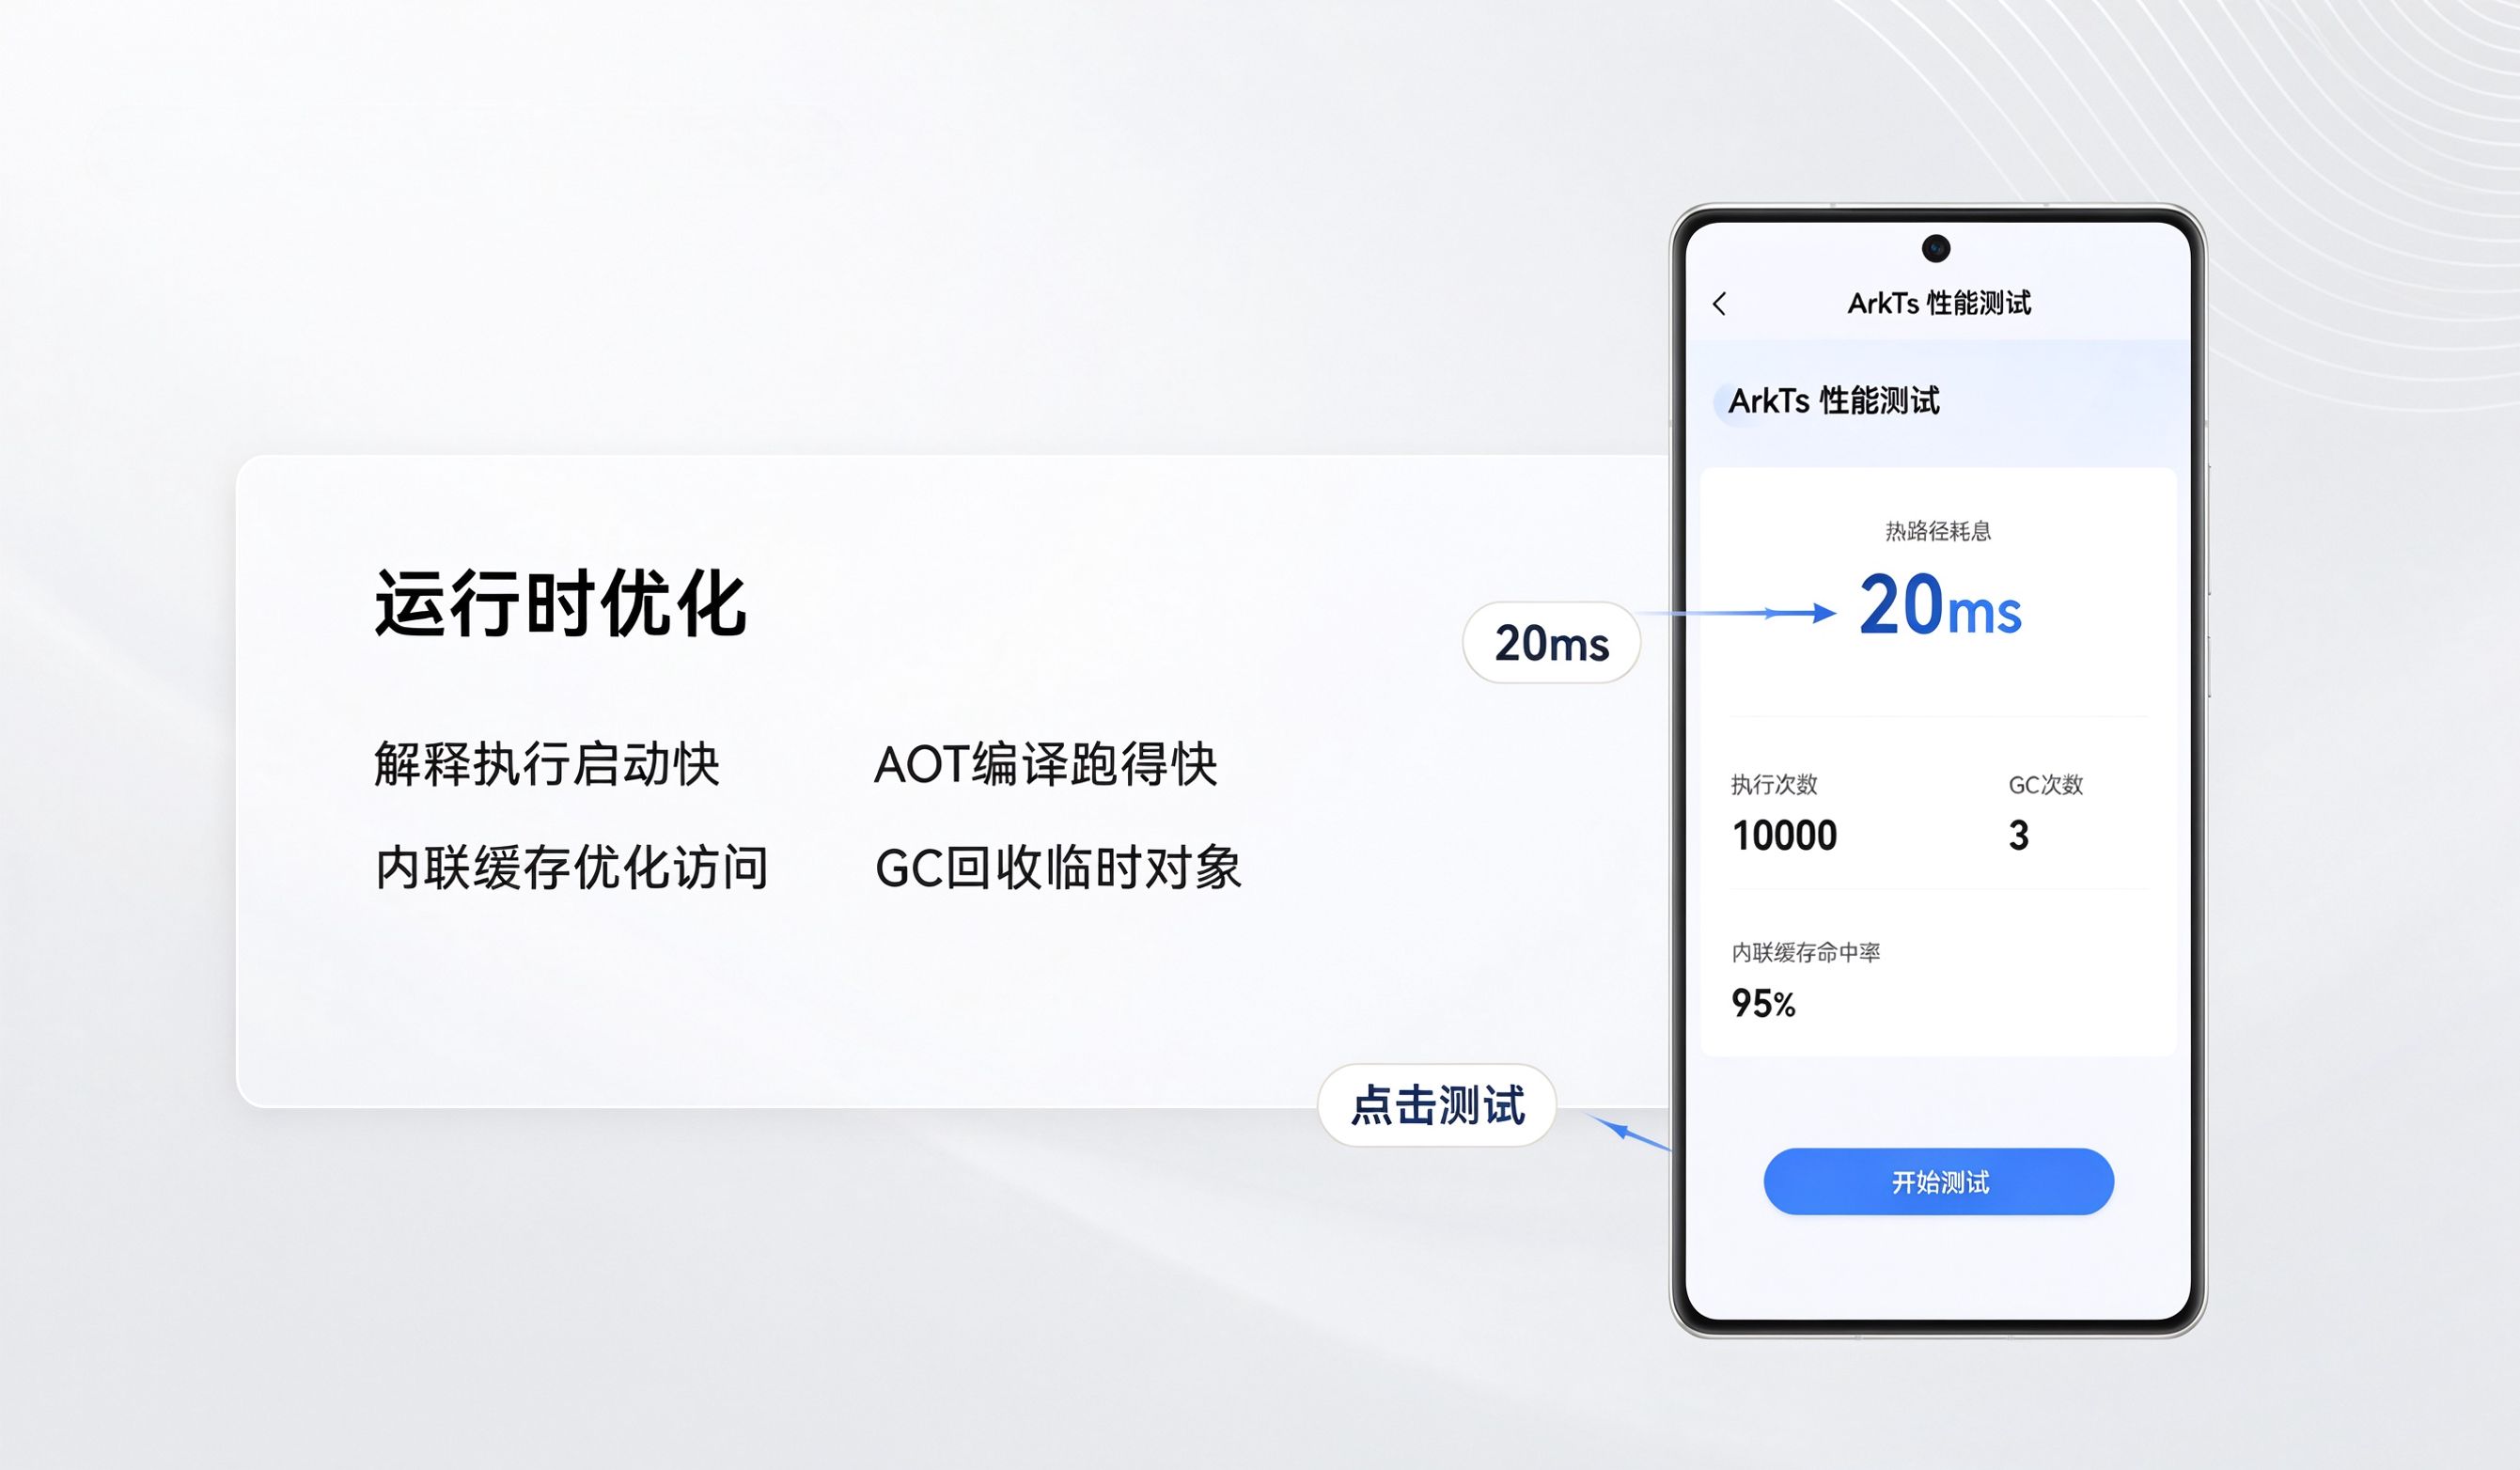
结果真做性能分析的时候发现不对:同一段代码,第一次跑要 100ms,跑了十次以后只要 20ms。为什么?
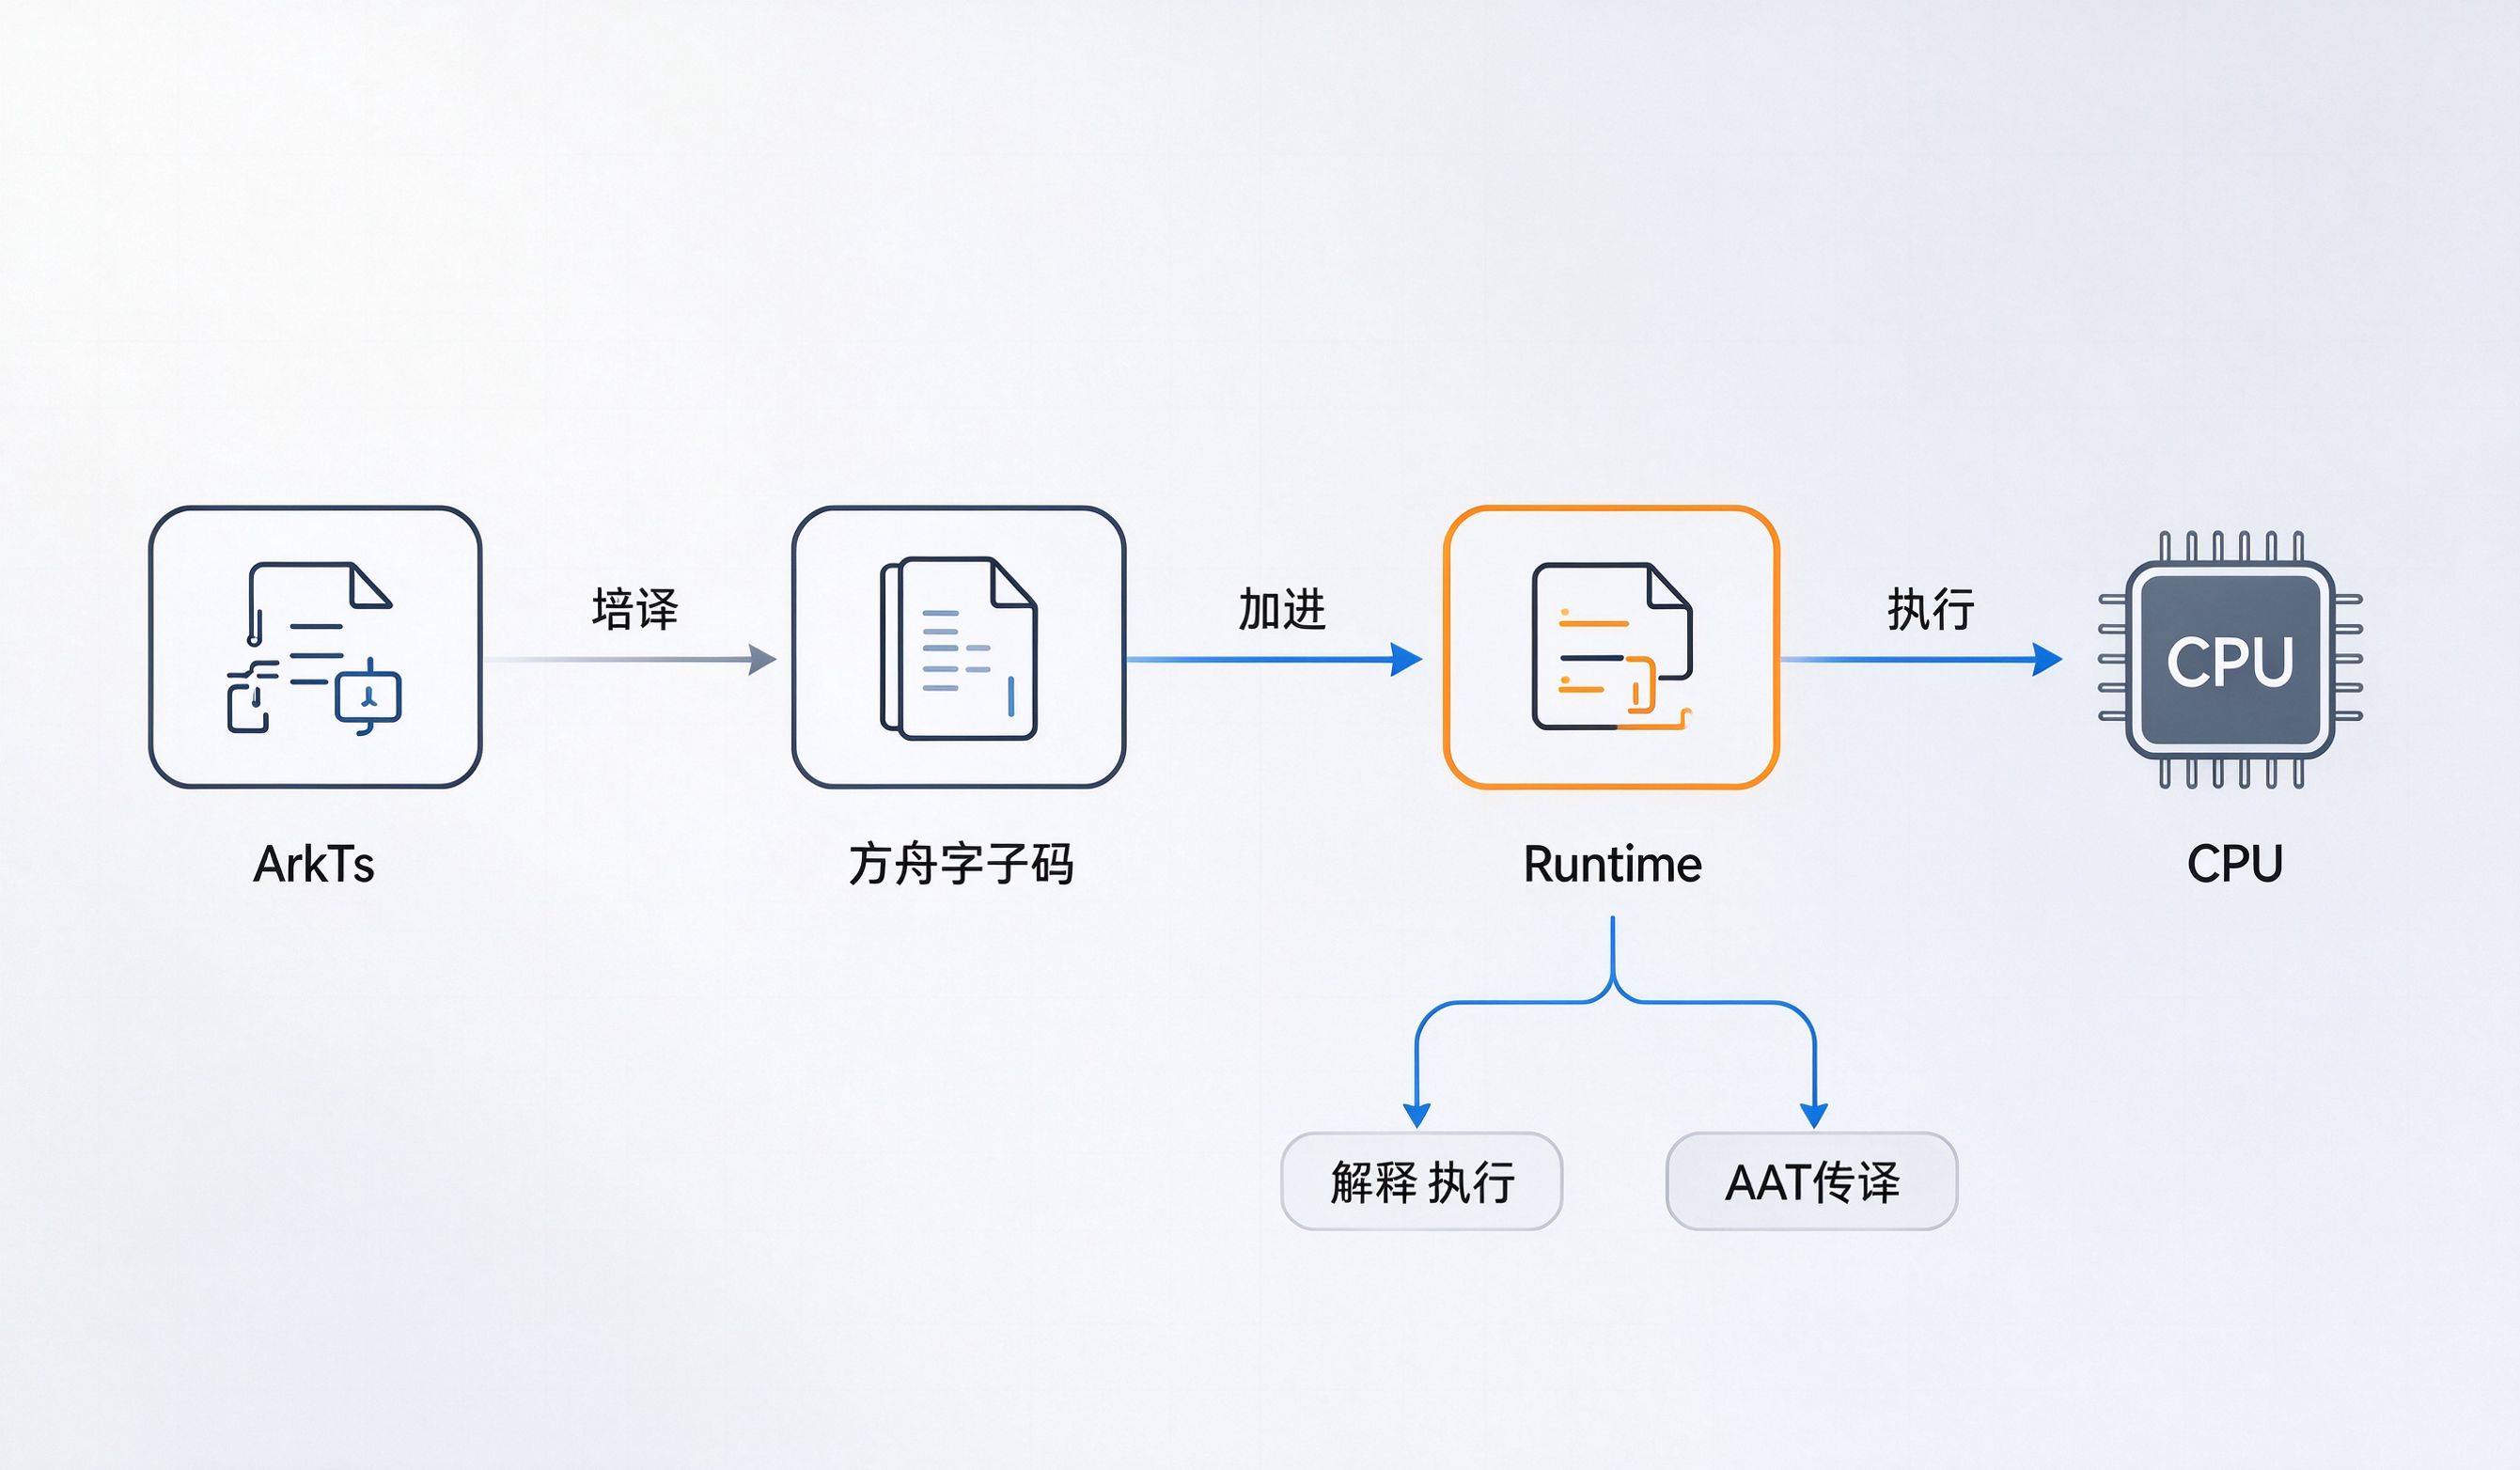
这时候才意识到:ArkTS 不是直接翻译成机器码跑的。它有一整套运行时,解释执行、AOT 编译、内联缓存,这些东西都在背后影响性能。
一、先写一行最简单的代码,看看它怎么跑
先写一行最简单的 ArkTS 代码:
let result = user.score + 1;
这一行代码,CPU 最终是怎么执行到的?
| 阶段 | 做什么 |
|---|---|
| ArkTS 源码 | 你写的代码 |
| 编译 | 编译成方舟字节码 |
| 解释执行 | 解释器逐条执行字节码 |
| AOT 编译 | 热路径编译成机器码 |
| 机器执行 | CPU 直接跑机器码 |
不是你写的代码直接在 CPU 上跑。中间经过了好几层。
二、解释器和 AOT 是什么关系
解释器:逐条读字节码,逐条执行。慢,但启动快。
AOT:提前把字节码编译成机器码。快,但启动慢。
| 对比 | 解释执行 | AOT 编译 |
|---|---|---|
| 启动速度 | 快 | 慢 |
| 执行速度 | 慢 | 快 |
| 内存占用 | 小 | 大 |
为什么要有两种?因为启动的时候,你想快点进应用,用解释器。跑起来以后,热路径用 AOT 编译,跑得快。
三、内联缓存是什么
内联缓存(Inline Cache)是优化对象访问的。
比如你访问 user.score,第一次访问的时候,解释器要查 user 的结构,找到 score 在哪个位置。这个查找是有开销的。
内联缓存就是把查找结果存起来。下次再访问 user.score,直接用缓存的结果,不用再查了。
这段代码解决什么问题: 理解对象访问优化。
文件: runtime/ObjectAccess.ets
用途: ArkTS 运行时优化
接入位置: 热路径代码
// 热路径里反复访问同一个对象
function getScore(user: User): number {
  // 第一次访问 user.score 要查结构
  // 第二次开始,内联缓存直接命中
  return user.score + 1;
}
如果 user 的结构一直不变,内联缓存就一直有效。如果结构变了,缓存就失效,要重新查。
四、对象分配和 GC 是什么关系
每次 new 一个对象,运行时要分配内存。分配多了,内存满了,就要 GC(垃圾回收)。
GC 是有停顿的。GC 的时候,所有线程都要暂停,等 GC 跑完。
| 情况 | GC 压力 |
|---|---|
| 少量大对象 | 小 |
| 大量小对象 | 大 |
| 热路径里频繁创建临时对象 | 很大 |
热路径里频繁创建临时对象,GC 就频繁,性能就上不去。
五、几个容易踩的坑
第一个坑:把 ArkTS 理解成直接翻译为 Native 指令。不对,中间有运行时。
第二个坑:把 AOT 和 JIT 当成互斥方案。不是,它们可以配合。
第三个坑:只看一段代码执行耗时就判断语言性能。要考虑运行时优化的影响。
第四个坑:热路径里不断改变对象结构导致优化条件变差。结构变了,内联缓存就失效。
第五个坑:频繁创建临时对象增加 GC 压力。热路径里别随便 new。
第六个坑:把 GC 停顿和普通函数执行慢混为一谈。一个是 GC 的问题,一个是代码的问题。
这次做 ArkTS 性能分析最大的体会是:ArkTS 不是直接跑的,背后有一整套运行时。解释器、AOT、内联缓存、GC,这些都在影响性能。
真正做的时候,最容易忽略的不是代码本身,而是运行时的行为。你以为代码写得没问题,但运行时在背后做了很多事,这些事才是性能的关键。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)