
DevEco Studio TSan:数据竞争、线程时序与锁错误定位【鸿蒙心迹】
两个线程各跑一万次都正常,线上偶尔却把计数器算错了。
做 Native 层业务的时候,最容易出问题的就是并发。
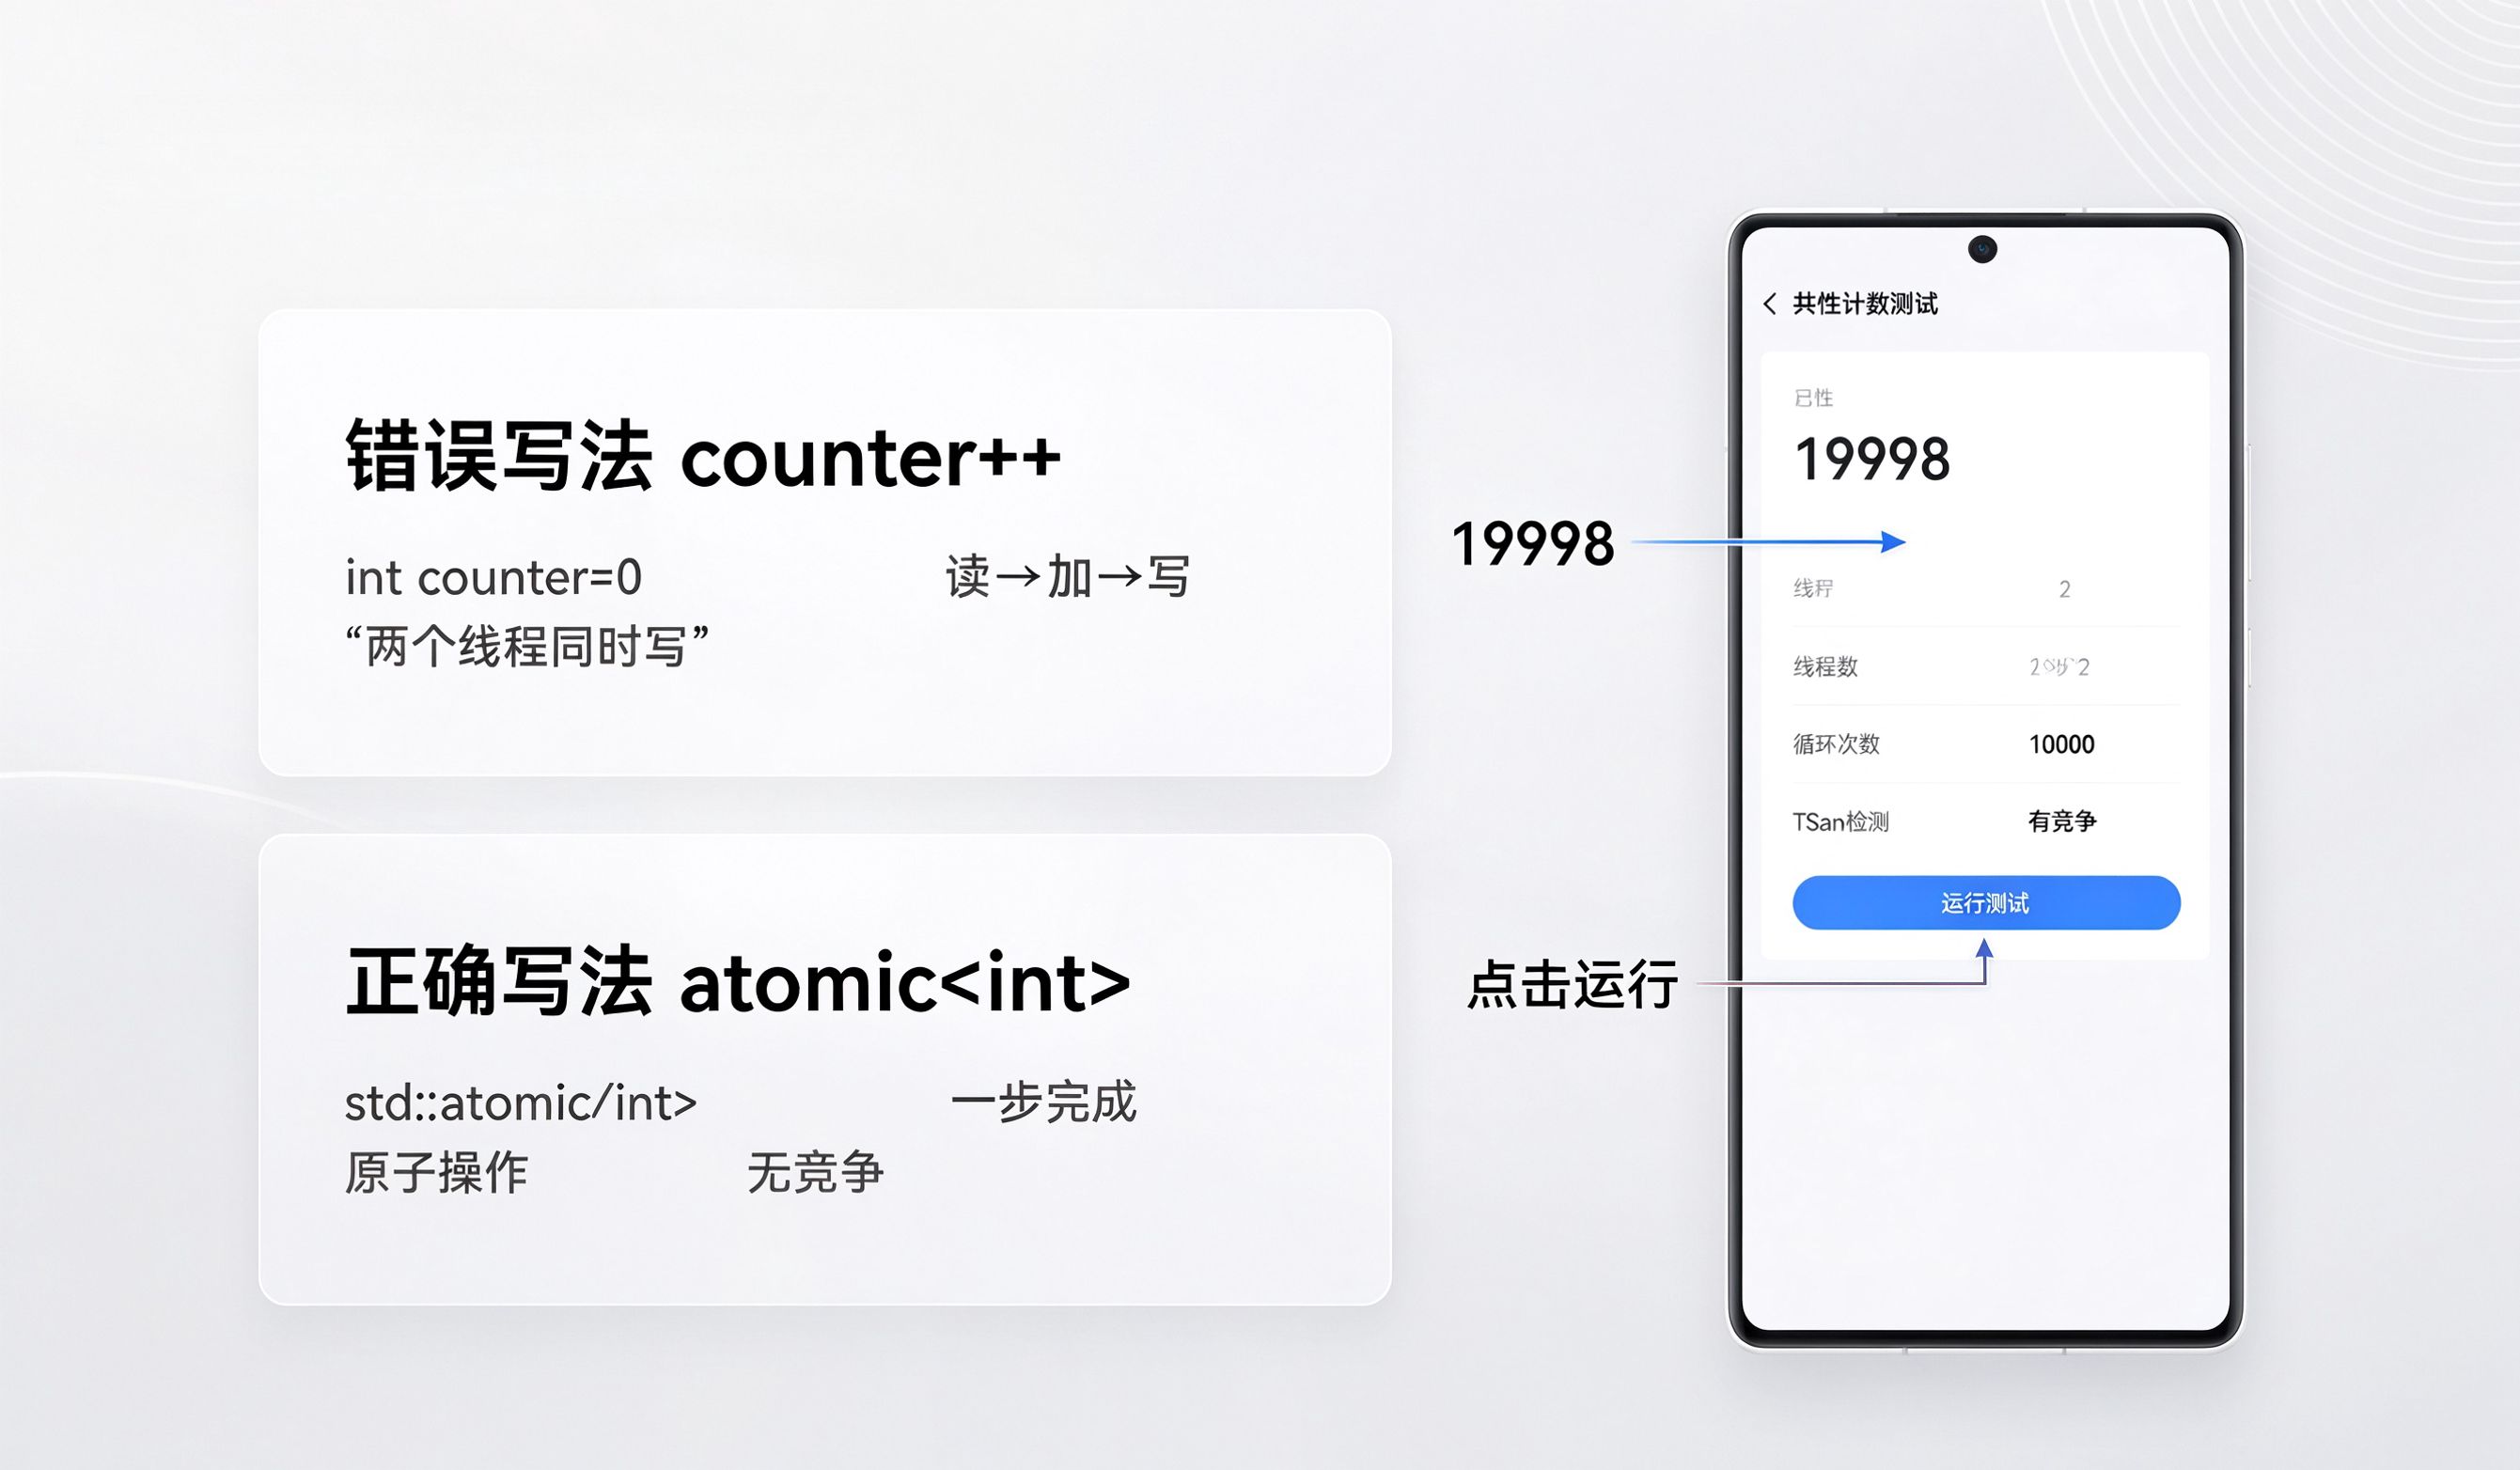
最开始写了个双线程计数:两个线程各加一万次,理论结果应该是 20000。本地跑了十次,每次都是 20000。结果上线之后,偶尔就出 19998、19999。复现都复现不出来。
这就是典型的数据竞争问题。看起来代码没问题,因为大多数时候两个线程刚好错开了。偶尔两个线程同时写同一块内存,就把结果算错了。
一、先看这段"完全没问题"的代码
先把问题代码放出来:
int counter = 0;

void worker() {
  for (int i = 0; i < 10000; i++) {
    counter++;
  }
}

int main() {
  std::thread t1(worker);
  std::thread t2(worker);
  t1.join();
  t2.join();
  printf("result: %d\n", counter);
}
这段代码看起来完全没问题吧?两个线程,各加一万次,最后结果应该是 20000。
但实际上,counter++ 不是一条指令。它是三步:读 counter → 加一 → 写回 counter。
两个线程同时跑的时候,可能发生这样的情况:
| 时刻 | 线程1 | 线程2 | counter |
|---|---|---|---|
| t1 | 读 counter=100 | 100 | |
| t2 | 读 counter=100 | 100 | |
| t3 | 写回 counter=101 | 101 | |
| t4 | 写回 counter=101 | 101 |
结果就是:两个线程都加了一次,counter 只加了一。这就是数据竞争。
二、为什么 volatile 不行
很多人第一反应:加 volatile 不就行了?
不对。volatile 只能保证每次读都从内存读,不保证 counter++ 是原子操作。
volatile 的问题是:它不保证多步操作的原子性。counter++ 还是三步,两个线程还是可能同时读、同时写。
三、加锁为什么也容易错
那加锁呢?
std::mutex mtx;
int counter = 0;

void worker() {
  for (int i = 0; i < 10000; i++) {
    mtx.lock();
    counter++;
    mtx.unlock();
  }
}
这样确实不会错了。但很多人加锁加错地方:
| 错误 | 问题 |
|---|---|
| 只给写加锁,读不加 | 读的时候可能读到中间值 |
| 不同路径用不同 Mutex | 等于没加锁 |
| 锁住了对象,但对象已经析构了 | 野指针 |
四、TSan 到底是怎么工作的
TSan 是 ThreadSanitizer 的缩写。它不是帮你修 bug 的,是帮你找 bug 的。
它的工作方式分两步:
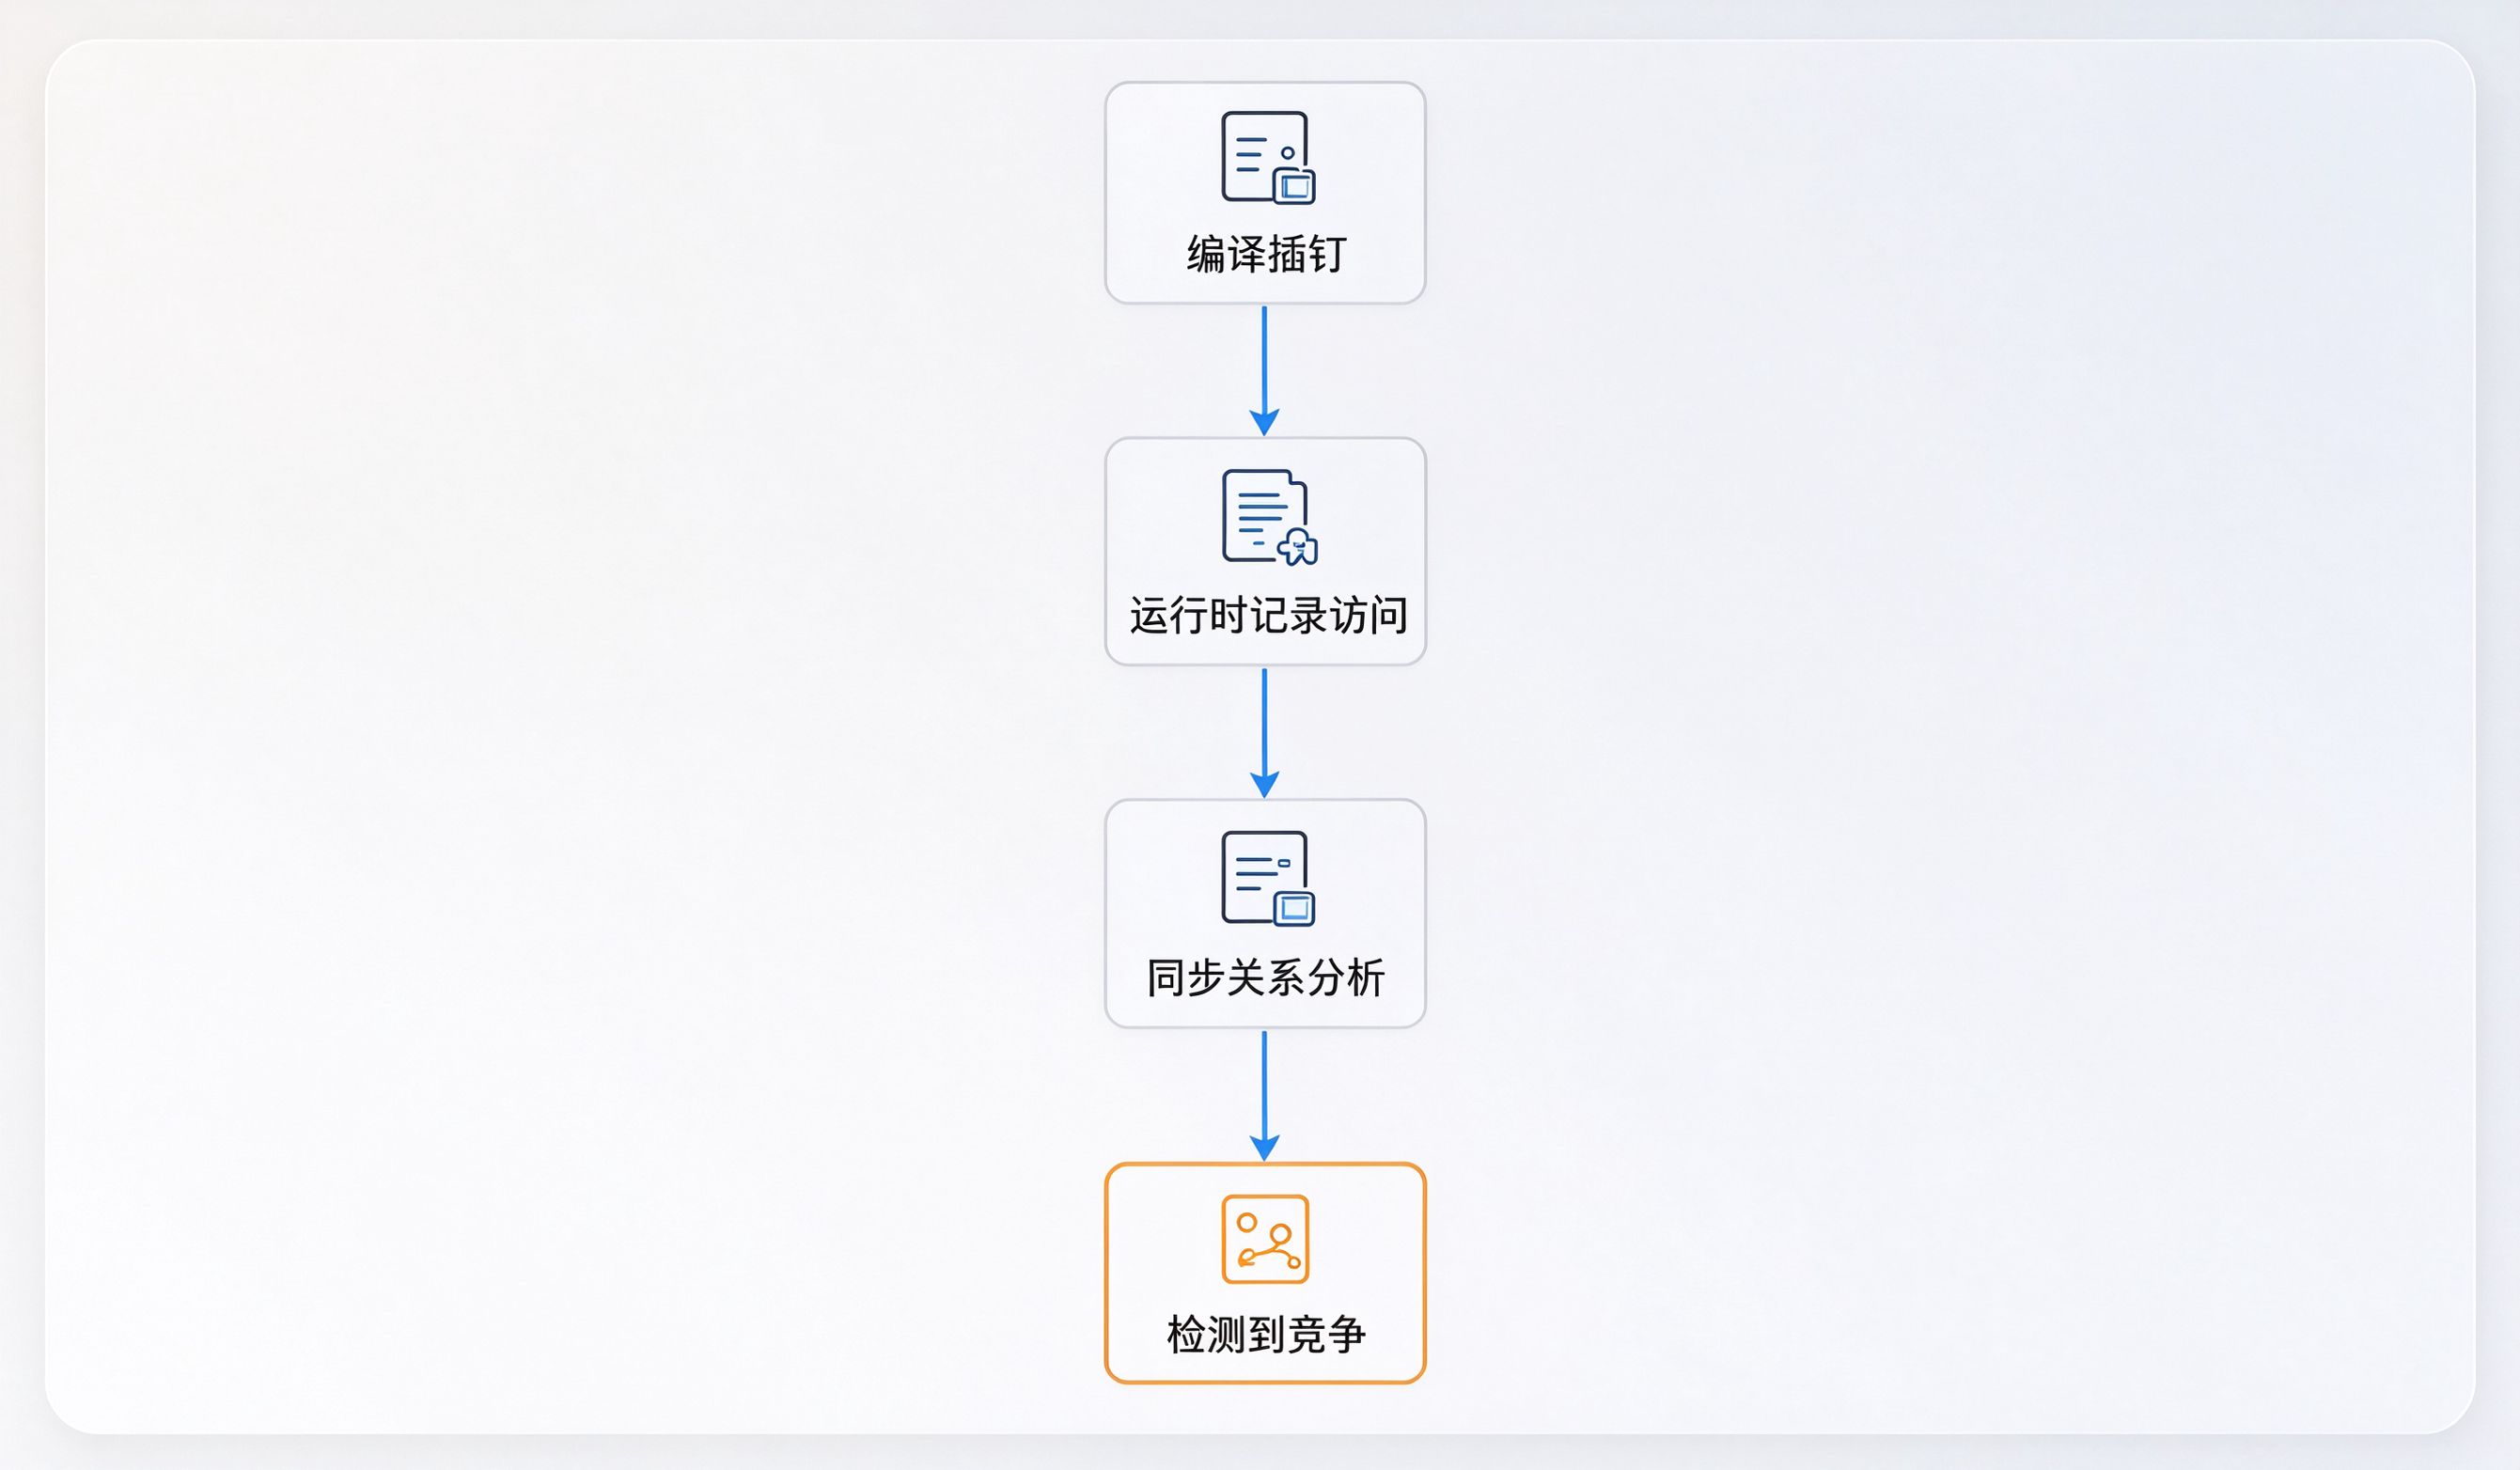
- 编译插桩:编译的时候,给每一处内存访问都加上插桩代码;
- 运行时检测:运行的时候,记录每个线程的内存访问和同步关系,发现竞争就报错。
| 阶段 | 做什么 |
|---|---|
| 编译插桩 | 给内存访问加钩子 |
| 运行时 | 记录访问时序,检测竞争 |
这段代码解决什么问题: 用原子操作解决数据竞争。
文件: src/counter.cpp
用途: 线程安全计数器
接入位置: Native 并发计数
#include <atomic>

std::atomic<int> counter{0};

void worker() {
  for (int i = 0; i < 10000; i++) {
    counter++;  // 原子操作,不会竞争
  }
}
用 atomic 就不用加锁了,counter++ 是一条原子指令,不会出现中间状态。
五、TSan 能检测出什么
TSan 不只是检测数据竞争。它还能检测很多锁相关的错误:
| 问题类型 | 说明 |
|---|---|
| Data Race | 数据竞争 |
| Double Unlock | 重复解锁 |
| 死锁 | 两个线程互相等对方的锁 |
| 条件变量错误 | 用错条件变量 |
六、性能开销有多大
TSan 因为要记录所有内存访问,所以开销很大。
| 指标 | 开销 |
|---|---|
| 性能 | 慢 5~15 倍 |
| 内存 | 多占 5~10 倍 |
所以 TSan 不能在正式环境用,只能在测试环境用。
七、几个容易踩的坑
第一个坑:把"偶尔结果不对"当普通逻辑 bug。这是典型的数据竞争。
第二个坑:认为加了 volatile 就解决线程安全。volatile 不保证原子性。
第三个坑:只给写操作加锁,读操作不加。读的时候可能读到中间值。
第四个坑:不同路径使用不同 Mutex。等于没加锁。
第五个坑:锁住对象但对象生命周期已经结束。野指针。
第六个坑:一开 TSan 就拿性能数据做基准。TSan 本身就慢 10 倍。
第七个坑:同时开启 ASan 和 TSan。官方明确说不能同时开。
八、怎么用 TSan 定位问题
用 TSan 定位问题的思路是:
- 打开 TSan 编译;
- 复现问题;
- 看 TSan 报告,找到竞争的两个线程;
- 找到两个线程同时访问的那块内存;
- 加锁或者改成原子操作。
TSan 报告会明确告诉你:哪个线程在哪个位置访问了哪块内存,另一个线程在哪个位置也访问了同一块内存,中间没有同步。
这次做并发 bug 定位最大的体会是:数据竞争是最难复现的 bug,因为大多数时候两个线程刚好错开了,只有偶尔同时访问才会出问题。靠肉眼看代码很难找出来。
TSan 的价值就是把这种偶现的、不确定的问题,变成一个确定性的、可复现的报告。你不用猜哪里有竞争,它直接告诉你。
真正做的时候,最容易忽略的不是加锁,而是:你以为加了锁就安全了,但其实不同路径用了不同的锁、读的时候没加锁、对象生命周期不对。这些才是真正的坑。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)