
HarmonyOS 7 OH_Archive 流式压缩的分块处理、CRC32 与内存边界【鸿蒙心迹】
压缩一个 2GB 日志文件,为什么不能先全部读进内存再压?
做日志归档的时候,最开始的思路很简单:把整个文件读进内存,调用压缩接口,把结果写出去。
结果跑了没几分钟,OOM 了。2GB 的文件,手机内存一共才多少?直接读进来,不炸才怪。
这时候才意识到:大文件处理,不能一次性全读进来。得流式处理,一块一块压。
一、先看暴力版为什么不行
先想清楚:暴力版哪里不对。
| 方案 | 内存占用 | 问题 |
|---|---|---|
| 一次性读入压缩 | 等于文件大小 | 大文件直接 OOM |
| 分块流式压缩 | 等于 chunk 大小 | 可控 |
2GB 的文件,一次性读进来,光明文就占 2GB。压缩过程中还要临时 Buffer,内存峰值直接爆了。
流式压缩就是:每次读一块,压一块,写一块。内存里永远只有一块数据,不管文件多大。
二、整个状态链是什么样
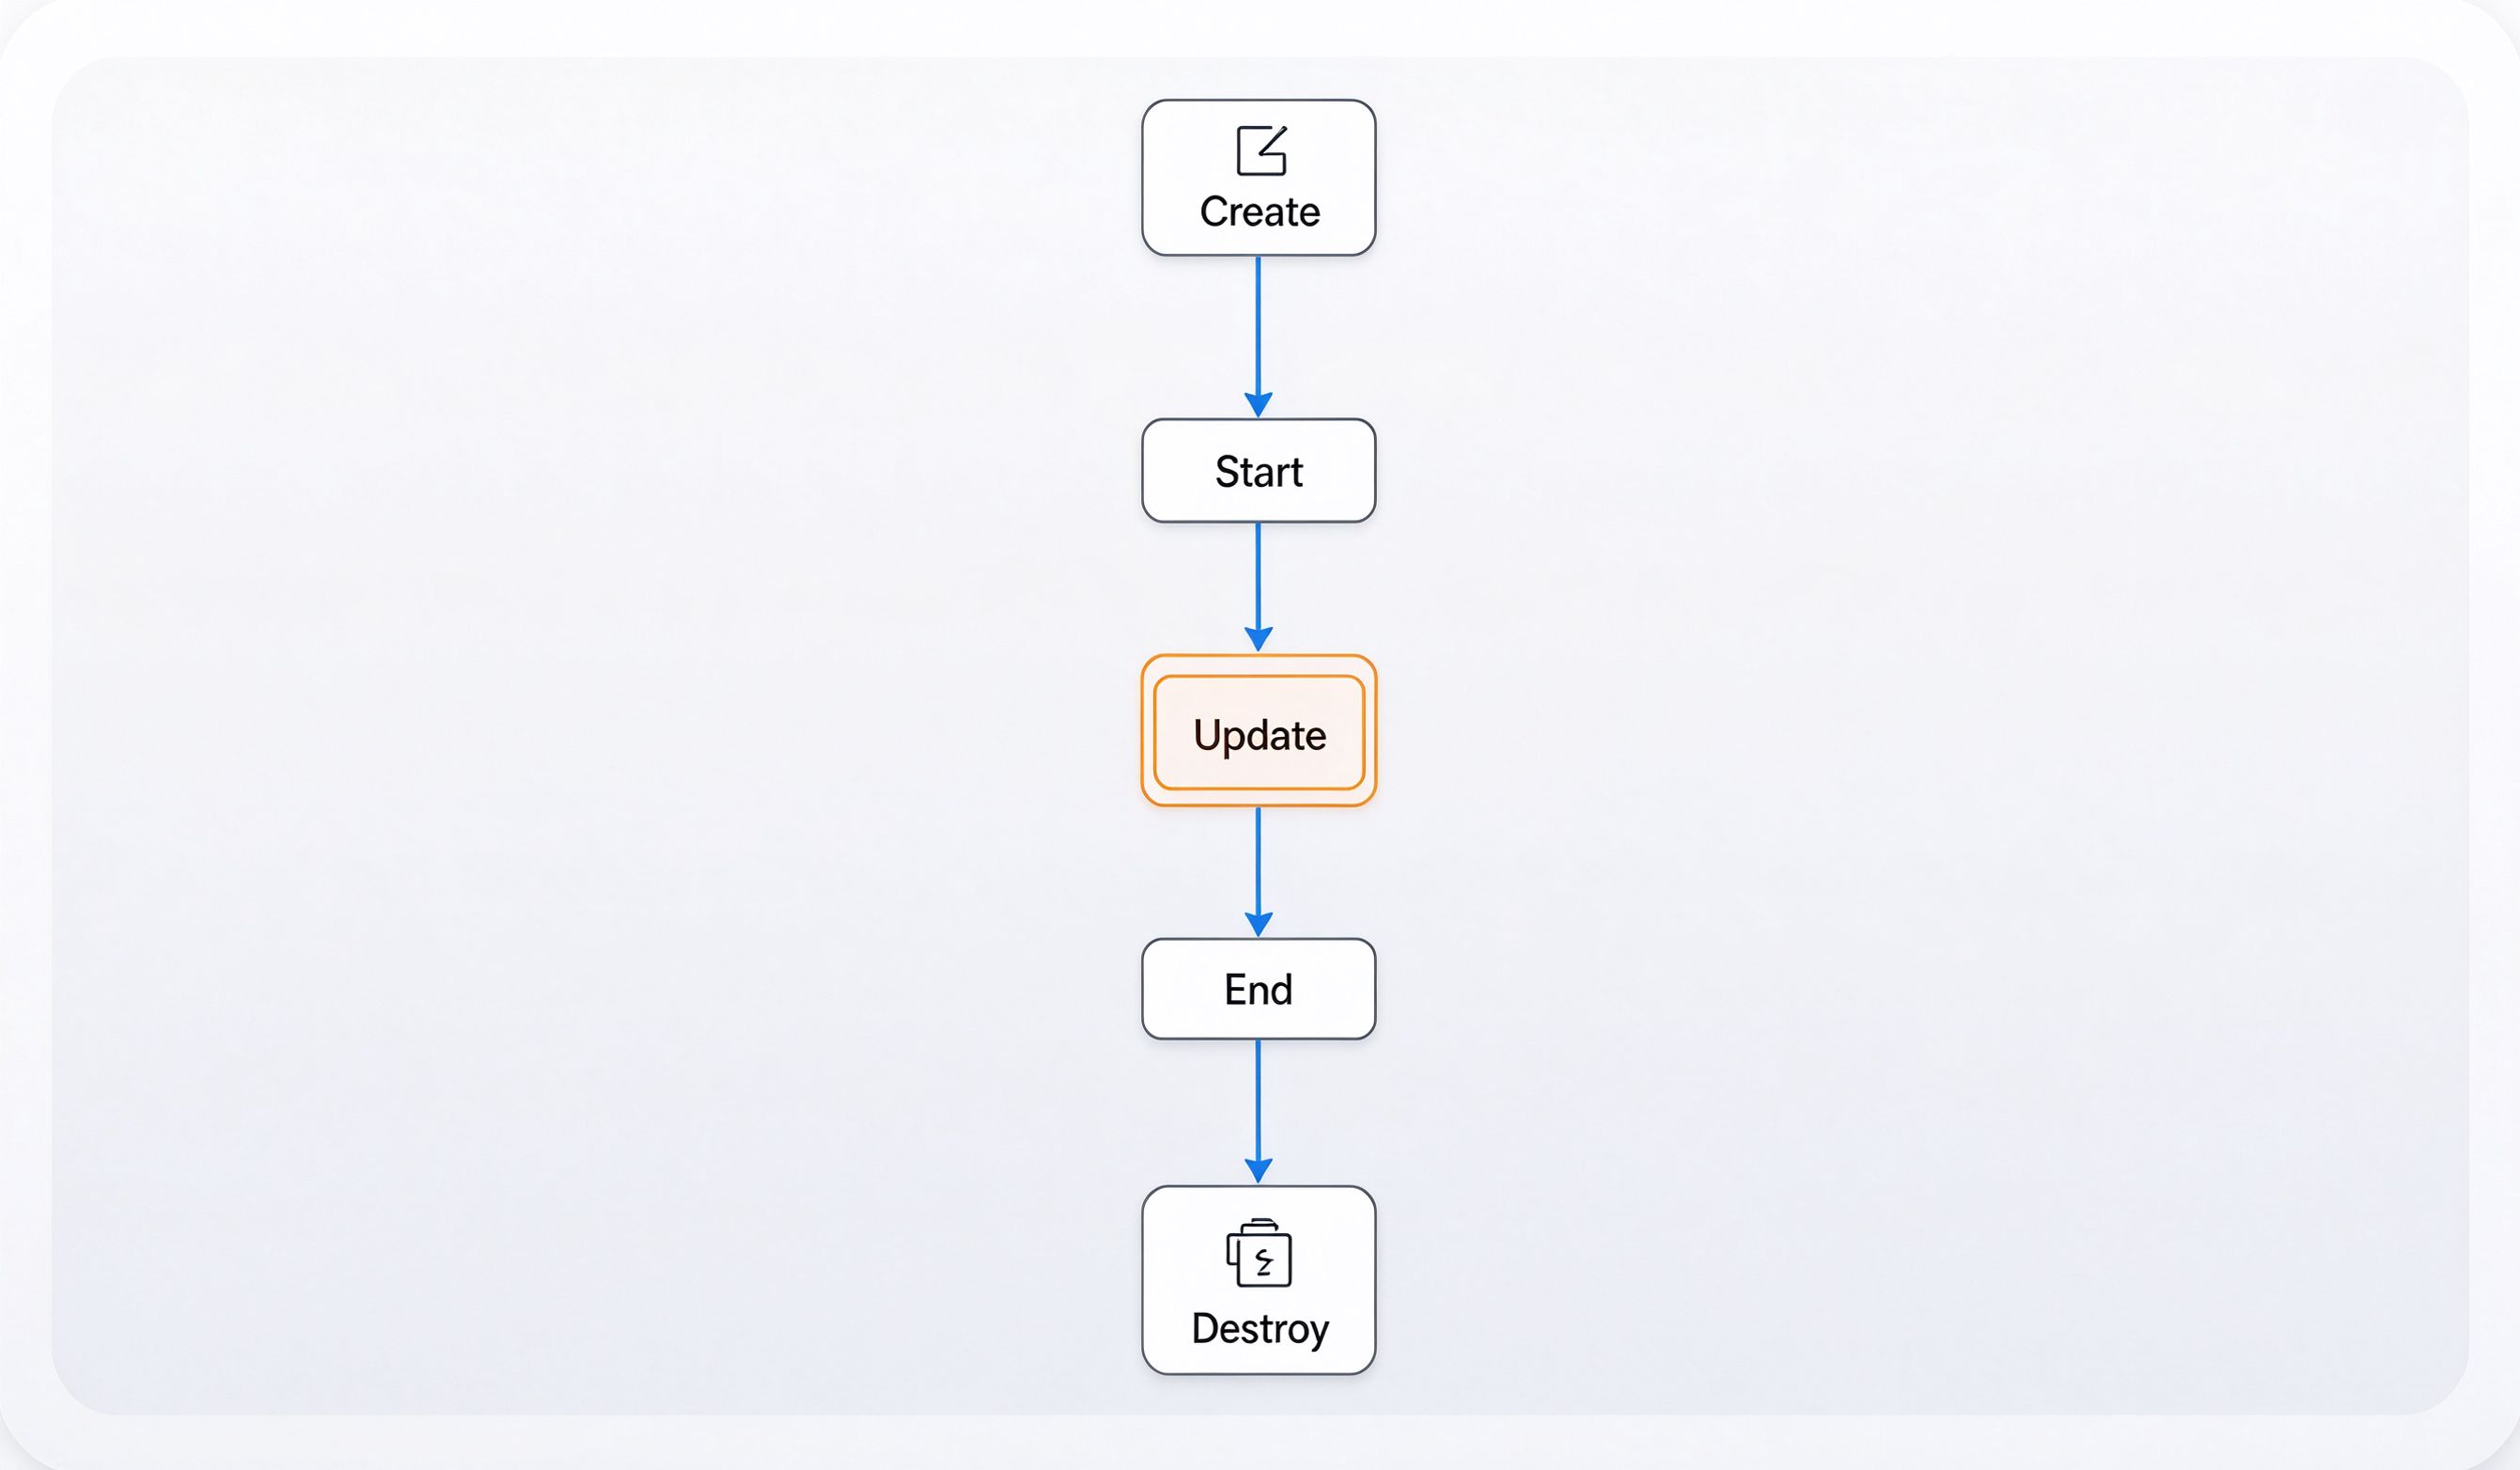
OH_Archive 的流式压缩,整个状态链是这样的:
Create → Start → Update → End → Destroy
每一步都有它的作用,不是随便调的。
这段代码解决什么问题: 流式压缩大文件。
文件: native/archive/stream_archive.cpp
用途: 大文件流式压缩
接入位置: 日志归档模块
// 1. 创建流式压缩器
OH_Archive* archive = OH_Archive_StreamWrite_Create(
  OH_ARCHIVE_FORMAT_ZIP,
  OH_ARCHIVE_COMPRESS_DEFLATE,
  OH_ARCHIVE_LEVEL_DEFAULT,
  output_handler,
  userData
);

// 2. 开始压缩
OH_Archive_Start(archive, "log.txt");

// 3. 分块更新
while (hasMoreData) {
  OH_Archive_Update(archive, chunkBuffer, chunkSize);
}

// 4. 结束压缩
OH_Archive_End(archive);

// 5. 销毁
OH_Archive_Destroy(archive);
三、每一步到底在干嘛
Create
创建一个压缩器实例。这个时候压缩器还没开始工作,就是个空对象。这里要指定压缩格式、压缩算法、压缩等级。
Start
开始压缩。告诉压缩器:我要开始压一个叫 log.txt 的文件了。压缩器初始化内部状态。
Update
往压缩器里喂数据。一次喂一块,比如 64KB、256KB、1MB。压缩器内部会压缩这块数据,然后通过 OutputHandler 把压缩结果输出出去。
这里最关键的是 OutputHandler:压缩结果不是你主动去拿的,是压缩器通过回调推给你的。你要及时消费,不然压缩器内部 Buffer 满了,就卡住了。
End
结束压缩。告诉压缩器:数据喂完了。压缩器把内部剩下的数据全部 flush 出来。
Destroy
销毁压缩器。释放所有资源。这个一定要调,不然内存泄漏。
四、分块大小怎么选
分块大小不是越小越好。
| 分块大小 | 内存占用 | 调用次数 | 性能 |
|---|---|---|---|
| 64KB | 低 | 多 | 调用开销大 |
| 256KB | 中 | 适中 | 平衡 |
| 1MB | 高 | 少 | 调用开销小 |
太小了,Update 调用次数太多,开销大。太大了,内存占用高。一般 256KB 到 1MB 之间比较合适。
五、CRC32 是干嘛的
压缩完了,怎么知道文件没坏?
CRC32 就是做完整性校验的。压缩过程中,压缩器会计算数据的 CRC32。解压的时候再算一遍,对不上就说明文件坏了。
六、几个容易踩的坑
第一个坑:大文件一次性读入 Buffer。直接 OOM。
第二个坑:把 chunk 切得过小。调用次数太多,性能反而差。
第三个坑:OutputHandler 消费不及时。压缩器内部 Buffer 满了,整个流程卡住。
第四个坑:只调用 End 不 Destroy。内存泄漏。
第五个坑:压缩等级一律设 9。等级越高压缩率越好,但越慢。不是所有场景都要最高等级。
第六个坑:忽略 CRC32。压缩完了不知道文件有没有坏。
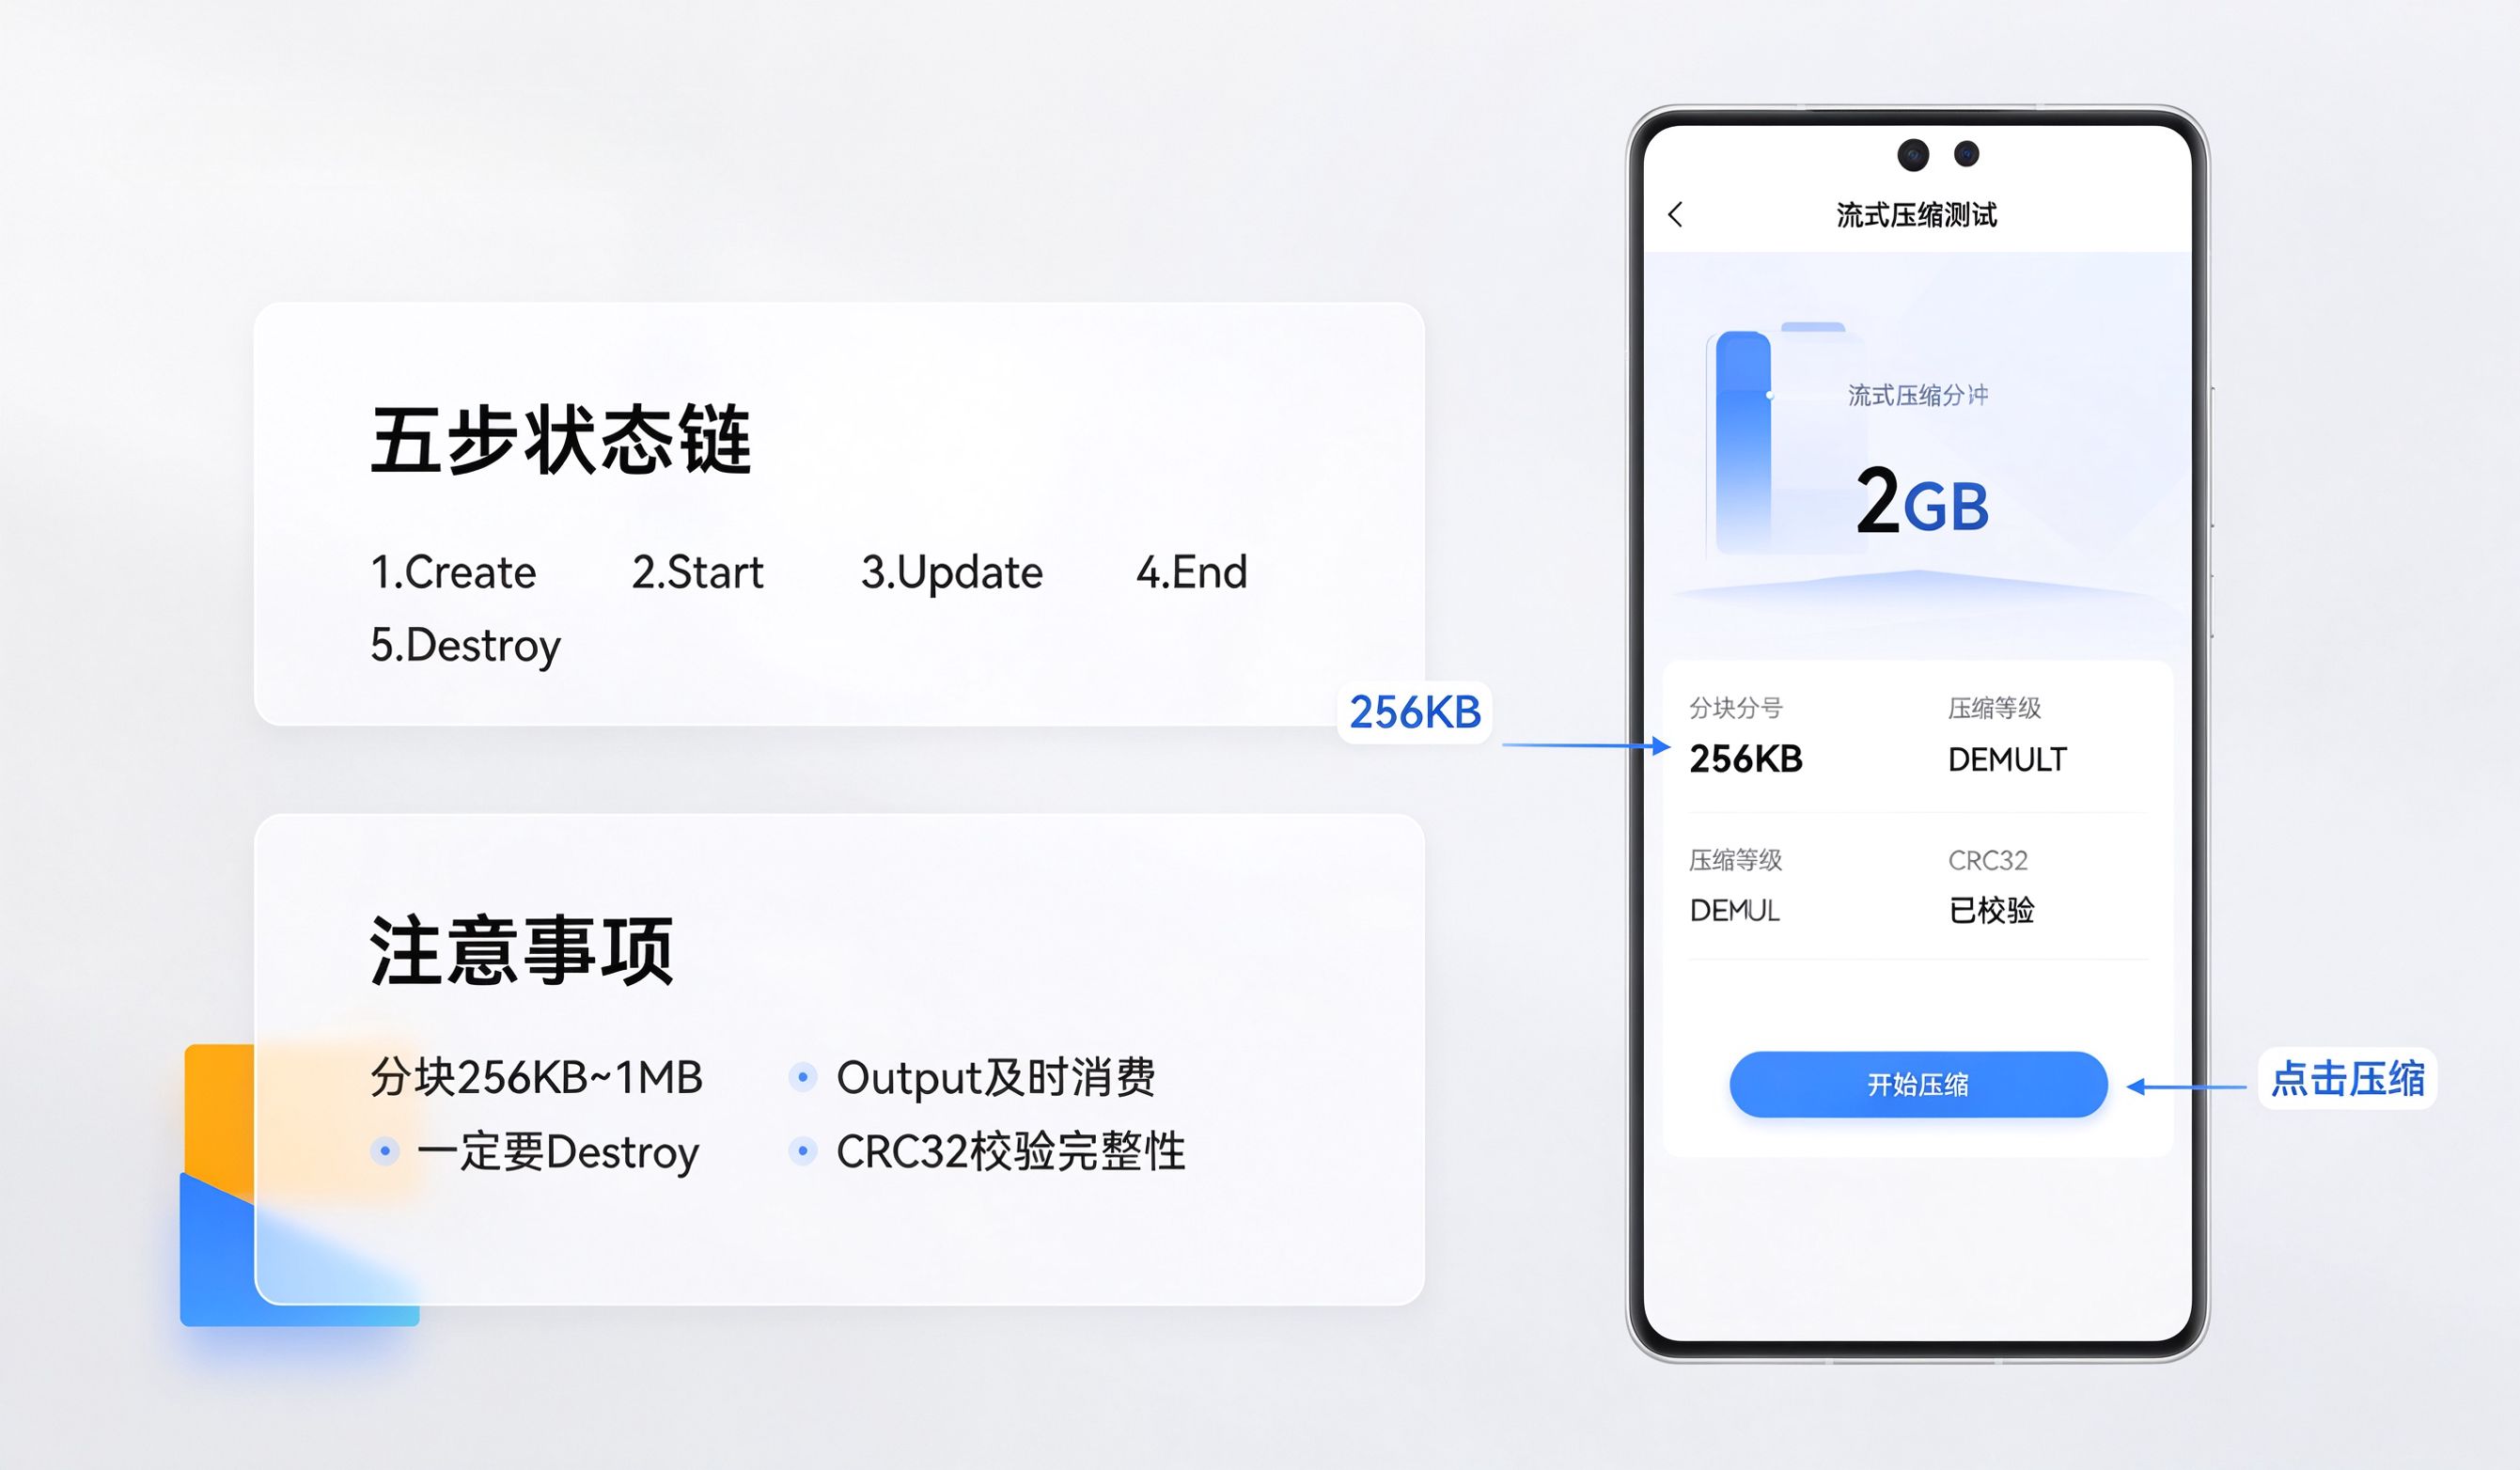
这次做大文件压缩最大的体会是:大文件处理,核心不是压缩算法,是内存控制。不管文件多大,内存里永远只放一块数据。整个状态链 Create → Start → Update → End → Destroy,每一步都要走完,不能少。
真正做的时候,最容易忽略的不是压缩率,是周边的东西:OutputHandler 及时消费、Destroy 释放、CRC32 校验。这些才是工程上的坑。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)