
炸场!小米MiMo-V2.6-Pro首秀登顶开源智能指数榜,Grok 4.7杀入全球前四,华为云码道鸿蒙大模型硬刚,AI圈卷疯了 | 9月22日 AI日报
🎬 视频版直达:https://www.bilibili.com/video/av117311981753605/
💡 今日趋势速览:小米发布MiMo-V2.6-Pro,首秀以46分登顶Artificial Analysis开放权重模型智能指数榜,成本性价比站上帕累托前沿。Grok 4.7同获46分,带动SpaceXAI跻身全球前四大AI实验室。华为云码道上线鸿蒙编码大模型,千行代码错误率降低80%以上。头部厂商同日密集亮剑,模型竞争全面白热化。
🎯 今日要点
📋 今日内容汇总
🤖 AI动态
- 小米 MiMo-V2.6-Pro 首秀登顶开放权重模型智能指数榜
- 华为云码道上线鸿蒙编码大模型,千行代码错误率降低 80% 以上
- Grok 4.7 智能指数 46 分,SpaceXAI 跻身前四
- Grok 4.7 现已在 GitHub Copilot 中可用
- 阶跃星辰国际版 Step 5 Preview 免费开放
- GLM-5.3-FlashX 上线,向 Coding Plan 用户开放申请
- Convai 开源 421M 决策模型 Laya,比 Jev 快 4 倍
- TypeSafe AI 取消候补名单,Jev 全面开放
- kyutai 发布语音原生数学模型 Voice of Reason
- 阿里巴巴 Qwen 团队发布五平台沙盒 RecreationWorld
- Claude Code 桌面应用 Mac 版支持后台计算机操作
- Hugging Face 发布 tokenizers v1
- Grok Build v1.0.39 发布:子智能体可锁定父模型
🧪 芯片半导体
🔌 AI基础设施
📌 模型排行榜
🤖 AI动态
1. 小米 MiMo-V2.6-Pro 首秀登顶开放权重模型智能指数榜
来源:原文 | TeksEdge (Twitter)
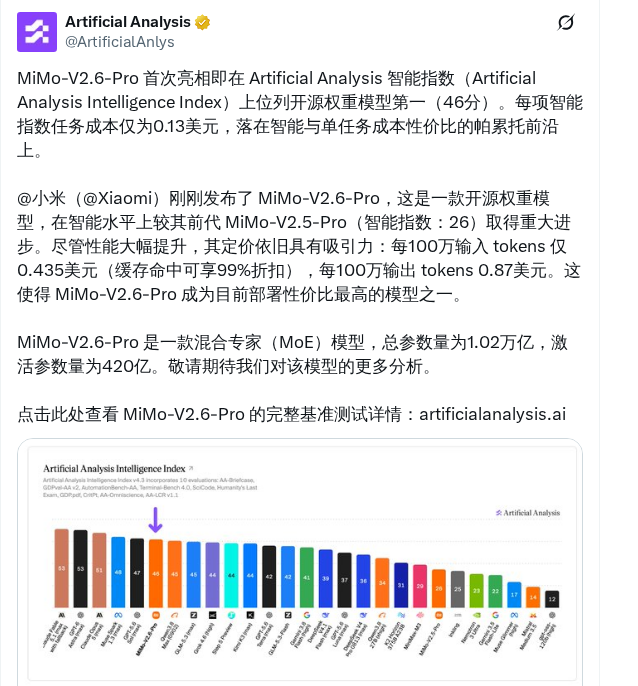
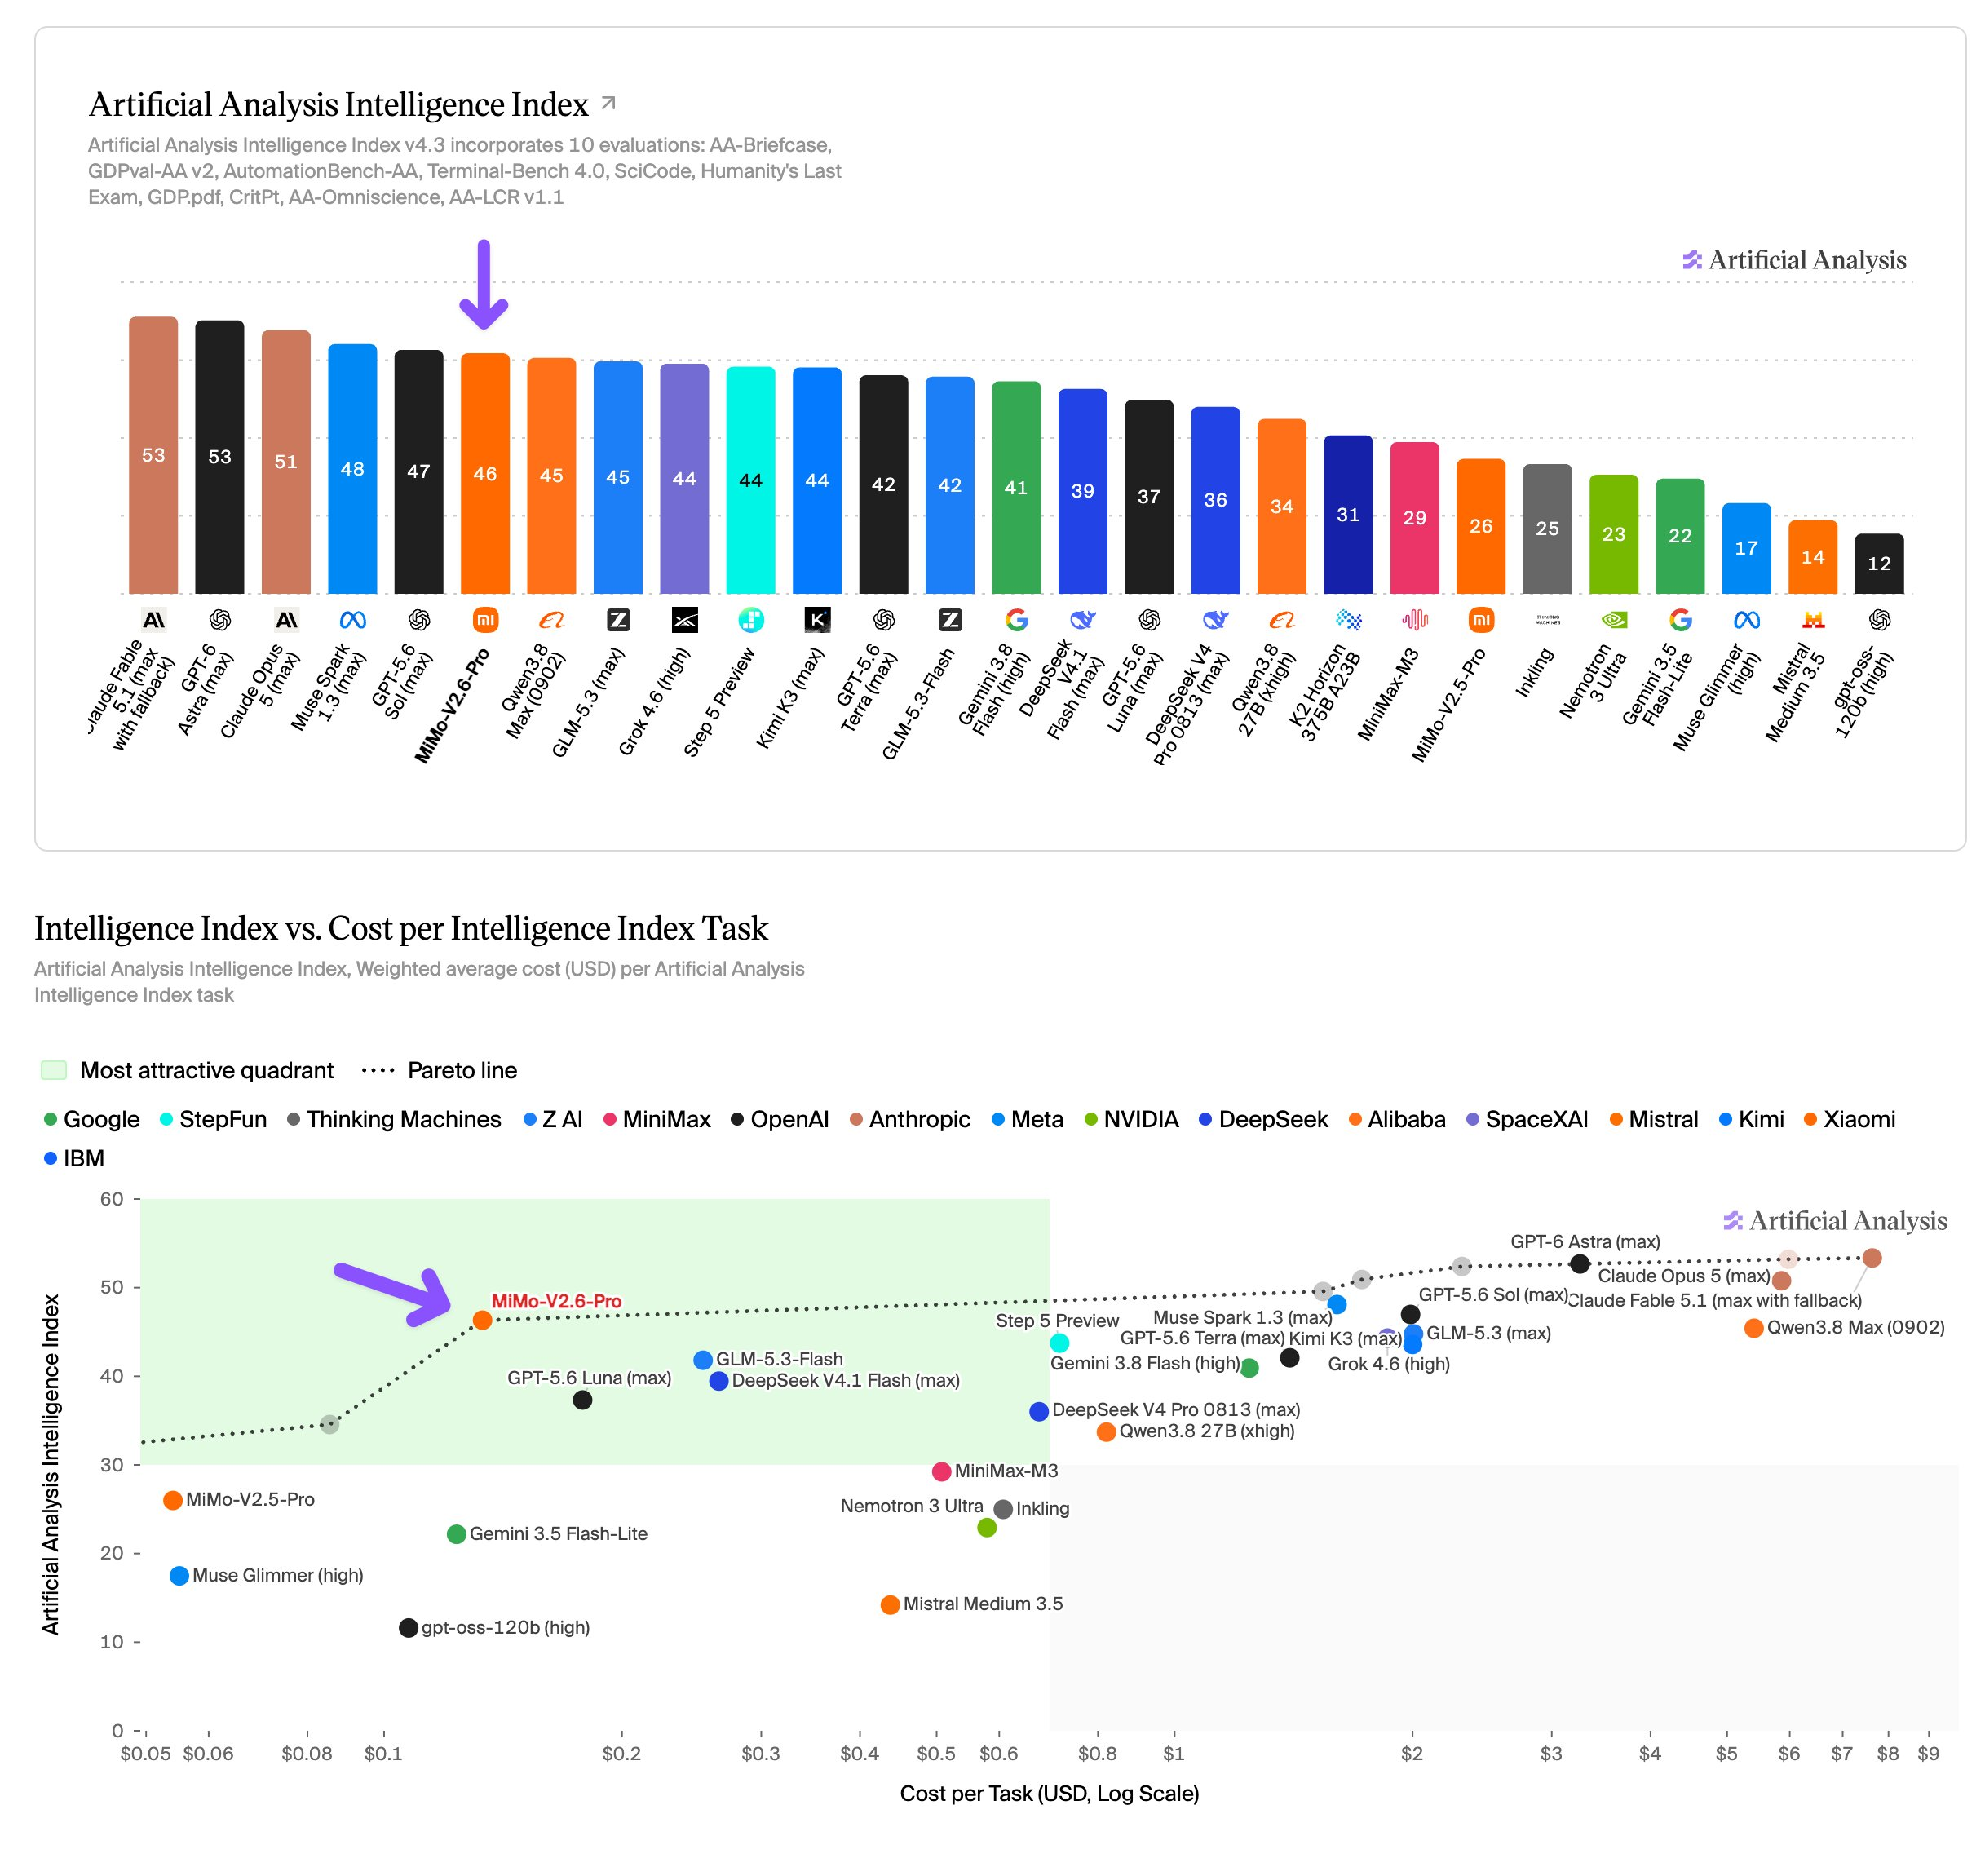
小米发布MiMo-V2.6-Pro,首秀即以46分登顶Artificial Analysis智能指数开源权重模型榜首。该模型每项任务成本仅0.13美元,每百万输入token定价0.435美元。凭借这一表现,它落于智能与单任务成本性价比的帕累托前沿,相较前代MiMo-V2.5-Pro的26分取得重大进步。
🔗 https://x.com/ArtificialAnlys/status/2102128560962187701
2. 华为云码道上线鸿蒙编码大模型,千行代码错误率降低 80% 以上
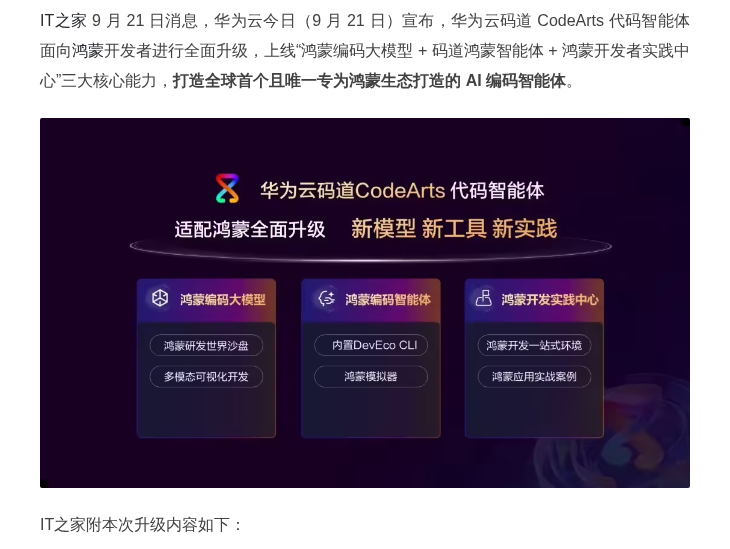
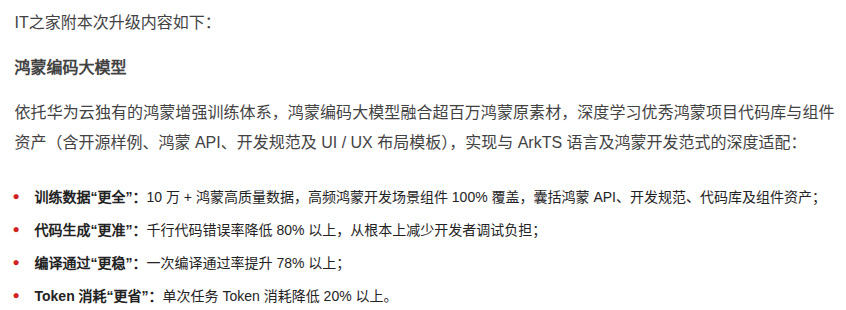
华为云9月21日宣布,云码道CodeArts代码智能体面向鸿蒙开发者全面升级。此次上线鸿蒙编码大模型、码道鸿蒙智能体与鸿蒙开发者实践中心三大核心能力。其中鸿蒙编码大模型融合超百万鸿蒙原素材,深度适配ArkTS语言,千行代码错误率降低80%以上。
🔗 https://www.ithome.com/1/005/375.htm
3. Grok 4.7 智能指数 46 分,SpaceXAI 跻身前四
来源:原文 | LuminaBench
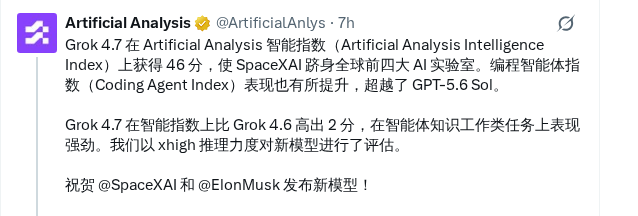
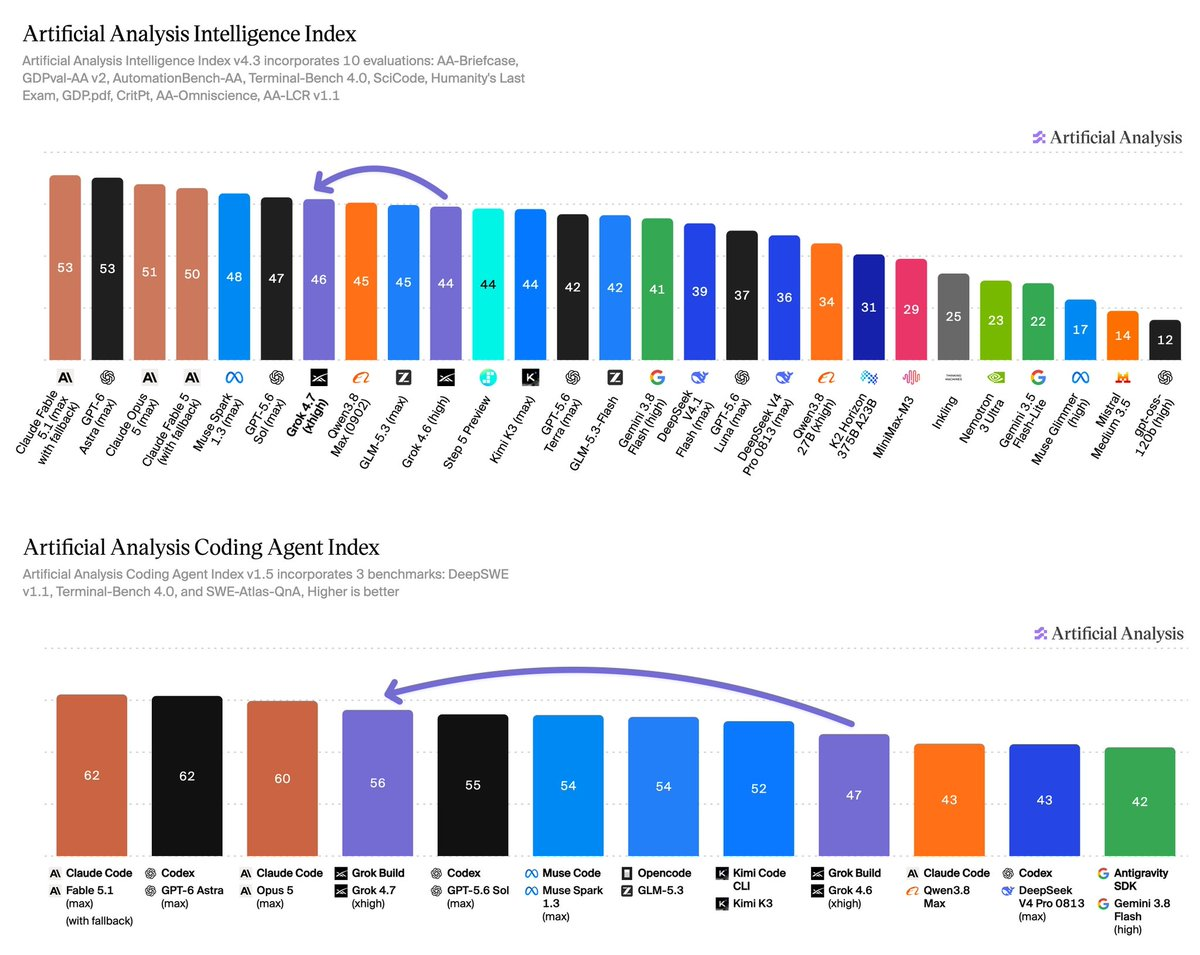
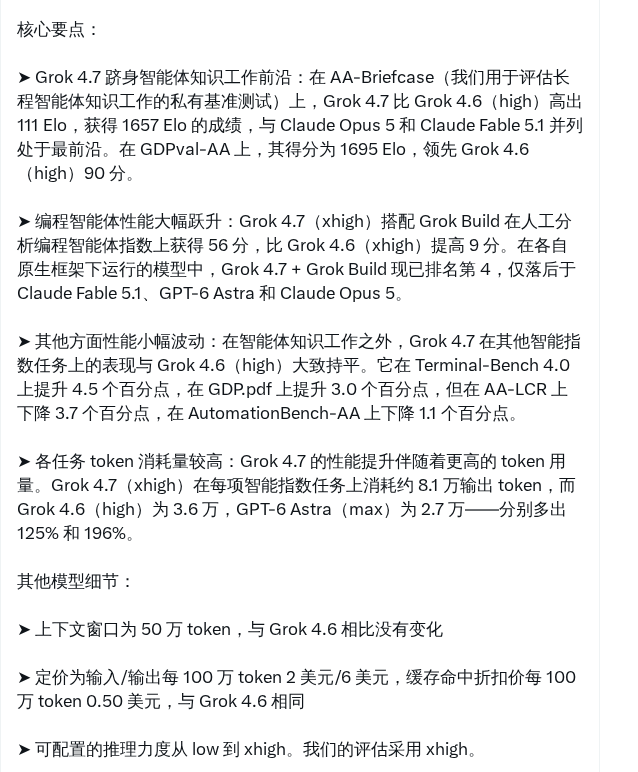
Grok 4.7 在 Artificial Analysis 智能指数获得 46 分,比 Grok 4.6 高出 2 分,带动 SpaceXAI 跻身全球前四大 AI 实验室。详细成绩上,AA-Briefcase 测试中它比 Grok 4.6 高出 111 Elo,编程智能体指数获 56 分。不过性能提升伴随更高 token 用量,每项任务消耗约 8.1 万输出 token,定价则与 Grok 4.6 保持相同。
🔗 https://x.com/ArtificialAnlys/status/2102074931563700266
4. Grok 4.7 现已在 GitHub Copilot 中可用
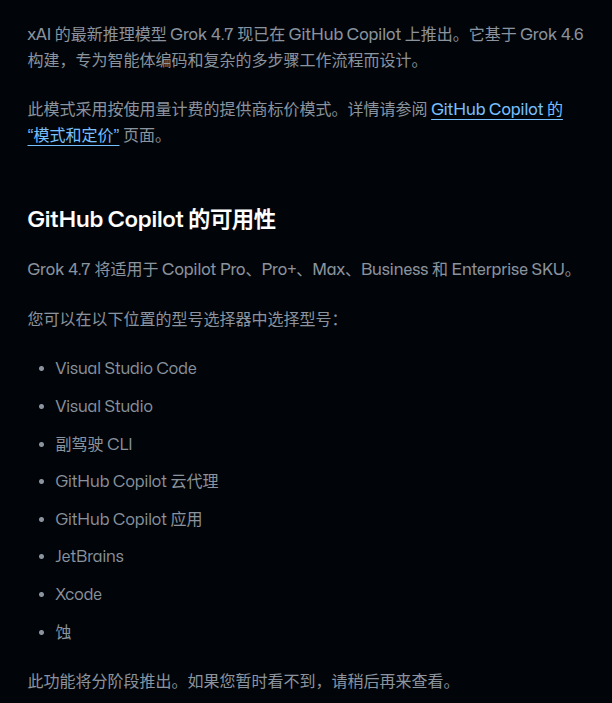
接上条新闻,xAI最新推理模型Grok 4.7现已登陆GitHub Copilot,正在向用户逐步推出。该模型在Grok 4.6基础上构建,专为代理式编程和复杂的多步骤工作流而设计,GitHub Copilot用户即日起可在编程助手场景中直接选用Grok 4.7。
🔗 https://github.blog/changelog/2026-09-21-grok-4-7-is-now-available-in-github-copilot
5. 阶跃星辰国际版 Step 5 Preview 免费开放
阶跃星辰 StepFun 国际版宣布 Step 5 Preview 模型现已免费开放:新用户注册即赠送 15 天免费额度,完成首次 API 调用可再追加 15 天,两项权益叠加后合计可免费使用 30 天,期间调用 Step 5 Preview 模型无需付费。
🔗 https://x.com/xiangxiang103/status/2101927793001103676
6. GLM-5.3-FlashX 上线,向 Coding Plan 用户开放申请
智谱上线更快的 GLM-5.3-FlashX 模型,最高可达 200 Token/秒,面向所有 API 用户开放,Coding Plan 用户可通过表单申请试用。其编码方案与 API 价格均为 GLM-5.3-Flash 的 2.5 倍,官方表示将把所有现有容量投入此次试用,试用权限分批开放。
🔗 https://x.com/ZixuanLi_/status/2102066321991274764
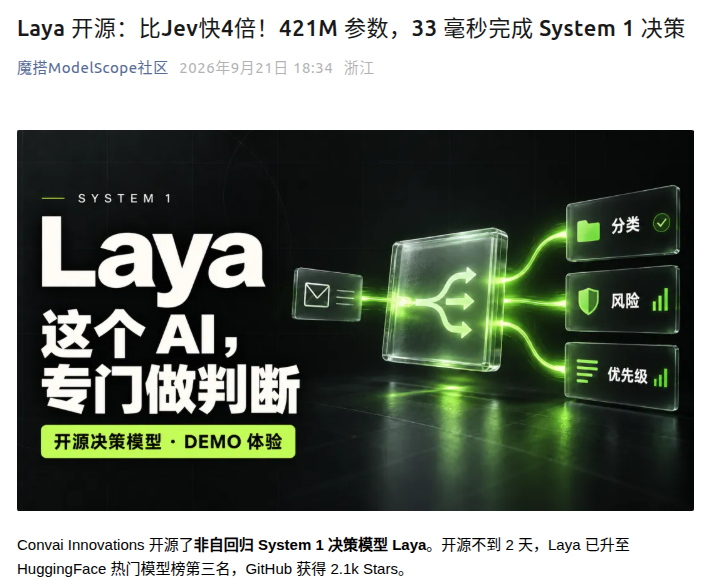
7. Convai 开源 421M 决策模型 Laya,比 Jev 快 4 倍
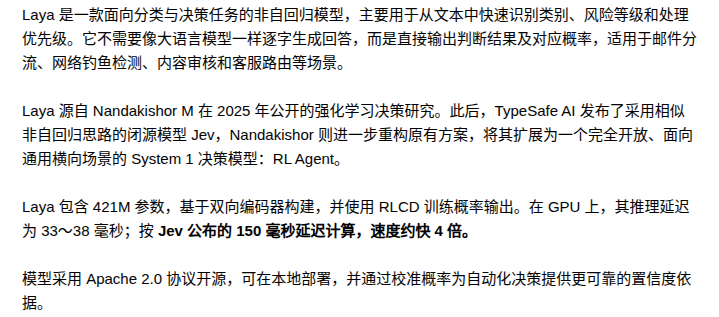
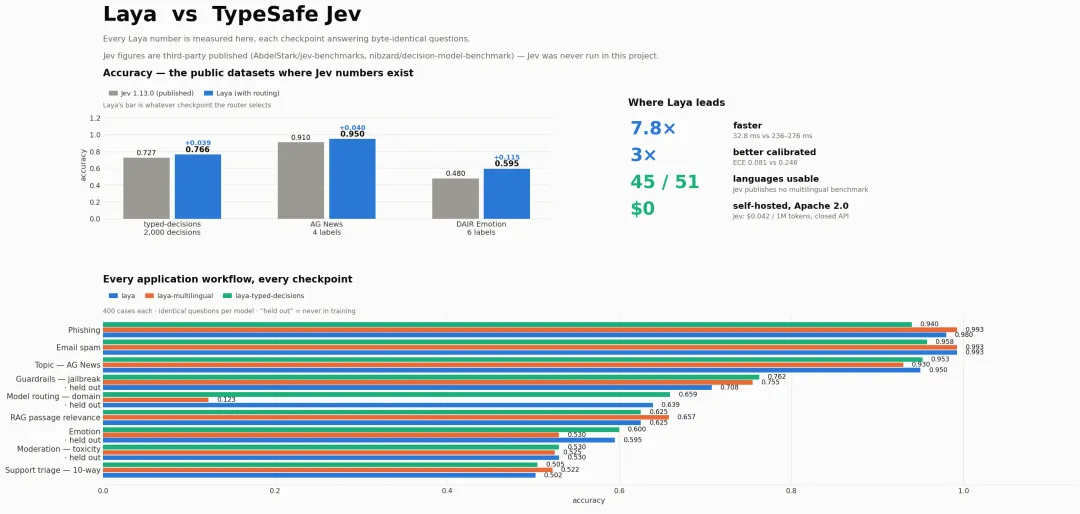
Convai Innovations 开源非自回归决策模型 Laya,421M 参数,推理延迟 33-38 毫秒完成 System 1 决策,速度比 Jev 快 4 倍。该模型主打分类与判断,用于邮件分流、钓鱼检测、内容审核等场景。在公开基准对比中,Laya 准确率领先 Jev,推理最快达 7.8 倍,支持 51 种语言。
🔗 https://mp.weixin.qq.com/s?__biz=Mzk3NTc1NTU0Mw==&mid=2247514085&idx=1&sn=03ffb2d4d97fbbaeaabcc6bd3cff3c76
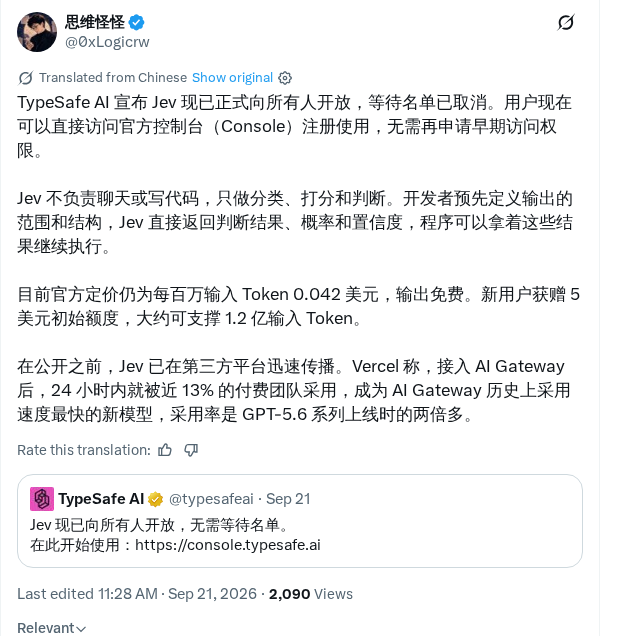
8. TypeSafe AI 取消候补名单,Jev 全面开放
TypeSafe AI 宣布 Jev 向所有人开放并取消候补名单,用户可直接在官方 Console 注册使用。Jev 不做聊天与写代码,只做分类、打分与判断:开发者预定义输出范围和结构,Jev 返回结果、概率与置信度。定价每百万输入 token 0.042 美元,输出免费。
🔗 https://x.com/0xLogicrw/status/2101876275644366967
9. kyutai 发布语音原生数学模型 Voice of Reason
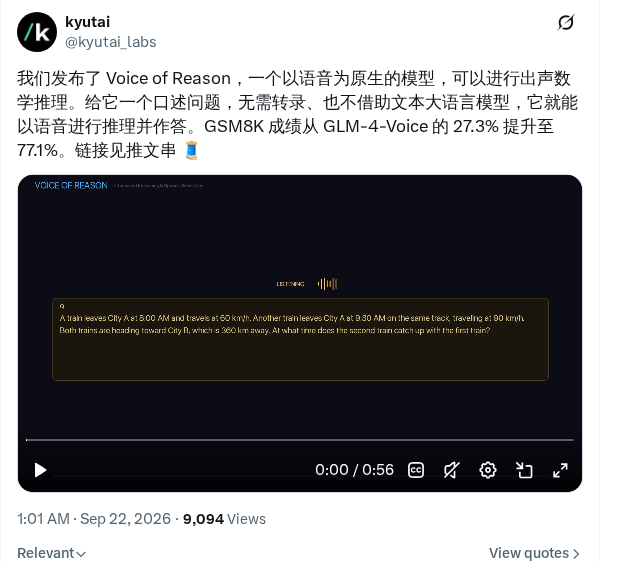
kyutai 发布语音原生模型 Voice of Reason,能直接出声做数学题:接收口述问题后,无需转写文本、也不依赖文本大语言模型,即可用语音完成推理并作答。在 GSM8K 测试中,其成绩从 GLM-4-Voice 的 27.3% 提升至 77.1%。以下是官方给出的 demo
🔗 https://x.com/kyutai_labs/status/2102080831242060123
10. 阿里巴巴 Qwen 团队发布五平台沙盒 RecreationWorld
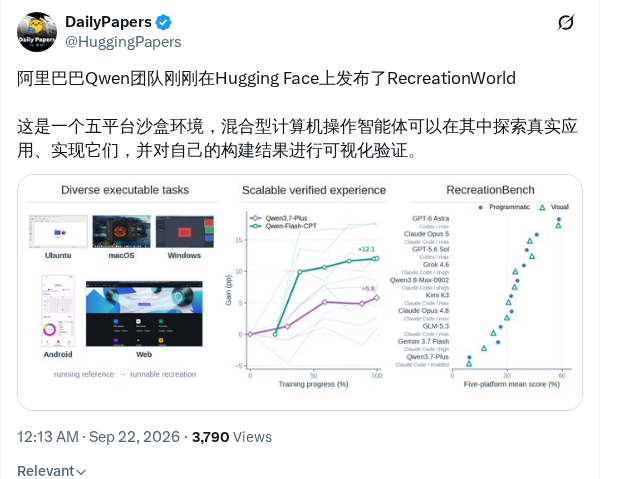
阿里巴巴 Qwen 团队在 Hugging Face 发布五平台沙盒环境 RecreationWorld:混合计算机使用智能体可在其中探索五个平台上的真实应用,亲手实现复刻,并以可视化方式验证自己的构建成果,探索、实现、验证全流程都在沙盒内完成。
🔗 https://x.com/HuggingPapers/status/2102068609396736180
11. Claude Code 桌面应用 Mac 版支持后台计算机操作
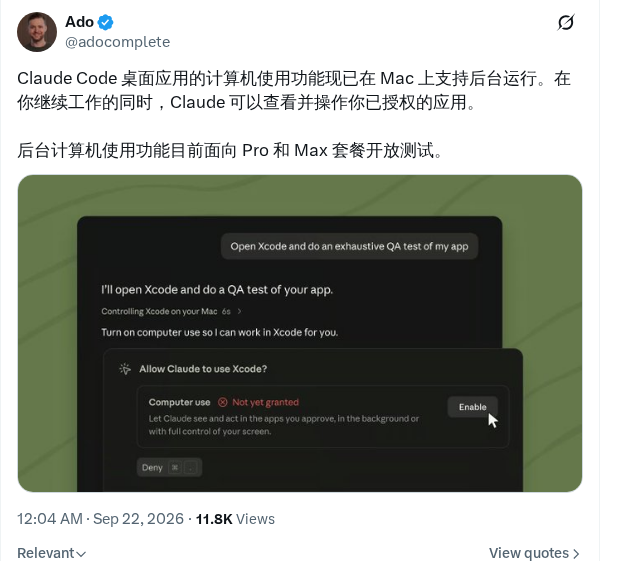
Claude Code 桌面应用的计算机操作功能现已在 Mac 上支持后台运行:Claude 会在后台查看并操作用户预先授权的应用,用户可同时继续手头的工作,无需等待任务完成。后台计算机操作功能现已在 Pro 和 Max 套餐开启测试。
🔗 https://x.com/adocomplete/status/2102066566745776135
12. Hugging Face 发布 tokenizers v1
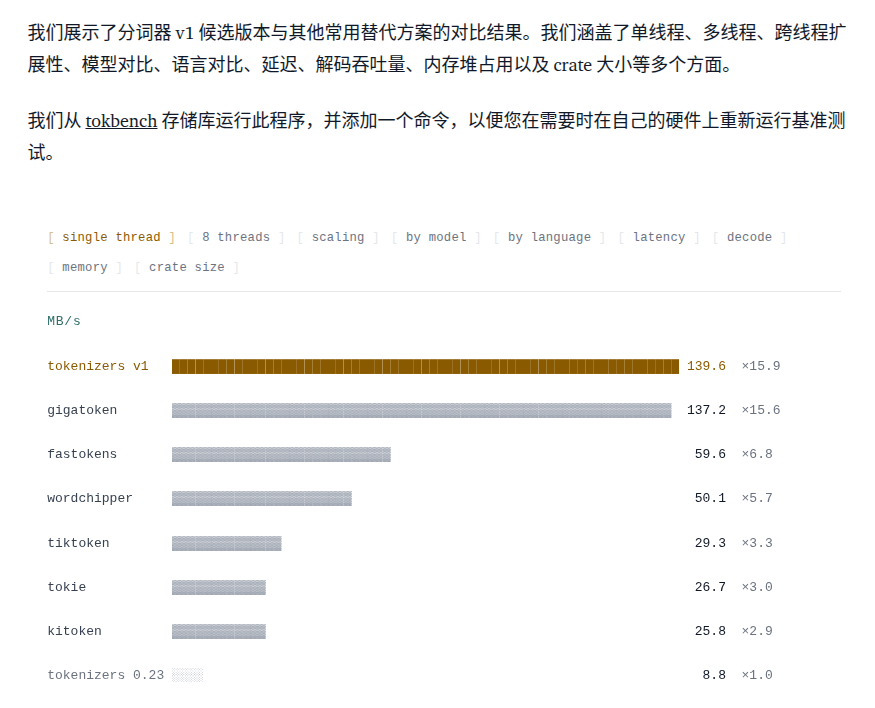
Hugging Face 发布 tokenizers v1,聚焦分词性能,编码速度较 v0.23 最多提升数十倍。实测数据显示,单线程速度达 139.6MB/s,为旧版 15.9 倍,且与 v0.23 输出、API、词表完全一致。随着模型负载扩展,分词渐成瓶颈,团队因此在 1.0 版重点提升性能,压缩高并发场景耗时。
🔗 https://huggingface.co/blog/tokenizers-v1
13. Grok Build v1.0.39 发布:子智能体可锁定父模型
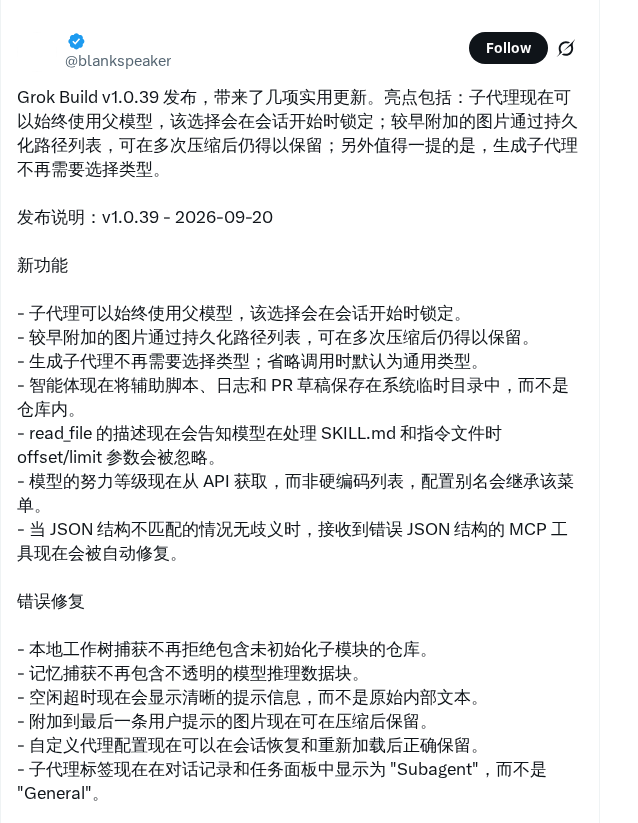
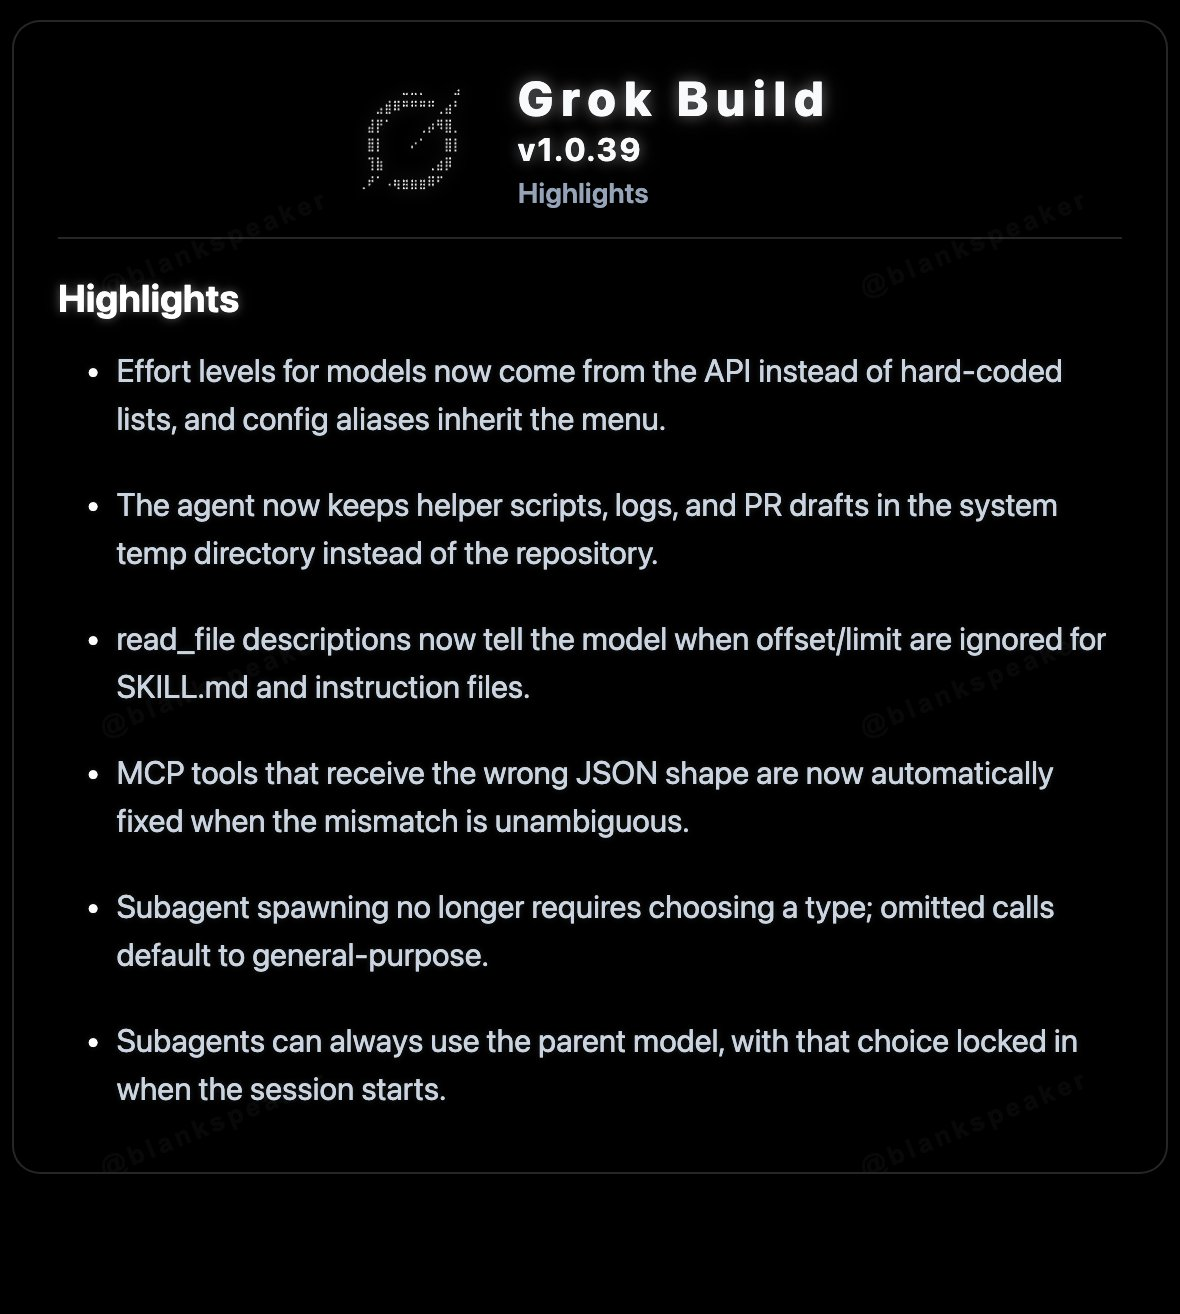
Grok Build 发布 v1.0.39 版本,带来多项实用更新。其中子智能体现在可以始终使用父模型,该选择在会话开始时即锁定。此外,生成子智能体不再需要选择类型;此前附加的图片改以持久化路径列表保存,可在多次上下文压缩后依然保留。
🔗 https://x.com/blankspeaker/status/2101799979249725501
🧪 芯片半导体
14. 谷歌发布全新品类笔记本 Googlebook,开启预订
来源:原文 | IT之家 (ITHome)
谷歌发布全新品类笔记本电脑 Googlebook 并开启预订,配备 2.8K OLED 触控屏与 14 小时续航,性能面向创意工作。该机与 Android 手机无缝同步,可在手机与电脑间流畅切换,并为 Gemini 智能设计,按需提供个性化、主动式帮助。以下是官方给出的 demo
🔗 https://x.com/Google/status/2102051060558750141
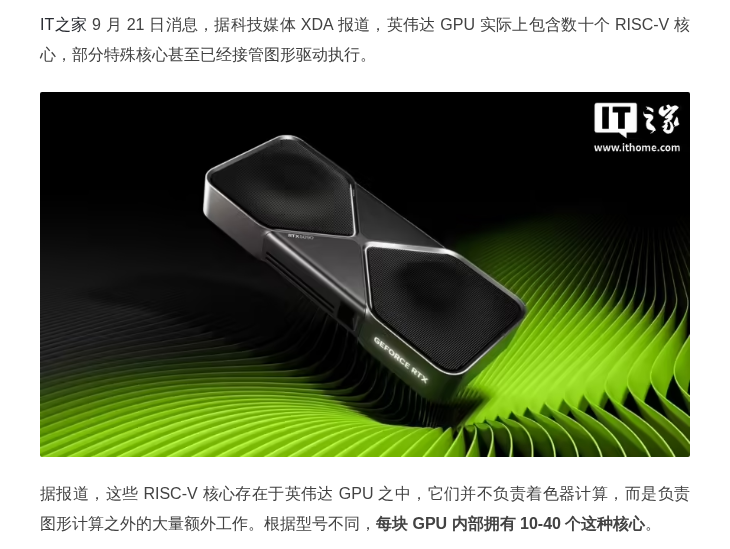
15. 英伟达 GPU 内含数十个 RISC-V 核心,已接管图形驱动
英伟达 GPU 内部实际包含数十个 RISC-V 核心,依型号不同每块 GPU 配备 10-40 个。这些核心不负责着色器计算,而是承担图形计算之外的大量额外任务,其中部分特殊核心已接管图形驱动执行,用户无法对其编程。
🔗 https://www.ithome.com/1/005/039.htm
🔌 AI基础设施
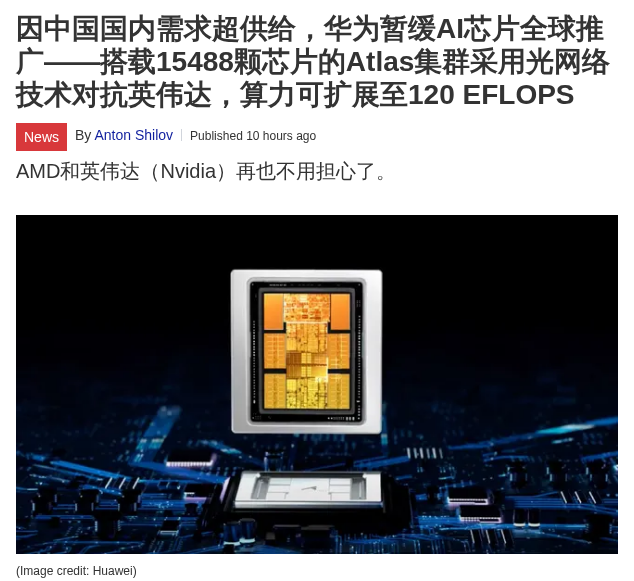
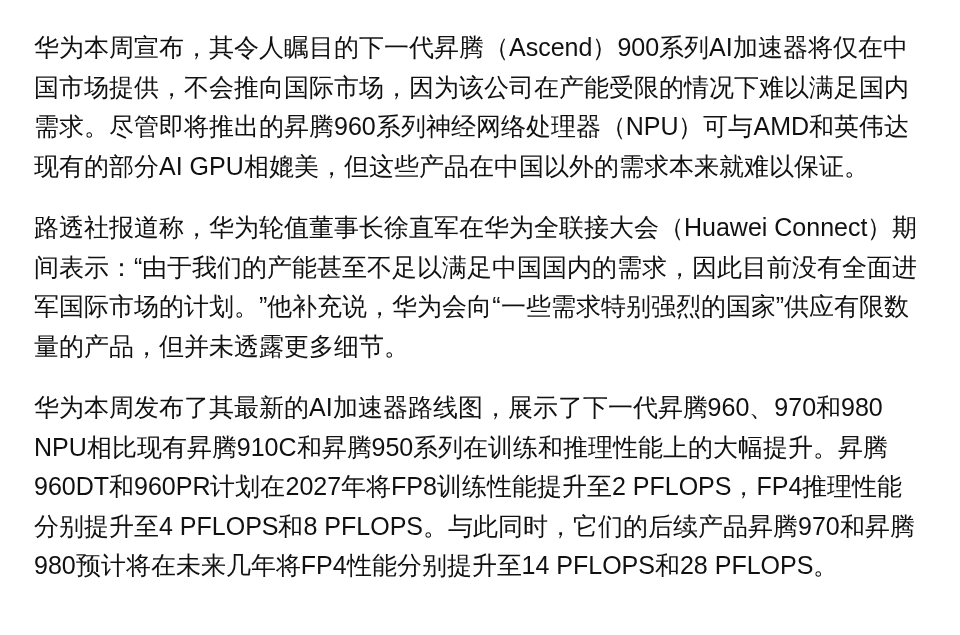
华为表示,由于国内自身需求超出供给能力,将不再向中国以外市场供应其最新 AI 硬件。作为对标英伟达的算力方案,其 15488 芯片规格的 Atlas 集群借助光网络互联组网,算力可扩展至 120 EFLOPS,最新硬件将优先满足国内需求。
🔗 https://www.tomshardware.com/tech-industry/artificial-intelligence/huawei-shelves-global-ai-chip-rollout-as-chinas-own-demand-outstrips-supply-15-488-chip-atlas-clusters-leverage-optical-networking-to-counter-nvidia-scales-to-120-eflops
📌 模型排行榜
17. Artificial Analysis AI 模型能力排行榜
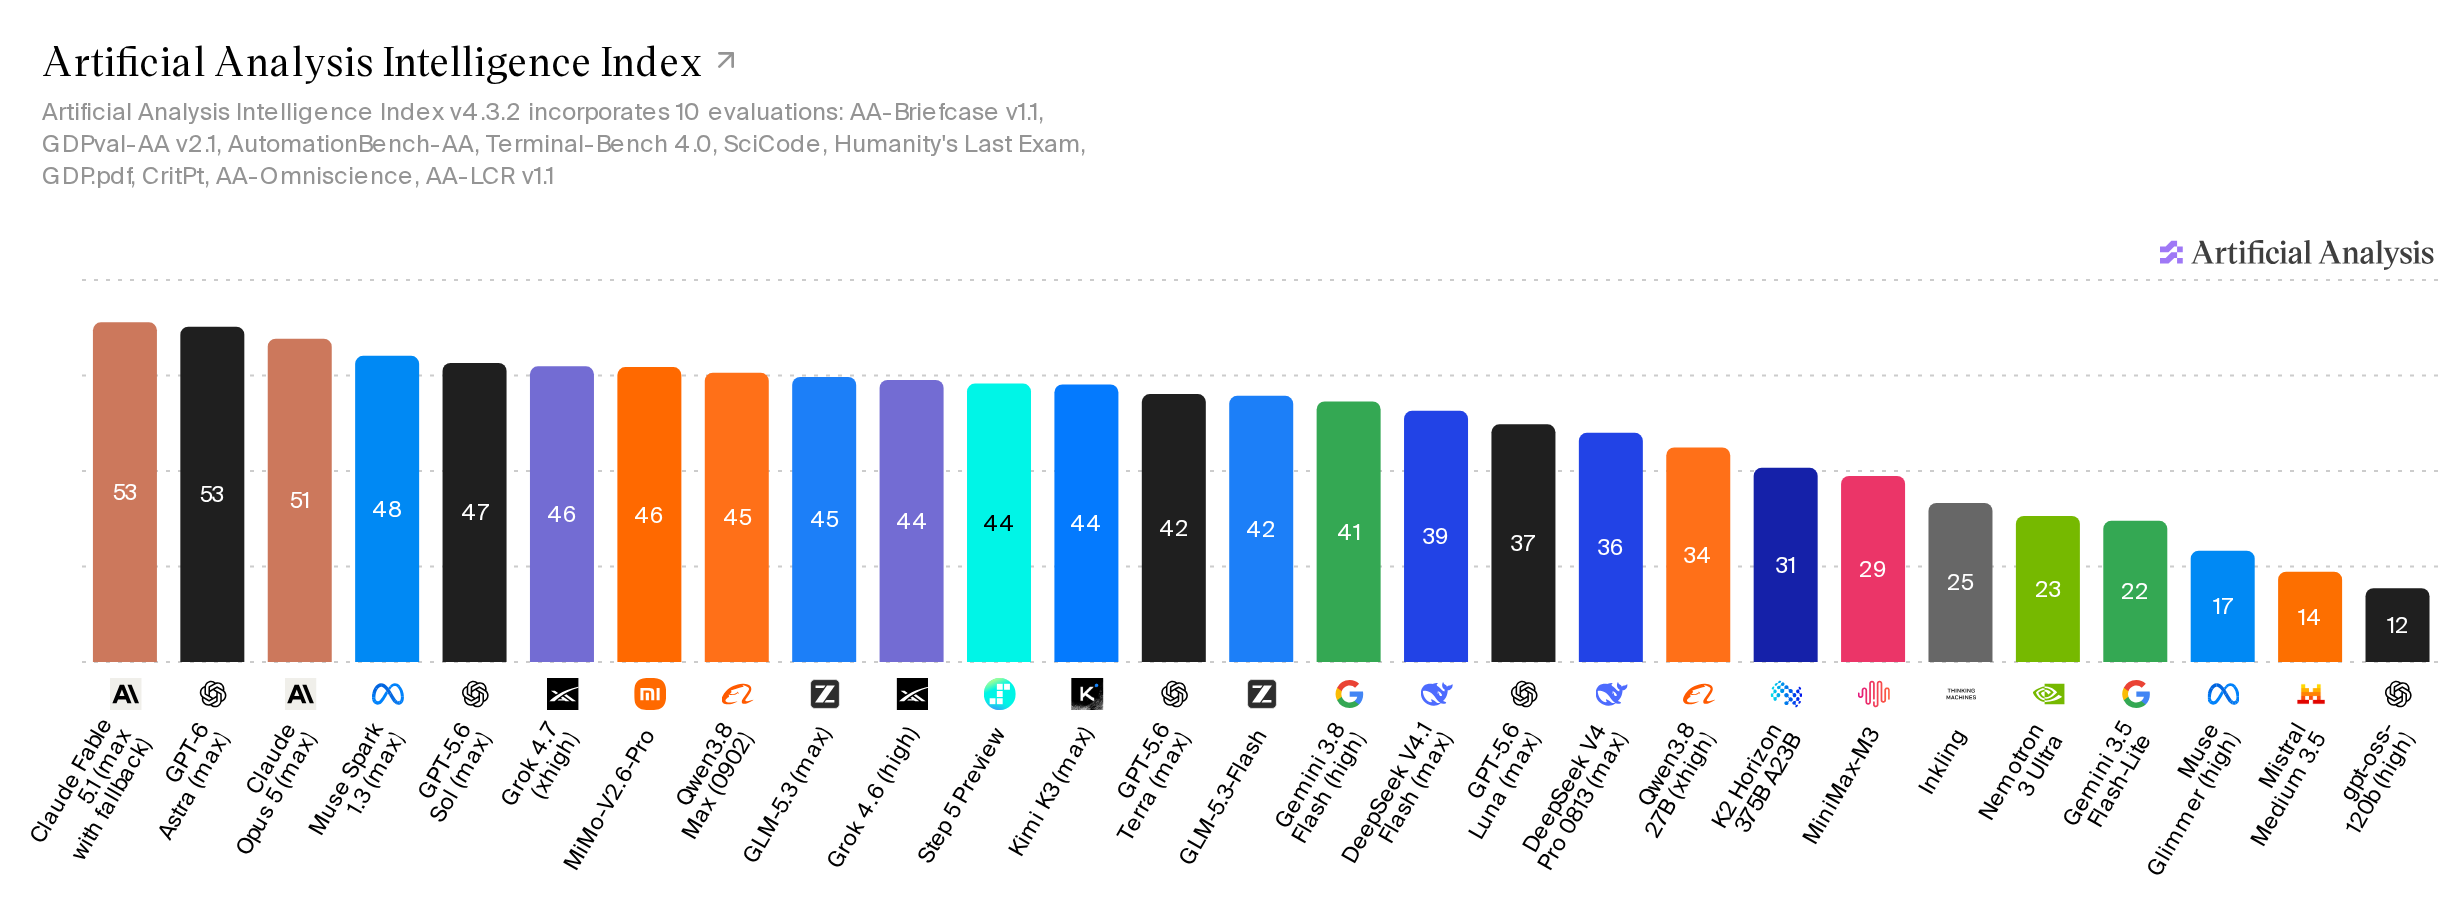
最后是今日的 AI 模型能力排行榜单,智力榜前三:Claude Fable 5.1与GPT-6 Astra同以53分并列第一,Claude Opus 5以51分第三。国产方面,Qwen3.8 Max列第8名45分,GLM-5.3列第9名45分,两者仅1分之差紧咬头部。
🔗 https://artificialanalysis.ai/
以上是今天的AI 风向标,欢迎在评论区提出建议,我们明天见。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)