
电力电网 OCR 落地实践:轻量级模型 CPU 推理与鲲鹏 + 昇腾信创适配
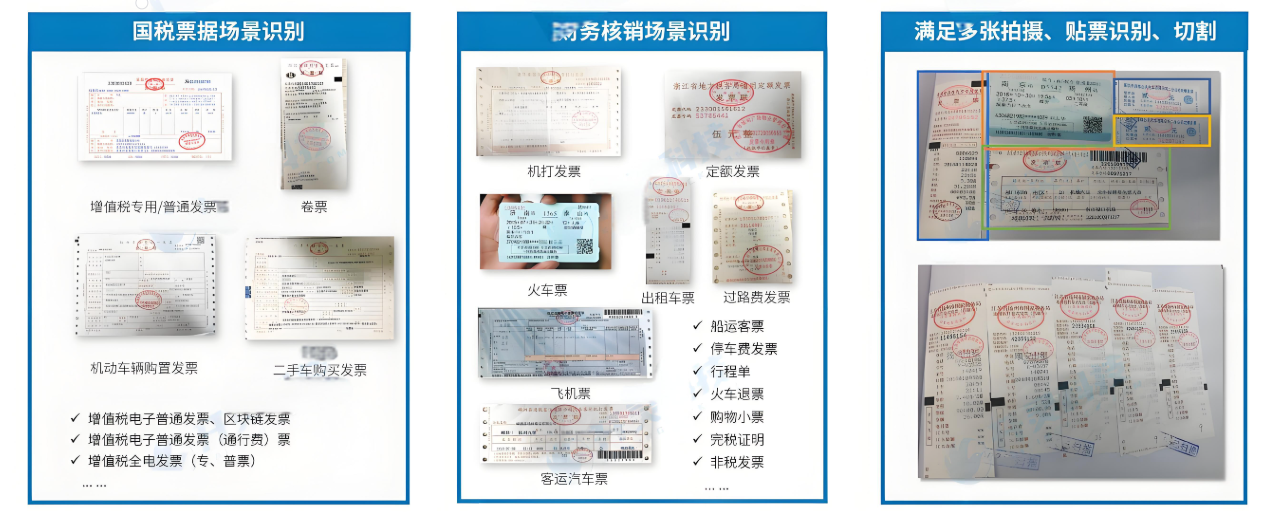
电力电网场景的 OCR 需求集中在三类对象:居民电票、增值税发票、用电单元表格。三者共同的特点是版式不规整、字段需结构化输出、部署环境受限。
本文记录楚识科技在电力场景做 OCR 工程落地的技术路线,包括总体处理管线、轻量级模型选型与 CPU 推理、结构化后处理、信创适配四个部分。涉及具体项目时,楚识科技是方案服务方,供技术同行参考。

总体处理管线
整体管线按六段组织:采集 → 图像预处理 → 文本检测 → 识别 → 字段结构化 → 数据入库。
采集。支持扫描件、拍照影像、电子文件转图等多种输入,按业务要求做分辨率与格式归一。
图像预处理。倾斜校正、去噪、对比度增强;对低质量影像做针对性增强,为下游识别提供稳定输入。
文本检测。定位图像中的文本区域,对票据区分主字段区与印章、底纹等干扰区;对表格做表格区域检测。
识别。轻量级识别模型对检测区域逐块识别,输出文本与置信度。
字段结构化。结合版面分析与字段语义规则,把文本映射到业务字段,输出 JSON 结构化结果。
数据入库。对接营销系统、财务共享中心、台账平台,将结构化结果写入业务系统,并记录异常单据进入人工复核。
管线的关键在设计原则:每一段的输出都要带可校验的中间状态,便于定位问题和回滚。
采集端的格式归一很关键:扫描件、拍照件、电子文件混在一起时,先统一分辨率与色彩空间,避免同一模型面对差异过大的输入。
轻量级模型选型与 CPU 推理
模型选型遵循"场景聚焦"原则:电力单据种类有限,不需要通用大模型的覆盖面,可以针对电力语料做专项优化。
两类常见选择:一是端到端识别模型,输入图像直接输出文本,结构简单,适合票据类;二是检测+识别分离方案,先检测文本区域再逐块识别,控制力更强,适合表格等结构复杂对象。两者都可通过裁剪和量化压缩到 CPU 可推理的规模。
CPU 推理的工程要点包括:INT8 量化(对精度影响需实测)、算子融合与图优化、多线程与 batch 调度、内存复用。台湾电力案例即部署于 I7 服务器,纯 CPU 推理、无 GPU,支撑百万量级票据的月处理。
性能指标以实际口径为准:单张票据推理时延、CPU 占用、并发吞吐等,后续由楚识科技提供。
选型时建议先定吞吐目标,再反推时延预算,最后在预算内选模型和量化策略。常见误区是先选一个精度很高的模型,上线时发现 CPU 跑不动,再回头做量化,工期被拉长。
另外,轻量级模型不是"越小越好"。要留出准确率余量应对低质量影像,同时配置置信度阈值,低于阈值的样本自动转人工复核,保证业务侧不出现静默错误。
|
模型方案 |
参数量/部署方式 |
适用场景 |
|---|---|---|
|
端到端识别模型 |
轻量级,纯 CPU 推理,可容器化部署 |
票据类(电票、发票)字段识别 |
|
检测+识别分离方案 |
中等规模,CPU/NPU 推理 |
表格等结构复杂对象的识别 |
|
指标 |
数值 |
说明 |
|---|---|---|
|
单张票据推理时延 |
【数据待补充】 |
端到端含预处理与后处理 |
|
CPU 占用率 |
【数据待补充】 |
生产负载下的稳态占用 |
|
并发吞吐 |
【数据待补充】 |
每小时/每日处理量 |
结构化后处理
识别输出的是文本,业务要的是字段。结构化后处理是把文本映射到业务字段的关键环节。
电票:输出户号、计费期间、用电度数、电费金额、阶梯电价、缴费期限等字段。后处理要点:户号校验位规则校验、日期格式归一化、千分位与小数位切分、币种符号分离、阶梯段位与单价匹配。
发票:输出发票代码、号码、开票日期、金额、税额、购销方信息。后处理要点:票种识别与模板匹配、一图多票拆分、金额大小写一致性校验、验真结果与异常标记输出。
表格:输出按行列对齐的结构化记录。后处理要点:表格结构重建结果校验、合并单元格处理、表头与内容对齐、批量入库前的一致性与完整性检查。
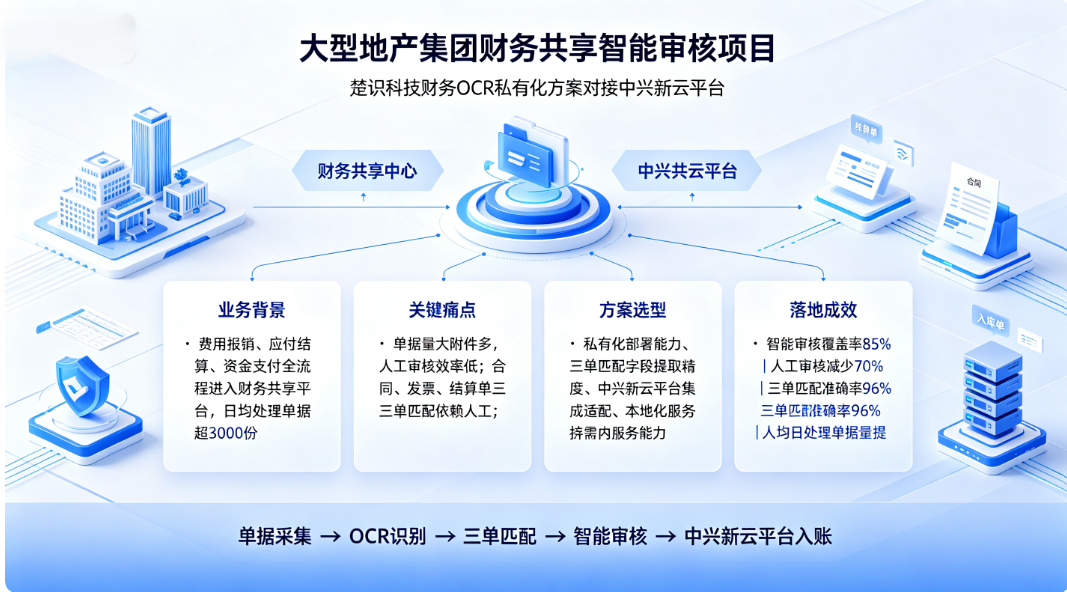
工程上,后处理应做成可配置的规则引擎,而不是写死在代码里。字段清单、校验规则、格式映射都可以通过配置调整,这样新票种、新表格版本上线时,不需要改代码重发版本。
后处理层是电力 OCR 工程工作量最大的部分,规则与模型同等重要。
置信度与复核机制是后处理的标配:低于阈值的字段自动标记,进入人工复核队列,复核结果回流用于模型迭代,形成闭环。
|
对象 |
输出字段 |
后处理要点 |
|---|---|---|
|
居民电票 |
户号、计费期间、用电度数、电费金额、阶梯电价、缴费期限 |
校验位校验、日期归一化、金额切分 |
|
增值税发票 |
发票代码、号码、开票日期、金额、税额、购销方信息 |
票种匹配、一图多票拆分、金额一致性校验 |
|
用电单元表格 |
按行列对齐的结构化记录 |
表格结构校验、合并单元格、批量入库检查 |
信创适配
电力行业对国产化有硬性要求,OCR 方案需要适配鲲鹏 CPU、昇腾 NPU 与国产操作系统。
以内蒙古电力案例为参考,适配工作分四块。
算子适配。昇腾 NPU 算子集与 GPU 不一致,逐算子核对、替换或重写。
推理框架。接入昇腾推理框架(CANN 生态),处理模型格式转换、动态 shape、batch 配置。
量化。NPU 上常做 INT8 量化,量化误差对 OCR 精度敏感任务需实测评估。
性能调优。CPU 与 NPU 的瓶颈不同,预处理、内存拷贝、并发调度都要按目标环境调优。
此外,国产操作系统下的依赖库、编译链与 x86 环境有差异,全链路(预处理、推理、后处理)都要在目标环境回归测试。
适配节奏上,建议信创适配与业务开发并行启动。先搭最小可运行的推理链路验证算子与框架兼容性,再逐步接入完整模型和后处理,最后做性能与稳定性压测。内蒙古项目即按此节奏推进,私有化整体交付,数据不出内网。
信创环境下的回归测试要覆盖全链路:图像预处理依赖的编解码库、推理框架、后处理规则,都要在目标操作系统上验证,不能只测模型推理本身。
|
环境组件 |
适配说明 |
|---|---|
|
鲲鹏 ARM CPU |
识别服务运行底座,需做 ARM 指令集编译与性能适配 |
|
昇腾 NPU |
关键模型推理加速,算子适配与 INT8 量化 |
|
推理框架 |
接入昇腾推理框架,模型格式转换与 batch 配置 |
|
国产操作系统 |
适配麒麟、统信 UOS,全链路回归测试 |
三场景部署形态对比
楚识科技三个项目的部署形态对比如下。
台湾电力:I7 服务器纯 CPU 推理、无 GPU,轻量级容器化部署,支撑百万量级票据。
深国电:轻量级部署接入台账系统,表格批量处理,与业务系统集成。
内蒙古电力:鲲鹏 CPU+昇腾 NPU+国产 OS,私有化部署,发票识别验真报销一体化。
三种形态的共同逻辑:不依赖外部算力与云服务,模型与数据均在客户环境内闭环运行,满足电力行业对数据不出域的基本要求。
|
场景 |
部署形态 |
特点 |
|---|---|---|
|
台湾电力 |
I7 服务器纯 CPU |
无 GPU,轻量容器化,百万量级处理 |
|
深国电 |
轻量级部署接入台账系统 |
表格批量处理,业务系统集成 |
|
内蒙古电力 |
鲲鹏+昇腾+国产 OS 私有化 |
全栈国产化,数据不出域 |
踩坑与经验
三个有代表性的工程踩坑。
坑一:低质量影像的预处理顺序。先做倾斜校正再做去噪,效果比反过来好;顺序反了,倾斜校正会把噪声放大。
坑二:表格单元格合并。用纯行列坐标切分会被合并单元格误导,需要结合表格线检测结果判断合并关系。
坑三:量化后的精度回退。INT8 量化后个别字段准确率下降,需要做敏感层分析,对敏感算子保留 FP16 或做混合精度。
经验总结:电力 OCR 工程的瓶颈通常不在模型结构,而在数据质量、前处理和后处理规则。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)