
鸿蒙应用线上冻屏崩溃,为什么总是定位不到根因
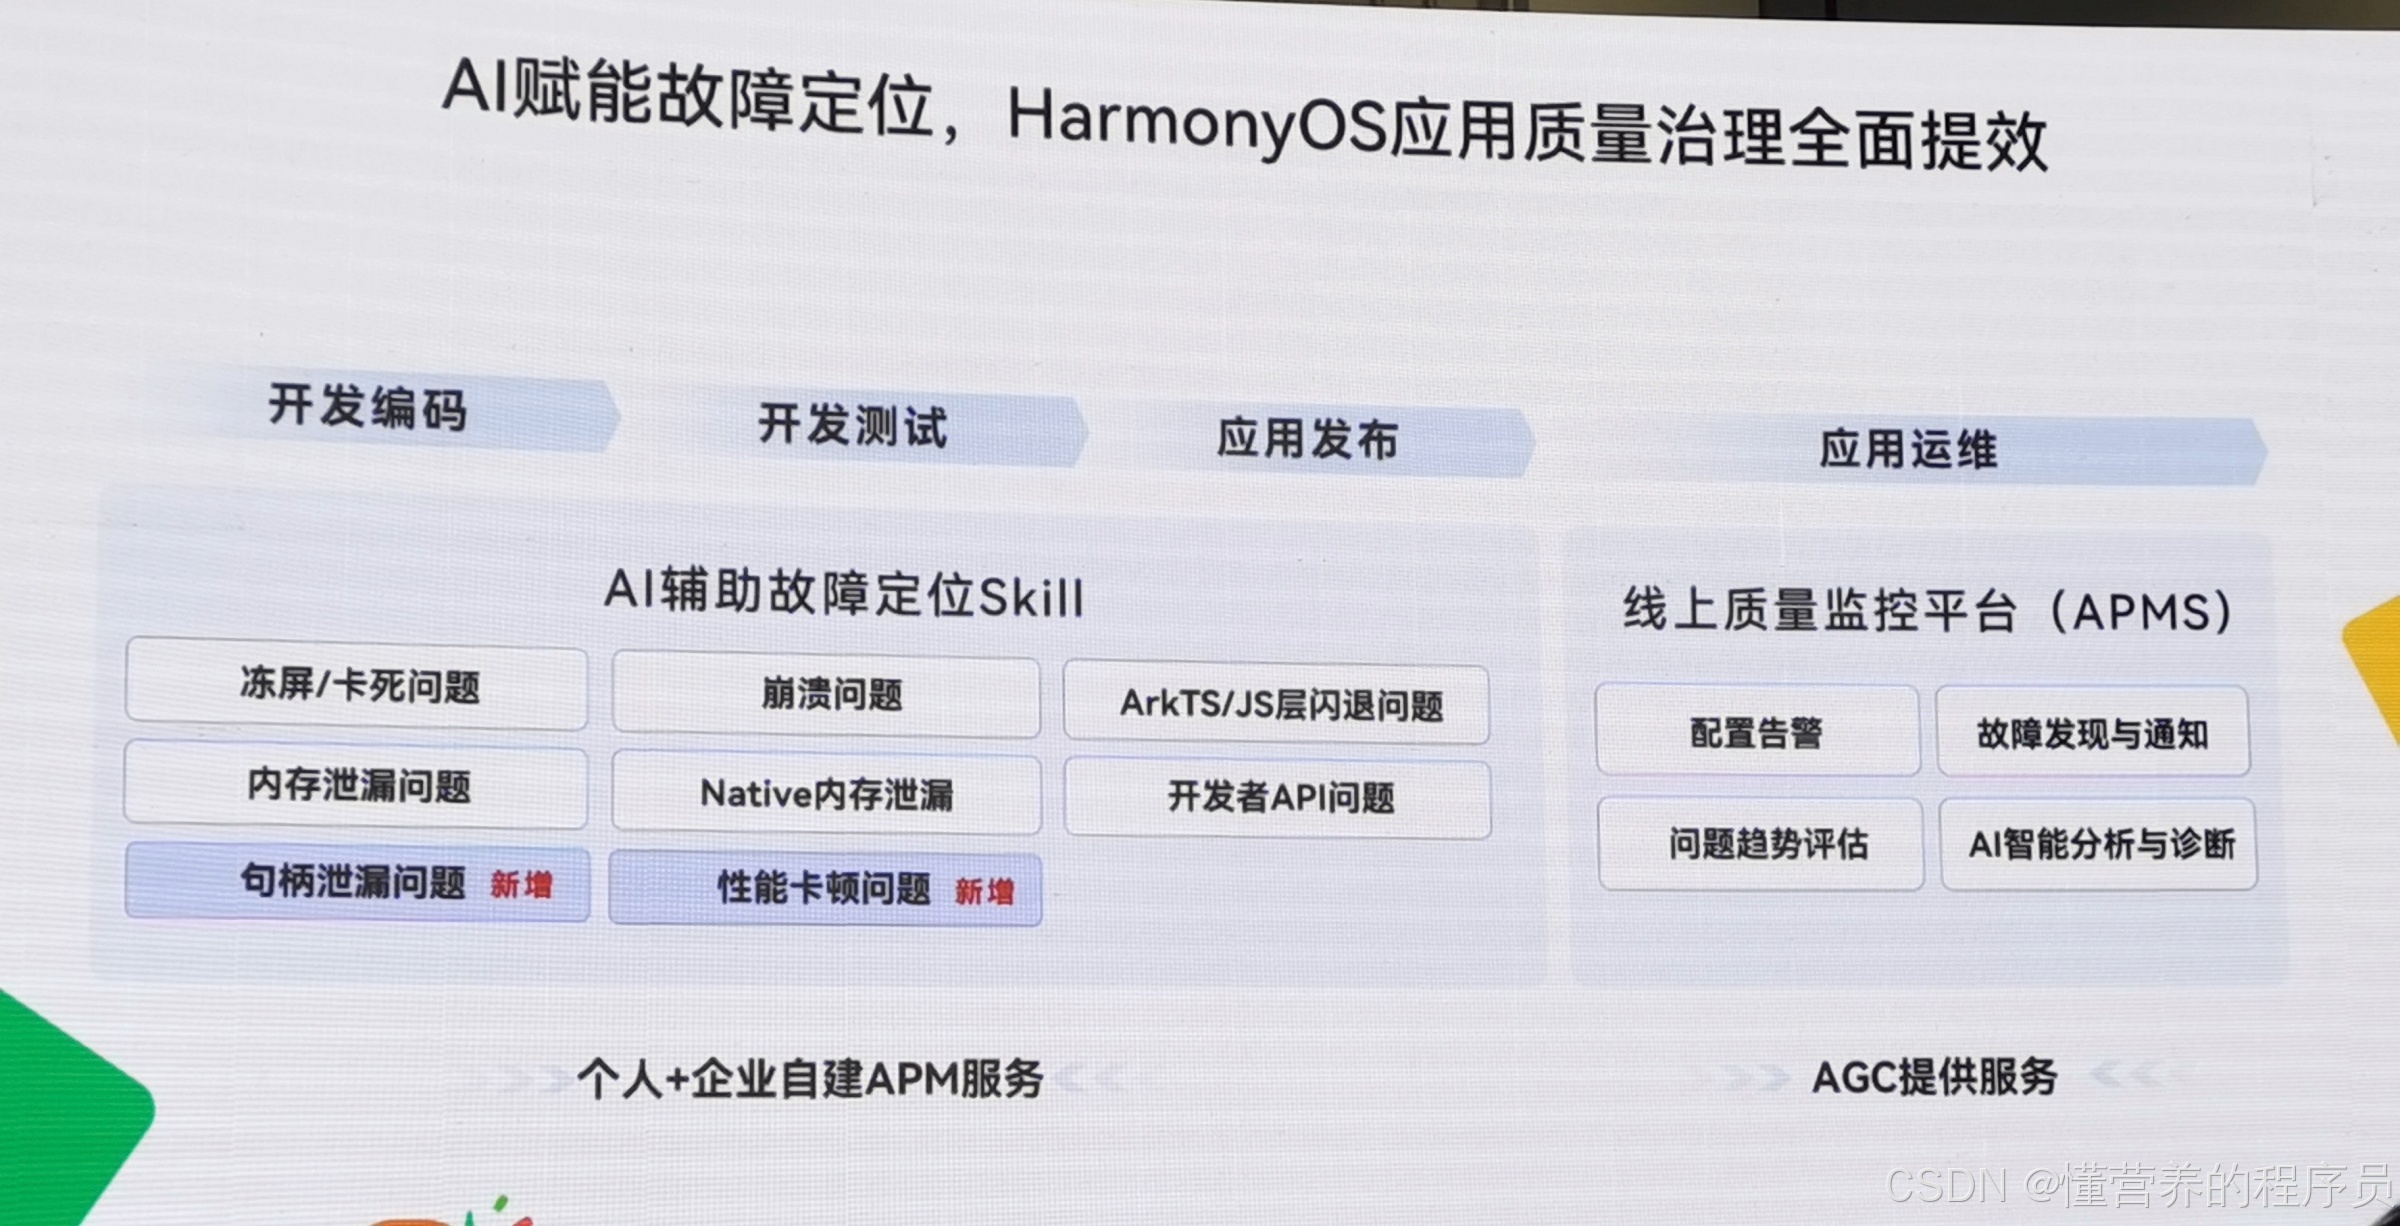
开发和测试阶段的问题都好说,因为是自己写的功能、自己搭的环境,日志都在手上。真正难的是应用上架之后:某个用户在小概率场景下遇到一次冻屏或者崩溃,日志捞回来一堆,堆栈、设备信息、版本信息分散在不同入口,同一现象可能对应好几个根因,只能靠经验一层层排。
为了解决这个问题,鸿蒙把专家的定位经验固化成了可下载的 Skill。2026 年 9 月 18 日 HDD·HarmonyOS 创新论坛上海站上,华为终端 DMS 团队把 AI 辅助故障定位的范式、目前已上线的 Skill 清单与两种部署方式讲了一遍,"冻屏这类问题交给 Skill 加模型,基本三五分钟就能出根因" 是全场最实在的一句。
本文基于该场分享的现场录音与课件照片整理,按"问题在哪 → 新范式 → Skill 清单与用法 → APMS 平台 → 与传统方式对比"的顺序梳理,内容与数据均出自现场分享。
一、卡点不在"发现",在"定位与修复"
AI 帮忙把代码写完,另一头的问题就冒出来了:调试的问题、上架之后的运维问题,谁来解?
现场先把应用质量治理的痛点按生命周期摆了一遍:
| 阶段 | 痛点 |
|---|---|
| 开发编码 | 代码依赖复杂,可能出现 API 误用;性能、功耗等非功能问题难在这一阶段暴露 |
| 应用测试 | 设备与版本组合多,问题难复现;日志、Trace、测试结果相互割裂,人工关联成本高 |
| 应用运维 | 线上日志、指标、调用链分散,告警噪声大;问题影响评估、根因判断与修复建议高度依赖专家经验 |
结论很清晰:随着检测与监控能力变强,发现一个问题已经不是难事,难的是把问题端到端闭环。瓶颈就在"分析"和"修复验证"这两段。
现场进一步拆成三个具体困难:
- 证据分散:日志、堆栈、设备、版本信息分布在不同入口;
- 根因难判:同一现象可能对应多个根因,排查依赖经验;
- 修复难验证:修复后仍需跨版本、跨环境验证,闭环容易中断。
然后点了两个典型难点。冻屏问题的特点是爆发快、影响广、排查难:根因定位复杂、人工排查耗时长、传统堆栈缺乏过程信息。内存泄漏问题的特点是隐蔽性强、复现难:复现场景碎片化、引用链难分析。这两类恰好是传统排查最吃人力、最吃专家经验的地方。
二、新范式:把专家经验固化成 Skill
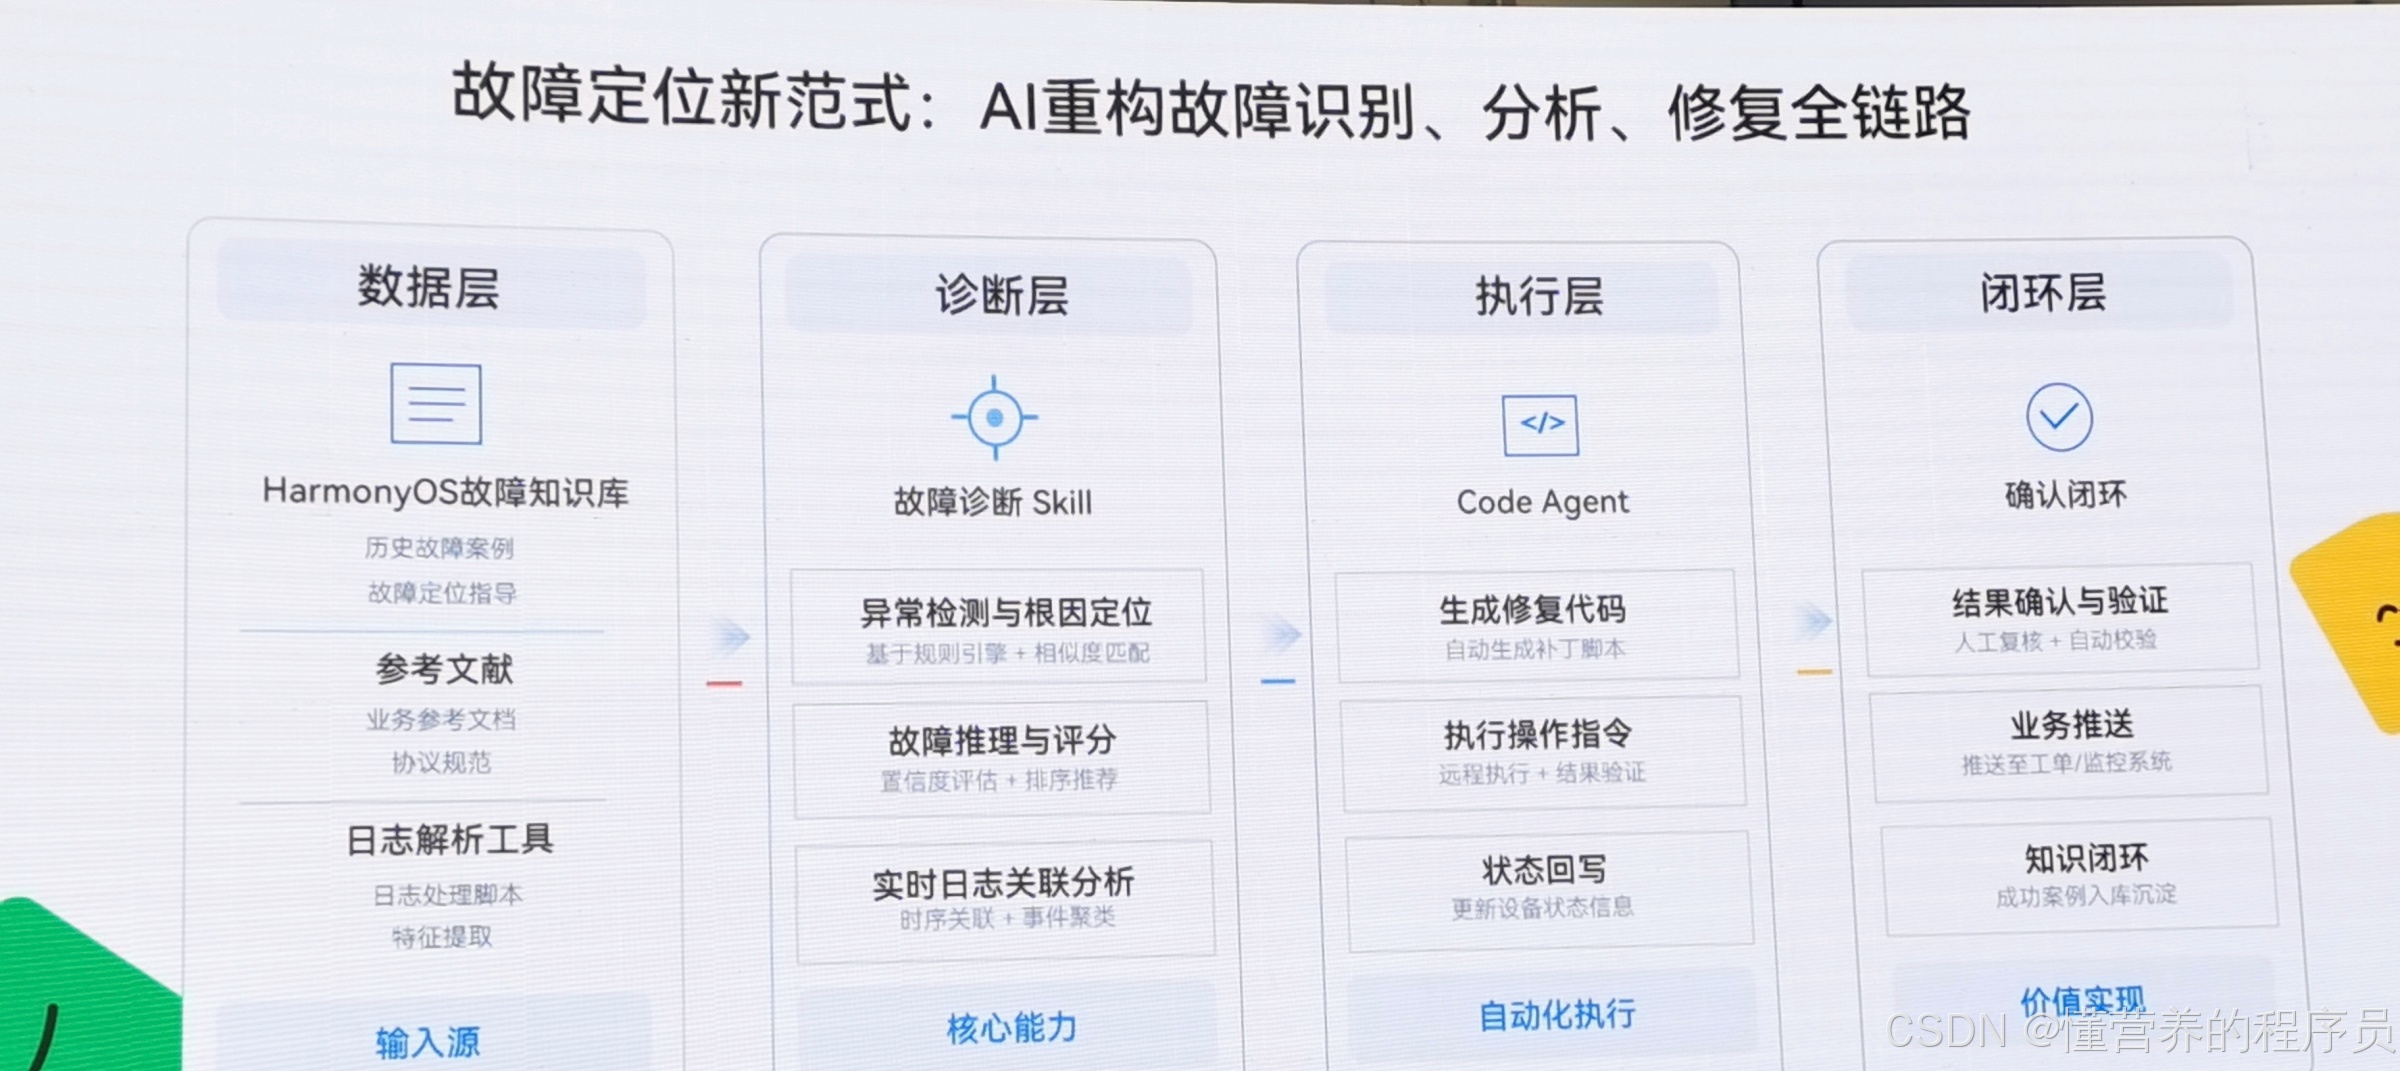
这套方案的整体结构分四层,值得按层理解:
| 层 | 内容 |
|---|---|
| 数据层 | 鸿蒙故障知识库、历史故障案例、参考文献、业务参考文档、协议规范、日志解析工具与处理脚本 |
| 诊断层 | 故障诊断 Skill:异常检测与根因定位、故障推理与评分(基于规则引擎 + 相似度匹配)、置信度评估 + 排序推荐、日志解析与特征提取 |
| 执行层 | Code Agent:生成修复代码、自动生成补丁脚本、执行操作指令、远程执行与结果验证 |
| 闭环层 | 结果确认与验证、人工复核 + 自动校验、推送至工单或监控系统 |
其中最关键的是诊断 Skill:它把鸿蒙专家与开发者的定位经验固化成可复用的标准打法,用来指导模型推理与分析;数据层则提供专业知识库、参考文档与工具,帮模型更好地理解日志、提取关键特征。
有三个工程特性值得单独点出来:
- 不需要微调模型。把这套结构部署到任意 AI 应用里,就能获得不错的定位效果——这对不想动模型的团队很友好;
- 提供源码时可做源码级溯源,修复建议能精确到代码或函数级;
- 人工只做两件事:感知问题并触发流程、确认验证结果的可靠性。
拿到修复建议后交给 Code Agent 生成修复代码,人工在确认与验证环节判断是否通过,通过即可上库上线。还有一个数据飞轮:被确认有效的案例会反哺回知识库,让系统自演进。
三、8 个已上线的故障定位 Skill
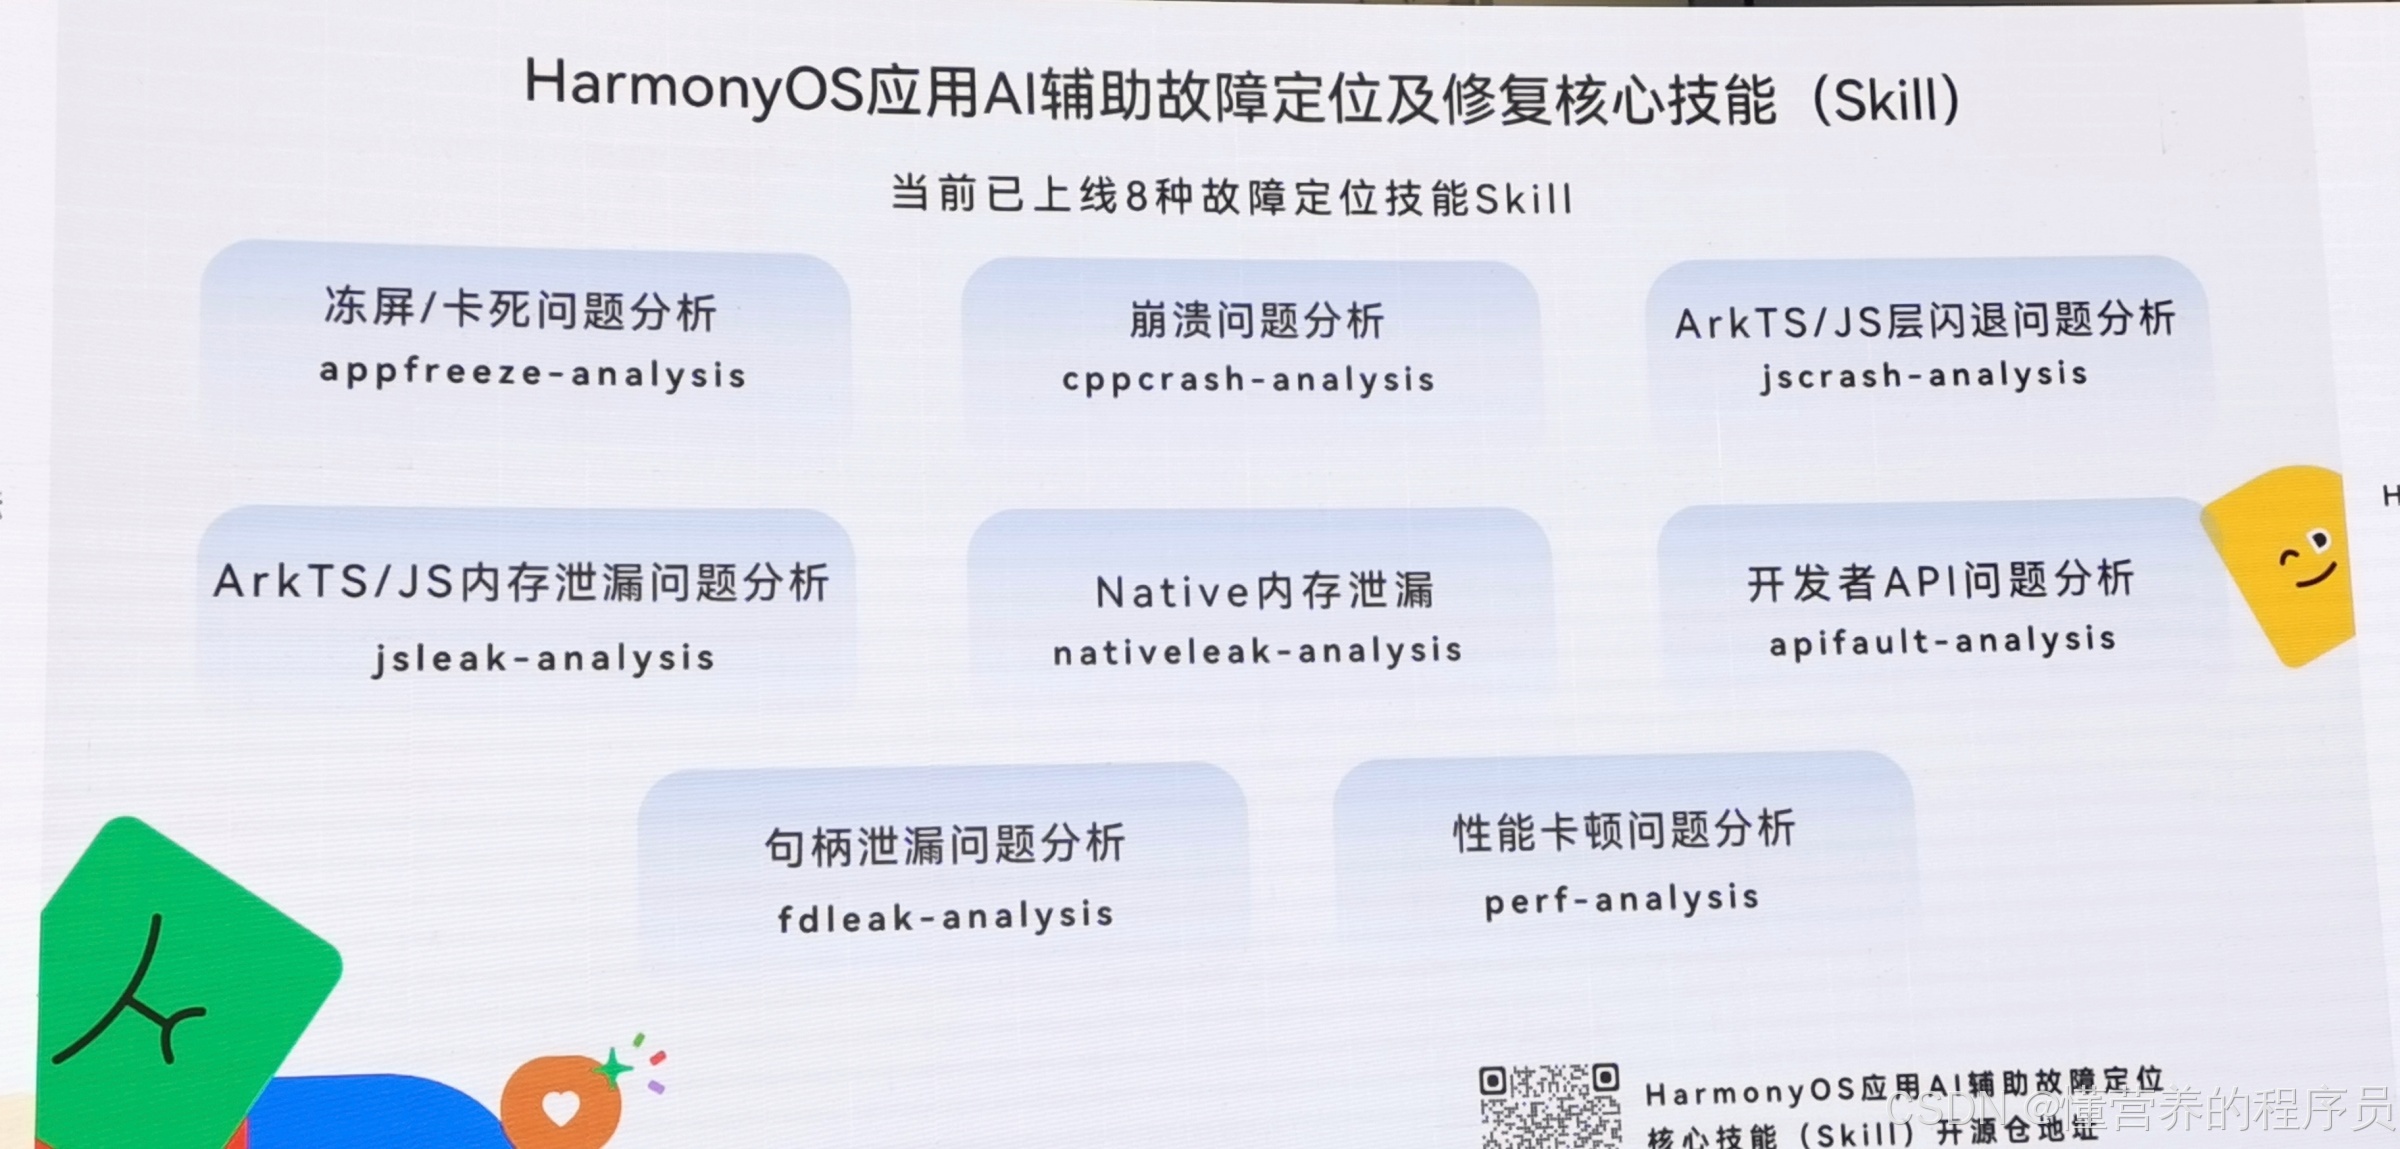
这批 Skill 已在鸿蒙开源社区上架并开源,覆盖了最典型的几类线上问题:
| Skill | 针对问题 |
|---|---|
jscrash-analysis | ArkTS / JS 层闪退问题分析 |
cppcrash-analysis | 崩溃问题分析 |
appfreeze-analysis | 冻屏 / 卡死问题分析 |
apifault-analysis | 开发者 API 问题分析 |
jsleak-analysis | ArkTS / JS 内存泄漏问题分析 |
nativeleak-analysis | Native 内存泄漏问题分析 |
| 另有两类 | 性能卡顿问题分析、句柄泄漏问题分析 |
用法:把日志丢给 Agent
最轻的用法是个人部署:从 Skill 网站下载仓库安装到本地——可以用命令行方式,也可以直接在 Agent 里让它自己装。装完之后 Agent 就能看到这些 Skill。
分析时把日志直接给 Agent,它会调用 Skill 检索并分析。以冻屏案例为例,分析流程是:判断整机资源 → 定位卡死线程 → 对该线程做详细调用栈分析——这套推导顺序与鸿蒙专家定位问题的思路一致,所以结果可用度高。
输出是一份完整报告,包含根因、证据链、整体推导过程、最终结论与修复建议。现场的评价是:这类冻屏问题如果交给 Skill 加模型,基本三五分钟就能搞定;从整体打样的效果看,可以把问题定位从天级压到 5–10 分钟级。
三种部署方式
现场把部署方式归成三类:
- 个人部署:下载到本地开发环境用;
- 企业部署:部署到公司内部平台或线上工单系统,故障发生时由 Agent 自动调用 Skill 分析,再按工作流推送给人确认;
- APMS 平台:应用上架后,在华为的线上质量监控平台上直接一键分析。
四、APMS:线上问题在哪里看、怎么看
APMS 是华为 AppGallery Connect 提供的现网质量监测服务,入口是:AGC 官网 → 开发者与服务 → 选择项目 → 质量 → APMS。
使用路径现场讲得很详细:
- 配置告警规则:应用出问题时按设定方式通知开发者,支持短信、邮件;
- 上架新版本,等待用户使用;
- 故障发现与通知:平台感知问题后主动通知;
- 看趋势:查看问题曲线与详细趋势,评估影响面;
- 进故障详情列表:能看到有多少份故障日志、每份大概是什么样;
- 一键 AI 分析:列表旁的按钮直接在线做分析闭环,拿到修复建议后导入本地模型运行修复。
对已经有自建 AI 平台的团队,现场也给了另一条路:因为能力是原子化的,可以直接把 Skill 部署进公司内部的 AI 工作流——某个伙伴的做法是,线网监测到故障后把问题单交给 Agent,Agent 自动去找问题、调用 Skill 分析、给出修复建议,再像工作流一样推送给人确认。
五、和传统方式比,差在哪
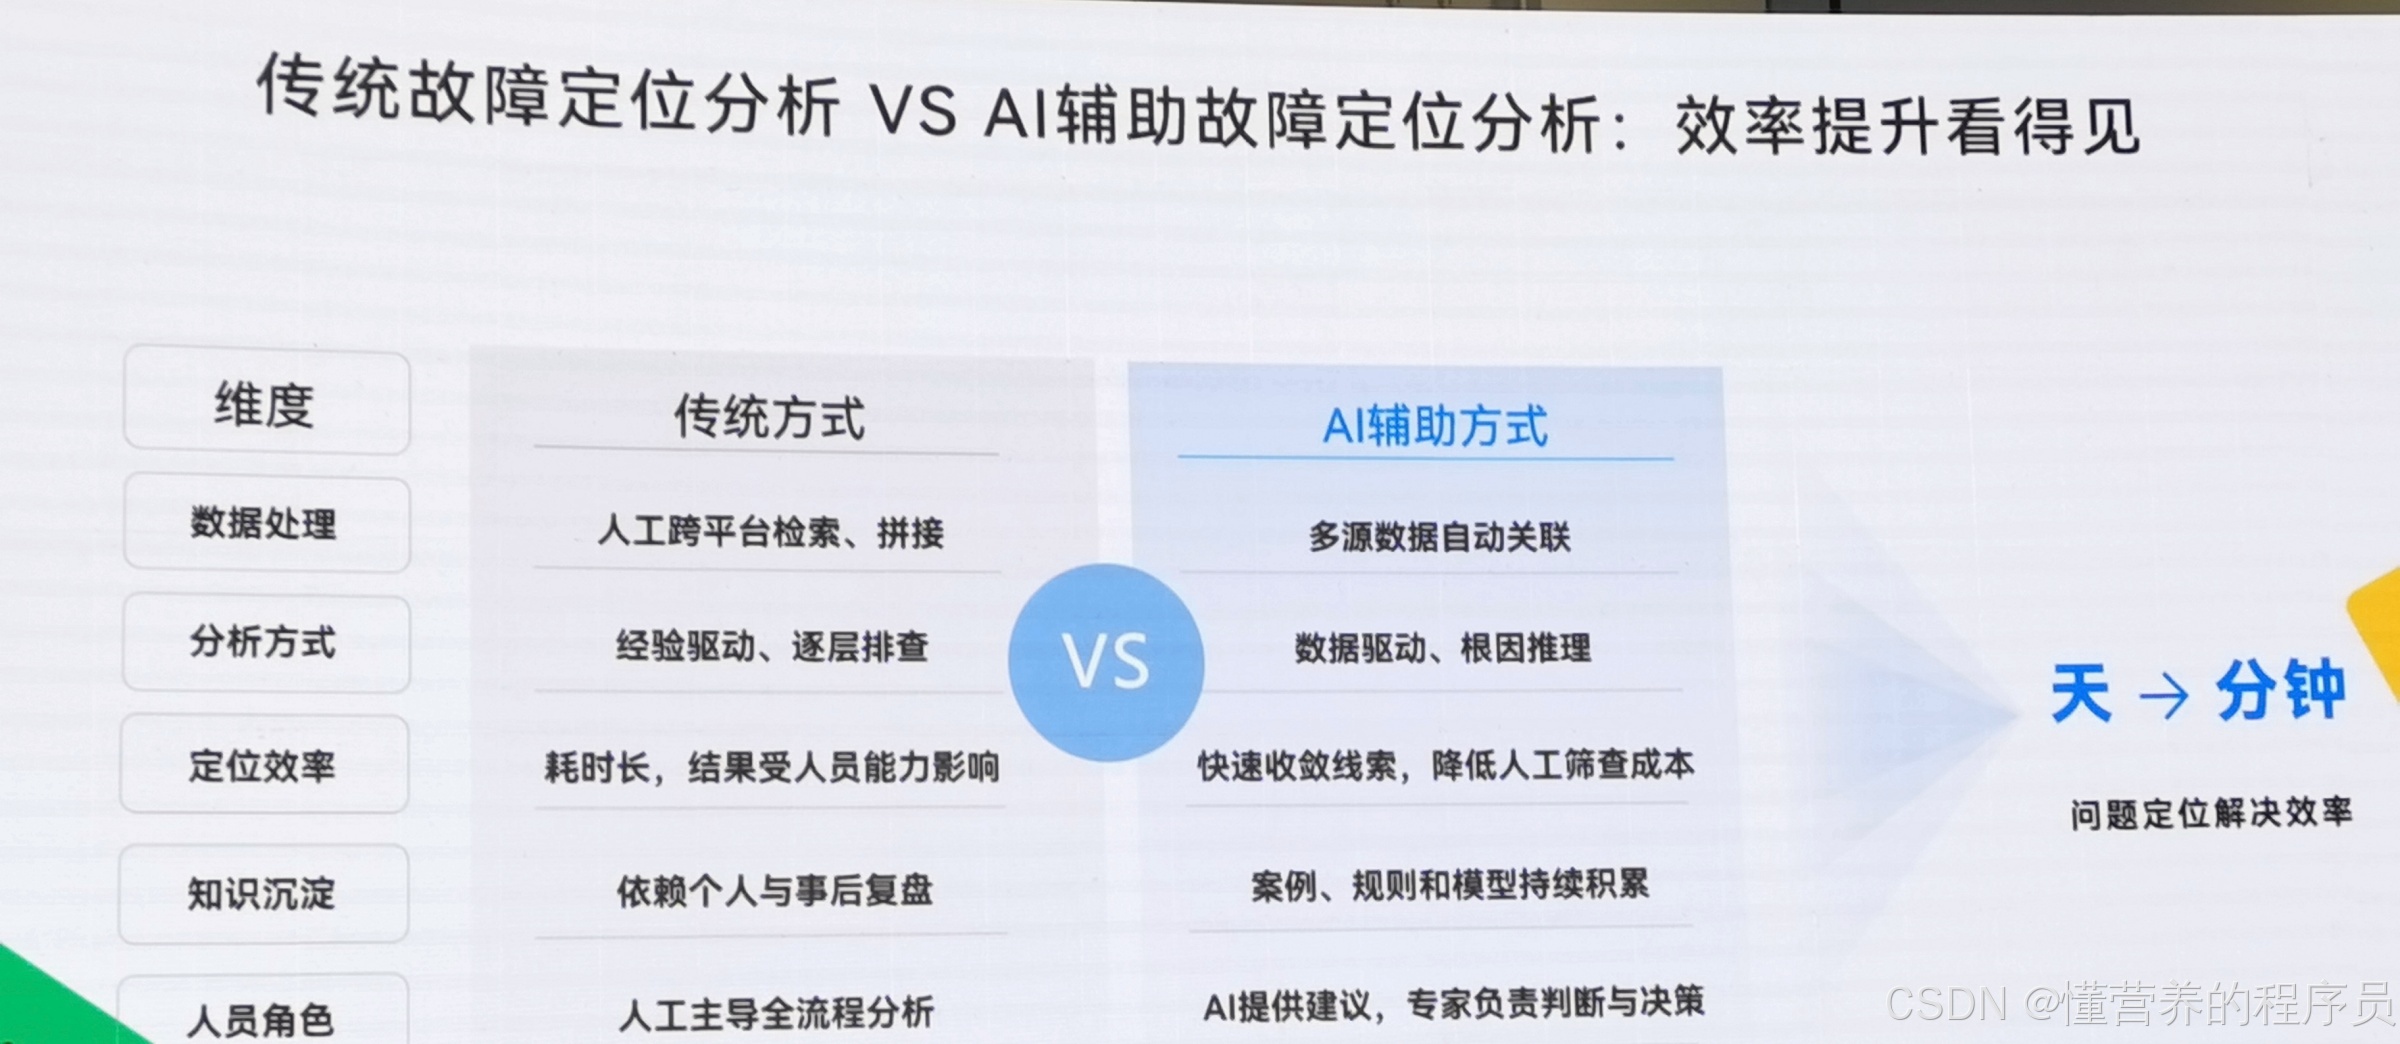
| 维度 | 传统方式 | AI 辅助方式 |
|---|---|---|
| 数据处理 | 人工跨平台检索、拼接 | 多源数据自动关联 |
| 分析方式 | 经验驱动、逐层排查 | 数据驱动、根因推理 |
| 定位效率 | 耗时长,结果受人员能力影响 | 从天级到分钟级 |
| 知识沉淀 | 依赖个人与事后复盘 | 案例、规则与模型持续积累 |
| 人员角色 | 专家负责判断与决策 | 提供建议 |
最后一行是最容易被忽略的收益:过去做不做知识沉淀取决于开发人员愿不愿意多做一步;现在每个问题都会自动留下详细的知识总结,新人也能很快积累经验。
四条优势也一并记下:全流程覆盖(开发态与运行态都能用)、无侵入接入(无需修改业务代码,也无须额外打点,基于已有日志、性能数据、调用链与测试数据开展分析)、低门槛使用、低成本落地(能力可快速复制复用,不需要堆很多专家)。
总结
这场分享的可持续用法有四条:
- 先分清"发现"和"定位"——监控和告警已经足够好,真正的瓶颈在后半段;
- 按问题类型挑 Skill——闪退、崩溃、冻屏、卡死、API 问题、内存泄漏、性能卡顿、句柄泄漏,先对准症状再动手;
- 反馈闭环要留人——整套流程里人工只做两件事:触发与验收,其余尽量交给 Skill 与 Agent,这比"全自动"更现实;
- 顺手把知识沉淀做成默认动作——它不再是良心活,而是流程的副产物。
如果你的应用已经上架并且有线上问题积压,最省力的第一步不是改代码,而是先把告警规则配起来——没有稳定输入,再好的分析链路也跑不动。
关于我
13 年 IT 全栈,.NET、Python、Office 自动化(VSTO/VBA/Python)都做,也做 AI 应用实操(智能体开发),主业是帮企业和团队把重复劳动自动化——报表一键生成、数据对接、文档批量处理、工具定制。
本科物理化学、硕士计算机化学,在一线实验室待过 13 年(9 年制药 + 4 年第三方检测),现在主要服务药企、检测机构和实验室:SOP、合规、样本流、仪器数据接口这些词不用你解释。
这几年做得比较多的是这几类:Office 自动化(VSTO/VBA/Python)工具定制、数据对接与 LIMS 咨询、技术陪跑。
不是外包码农,是听得懂业务的自己人。有同类场景的朋友欢迎评论区聊聊,先聊清楚再动手不迟。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)