
达芬奇架构深度解析:AI Core 的三大计算单元与存储层次
达芬奇架构深度解析:AI Core 的三大计算单元与存储层次
昇腾深度学习技术系列 · 第 2 篇 / 共 20 篇
定位:架构深入 · 阅读时长约 20 分钟
前置阅读:第 1 篇《华为昇腾AI全栈技术概览》
各组件的核心职责:
| 组件 | 核心功能 | 类比角色 |
|---|---|---|
| Cube 计算单元 | 矩阵乘加运算(MAC),AI 算力的核心输出 | 工厂的主力机床 |
| Vector 计算单元 | 向量运算(加减乘除、激活函数、归一化、pooling 等) | 精加工车间 |
| Scalar 计算单元 | 标量运算 + 控制流 + 指令调度 | 车间调度员 |
| MTE(DMA) | 各层 Buffer 之间的数据搬运与格式转换 | 物流传送带 |
为什么用工厂类比? 这个类比贯穿全文:Cube 是产能核心,Vector 负责精细加工,Scalar 统筹调度,MTE 保障物料流转。理解了这个分工,后面每一节的存储路径和流水线设计就都有了直观抓手。
上一篇我们从全栈视角俯瞰了昇腾的技术版图。现在我们下钻到最核心的那层——达芬奇架构(Da Vinci Architecture) 。
达芬奇是华为自研的面向 AI 计算的特定域架构(DSA,Domain Specific Architecture) 。理解这个定位很重要:它不是通用处理器,也不是通用并行加速器,而是专门为神经网络计算量身定制的计算架构。
打一个比方:
- CPU 像是全能工匠,什么都能做,但做每件事都不是最快的;
- GPU 像是几千个小工匠一起干同样的活,吞吐量极大,但灵活性受限;
- AI Core
则像是一条为神经网络精心设计的流水线——矩阵乘法、向量运算、标量控制各自有专属的工位,数据在工位之间高效流转,不多绕一步路。
如果你要做算子开发或者性能调优,理解这套架构不是"锦上添花",而是"基本功"。因为昇腾上的很多编程范式和设计决策,都是直接由架构特性决定的——不理解硬件为什么这样设计,就无法理解软件为什么要这样写。
二、AI Core 总体架构
一个 AI Core 内部包含四大功能组件:
┌──────────────────────────────────────────────────┐
│ AI Core │
│ │
│ ┌───────────┐ ┌───────────┐ ┌───────────┐ │
│ │ Cube │ │ Vector │ │ Scalar │ │
│ │ 矩阵单元 │ │ 向量单元 │ │ 标量单元 │ │
│ └─────┬─────┘ └─────┬─────┘ └─────┬─────┘ │
│ │ │ │ │
│ ┌─────┴──────────────┴──────────────┴─────┐ │
│ │ 存储层次(Buffer 体系) │ │
│ │ L0A / L0B / L0C · UB · L1 · Scalar Buf │ │
│ └─────────────────┬───────────────────────┘ │
│ │ │
│ ┌─────────────────┴───────────────────────┐ │
│ │ MTE(存储转换引擎 / DMA) │ │
│ │ 数据搬运 + 格式转换(padding 等) │ │
│ └─────────────────────────────────────────┘ │
│ │
│ ┌─────────────────────────────────────────┐ │
│ │ 控制单元(指令调度) │ │
│ └─────────────────────────────────────────┘ │
└──────────────────────────────────────────────────┘
各组件的核心职责:
| 组件 | 核心功能 | 类比角色 |
|---|---|---|
| Cube 计算单元 | 矩阵乘加运算(MAC),AI算力的核心输出 | 工厂的主力机床 |
| Vector 计算单元 | 向量运算(加减乘除、激活函数、归一化、pooling等) | 精加工车间 |
| Scalar 计算单元 | 标量运算 + 控制流 + 指令调度 | 车间调度员 |
| MTE(DMA) | 各层Buffer之间的数据搬运与格式转换 | 物流传送带 |
关键设计哲学:三种计算单元各司其职,形成三条独立的执行流水线,可以并行工作。这不是简单的功能划分,而是一种深思熟虑的异构协作设计——神经网络中 80%+ 的算力集中在矩阵乘法,Cube 专注于此;剩余的逐元素操作(激活、归一化等)交给 Vector;标量运算虽然算力最弱,但负责控制整个流水线的节奏。
三、三大计算单元深度解析
3.1 Cube 计算单元——矩阵计算的核心引擎
Cube 是整个 AI Core 中算力最强的单元,也是昇腾区别于通用处理器的根本所在。
核心能力
Cube 的设计目标非常明确:高效执行矩阵乘加运算。深度学习中最核心的计算就是矩阵乘法——全连接层、卷积层(im2col 之后)、注意力机制的 QKV 计算,本质上都是大矩阵乘。
一次 Cube 指令的执行能力:
| 输入精度 | 矩阵运算说明 |
|---|---|
| FP16 | C = A × B,其中 A 为 16×16,B 为 16×16,输出 C 为 16×16 |
| INT8 | C = A × B,其中 A 为 16×32,B 为 32×16,输出 C 为 16×16 |
换句话说,一条 Cube 指令就能完成一整块矩阵的乘法。
内部结构:256 个并行子电路
Cube 内部并不是一个黑盒,而是由 256 个矩阵计算子电路 并行组成。当一条 Cube 指令发射时,这 256 个子电路同时工作,每个子电路计算结果矩阵 C 的一个元素。
对于 FP16 的 16×16 × 16×16 矩阵乘:结果矩阵 C 有 256 个元素,恰好由 256 个子电路各算一个。这意味着一条指令一个周期就能算完整个矩阵乘——这就是 Cube 恐怖的算力来源。
用数字说话:假设 AI Core 主频 1.8GHz,每个周期一条 Cube 指令完成 256 个乘加对(每个乘加对算 2 FLOP),则单核 Cube 的峰值算力为:
256 × 2 × 1.8 GHz = 921.6 GFLOPS(FP16)
一颗 910B 芯片有 24 个 AIC 核,理论 Cube 峰值算力约为 22.1 TFLOPS FP16。
数据来源与输出路径
Cube 计算时,数据的来源和去向是固定的:
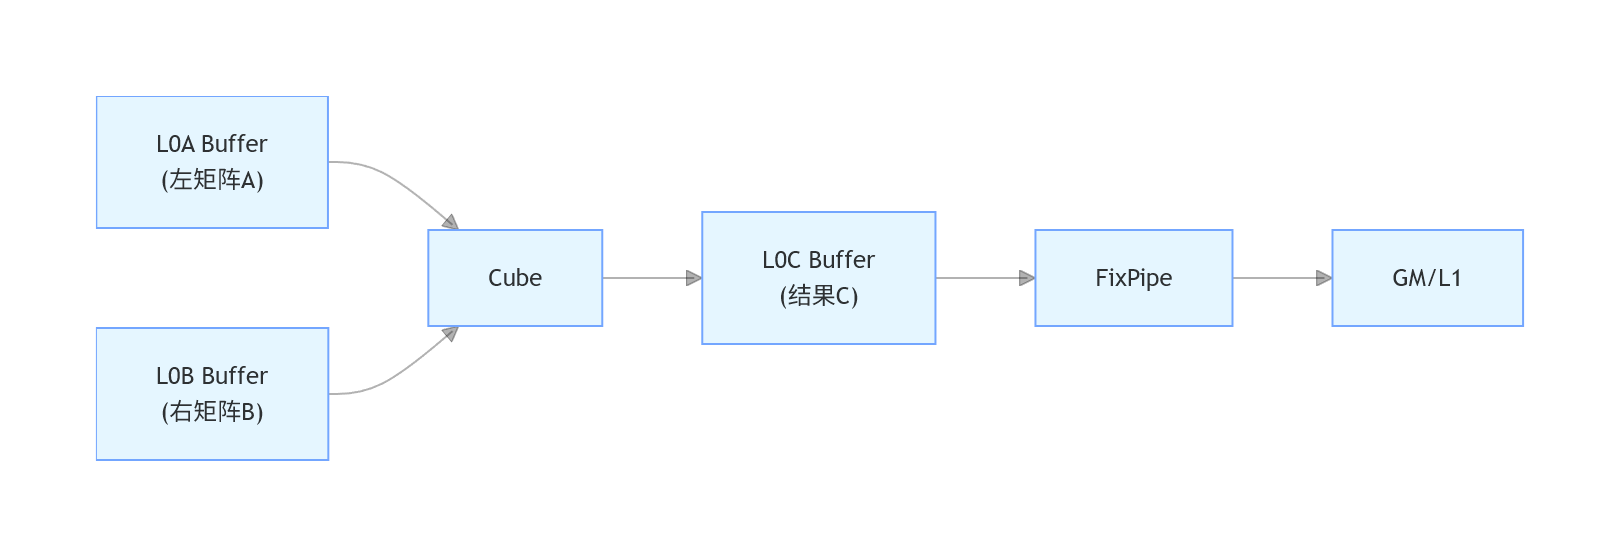
- 矩阵 A(左矩阵):从 L0A Buffer 读取
- 矩阵 B(右矩阵):从 L0B Buffer 读取
- 结果 C:写入 L0C Buffer(L0C 也用于存储中间累加结果
)
这种固定映射关系不是限制,而是优势——编译器可以精确地预知数据路径,提前做好搬运调度,不需要运行时动态决策。
精度支持演进
| 架构版本 | 支持的精度 | 备注 |
|---|---|---|
| arch22(910B/910C) | FP16, INT8, UINT8, U2 | - |
| arch35(950PR/950DT) | FP16, INT8, UINT8, U2, FP8, MXFP8, MXFP4 | 低精度计算大幅增强 |
arch35 新增的 FP8/MXFP8/MXFP4 支持意义重大:在大模型训练中,FP8 混合精度训练已成为主流趋势,相比 FP16 训练,显存占用减半、计算吞吐翻倍,而精度损失可控。
3.2 Vector 计算单元——灵活的向量处理器
如果说 Cube 是重火力武器,那 Vector 就是多面手。它处理的是 Cube 不擅长(或者说做不了)的那些计算。
SIMD 执行模型
Vector 单元采用经典的 SIMD(Single Instruction, Multiple Data,单指令多数据) 执行模型:
- 一条指令同时对多个数据执行相同的运算
- 类比:一条命令下去,整排工人同时做同样的动作
典型应用场景:
- 逐元素运算:向量加、减、乘、除(ReLU 本质上就是逐元素操作)
- 激活函数:ReLU、GELU、Sigmoid、Tanh 等
- 归一化:LayerNorm、BatchNorm、RMSNorm 的核心计算
- Pooling:MaxPool、AvgPool
- 数学函数:倒数(reciprocal)、平方根(sqrt)、指数(exp)、对数(log)等 比较与选择:元素比较、条件选择(where)
与 Cube 的互补关系
一个典型的 Transformer 层中,计算大致分为两部分:
- Q·K^T 的矩阵乘法 → 交给 Cube
- Softmax、LayerNorm、残差加法 → 交给 Vector
两者协同完成整个层的计算。Vector 单元的计算强度虽不如 Cube,但其灵活性远超 Cube——几乎任何逐元素的标量运算,Vector 都能处理。
数据约束
Vector 单元有一个重要约束:所有参与运算的数据必须存储在 Unified Buffer(UB)中。
此外,还有对齐要求:
- 数据首地址必须 32 字节对齐
- 操作长度必须 32 字节对齐
这些约束源于 SIMD 硬件的实现方式:Vector 单元的数据通路宽度固定,必须按对齐要求存取数据才能保证效率。违反对齐要求会导致额外的数据重组开销,严重时可能导致性能下降。
高级特性
Vector 单元支持一些高级执行模式:
- 多次迭代执行:一条指令可以指定迭代次数,自动循环处理多块数据
- 带间隔的向量运算:支持非连续的数据访问模式(stride access),减少数据搬运量
这些特性在实际算子开发中非常有用。比如一个分块的 LayerNorm 计算,可以用迭代模式一次指令处理多个分块,减少指令发射开销。
3.3 Scalar 计算单元——AI Core 的"大脑"
Scalar 是三大计算单元中算力最弱的,但在某种意义上却是最重要的——它负责整个 AI Core 的指挥调度。
核心职责
Scalar 的功能类似于一个小 CPU,通过标准 ALU 执行标量运算。但它的主要工作不是"算数",而是"调度":
| 功能 | 职责说明 |
|---|---|
| 指令发射 | 从指令流中取出指令,分发给 Cube/Vector/MTE |
| 循环控制 | 管理算子中的循环结构(for、while) |
| 分支判断 | 执行 if/else 等条件逻辑 |
| 地址计算 | 为 Cube 和 Vector 指令计算操作数地址和参数 |
| 同步控制 | 通过事件同步模块插入同步符,控制各单元的执行顺序 |
| 基本算术 | 在 GPR 上执行标量的加减乘除 |
一句话总结:Scalar 是指挥官,不是战斗员。
指令调度机制
Scalar 读取指令序列后,按指令类型分发到三条独立的指令队列:
┌─── M 队列 ──→ Cube 指令
│
指令流 ──→ Scalar ──────┼─── V 队列 ──→ Vector 指令
│
└─── DMA 队列 ──→ MTE 搬运指令
关键规则:
- 同一队列内:指令顺序执行
- 不同队列间:指令可以并行执行
这意味着 Cube 在做矩阵乘的同时,Vector 可以做向量运算,MTE 可以同时搬运下一批数据——只要 Scalar 提前把指令安排好。
存储资源
Scalar 拥有自己独立的缓存体系:
| 缓存名称 | 容量 | 说明 |
|---|---|---|
| ICache | 16KB 或 32KB | 缓存代码段(指令),以 2KB 为单位从 L2 加载 |
| DCache | 16KB | 缓存数据段,cacheline 大小 64 字节 |
性能瓶颈与编程建议
Scalar 的性能相对较弱,这意味着:
编程时应尽量减少 Scalar 的计算负担。
具体建议:
- 尽量减少 if/else 分支,特别是循环内的条件判断
- 尽量用 Vector 指令替代 Scalar 的循环展开
- 地址计算尽量规整,避免复杂的索引运算
- 将标量运算和向量运算合并,减少指令发射次数
Scalar 的瓶颈也是架构设计哲学的体现:DSA 不需要一个强大的标量单元,因为神经网络的计算主体是矩阵和向量运算。Scalar 只需要足够"聪明"地调度其他单元就好。
四、存储层次详解
深度学习的性能瓶颈往往不在计算,而在访存。数据搬得不够快、搬的路线不够好,计算单元就会"饿着"。达芬奇架构的存储层次设计,就是围绕"让数据尽量靠近计算单元"这个目标展开的。
4.1 完整存储层次表
| 存储单元 | 描述 | 典型用途 | 对应逻辑位置 |
|---|---|---|---|
| MTE | 存储转换引擎(Memory Transfer Engine),负责 Buffer 间数据搬运和格式转换 | padding、transpose、Img2Col 等数据重排 | — |
| BIU | 总线接口单元(Bus Interface Unit),AI Core 与外部总线的交互出入口 | 与 HBM/L2 的数据交换 | — |
| L1 Buffer | 通用内部存储,大数据中转区 | 减少对外部总线的读写次数,Cube 数据的"前厅" | A1 / B1 |
| L0A Buffer | Cube 指令的左矩阵输入缓存 | 存放矩阵 A | A2 |
| L0B Buffer | Cube 指令的右矩阵输入缓存 | 存放矩阵 B | B2 |
| L0C Buffer | Cube 指令输出缓存,累加时也是输入 | 存放矩阵乘结果 C | CO1 |
| Unified Buffer (UB) | 统一缓冲区,向量和标量计算的数据池 | Vector 的输入(VECIN)、输出(VECOUT)、中间结果(VECCALC) | VECIN / VECOUT / VECCALC |
| Scalar Buffer | 标量计算通用缓冲区 | GPR 不足时的补充存储 | — |
| GPR | 通用寄存器(General Purpose Registers) | 标量计算的输入输出 | — |
| SPR | 专用寄存器(Special Purpose Registers) | 修改 AI Core 的计算行为(如同步、中断等) | — |
| BT Buffer | Bias Tile Buffer(分离架构独有) | 存放 Bias 数据 | — |
| FP Buffer | Fixpipe Buffer(分离架构独有) | 存放量化参数、ReLU 参数等 | — |
4.2 三类存储的本质区别
理解这些存储单元,可以从"对程序员是否可见"这个维度来分类:
┌─────────────────────────────────────────────────┐
│ 对程序员透明 │
│ (硬件自动管理,不需要手动控制) │
│ ICache · DCache · L2 Cache │
├─────────────────────────────────────────────────┤
│ 对程序员可见 - Buffer │
│ (需要手动管理数据搬运和生命周期) │
│ UB · L1 Buffer · L0A/B/C · Scalar Buffer │
│ BT Buffer · FP Buffer │
├─────────────────────────────────────────────────┤
│ 对程序员可见 - Register │
│ (最快、最少,直接参与计算) │
│ GPR · SPR │
└─────────────────────────────────────────────────┘
Cache vs Buffer vs Register:
- Cache:对程序员透明,硬件自动管理替换策略。ICache 缓存指令、DCache 缓存标量数据、L2 Cache 是多 AI Core
共享的全局缓存。 - Buffer:对程序员可见,需要开发者(或编译器)显式管理数据的搬运和驻留。这是达芬奇架构的一大特色——不像 GPU 用 Cache
层次来隐藏访存,昇腾让你"看到"并"控制"每一层存储。 - Register:最快但也最少,GPR 用于标量运算的操作数,SPR 用于控制 AI Core 的行为。
4.3 910B vs 950 存储规格对比
| 存储参数 | 910B(Atlas A2,arch22) | 950PR/950DT(Atlas A5,arch35) | 变化趋势 |
|---|---|---|---|
| AIC 核数 | 24 | 32(满 die) | ↑ 33% |
| AIV 核数 | 48 | 64(满 die) | ↑ 33% |
| L0C | 128 KB | 256 KB | ↑ 100% |
| UB | 192 KB | 256 KB | ↑ 33% |
| L2 Cache | 192 MB | 128 MB | ↓ 33% |
| 主频 | 1.8 GHz | 1.65 GHz | ↓ 8% |
几个值得注意的变化:
- L0C 翻倍:更大的 Cube 结果缓存意味着可以处理更大的矩阵分块,减少中间结果写回 L1 的次数,对大矩阵运算性能提升显著。
- UB 增大 33% :Vector 计算有更多的工作空间,可以一次处理更大的数据块。
- L2 Cache 反而缩小:这是因为架构设计上将更多存储资源分配给了核内 Buffer(L0C、UB),让数据更靠近计算单元。L2
虽然容量减小,但访问效率和带宽可能有所优化。 - 主频下降:从 1.8GHz 降到 1.65GHz,但通过更大的核数和更高的每周期效率来弥补,整体算力反而提升。
4.4 数据流路径
不同计算单元的数据流路径不同,理解这些路径对于算子性能优化至关重要:
Vector 计算的数据流:
GM(Global Memory / HBM)
│ MTE 搬入
▼
UB(VECIN 位置)
│ Vector 计算
▼
UB(VECOUT 位置)
│ MTE 搬出
▼
GM
Cube 计算的数据流(完整路径):
GM
│ MTE 搬入 + 格式转换
▼
L1 Buffer(A1/B1,数据中转)
│ MTE 搬入
▼
L0A Buffer / L0B Buffer
│ Cube 矩阵乘
▼
L0C Buffer
│ FixPipe 后处理(量化/反量化/Bias 加等)
▼
GM(或写回 L1 作为中间结果)
Cube 计算的中间结果路径:
GM → L1 → L0A/L0B → [Cube] → L0C → FixPipe → L1(中间结果,下一步继续使用)
注意 FixPipe(固定管线)在 Cube 输出之后的位置——它可以在数据写回之前完成量化、反量化、Bias 加、ReLU 激活等操作,避免数据绕一圈回 Vector 单元再处理。这在分离架构中对应 BT Buffer 和 FP Buffer 的功能。
五、控制单元与执行流水线
5.1 三条并行流水线
三大计算单元 + MTE 构成了三条独立的执行流水线,可以异步并行工作:
| 流水线类型 | 颜色 | 功能 | 执行内容 |
|---|---|---|---|
| 指令流 | 蓝色 | Scalar 发射指令到各单元 | 取指→译码→分发 |
| 同步流 | 绿色 | Scalar 下发同步指令 | 保证执行顺序和数据依赖正确 |
| 数据流 | 红色 | DMA 搬入 → 计算 → DMA 搬出 | 实际的数据搬运和计算 |
5.2 同步机制
并行计算的关键挑战是同步——如果 Cube 还在算,数据就被 MTE 搬走了,结果就会出错。
昇腾的同步机制由 Scalar 单元通过事件同步模块实现:
- Scalar 在发射指令时,会插入同步标记(barrier/sync event)
- 各执行单元在遇到同步标记时会等待前序操作完成
- 合理的同步点设置是性能优化的关键:同步太少会出错,同步太多会降低并行度
5.3 异步并行计算过程
一个典型的 AI Core 计算过程:
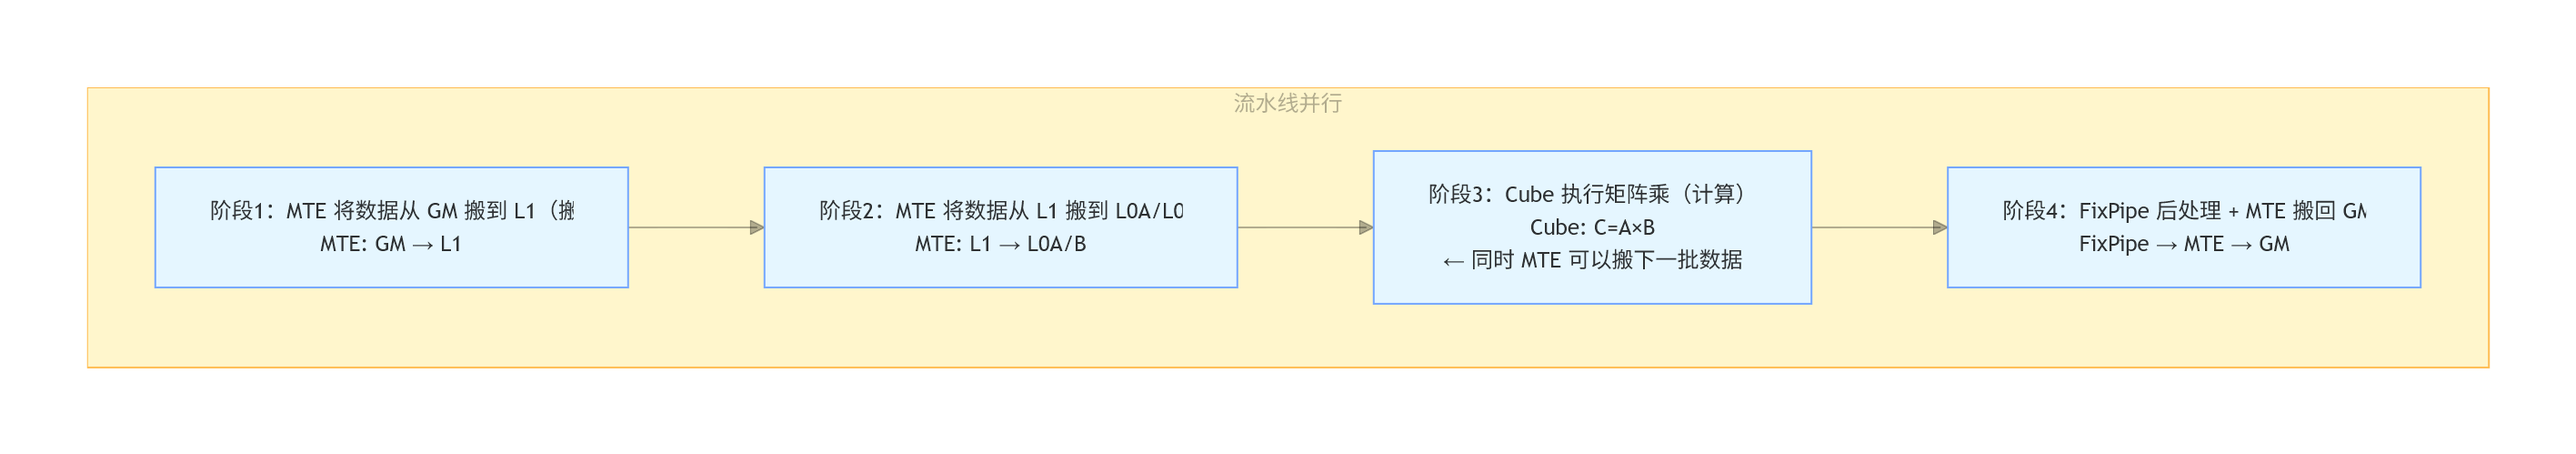
理想状态下,多个阶段可以流水重叠,让计算单元不空闲、搬运单元不空闲。
六、耦合架构 vs 分离架构
达芬奇架构在不同代产品中采用了两种不同的物理部署方式,这对编程模型有直接影响。
6.1 耦合架构(Coupled Architecture)
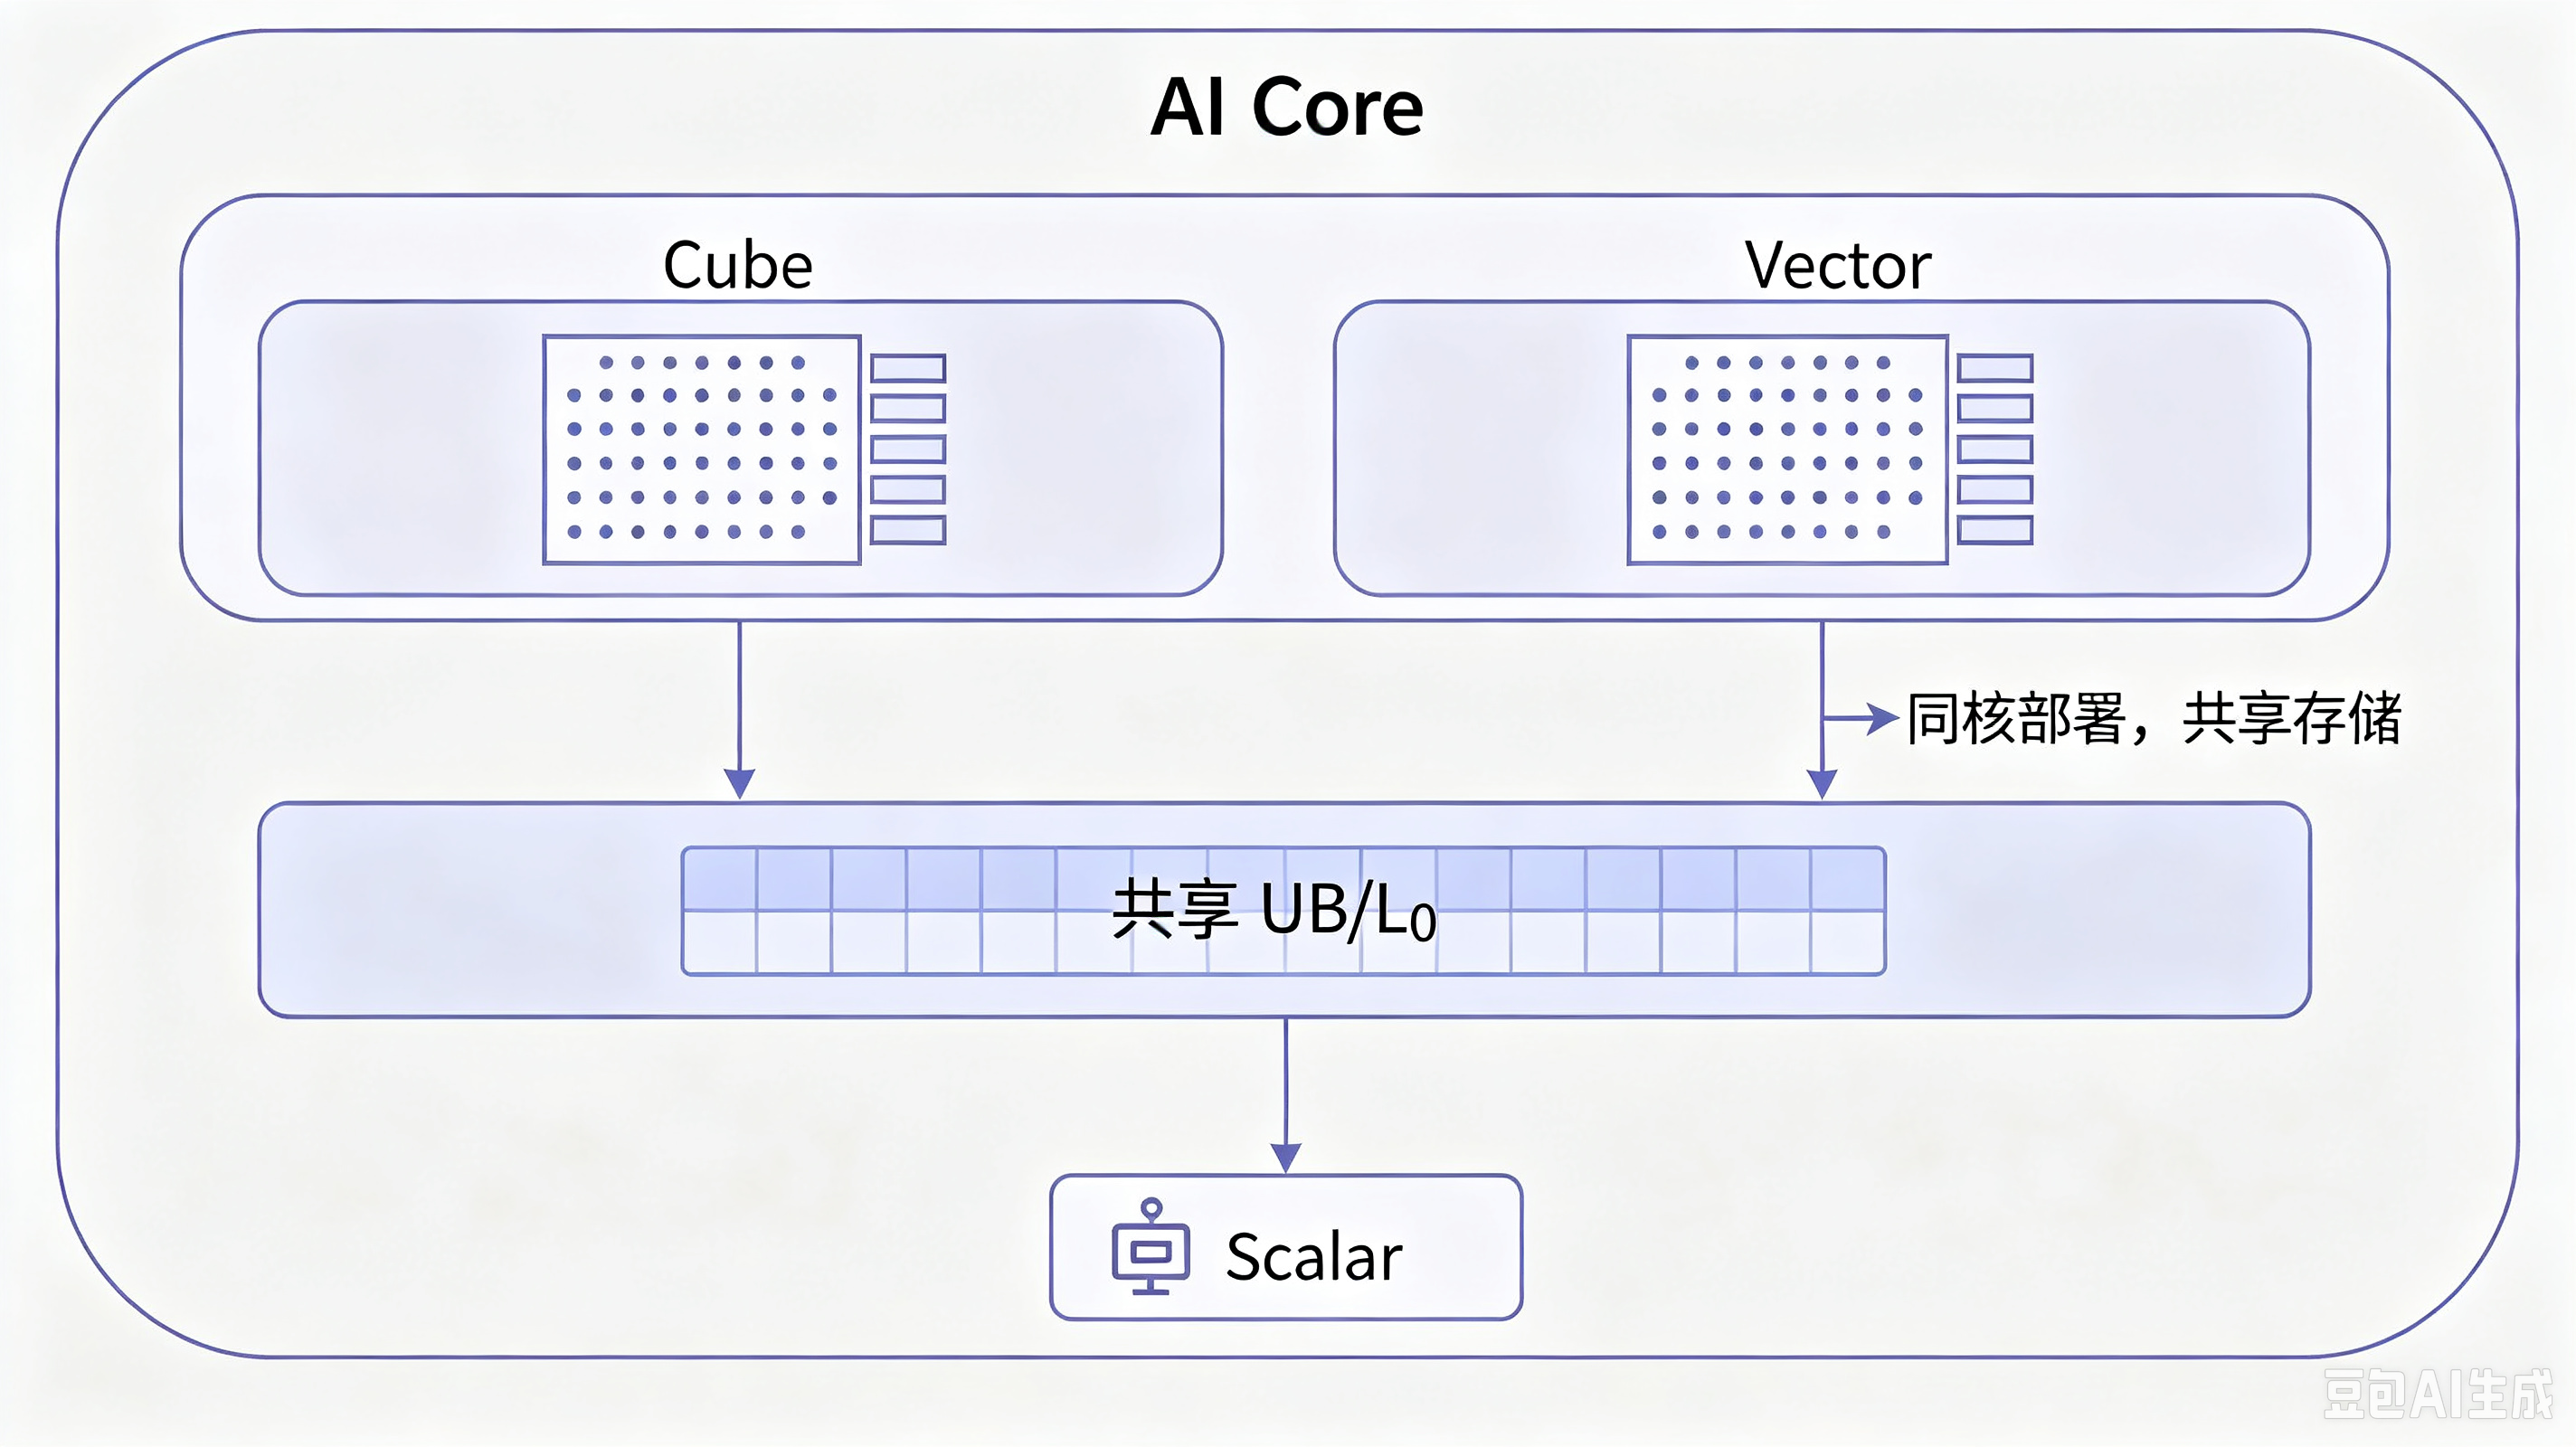
特点:
- Cube 和 Vector 部署在同一个核内
- 共享存储资源(如 UB),数据交互在核内完成,不需要经过外部总线
- 数据交换延迟低、带宽高
应用产品:
- Atlas 推理系列(Ascend 310)
- Atlas 训练系列早期产品
- Atlas 200I / 500 A2
6.2 分离架构(Separated Architecture)
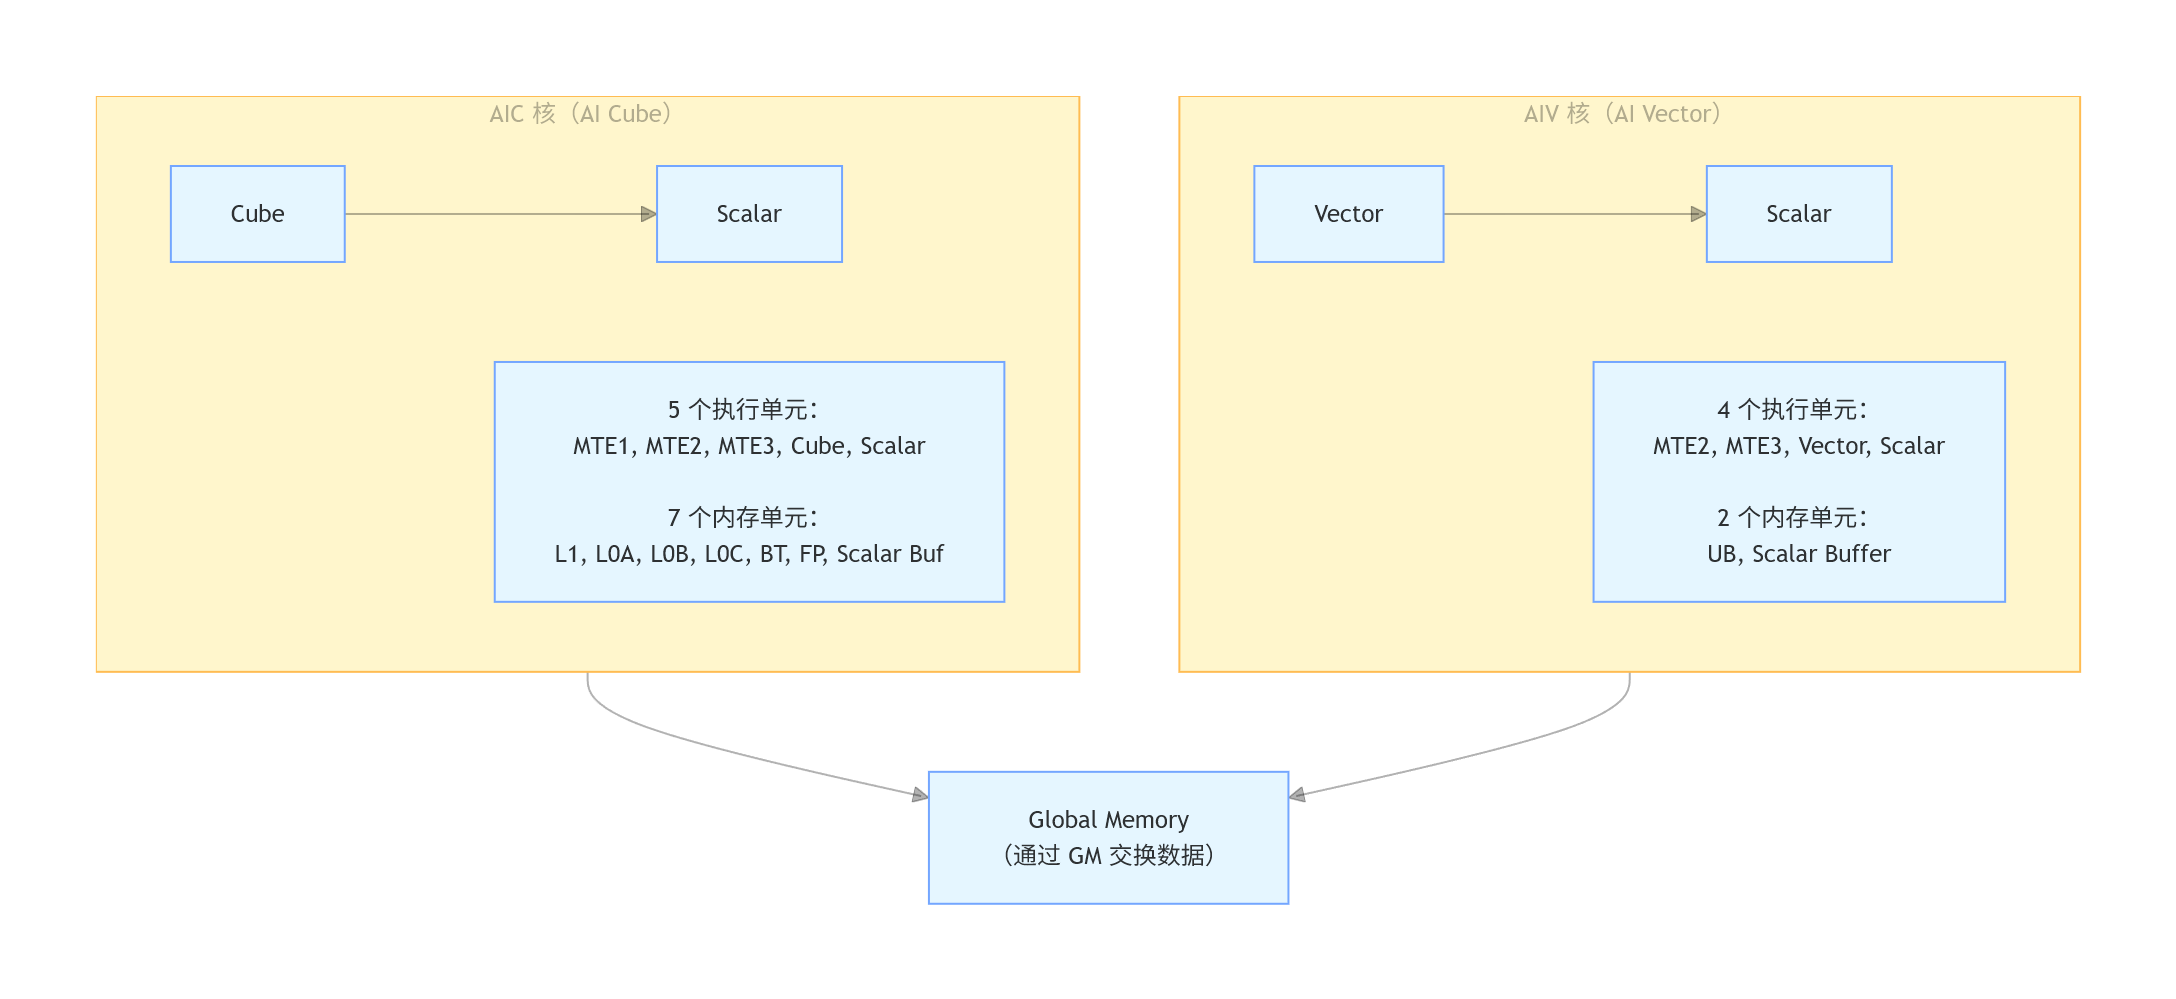
特点:
- AI Core 被拆分为 AIC(AI Cube) 和 AIV(AI Vector) 两个独立核
- 各自拥有独立的 Scalar 单元,能独立加载代码段
- AIV 与 AIC 之间必须通过 Global Memory(GM) 传递数据
- 增加了 BT Buffer(Bias 数据)和 FP Buffer(量化/ReLU 参数等 FixPipe 参数)
应用产品:
- Atlas A2 训练系列(Ascend 910B)
- Atlas 800I A2
6.3 两种架构的对比
| 维度 | 耦合架构 | 分离架构 |
|---|---|---|
| Cube/Vector 关系 | 同核部署 | 异核分离(AIC/AIV) |
| 数据交互方式 | 核内共享存储 | 通过 Global Memory |
| Scalar 数量 | 1 个 | 2 个(各自独立) |
| 代码段加载 | 统一加载 | 各自独立加载 |
| Cube 核内数据交换延迟 | 低 | 高(需经 GM) |
| 独立调度灵活性 | 有限 | 高(可独立执行不同任务) |
| 典型产品 | Atlas A2(910B) | Atlas 推理系列、Atlas 200I/500 A2、Atlas 800I A2 |
分离架构的设计哲学是** specialization**:让 Cube 核专注矩阵乘,让 Vector 核专注向量运算,各自优化到极致。代价是数据交互必须经过 GM,增加了搬运开销。但在大模型训练场景下,Cube 核的利用率大幅提升,整体收益显著。
七、编程范式
理解了硬件架构,接下来看它如何映射到编程模型。昇腾上的算子编程(Ascend C)有几种核心范式。
7.1 Vector 编程范式——三阶段流水线
Vector 计算遵循经典的三阶段流水线模型:
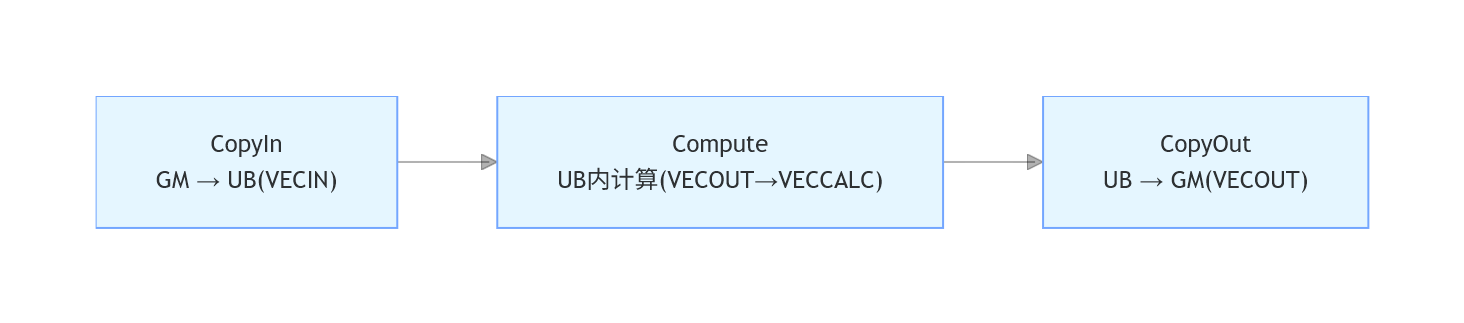
CopyIn:将输入数据从 GM 搬运到 UB 中的 VECIN 位置
Compute:从 UB 中取数据执行计算,结果写入 UB 中的 VECOUT(或 VECCALC 中间区域)
CopyOut:将结果从 UB 搬运回 GM
通过 Queue(队列)完成任务间的数据通信和同步。多个执行单元可以异步并行处理数据的不同分片——就像工业流水线一样,上游在做下一块数据的搬运时,下游在算当前块的结果。
7.2 Cube 编程范式
Cube 的数据路径更复杂,涉及多级 Buffer:
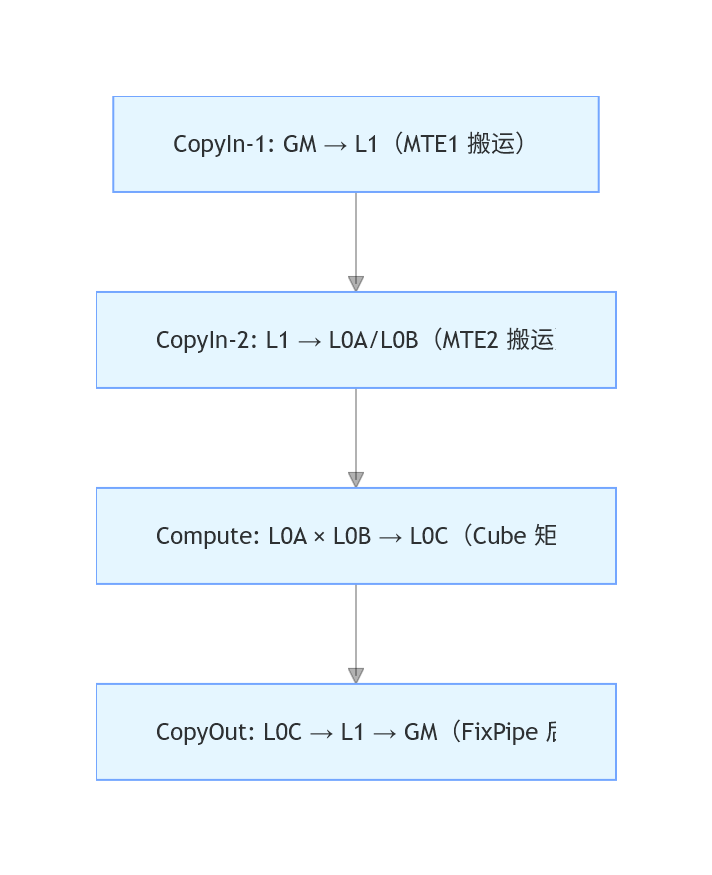
Cube 的流水线比 Vector 多了一个 L1 中转层,这是因为 Cube 需要的输入数据量更大(两个完整矩阵),需要更大的缓冲空间。
7.3 融合算子编程范式
融合算子(Fused Operator) 是昇腾编程中非常重要的优化手段:
将多个逻辑上的算子融合在一个 AI Core 核函数中执行。
例如,一个常见的模式是 MatMul + Bias + ReLU:
- 不融合:MatMul → 写回 GM → 读入 → Bias 加 → 写回 GM → 读入 → ReLU → 写回 GM
- 融合:MatMul → L0C → FixPipe(Bias + ReLU)→ 一次写回 GM
融合的好处:
- 减少数据搬运次数(GM 读写大幅减少)
- 减少 kernel launch 开销
- 提升数据局部性
但融合的代价是代码复杂度增加,需要仔细管理多级 Buffer 的生命周期。
7.4 双缓冲(Double Buffer)技术
双缓冲是提升流水线效率的关键技术:
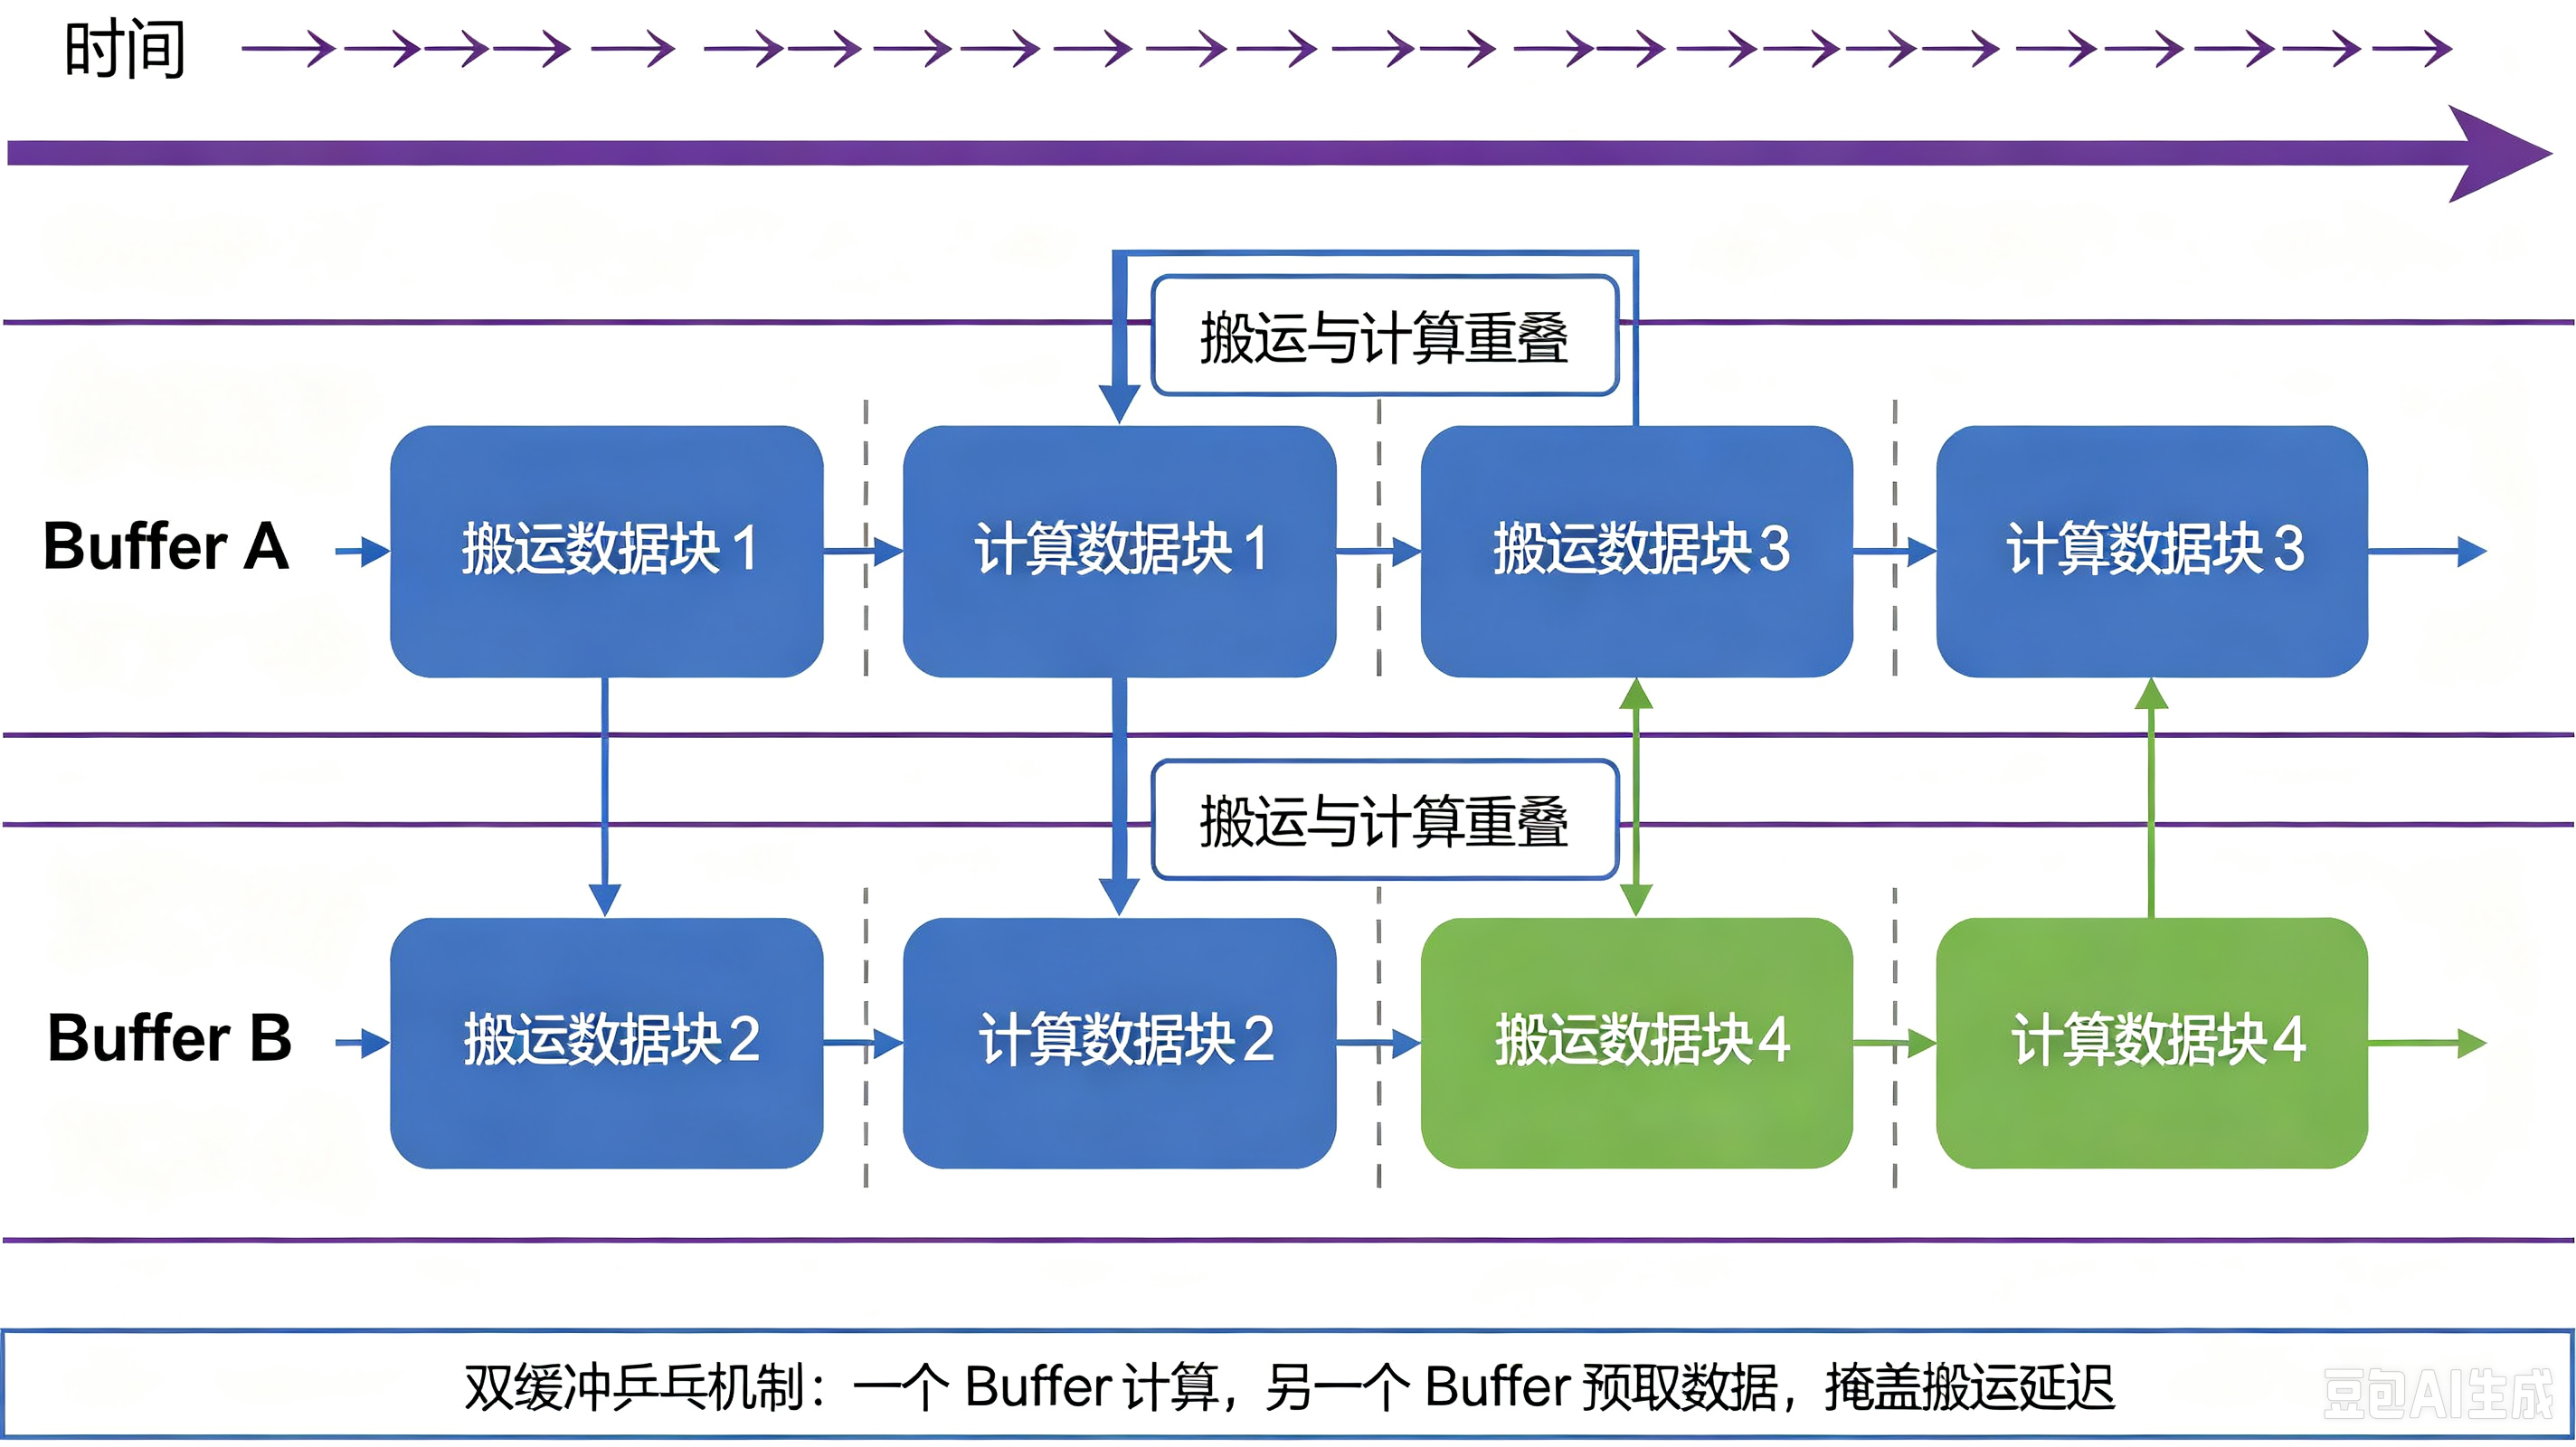
- 当一组 Buffer 正在被计算单元使用时,另一组 Buffer 同时进行数据搬运
- 计算和搬运在时间上重叠,互相隐藏延迟
- 这是达芬奇架构 MTE 与计算单元可以并行的直接体现
双缓冲的思想可以推广到多缓冲(Multi-Buffer) ,但 Buffer 空间有限(UB 在 910B 上只有 192KB),实际使用时需要在并行度和存储占用之间做权衡。
八、从 arch22 到 arch35 的架构演进
arch35 是昇腾架构演进中最重要的一次跃迁,核心变化是从纯 SIMD 模式进入了 SIMD + SIMT 双模。
8.1 全面规格对比
| 维度 | arch22(910B / 910C) | arch35(950PR / 950DT) |
|---|---|---|
| NPU_ARCH 宏值 | 2201 | 3510 |
| 编程模型 | SIMD only | SIMD + SIMT 双模 |
| Cube 核数(AIC) | 24 | 32(满 die) |
| Vector 核数(AIV) | 48 | 64(满 die) |
| L0C 容量 | 128 KB | 256 KB |
| UB 容量 | 192 KB | 256 KB |
| L2 Cache | 192 MB | 128 MB |
| 主频 | 1.8 GHz | 1.65 GHz |
| FP8 / MXFP8 / MXFP4 | 不支持 | 支持 |
| 编译路径 | BUILD_MODE=c220, arch22 | arch35 |
8.2 SIMD → SIMD+SIMT 双模的意义
这是 arch35 最核心的架构升级,值得展开讲。
SIMD(Single Instruction, Multiple Data) :
- 所有线程执行完全相同的指令
- 数据不同,但操作相同
- 非常适合矩阵乘、向量加减这类规整计算
- 缺点:遇到分支(if/else)时,所有线程必须等待最慢的分支执行完毕
SIMT(Single Instruction, Multiple Threads) :
- 每个线程可以走不同的分支路径
- 类似 GPU 的执行模型
- 适合复杂控制流:条件分支、动态循环、不规则数据访问
- 缺点:线程发散(divergence)会导致部分线程空闲
双模的意义:
| 算子类型 | SIMD 表现 | SIMT 表现 | 双模优势 |
|---|---|---|---|
| 矩阵乘法 | ★★★★ | ★★★★★ | 用 SIMD 模式,发挥最大吞吐 |
| LayerNorm | ★★★★★ | ★★★ | SIMD 模式足够 |
| MoE 路由 | ★★ | ★★★★★ | SIMT 模式处理动态分支 |
| 动态稀疏计算 | ★★ | ★★★★★ | SIMT 模式处理不规则访问 |
| 条件激活(如 Gated Linear Unit) | ★★★ | ★★★★★ | SIMT 模式减少分支浪费 |
大模型时代带来了越来越多的"非规整"算子——MoE(Mixture of Experts)的路由层、动态稀疏注意力、各种 Gating 机制——这些算子包含大量条件分支和不规则数据访问,纯 SIMD 处理效率很低。SIMT 模式让昇腾能高效处理这些算子,大幅拓宽了架构的适用范围。
8.3 950 系列的其他架构创新
除了编程模型升级,arch35 还有几个重要的技术改进:
- 内存访问颗粒度优化
从 512 字节降至 128 字节。这意味着:
-
更细粒度的内存访问,减少不必要的数据搬运
-
带宽利用率提升 30%+
-
对于小规模数据搬运(如标量、小向量)效率改善尤为明显
-
PD 分离架构(Prefill / Decode 分离)
大模型推理有两个阶段: -
Prefill 阶段:一次性处理所有输入 token,计算密集
-
Decode 阶段:逐个生成输出 token,访存密集
950 系列支持将这两个阶段分配到不同的芯片上:
- 950PR(Prefill):128GB HBM,1.6 TB/s 带宽,FP8 算力 1 PFLOPS
- 950DT(Decode/Training):144GB HBM,4 TB/s 带宽,FP4 算力 2 PFLOPS
这种差异化设计让推理延迟降低约 50% ,是系统级优化与芯片架构协同设计的典范。
- 自研 HBM
950 系列是昇腾首款采用华为自研 HBM 芯片的产品,摆脱了对外部 HBM 供应商的依赖。这在当前全球 HBM 产能紧张的背景下具有重要的战略意义。
九、与 GPU 架构的对比思考
昇腾达芬奇架构经常被拿来和 NVIDIA GPU 对比。两者设计哲学的差异值得深入理解。
| 维度 | NVIDIA GPU(以 SM 为单位) | 昇腾达芬奇(以 AI Core 为单位) |
|---|---|---|
| 核心设计理念 | 通用并行计算(GPGPU) | 特定域计算(DSA) |
| 计算组织 | 线程束(Warp,32 线程)为中心 | 三大计算单元异构协作为中心 |
| 矩阵计算 | Tensor Core(嵌入在 SM 内) | Cube 单元(独立计算单元) |
| 向量/标量计算 | CUDA Core 统一处理 | Vector + Scalar 独立单元 |
| 存储层次 | L1 Cache + L2 Cache(透明管理) | 多级 Buffer(显式管理) |
| 线程模型 | SIMT(线程级并行) | SIMD + SIMT(arch35) |
| 存储编程模型 | Cache 为主,对程序员透明 | Buffer 为主,对程序员可见 |
| 调度方式 | 硬件 warp scheduler | Scalar 单元软件调度 |
| 编程抽象 | CUDA Thread / Block / Grid | Ascend C 核函数 + 多级 Buffer |
核心差异总结:
- GPU 是"通用并行 + 硬件调度" :靠大量的线程和硬件调度器来隐藏延迟,程序员不太需要关心数据在哪层缓存。
- 昇腾是"异构协作 + 软件调度" :三大单元各司其职,Scalar 单元负责调度,程序员需要显式管理数据在 Buffer 之间的搬运。
- 存储哲学不同:GPU 依赖 Cache 层次隐藏访存延迟(类似 CPU 的思路),而昇腾采用显式 Buffer
管理——牺牲了一定的编程便利性,换取了更确定的性能行为和更大的优化空间。
这种差异意味着:从 GPU 迁移到昇腾,不只是换一套 API,而是需要转变编程思维——从"依赖硬件自动管理"转变为"主动规划数据流"。
十、总结
达芬奇架构是昇腾 AI 算力的基石。回顾本篇的核心要点:
- 三大计算单元异构协作:Cube(矩阵)+ Vector(向量)+ Scalar(标量/控制),形成三条独立流水线,并行执行。
- 精细的多级存储层次:从 GM → L2 → L1 → L0A/B/C → UB →
GPR,每一层的容量、速度、可见性都不同。Buffer 对程序员可见是昇腾编程模型的核心特征。 - 耦合与分离两种架构:耦合架构核内数据交换快,分离架构独立性强、专精化程度高。910B 采用分离架构(AIC +
AIV),是面向训练场景的优化选择。 - 编程范式的核心思想:三阶段流水线(CopyIn → Compute →
CopyOut)、融合算子、双缓冲技术——都围绕着"最大化计算与搬运的并行度"这一目标。 - arch35 的里程碑意义:SIMD+SIMT 双模让昇腾能处理更广泛的算子类型,FP8/MXFP8
支持顺应了大模型低精度训练的趋势,PD 分离架构开创了推理部署的新范式。
理解了架构,才能真正理解为什么昇腾上的算子要这样写、性能要这样调。 接下来的系列文章中,我们会从这些架构基础出发,逐步深入到 CANN、AscendCL、算子开发等实际编程层面。
下一篇预告
第 3 篇:《昇腾芯片演进史:从 910B 到 960 的代际跨越》
本篇我们从微架构层面拆解了 AI Core 的内部构造。下一篇将视角拉高到芯片和系统层面——从 910B 的单 die 设计,到 910C 的双 die 封装,到 950 系列的自研 HBM 和 arch35 架构,再到 960 超节点的 NPO 光互连技术——完整梳理昇腾芯片的代际演进路线,以及每一代的核心技术突破。
参考资料
华为昇腾官方技术文档·达芬奇架构总览
昇腾 CANN 算子开发指南·Ascend C 编程范式
华为全联接大会 2025/2026 昇腾产品发布内容
Ascend C 算子开发官方教程
本文基于 2026 年 9 月公开技术数据撰写,如有更新请以官方信息为准。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)