
HarmonyOS 7 流式压缩日志还爆内存?API 26 的 Update、回调与取消怎么用
HarmonyOS 7 流式压缩日志还爆内存?API 26 的 Update、回调与取消怎么用
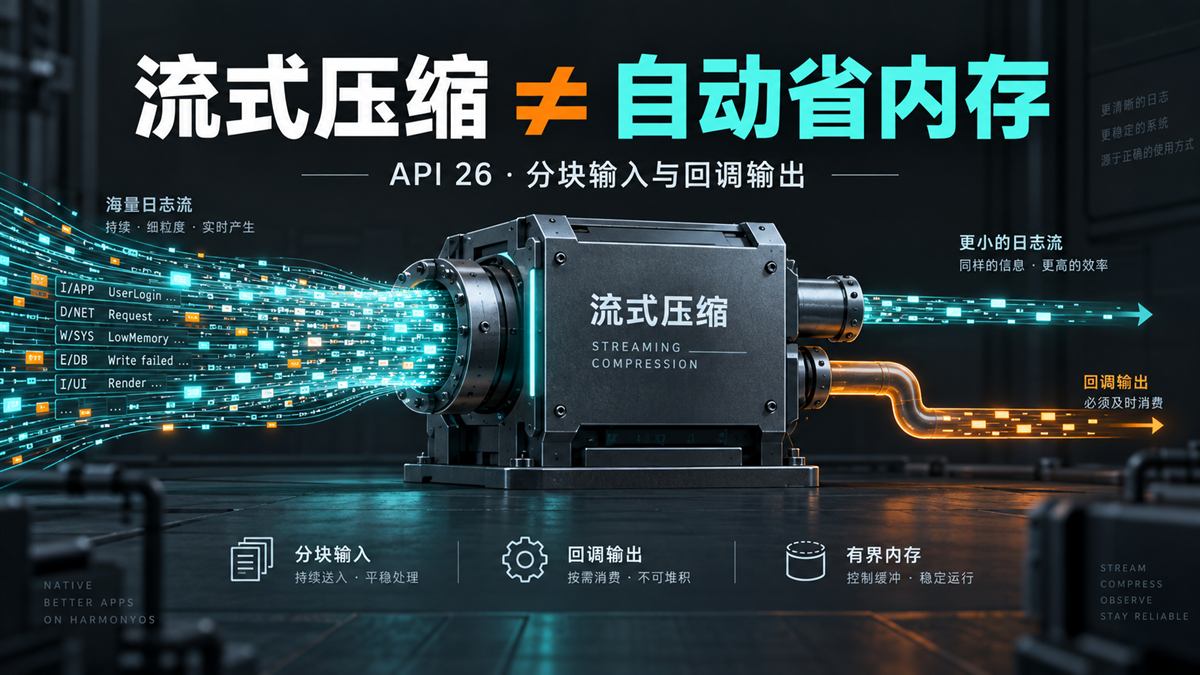
项目里的日志持续产生时,最容易写出的“流式压缩”是这样的:先把日志全读到一个大数组,再一次性压缩,最后把压缩结果攒在另一个数组里。这只是把一次性处理改了个名字,峰值内存并不会因为 API 名字带了 Stream 就自动下降。
HarmonyOS 7 对应的 API 26 提供 Native 流式压缩/解压接口。华为文档把实时日志、网络数据和无法一次装入内存的大数据列为适用场景。要发挥它的作用,得同时想清楚三件事:输入怎样分块、输出回调写到哪里、取消时怎样处理已经写出的半成品。下文用两个小实验把这三个边界拆开。
验证范围:本文的 Node.js 流实验已在开发机运行。它验证的是分块输入、解压回环和取消的流程,不等于已经在 HarmonyOS API 26 SDK 上编译或在真机上跑通
OH_Archive_*。Native 代码接口以文末官方文档为准,接入时还需要设备测试。
先分清楚三种压缩入口
| 输入是什么 | 更合适的思路 | 不该误用的点 |
|---|---|---|
| 几 KB 的完整内存数据 | 缓冲区压缩 | 为一个小对象搭复杂的持续流管线 |
| 多个文件/目录组成 ZIP | 文件归档 | 把流式接口当成自动打包目录的接口 |
| 日志或网络数据边产生边到达 | 流式压缩 | 先把全部输入和输出攒在内存,再称为流式 |
这是华为压缩模块概览区分的三类处理方式。本文只讨论第三种。Native 接口从 API 26.0.0 起提供,使用头文件 <filemanagement/archive/oh_archive.h>,链接 liboharchive.so。文档的配置例子使用 65536 字节块、4 个线程、DEFLATE 和 CRC32;这些是示例配置,不是所有项目的最佳参数。实际值要测吞吐、内存、功耗和目标设备支持情况。
案例一:日志分块输入,回调输出别再攒成大数组
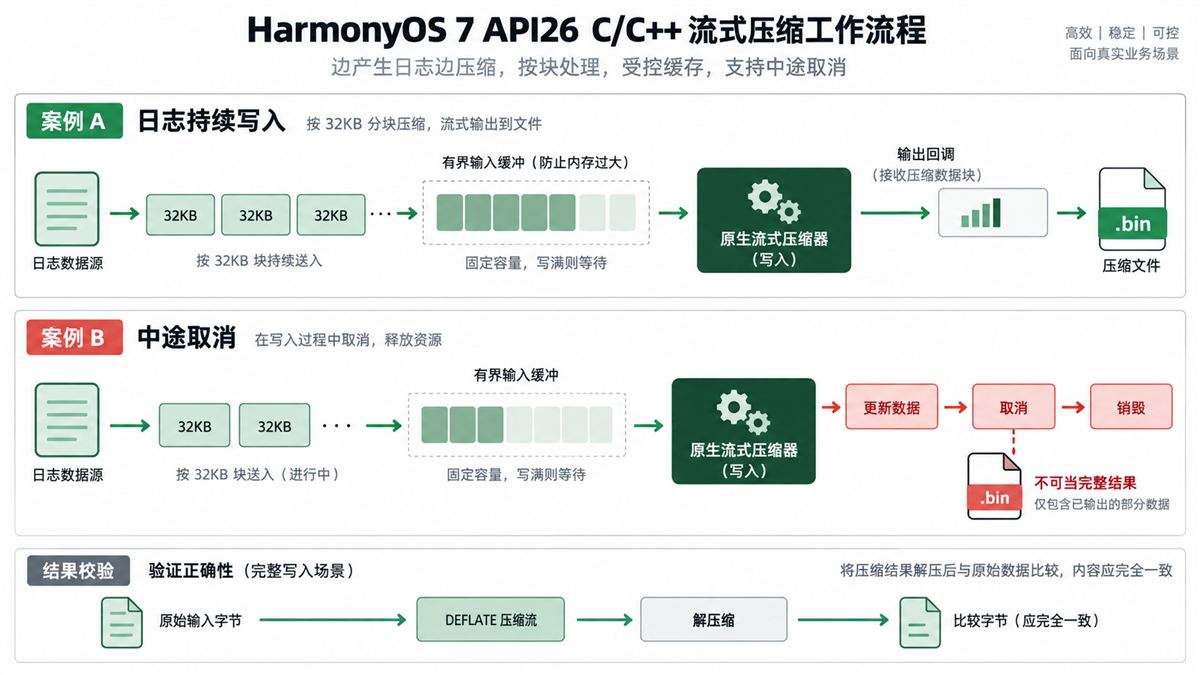
Native 写入端的生命周期可以按下面的顺序检查:
OH_Archive_StreamWrite_Create(config)
  -> OH_Archive_StreamWrite_Start(ctx, outputHandler, userData)
  -> 多次 OH_Archive_StreamWrite_Update(ctx, data, size)
  -> OH_Archive_StreamWrite_End(ctx, &streamInfo)
  -> OH_Archive_StreamWrite_Destroy(ctx)
Update 是输入,Start 提供的 outputHandler 才是处理压缩输出的地方。官方示例把输入文件分段读进来,输出回调写入文件。只调用多次 Update,却在回调里把每一块输出继续追加到一个无限增长的数组,内存压力照样会回来。生产环境通常需要有界队列、写入速度监控和错误处理;不能把“接口支持分块”误说成“接口替应用自动实现了背压策略”。
下面是可在开发机直接运行的流程实验。保存为 stream-compression-check.mjs,执行 node stream-compression-check.mjs。它用 Node 的 DEFLATE Raw 模拟分块压缩、分块解压;不是鸿蒙 Native API 的替代实现。这里为了比较原文,测试把结果暂存内存;真实大文件的输出端应改成文件或受控下游,不能照搬测试的收集方式去宣称内存有界。
import assert from 'node:assert/strict';
import { createDeflateRaw, createInflateRaw } from 'node:zlib';
import { Readable, Writable } from 'node:stream';
import { pipeline } from 'node:stream/promises';
import { setTimeout as delay } from 'node:timers/promises';

async function transform(chunks, stream, signal) {
  const output = [];
  const sink = new Writable({
    write(chunk, _encoding, done) {
      output.push(Buffer.from(chunk));
      done();
    }
  });
  await pipeline(Readable.from(chunks), stream, sink, { signal });
  return Buffer.concat(output);
}

const input = Buffer.from('API26 stream log\n'.repeat(8192));
const chunks = [];
for (let offset = 0; offset < input.length; offset += 32 * 1024) {
  chunks.push(input.subarray(offset, offset + 32 * 1024));
}
const compressed = await transform(chunks, createDeflateRaw());
const compressedChunks = [];
for (let offset = 0; offset < compressed.length; offset += 7) {
  compressedChunks.push(compressed.subarray(offset, offset + 7));
}
const restored = await transform(compressedChunks, createInflateRaw());
assert.deepEqual(restored, input);
console.log(`case 1: ${chunks.length} input chunks round-trip to ${compressed.length} bytes`);

const controller = new AbortController();
let produced = 0;
async function* slowSource() {
  for (let index = 0; index < 1000; index++) {
    produced++;
    yield Buffer.alloc(32 * 1024, index % 256);
    await delay(2);
  }
}
const timer = setTimeout(() => controller.abort(), 20);
try {
  await assert.rejects(
    pipeline(
      Readable.from(slowSource()),
      createDeflateRaw(),
      new Writable({ write(_chunk, _encoding, done) { done(); } }),
      { signal: controller.signal }
    ),
    { name: 'AbortError' }
  );
} finally {
  clearTimeout(timer);
}
assert.ok(produced < 1000);
console.log(`case 2: canceled after ${produced} source chunks; incomplete output discarded`);
本机这次输出是:案例一 5 个输入块压成 380 字节,再按每次 7 字节喂给解压器,逐字节还原成功;案例二产生 4 个输入块后取消,没有继续生成到 1000 块。380 字节只是高度重复测试文本的结果,不是通用压缩率,更不能拿来估计真实图片、加密数据或生产日志。
案例二:用户取消上传,已输出的压缩块怎么办
官方还有 OH_Archive_StreamWrite_Cancel 和 OH_Archive_StreamRead_Cancel。取消是生命周期动作,不是“把已经写进目标文件的数据自动撤销”。如果输出回调此前已经写了部分字节,应用要把目标当成未完成结果处理:关闭并清理临时文件,或保留显式失败标记;不要改名成正式归档文件给别人使用。只有正常 End、检查返回值并完成回环验证后,才进入正式路径。
上面的 Node 实验通过 AbortController 在管线运行时中断,pipeline 抛出 AbortError,断言输入没有继续跑完。它说明取消路径要单独测试,但不能拿 Node 的错误名推断 HarmonyOS 的错误码;鸿蒙侧应检查 OH_Archive_ErrCode 和具体接口文档。
还有一个容易误解的地方:配置里的 OH_ARCHIVE_CRC32 是校验和选项,用于发现传输或存储中的某些错误,不是身份认证,不能防止有意篡改。要验签、鉴权或保护秘密数据,得另行设计安全机制,不要让“有 CRC32”承担它不具备的责任。
接入 API 26 时我会怎么验收
- 版本与链接:目标设备、SDK 和编译目标支持 API 26;包含
oh_archive.h并链接liboharchive.so。低版本设备要有功能检测或降级,不要只在新模拟器上过编译。 - 完整生命周期:
Create、Start、每次Update、End和Destroy都检查错误;异常路径也释放上下文。取消走Cancel后清理不完整输出。 - 输出去向:回调直接写可控下游或临时文件;测缓慢磁盘、下游故障和连续高峰输入,不以一次成功压缩推断内存稳定。
- 回环与损坏测试:用与压缩端一致的配置做
StreamRead_*解压,比较原始字节;再测试截断、损坏和取消。OH_Archive_StreamInfo的输入/输出大小与校验和也纳入检查。 - 性能对比:用真实日志规模测峰值内存、吞吐、耗时和功耗,和缓冲区方案对照。测试里收集全部输出的写法不能拿来做内存结论。
这里最值得记住的不是函数名,而是边界:流式接口只给了分段处理能力;实际能否稳定、省内存,取决于应用怎样处理输出、下游变慢和中途取消。
参考资料(核对日期:2026-09-18):

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献26条内容

所有评论(0)