
【无标题】
华为昇腾AI全栈技术概览:从芯片到生态**
昇腾深度学习技术系列 · 第 1 篇 / 共 20 篇
定位:入门总览 · 阅读时长约 15 分钟
前言
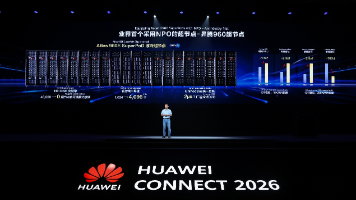
2026 年 9 月 17 日,华为全联接大会上,昇腾 960 超节点正式发布——全球首个采用 NPO(近封装光学)技术的 AI 超节点,4096 卡规模,8 EFLOPS FP8 算力,1 PB HBM 显存,可直接支撑 10 万亿参数大模型的训练。这不只是一颗新芯片的发布,而是华为昇腾 AI 全栈能力的一次集中展示。
很多人对昇腾的印象还停留在"华为的 AI 芯片"。但事实上,昇腾早已是一个覆盖芯片→架构→框架→工具链→应用的完整技术栈。本文是这个系列的第一篇,目标是帮你建立对昇腾 AI 全栈的完整认知——从最底层的芯片,到最上层的生态,一次看透。
一、昇腾是什么
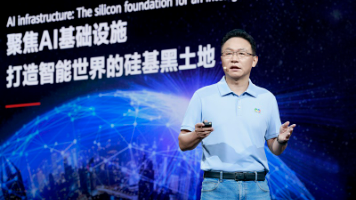
昇腾(Ascend) 是华为自主研发的 AI 计算品牌,定位非常明确:打造智能世界的"硅基黑土地" 。
这不是一句口号。昇腾的技术栈自下而上可以分为以下几个层次:
| 层次内容 | 代表产品/技术 |
|---|---|
| 芯片层 | AI 处理器硬件:Ascend 310 / 910 系列 / 950 系列 / 960 |
| 架构层 | 指令集与微架构:达芬奇架构(Da Vinci Architecture) |
| 异构计算层 | 算子编译与执行:CANN(Compute Architecture for Neural Networks) |
| 框架层 | 深度学习框架:MindSpore(昇思)、TorchNPU |
| 工具层 | 开发、调试、调优:MindStudio、MindIE、MindSpeed 系列 |
| 应用层 | 行业解决方案:智慧城市、自动驾驶、科学计算等 |
这种"全栈自研"的策略意味着:从晶体管到训练脚本,每一层都在华为自己的控制之下。好处是端到端优化空间大,挑战是每一层都要做到足够好用才能留住开发者。
二、芯片产品线:从推理到训练的完整覆盖
昇腾的芯片产品线经过多代演进,已经形成了覆盖边缘推理、数据中心训练的全系列布局。下表是截至 2026 年 9 月的核心产品矩阵:
| 芯片型号 | 所属平台 | 架构版本 | 核心定位 | 关键规格 | 备注 |
|---|---|---|---|---|---|
| Ascend 310 | —— | 边缘推理 | 低功耗,8 TOPS INT8 | 适用于边缘设备、摄像头等场景 | |
| Ascend 910B | Atlas A2 | arch22 | 数据中心训练 | 24 AIC + 48 AIV,FP16 353.89 TOPS | 单 die 设计,不支持 FP8 |
| Ascend 910C | Atlas A3 | arch22 | 大规模集群训练 | 双 die 封装 | 已部署超 1000 套超节点 |
| Ascend 950PR / 950DT | Atlas A5 | arch35 | 新一代训练/推理 | 32 AIC + 64 AIV,FP16 432.54 TOPS,支持 FP8/MXFP8/MXFP4 | 第三代 DaVinci Core,系列首款自研 HBM 芯片 |
| Ascend 960 | 新一代超节点 | — | 超大规模训练 | 4096 卡,8 EFLOPS FP8,1 PB HBM | 2026.9.17 发布,全球首个 NPO 超节点 |
未来路线图
华为已明确宣布昇腾芯片将坚持一年一代的节奏:
- 960DT → 2027 Q1
- 960PR → 2027 Q3
- Ascend 970 → 2028
- Ascend 980 → 2029
这个节奏非常激进。对比来看,NVIDIA 从 A100 到 H100 再到 Blackwell 大约也是两年一代。昇腾选择"一年一代",说明华为在芯片设计迭代上投入了极大的工程资源。
一个值得关注的技术细节
从 910B 到 910C,华为采用了双 die 封装——将两个计算 die 封装在一起以提升算力密度。而到了 950 系列,华为更进一步实现了自研 HBM 芯片,这意味着在存储带宽这个关键瓶颈上,昇腾也不再依赖外部供应商。
三、达芬奇架构:昇腾算力的核心引擎
昇腾芯片的计算核心是华为自研的达芬奇架构(Da Vinci Architecture) 。理解达芬奇架构,是理解昇腾性能特点的基础。
3.1 AI Core 的三大计算单元
每个 AI Core 由三个独立的计算单元组成:
- Cube(矩阵计算单元) :负责矩阵乘加运算,这是深度学习中最密集的计算。采用 3D Cube 技术,支持 16×16 矩阵乘法,内部有
256 个子电路并行工作。一个时钟周期可以完成 4096 个 FLOP。 - Vector(向量计算单元) :负责向量运算,处理激活函数、归一化、 pooling 等逐元素操作。
- Scalar(标量计算单元) :负责标量运算和控制流,包括循环控制、条件分支等。
三大单元并行工作,意味着一个 AI Core 可以同时处理矩阵运算、向量运算和标量控制,避免了传统 GPU 架构中多种计算争抢同一计算资源的瓶颈。
3.2 多级存储层次
深度学习是典型的访存密集型任务,存储层次的设计直接决定了计算单元的利用率。达芬奇架构的存储层次从外到内依次为:
HBM(高带宽内存)
↓
L2 Cache(全局共享缓存)
↓
L1 Cache(AI Core 级缓存)
↓
L0A / L0B / L0C(计算单元私有缓存)
↓
UB(Unified Buffer,统一缓冲区)
这种设计让数据尽可能靠近计算单元,减少访存延迟。特别是 L0 级缓存直接服务于 Cube、Vector、Scalar 三个单元,确保计算不饿数据。
3.3 从 arch22 到 arch35:SIMD-only → SIMD+SIMT 双模
架构演进是昇腾最值得关注的技术路线之一:
- arch22(910B / 910C 使用):纯
SIMD(单指令多数据)模式。所有线程必须执行相同的指令,适合矩阵、向量这类规整计算,但对复杂控制流支持较弱。 - arch35(950 系列使用):引入 SIMT(单指令多线程) 模式,与 GPU
的执行模型类似。每个线程可以走不同的分支路径,大幅提升了处理复杂算子和动态图的能力。
SIMD+SIMT 双模是 arch35 最关键的升级。它意味着昇腾不再只擅长"规整"的矩阵运算,也能高效处理"不规则"的控制流——这对于支持越来越多的大模型算子(如 MoE 路由、动态稀疏计算)至关重要。
四、CANN:连接硬件与框架的桥梁
如果说达芬奇架构是引擎,那 CANN(Compute Architecture for Neural Networks) 就是传动系统。它是昇腾的异构计算架构,负责将上层框架的计算图翻译为底层硬件能高效执行的指令。
4.1 五层架构
CANN 采用五层分层设计,自底向上依次为:
┌─────────────────────────────────────────────┐
│ ① AscendCL(编程接口层) │
│ 统一的 C / Python API,面向开发者 │
├─────────────────────────────────────────────┤
│ ② 计算服务层 │
│ 算子库 AOL · 调优引擎 AOE · 框架适配器 │
├─────────────────────────────────────────────┤
│ ③ 计算编译层 │
│ 图编译器 GraphCompiler · TBE 张量加速引擎 │
├─────────────────────────────────────────────┤
│ ④ 计算执行层 │
│ Runtime · Graph Executor · DVPP · AIPP │
│ · HCCL │
├─────────────────────────────────────────────┤
│ ⑤ 计算基础层 │
│ SVM 共享虚拟内存 · VM 虚拟化 │
│ · HDC 主机-设备通信 │
└─────────────────────────────────────────────┘
每一层的职责简述:
| 层级 | 核心组件 | 职责说明 |
|---|---|---|
| 编程接口层 | AscendCL | 为开发者提供统一的 C/Python 编程接口,屏蔽底层硬件差异 |
| 计算服务层 | AOL、AOE、框架适配器 | AOL 提供丰富的算子库;AOE 自动进行算子和图的调优;框架适配器对接不同深度学习框架 |
| 计算编译层 | GraphCompiler、TBE | GraphCompiler 负责计算图的优化和代码生成;TBE(Tensor Boost Engine)是张量加速引擎,用于自定义算子开发 |
| 计算执行层 | Runtime、DVPP、AIPP、HCCL | Runtime 管理设备和内存;DVPP 处理数字视频预处理;AIPP 处理 AI 前处理;HCCL 负责多卡/多机集合通信 |
| 计算基础层 | SVM、VM、HDC | SVM 实现主机和设备的共享虚拟内存;VM 提供虚拟化支持;HDC 实现高效的主机-设备通信 |
4.2 CANN 的开源现状
CANN 已经全面开源,这是昇腾生态建设中非常重要的一步。根据公开数据:
- 外部开发者占比达到 61%
- 月活跃开发者超过 5200+
- 已成为中国最活跃的开源社区之一
当前版本:
- CANN 9.1.1:稳定版,推荐生产环境使用
- CANN 9.2.0-beta.2:社区版,包含最新特性
开源的意义在于:开发者不再只能被动接受华为提供的算子,而是可以自己编写、优化、贡献算子。这大幅降低了生态建设的"中央负担"。
五、AI 框架生态:两条腿走路
昇腾在框架层的策略非常务实——自研 + 兼容,两条腿走路。
5.1 MindSpore(昇思)
MindSpore 是华为自研的全场景深度学习框架,核心特点:
- 动静统一:同一个模型代码可以在动态图模式下调试,在静态图模式下高效运行,无需大幅改写
- 全场景覆盖:支持云、边、端,从手机到超算集群都能运行
- 昇腾深度优化:作为"亲儿子"框架,MindSpore 对昇腾硬件的利用效率是最高的
5.2 TorchNPU(Ascend for PyTorch)
现实是,绝大多数 AI 开发者都在用 PyTorch。如果昇腾不能用 PyTorch,就很难进入主流生态。TorchNPU 就是解决这个问题的:
- 让 PyTorch 代码直接调用昇腾 NPU,无需大幅修改
- 已支持 PyTorch 2.12.0 和 2.11.0
- 昇腾已成为 PyTorch 官网可直接安装的算力平台,这是第一个来自中国的平台
这一点意义重大。它意味着开发者不需要"切换到昇腾生态",只需要 pip install 一个包,就能在昇腾 NPU 上跑 PyTorch 模型。
5.3 生态覆盖
截至目前,昇腾已经覆盖了 90+ 主流三方社区,包括:
- PyTorch:通过 TorchNPU 原生支持
- Triton:OpenAI 的 GPU 编程语言,已适配昇腾
- vLLM:大模型推理引擎,已支持昇腾
- veRL:字节跳动的 RLHF 训练框架,已支持昇腾
这种"拥抱现有生态"的策略,比"另起炉灶"更容易获得开发者认可。
六、关键软件套件一览
昇腾的软件工具链相当丰富,以下是核心套件的功能定位:
| 套件名称 | 用途 | 最新版本 |
|---|---|---|
| MindIE | 推理加速套件,针对大模型推理场景进行深度优化 | 3.1.0 |
| MindSpeed Core | 大模型训练加速核心库,提供分布式训练基础能力 | 最新版 |
| MindSpeed MM | 多模态大模型训练加速,支持视觉-语言等多模态场景 | 最新版 |
| MindSpeed LLM | 大语言模型分布式训练加速,针对 LLM 场景优化 | 最新版 |
| HCCL | 集合通信库,支持多卡/多机间的高效数据传输 | 最新版 |
| MindStudio | IDE 开发工具,提供模型开发、调试、调优的一站式环境 | 26.1.0 |
| TorchNPU | PyTorch 适配框架,让 PyTorch 在昇腾 NPU 上运行 | 26.1.0 |
其中 MindIE 和 MindSpeed 系列值得重点关注:它们直接决定了昇腾平台上大模型的训练和推理效率,是昇腾在"性能"之外另一个关键的竞争力维度。
七、超节点战略:从单卡到集群的质变
大模型时代,单卡算力再强也不够用。真正的挑战是:如何让成千上万张卡高效协同工作。这正是昇腾"超节点"战略要解决的问题。
7.1 设计理念
昇腾超节点的核心设计理念是:
- 以一套协议平等连接所有组件:不区分计算节点和存储节点,所有资源通过统一协议互联
- 跨物理服务器的内存访问:突破单台服务器的内存边界,实现更大规模的参数存放
- 近铜远光互连:机柜内用铜缆(低延迟、高带宽),跨机柜用光缆(远距离),兼顾性能和扩展性
7.2 超节点演进
| 超节点配置 | 算力亮点 |
|---|---|
| CloudMatrix 384:384 颗 910C + 192 颗鲲鹏 CPU | ~300 PFLOPS BF16,早期超节点方案 |
| Atlas 950 SuperPoD:最大 8192 张 950DT | 较 Atlas 900 提升 17 倍,新一代大规模训练集群 |
| 昇腾 960 超节点:4096 张 960 卡 | 8 EFLOPS FP8,1 PB HBM,全球首个 NPO 超节点,支撑 10T 参数模型 |
7.3 NPO 技术:960 超节点的核心突破
昇腾 960 超节点最大的技术亮点是采用了 NPO(Near-Package Optics,近封装光学) 技术,搭载了华为自研的 NPO 光引擎 Hi-ONE。
传统的数据中心互连是"电→光→电"的转换,存在带宽和功耗瓶颈。NPO 将光引擎直接封装在芯片封装附近,实现"电→光"的零距离转换,大幅提升互连带宽并降低功耗。这是华为在光互连领域的重要突破,也是 960 超节点能实现 4096 卡规模高效协同的关键。
目前,昇腾超节点已在全球部署超过 1000 套。
八、生态现状与展望
技术再好,没有生态也是白搭。来看一组关键数字:
| 指标 | 数据 |
|---|---|
| 鲲鹏全球开发者 | 超 416 万 |
| CANN 月活跃开发者 | 5200+ |
| CANN 外部开发者占比 | 61% |
| 原生训练模型 | 超 40 个 |
| 覆盖主流三方社区 | 90+ |
8.1 优势
- 全栈自研:从芯片到框架完全自主可控,不存在"卡脖子"风险
- PyTorch 兼容:TorchNPU 让开发者几乎零成本迁移
- 开源生态活跃:CANN 开源后外部开发者占比超六成,社区自驱力已形成
- 超节点规模化部署:1000+ 套超节点的实战经验,证明了集群能力的可靠性
8.2 挑战
- 软件易用性:与 CUDA 十年积累相比,CANN 的工具链成熟度仍有差距
- 开发者习惯:大量开发者习惯了 CUDA 思维,切换到昇腾有学习成本
- 算子覆盖度:虽然 AOL 算子库在快速扩展,但一些前沿算子的适配可能滞后
- 生态碎片化:MindSpore 和 PyTorch 两条路线需要同时维护,资源分散
九、总结与系列预告
本文从芯片、架构、CANN、框架、工具链、超节点、生态七个维度,完整梳理了华为昇腾 AI 全栈的技术版图。核心结论:
昇腾不是一个芯片产品,而是一个完整的 AI 计算技术体系。它正在以极快的速度缩小与 NVIDIA CUDA 生态的差距,而"全栈自研 + 开源生态 + PyTorch 兼容"的三叉戟策略,是它最核心的竞争力。
后续 19 篇预告
本系列将从基础到深入,系统覆盖昇腾深度学习技术的方方面面:
基础篇(第 2-5 篇)
第 2 篇:达芬奇架构深度解析——从 arch22 到 arch35 的微架构细节
第 3 篇:CANN 架构详解——五层设计的设计哲学与工程实现
第 4 篇:AscendCL 编程入门——第一个昇腾 AI 应用
第 5 篇:MindStudio 开发环境搭建与使用指南
编程篇(第 6-9 篇)
第 6 篇:TBE 自定义算子开发——从原理到实战
第 7 篇:Triton on Ascend——在昇腾上用 Triton 写算子
第 8 篇:PyTorch on NPU——TorchNPU 深度使用指南
第 9 篇:MindSpore 框架深度解析——动静统一的实现原理
训练篇(第 10-13 篇)
第 10 篇:HCCL 集合通信原理与实践
第 11 篇:MindSpeed Core——大模型分布式训练加速实战
第 12 篇:MindSpeed LLM——大语言模型训练全流程
第 13 篇:超节点训练实战——从单机到 4096 卡集群
推理篇(第 14-17 篇)
第 14 篇:MindIE 推理加速套件深度解析
第 15 篇:vLLM on Ascend——在昇腾上部署高性能推理服务
第 16 篇:模型量化实战——FP8/MXFP8/MXFP4 在昇腾上的实践
第 17 篇:大模型推理性能调优——从 profiling 到瓶颈突破
系统与生态篇(第 18-20 篇)
第 18 篇:昇腾 vs NVIDIA——全栈对比分析与选型建议
第 19 篇:昇腾开源社区参与指南——如何贡献你的第一个 PR
第 20 篇:昇腾技术路线图展望——从 960 到 980 的未来
写在最后
昇腾是目前国内唯一真正意义上实现了"芯片→架构→框架→应用"全栈自研的 AI 计算平台。它的技术路线有自己的特色(比如达芬奇架构的三大计算单元并行),也在积极融入全球开源生态(PyTorch 官方支持、CANN 开源)。
对于开发者来说,现在是一个很好的时机开始了解昇腾——生态在快速成熟,文档在不断完善,社区在持续壮大。这个系列将陪你走完全程。
下一篇预告:《达芬奇架构深度解析——从 arch22 到 arch35 的微架构细节》 ,我们将从晶体管级的 Cube 单元开始,逐层拆解昇腾芯片的计算核心。敬请期待。
参考资料
华为全联接大会 2026 发布会内容
昇腾 CANN 开源社区
PyTorch 官网 Ascend 平台支持页面
华为昇腾官方技术文档
本文基于 2026 年 9 月公开数据撰写,如有更新请以官方信息为准。

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)