
算子开发高级课程总结(个人学习总结,如有侵犯立即删除)
算子调试介绍:
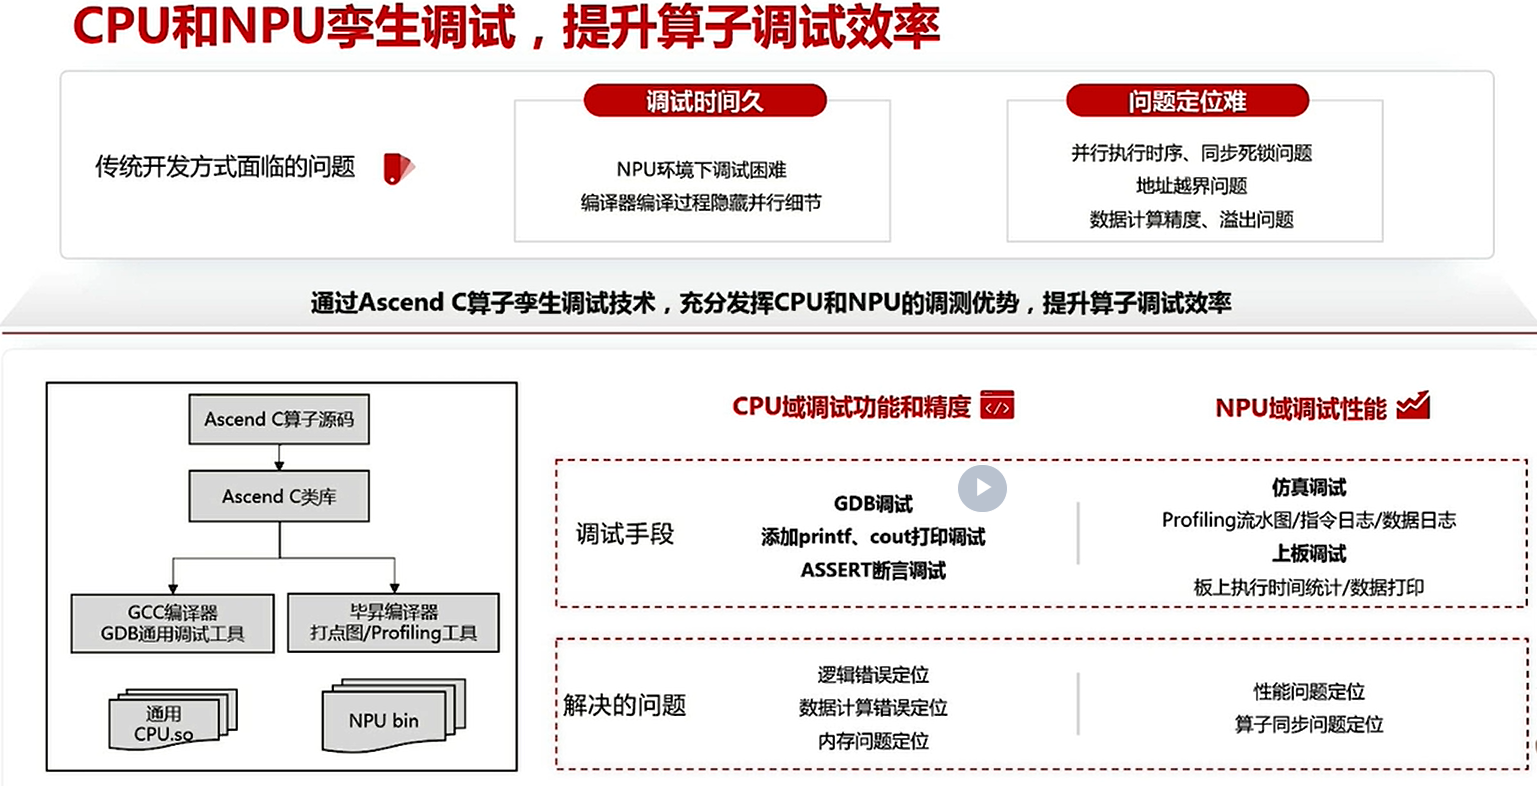
【图片知识总结】CPU和NPU孪生调试,提升算子调试效率
传统开发方式面临的两大问题:
问题 具体表现 调试时间久 NPU环境下调试困难;编译器编译过程隐藏并行细节 问题定位难 并行执行时序、同步死锁问题;地址越界问题;数据计算精度、溢出问题 解决思路:通过 Ascend C 算子孪生调试技术,充分发挥 CPU 和 NPU 的调测优势,提升算子调试效率。同一份 Ascend C 算子源码经 Ascend C 类库编译,走两条链路:
GCC编译器 + GDB通用调试工具 → 生成通用 CPU.so(CPU域调试);
毕昇编译器 + 打点图/Profiling工具 → 生成 NPU bin(NPU域调试)。
两域分工:
域 调试手段 解决的问题 CPU域(调功能和精度) GDB调试;添加printf、cout打印调试;ASSERT断言调试 逻辑错误定位;数据计算错误定位;内存问题定位 NPU域(调性能) 仿真调试:Profiling流水图/指令日志/数据日志;上板调试:板上执行时间统计/数据打印 性能问题定位;算子同步问题定位 原则:先在CPU域调对错(功能/精度),再到NPU域调性能。
算子调试分为:
在cpu上调试
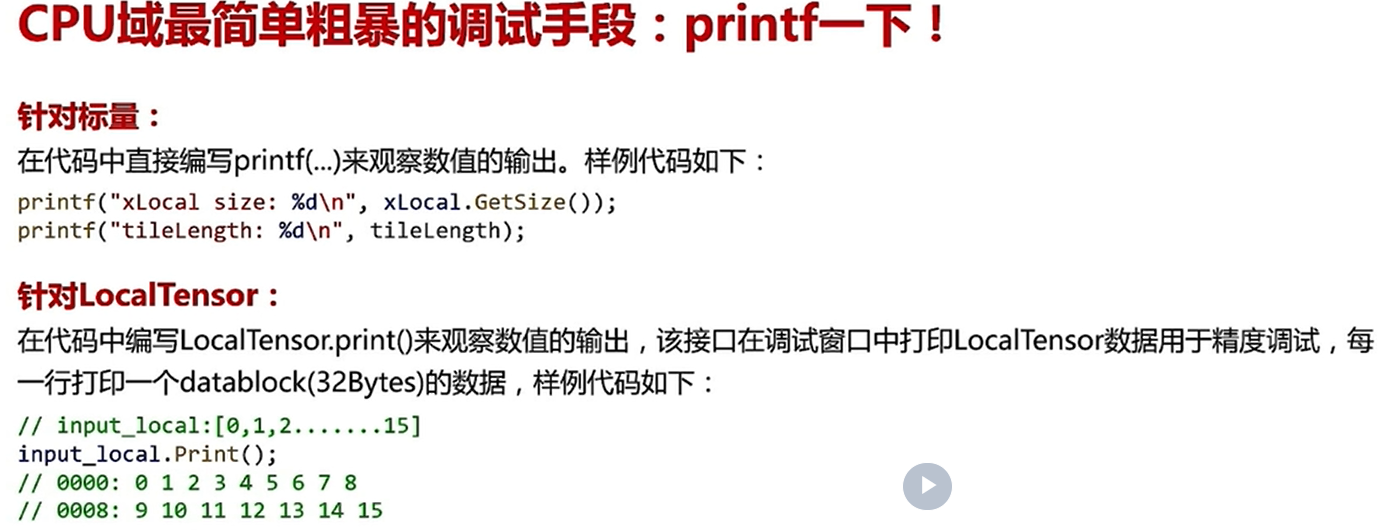
【图片知识总结】CPU域最简单粗暴的调试手段:printf一下!
针对标量:在代码中直接编写
printf(...)观察数值输出。样例:printf("xLocal size: %d\n", xLocal.GetSize()); printf("tileLength: %d\n", tileLength);针对LocalTensor:编写
LocalTensor.print()观察数值输出,该接口在调试窗口中打印 LocalTensor 数据用于精度调试,每一行打印一个 datablock(32Bytes)的数据。样例:// input_local:[0,1,2.......15] input_local.Print(); // 0000: 0 1 2 3 4 5 6 7 8 // 0008: 9 10 11 12 13 14 15
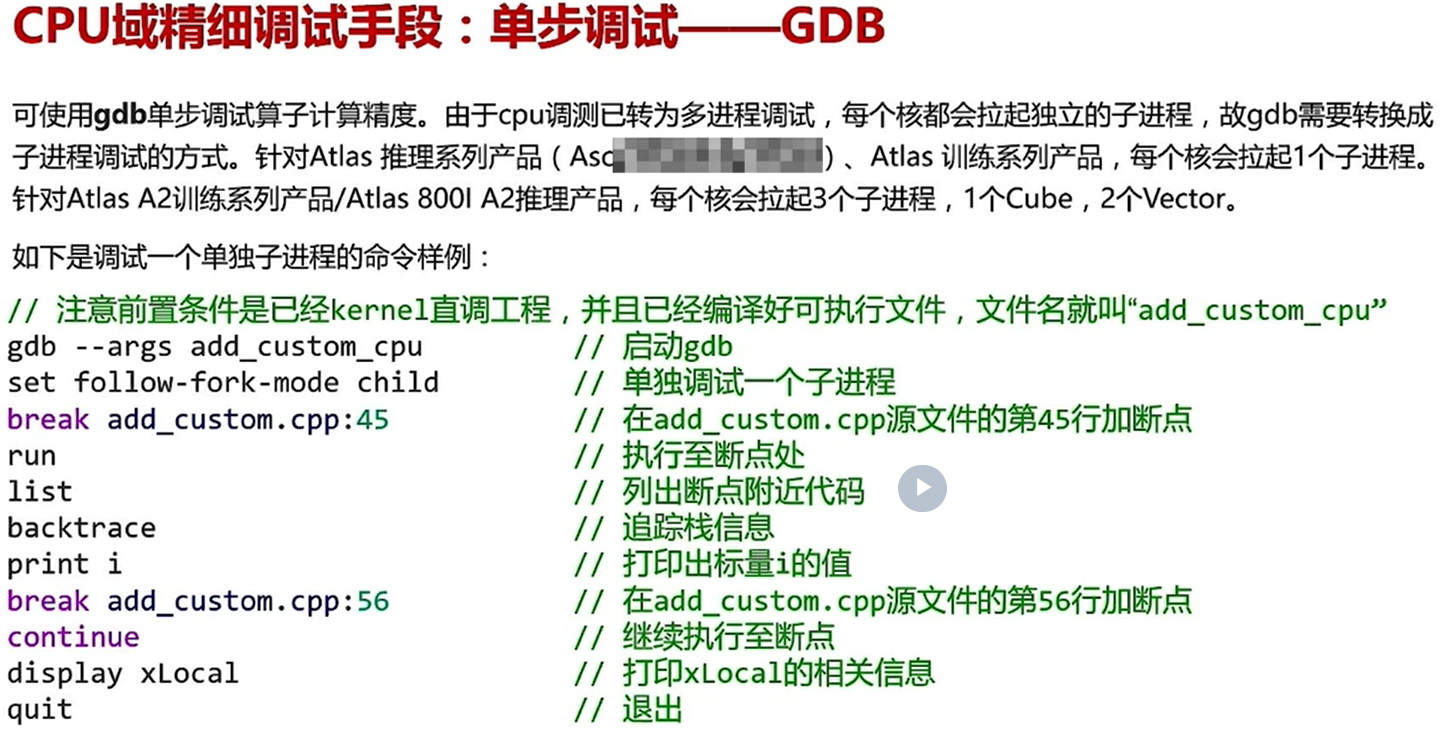
【图片知识总结】CPU域精细调试手段:单步调试——GDB
可使用 gdb 单步调试算子计算精度。由于 CPU 调测已转为多进程调试(每个核都会拉起独立的子进程),故 gdb 需要转换成子进程调试的方式:
针对 Atlas 推理系列产品、Atlas 训练系列产品:每个核拉起 1 个子进程;
针对 Atlas A2 训练系列产品 / Atlas 800I A2 推理产品:每个核拉起 3 个子进程(1个Cube + 2个Vector)。
调试一个单独子进程的命令样例(前置条件:已是 kernel 直调工程且编译好可执行文件
add_custom_cpu):gdb --args add_custom_cpu # 启动gdb set follow-fork-mode child # 单独调试一个子进程 break add_custom.cpp:45 # 在add_custom.cpp源文件的第45行加断点 run # 执行至断点处 list # 列出断点附近代码 backtrace # 追踪栈信息 print i # 打印出标量i的值 break add_custom.cpp:56 # 在第56行加断点 continue # 继续执行至断点 display xLocal # 打印xLocal的相关信息 quit # 退出
在npu上调试
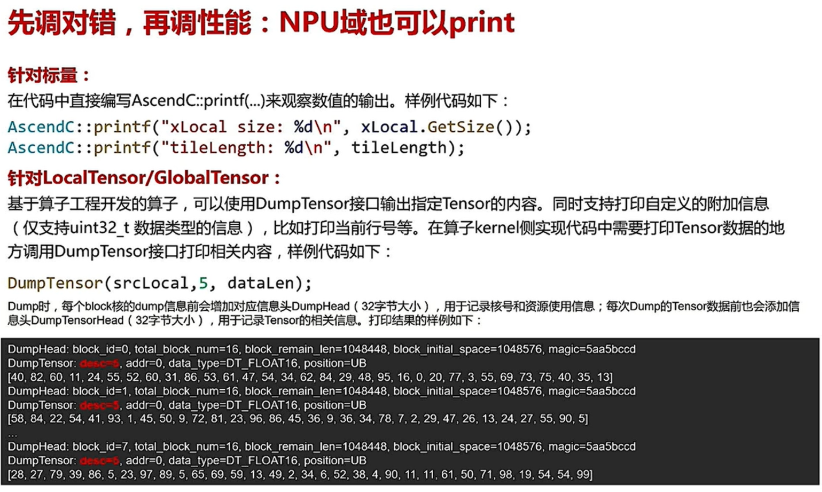
【图片知识总结】先调对错,再调性能:NPU域也可以print
针对标量:在代码中直接编写
AscendC::printf(...)观察数值输出。样例:AscendC::printf("xLocal size: %d\n", xLocal.GetSize()); AscendC::printf("tileLength: %d\n", tileLength);针对LocalTensor/GlobalTensor:基于算子工程开发的算子,可以使用 DumpTensor 接口输出指定 Tensor 的内容,同时支持打印自定义的附加信息(仅支持 uint32_t 数据类型的信息,比如打印当前行号等)。在算子 kernel 侧实现代码中需要打印 Tensor 数据的地方调用:
DumpTensor(srcLocal, 5, dataLen);Dump 时每个 block 核的 dump 信息前会增加信息头 DumpHead(32字节),用于记录核号和资源使用信息(block_id、total_block_num、block_remain_len、block_initial_space、magic);每次 Dump 的 Tensor 数据前也会添加信息头 DumpTensorHead(32字节),用于记录 Tensor 的相关信息(desc、addr、data_type、position=UB 等)。
内存检查工具
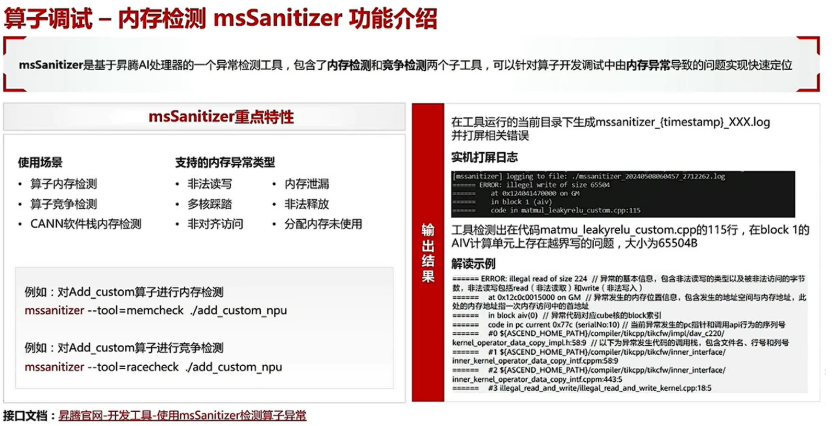
【图片知识总结】算子调试——内存检测 msSanitizer 功能介绍
msSanitizer 是基于昇腾AI处理器的一个异常检测工具,包含内存检测和竞争检测两个子工具,可以针对算子开发调试中由内存异常导致的问题实现快速定位。
使用场景:算子内存检测、算子竞争检测、CANN软件栈内存检测。
支持的内存异常类型:非法读写、多核踩踏、非对齐访问、内存泄漏、非法释放、分配内存未使用。
使用命令:
# 内存检测 mssanitizer --tool=memcheck ./add_custom_npu # 竞争检测 mssanitizer --tool=racecheck ./add_custom_npu输出结果:在工具运行的当前目录下生成
mssanitizer_{timestamp}_XXX.log并打屏相关错误。例如实机日志显示:代码 matmul_leakyrelu_custom.cpp 的 115 行,在 block 1 的 AIV 计算单元上存在越界写的问题,大小为 65504B。日志解读要素:异常基本信息(非法读 read / 非法写 write 类型及被非法访问的字节数)、异常发生的内存位置信息(地址空间与内存首地址)、cube 核的 block 索引、pc 指针和调用 api 行为的序列号、异常发生代码的调用栈(文件名、行号、列号)。
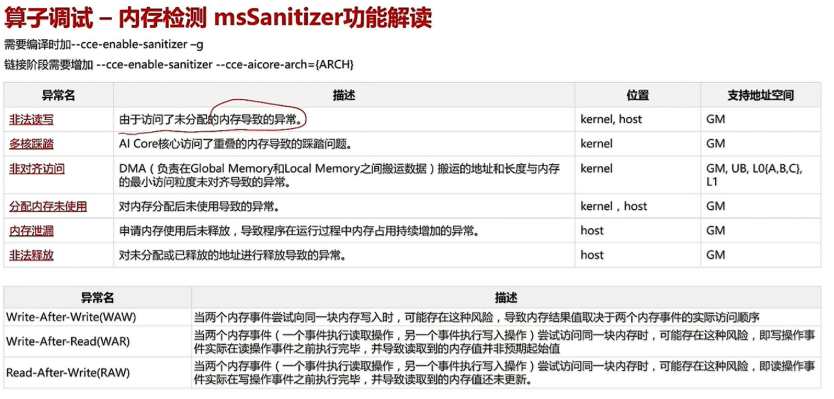
【图片知识总结】msSanitizer 功能解读(编译选项与异常类型详解)
编译要求:编译时加
--cce-enable-sanitizer -g;链接阶段需要增加--cce-enable-sanitizer --cce-aicore-arch={ARCH}。内存异常类型表:
异常名 描述 位置 支持地址空间 非法读写 由于访问了未分配的内存导致的异常 kernel, host GM 多核踩踏 AI Core核心访问了重叠的内存导致的踩踏问题 kernel GM 非对齐访问 DMA(负责在Global Memory和Local Memory之间搬运数据)搬运的地址和长度与内存的最小访问粒度未对齐导致的异常 kernel GM, UB, L0{A,B,C}, L1 分配内存未使用 对内存分配后未使用导致的异常 kernel, host GM 内存泄漏 申请内存使用后未释放,导致程序在运行过程中内存占用持续增加的异常 host GM 非法释放 对未分配或已释放的地址进行释放导致的异常 host GM 竞争异常类型表:
异常名 描述 Write-After-Write (WAW) 两个内存事件尝试向同一块内存写入时存在风险,内存结果值取决于两个内存事件的实际访问顺序 Write-After-Read (WAR) 一个事件读、一个事件写访问同一块内存时存在风险,即写操作实际在读操作之前执行完毕,导致读取到的内存值并非预期起始值 Read-After-Write (RAW) 一个事件读、一个事件写访问同一块内存时存在风险,即读操作实际在写操作之前执行完毕,导致读取到的内存值还未更新
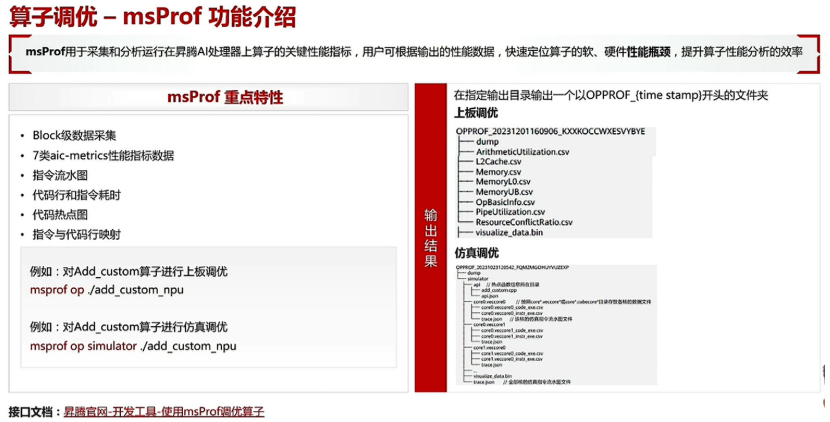
【图片知识总结】算子调优——msProf 功能介绍
msProf 用于采集和分析运行在昇腾AI处理器上算子的关键性能指标,用户可根据输出的性能数据,快速定位算子的软、硬件性能瓶颈,提升算子性能分析的效率。
重点特性:Block级数据采集;7类 aic-metrics 性能指标数据;指令流水图;代码行和指令耗时;代码热点图;指令与代码行映射。
使用命令:
# 上板调优 msprof op ./add_custom_npu # 仿真调优 msprof op simulator ./add_custom_npu输出结果:在指定输出目录输出一个以
OPPROF_{time stamp}开头的文件夹。
上板调优输出:dump/、ArithmeticUtilization.csv、L2Cache.csv、Memory.csv、MemoryL0.csv、MemoryUB.csv、OpBasicInfo.csv、PipeUtilization.csv、ResourceConflictRatio.csv、visualize_data.bin;
仿真调优输出:dump/simulator/ 下按 core0,veccore0 等目录存放各核的数据文件(code_exe.csv、instr_exe.csv、trace.json 仿真指令流水图文件)以及全量核的仿真指令流水图 trace.json。
矩阵编程
【图片知识总结】矩阵乘章节大纲:1. 矩阵乘基础知识;2. 矩阵乘的核函数;3. 矩阵乘的Tiling;4. 运行验证。
矩阵基础: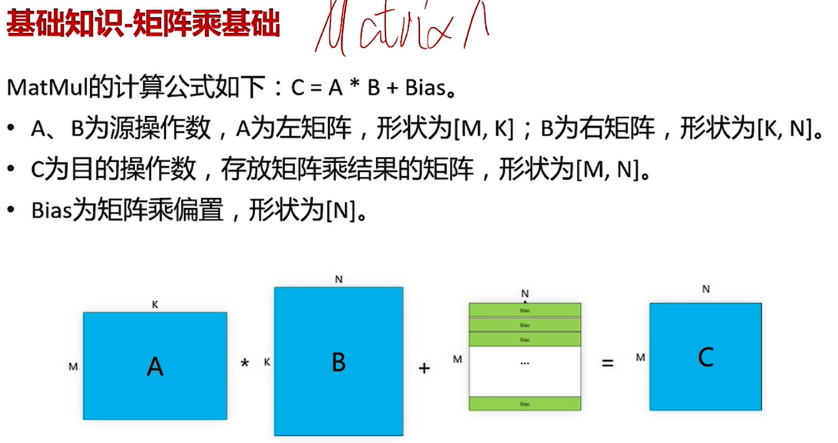
【图片知识总结】基础知识——矩阵乘基础
MatMul 的计算公式:C = A * B + Bias。
A、B 为源操作数:A 为左矩阵,形状为 [M, K];B 为右矩阵,形状为 [K, N];
C 为目的操作数,存放矩阵乘结果的矩阵,形状为 [M, N];
Bias 为矩阵乘偏置,形状为 [N](按行广播叠加到结果矩阵上)。
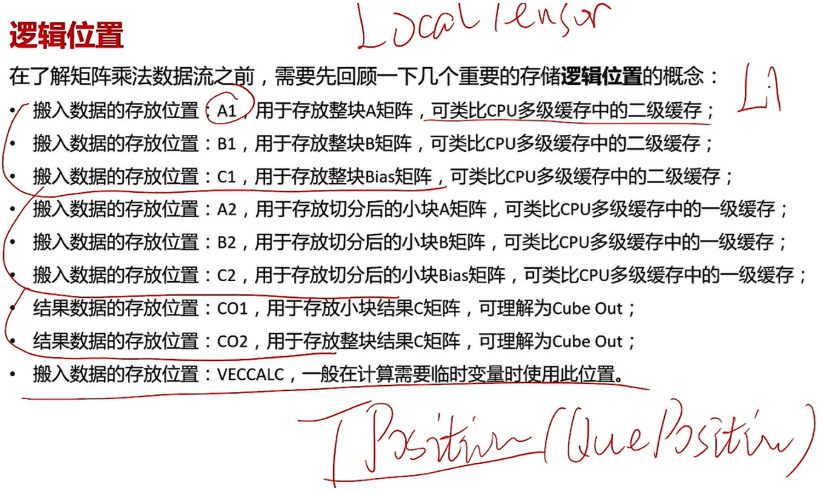
【图片知识总结】逻辑位置(LocalTensor 的 Position/QueuePosition 概念)
在了解矩阵乘法数据流之前,需要先回顾几个重要的存储逻辑位置概念:
逻辑位置 用途 类比 A1 存放整块A矩阵 类比CPU二级缓存 B1 存放整块B矩阵 类比CPU二级缓存 C1 存放整块Bias矩阵 类比CPU二级缓存 A2 存放切分后的小块A矩阵 类比CPU一级缓存 B2 存放切分后的小块B矩阵 类比CPU一级缓存 C2 存放切分后的小块Bias矩阵 类比CPU一级缓存 CO1 存放小块结果C矩阵 可理解为Cube Out CO2 存放整块结果C矩阵 可理解为Cube Out VECCALC 计算需要临时变量时使用此位置 —
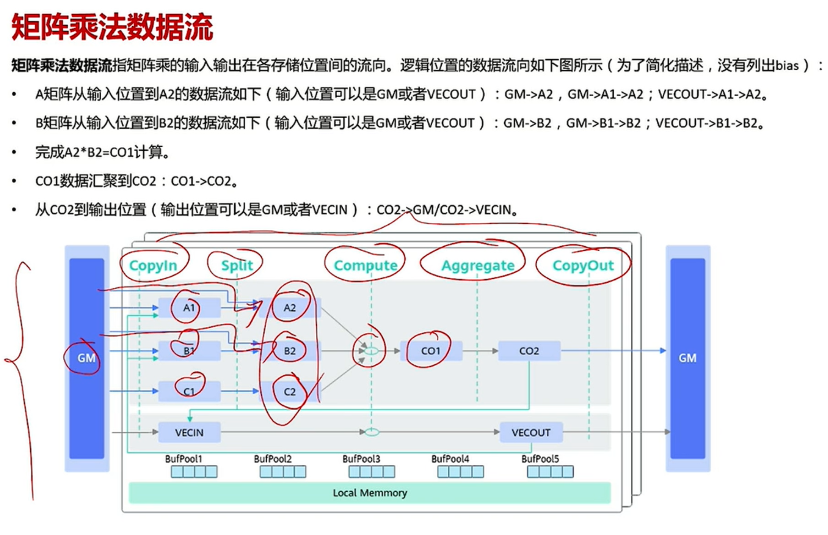
【图片知识总结】矩阵乘法数据流
矩阵乘法数据流指矩阵乘的输入输出在各存储位置间的流向(五个阶段:CopyIn → Split → Compute → Aggregate → CopyOut):
A矩阵从输入位置到A2(输入位置可以是GM或者VECOUT):GM->A2,GM->A1->A2;VECOUT->A1->A2;
B矩阵从输入位置到B2(输入位置可以是GM或者VECOUT):GM->B2,GM->B1->B2;VECOUT->B1->B2;
完成 A2*B2=CO1 计算;
CO1 数据汇聚到 CO2:CO1->CO2;
从 CO2 到输出位置(输出位置可以是GM或者VECIN):CO2->GM / CO2->VECIN。
数据流图结构:GM 经 CopyIn 搬入 A1/B1/C1 与 VECIN,经 Split 切分到 A2/B2/C2,Compute 完成矩阵乘得到 CO1,Aggregate 汇聚到 CO2,最后 CopyOut 搬回 GM;各逻辑位置对应 Local Memory 上的 BufPool1~BufPool5 缓冲池。
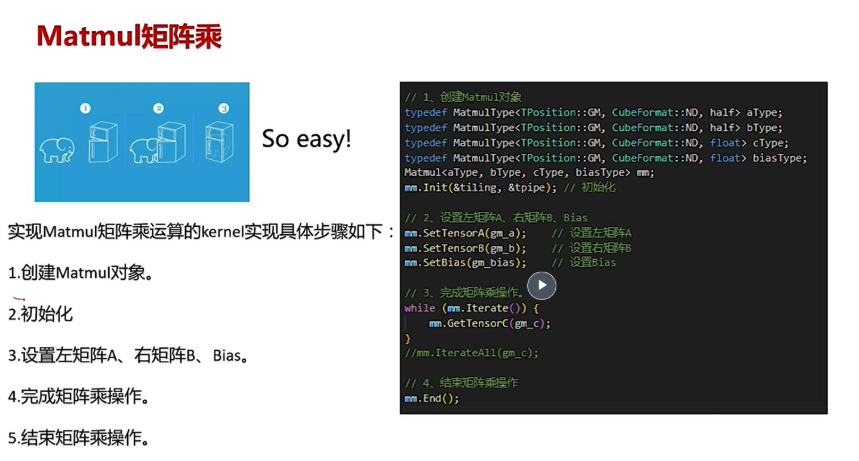
【图片知识总结】Matmul矩阵乘——kernel实现五步骤
创建Matmul对象;2. 初始化;3. 设置左矩阵A、右矩阵B、Bias;4. 完成矩阵乘操作;5. 结束矩阵乘操作。
// 1、创建Matmul对象 typedef MatmulType<TPosition::GM, CubeFormat::ND, half> aType; typedef MatmulType<TPosition::GM, CubeFormat::ND, half> bType; typedef MatmulType<TPosition::GM, CubeFormat::ND, float> cType; typedef MatmulType<TPosition::GM, CubeFormat::ND, float> biasType; Matmul<aType, bType, cType, biasType> mm; mm.Init(&tiling, &tpipe); // 初始化 // 2、设置左矩阵A、右矩阵B、Bias mm.SetTensorA(gm_a); // 设置左矩阵A mm.SetTensorB(gm_b); // 设置右矩阵B mm.SetBias(gm_bias); // 设置Bias // 3、完成矩阵乘操作 while (mm.Iterate()) { // 方式一:单次迭代叠加while循环 mm.GetTensorC(gm_c); } //mm.IterateAll(gm_c); // 方式二:IterateAll完成单核全量数据计算 // 4、结束矩阵乘操作 mm.End();
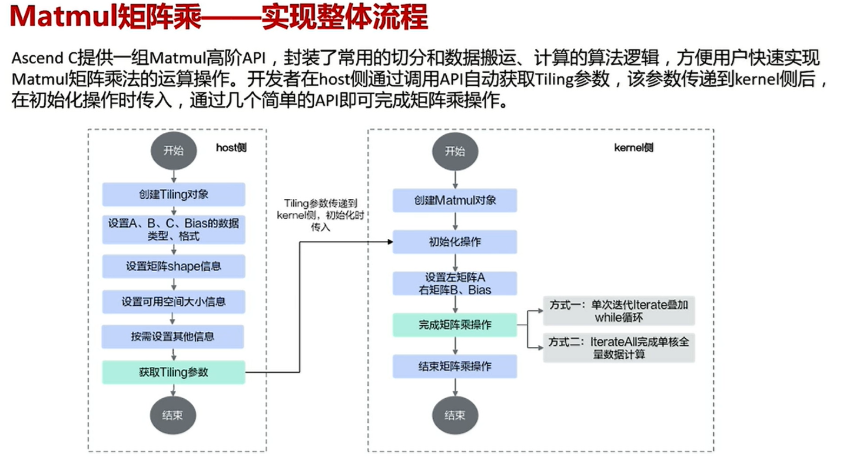
【图片知识总结】Matmul矩阵乘——实现整体流程(host侧 + kernel侧)
Ascend C 提供一组 Matmul 高阶API,封装了常用的切分和数据搬运、计算的算法逻辑,方便用户快速实现 Matmul 矩阵乘法的运算操作。开发者在 host侧通过调用API自动获取Tiling参数,该参数传递到 kernel侧后,在初始化操作时传入,通过几个简单的API即可完成矩阵乘操作。
host侧流程:创建Tiling对象 → 设置A、B、C、Bias的数据类型、格式 → 设置矩阵shape信息 → 设置可用空间大小信息 → 按需设置其他信息 → 获取Tiling参数。
kernel侧流程:创建Matmul对象 → 初始化操作(传入Tiling参数) → 设置左矩阵A、右矩阵B、Bias → 完成矩阵乘操作(方式一:单次迭代Iterate叠加while循环;方式二:IterateAll完成单核全量数据计算) → 结束矩阵乘操作。
AICore有两种架构:
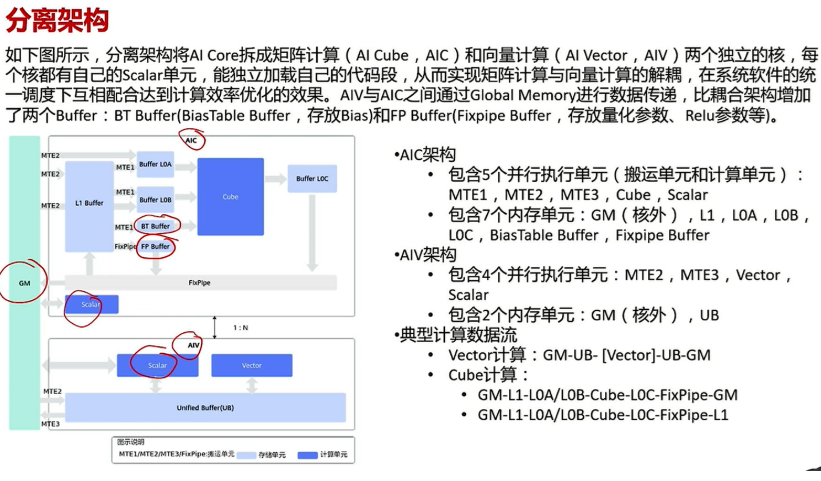
第一种是分离架构,分离架构将AIcore分成两个计算单元,一个是AIC(cube-矩阵计算)另一个是AIV(标量和向量计算),这两个单元通过GM进行数据交互。分离架构比耦合架构多了两个缓存单元,一个是BTbuffer另一个是FPbuffer。
【图片知识总结】分离架构详解
分离架构将 AI Core 拆成矩阵计算(AI Cube,AIC)和向量计算(AI Vector,AIV)两个独立的核,每个核都有自己的 Scalar 单元,能独立加载自己的代码段,从而实现矩阵计算与向量计算的解耦,在系统软件的统一调度下互相配合达到计算效率优化的效果。AIV 与 AIC 之间通过 Global Memory 进行数据传递,比耦合架构增加了两个 Buffer:BT Buffer(BiasTable Buffer,存放Bias)和 FP Buffer(Fixpipe Buffer,存放量化参数、Relu参数等)。
AIC架构:包含5个并行执行单元(搬运单元和计算单元):MTE1、MTE2、MTE3、Cube、Scalar;包含7个内存单元:GM(核外)、L1、LOA、LOB、LOC、BiasTable Buffer、Fixpipe Buffer。
AIV架构:包含4个并行执行单元:MTE2、MTE3、Vector、Scalar;包含2个内存单元:GM(核外)、UB。
典型计算数据流:
Vector计算:GM-UB-[Vector]-UB-GM;
Cube计算:GM-L1-LOA/LOB-Cube-LOC-FixPipe-GM,或 GM-L1-LOA/LOB-Cube-LOC-FixPipe-L1。
第二种是耦合架构
【图片知识总结】耦合架构详解
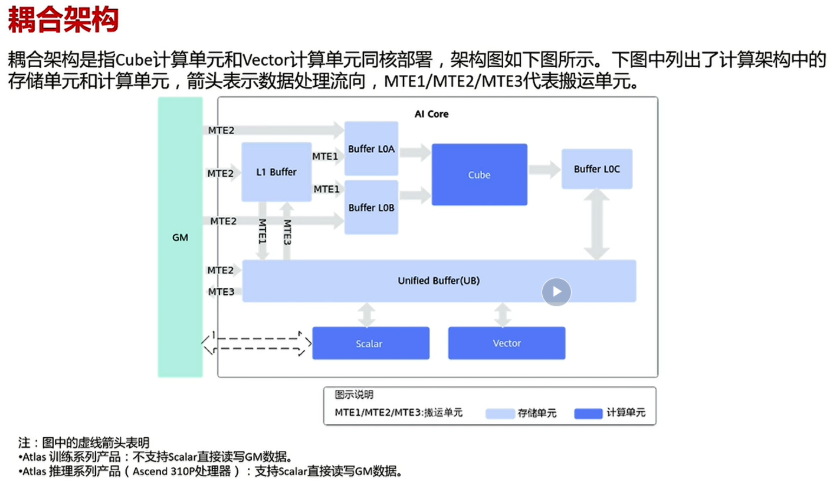
耦合架构是指 Cube 计算单元和 Vector 计算单元同核部署。架构图中列出了计算架构中的存储单元和计算单元,箭头表示数据处理流向,MTE1/MTE2/MTE3 代表搬运单元。
数据通路:GM 经 MTE2 搬入 L1 Buffer(Cube 输入路径)和 UB(Vector 输入路径);L1 经 MTE1 搬入 Buffer LOA / Buffer LOB 供 Cube 计算,结果存入 Buffer LOC;LOC 与 UB 之间可互搬;UB 与 Scalar、Vector 计算单元交互。
注(虚线箭头含义):
Atlas 训练系列产品:不支持 Scalar 直接读写 GM 数据;
Atlas 推理系列产品(Ascend 310P处理器):支持 Scalar 直接读写 GM 数据。
融合算子
【图片知识总结】融合算子章节大纲:1. 再谈架构;2. 融合算子基础知识;3. 以Matmul+LeakyRelu为例;4. 代码精讲&运行验证。
什么是融合算子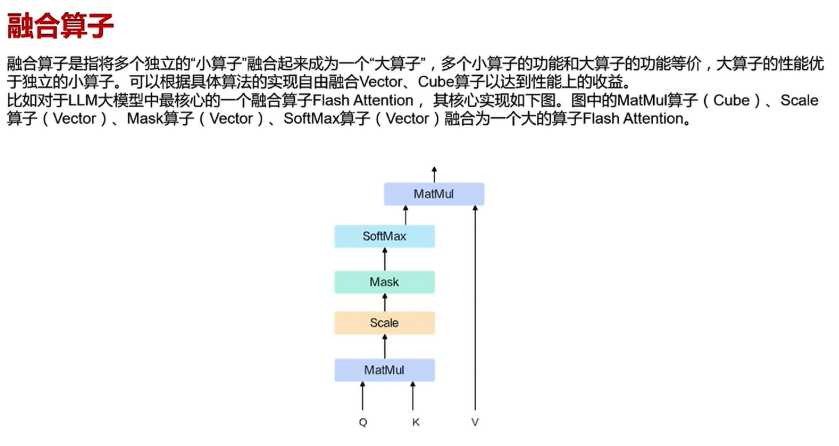
【图片知识总结】融合算子定义与典型例子
融合算子是指将多个独立的"小算子"融合起来成为一个"大算子",多个小算子的功能和大算子的功能等价,大算子的性能优于独立的小算子。可以根据具体算法的实现自由融合 Vector、Cube 算子以达到性能上的收益。
典型例子:LLM 大模型中最核心的融合算子 Flash Attention——将 MatMul 算子(Cube)、Scale 算子(Vector)、Mask 算子(Vector)、SoftMax 算子(Vector)融合为一个大的算子。数据流:Q、K 先经 MatMul → Scale → Mask → SoftMax → 再与 V 一起经 MatMul 输出。
【图片知识总结】融合算子的使用场景和优势(为什么融合能带来性能收益)
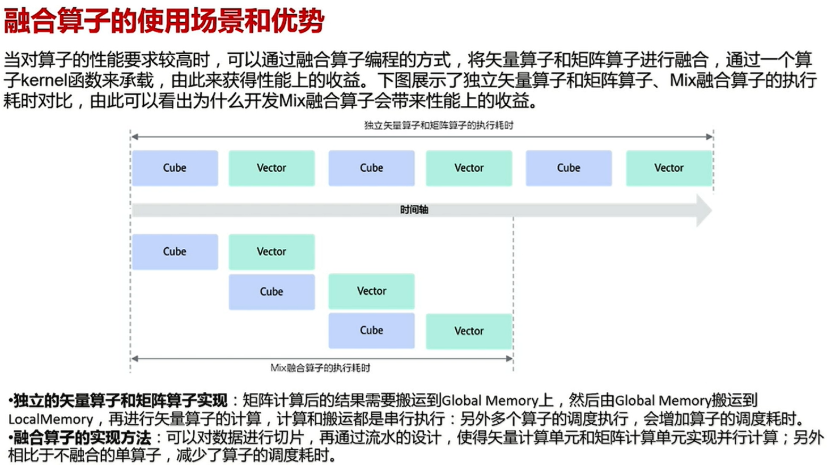
当对算子的性能要求较高时,可以通过融合算子编程的方式,将矢量算子和矩阵算子进行融合,通过一个算子 kernel 函数来承载,由此来获得性能上的收益。时间轴对比图显示:独立矢量算子和矩阵算子串行执行(Cube→Vector→Cube→Vector…)耗时长;Mix 融合算子通过流水并行(Cube 与 Vector 交错重叠执行)耗时显著缩短。
独立的矢量算子和矩阵算子实现:矩阵计算后的结果需要搬运到 Global Memory 上,然后由 Global Memory 搬运到 LocalMemory,再进行矢量算子的计算,计算和搬运都是串行执行;另外多个算子的调度执行,会增加算子的调度耗时。
融合算子的实现方法:可以对数据进行切片,再通过流水的设计,使得矢量计算单元和矩阵计算单元实现并行计算;另外相比于不融合的单算子,减少了算子的调度耗时。
【图片知识总结】融合算子的其他优势(What else?)
除了有效提升算子性能、充分发挥AI处理器的算力,融合算子还有如下优势:
减少计算量:融合算子可以将多个算子合并为一个,简化计算过程,减少计算量,提高计算效率;
减少内存占用:融合算子可以将多个算子的中间结果合并为一个,从而减少内存占用,提高内存利用率;
优化数据流:融合算子可以优化数据流,减少数据在不同算子之间的传输,从而提高数据处理效率;
简化代码实现:融合算子可以简化代码实现,减少代码量,提高代码可读性和可维护性。
总之,融合算子是一种优化计算的有效手段,可以提高计算效率和内存利用率,优化数据流,简化代码实现。
算子编程范式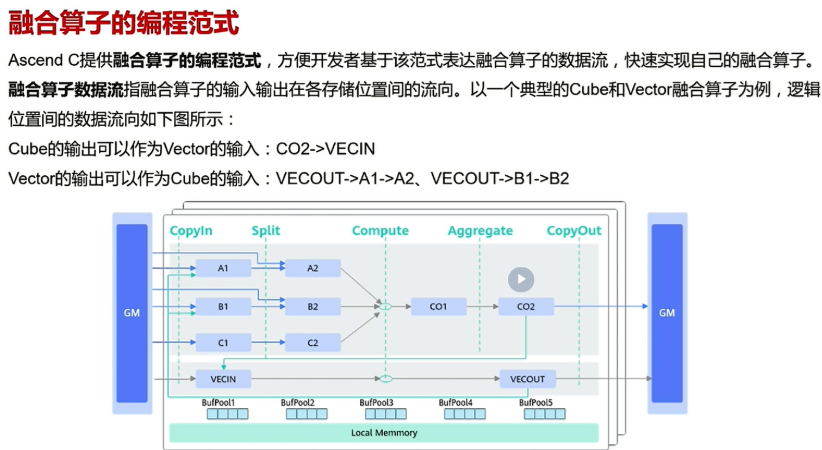
【图片知识总结】融合算子的编程范式
Ascend C 提供融合算子的编程范式,方便开发者基于该范式表达融合算子的数据流,快速实现自己的融合算子。融合算子数据流指融合算子的输入输出在各存储位置间的流向。以一个典型的 Cube 和 Vector 融合算子为例(五阶段:CopyIn → Split → Compute → Aggregate → CopyOut,对应 Local Memory 上的 BufPool1~BufPool5):
Cube的输出可以作为Vector的输入:CO2->VECIN;
Vector的输出可以作为Cube的输入:VECOUT->A1->A2、VECOUT->B1->B2。
在这个范式流程中,比如第一次是cube计算,可以将copyOut的结果直接传入VECIN,不用在存入LM搬出到GM在通过上述搬入到VECIN,省去了数据流转时间,存储消耗等。
举例融合算子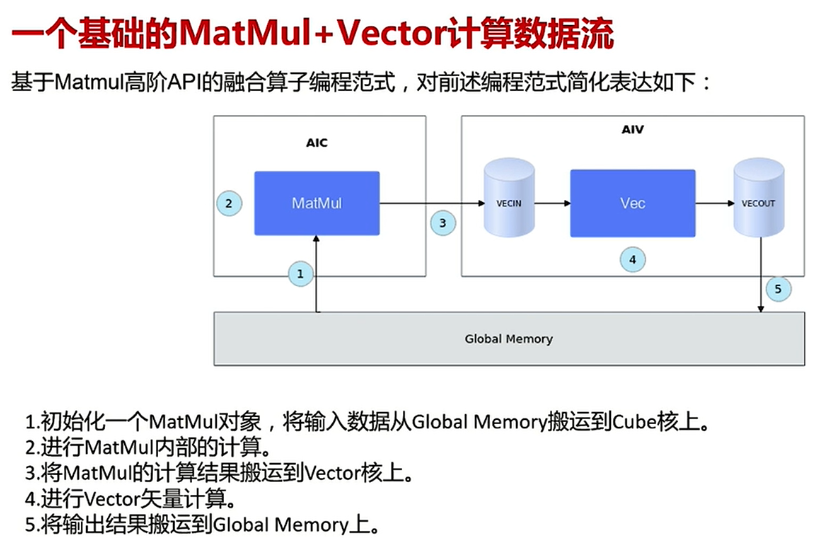
【图片知识总结】一个基础的MatMul+Vector计算数据流
基于 Matmul 高阶API的融合算子编程范式,简化表达为5步:
初始化一个MatMul对象,将输入数据从Global Memory搬运到Cube核上;
进行MatMul内部的计算;
将MatMul的计算结果搬运到Vector核上(AIC → VECIN);
进行Vector矢量计算(Vec);
将输出结果(VECOUT)搬运到Global Memory上。
算子分析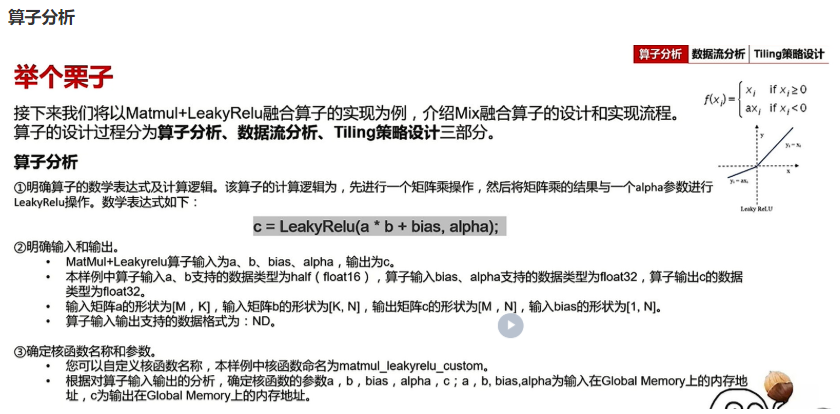
【图片知识总结】举个栗子——Matmul+LeakyRelu融合算子的算子分析
以 Matmul+LeakyRelu 融合算子的实现为例,介绍 Mix 融合算子的设计和实现流程。算子的设计过程分为算子分析、数据流分析、Tiling策略设计三部分。
① 明确算子的数学表达式及计算逻辑:先进行一个矩阵乘操作,然后将矩阵乘的结果与一个 alpha 参数进行 LeakyRelu 操作。数学表达式:
c = LeakyRelu(a * b + bias, alpha);其中 LeakyRelu:f(x)=x(若 x≥0),f(x)=αx(若 x<0)。② 明确输入和输出:
算子输入为 a、b、bias、alpha,输出为 c;
a、b 支持的数据类型为 half(float16),bias、alpha 支持的数据类型为 float32,输出 c 的数据类型为 float32;
输入矩阵 a 的形状为 [M, K],输入矩阵 b 的形状为 [K, N],输出矩阵 c 的形状为 [M, N],输入 bias 的形状为 [1, N];
算子输入输出支持的数据格式为:ND。
③ 确定核函数名称和参数:核函数命名为
matmul_leakyrelu_custom;参数 a、b、bias、alpha 为输入在 Global Memory 上的内存地址,c 为输出在 Global Memory 上的内存地址。
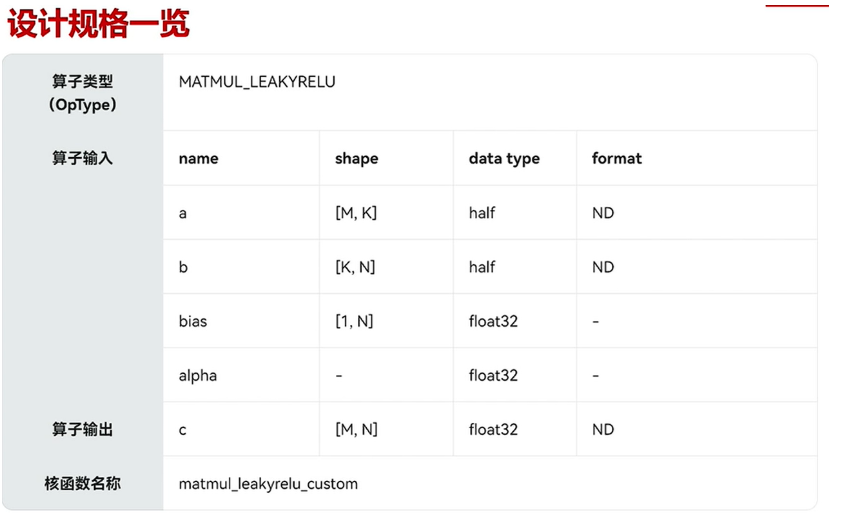
【图片知识总结】设计规格一览
项目 内容 算子类型(OpType) MATMUL_LEAKYRELU 算子输入 a shape [M, K],data type half,format ND 算子输入 b shape [K, N],data type half,format ND 算子输入 bias shape [1, N],data type float32 算子输入 alpha 标量,data type float32 算子输出 c shape [M, N],data type float32,format ND 核函数名称 matmul_leakyrelu_custom
数据流分析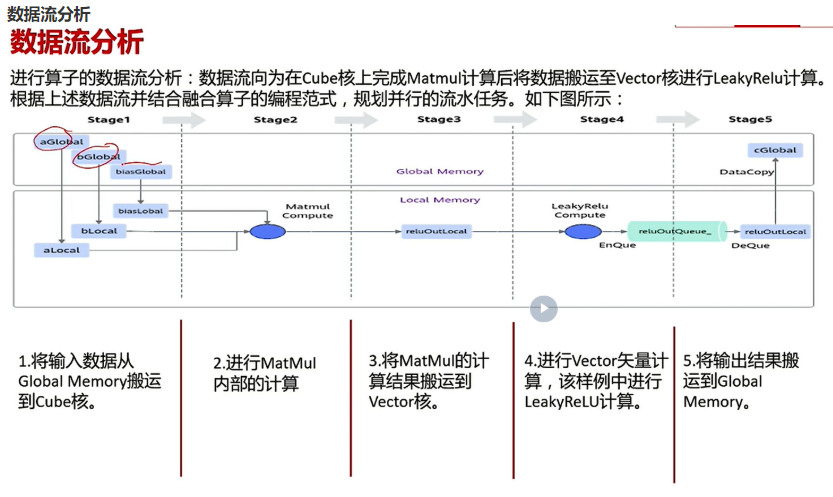
【图片知识总结】数据流分析(5个Stage的流水规划)
数据流向为在 Cube 核上完成 Matmul 计算后将数据搬运至 Vector 核进行 LeakyRelu 计算。根据上述数据流并结合融合算子的编程范式,规划并行的流水任务:
Stage1:将输入数据(aGlobal、bGlobal、biasGlobal)从 Global Memory 搬运到 Cube 核(aLocal、bLocal、biasLobal);
Stage2:进行 MatMul 内部的计算(Matmul Compute);
Stage3:将 MatMul 的计算结果(reluOutLocal)搬运到 Vector 核;
Stage4:进行 Vector 矢量计算(LeakyRelu Compute),结果经 EnQue 入队 reluOutQueue_;
Stage5:DeQue 出队后经 DataCopy 将输出结果(reluOutLocal → cGlobal)搬运到 Global Memory。
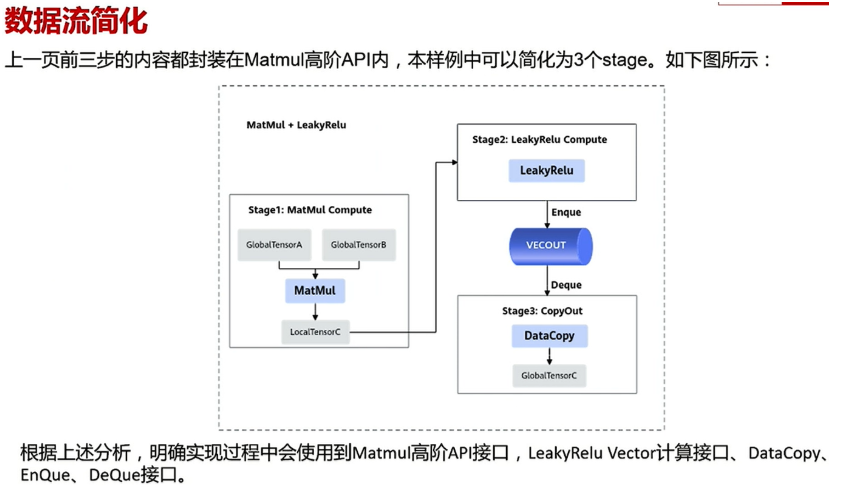
【图片知识总结】数据流简化
前三步的内容都封装在 Matmul 高阶API内,本样例中可以简化为3个stage:
Stage1: MatMul Compute:GlobalTensorA、GlobalTensorB → MatMul → LocalTensorC;
Stage2: LeakyRelu Compute:LeakyRelu 计算后 EnQue 到 VECOUT 队列;
Stage3: CopyOut:DeQue 后 DataCopy 到 GlobalTensorC。
根据上述分析,明确实现过程中会使用到 Matmul高阶API接口、LeakyRelu Vector计算接口、DataCopy、EnQue、DeQue 接口。
Tiling策略设计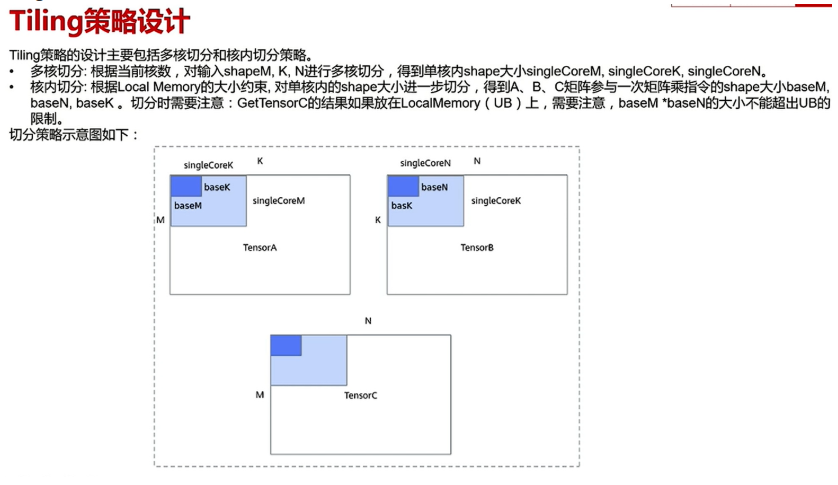
【图片知识总结】Tiling策略设计(多核切分 + 核内切分)
多核切分:根据当前核数,对输入 shape M, K, N 进行多核切分,得到单核内 shape 大小 singleCoreM, singleCoreK, singleCoreN;
核内切分:根据 Local Memory 的大小约束,对单核内的 shape 大小进一步切分,得到 A、B、C 矩阵参与一次矩阵乘指令的 shape 大小 baseM, baseN, baseK。切分时需要注意:GetTensorC 的结果如果放在 LocalMemory(UB)上,baseM * baseN 的大小不能超出 UB 的限制。
切分策略示意图:TensorA [M, K] 上先取 singleCoreM×singleCoreK 的单核块,再取 baseM×baseK 的指令块;TensorB [K, N] 上先取 singleCoreK×singleCoreN,再取 baseK×baseN;TensorC [M, N] 对应逐块累加输出。
算子实现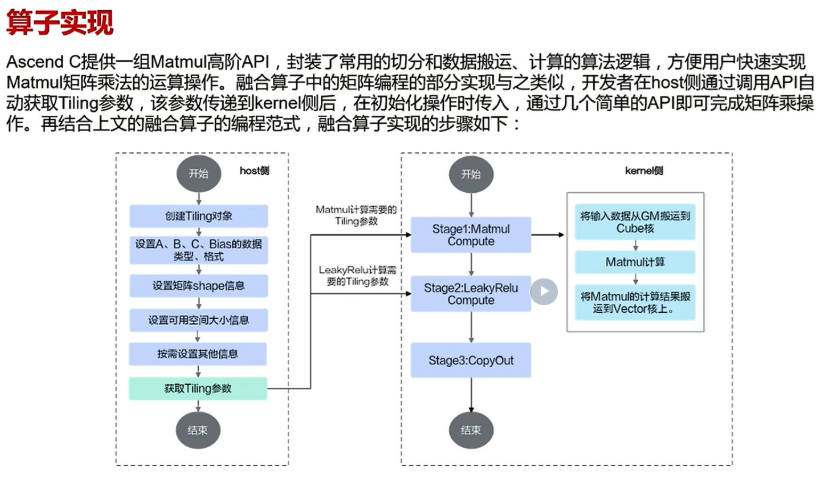
【图片知识总结】算子实现(host侧 + kernel侧整体流程)
Ascend C 提供一组 Matmul 高阶API,封装了常用的切分和数据搬运、计算的算法逻辑。融合算子中的矩阵编程的部分实现与之类似,开发者在 host 侧通过调用API自动获取Tiling参数,该参数传递到 kernel 侧后,在初始化操作时传入,通过几个简单的API即可完成矩阵乘操作。再结合上文的融合算子的编程范式,融合算子实现的步骤如下:
host侧:创建Tiling对象 → 设置A、B、C、Bias的数据类型、格式 → 设置矩阵shape信息 → 设置可用空间大小信息 → 按需设置其他信息 → 获取Tiling参数(分别提供 Matmul 计算需要的 Tiling 参数和 LeakyRelu 计算需要的 Tiling 参数)。
kernel侧:Stage1 Matmul Compute(将输入数据从GM搬运到Cube核 → Matmul计算 → 将Matmul的计算结果搬运到Vector核上) → Stage2 LeakyRelu Compute → Stage3 CopyOut → 结束。
算子的性能优化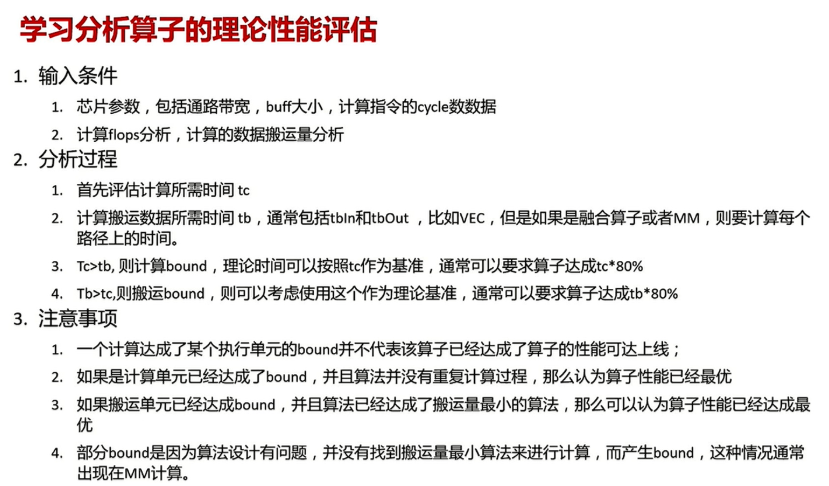
【图片知识总结】学习分析算子的理论性能评估
1. 输入条件:
芯片参数:包括通路带宽、buff大小、计算指令的cycle数数据;
计算flops分析、计算的数据搬运量分析。
2. 分析过程:
首先评估计算所需时间 tc;
计算搬运数据所需时间 tb,通常包括 tbIn 和 tbOut(比如VEC);但如果是融合算子或者MM,则要计算每个路径上的时间;
Tc > tb,则计算bound:理论时间可以按照 tc 作为基准,通常可以要求算子达成 tc*80%;
Tb > tc,则搬运bound:则可以考虑使用这个作为理论基准,通常可以要求算子达成 tb*80%。
3. 注意事项:
一个计算达成了某个执行单元的bound并不代表该算子已经达成了算子的性能可达上限;
如果是计算单元已经达成了bound,并且算法并没有重复计算过程,那么认为算子性能已经最优;
如果搬运单元已经达成bound,并且算法已经达成了搬运量最小的算法,那么可以认为算子性能已经达成最优;
部分bound是因为算法设计有问题,并没有找到搬运量最小算法来进行计算而产生bound,这种情况通常出现在MM计算。
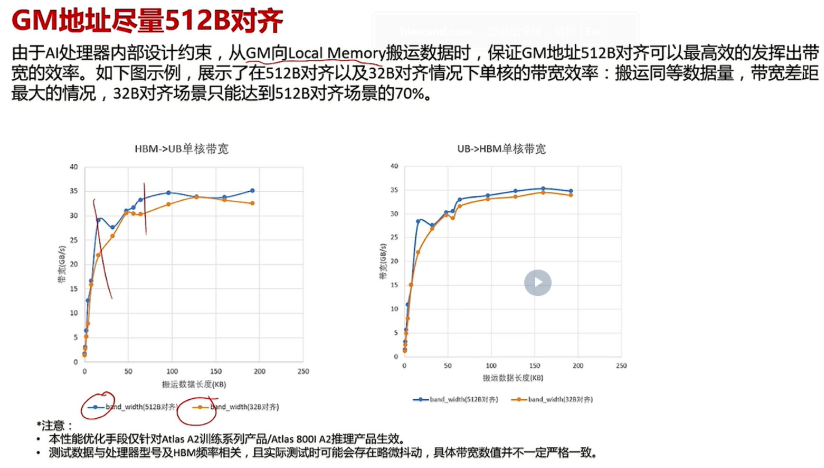
【图片知识总结】GM地址尽量512B对齐
由于AI处理器内部设计约束,从GM向Local Memory搬运数据时,保证GM地址512B对齐可以最高效地发挥出带宽的效率。对比图展示了512B对齐以及32B对齐情况下单核的带宽效率(HBM->UB单核带宽、UB->HBM单核带宽随搬运数据长度的变化曲线):搬运同等数据量,带宽差距最大的情况,32B对齐场景只能达到512B对齐场景的70%。
注意:
本性能优化手段仅针对 Atlas A2 训练系列产品 / Atlas 800I A2 推理产品生效;
测试数据与处理器型号及HBM频率相关,且实际测试时可能会存在略微抖动,具体带宽数值并不一定严格一致。
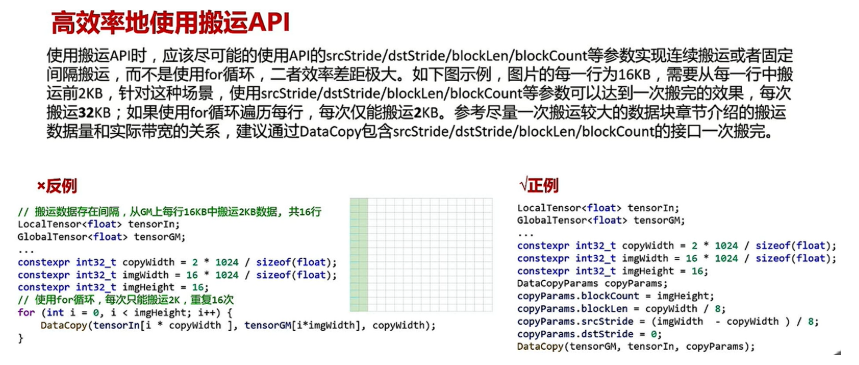
【图片知识总结】高效率地使用搬运API
使用搬运API时,应该尽可能地使用API的 srcStride/dstStride/blockLen/blockCount 等参数实现连续搬运或者固定间隔搬运,而不是使用for循环,二者效率差距极大。
示例场景:图片的每一行为16KB,需要从每一行中搬运前2KB。使用 srcStride/dstStride/blockLen/blockCount 等参数可以达到一次搬完的效果(每次搬运32KB);如果使用for循环遍历每行,每次仅能搬运2KB。建议通过 DataCopy 包含 srcStride/dstStride/blockLen/blockCount 的接口一次搬完。
反例(for循环,每次只能搬运2K,重复16次):
// 搬运数据存在间隔,从GM上每行16KB中搬运2KB数据,共16行 for (int i = 0; i < imgHeight; i++) { DataCopy(tensorIn[i * copyWidth], tensorGM[i*imgWidth], copyWidth); }正例(一次搬完):
DataCopyParams copyParams;
copyParams.blockCount = imgHeight;
copyParams.blockLen = copyWidth / 8;
copyParams.srcStride = (imgWidth - copyWidth) / 8;
copyParams.dstStride = 0;
DataCopy(tensorGM, tensorIn, copyParams);
内存优化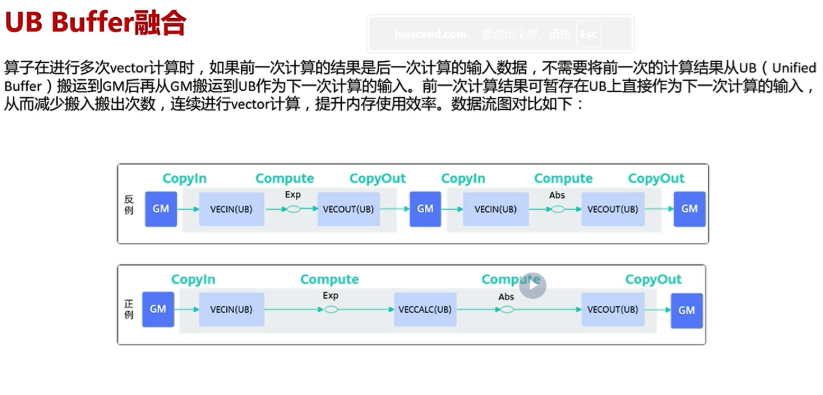
【图片知识总结】UB Buffer融合
算子在进行多次vector计算时,如果前一次计算的结果是后一次计算的输入数据,不需要将前一次的计算结果从UB(Unified Buffer)搬运到GM后再从GM搬运到UB作为下一次计算的输入。前一次计算结果可暂存在UB上直接作为下一次计算的输入,从而减少搬入搬出次数,连续进行vector计算,提升内存使用效率。
反例数据流:GM → VECIN(UB) →[Exp]→ VECOUT(UB) → GM → VECIN(UB) →[Abs]→ VECOUT(UB) → GM(中间结果往返GM);
正例数据流:GM → VECIN(UB) →[Exp]→ VECCALC(UB) →[Abs]→ VECOUT(UB) → GM(中间结果留在UB)。
此为十分基础的算子融合思想:在满足计算逻辑的前提下,尽可能减少数据交换次数。
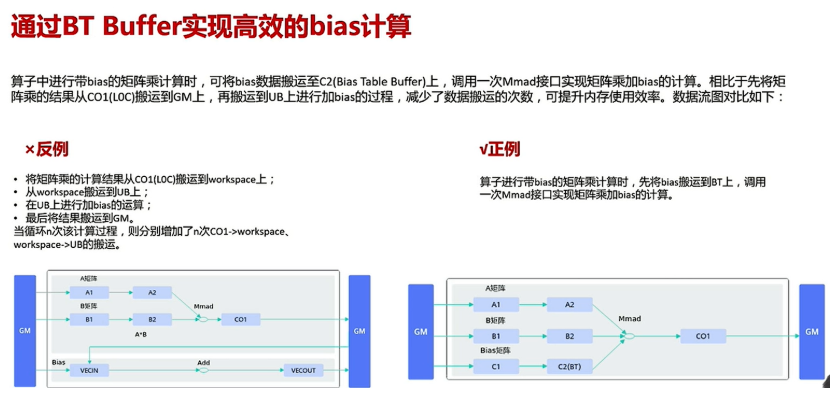
【图片知识总结】通过BT Buffer实现高效的bias计算
算子中进行带bias的矩阵乘计算时,可将bias数据搬运至 C2(Bias Table Buffer,BT)上,调用一次Mmad接口实现矩阵乘加bias的计算。相比于先将矩阵乘的结果从CO1(LOC)搬运到GM上、再搬运到UB上进行加bias的过程,减少了数据搬运的次数,可提升内存使用效率。
反例:将矩阵乘的计算结果从CO1(L0C)搬运到workspace上 → 从workspace搬运到UB上 → 在UB上进行加bias的运算 → 最后将结果搬运到GM。当循环n次该计算过程,则分别增加了n次 CO1->workspace、workspace->UB 的搬运;
正例:算子进行带bias的矩阵乘计算时,先将bias搬运到BT上,调用一次Mmad接口实现矩阵乘加bias的计算(A1→A2、B1→B2、C1→C2(BT) 共同输入Mmad得到CO1)。
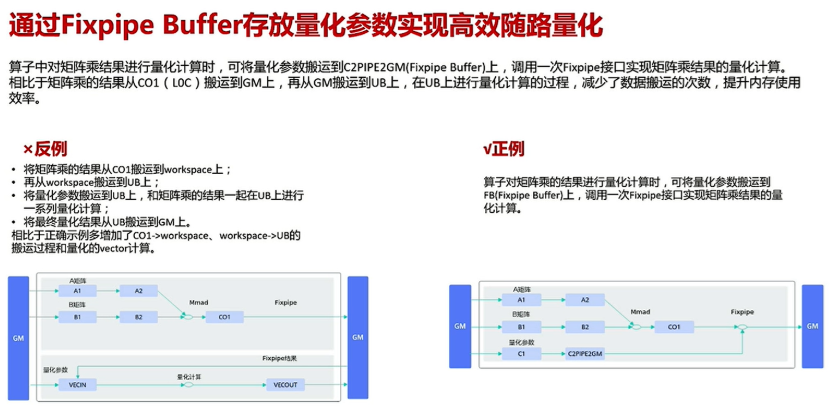
【图片知识总结】通过Fixpipe Buffer存放量化参数实现高效随路量化
算子中对矩阵乘结果进行量化计算时,可将量化参数搬运到 C2PIPE2GM(Fixpipe Buffer,FB)上,调用一次Fixpipe接口实现矩阵乘结果的量化计算。相比于矩阵乘的结果从CO1(L0C)搬运到GM上、再从GM搬运到UB上、在UB上进行量化计算的过程,减少了数据搬运的次数,提升内存使用效率。
反例:将矩阵乘的结果从CO1搬运到workspace上 → 再从workspace搬运到UB上 → 将量化参数搬运到UB上和矩阵乘的结果一起在UB上进行一系列量化计算 → 将最终量化结果从UB搬运到GM上。相比于正确示例多增加了 CO1->workspace、workspace->UB 的搬运过程和量化的vector计算;
正例:将量化参数搬运到FB(Fixpipe Buffer)上(C1→C2PIPE2GM),Mmad 得到 CO1 后经 Fixpipe 随路完成量化直接输出GM。
注意:本性能优化手段仅针对 Atlas A2 训练系列产品 / Atlas 800I A2 推理产品生效。
API使用优化: 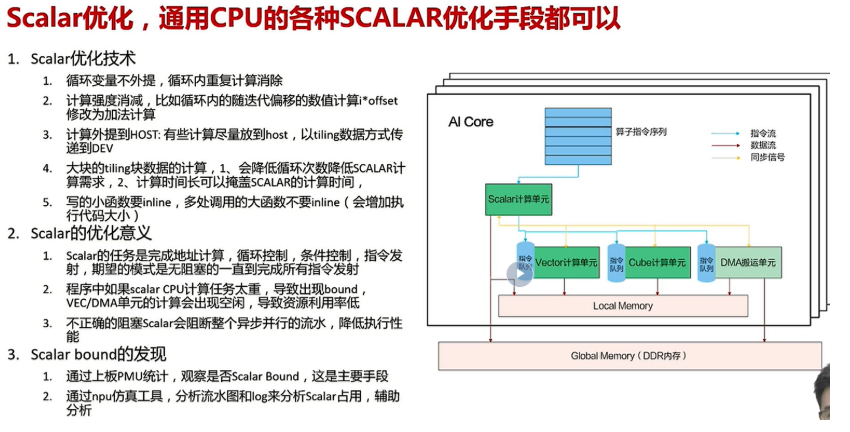
【图片知识总结】Scalar优化——通用CPU的各种SCALAR优化手段都可以
1. Scalar优化技术:
循环变量不外提,循环内重复计算消除;
计算强度消减:比如循环内的随迭代偏移的数值计算 i*offset 修改为加法计算;
计算外提到HOST:有些计算尽量放到host,以tiling数据方式传递到DEV;
大块的tiling块数据的计算:①会降低循环次数降低SCALAR计算需求;②计算时间长可以掩盖SCALAR的计算时间;
写的小函数要inline,多处调用的大函数不要inline(会增加执行代码大小)。
2. Scalar的优化意义:
Scalar的任务是完成地址计算、循环控制、条件控制、指令发射,期望的模式是无阻塞的一直到完成所有指令发射;
程序中如果scalar CPU计算任务太重,导致出现bound,VEC/DMA单元的计算会出现空闲,导致资源利用率低;
不正确的阻塞Scalar会阻断整个异步并行的流水,降低执行性能。
3. Scalar bound的发现:
通过上板PMU统计,观察是否Scalar Bound,这是主要手段;
通过npu仿真工具,分析流水图和log来分析Scalar占用,辅助分析。
架构图说明:AI Core 中算子指令序列由 Scalar 计算单元解析后,向 Vector 计算单元、Cube 计算单元、DMA 搬运单元的指令队列发射指令(指令流),各单元与 Local Memory 交互数据(数据流),并通过同步信号协调;Scalar 与 GM(DDR内存)直接交互。
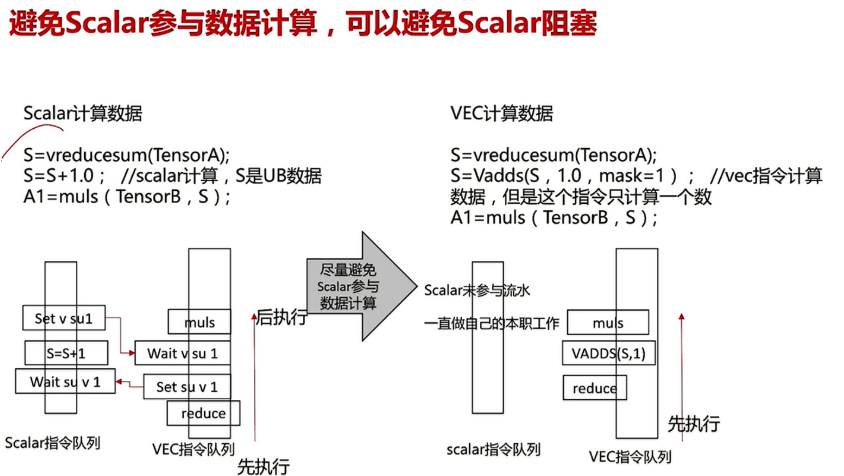
【图片知识总结】避免Scalar参与数据计算,可以避免Scalar阻塞
反例(Scalar计算数据):
S = vreducesum(TensorA);
S = S + 1.0;              // scalar计算,S是UB数据
A1 = muls(TensorB, S);
此时 Scalar 指令队列与 VEC 指令队列之间需要互相等待同步(Set v su1 / Wait v su1 / Set su v1 等),Scalar 参与流水导致阻塞。
正例(VEC计算数据):
S = vreducesum(TensorA);
S = Vadds(S, 1.0, mask=1);  // vec指令计算数据,但是这个指令只计算一个数
A1 = muls(TensorB, S);
将标量加法改用向量指令 Vadds 完成(只计算一个数),Scalar 未参与流水、一直做自己的本职工作,避免了指令队列间的互相等待。原则:尽量避免Scalar参与数据计算。
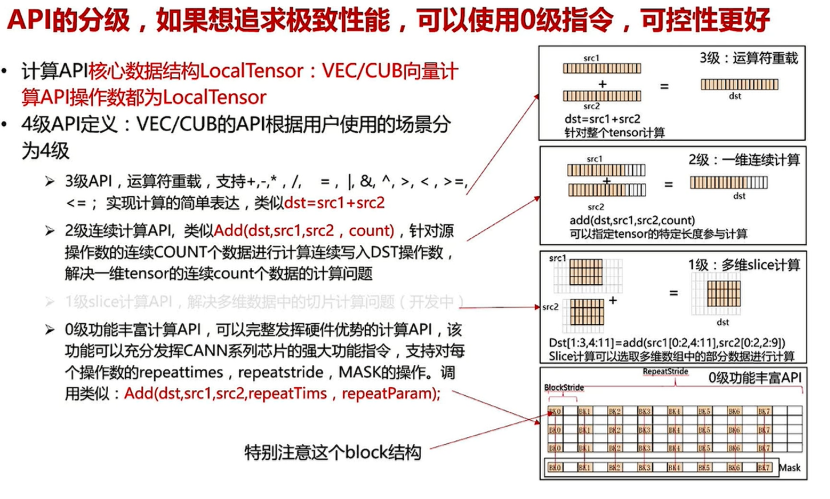
【图片知识总结】API的分级——追求极致性能可以使用0级指令,可控性更好
计算API核心数据结构 LocalTensor:VEC/CUB 向量计算API操作数都为 LocalTensor;
4级API定义:VEC/CUB 的API根据用户使用的场景分为4级:
级别 名称 说明 示例 3级 运算符重载 支持 +,-,*,/,=, ,&,^,>,<,>=,<=;实现计算的简单表达,针对整个tensor计算 2级 一维连续计算 针对源操作数的连续COUNT个数据进行计算连续写入DST操作数,解决一维tensor的连续count个数据的计算问题 Add(dst,src1,src2,count) 1级 多维slice计算 解决多维数据中的切片计算问题(开发中) Dst[1:3,4:11]=add(src1[0:2,4:11],src2[0:2,2:9]) 0级 功能丰富计算API 可以完整发挥硬件优势的计算API,充分发挥CANN系列芯片的强大功能指令,支持对每个操作数的 repeatTimes、repeatStride、MASK 的操作 Add(dst,src1,src2,repeatTims,repeatParam) 0级API中要特别注意block结构(BlockStride、RepeatStride、Mask 的组织方式)。
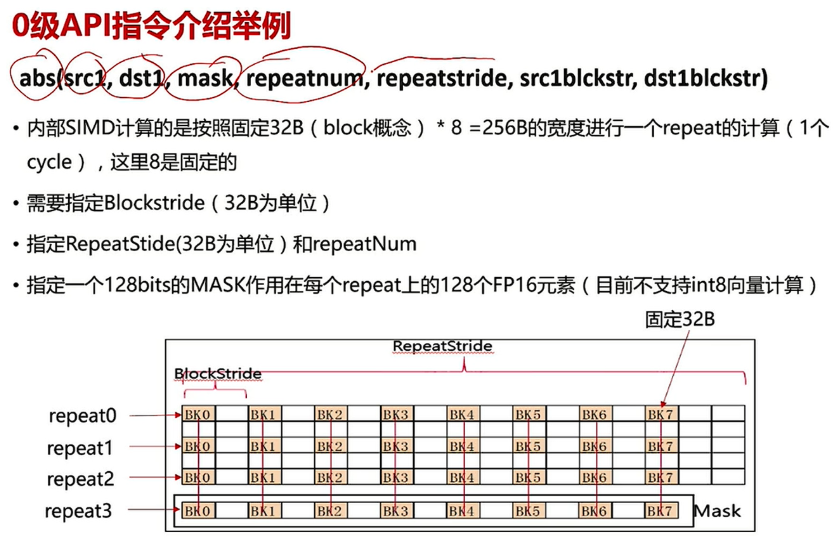
【图片知识总结】0级API指令介绍举例
接口形式:
abs(src1, dst1, mask, repeatnum, repeatstride, src1blckstr, dst1blckstr)
内部SIMD计算的是按照固定32B(block概念)* 8 = 256B的宽度进行一个repeat的计算(1个cycle),这里8是固定的;
需要指定 BlockStride(32B为单位);
指定 RepeatStride(32B为单位)和 repeatNum;
指定一个 128bits的MASK 作用在每个repeat上的128个FP16元素(目前不支持int8向量计算)。
图示结构:每个 repeat(repeat0~repeat3)包含 BK0~BK7 共8个固定32B的block;BlockStride 为 repeat 内相邻block的间隔,RepeatStride 为相邻 repeat 首block 的间隔,Mask 作用于整个repeat的数据。
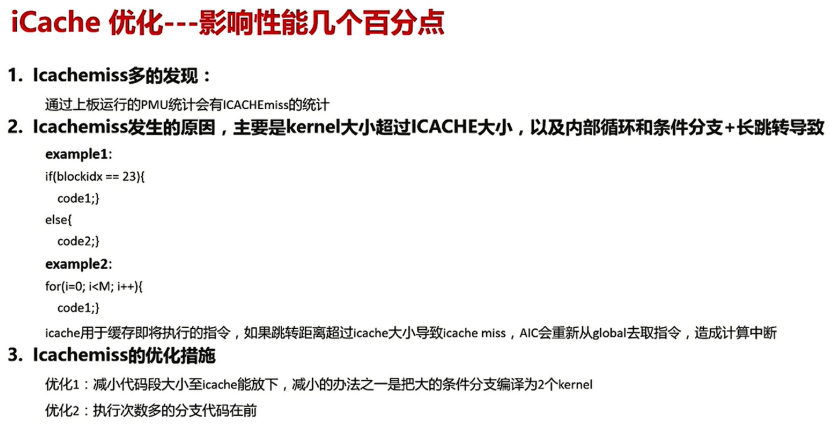
【图片知识总结】iCache优化——影响性能几个百分点
1. Icachemiss多的发现:通过上板运行的PMU统计会有ICACHEmiss的统计。
2. Icachemiss发生的原因:主要是 kernel大小超过ICACHE大小,以及内部循环和条件分支+长跳转导致。示例:
// example1: 大条件分支
if(blockidx == 23){ code1; } else{ code2; }
// example2: 长循环
for(i=0; i<M; i++){ code1; }
icache用于缓存即将执行的指令,如果跳转距离超过icache大小导致icache miss,AIC会重新从global去取指令,造成计算中断。
3. Icachemiss的优化措施:
优化1:减小代码段大小至icache能放下,减小的办法之一是把大的条件分支编译为2个kernel;
优化2:执行次数多的分支代码在前。
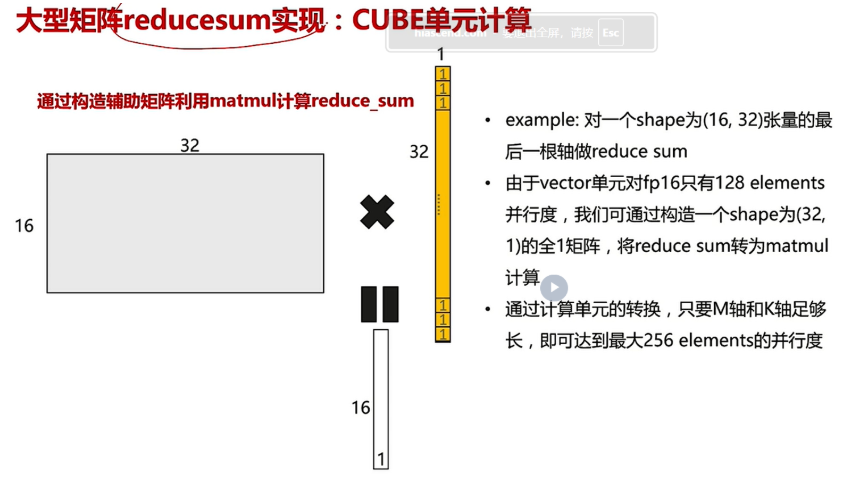
【图片知识总结】大型矩阵reducesum实现:CUBE单元计算
通过构造辅助矩阵利用matmul计算reduce_sum:
example:对一个shape为(16, 32)张量的最后一根轴做reduce sum;
由于vector单元对fp16只有128 elements并行度,我们可通过构造一个shape为(32, 1)的全1矩阵,将reduce sum转为matmul计算:(16,32) × (32,1) = (16,1);
通过计算单元的转换,只要M轴和K轴足够长,即可达到最大256 elements的并行度(高于Vector单元的128并行度)。
全文图片知识总纲(速查)
| 主题 | 核心知识点 |
|---|---|
| 孪生调试总览 | CPU域调功能/精度(GDB、printf、ASSERT),NPU域调性能(Profiling流水图、上板统计);先调对错再调性能 |
| CPU域调试 | printf打印标量;LocalTensor.Print()每行打印一个32B datablock;GDB多进程子进程调试(set follow-fork-mode child) |
| NPU域调试 | AscendC::printf打印标量;DumpTensor(srcLocal, 5, dataLen)输出Tensor内容,带DumpHead/DumpTensorHead 32字节信息头 |
| msSanitizer | 内存检测memcheck + 竞争检测racecheck;编译加--cce-enable-sanitizer -g;支持非法读写/多核踩踏/非对齐访问/内存泄漏/非法释放/分配未使用;WAW/WAR/RAW竞争 |
| msProf | 算子性能采集分析;msprof op(上板)/ msprof op simulator(仿真);输出OPPROF_目录含各类csv与流水图 |
| 矩阵乘基础 | C = A*B + Bias;A[M,K]、B[K,N]、C[M,N]、Bias[N] |
| 逻辑位置 | A1/B1/C1(整块,类比L2)、A2/B2/C2(切分小块,类比L1)、CO1/CO2(Cube Out)、VECCALC(临时变量) |
| 矩阵乘数据流 | GM/VECOUT → A1/B1 → A2/B2 → Compute(A2*B2=CO1) → Aggregate(CO1→CO2) → CopyOut(CO2→GM/VECIN) |
| Matmul高阶API | host侧创建Tiling对象获取Tiling参数 → kernel侧 Init/SetTensorA/B/Bias/Iterate或IterateAll/End |
| AICore架构 | 分离架构:AIC(MTE1/2/3、Cube、Scalar;GM、L1、LOA、LOB、LOC、BT、FP)+ AIV(MTE2/3、Vector、Scalar;GM、UB);耦合架构:Cube与Vector同核部署 |
| 融合算子 | 多个小算子融合为一个大算子,功能等价性能更优;Flash Attention = MatMul+Scale+Mask+SoftMax+MatMul;优势:减少计算量/内存占用/优化数据流/简化代码 |
| 融合编程范式 | Cube输出可作Vector输入(CO2→VECIN);Vector输出可作Cube输入(VECOUT→A1→A2、VECOUT→B1→B2);中间结果不经GM |
| Matmul+LeakyRelu实例 | c = LeakyRelu(ab + bias, alpha);设计三步:算子分析→数据流分析(5 Stage简化为3 Stage)→Tiling策略设计(多核切分singleCoreM/K/N + 核内切分baseM/K/N,baseMbaseN不超UB) |
| 理论性能评估 | 比较计算时间tc与搬运时间tb:tc>tb计算bound(目标tc80%),tb>tc搬运bound(目标tb80%) |
| 内存/搬运优化 | GM地址512B对齐(32B对齐带宽仅70%);DataCopy用srcStride/dstStride/blockLen/blockCount一次搬完代替for循环;UB Buffer融合减少搬入搬出;BT Buffer随路加bias(Mmad);Fixpipe Buffer随路量化 |
| Scalar优化 | 循环不变量外提、计算强度消减、计算外提host、大块tiling掩盖Scalar时间、小函数inline;避免Scalar参与数据计算(用Vadds等vec指令代替)防阻塞 |
| API分级 | 3级运算符重载 → 2级一维连续计算 → 1级多维slice → 0级功能丰富API(repeatTimes/repeatStride/MASK,固定32B*8=256B一个repeat) |
| iCache优化 | kernel超ICACHE大小或长跳转会miss;减小代码段(大条件分支拆2个kernel)、高频分支代码在前 |
| Cube做reducesum | 构造(32,1)全1矩阵将reduce sum转matmul,并行度从Vector的128提升到最大256 elements |

作为“人工智能6S店”的官方数字引擎,为AI开发者与企业提供一个覆盖软硬件全栈、一站式门户。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)